AI ontwikkelt zich zo snel dat bijblijven met de beveiligingsuitdagingen voelt als proberen een vliegtuig te repareren terwijl het in de lucht is. Naarmate systemen slimmer worden en dieper in dagelijkse bedrijfsprocessen worden ingebed, worden ze ook kwetsbaarder voor nieuwe soorten dreigingen.
Ik heb dit van dichtbij meegemaakt in mijn werk. Ik heb vaak beveiligingslekken ontdekt in bedrijfsprocessen waardoor iemand toegang had kunnen krijgen tot gevoelige informatie die ze niet mochten zien, zeker wanneer AI-oplossingen gehaast werden geïmplementeerd zonder de juiste beveiligingsmaatregelen.
Daar gaat dit artikel over: de risico's, uitdagingen en best practices om AI veilig te houden. AI groeit zo snel, en als we de kwetsbaarheden niet voorblijven, riskeren we het vertrouwen en de voordelen die het biedt te verliezen.
Wil je dit onderwerp uitgebreider bestuderen, bekijk dan zeker de cursus AI Security and Risk Management.
Nieuwe AI-beveiligingsuitdagingen
AI draait op data. En hoe meer data je AI nodig heeft, hoe groter het doelwit. Hackers weten dit. Stel je een ziekenhuis voor dat AI gebruikt om gezondheidsrisico's van patiënten te voorspellen. Klinkt goed, totdat iemand het systeem hackt. Plotseling liggen privé-patiëntendossiers te grabbel op het dark web, of erger nog: medische data wordt aangepast, wat kan leiden tot schadelijke beslissingen. Het versleutelen van gevoelige data en het hebben van back-ups is essentieel, maar veel bedrijven zijn zo gericht op innovatie dat ze deze basis vergeten.
En hackers stelen trouwens niet alleen data. Ze kunnen ook met AI-modellen zelf knoeien. Denk aan een zelfrijdende auto die wordt misleid om een stopbord voor een snelheidslimietbord aan te zien. Dit soort aanval heet een data poisoning-aanval, waarbij hackers slechte data in het systeem voeren om het besluitvormingsproces te corrumperen. In de volgende sectie gaan we hier dieper op in.
Prompt-injectieaanvallen zijn ook een ander type aanval. Dit zijn subtiele manipulaties die een AI verleiden om iets te zeggen—of te doen—wat niet de bedoeling is. We hebben een fantastisch artikel over prompt-injectie, dus we gaan in dit artikel niet in veel detail, maar het is zeker de moeite waard om te lezen.
Ironisch genoeg gebruiken hackers ook AI om te hacken. Dit is waar cybersecurity een race tegen de klok wordt—hackers innoveren, en securityteams moeten net zo snel reageren. Tools zoals anomaliedetectie kunnen helpen, maar ze zijn niet waterdicht.
Ken je de uitdrukking: "Een ketting is zo sterk als de zwakste schakel"? Dit geldt volledig voor AI. Bedrijven integreren vaak kant-en-klare AI-tools in hun systemen. Maar wat als een van die tools wordt gecompromitteerd? Stel je een populaire chatbot voor die door honderden bedrijven wordt gebruikt en gehackt wordt. Dan lopen honderden bedrijven—en al hun klantgegevens—risico. Het is een digitaal domino-effect.
Tot slot is er de kenniskloof. De adoptie van AI stijgt, maar cybersecurity voor AI loopt nog achter.
AI-beveiligingsdreigingen
AI-systemen worden geconfronteerd met serieuze beveiligingsdreigingen die hun werking en betrouwbaarheid kunnen ondermijnen. Laten we de belangrijkste dreigingen bekijken.
Adversarial attacks
Adversarial attacks misleiden AI-systemen door kleine, sluwe wijzigingen aan te brengen in de input die de AI verwerkt. Deze veranderingen zijn zo subtiel dat mensen ze meestal niet opmerken, maar ze kunnen de AI compleet in de war brengen zodat die de verkeerde beslissing neemt.
Bijvoorbeeld:
- Piepkleine details in een afbeelding veranderen, zoals slechts een paar pixels aanpassen, zodat de AI die verkeerd herkent.
- Lichte ruis toevoegen aan een audiobestand, waardoor het voor ons hetzelfde klinkt maar de AI het verkeerd interpreteert.
- De formulering van een zin net genoeg aanpassen om het begrip van de AI te verwarren.
Voor deze aanvallen hoeft de aanvaller niet te weten hoe de AI intern werkt, wat nog een reden is waarom ze zo lastig te detecteren en te stoppen zijn.
Laten we nu naar enkele praktijkvoorbeelden kijken.
- DeepFool-algoritme: DeepFool is een methode die minuscule, vrijwel onzichtbare wijzigingen aanbrengt in een input, zoals een afbeelding, om de AI te misleiden en verkeerd te laten classificeren. Het werkt door de input stapsgewijs te verfijnen totdat de AI het fout heeft. Deze veranderingen zijn zo klein dat mensen ze niet eens zouden opmerken.
- Gerichte audioaanvallen: In dit paper maakten aanvallers audio die bijna identiek klinkt aan het origineel maar ervoor zorgt dat een spraakherkenningssysteem compleet andere woorden hoort. Deze methode werd gebruikt om Mozilla's DeepSpeech-systeem met 100% succes te misleiden.
- Manipulatie van Tesla-autopilot: Keen Labs misleidde Tesla's autopilotsysteem door strategisch drie onopvallende stickers op de weg te plaatsen, waardoor het rijstrookmarkeringen verkeerd interpreteerde en mogelijk de verkeerde rijstrook instuurde. Lees hier meer.
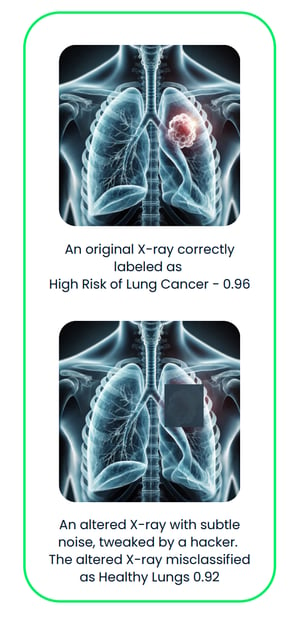
Dit diagram laat een adversarial attack zien op een AI-systeem voor medische beeldvorming. De originele röntgenfoto, correct geclassificeerd als "Hoge kans op longkanker", wordt subtiel gewijzigd met adversarial noise, wat resulteert in een foutieve classificatie van "Gezonde longen".
Een aanrader is Adversarial Machine Learning, een vakgebied dat aanvallen bestudeert die kwetsbaarheden in machinelearningmodellen uitbuiten en verdedigingen ontwikkelt om hiertegen te beschermen.
Poisoning-aanvallen
Poisoning-aanvallen richten zich op de trainingsfase van AI-systemen, waarin het model leert beslissingen te nemen. Aanvallers sluizen gecorrumpeerde of misleidende data de trainingsset in, zodat ze de AI kunnen manipuleren om zich verkeerd te gedragen of bevooroordeelde uitkomsten te geven. Deze aanvallen werken omdat ze knoeien met de basis van het leerproces van de AI, vaak zonder duidelijke sporen na te laten dat er iets mis is.
Dit kan inhouden:
- De labels van bepaalde trainingsvoorbeelden wijzigen, zoals een foto van een hond als kat labelen.
- Valse datapunten toevoegen die zijn ontworpen om de beslissingen van de AI op specifieke manieren te beïnvloeden.
Deze subtiele veranderingen kunnen ervoor zorgen dat de AI onder bepaalde omstandigheden faalt of zich op manieren gedraagt die de aanvaller ten goede komen. Omdat de aanval tijdens de training plaatsvindt, is die lastig te ontdekken zodra het model is uitgerold.
Laten we naar enkele praktijkvoorbeelden kijken:
- Backdoor-aanvallen: Een studie met de titel “Bypassing Backdoor Detection Algorithms in Deep Learning” liet zien hoe aanvallers kwaadaardige "backdoors" in AI-modellen kunnen verbergen. Deze backdoors worden alleen geactiveerd onder specifieke omstandigheden, zoals het tonen van een bepaald patroon in een afbeelding. De studie toonde aan dat aanvallers geavanceerde technieken kunnen gebruiken om vergiftigde data identiek aan schone data te laten lijken, zodat detectie wordt omzeild.
- Vergiftiging van datasest op webschaal: In het paper “Poisoning Web-Scale Training Datasets is Practical,” beschreven onderzoekers hoe grote datasets die van internet worden verzameld, kunnen worden vergiftigd:
- Split-view data poisoning: Data corrumperen nadat die is verzameld maar voordat die voor training wordt gebruikt.
- Frontrunning data poisoning: Data manipuleren vlak voordat die aan de dataset wordt toegevoegd.
- Microsofts Tay-chatbot: In 2016 lanceerde Microsoft een chatbot genaamd Tay op Twitter. Gebruikers manipuleerden Tay al snel door die te bestoken met aanstootgevende content, waardoor de bot racistische en ongepaste tweets plaatste. Microsoft moest Tay kort na de lancering uitschakelen. Lees hier meer.
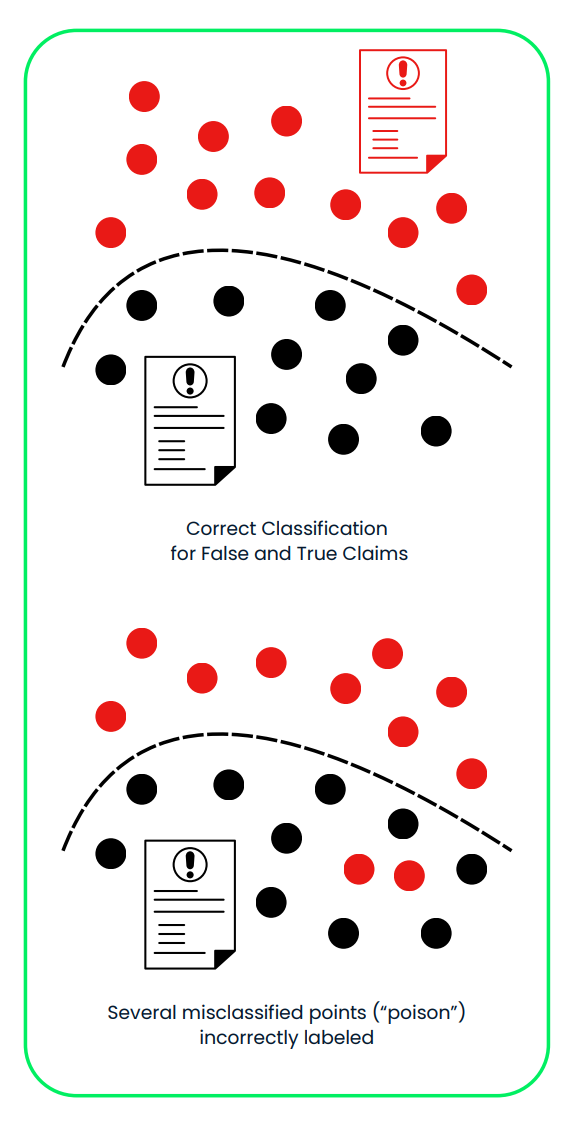
Dit diagram toont een poisoning-aanval op een AI-systeem dat valse en echte verzekeringsclaims classificeert. In het eerste paneel scheidt het systeem valse (rood) en echte (zwart) claims correct met een schone trainingsdataset. In het tweede paneel verschuift kwaadaardig verkeerd gelabelde data (“gif”) de beslissingsgrens, waardoor valse claims als echt worden geclassificeerd en de betrouwbaarheid en veiligheid van het systeem in het geding komt.
Bij een model extraction-aanval achterhaalt een aanvaller hoe een AI-model werkt door het te reverse-engineeren. Ze gebruiken de inputs en outputs die ze verzamelen om het ontwerp en gedrag van het systeem te kopiëren.
Zodra ze een replica van het model hebben gebouwd, kunnen ze:
- Het gebruiken om voorspellingen te doen, mogelijk met gevoelige of privégegevens.
- Vertrouwelijke informatie uit het oorspronkelijke model stelen.
- Het model aanpassen en hertrainen voor hun eigen doeleinden, vaak met schadelijke intenties.
Als het gestolen model bijvoorbeeld is getraind op privé-klantgegevens, zou de aanvaller persoonlijke details over die klanten kunnen voorspellen of een aangepaste versie van het model voor eigen gebruik kunnen maken.
Laten we naar enkele praktijkvoorbeelden kijken:
- Een tool genaamd DeepSniffer laat zien hoe dit soort aanval kan werken. DeepSniffer hoeft vooraf niets van het oorspronkelijke model te weten. Het verzamelt in plaats daarvan aanwijzingen uit hoe het model data verwerkt, zoals het volgen van geheugenoperaties tijdens runtime. Het combineert deze aanwijzingen om de structuur van het model te achterhalen, zelfs als het systeem probeert processen te optimaliseren of te verbergen.
- Mindgard demonstreerde hoe kritieke componenten van een black-box-taalmodel, zoals OpenAI's ChatGPT 3.5 Turbo, via een goedkope aanpak kunnen worden geëxtraheerd. Met slechts $50 aan API-kosten slaagde het team erin een kleiner model te creëren—ongeveer 100 keer kleiner dan het origineel—dat ChatGPT op een specifieke taak overtrof. Dit geëxtraheerde model werd vervolgens gebruikt om een andere aanval te verbeteren, die daarna tegen ChatGPT zelf werd ingezet. De verbeterde aanval behaalde een hogere slagingskans, oplopend tot 11%.
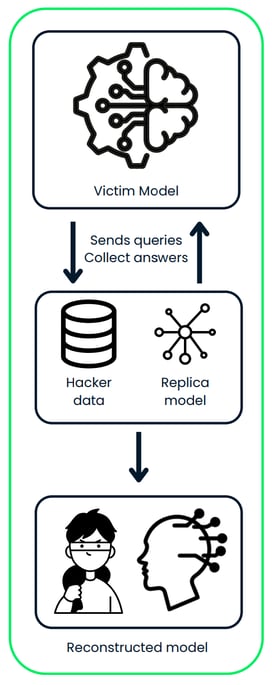
Dit diagram illustreert een model extraction-aanval, waarbij een aanvaller met een slachtoffer-AI-model interageert door queries te sturen en de voorspellingen te verzamelen. De aanvaller gebruikt de verzamelde data om een replicamodel te trainen en zo uiteindelijk een gestolen versie van het oorspronkelijke systeem te reconstrueren.
AI-beveiligingsverdedigingen
We hebben in eerdere secties genoemd dat, naarmate AI gebruikelijker wordt, het belangrijk is om sterke beveiligingsmaatregelen te treffen om aanvallen te voorkomen. Laten we enkele effectieve manieren bespreken om AI veiliger te maken.
Adversarial training
Deze methode houdt in dat je modellen leert om lastige, gemanipuleerde inputs (zogenaamde adversarial examples) te herkennen en ermee om te gaan. Wanneer je je model met deze voorbeelden traint, wordt het beter bestand tegen bepaalde soorten aanvallen.
- Hoe het werkt: Maak voorbeelden van gemanipuleerde data en neem die op in de training van de AI.
- Waarom het helpt: Het maakt AI-systemen robuuster tegen aanvallen die proberen ze te misleiden.
- Nadeel: De nauwkeurigheid op normale (schone) data kan iets lager worden.
- Praktijkvoorbeelden:
- Google's Cloud Vision API gebruikt adversarial training om de veerkracht van zijn beeldherkenningsmodellen tegen gemanipuleerde inputs te verbeteren
- OpenAI's modellen verwerken adversarial examples in het trainingsproces om de robuustheid tegen tekstgebaseerde aanvallen te vergroten.
Defensive distillation
LLM-distillatie houdt in dat je een tweede model traint om het gedrag van het oorspronkelijke model na te bootsen, met als doel het lastiger te maken voor aanvallers om te manipuleren.
- Hoe het werkt: Train eerst het ene model en gebruik vervolgens de output om een ander model te trainen op een manier die het beslissingsproces afvlakt.
- Waarom het helpt: Het maakt het moeilijker voor aanvallers om zwaktes uit te buiten.
- Nadeel: Deze aanpak kan veel rekenkracht vereisen, zeker bij grote modellen.
- Praktijkvoorbeelden:
- Onderzoekers van de University of California, Berkeley, pasten defensive distillation toe om de robuustheid van deep neural networks voor autonome voertuigen te verbeteren.
- IBM's Watson AI-platform past defensive distillation-technieken toe om zijn natural language processing-modellen te beschermen tegen adversarial attacks.
Zeker stellen dat de data die een AI-systeem binnenkomt schoon en veilig is, is cruciaal om het te beschermen tegen kwaadaardige inputs.
- Hoe het werkt: Controleer of inputs het juiste formaat hebben, binnen verwachte bereiken vallen en geen schadelijke elementen bevatten.
- Waarom het helpt: Voorkomt aanvallen zoals data poisoning en houdt het AI-systeem soepel draaiend.
- Best practice: Valideer data in meerdere stappen—aan de gebruikerskant, aan de serverkant en binnen het AI-systeem zelf.
- Praktijkvoorbeelden:
- Microsofts Azure AI-services implementeren strikte inputvalidatie om SQL-injectieaanvallen op hun machinelearningmodellen te voorkomen.
- Amazon's Rekognition-gezichtsherkenningssysteem gebruikt inputsanitatie om potentieel kwaadaardige beeldinputs te filteren.
Ensemble-methoden
Het gebruik van meerdere verschillende AI-modellen samen (een ensemble) kan systemen veiliger maken. Zelfs als één model wordt aangevallen, kunnen de andere als back-up dienen.
- Hoe het werkt: Combineer de voorspellingen van meerdere modellen om beslissingen te nemen.
- Waarom het helpt: Het is lastiger voor aanvallers om alle modellen tegelijk te compromitteren.
- Nadeel: Vereist meer rekenbronnen om meerdere modellen te beheren.
- Praktijkvoorbeelden:
- Het aanbevelingssysteem van Netflix gebruikt een ensemble van meerdere AI-modellen om de nauwkeurigheid en de weerbaarheid tegen manipulatiepogingen te verbeteren.
- Ensemble-methoden zijn niet exclusief voor beveiliging in AI; ze worden in het algemeen gebruikt om robuustere en nauwkeurigere voorspellende modellen te bouwen.
Explainable AI (XAI)
AI-systemen uitlegbaar maken helpt mensen te begrijpen hoe ze werken en eventuele kwetsbaarheden of ongewoon gedrag te detecteren. Je kunt dit onderwerp uitgebreider verkennen in de cursus Explainable AI in Python.
- Hoe het werkt: Gebruik tools zoals LIME, SHAP of attention-mechanismen om AI-beslissingen uit te leggen.
- Waarom het helpt: Vergroot het vertrouwen in AI-systemen en maakt het makkelijker om issues zoals bias te signaleren en te verhelpen.
- Uitdaging: Eenvoudigere, uitlegbare modellen zijn mogelijk niet zo krachtig als complexe.
- Praktijkvoorbeeld:
- Het Explainable AI (XAI)-programma van DARPA heeft als doel om transparantere AI-systemen voor militaire toepassingen te ontwikkelen.
- IBM's AI Explainability 360-toolkit biedt open-sourceresources voor het implementeren van uitlegbare AI-technieken in diverse sectoren.
Regelmatige security-audits
AI-systemen regelmatig op zwaktes controleren helpt problemen vroegtijdig te ontdekken en zorgt dat ze op termijn veilig blijven.
- Wat het inhoudt: Voer kwetsbaarheidsassessments, penetratietests en code-reviews uit.
- Hoe vaak: Voer audits regelmatig uit en na belangrijke wijzigingen aan het systeem.
- Waarom het helpt: Identificeert potentiële beveiligingsgaten en zorgt voor naleving van regelgeving.
- Praktijkvoorbeelden:
- Facebook voert regelmatige security-audits uit van zijn AI-gestuurde contentmoderatiesystemen om potentiële kwetsbaarheden te identificeren en aan te pakken.
- De AI Act van de Europese Unie stelt verplichte security-audits voor hoog-risico-AI-systemen in kritieke sectoren voor.
Met deze strategieën worden AI-systemen veiliger en beter beschermd tegen aanvallen. Maar hier is het punt—AI-beveiliging is geen "set it and forget it"-verhaal. Het is een continu proces.
Naarmate er nieuwe dreigingen opduiken—en geloof me, die komen er altijd—moeten bedrijven scherp blijven. Dat betekent voortdurend monitoren op kwetsbaarheden, systemen updaten en verdedigingen verbeteren.
|
Methode
|
Hoe het werkt
|
Waarom het helpt
|
Nadelen
|
|
Adversarial training
|
Maak voorbeelden van gemanipuleerde data en neem die op in de training van de AI.
|
Verbetert de robuustheid tegen adversarial aanvallen die het systeem proberen te misleiden.
|
Kan de nauwkeurigheid van de AI op normale (schone) data licht verlagen.
|
|
Defensive distillation
|
Train een secundair model om het gedrag van het oorspronkelijke model na te bootsen en het beslisproces te verzachten.
|
Maakt het moeilijker voor aanvallers om zwaktes in het model uit te buiten.
|
Vereist veel rekenkracht, vooral bij grote modellen.
|
|
Inputvalidatie & -sanitatie
|
Valideer dat inputs het juiste formaat hebben, binnen verwachte bereiken vallen en geen schadelijke elementen bevatten.
|
Voorkomt datavergiftiging en zorgt voor een soepele werking van het AI-systeem.
|
Vereist zorgvuldige implementatie in meerdere stappen.
|
|
Ensemble-methoden
|
Combineer voorspellingen van meerdere modellen om beslissingen te nemen.
|
Het is moeilijker voor aanvallers om alle modellen tegelijkertijd te compromitteren.
|
Vereist meer rekenbronnen om meerdere modellen te beheren en te onderhouden.
|
|
Explainable AI (XAI)
|
Gebruik tools zoals LIME, SHAP of attention-mechanismen om AI-beslissingen uit te leggen.
|
Vergroot het vertrouwen en maakt het makkelijker om problemen zoals vooringenomenheid of ongebruikelijk gedrag te identificeren en op te lossen.
|
Eenvoudigere, verklaarbare modellen presteren mogelijk minder goed dan complexe modellen.
|
|
Regelmatige security-audits
|
Voer kwetsbaarheidsanalyses, penetratietests en code-reviews uit om zwaktes te identificeren.
|
Spoort potentiële beveiligingslekken op en zorgt voor naleving van regelgeving.
|
Kan veel middelen vergen, afhankelijk van de complexiteit van het systeem.
|
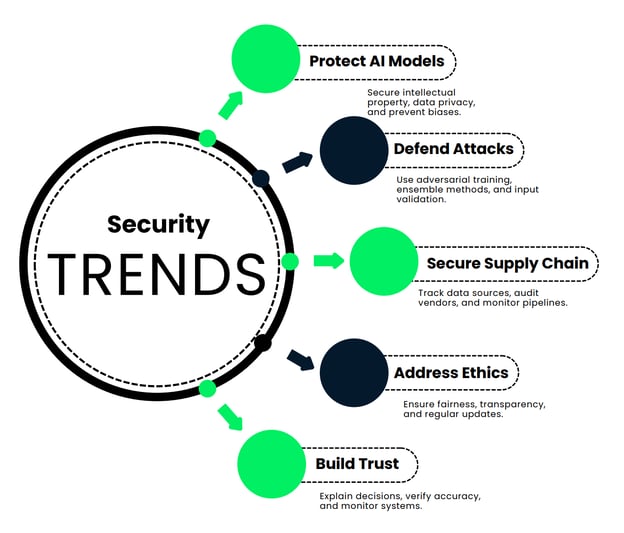
Nieuwe trends in AI-beveiliging
In deze sectie kijken we naar nieuwe trends die AI-systemen veilig, nauwkeurig en betrouwbaar houden.
AI-modellen en dataintegriteit beschermen
Laten we eerst bespreken waarom het zo belangrijk is om AI-modellen en data te beschermen.
- Intellectueel eigendom beschermen: Denk aan de tijd, het geld en het denkwerk die in een AI-model gaan. Het zijn niet zomaar algoritmes; het zijn enorme investeringen. Ze veilig houden voorkomt dat concurrenten ermee aan de haal gaan.
- Concurrentievoordeel behouden: Als iemand ongeautoriseerde toegang krijgt tot jouw AI-model, kan die het kopiëren en dezelfde resultaten behalen—zonder een cent aan ontwikkeling uit te geven.
- Dataprivacy en compliance: AI verwerkt vaak gevoelige data—financiële info, medische dossiers, noem maar op. Als deze data uitlekt, kun je rekenen op forse boetes en een flinke deuk in het publieke vertrouwen. Leer meer in deze Introduction to Data Privacy.
- Datavergiftiging voorkomen: Hackers kunnen met je trainingsdata knoeien en je AI verkeerde beslissingen laten nemen—zoals fraude doorlaten of onschuldige acties als bedreiging aanmerken.
- Model inversion-aanvallen beperken: Stel je voor dat aanvallers privéklantgegevens kunnen achterhalen door alleen naar de outputs van je AI te kijken. Dat wil je niet!
- Vooringenomen of onethische uitkomsten vermijden: Een gecompromitteerd model kan leiden tot oneerlijke of zelfs schadelijke beslissingen, met reputatieschade tot gevolg.
- Kritieke infrastructuur beschermen: Nu AI wordt ingezet in de zorg, financiën en zelfs nationale veiligheid, is bescherming niet alleen een zakelijke kwestie—het is een kwestie van publieke veiligheid.
Hoe houd je je AI dan daadwerkelijk veilig? Dit zijn enkele kernstrategieën:
- Gebruik data-encryptie en anonimisering om gevoelige informatie te beschermen.
- Implementeer strikte bewaartermijnen voor data om te bepalen hoe lang informatie wordt opgeslagen.
- Voer regelmatige security-audits en monitoring uit om zwaktes vroeg te detecteren.
- Ontwerp systemen volgens privacy by design-principes en bouw beveiliging in elke stap in.
- Gebruik geavanceerde technieken zoals federated learning om het model en de data te beschermen zonder gevoelige informatie te verplaatsen.
Laten we dit concreet maken met een scenario uit de praktijk. Stel je een grote internationale bank voor die een AI-model heeft ontwikkeld om frauduleuze transacties te detecteren. Het systeem verwerkt dagelijks miljoenen transacties, spoort verdachte patronen op en markeert fraude.
De bank heeft 50 miljoen dollar en drie jaar in dit systeem geïnvesteerd. Als het wordt gestolen, kunnen concurrenten het gebruiken zonder een cent te investeren, waardoor de bank haar voorsprong verliest.
Dit model verwerkt gevoelige financiële data van miljoenen klanten. Een datalek kan deze informatie blootleggen en leiden tot enorme boetes onder wetten zoals de AVG.
Als hackers tijdens de training nepdata injecteren, kunnen ze de AI leren bepaalde fraudepatronen te missen, waardoor de bank kwetsbaar blijft.
Geavanceerde aanvallers zouden zelfs privégegevens van klanten uit de outputs van het model kunnen afleiden.
Hoe beschermt de bank dit?
- Ze gebruiken end-to-end-encryptie om data te beveiligen.
- Toegang tot het model vereist multi-factorauthenticatie en is beperkt via rolgebaseerde controles.
- Ze voeren regelmatige audits en penetratietests uit om zwaktes te vinden.
- Klantdata die voor training wordt gebruikt, is volledig geanonimiseerd.
- De bank monitort de prestaties van het model continu om onregelmatigheden snel te signaleren.
Dit resulteert in een veiliger, betrouwbaarder AI-systeem dat klantdata beschermt en zijn belofte om fraude effectief op te sporen waarmaakt. Een win-win voor de bank en haar klanten.
Verdedigen tegen ontwijkings- en vergiftigingsaanvallen
Stel, je beheert een hoogbeveiligde faciliteit die op gezichtsherkenning vertrouwt om alles veilig te houden. We weten echter dat AI-systemen kwetsbaar zijn voor aanvallen, zoals adversarial inputs of vergiftigde trainingsdata. Hackers kunnen het systeem manipuleren om binnen te komen.
Dit zijn de vier belangrijkste verdedigingen die aanvallers kunnen stoppen:
- Adversarial training: Dit is alsof je je model wat zelfverdediging aanleert. Je neemt voorbeelden op van gemanipuleerde inputs—afbeeldingen met subtiele aanpassingen die de AI moeten misleiden—en traint het om die te herkennen. Denk aan een gezichtsherkenningssysteem dat niet alleen jouw gezicht ziet, maar ook de pixelperfecte wijzigingen die aanvallers proberen binnen te smokkelen. Je AI wordt slimmer tegen deze aanvallen door van deze voorbeelden te leren, zodat het zich in de praktijk niet laat foppen.
- Ensemble-methoden: Die hebben we al eerder besproken. In plaats van te vertrouwen op één systeem, gebruik je een team van modellen. Elk model verwerkt de input onafhankelijk, en de resultaten worden gecombineerd via een stemsysteem. Aanvallers kunnen niet slechts één model misleiden—ze moeten het hele team foppen. Succes daarmee.
- Regelmatige datacontroles: Niemand houdt van opruimen, maar dit is essentieel onderhoud voor je AI. Wekelijkse audits zorgen dat je trainingsdata vrij is van duplicaten, verkeerd gelabelde items of stiekeme kwaadwillige inputs. En door de dataset up-to-date te houden met geverifieerde afbeeldingen blijft je systeem scherp.
- InputvalidatieVoordat een afbeelding ook maar in de buurt van je AI komt, gaat die door een veiligheidscontrole. Dit gebeurt er:
- Formaat en grootte worden gecontroleerd.
- Metadata wordt geanalyseerd op tekenen van knoeien.
- Bekende adversarial patronen worden geflagd.
- Anomaliedetectie spoort alles wat ongewoon is op.
Het systeem is niet alleen slim, maar ook voorzichtig. Elke input moet bewijzen dat die legitiem is voordat die verder mag.
AI-toeleveringsketens beveiligen
AI beveiligen draait om het beheren van dataintegriteit, het beschermen van eigen modellen en zorgen dat alles goed samenwerkt met je bestaande cybersecurity. Voeg daar de noodzaak aan toe om in te spelen op veranderende dreigingen, regelgeving, ethiek en kwetsbaarheden in de toeleveringsketen. Hier zijn enkele strategieën om de AI-levenscyclus te beveiligen:
- Houd je bronnen bij: Elk datapunt en elk model in je AI-systeem moet een duidelijke herkomst hebben. Documenteer waar het vandaan komt—een vertrouwd ziekenhuis, een onderzoeksinstelling of een gespecialiseerde leverancier. Waarom? Omdat weten wat de bron is, stap één is om te weten of je die kunt vertrouwen.
- Auditeer je leveranciers: Derdepartijleveranciers zijn cruciaal, maar ook potentiële zwakke schakels. Voer regelmatige audits uit om te zorgen dat ze aan jouw beveiligingsstandaarden voldoen, of dat nu HIPAA-compliance, protocollen voor data-anonimisering of ISO-certificeringen zijn.
- Gebruik datatrackingtools: Je data is niet statisch. In de tijd ontwikkelt die zich, en soms omvat die ontwikkeling fouten of kwaadwillige wijzigingen. Tools zoals geautomatiseerde datamonitoring kunnen veranderingen bijhouden en onverwachte verschuivingen signaleren, zodat je datasets schoon en accuraat blijven.
- Monitor datapijplijnen: Data stroomt via complexe pijplijnen van bron naar model, en elke hapering onderweg kan problemen opleveren. Realtime dashboards helpen onregelmatigheden te vangen, zoals plotselinge dalingen in datavolume of onverwachte featurewijzigingen.
Hier is een praktijkvoorbeeld. Neem een zorgorganisatie die een AI-ondersteunde diagnostische tool ontwikkelt. Hun toeleveringsketen omvat:
- Patiëntdata van partnerziekenhuizen.
- Medische beeldvormingsdatasets van een toonaangevende onderzoeksinstelling.
- Voorgetrainde modellen van een gespecialiseerde AI-leverancier.
Hoe beveiligen ze deze keten?
- Bronnen bijhouden: Elke dataset en elk model wordt nauwkeurig gedocumenteerd om traceerbaarheid te garanderen.
- Leveranciersaudits: Elk kwartaal controleren ze op HIPAA-compliance en zorgen ze voor data-anonimisering. Leveranciers krijgen jaarlijkse security-assessments om certificeringen te behouden.
- Data lineage-tools: Ze gebruiken tools zoals Anomalo om onverwachte verschuivingen in patiëntdemografie of beelddata te signaleren.
- Pijplijnmonitoring: Realtime dashboards in Looker houden de datastroom in de gaten en vlaggen onregelmatigheden direct.
Zo ontstaat een veilige AI-toeleveringsketen die ervoor zorgt dat hun diagnostische tool accuraat, betrouwbaar en conform de industrienormen is.
Omgaan met ethische risico's
AI is krachtig, maar die kracht kan gevaarlijk zijn in de verkeerde handen. Als een AI-systeem wordt gehackt of slecht is ontworpen, kan dat leiden tot bevooroordeelde beslissingen, onethische uitkomsten of zelfs misbruik. Dat is een groot probleem, zeker wanneer AI beslissingen neemt die echte levens raken—zoals bij werving, leningen of gezondheidszorg.
Hoe maken we AI-systemen ethischer en veerkrachtiger? Vier kernstappen:
- Ontwikkel duidelijke regels en kaders: Begin met een solide basis. Stel beleid op dat definieert wat eerlijkheid en ethiek betekenen voor jouw systeem.
- Train AI-teams in ethiek: Je kunt niet verwachten dat AI ethisch handelt als de mensen die het bouwen niet zijn uitgerust om kritisch over deze kwesties na te denken. Ethiektraining helpt teams onbewuste vooroordelen te herkennen en aan te pakken, eerlijkheid te begrijpen en de maatschappelijke impact van hun werk te overzien.
- Maak AI-beslissingen transparant: Transparantie betekent systemen ontwerpen die hun beslissingen kunnen uitleggen—welke factoren zijn meegewogen, hoe kandidaten zijn vergeleken en waar mogelijke aandachtspunten liggen. Transparantie bouwt vertrouwen en verantwoordelijkheid.
- Update AI-systemen regelmatig: AI is geen set-and-forget. Regelmatige audits helpen vooroordelen te identificeren en te verminderen, zorgen voor eerlijkheid en houden het systeem in lijn met de laatste industrienormen en wettelijke vereisten. Eerlijkheid is niet statisch; het is een continu proces.
Een praktijkvoorbeeld: een groot techbedrijf gebruikt een AI-gestuurd wervingssysteem. Hoe houden ze dat ethisch?
- Duidelijke regels opstellen: Ze maken een AI-ethiekbeleid met principes voor onbevooroordeelde werving, van dataverzameling tot besluitvorming. Een AI Ethics Board houdt toezicht om accountability te borgen.
- Teams trainen: Ethiektraining wordt verplicht voor alle medewerkers die aan het systeem werken. Ze volgen cursussen over onbewuste vooringenomenheid en eerlijkheid in machine learning en doen mee aan workshops met praktijkdilemma’s.
- Transparantie: Het wervingssysteem bevat explainability-tools. Bij elke aanbeveling geeft het een uitsplitsing van de bepalende factoren—zoals kernkwalificaties of hoe een kandidaat zich verhoudt tot anderen. Zo kunnen HR-managers beslissingen eenvoudig beoordelen.
- Regelmatige updates: Kwartaalaudits analyseren wervingsbeslissingen op bias en passen technieken zoals adversarial debiasing toe om eerlijkheid continu te verbeteren. Ook wordt het systeem geüpdatet met de nieuwste wetgeving rond gelijke behandeling en best practices in de sector.
Dit is een wervingssysteem dat ethisch, eerlijk en transparant is—zelfs wanneer het wordt uitgedaagd.
Uitdagingen rond uitlegbaarheid en vertrouwen
AI-systemen worden vaak gezien als “black boxes”, wat betekent dat hun besluitvormingsproces niet gemakkelijk te doorgronden is. Dat maakt het lastig om problemen te signaleren of vertrouwen op te bouwen. Als je als arts op een AI-tool vertrouwt of als patiënt door een beslissing wordt geraakt, wil je antwoorden, geen vraagtekens. De oplossing is uitlegbaarheid. Hier zijn vier strategieën om AI-systemen transparanter en betrouwbaarder te maken:
- Gebruik explainable AI (XAI)-tools: Deze tools helpen te ontrafelen hoe AI tot conclusies komt. Technieken zoals LIME of SHAP kunnen bijvoorbeeld laten zien welke factoren een specifieke beslissing hebben beïnvloed, waardoor de redenering van het systeem toegankelijker wordt.
- Wijzigingen in data bijhouden en documenteren: Door elke wijziging te documenteren—welke data is toegevoegd, verwijderd of aangepast—kun je herleiden hoe updates de modelprestaties beïnvloeden.
- Regelmatig nauwkeurigheid verifiëren: Neem AI niet klakkeloos aan. Vergelijk de outputs met de brondata en laat waar mogelijk menselijke experts meebeoordelen. Regelmatige audits zorgen dat het systeem scherp en onbevooroordeeld blijft. Vertrouw, maar verifieer.
- Continu testen en monitoren: AI is geen “set it and forget it”-tool. Veelvuldig testen met diverse inputs helpt fouten vroeg te vangen, en realtime monitoring zorgt voor consistente prestaties in verschillende scenario’s.
Kijk hoe een ziekenhuis vertrouwen opbouwt in een AI-dermatologietool—een systeem dat beeldherkenning gebruikt om mogelijke huidaandoeningen te identificeren.
- XAI-tools: Het ziekenhuis gebruikt LIME, een tool die laat zien welke delen van een huidafbeelding het meest bepalend waren voor de diagnose van de AI, zodat artsen de redenering begrijpen en erop kunnen vertrouwen.
- Wijzigingen in data bijhouden: Een data lineage-tool logt alle updates aan de trainingsdataset, zoals nieuw toegevoegde of verwijderde afbeeldingen. Zo kan het ziekenhuis volgen hoe deze wijzigingen de nauwkeurigheid van de AI in de tijd beïnvloeden.
- Nauwkeurigheid verifiëren: Elke maand beoordelen dermatologen een willekeurige steekproef van AI-diagnoses, die ze vergelijken met de oorspronkelijke patiëntdata en hun eigen deskundige mening. Doel: borgen dat het systeem hoge standaarden voor nauwkeurigheid en eerlijkheid blijft halen.
- Regelmatig testen en monitoren: Het IT-team voert wekelijks tests uit met diverse afbeeldingen, en checkt de prestaties van de AI bij verschillende huidtypes en aandoeningen. Ze monitoren ook realtime op ongebruikelijke patronen, zodat issues worden verholpen voordat ze escaleren.
Deze AI-tool is niet alleen slim, maar ook uitlegbaar en betrouwbaar. Artsen begrijpen de beslissingen, patiënten voelen zich zeker over hun zorg, en het ziekenhuis borgt eerlijke en nauwkeurige technologie.
Conclusie
Nu AI een groter deel van ons leven wordt, is het belangrijker dan ooit om het veilig te houden. Waarom? Omdat dezelfde kracht die AI aandrijft, het ook tot doelwit maakt. Dreigingen zoals adversarial aanvallen, datavergiftiging en modeldiefstal kunnen de werking van AI ernstig verstoren.
Hoe verdedigen we AI? We hebben geleerd dat er geen one-size-fits-alloplossing is. Technieken zoals adversarial training, regelmatige audits en gelaagde waarborgen kunnen risico’s verkleinen en je systemen robuuster maken.
Dan is er nog generatieve AI. Large language models bieden enorme kansen, maar introduceren ook nieuwe kwetsbaarheden. Van misleidende content produceren tot gemanipuleerd worden om schadelijke outputs te geven: deze tools vragen om zorgvuldige controle. In het artikel How to Build Guardrails for Large Language Models worden veiligheidsmaatregelen verkend om te zorgen dat LLM’s zich gedragen zoals het hoort.
Ethiek en transparantie zijn niet-onderhandelbaar. AI-systemen moeten eerlijk, uitlegbaar en betrouwbaar zijn. Vooroordelen en misbruik ondermijnen vertrouwen—en vertrouwen is alles in de techgedreven wereld van vandaag. Mensen gebruiken niet wat ze niet vertrouwen.
Tot slot is vooroplopen essentieel. AI-dreigingen blijven zich ontwikkelen. Bedrijven moeten hun beveiligingsstrategieën regelmatig updaten en gelijke pas houden met nieuwe risico’s om beschermd te blijven.De sleutel is proactief en waakzaam te zijn, en je te committeren aan ethiek en transparantie. Zo kunnen bedrijven vertrouwen opbouwen en maximaal profiteren van de voordelen van AI.



 Adel Nehme · 15 min
AI ontwikkelt zich zo snel dat bijblijven met de beveiligingsuitdagingen voelt als proberen een vliegtuig te repareren terwijl het in de lucht is. Naarmate systemen slimmer worden en dieper in dagelijkse bedrijfsprocessen worden ingebed, worden ze ook kwetsbaarder voor nieuwe soorten dreigingen.
Ik heb dit van dichtbij meegemaakt in mijn werk. Ik heb vaak beveiligingslekken ontdekt in bedrijfsprocessen waardoor iemand toegang had kunnen krijgen tot gevoelige informatie die ze niet mochten zien, zeker wanneer AI-oplossingen gehaast werden geïmplementeerd zonder de juiste beveiligingsmaatregelen.
Daar gaat dit artikel over: de risico's, uitdagingen en best practices om AI veilig te houden. AI groeit zo snel, en als we de kwetsbaarheden niet voorblijven, riskeren we het vertrouwen en de voordelen die het biedt te verliezen.
Wil je dit onderwerp uitgebreider bestuderen, bekijk dan zeker de cursus AI Security and Risk Management.
Nieuwe AI-beveiligingsuitdagingen
AI draait op data. En hoe meer data je AI nodig heeft, hoe groter het doelwit. Hackers weten dit. Stel je een ziekenhuis voor dat AI gebruikt om gezondheidsrisico's van patiënten te voorspellen. Klinkt goed, totdat iemand het systeem hackt. Plotseling liggen privé-patiëntendossiers te grabbel op het dark web, of erger nog: medische data wordt aangepast, wat kan leiden tot schadelijke beslissingen. Het versleutelen van gevoelige data en het hebben van back-ups is essentieel, maar veel bedrijven zijn zo gericht op innovatie dat ze deze basis vergeten.
En hackers stelen trouwens niet alleen data. Ze kunnen ook met AI-modellen zelf knoeien. Denk aan een zelfrijdende auto die wordt misleid om een stopbord voor een snelheidslimietbord aan te zien. Dit soort aanval heet een data poisoning-aanval, waarbij hackers slechte data in het systeem voeren om het besluitvormingsproces te corrumperen. In de volgende sectie gaan we hier dieper op in.
Prompt-injectieaanvallen zijn ook een ander type aanval. Dit zijn subtiele manipulaties die een AI verleiden om iets te zeggen—of te doen—wat niet de bedoeling is. We hebben een fantastisch artikel over prompt-injectie, dus we gaan in dit artikel niet in veel detail, maar het is zeker de moeite waard om te lezen.
Ironisch genoeg gebruiken hackers ook AI om te hacken. Dit is waar cybersecurity een race tegen de klok wordt—hackers innoveren, en securityteams moeten net zo snel reageren. Tools zoals anomaliedetectie kunnen helpen, maar ze zijn niet waterdicht.
Ken je de uitdrukking: "Een ketting is zo sterk als de zwakste schakel"? Dit geldt volledig voor AI. Bedrijven integreren vaak kant-en-klare AI-tools in hun systemen. Maar wat als een van die tools wordt gecompromitteerd? Stel je een populaire chatbot voor die door honderden bedrijven wordt gebruikt en gehackt wordt. Dan lopen honderden bedrijven—en al hun klantgegevens—risico. Het is een digitaal domino-effect.
Tot slot is er de kenniskloof. De adoptie van AI stijgt, maar cybersecurity voor AI loopt nog achter.
AI-beveiligingsdreigingen
AI-systemen worden geconfronteerd met serieuze beveiligingsdreigingen die hun werking en betrouwbaarheid kunnen ondermijnen. Laten we de belangrijkste dreigingen bekijken.
Adversarial attacks
Adversarial attacks misleiden AI-systemen door kleine, sluwe wijzigingen aan te brengen in de input die de AI verwerkt. Deze veranderingen zijn zo subtiel dat mensen ze meestal niet opmerken, maar ze kunnen de AI compleet in de war brengen zodat die de verkeerde beslissing neemt.
Bijvoorbeeld:
Voor deze aanvallen hoeft de aanvaller niet te weten hoe de AI intern werkt, wat nog een reden is waarom ze zo lastig te detecteren en te stoppen zijn.
Laten we nu naar enkele praktijkvoorbeelden kijken.
Dit diagram laat een adversarial attack zien op een AI-systeem voor medische beeldvorming. De originele röntgenfoto, correct geclassificeerd als "Hoge kans op longkanker", wordt subtiel gewijzigd met adversarial noise, wat resulteert in een foutieve classificatie van "Gezonde longen".
Een aanrader is Adversarial Machine Learning, een vakgebied dat aanvallen bestudeert die kwetsbaarheden in machinelearningmodellen uitbuiten en verdedigingen ontwikkelt om hiertegen te beschermen.
Poisoning-aanvallen
Poisoning-aanvallen richten zich op de trainingsfase van AI-systemen, waarin het model leert beslissingen te nemen. Aanvallers sluizen gecorrumpeerde of misleidende data de trainingsset in, zodat ze de AI kunnen manipuleren om zich verkeerd te gedragen of bevooroordeelde uitkomsten te geven. Deze aanvallen werken omdat ze knoeien met de basis van het leerproces van de AI, vaak zonder duidelijke sporen na te laten dat er iets mis is.
Dit kan inhouden:
Deze subtiele veranderingen kunnen ervoor zorgen dat de AI onder bepaalde omstandigheden faalt of zich op manieren gedraagt die de aanvaller ten goede komen. Omdat de aanval tijdens de training plaatsvindt, is die lastig te ontdekken zodra het model is uitgerold.
Laten we naar enkele praktijkvoorbeelden kijken:
Dit diagram toont een poisoning-aanval op een AI-systeem dat valse en echte verzekeringsclaims classificeert. In het eerste paneel scheidt het systeem valse (rood) en echte (zwart) claims correct met een schone trainingsdataset. In het tweede paneel verschuift kwaadaardig verkeerd gelabelde data (“gif”) de beslissingsgrens, waardoor valse claims als echt worden geclassificeerd en de betrouwbaarheid en veiligheid van het systeem in het geding komt.
Model extraction-aanvallen
Bij een model extraction-aanval achterhaalt een aanvaller hoe een AI-model werkt door het te reverse-engineeren. Ze gebruiken de inputs en outputs die ze verzamelen om het ontwerp en gedrag van het systeem te kopiëren.
Zodra ze een replica van het model hebben gebouwd, kunnen ze:
Als het gestolen model bijvoorbeeld is getraind op privé-klantgegevens, zou de aanvaller persoonlijke details over die klanten kunnen voorspellen of een aangepaste versie van het model voor eigen gebruik kunnen maken.
Laten we naar enkele praktijkvoorbeelden kijken:
Dit diagram illustreert een model extraction-aanval, waarbij een aanvaller met een slachtoffer-AI-model interageert door queries te sturen en de voorspellingen te verzamelen. De aanvaller gebruikt de verzamelde data om een replicamodel te trainen en zo uiteindelijk een gestolen versie van het oorspronkelijke systeem te reconstrueren.
AI-beveiligingsverdedigingen
We hebben in eerdere secties genoemd dat, naarmate AI gebruikelijker wordt, het belangrijk is om sterke beveiligingsmaatregelen te treffen om aanvallen te voorkomen. Laten we enkele effectieve manieren bespreken om AI veiliger te maken.
Adversarial training
Deze methode houdt in dat je modellen leert om lastige, gemanipuleerde inputs (zogenaamde adversarial examples) te herkennen en ermee om te gaan. Wanneer je je model met deze voorbeelden traint, wordt het beter bestand tegen bepaalde soorten aanvallen.
Defensive distillation
LLM-distillatie houdt in dat je een tweede model traint om het gedrag van het oorspronkelijke model na te bootsen, met als doel het lastiger te maken voor aanvallers om te manipuleren.
Inputvalidatie en -sanitatie
Zeker stellen dat de data die een AI-systeem binnenkomt schoon en veilig is, is cruciaal om het te beschermen tegen kwaadaardige inputs.
Ensemble-methoden
Het gebruik van meerdere verschillende AI-modellen samen (een ensemble) kan systemen veiliger maken. Zelfs als één model wordt aangevallen, kunnen de andere als back-up dienen.
Explainable AI (XAI)
AI-systemen uitlegbaar maken helpt mensen te begrijpen hoe ze werken en eventuele kwetsbaarheden of ongewoon gedrag te detecteren. Je kunt dit onderwerp uitgebreider verkennen in de cursus Explainable AI in Python.
Regelmatige security-audits
AI-systemen regelmatig op zwaktes controleren helpt problemen vroegtijdig te ontdekken en zorgt dat ze op termijn veilig blijven.
Met deze strategieën worden AI-systemen veiliger en beter beschermd tegen aanvallen. Maar hier is het punt—AI-beveiliging is geen "set it and forget it"-verhaal. Het is een continu proces.
Naarmate er nieuwe dreigingen opduiken—en geloof me, die komen er altijd—moeten bedrijven scherp blijven. Dat betekent voortdurend monitoren op kwetsbaarheden, systemen updaten en verdedigingen verbeteren.
Methode
Hoe het werkt
Waarom het helpt
Nadelen
Adversarial training
Maak voorbeelden van gemanipuleerde data en neem die op in de training van de AI.
Verbetert de robuustheid tegen adversarial aanvallen die het systeem proberen te misleiden.
Kan de nauwkeurigheid van de AI op normale (schone) data licht verlagen.
Defensive distillation
Train een secundair model om het gedrag van het oorspronkelijke model na te bootsen en het beslisproces te verzachten.
Maakt het moeilijker voor aanvallers om zwaktes in het model uit te buiten.
Vereist veel rekenkracht, vooral bij grote modellen.
Inputvalidatie & -sanitatie
Valideer dat inputs het juiste formaat hebben, binnen verwachte bereiken vallen en geen schadelijke elementen bevatten.
Voorkomt datavergiftiging en zorgt voor een soepele werking van het AI-systeem.
Vereist zorgvuldige implementatie in meerdere stappen.
Ensemble-methoden
Combineer voorspellingen van meerdere modellen om beslissingen te nemen.
Het is moeilijker voor aanvallers om alle modellen tegelijkertijd te compromitteren.
Vereist meer rekenbronnen om meerdere modellen te beheren en te onderhouden.
Explainable AI (XAI)
Gebruik tools zoals LIME, SHAP of attention-mechanismen om AI-beslissingen uit te leggen.
Vergroot het vertrouwen en maakt het makkelijker om problemen zoals vooringenomenheid of ongebruikelijk gedrag te identificeren en op te lossen.
Eenvoudigere, verklaarbare modellen presteren mogelijk minder goed dan complexe modellen.
Regelmatige security-audits
Voer kwetsbaarheidsanalyses, penetratietests en code-reviews uit om zwaktes te identificeren.
Spoort potentiële beveiligingslekken op en zorgt voor naleving van regelgeving.
Kan veel middelen vergen, afhankelijk van de complexiteit van het systeem.
Nieuwe trends in AI-beveiliging
In deze sectie kijken we naar nieuwe trends die AI-systemen veilig, nauwkeurig en betrouwbaar houden.
AI-modellen en dataintegriteit beschermen
Laten we eerst bespreken waarom het zo belangrijk is om AI-modellen en data te beschermen.
Hoe houd je je AI dan daadwerkelijk veilig? Dit zijn enkele kernstrategieën:
Laten we dit concreet maken met een scenario uit de praktijk. Stel je een grote internationale bank voor die een AI-model heeft ontwikkeld om frauduleuze transacties te detecteren. Het systeem verwerkt dagelijks miljoenen transacties, spoort verdachte patronen op en markeert fraude.
De bank heeft 50 miljoen dollar en drie jaar in dit systeem geïnvesteerd. Als het wordt gestolen, kunnen concurrenten het gebruiken zonder een cent te investeren, waardoor de bank haar voorsprong verliest.
Dit model verwerkt gevoelige financiële data van miljoenen klanten. Een datalek kan deze informatie blootleggen en leiden tot enorme boetes onder wetten zoals de AVG.
Als hackers tijdens de training nepdata injecteren, kunnen ze de AI leren bepaalde fraudepatronen te missen, waardoor de bank kwetsbaar blijft.
Geavanceerde aanvallers zouden zelfs privégegevens van klanten uit de outputs van het model kunnen afleiden.
Hoe beschermt de bank dit?
Dit resulteert in een veiliger, betrouwbaarder AI-systeem dat klantdata beschermt en zijn belofte om fraude effectief op te sporen waarmaakt. Een win-win voor de bank en haar klanten.
Verdedigen tegen ontwijkings- en vergiftigingsaanvallen
Stel, je beheert een hoogbeveiligde faciliteit die op gezichtsherkenning vertrouwt om alles veilig te houden. We weten echter dat AI-systemen kwetsbaar zijn voor aanvallen, zoals adversarial inputs of vergiftigde trainingsdata. Hackers kunnen het systeem manipuleren om binnen te komen.
Dit zijn de vier belangrijkste verdedigingen die aanvallers kunnen stoppen:
Het systeem is niet alleen slim, maar ook voorzichtig. Elke input moet bewijzen dat die legitiem is voordat die verder mag.
AI-toeleveringsketens beveiligen
AI beveiligen draait om het beheren van dataintegriteit, het beschermen van eigen modellen en zorgen dat alles goed samenwerkt met je bestaande cybersecurity. Voeg daar de noodzaak aan toe om in te spelen op veranderende dreigingen, regelgeving, ethiek en kwetsbaarheden in de toeleveringsketen. Hier zijn enkele strategieën om de AI-levenscyclus te beveiligen:
Hier is een praktijkvoorbeeld. Neem een zorgorganisatie die een AI-ondersteunde diagnostische tool ontwikkelt. Hun toeleveringsketen omvat:
Hoe beveiligen ze deze keten?
Zo ontstaat een veilige AI-toeleveringsketen die ervoor zorgt dat hun diagnostische tool accuraat, betrouwbaar en conform de industrienormen is.
Omgaan met ethische risico's
AI is krachtig, maar die kracht kan gevaarlijk zijn in de verkeerde handen. Als een AI-systeem wordt gehackt of slecht is ontworpen, kan dat leiden tot bevooroordeelde beslissingen, onethische uitkomsten of zelfs misbruik. Dat is een groot probleem, zeker wanneer AI beslissingen neemt die echte levens raken—zoals bij werving, leningen of gezondheidszorg.
Hoe maken we AI-systemen ethischer en veerkrachtiger? Vier kernstappen:
Een praktijkvoorbeeld: een groot techbedrijf gebruikt een AI-gestuurd wervingssysteem. Hoe houden ze dat ethisch?
Dit is een wervingssysteem dat ethisch, eerlijk en transparant is—zelfs wanneer het wordt uitgedaagd.
Uitdagingen rond uitlegbaarheid en vertrouwen
AI-systemen worden vaak gezien als “black boxes”, wat betekent dat hun besluitvormingsproces niet gemakkelijk te doorgronden is. Dat maakt het lastig om problemen te signaleren of vertrouwen op te bouwen. Als je als arts op een AI-tool vertrouwt of als patiënt door een beslissing wordt geraakt, wil je antwoorden, geen vraagtekens. De oplossing is uitlegbaarheid. Hier zijn vier strategieën om AI-systemen transparanter en betrouwbaarder te maken:
Kijk hoe een ziekenhuis vertrouwen opbouwt in een AI-dermatologietool—een systeem dat beeldherkenning gebruikt om mogelijke huidaandoeningen te identificeren.
Deze AI-tool is niet alleen slim, maar ook uitlegbaar en betrouwbaar. Artsen begrijpen de beslissingen, patiënten voelen zich zeker over hun zorg, en het ziekenhuis borgt eerlijke en nauwkeurige technologie.
Conclusie
Nu AI een groter deel van ons leven wordt, is het belangrijker dan ooit om het veilig te houden. Waarom? Omdat dezelfde kracht die AI aandrijft, het ook tot doelwit maakt. Dreigingen zoals adversarial aanvallen, datavergiftiging en modeldiefstal kunnen de werking van AI ernstig verstoren.
Hoe verdedigen we AI? We hebben geleerd dat er geen one-size-fits-alloplossing is. Technieken zoals adversarial training, regelmatige audits en gelaagde waarborgen kunnen risico’s verkleinen en je systemen robuuster maken.
Dan is er nog generatieve AI. Large language models bieden enorme kansen, maar introduceren ook nieuwe kwetsbaarheden. Van misleidende content produceren tot gemanipuleerd worden om schadelijke outputs te geven: deze tools vragen om zorgvuldige controle. In het artikel How to Build Guardrails for Large Language Models worden veiligheidsmaatregelen verkend om te zorgen dat LLM’s zich gedragen zoals het hoort.
Ethiek en transparantie zijn niet-onderhandelbaar. AI-systemen moeten eerlijk, uitlegbaar en betrouwbaar zijn. Vooroordelen en misbruik ondermijnen vertrouwen—en vertrouwen is alles in de techgedreven wereld van vandaag. Mensen gebruiken niet wat ze niet vertrouwen.
Tot slot is vooroplopen essentieel. AI-dreigingen blijven zich ontwikkelen. Bedrijven moeten hun beveiligingsstrategieën regelmatig updaten en gelijke pas houden met nieuwe risico’s om beschermd te blijven.De sleutel is proactief en waakzaam te zijn, en je te committeren aan ethiek en transparantie. Zo kunnen bedrijven vertrouwen opbouwen en maximaal profiteren van de voordelen van AI.