L’IA evolve così in fretta che stare al passo con le sue sfide di sicurezza è come cercare di riparare un aereo mentre è in volo. Man mano che i sistemi diventano più intelligenti e sempre più integrati nei processi aziendali quotidiani, aumentano anche le loro vulnerabilità a nuove tipologie di minacce.
L’ho visto da vicino nel mio lavoro. Mi è capitato spesso di scoprire falle nei processi aziendali che avrebbero potuto consentire l’accesso a informazioni sensibili a chi non avrebbe dovuto averle, soprattutto quando soluzioni di IA venivano implementate in fretta senza adeguate misure di sicurezza.
Di questo parla l’articolo: capire rischi, sfide e buone pratiche per mantenere l’IA al sicuro. L’IA cresce così rapidamente che, se non anticipiamo le vulnerabilità, rischiamo di perdere la fiducia e i benefici che porta con sé.
Se vuoi approfondire l’argomento, ti consiglio di dare un’occhiata al corso AI Security and Risk Management.
Nuove sfide della sicurezza dell’IA
L’IA si basa sui dati. E più dati usa la tua IA, più grande è il bersaglio. Gli hacker lo sanno. Immagina un ospedale che utilizza l’IA per prevedere i rischi per la salute dei pazienti. Ottimo, finché qualcuno non viola il sistema. All’improvviso, cartelle cliniche private finiscono sul dark web o, peggio, i dati medici vengono alterati, con il rischio di decisioni dannose. Cifrare i dati sensibili e avere backup è fondamentale, ma molte aziende, prese dall’innovazione, trascurano queste basi.
E gli hacker non si limitano a rubare dati. Possono intaccare direttamente i modelli di IA. Per esempio, un’auto a guida autonoma indotta a scambiare un cartello di stop per un limite di velocità. Questo tipo di attacco è chiamato attacco di avvelenamento dei dati, in cui gli hacker alimentano il sistema con dati corrotti per compromettere il processo decisionale. Ne parleremo più in dettaglio nella prossima sezione.
Anche gli attacchi di prompt injection sono un’altra tipologia. Sono manipolazioni sottili che ingannano un’IA inducendola a dire—o fare—qualcosa che non dovrebbe. Abbiamo un articolo ottimo sul prompt injection, quindi qui non entreremo troppo nel dettaglio, ma vale sicuramente la pena leggerlo.
Paradossalmente, anche gli hacker usano l’IA per hackerare. È qui che la cybersecurity diventa una corsa contro il tempo: gli hacker innovano e i team di sicurezza devono rispondere con la stessa rapidità. Strumenti come il rilevamento delle anomalie possono aiutare, ma non sono infallibili.
Hai mai sentito il detto “Una catena è forte quanto il suo anello più debole”? Si applica perfettamente all’IA. Le aziende integrano spesso strumenti di IA preconfezionati nei loro sistemi. Ma cosa succede se uno di questi strumenti viene compromesso? Immagina un chatbot popolare usato da centinaia di aziende che viene hackerato. Centinaia di aziende—e tutti i loro dati clienti—finirebbero a rischio. Un effetto domino digitale.
Infine, c’è il gap di competenze. L’adozione dell’IA cresce, ma la sicurezza informatica per l’IA sta ancora rincorrendo.
Minacce alla sicurezza dell’IA
I sistemi di IA affrontano minacce serie che possono comprometterne l’efficacia e l’affidabilità. Vediamo le principali.
Attacchi avversari
Gli attacchi avversari ingannano i sistemi di IA apportando piccole, subdole modifiche agli input che l’IA elabora. Questi cambiamenti sono così sottili che le persone di solito non li notano, ma possono confondere completamente l’IA portandola a decisioni errate.
Per esempio:
- Modificare dettagli minuscoli in un’immagine, come alterare pochi pixel, così da farla identificare male dall’IA.
- Aggiungere un leggero rumore a un file audio, che a noi suona uguale ma porta l’IA a interpretarlo in modo errato.
- Ritoccare la formulazione di una frase per confondere la comprensione dell’IA.
Questi attacchi non richiedono che l’attaccante conosca il funzionamento interno dell’IA, il che li rende ancora più difficili da rilevare e fermare.
Vediamo ora alcuni esempi reali.
- Algoritmo DeepFool: DeepFool è un metodo pensato per apportare modifiche minuscole e quasi invisibili a un input, come un’immagine, per indurre l’IA a classificarla in modo errato. Funziona ritoccando gradualmente l’input finché l’IA sbaglia. Le modifiche sono così lievi che l’occhio umano non le nota.
- Attacchi audio mirati: In questo paper, gli attaccanti hanno creato audio quasi identici agli originali ma che portano un sistema di riconoscimento vocale a sentire parole completamente diverse. Questo metodo ha ingannato il sistema DeepSpeech di Mozilla con un tasso di successo del 100%.
- Manipolazione dell’autopilota Tesla: Keen Labs ha ingannato l’autopilota di Tesla posizionando strategicamente tre adesivi poco appariscenti sulla strada, inducendolo a interpretare male le linee di corsia e potenzialmente a sterzare nella corsia sbagliata. Leggi di più qui.
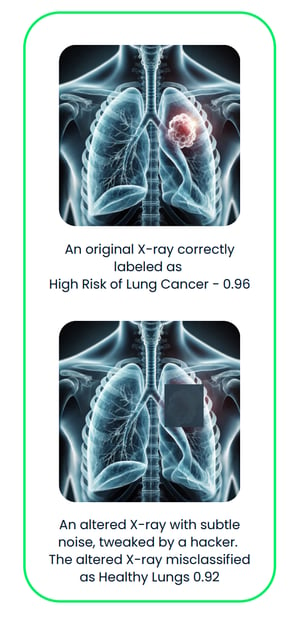
Questo diagramma illustra un attacco avversario su un sistema di IA per imaging medico. La radiografia originale, correttamente classificata come "Alto rischio di cancro ai polmoni", viene alterata in modo sottile con rumore avversario, portando a una classificazione errata come "Polmoni sani".
Un’ottima lettura è Adversarial Machine Learning, un campo che studia gli attacchi che sfruttano le vulnerabilità dei modelli di machine learning e sviluppa difese per proteggerli da queste minacce.
Attacchi di avvelenamento
Gli attacchi di avvelenamento prendono di mira la fase di addestramento dei sistemi di IA, quando il modello impara a prendere decisioni. Gli aggressori inseriscono dati corrotti o fuorvianti nel set di training per manipolare l’IA a comportarsi in modo errato o a favorire esiti distorti. Questi attacchi funzionano perché intaccano le fondamenta del processo di apprendimento dell’IA, spesso senza lasciare segni evidenti che qualcosa non va.
Ciò può includere:
- Cambiare le etichette di alcuni esempi di training, ad esempio etichettare una foto di un cane come se fosse un gatto.
- Aggiungere punti dati falsi pensati per influenzare le decisioni dell’IA in modi specifici.
Queste modifiche sottili possono far fallire l’IA in determinate condizioni o farla agire a vantaggio dell’attaccante. Poiché l’attacco avviene durante l’addestramento, è difficile da individuare una volta che il modello è in produzione.
Ecco alcuni esempi reali:
- Backdoor attacks: Uno studio intitolato “Bypassing Backdoor Detection Algorithms in Deep Learning” ha mostrato come gli aggressori possano nascondere “backdoor” malevole nei modelli di IA. Queste backdoor si attivano solo in condizioni specifiche, come la presenza di un certo pattern in un’immagine. Lo studio ha dimostrato che si possono usare tecniche avanzate per far sembrare i dati avvelenati identici a quelli puliti, eludendo il rilevamento.
- Avvelenamento di dataset su scala web: Nel paper “Poisoning Web-Scale Training Datasets is Practical,” i ricercatori descrivono come i grandi dataset raccolti da internet possano essere avvelenati:
- Split-view data poisoning: Corrompere i dati dopo la raccolta ma prima dell’uso per l’addestramento.
- Frontrunning data poisoning: Manipolare i dati subito prima che vengano aggiunti al dataset.
- Tay, il chatbot di Microsoft: Nel 2016, Microsoft ha lanciato su Twitter un chatbot chiamato Tay. Gli utenti lo hanno manipolato in fretta bombardandolo di contenuti offensivi, inducendolo a pubblicare tweet razzisti e inappropriati. Microsoft ha dovuto chiuderlo poco dopo il lancio. Leggi di più qui.
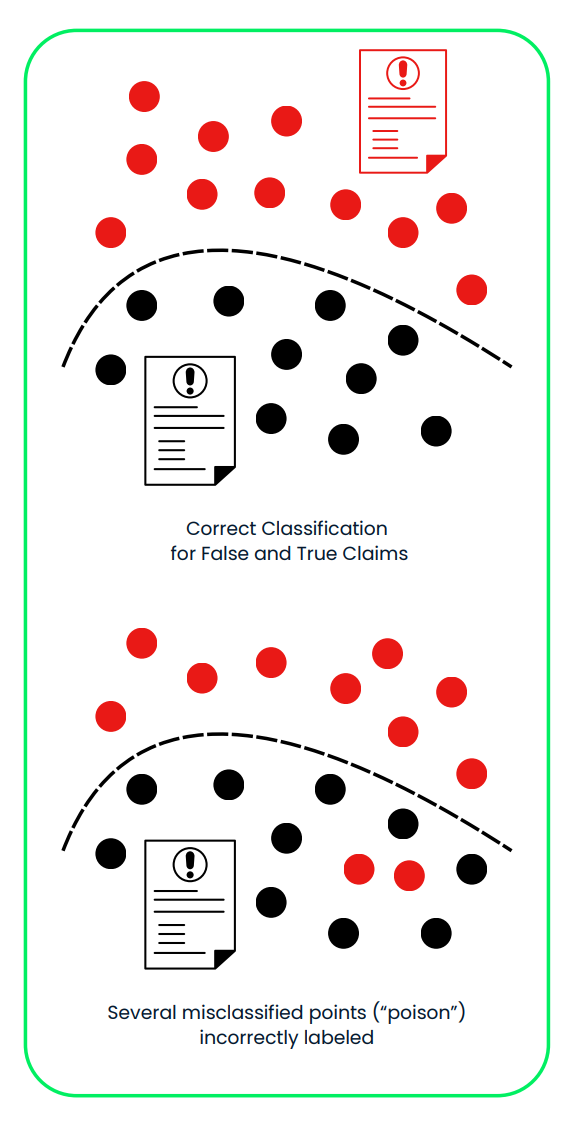
Questo diagramma mostra un attacco di avvelenamento su un sistema di IA usato per classificare richieste di rimborso assicurativo false e vere. Nel primo pannello, il sistema separa correttamente le false (rosso) dalle vere (nero) usando un dataset di training pulito. Nel secondo, dati etichettati in modo malevolo (“veleno”) spostano il confine decisionale, portando a classificare come vere richieste false, compromettendo affidabilità e sicurezza.
Attacchi di estrazione del modello
In un attacco di estrazione, un aggressore capisce come funziona un modello di IA effettuandone il reverse engineering. Usa gli input e gli output raccolti per copiarne progettazione e comportamento.
Una volta creata una replica del modello, può:
- Usarla per fare previsioni, potenzialmente su dati sensibili o privati.
- Rubare informazioni riservate dal modello originale.
- Modificare e riaddestrare il modello per i propri scopi, spesso dannosi.
Ad esempio, se il modello rubato è stato addestrato su dati privati dei clienti, l’aggressore potrebbe prevedere dettagli personali su quei clienti o creare una versione personalizzata del modello per il proprio uso.
Ecco alcuni esempi reali:
- Uno strumento chiamato DeepSniffer mostra come può funzionare questo tipo di attacco. DeepSniffer non ha bisogno di conoscere in anticipo nulla del modello originale. Raccoglie invece indizi da come il modello elabora i dati, ad esempio tracciando le operazioni di memoria durante l’esecuzione. Mette insieme questi indizi per ricostruire la struttura del modello, anche se il sistema tenta di ottimizzare o nascondere i propri processi.
- Mindgard ha dimostrato come componenti critici di un modello linguistico black-box, come ChatGPT 3.5 Turbo di OpenAI, possano essere estratti con un processo a basso costo. Con soli 50 $ di spesa in API, il team ha creato un modello più piccolo—circa 100 volte più piccolo dell’originale—che ha superato ChatGPT in un compito specifico. Questo modello estratto è stato poi usato per potenziare un altro attacco, successivamente lanciato contro lo stesso ChatGPT. L’attacco migliorato ha ottenuto un tasso di successo più alto, salendo all’11%.
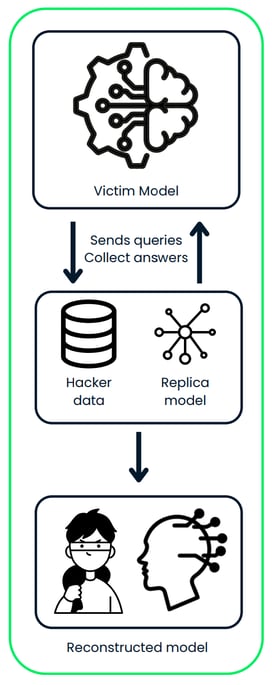
Questo diagramma illustra un attacco di estrazione del modello, in cui un aggressore interagisce con un modello di IA vittima inviando query e raccogliendo le sue previsioni. I dati raccolti vengono usati per addestrare un modello replica, ricostruendo di fatto una versione rubata del sistema originale.
Difese per la sicurezza dell’IA
Abbiamo visto nelle sezioni precedenti che, con la diffusione dell’IA, è importante adottare solide misure di sicurezza per proteggerla dagli attacchi. Vediamo alcune modalità efficaci per rendere l’IA più sicura.
Addestramento avversario
Questo metodo consiste nell’insegnare ai modelli a riconoscere e gestire input subdoli e manipolati (chiamati esempi avversari). Se addestri il modello con questi esempi, diventa più resistente a determinati tipi di attacchi.
- Come funziona: crea esempi di dati manipolati e includili nell’addestramento dell’IA.
- Perché aiuta: rende i sistemi di IA più robusti contro gli attacchi che cercano di ingannarli.
- Svantaggio: può ridurre leggermente l’accuratezza dell’IA su dati normali (puliti).
- Esempi reali:
- Le API Cloud Vision di Google usano l’addestramento avversario per migliorare la resilienza dei modelli di riconoscimento immagini contro input manipolati.
- I modelli di OpenAI incorporano esempi avversari nel processo di training per aumentare la robustezza contro attacchi testuali.
Distillazione difensiva
La distillazione degli LLM prevede l’addestramento di un modello secondario per imitare il comportamento dell’originale con l’obiettivo di renderne più difficile la manipolazione da parte degli attaccanti.
- Come funziona: allena il primo modello, poi usa i suoi output per addestrarne un altro in modo da “smussarne” il processo decisionale.
- Perché aiuta: rende più difficile sfruttarne le debolezze.
- Svantaggio: può richiedere molte risorse di calcolo, soprattutto per modelli grandi.
- Esempi reali:
- Ricercatori dell’Università della California, Berkeley, hanno applicato la distillazione difensiva per migliorare la robustezza delle reti neurali profonde usate nei veicoli autonomi.
- La piattaforma IBM Watson adotta tecniche di distillazione difensiva per proteggere i modelli di elaborazione del linguaggio naturale da attacchi avversari.
Garantire che i dati in ingresso a un sistema di IA siano puliti e sicuri è fondamentale per proteggerlo da input malevoli.
- Come funziona: verifica che gli input abbiano il formato corretto, rientrino negli intervalli attesi e non contengano elementi dannosi.
- Perché aiuta: previene attacchi come l’avvelenamento dei dati e mantiene il sistema di IA stabile.
- Best practice: valida i dati in più fasi: lato utente, lato server e all’interno del sistema di IA stesso.
- Esempi reali:
- I servizi Azure AI di Microsoft implementano una rigorosa validazione degli input per prevenire attacchi di SQL injection sui loro modelli di machine learning.
- Amazon Rekognition utilizza la sanitizzazione degli input per filtrare immagini potenzialmente malevole.
Metodi ensemble
Usare più modelli di IA insieme (un ensemble) può rendere i sistemi più sicuri. Anche se uno viene attaccato, gli altri fanno da “backup”.
- Come funziona: combina le previsioni di più modelli per prendere decisioni.
- Perché aiuta: è più difficile compromettere tutti i modelli contemporaneamente.
- Svantaggio: richiede più risorse di calcolo per gestire più modelli.
- Esempi reali:
- Il sistema di raccomandazione di Netflix usa un ensemble di più modelli di IA per migliorare l’accuratezza e la resilienza contro tentativi di manipolazione.
- I metodi ensemble non sono esclusivi della sicurezza nell’IA: sono usati in generale per creare modelli predittivi più robusti e accurati.
Explainable AI (XAI)
Rendere spiegabili i sistemi di IA aiuta a capirne il funzionamento e a individuare vulnerabilità o comportamenti anomali. Puoi approfondire l’argomento nel corso Explainable AI in Python.
- Come funziona: usa strumenti come LIME, SHAP o meccanismi di attenzione per spiegare le decisioni dell’IA.
- Perché aiuta: aumenta la fiducia nei sistemi di IA e semplifica l’individuazione e la correzione di problemi come i bias.
- Sfida: modelli più semplici e spiegabili possono essere meno potenti di quelli complessi.
- Esempi reali:
- Il programma Explainable AI (XAI) di DARPA mira a sviluppare sistemi di IA più trasparenti per applicazioni militari.
- Il toolkit AI Explainability 360 di IBM fornisce risorse open source per implementare tecniche di IA spiegabile in vari settori.
Audit di sicurezza regolari
Verificare regolarmente i sistemi di IA per individuare debolezze aiuta a intercettare i problemi in anticipo e a mantenere la sicurezza nel tempo.
- Cosa include: assessment di vulnerabilità, penetration test e code review.
- Con che frequenza: esegui audit regolarmente e dopo modifiche significative al sistema.
- Perché aiuta: individua potenziali lacune e assicura la conformità alle normative.
- Esempi reali:
- Facebook effettua audit di sicurezza regolari dei suoi sistemi di moderazione dei contenuti basati su IA per identificare e correggere potenziali vulnerabilità.
- L’AI Act dell’Unione Europea propone audit di sicurezza obbligatori per i sistemi di IA ad alto rischio usati in settori critici.
Usare queste strategie rende i sistemi di IA più sicuri e meglio protetti dagli attacchi. Ma attenzione: la sicurezza dell’IA non è un “imposta e dimentica”. È un processo continuo.
Poiché emergono continuamente nuove minacce—e credimi, succede sempre—le aziende devono restare vigili. Significa monitorare costantemente le vulnerabilità, aggiornare i sistemi e migliorare le difese.
|
Metodo
|
Come funziona
|
Perché aiuta
|
Svantaggi
|
|
Addestramento avversario
|
Crea esempi di dati manipolati e includili nell’addestramento dell’IA.
|
Migliora la robustezza contro attacchi avversari che cercano di ingannare il sistema.
|
Può ridurre leggermente l’accuratezza dell’IA su dati normali (puliti).
|
|
Distillazione difensiva
|
Allena un modello secondario a imitare il comportamento dell’originale, smussandone il processo decisionale.
|
Rende più difficile per gli attaccanti sfruttare le debolezze del modello.
|
Richiede molte risorse di calcolo, soprattutto per modelli grandi.
|
|
Validazione e sanitizzazione degli input
|
Verifica che gli input abbiano il formato corretto, rientrino negli intervalli attesi e non contengano elementi dannosi.
|
Previene l’avvelenamento dei dati e garantisce il regolare funzionamento del sistema di IA.
|
Richiede un’implementazione accurata in più fasi.
|
|
Metodi ensemble
|
Combina le previsioni di più modelli per prendere decisioni.
|
È più difficile per gli attaccanti compromettere tutti i modelli contemporaneamente.
|
Richiede più risorse di calcolo per gestire e mantenere più modelli.
|
|
Explainable AI (XAI)
|
Usa strumenti come LIME, SHAP o meccanismi di attenzione per spiegare le decisioni dell’IA.
|
Aumenta la fiducia e facilita l’individuazione e la correzione di problemi come bias o comportamenti anomali.
|
Modelli più semplici e spiegabili potrebbero non performare quanto quelli complessi.
|
|
Audit di sicurezza regolari
|
Esegui assessment di vulnerabilità, penetration test e code review per individuare debolezze.
|
Individua potenziali lacune di sicurezza e assicura la conformità normativa.
|
Può essere dispendioso in termini di risorse a seconda della complessità del sistema.
|
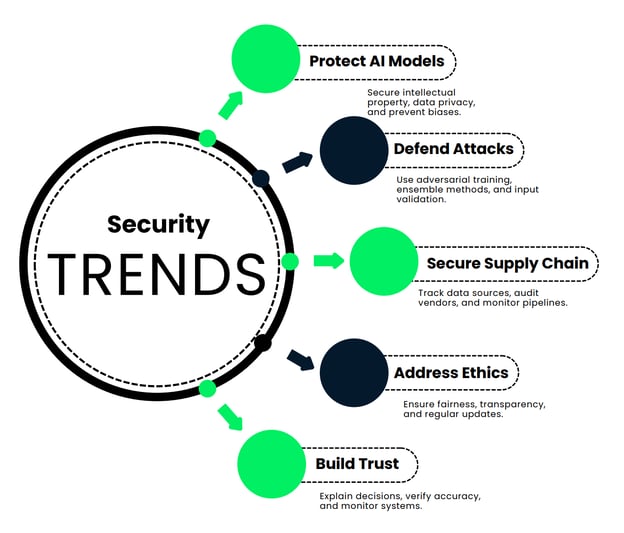
Nuove tendenze nella sicurezza dell’IA
In questa sezione, vediamo le nuove tendenze che mantengono i sistemi di IA sicuri, accurati e affidabili.
Proteggere i modelli di IA e l’integrità dei dati
Prima di tutto, vediamo perché è così importante proteggere modelli e dati di IA.
- Proteggere la proprietà intellettuale: pensa al tempo, al denaro e all’ingegno necessari per creare un modello di IA. Non sono solo algoritmi; sono investimenti enormi. Tenerli al sicuro impedisce ai concorrenti di rubare quel lavoro.
- Mantenere il vantaggio competitivo: se qualcuno ottiene accesso non autorizzato al tuo modello di IA, potrebbe copiarlo e ottenere gli stessi risultati—senza spendere un centesimo in sviluppo.
- Privacy dei dati e conformità: l’IA tratta spesso dati sensibili—informazioni finanziarie, cartelle cliniche, e così via. Se questi dati vengono esposti, ti aspettano multe salate e un duro colpo alla fiducia pubblica. Scopri di più in Introduction to Data Privacy.
- Prevenire l’avvelenamento dei dati: gli hacker possono manomettere i dati di training, insegnando alla tua IA a prendere decisioni sbagliate—per esempio lasciando passare frodi o segnalando come minacce azioni innocue.
- Mitigare gli attacchi di inversione del modello: immagina che gli aggressori possano ricavare dettagli privati dei clienti solo studiando gli output della tua IA. Non sarebbe bello!
- Evitare esiti distorti o non etici: un modello compromesso può portare a decisioni ingiuste o dannose, con danni alla reputazione.
- Proteggere le infrastrutture critiche: poiché l’IA viene usata in sanità, finanza e persino nella sicurezza nazionale, proteggerla non è solo una questione di business—è un tema di sicurezza pubblica.
Come tenere davvero al sicuro la tua IA? Ecco alcune strategie chiave:
- Usa cifratura e anonimizzazione dei dati per proteggere le informazioni sensibili.
- Implementa rigide policy di conservazione dei dati per controllare per quanto tempo le informazioni vengono conservate.
- Effettua audit e monitoraggi di sicurezza regolari per intercettare le vulnerabilità presto.
- Progetta i sistemi secondo i principi di privacy by design, integrando la sicurezza in ogni fase.
- Usa tecniche avanzate come il federated learning per proteggere il modello e i dati senza spostare informazioni sensibili.
Facciamo un esempio reale. Immagina una grande banca internazionale che ha sviluppato un modello di IA per individuare transazioni fraudolente. Questo sistema gestisce milioni di transazioni al giorno, individuando schemi sospetti e segnalando le frodi.
La banca ha speso 50 milioni di dollari e tre anni per costruire questo sistema. Se venisse rubato, i concorrenti potrebbero usarlo senza investire nulla, facendole perdere il vantaggio competitivo.
Questo modello elabora dati finanziari sensibili di milioni di clienti. Una violazione potrebbe esporli, portando a multe enormi ai sensi di normative come il GDPR.
Se gli hacker inserissero dati falsi durante l’addestramento, potrebbero insegnare all’IA a non riconoscere determinati schemi di frode, lasciando la banca vulnerabile.
Attaccanti sofisticati potrebbero persino ricavare dettagli privati dei clienti dagli output del modello.
Come si protegge la banca?
- Usa cifratura end-to-end per proteggere i dati.
- L’accesso al modello richiede autenticazione a più fattori ed è limitato da controlli basati sui ruoli.
- Esegue audit e penetration test regolari per individuare debolezze.
- I dati dei clienti usati per l’addestramento sono completamente anonimizzati.
- La banca monitora costantemente le prestazioni del modello per intercettare qualsiasi anomalia.
Il risultato è un sistema di IA più sicuro e affidabile che protegge i dati dei clienti e mantiene la promessa di individuare le frodi in modo efficace. Un vantaggio per la banca e per i suoi clienti.
Difendersi da attacchi di elusione e avvelenamento
Immagina di gestire una struttura ad alta sicurezza che si affida al riconoscimento facciale. Abbiamo però imparato che i sistemi di IA sono vulnerabili ad attacchi, come input avversari o dati di training avvelenati. Gli hacker possono manipolare il sistema per farsi aprire le porte.
Vediamo quattro difese chiave che possono fermare gli attaccanti:
- Addestramento avversario: è come insegnare al modello delle mosse di autodifesa. Includi esempi di input manipolati—immagini con ritocchi sottili progettati per ingannare l’IA—e addestralo a riconoscerli. Immagina un sistema di riconoscimento facciale che non veda solo il volto, ma anche quelle alterazioni “pixel-perfect” che gli attaccanti cercano di inserire. La tua IA diventa più furba contro questi attacchi, imparando da questi esempi per non farsi ingannare nella realtà.
- Metodi ensemble: ne abbiamo già parlato. Invece di affidarti a un solo sistema, usi una “squadra” di modelli. Ognuno elabora l’input in modo indipendente e i risultati vengono combinati con un meccanismo di voto. Gli attaccanti non possono ingannare un solo modello: devono raggirare l’intera squadra. Buona fortuna.
- Controlli regolari dei dati: nessuno ama “fare pulizia”, ma è una manutenzione essenziale per la tua IA. Audit settimanali garantiscono che i dati di training siano privi di duplicati, etichette errate o input malevoli subdoli. E mantenere il dataset aggiornato con immagini verificate aiuta il sistema a restare in forma.
- Validazione degli input: prima che un’immagine si avvicini alla tua IA, passa da un checkpoint di sicurezza. Ecco cosa succede:
- Si controllano formato e dimensione.
- I metadati vengono analizzati per segni di manomissione.
- Si segnalano pattern avversari noti.
- Il rilevamento anomalie individua qualsiasi cosa insolita.
Il sistema non è solo intelligente: è prudente. Ogni input deve dimostrare di essere legittimo prima di procedere.
Mettere in sicurezza le supply chain dell’IA
Mettere in sicurezza l’IA significa gestire l’integrità dei dati, proteggere i modelli proprietari e assicurare l’integrazione con la tua infrastruttura di cybersecurity. A questo si aggiungono minacce in evoluzione, conformità normativa, etica e vulnerabilità della supply chain. Ecco alcune strategie per mettere in sicurezza il ciclo di vita dell’IA:
- Traccia le fonti: ogni dato e ogni modello del tuo sistema di IA deve avere una chiara origine. Documenta da dove proviene, che sia un ospedale affidabile, un’istituzione di ricerca o un fornitore specializzato. Perché? Perché conoscere la fonte è il primo passo per poterti fidare.
- Audita i fornitori: i provider terzi sono fondamentali, ma anche potenziali anelli deboli. Conduci audit regolari per assicurarti che rispettino i tuoi standard di sicurezza, che si tratti di conformità HIPAA, protocolli di anonimizzazione dei dati o certificazioni ISO.
- Usa strumenti di tracciamento dei dati: i tuoi dati non sono statici. Evolvono nel tempo e a volte quell’evoluzione include errori o modifiche malevole. Strumenti come il monitoraggio automatico dei dati possono tracciare i cambiamenti e segnalare variazioni inattese, mantenendo i dataset puliti e accurati.
- Monitora le pipeline di dati: i dati scorrono dalla fonte al modello attraverso pipeline complesse, e qualsiasi intoppo lungo il percorso può creare problemi. Dashboard in tempo reale aiutano a cogliere irregolarità, come cali improvvisi nei volumi o cambiamenti inattesi delle feature.
Ecco un esempio reale. Prendiamo un’azienda sanitaria che sviluppa uno strumento diagnostico basato su IA. La sua supply chain include:
- Dati dei pazienti da ospedali partner.
- Dataset di imaging medico da un istituto di ricerca di alto livello.
- Modelli pre-addestrati da un fornitore specializzato di IA.
Come mettono in sicurezza questa pipeline?
- Tracciabilità delle fonti: ogni dataset e modello è documentato meticolosamente per garantirne la tracciabilità.
- Audit dei fornitori: effettuano verifiche trimestrali per la conformità HIPAA e assicurano l’anonimizzazione dei dati. I fornitori svolgono valutazioni annuali di sicurezza per mantenere le certificazioni.
- Strumenti di data lineage: usano strumenti come Anomalo per individuare variazioni inattese nella demografia dei pazienti o nei dati di imaging.
- Monitoraggio della pipeline: dashboard in tempo reale in Looker tengono sotto controllo i flussi di dati, segnalando immediatamente eventuali irregolarità.
In questo modo, ottengono una supply chain dell’IA sicura che assicura che lo strumento diagnostico sia accurato, affidabile e conforme agli standard di settore.
Affrontare i rischi etici
L’IA è potente, ma nelle mani sbagliate può essere pericolosa. Se un sistema di IA viene violato o progettato male, può produrre decisioni distorte, esiti non etici o addirittura abusi. È un problema serio, soprattutto quando l’IA prende decisioni che incidono sulle persone—come assunzioni, prestiti o sanità.
Come rendere i sistemi di IA più etici e resilienti? Ecco quattro passaggi chiave:
- Sviluppa regole e framework chiari: parti da solide fondamenta. Redigi policy che definiscano cosa significano equità ed etica per il tuo sistema.
- Forma i team di IA sull’etica: non puoi aspettarti che l’IA agisca in modo etico se chi la costruisce non è attrezzato per riflettere criticamente su questi temi. La formazione aiuta i team a riconoscere e gestire bias inconsci, comprendere l’equità e valutare l’impatto sociale del loro lavoro.
- Rendi trasparenti le decisioni dell’IA: trasparenza significa progettare sistemi che sappiano spiegare le proprie decisioni—quali fattori sono stati considerati, come sono stati confrontati i candidati e dove potrebbero esserci criticità. La trasparenza costruisce fiducia e responsabilità.
- Aggiorna regolarmente i sistemi di IA: l’IA non è “imposta e dimentica”. Audit regolari aiutano a identificare e ridurre i bias, garantire l’equità e mantenere la conformità agli standard e ai requisiti legali più recenti. L’equità non è statica: è un processo continuo.
Esempio reale: un’ampia azienda tech usa un sistema di selezione del personale basato su IA. Come lo mantiene etico?
- Regole chiare: creano una AI Ethics Policy che definisce principi per assunzioni imparziali, dalla raccolta dati al processo decisionale. Un AI Ethics Board supervisiona queste policy per garantire responsabilità.
- Formazione dei team: la formazione etica diventa obbligatoria per tutti i dipendenti che lavorano sul sistema. Seguono corsi su bias inconsci ed equità nel machine learning e partecipano a workshop su dilemmi reali.
- Trasparenza: il sistema di selezione include strumenti di spiegabilità. Per ogni raccomandazione fornisce un riepilogo dei fattori che hanno influenzato la decisione—come qualifiche chiave o confronti tra candidati—così che gli HR possano rivederle facilmente.
- Aggiornamenti regolari: audit trimestrali analizzano le decisioni di assunzione alla ricerca di bias e applicano tecniche come l’adversarial debiasing per migliorare continuamente l’equità. Il sistema viene aggiornato con le ultime norme sul lavoro e le best practice di settore.
Risultato: un sistema di selezione etico, equo e trasparente, anche in caso di compromissioni potenziali.
Sfide di spiegabilità e fiducia
I sistemi di IA sono spesso visti come “scatole nere”, cioè il loro processo decisionale non è facile da capire. Questo rende difficile individuare problemi o costruire fiducia. Se sei un medico che si affida a uno strumento di IA o un paziente influenzato dalle sue decisioni, vuoi risposte, non punti interrogativi. La soluzione è la spiegabilità. Ecco quattro strategie per rendere i sistemi di IA più trasparenti e affidabili:
- Usa strumenti di XAI: questi strumenti aiutano a demistificare come l’IA arriva alle sue conclusioni. Tecniche come LIME o SHAP possono mostrare quali fattori hanno influenzato una decisione specifica, rendendo più accessibile il ragionamento del sistema.
- Traccia e documenta le modifiche ai dati: documentare ogni cambiamento—quali dati sono stati aggiunti, rimossi o modificati—consente di tracciare l’impatto di questi aggiornamenti sulle prestazioni del modello.
- Verifica regolarmente l’accuratezza: non prendere l’IA per oro colato. Confronta gli output con i dati originali e, dove possibile, coinvolgi esperti umani. Audit regolari mantengono il sistema accurato e imparziale. Fidati, ma verifica.
- Testa e monitora continuamente: l’IA non è uno strumento “imposta e dimentica”. Test frequenti con input diversificati aiutano a intercettare presto gli errori e il monitoraggio in tempo reale assicura prestazioni costanti in scenari diversi.
Vediamo come un ospedale costruisce fiducia in uno strumento di diagnosi dermatologica basato su IA—un sistema che usa il riconoscimento di immagini per identificare possibili condizioni della pelle.
- Strumenti XAI: l’ospedale usa LIME, che evidenzia le parti dell’immagine cutanea più influenti nella diagnosi dell’IA, così i medici possono comprenderne e fidarsi del ragionamento.
- Tracciamento delle modifiche ai dati: uno strumento di data lineage registra tutti gli aggiornamenti al dataset di training, come immagini aggiunte o rimosse. Questo consente di tracciare come tali cambiamenti influenzano l’accuratezza nel tempo.
- Verifica dell’accuratezza: ogni mese, i dermatologi rivedono un campione casuale di diagnosi dell’IA, confrontandole con i dati originali dei pazienti e con le loro opinioni di esperti. L’obiettivo è mantenere alti standard di accuratezza ed equità.
- Test e monitoraggio regolari: il team IT effettua test settimanali con immagini diversificate, verificando le prestazioni su diversi tipi di pelle e condizioni. Monitorano anche pattern insoliti in tempo reale, così da risolvere i problemi prima che peggiorino.
Questo strumento di IA non è solo intelligente, ma anche spiegabile e affidabile. I medici comprendono le sue decisioni, i pazienti si sentono sicuri e l’ospedale garantisce che la tecnologia funzioni in modo equo e accurato.
Conclusione
Man mano che l’IA entra sempre più nelle nostre vite, mantenerla sicura è più critico che mai. Perché? Perché lo stesso potere che ne alimenta le capacità la rende anche un bersaglio. Minacce come attacchi avversari, avvelenamento dei dati e furto di modelli possono compromettere seriamente il funzionamento dell’IA.
Come difendere l’IA? Abbiamo visto che non esiste una soluzione unica. Tecniche come l’addestramento avversario, gli audit regolari e le difese a strati possono ridurre i rischi e rendere i sistemi più robusti.
Poi c’è l’IA generativa. I large language model offrono opportunità incredibili, ma introducono anche nuove vulnerabilità. Dalla generazione di contenuti fuorvianti alla manipolazione per ottenere output dannosi, questi strumenti richiedono supervisione attenta. Nell’articolo How to Build Guardrails for Large Language Models trovi misure di sicurezza per assicurare che gli LLM si comportino come dovrebbero.
Etica e trasparenza sono imprescindibili. I sistemi di IA devono essere equi, spiegabili e affidabili. Bias e abusi erodono la fiducia—e oggi la fiducia è tutto. Le persone non usano ciò di cui non si fidano.
Infine, restare avanti è fondamentale. Le minacce all’IA evolvono continuamente. Le aziende devono aggiornare regolarmente le strategie di sicurezza, tenendo il passo con i nuovi rischi per restare protette. La chiave è essere proattivi, vigili e impegnati su etica e trasparenza: così le aziende possono costruire fiducia e sfruttare al massimo i benefici dell’IA.



 Abid Ali Awan · 15 min


 Tim Lu · 12 min
L’IA evolve così in fretta che stare al passo con le sue sfide di sicurezza è come cercare di riparare un aereo mentre è in volo. Man mano che i sistemi diventano più intelligenti e sempre più integrati nei processi aziendali quotidiani, aumentano anche le loro vulnerabilità a nuove tipologie di minacce.
L’ho visto da vicino nel mio lavoro. Mi è capitato spesso di scoprire falle nei processi aziendali che avrebbero potuto consentire l’accesso a informazioni sensibili a chi non avrebbe dovuto averle, soprattutto quando soluzioni di IA venivano implementate in fretta senza adeguate misure di sicurezza.
Di questo parla l’articolo: capire rischi, sfide e buone pratiche per mantenere l’IA al sicuro. L’IA cresce così rapidamente che, se non anticipiamo le vulnerabilità, rischiamo di perdere la fiducia e i benefici che porta con sé.
Se vuoi approfondire l’argomento, ti consiglio di dare un’occhiata al corso AI Security and Risk Management.
Nuove sfide della sicurezza dell’IA
L’IA si basa sui dati. E più dati usa la tua IA, più grande è il bersaglio. Gli hacker lo sanno. Immagina un ospedale che utilizza l’IA per prevedere i rischi per la salute dei pazienti. Ottimo, finché qualcuno non viola il sistema. All’improvviso, cartelle cliniche private finiscono sul dark web o, peggio, i dati medici vengono alterati, con il rischio di decisioni dannose. Cifrare i dati sensibili e avere backup è fondamentale, ma molte aziende, prese dall’innovazione, trascurano queste basi.
E gli hacker non si limitano a rubare dati. Possono intaccare direttamente i modelli di IA. Per esempio, un’auto a guida autonoma indotta a scambiare un cartello di stop per un limite di velocità. Questo tipo di attacco è chiamato attacco di avvelenamento dei dati, in cui gli hacker alimentano il sistema con dati corrotti per compromettere il processo decisionale. Ne parleremo più in dettaglio nella prossima sezione.
Anche gli attacchi di prompt injection sono un’altra tipologia. Sono manipolazioni sottili che ingannano un’IA inducendola a dire—o fare—qualcosa che non dovrebbe. Abbiamo un articolo ottimo sul prompt injection, quindi qui non entreremo troppo nel dettaglio, ma vale sicuramente la pena leggerlo.
Paradossalmente, anche gli hacker usano l’IA per hackerare. È qui che la cybersecurity diventa una corsa contro il tempo: gli hacker innovano e i team di sicurezza devono rispondere con la stessa rapidità. Strumenti come il rilevamento delle anomalie possono aiutare, ma non sono infallibili.
Hai mai sentito il detto “Una catena è forte quanto il suo anello più debole”? Si applica perfettamente all’IA. Le aziende integrano spesso strumenti di IA preconfezionati nei loro sistemi. Ma cosa succede se uno di questi strumenti viene compromesso? Immagina un chatbot popolare usato da centinaia di aziende che viene hackerato. Centinaia di aziende—e tutti i loro dati clienti—finirebbero a rischio. Un effetto domino digitale.
Infine, c’è il gap di competenze. L’adozione dell’IA cresce, ma la sicurezza informatica per l’IA sta ancora rincorrendo.
Minacce alla sicurezza dell’IA
I sistemi di IA affrontano minacce serie che possono comprometterne l’efficacia e l’affidabilità. Vediamo le principali.
Attacchi avversari
Gli attacchi avversari ingannano i sistemi di IA apportando piccole, subdole modifiche agli input che l’IA elabora. Questi cambiamenti sono così sottili che le persone di solito non li notano, ma possono confondere completamente l’IA portandola a decisioni errate.
Per esempio:
Questi attacchi non richiedono che l’attaccante conosca il funzionamento interno dell’IA, il che li rende ancora più difficili da rilevare e fermare.
Vediamo ora alcuni esempi reali.
Questo diagramma illustra un attacco avversario su un sistema di IA per imaging medico. La radiografia originale, correttamente classificata come "Alto rischio di cancro ai polmoni", viene alterata in modo sottile con rumore avversario, portando a una classificazione errata come "Polmoni sani".
Un’ottima lettura è Adversarial Machine Learning, un campo che studia gli attacchi che sfruttano le vulnerabilità dei modelli di machine learning e sviluppa difese per proteggerli da queste minacce.
Attacchi di avvelenamento
Gli attacchi di avvelenamento prendono di mira la fase di addestramento dei sistemi di IA, quando il modello impara a prendere decisioni. Gli aggressori inseriscono dati corrotti o fuorvianti nel set di training per manipolare l’IA a comportarsi in modo errato o a favorire esiti distorti. Questi attacchi funzionano perché intaccano le fondamenta del processo di apprendimento dell’IA, spesso senza lasciare segni evidenti che qualcosa non va.
Ciò può includere:
Queste modifiche sottili possono far fallire l’IA in determinate condizioni o farla agire a vantaggio dell’attaccante. Poiché l’attacco avviene durante l’addestramento, è difficile da individuare una volta che il modello è in produzione.
Ecco alcuni esempi reali:
Questo diagramma mostra un attacco di avvelenamento su un sistema di IA usato per classificare richieste di rimborso assicurativo false e vere. Nel primo pannello, il sistema separa correttamente le false (rosso) dalle vere (nero) usando un dataset di training pulito. Nel secondo, dati etichettati in modo malevolo (“veleno”) spostano il confine decisionale, portando a classificare come vere richieste false, compromettendo affidabilità e sicurezza.
Attacchi di estrazione del modello
In un attacco di estrazione, un aggressore capisce come funziona un modello di IA effettuandone il reverse engineering. Usa gli input e gli output raccolti per copiarne progettazione e comportamento.
Una volta creata una replica del modello, può:
Ad esempio, se il modello rubato è stato addestrato su dati privati dei clienti, l’aggressore potrebbe prevedere dettagli personali su quei clienti o creare una versione personalizzata del modello per il proprio uso.
Ecco alcuni esempi reali:
Questo diagramma illustra un attacco di estrazione del modello, in cui un aggressore interagisce con un modello di IA vittima inviando query e raccogliendo le sue previsioni. I dati raccolti vengono usati per addestrare un modello replica, ricostruendo di fatto una versione rubata del sistema originale.
Difese per la sicurezza dell’IA
Abbiamo visto nelle sezioni precedenti che, con la diffusione dell’IA, è importante adottare solide misure di sicurezza per proteggerla dagli attacchi. Vediamo alcune modalità efficaci per rendere l’IA più sicura.
Addestramento avversario
Questo metodo consiste nell’insegnare ai modelli a riconoscere e gestire input subdoli e manipolati (chiamati esempi avversari). Se addestri il modello con questi esempi, diventa più resistente a determinati tipi di attacchi.
Distillazione difensiva
La distillazione degli LLM prevede l’addestramento di un modello secondario per imitare il comportamento dell’originale con l’obiettivo di renderne più difficile la manipolazione da parte degli attaccanti.
Validazione e sanitizzazione degli input
Garantire che i dati in ingresso a un sistema di IA siano puliti e sicuri è fondamentale per proteggerlo da input malevoli.
Metodi ensemble
Usare più modelli di IA insieme (un ensemble) può rendere i sistemi più sicuri. Anche se uno viene attaccato, gli altri fanno da “backup”.
Explainable AI (XAI)
Rendere spiegabili i sistemi di IA aiuta a capirne il funzionamento e a individuare vulnerabilità o comportamenti anomali. Puoi approfondire l’argomento nel corso Explainable AI in Python.
Audit di sicurezza regolari
Verificare regolarmente i sistemi di IA per individuare debolezze aiuta a intercettare i problemi in anticipo e a mantenere la sicurezza nel tempo.
Usare queste strategie rende i sistemi di IA più sicuri e meglio protetti dagli attacchi. Ma attenzione: la sicurezza dell’IA non è un “imposta e dimentica”. È un processo continuo.
Poiché emergono continuamente nuove minacce—e credimi, succede sempre—le aziende devono restare vigili. Significa monitorare costantemente le vulnerabilità, aggiornare i sistemi e migliorare le difese.
Metodo
Come funziona
Perché aiuta
Svantaggi
Addestramento avversario
Crea esempi di dati manipolati e includili nell’addestramento dell’IA.
Migliora la robustezza contro attacchi avversari che cercano di ingannare il sistema.
Può ridurre leggermente l’accuratezza dell’IA su dati normali (puliti).
Distillazione difensiva
Allena un modello secondario a imitare il comportamento dell’originale, smussandone il processo decisionale.
Rende più difficile per gli attaccanti sfruttare le debolezze del modello.
Richiede molte risorse di calcolo, soprattutto per modelli grandi.
Validazione e sanitizzazione degli input
Verifica che gli input abbiano il formato corretto, rientrino negli intervalli attesi e non contengano elementi dannosi.
Previene l’avvelenamento dei dati e garantisce il regolare funzionamento del sistema di IA.
Richiede un’implementazione accurata in più fasi.
Metodi ensemble
Combina le previsioni di più modelli per prendere decisioni.
È più difficile per gli attaccanti compromettere tutti i modelli contemporaneamente.
Richiede più risorse di calcolo per gestire e mantenere più modelli.
Explainable AI (XAI)
Usa strumenti come LIME, SHAP o meccanismi di attenzione per spiegare le decisioni dell’IA.
Aumenta la fiducia e facilita l’individuazione e la correzione di problemi come bias o comportamenti anomali.
Modelli più semplici e spiegabili potrebbero non performare quanto quelli complessi.
Audit di sicurezza regolari
Esegui assessment di vulnerabilità, penetration test e code review per individuare debolezze.
Individua potenziali lacune di sicurezza e assicura la conformità normativa.
Può essere dispendioso in termini di risorse a seconda della complessità del sistema.
Nuove tendenze nella sicurezza dell’IA
In questa sezione, vediamo le nuove tendenze che mantengono i sistemi di IA sicuri, accurati e affidabili.
Proteggere i modelli di IA e l’integrità dei dati
Prima di tutto, vediamo perché è così importante proteggere modelli e dati di IA.
Come tenere davvero al sicuro la tua IA? Ecco alcune strategie chiave:
Facciamo un esempio reale. Immagina una grande banca internazionale che ha sviluppato un modello di IA per individuare transazioni fraudolente. Questo sistema gestisce milioni di transazioni al giorno, individuando schemi sospetti e segnalando le frodi.
La banca ha speso 50 milioni di dollari e tre anni per costruire questo sistema. Se venisse rubato, i concorrenti potrebbero usarlo senza investire nulla, facendole perdere il vantaggio competitivo.
Questo modello elabora dati finanziari sensibili di milioni di clienti. Una violazione potrebbe esporli, portando a multe enormi ai sensi di normative come il GDPR.
Se gli hacker inserissero dati falsi durante l’addestramento, potrebbero insegnare all’IA a non riconoscere determinati schemi di frode, lasciando la banca vulnerabile.
Attaccanti sofisticati potrebbero persino ricavare dettagli privati dei clienti dagli output del modello.
Come si protegge la banca?
Il risultato è un sistema di IA più sicuro e affidabile che protegge i dati dei clienti e mantiene la promessa di individuare le frodi in modo efficace. Un vantaggio per la banca e per i suoi clienti.
Difendersi da attacchi di elusione e avvelenamento
Immagina di gestire una struttura ad alta sicurezza che si affida al riconoscimento facciale. Abbiamo però imparato che i sistemi di IA sono vulnerabili ad attacchi, come input avversari o dati di training avvelenati. Gli hacker possono manipolare il sistema per farsi aprire le porte.
Vediamo quattro difese chiave che possono fermare gli attaccanti:
Il sistema non è solo intelligente: è prudente. Ogni input deve dimostrare di essere legittimo prima di procedere.
Mettere in sicurezza le supply chain dell’IA
Mettere in sicurezza l’IA significa gestire l’integrità dei dati, proteggere i modelli proprietari e assicurare l’integrazione con la tua infrastruttura di cybersecurity. A questo si aggiungono minacce in evoluzione, conformità normativa, etica e vulnerabilità della supply chain. Ecco alcune strategie per mettere in sicurezza il ciclo di vita dell’IA:
Ecco un esempio reale. Prendiamo un’azienda sanitaria che sviluppa uno strumento diagnostico basato su IA. La sua supply chain include:
Come mettono in sicurezza questa pipeline?
In questo modo, ottengono una supply chain dell’IA sicura che assicura che lo strumento diagnostico sia accurato, affidabile e conforme agli standard di settore.
Affrontare i rischi etici
L’IA è potente, ma nelle mani sbagliate può essere pericolosa. Se un sistema di IA viene violato o progettato male, può produrre decisioni distorte, esiti non etici o addirittura abusi. È un problema serio, soprattutto quando l’IA prende decisioni che incidono sulle persone—come assunzioni, prestiti o sanità.
Come rendere i sistemi di IA più etici e resilienti? Ecco quattro passaggi chiave:
Esempio reale: un’ampia azienda tech usa un sistema di selezione del personale basato su IA. Come lo mantiene etico?
Risultato: un sistema di selezione etico, equo e trasparente, anche in caso di compromissioni potenziali.
Sfide di spiegabilità e fiducia
I sistemi di IA sono spesso visti come “scatole nere”, cioè il loro processo decisionale non è facile da capire. Questo rende difficile individuare problemi o costruire fiducia. Se sei un medico che si affida a uno strumento di IA o un paziente influenzato dalle sue decisioni, vuoi risposte, non punti interrogativi. La soluzione è la spiegabilità. Ecco quattro strategie per rendere i sistemi di IA più trasparenti e affidabili:
Vediamo come un ospedale costruisce fiducia in uno strumento di diagnosi dermatologica basato su IA—un sistema che usa il riconoscimento di immagini per identificare possibili condizioni della pelle.
Questo strumento di IA non è solo intelligente, ma anche spiegabile e affidabile. I medici comprendono le sue decisioni, i pazienti si sentono sicuri e l’ospedale garantisce che la tecnologia funzioni in modo equo e accurato.
Conclusione
Man mano che l’IA entra sempre più nelle nostre vite, mantenerla sicura è più critico che mai. Perché? Perché lo stesso potere che ne alimenta le capacità la rende anche un bersaglio. Minacce come attacchi avversari, avvelenamento dei dati e furto di modelli possono compromettere seriamente il funzionamento dell’IA.
Come difendere l’IA? Abbiamo visto che non esiste una soluzione unica. Tecniche come l’addestramento avversario, gli audit regolari e le difese a strati possono ridurre i rischi e rendere i sistemi più robusti.
Poi c’è l’IA generativa. I large language model offrono opportunità incredibili, ma introducono anche nuove vulnerabilità. Dalla generazione di contenuti fuorvianti alla manipolazione per ottenere output dannosi, questi strumenti richiedono supervisione attenta. Nell’articolo How to Build Guardrails for Large Language Models trovi misure di sicurezza per assicurare che gli LLM si comportino come dovrebbero.
Etica e trasparenza sono imprescindibili. I sistemi di IA devono essere equi, spiegabili e affidabili. Bias e abusi erodono la fiducia—e oggi la fiducia è tutto. Le persone non usano ciò di cui non si fidano.
Infine, restare avanti è fondamentale. Le minacce all’IA evolvono continuamente. Le aziende devono aggiornare regolarmente le strategie di sicurezza, tenendo il passo con i nuovi rischi per restare protette. La chiave è essere proattivi, vigili e impegnati su etica e trasparenza: così le aziende possono costruire fiducia e sfruttare al massimo i benefici dell’IA.