AI इतनी तेजी से विकसित हो रहा है कि उसकी सुरक्षा चुनौतियों के साथ कदम मिलाना मानो हवा में उड़ते विमान की मरम्मत करने जैसा लगता है। जैसे-जैसे सिस्टम स्मार्ट होते जा रहे हैं और रोज़मर्रा की व्यावसायिक प्रक्रियाओं में गहराई से समाहित हो रहे हैं, वे नए प्रकार के खतरों के प्रति अधिक संवेदनशील भी बनते जा रहे हैं।
मैंने इसे अपने काम में क़रीब से देखा है। कई बार मुझे व्यावसायिक प्रक्रियाओं में ऐसे सुरक्षा छिद्र मिले हैं जिनसे किसी को वह संवेदनशील जानकारी मिल सकती थी जो उन्हें नहीं मिलनी चाहिए थी—खासकर तब, जब AI समाधान बिना उचित सुरक्षा उपायों के जल्दबाज़ी में लागू किए गए थे।
यही इस लेख का विषय है: AI को सुरक्षित रखने के जोखिम, चुनौतियाँ, और सर्वोत्तम प्रक्रियाएँ समझना। AI इतनी तेज़ी से बढ़ रहा है कि यदि हम कमज़ोरियों से आगे नहीं रहे, तो हम उससे मिलने वाले भरोसे और फ़ायदों को खोने का जोखिम उठाते हैं।
यदि आप इस विषय को और विस्तार से सीखना चाहते हैं, तो मैं AI Security and Risk Management कोर्स देखने की सलाह देता/देती हूँ।
नई AI सुरक्षा चुनौतियाँ
AI डेटा पर चलता है। और जितना अधिक डेटा आपका AI इस्तेमाल करता है, उतना बड़ा लक्ष्य बनता है। हैकर्स यह जानते हैं। कल्पना कीजिए कि कोई अस्पताल मरीजों के स्वास्थ्य जोखिमों की भविष्यवाणी के लिए AI का उपयोग कर रहा है। बढ़िया लगता है—तब तक, जब तक कोई सिस्टम हैक न कर दे। अचानक, निजी मरीज रिकॉर्ड डार्क वेब पर बिकने लगते हैं, या उससे भी बुरा, चिकित्सा डेटा में फेरबदल हो जाता है, जो हानिकारक निर्णयों तक ले जा सकता है। संवेदनशील डेटा को एन्क्रिप्ट करना और बैकअप रखना अहम है, लेकिन कई कंपनियाँ नवाचार में इतनी मग्न होती हैं कि ये बुनियादी बातें नज़रअंदाज़ कर देती हैं।
और हैकर्स केवल डेटा चुराते ही नहीं हैं। वे AI मॉडलों से भी छेड़छाड़ कर सकते हैं। उदाहरण के लिए, किसी सेल्फ-ड्राइविंग कार को स्टॉप साइन को स्पीड लिमिट साइन समझने में गुमराह करना। इस प्रकार के हमले को डेटा पॉइज़निंग अटैक कहा जाता है, जहाँ हमलावर सिस्टम में खराब डेटा डालकर उसके निर्णयों को बिगाड़ देते हैं। अगले खंड में हम इसे विस्तार से देखेंगे।
प्रॉम्प्ट इंजेक्शन अटैक भी एक प्रकार का हमला है। ये सूक्ष्म छेड़छाड़ें हैं जो AI को किसी ऐसी बात—या काम—के लिए उकसाती हैं जो उसे नहीं करना चाहिए। हमारे पास प्रॉम्प्ट इंजेक्शन पर एक शानदार लेख है, इसलिए हम इस लेख में बहुत विस्तार में नहीं जाएँगे, लेकिन यह ज़रूर पढ़ने लायक है।
विडंबना यह है कि हैकर्स भी हैकिंग के लिए AI का उपयोग कर रहे हैं। यही वह जगह है जहाँ साइबर सुरक्षा समय के साथ दौड़ बन जाती है—हैकर्स नवाचार करते हैं, और सुरक्षा टीमें उतनी ही तेज़ी से जवाब देती हैं। एनोमली डिटेक्शन जैसे टूल मदद कर सकते हैं, लेकिन वे अचूक नहीं हैं।
क्या आपने यह कहावत सुनी है, "ज़ंजीर उतनी ही मज़बूत होती है जितनी उसकी सबसे कमज़ोर कड़ी"? यह AI पर पूरी तरह लागू होती है। कंपनियाँ अक्सर अपने सिस्टम में प्री-बिल्ट AI टूल्स एकीकृत करती हैं। लेकिन यदि उन टूल्स में से कोई एक समझौता कर लिया जाए तो क्या होगा? कल्पना करें कि सैकड़ों व्यवसायों द्वारा इस्तेमाल किया जाने वाला कोई लोकप्रिय चैटबॉट हैक हो जाए। तब सैकड़ों कंपनियाँ—और उनके समस्त ग्राहक डेटा—जोखिम में हैं। यह एक डिजिटल डोमिनो प्रभाव है।
अंततः, विशेषज्ञता का अंतर भी है। AI अपनाने की रफ्तार बढ़ रही है, लेकिन AI के लिए साइबर सुरक्षा अब भी पीछे-पीछे चल रही है।
AI सुरक्षा खतरे
AI सिस्टम ऐसे गंभीर सुरक्षा खतरों का सामना करते हैं जो उनकी कार्यकुशलता और विश्वसनीयता को प्रभावित कर सकते हैं। आइए प्रमुख खतरों पर नज़र डालते हैं।
एडवर्सेरियल अटैक्स
एडवर्सेरियल अटैक्स, AI द्वारा प्रोसेस किए जाने वाले इनपुट्स में छोटी, चुपके से की गई बदलावों के ज़रिए सिस्टम को धोखा देते हैं। ये बदलाव इतने सूक्ष्म होते हैं कि इंसान अक्सर उन्हें नोटिस भी नहीं कर पाते, लेकिन AI पूरी तरह भ्रमित होकर ग़लत निर्णय ले सकता है।
उदाहरण के लिए:
- किसी चित्र में बहुत बारीक़ बदलाव करना, जैसे कुछ पिक्सेल बदल देना, ताकि AI उसे गलत पहचान ले।
- ऑडियो फ़ाइल में हल्का शोर जोड़ना—जो हमें वही लगता है, लेकिन AI उसे गलत समझ लेता है।
- वाक्य की शब्दावली में थोड़ी फेरबदल कर AI की समझ को भ्रमित करना।
इन हमलों के लिए हमलावर को AI के आंतरिक कामकाज का पता होना ज़रूरी नहीं होता, जो इन्हें पकड़ना और रोकना और भी कठिन बना देता है।
अब कुछ वास्तविक उदाहरण देखते हैं।
- DeepFool एल्गोरिदम: DeepFool ऐसा तरीका है जो इनपुट (जैसे इमेज) में बेहद मामूली, लगभग अदृश्य परिवर्तन करके AI को गलत वर्गीकरण करने पर मजबूर करता है। यह इनपुट को धीरे-धीरे बदलता है जब तक कि AI ग़लत न हो जाए। ये बदलाव इतने छोटे होते हैं कि इंसान उन्हें नोटिस तक नहीं कर पाते।
- टारगेटेड ऑडियो अटैक्स: इस पेपर में हमलावरों ने ऐसा ऑडियो तैयार किया जो मूल जैसा ही सुनाई देता है, लेकिन स्पीच रिकग्निशन सिस्टम को बिल्कुल अलग शब्द सुनने पर मजबूर कर देता है। इस तरीके से Mozilla के DeepSpeech सिस्टम को 100% सफलता दर के साथ धोखा दिया गया।
- Tesla ऑटोपायलट में छेड़छाड़: Keen Labs ने सड़क पर तीन साधारण से स्टीकर रणनीतिक रूप से लगाकर Tesla के ऑटोपायलट सिस्टम को लेन मार्किंग्स की गलत व्याख्या करने के लिए गुमराह कर दिया, जिससे वाहन गलत लेन में मुड़ सकता था। यहाँ और पढ़ें।
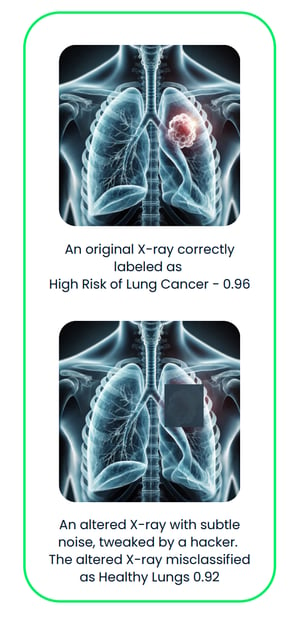
यह आरेख चिकित्सा इमेजिंग AI सिस्टम पर एक एडवर्सेरियल अटैक को दर्शाता है। मूल एक्स-रे, जिसे सही ढंग से "फेफड़ों के कैंसर का उच्च जोखिम" के रूप में वर्गीकृत किया गया था, में सूक्ष्म एडवर्सेरियल शोर जोड़कर इसे "स्वस्थ फेफड़े" के रूप में गलत वर्गीकृत करा दिया गया।
एक बेहतरीन लेख है Adversarial Machine Learning, जो मशीन लर्निंग मॉडलों की कमज़ोरियों का फ़ायदा उठाने वाले हमलों का अध्ययन करता है और उनसे बचाव के उपाय विकसित करता है।
पॉइज़निंग अटैक्स
पॉइज़निंग अटैक्स AI सिस्टम के प्रशिक्षण चरण को निशाना बनाते हैं, जहाँ मॉडल निर्णय लेना सीखता है। हमलावर प्रशिक्षण सेट में भ्रष्ट या भ्रामक डेटा घुसा देते हैं ताकि AI को गलत व्यवहार करने या पक्षपातपूर्ण परिणाम देने के लिए प्रभावित किया जा सके। ये हमले इसलिए कारगर होते हैं क्योंकि वे AI की सीखने की नींव से छेड़छाड़ करते हैं, और अक्सर कोई स्पष्ट निशान नहीं छोड़ते।
इसमें शामिल हो सकता है:
- कुछ प्रशिक्षण उदाहरणों के लेबल बदल देना, जैसे कुत्ते की तस्वीर को बिल्ली के रूप में लेबल करना।
- ऐसे नकली डेटा पॉइंट जोड़ना जो AI के निर्णयों को विशिष्ट तरीकों से प्रभावित करने के लिए बनाए गए हों।
ये सूक्ष्म बदलाव AI को कुछ परिस्थितियों में विफल कर सकते हैं या उसे हमलावर के हित में काम करने पर मजबूर कर सकते हैं। चूँकि हमला प्रशिक्षण के दौरान होता है, मॉडल के तैनात होने के बाद इसे पहचानना कठिन होता है।
कुछ वास्तविक उदाहरण देखें:
- बैकडोर अटैक्स: “Bypassing Backdoor Detection Algorithms in Deep Learning” नामक अध्ययन ने दिखाया कि हमलावर AI मॉडलों में दुर्भावनापूर्ण "बैकडोर्स" छिपा सकते हैं। ये केवल विशिष्ट परिस्थितियों में ट्रिगर होते हैं, जैसे इमेज में कोई खास पैटर्न दिखाना। अध्ययन ने दर्शाया कि उन्नत तकनीकों से ज़हरीला (poisoned) डेटा साफ़ डेटा जैसा दिख सकता है और पकड़े जाने से बच सकता है।
- वेब-स्केल डेटासेट पॉइज़निंग: “Poisoning Web-Scale Training Datasets is Practical” पेपर में शोधकर्ताओं ने बताया कि इंटरनेट से एकत्रित बड़े डेटासेट्स को इस प्रकार ज़हरीला किया जा सकता है:
- स्प्लिट-व्यू डेटा पॉइज़निंग: डेटा संग्रहण के बाद लेकिन प्रशिक्षण से पहले उसे भ्रष्ट करना।
- फ्रंट-रनिंग डेटा पॉइज़निंग: डेटा को डेटासेट में जोड़े जाने से ठीक पहले छेड़छाड़ करना।
- Microsoft का Tay चैटबॉट: 2016 में Microsoft ने Twitter पर Tay नाम का चैटबॉट लॉन्च किया। यूज़र्स ने उसे आपत्तिजनक सामग्री से भरकर जल्द ही प्रभावित कर दिया, जिसके चलते वह नस्लवादी और अनुचित ट्वीट करने लगा। Microsoft को लॉन्च के तुरंत बाद Tay को बंद करना पड़ा। यहाँ और पढ़ें।
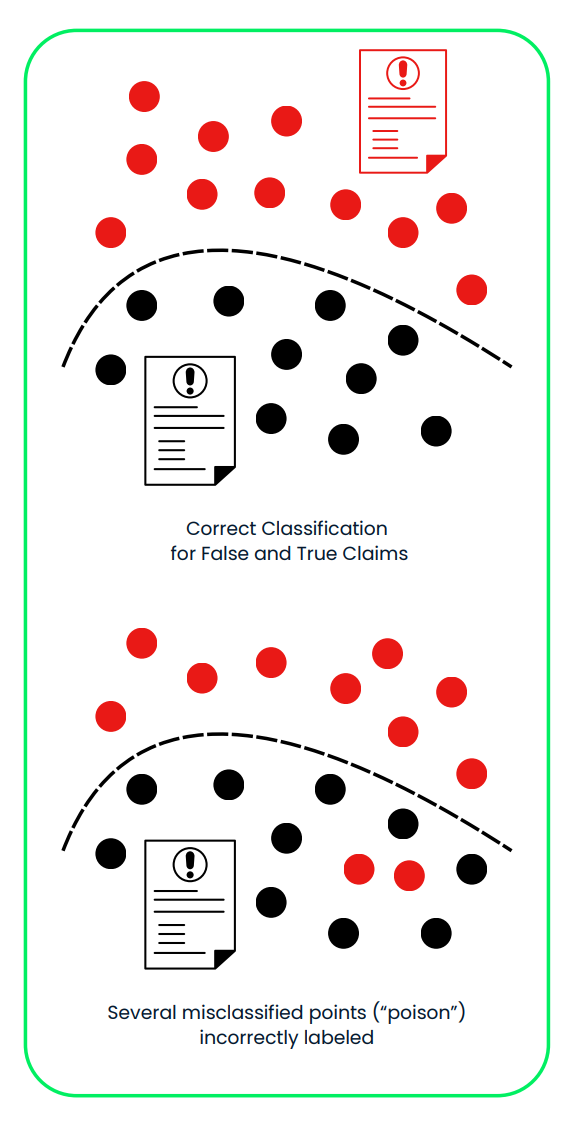
यह आरेख एक ऐसे पॉइज़निंग अटैक को दर्शाता है जो झूठे और सही बीमा दावों को वर्गीकृत करने वाली AI प्रणाली पर किया गया है। पहले पैनल में, सिस्टम साफ़ प्रशिक्षण डेटासेट का उपयोग कर झूठे (लाल) और सही (काला) दावों को सही ढंग से अलग करता है। दूसरे पैनल में, दुर्भावनापूर्ण रूप से गलत-लेबल किया गया डेटा (“ज़हर”) निर्णय सीमा को खिसका देता है, जिससे झूठे दावे सही के रूप में गलत वर्गीकृत होने लगते हैं और सिस्टम की विश्वसनीयता व सुरक्षा से समझौता होता है।
मॉडल एक्सट्रैक्शन अटैक्स
मॉडल एक्सट्रैक्शन अटैक में हमलावर, AI मॉडल को रिवर्स-इंजीनियर करके उसके काम करने के तरीके का पता लगा लेते हैं। वे एकत्रित इनपुट और आउटपुट का उपयोग कर सिस्टम के डिज़ाइन और व्यवहार की नकल बनाते हैं।
एक बार जब वे मॉडल की एक प्रतिकृति बना लेते हैं, तो वे यह कर सकते हैं:
- उससे प्रेडिक्शंस करवाना, जिनमें संवेदनशील या निजी डेटा शामिल हो सकता है।
- मूल मॉडल से गोपनीय जानकारी चुराना।
- मॉडल में बदलाव कर उसे अपनी ज़रूरतों के अनुरूप फिर से प्रशिक्षित करना—अक्सर हानिकारक उद्देश्यों के लिए।
उदाहरण के लिए, यदि चोरी किया गया मॉडल निजी ग्राहक डेटा पर प्रशिक्षित था, तो हमलावर उन ग्राहकों के बारे में व्यक्तिगत विवरणों की भविष्यवाणी कर सकता है या अपने उपयोग के लिए मॉडल का कस्टमाइज़्ड संस्करण बना सकता है।
कुछ वास्तविक उदाहरण देखें:
- एक टूल DeepSniffer दिखाता है कि इस तरह का अटैक कैसे काम कर सकता है। DeepSniffer को मूल मॉडल के बारे में पहले से कुछ जानने की ज़रूरत नहीं होती। यह मॉडल डेटा कैसे प्रोसेस करता है, उससे सुराग जुटाता है—जैसे रनटाइम के दौरान मेमोरी ऑपरेशंस को ट्रैक करना। फिर इन सुरागों को जोड़कर, यह मॉडल की संरचना का अनुमान लगा लेता है, भले ही सिस्टम अपनी प्रक्रियाओं को ऑप्टिमाइज़ या छुपाने की कोशिश करे।
- Mindgard ने दिखाया कि OpenAI के ChatGPT 3.5 Turbo जैसे ब्लैक-बॉक्स भाषा मॉडल के महत्वपूर्ण घटकों को कम लागत पर निकाला जा सकता है। सिर्फ $50 के API खर्च में, टीम ने एक छोटा मॉडल—मूल से लगभग 100 गुना छोटा—बना लिया, जो एक विशिष्ट कार्य पर ChatGPT से बेहतर निकला। फिर इस निकाले गए मॉडल का उपयोग एक अन्य हमले को बेहतर बनाने के लिए किया गया, जिसे बाद में ChatGPT के ख़िलाफ़ तैनात किया गया। बेहतर हमले की सफलता दर बढ़कर 11% हो गई।
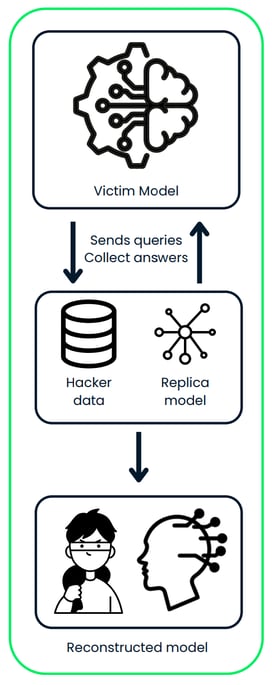
यह आरेख एक मॉडल एक्सट्रैक्शन अटैक दर्शाता है, जहाँ हमलावर क्वेरी भेजकर और प्रेडिक्शंस एकत्रित करके पीड़ित AI मॉडल के साथ इंटरैक्ट करता है। हमलावर संकलित डेटा का उपयोग कर एक प्रतिकृति मॉडल प्रशिक्षित करता है और अंततः मूल सिस्टम का चुराया हुआ संस्करण पुनर्निर्मित कर लेता है।
AI सुरक्षा के बचाव उपाय
पिछले खंडों में हमने बताया कि जैसे-जैसे AI आम होता जा रहा है, हमलों से बचाने के लिए मज़बूत सुरक्षा उपाय लागू करना ज़रूरी है। आइए कुछ प्रभावी तरीकों पर बात करते हैं जो AI को अधिक सुरक्षित बनाते हैं।
एडवर्सेरियल ट्रेनिंग
इस विधि में मॉडलों को चालाकी से बदले गए इनपुट्स (एडवर्सेरियल उदाहरण) पहचानना और संभालना सिखाया जाता है। जब आप ऐसे उदाहरणों के साथ मॉडल को प्रशिक्षित करते हैं, तो वह कुछ प्रकार के हमलों के प्रति अधिक प्रतिरोधी हो जाता है।
- कैसे काम करता है: बदले हुए डेटा के उदाहरण बनाकर AI के प्रशिक्षण में शामिल करें।
- क्यों सहायक है: यह AI सिस्टम को उन हमलों के ख़िलाफ़ मज़बूत बनाता है जो उसे धोखा देने की कोशिश करते हैं।
- कमज़ोरी: सामान्य (क्लीन) डेटा पर AI की सटीकता थोड़ी कम हो सकती है।
- वास्तविक उदाहरण:
- Google का Cloud Vision API अपनी इमेज रिकग्निशन मॉडलों की बदले हुए इनपुट्स के प्रति रेज़िलिएंस बढ़ाने के लिए एडवर्सेरियल ट्रेनिंग का उपयोग करता है
- OpenAI के मॉडल्स टेक्स्ट-आधारित हमलों के विरुद्ध मजबूती बढ़ाने के लिए प्रशिक्षण प्रक्रिया में एडवर्सेरियल उदाहरणों को शामिल करते हैं।
डिफेंसिव डिस्टिलेशन
LLM डिस्टिलेशन में एक द्वितीयक मॉडल को मूल मॉडल के व्यवहार की नकल करने के लिए प्रशिक्षित किया जाता है ताकि हमलावरों के लिए उसे प्रभावित करना कठिन हो जाए।
- कैसे काम करता है: पहले मॉडल को प्रशिक्षित करें, फिर उसकी आउटपुट को उपयोग करके दूसरे मॉडल को इस तरह प्रशिक्षित करें कि उसका निर्णय-निर्माण अधिक स्मूथ हो जाए।
- क्यों सहायक है: मॉडल की कमज़ोरियों का फ़ायदा उठाना हमलावरों के लिए कठिन बनाता है।
- कमज़ोरी: बड़े मॉडलों के लिए यह तरीका काफ़ी कंप्यूटिंग शक्ति माँग सकता है।
- वास्तविक उदाहरण:
- यूनिवर्सिटी ऑफ़ कैलिफ़ोर्निया, बर्कले के शोधकर्ताओं ने स्वायत्त वाहनों में प्रयुक्त डीप न्यूरल नेटवर्क्स की मजबूती बढ़ाने के लिए डिफेंसिव डिस्टिलेशन लागू किया।
- IBM के Watson AI प्लेटफ़ॉर्म में प्राकृतिक भाषा प्रसंस्करण मॉडलों को एडवर्सेरियल अटैक्स से बचाने के लिए डिफेंसिव डिस्टिलेशन तकनीकों का उपयोग किया जाता है।
इनपुट वैलिडेशन और सैनिटाइज़ेशन
AI सिस्टम में जाने वाला डेटा साफ़ और सुरक्षित हो—यह सुनिश्चित करना, उसे दुर्भावनापूर्ण इनपुट्स से बचाने की कुंजी है।
- कैसे काम करता है: जाँचें कि इनपुट सही फ़ॉर्मैट में हों, अपेक्षित सीमाओं में हों, और हानिकारक तत्व न हों।
- क्यों सहायक है: डेटा पॉइज़निंग जैसे हमलों को रोकता है और AI सिस्टम का सुचारू संचालन सुनिश्चित करता है।
- सर्वोत्तम अभ्यास: कई चरणों पर डेटा वैलिडेट करें—यूज़र साइड, सर्वर साइड और स्वयं AI सिस्टम के भीतर।
- वास्तविक उदाहरण:
- Microsoft के Azure AI सेवाएँ अपने मशीन लर्निंग मॉडलों पर SQL इंजेक्शन अटैक्स को रोकने के लिए सख्त इनपुट वैलिडेशन लागू करती हैं।
- Amazon का Rekognition फ़ेशियल रिकग्निशन सिस्टम संभावित रूप से दुर्भावनापूर्ण इमेज इनपुट्स को फ़िल्टर करने के लिए इनपुट सैनिटाइज़ेशन का उपयोग करता है।
एंसेंबल मेथड्स
कई अलग-अलग AI मॉडलों को साथ में उपयोग करना (एंसेंबल) सिस्टम को अधिक सुरक्षित बना सकता है। भले ही एक मॉडल पर हमला हो जाए, बाकी बैकअप दे सकते हैं।
- कैसे काम करता है: निर्णय लेने के लिए कई मॉडलों की भविष्यवाणियों को संयोजित करें।
- क्यों सहायक है: सभी मॉडलों को एक साथ प्रभावित करना हमलावरों के लिए कठिन होता है।
- कमज़ोरी: कई मॉडलों को प्रबंधित करने के लिए अधिक कंप्यूटिंग संसाधन चाहिए।
- वास्तविक उदाहरण:
- Netflix की सिफ़ारिश प्रणाली सटीकता और हेरफेर-रोधी क्षमता बढ़ाने के लिए कई AI मॉडलों का एंसेंबल उपयोग करती है।
- एंसेंबल मेथड्स केवल AI सुरक्षा तक सीमित नहीं हैं; इन्हें सामान्य रूप से अधिक मज़बूत और सटीक प्रेडिक्टिव मॉडल बनाने के लिए भी उपयोग किया जाता है।
एक्सप्लनेबल AI (XAI)
AI सिस्टम को समझाने योग्य बनाना लोगों को यह समझने में मदद करता है कि वे कैसे काम करते हैं और किसी भी कमज़ोरी या असामान्य व्यवहार का पता चलता है। आप इस विषय को विस्तार से Explainable AI in Python कोर्स में देख सकते हैं।
- कैसे काम करता है: LIME, SHAP या अटेंशन मैकेनिज़्म जैसे टूल्स का उपयोग कर AI निर्णयों को समझाएँ।
- क्यों सहायक है: AI सिस्टम पर भरोसा बढ़ता है और पूर्वाग्रह जैसी समस्याओं को पहचानना व ठीक करना आसान होता है।
- चुनौती: सरल, समझाने योग्य मॉडल जटिल मॉडलों जितना शक्तिशाली नहीं हो सकते।
- वास्तविक उदाहरण:
- DARPA का Explainable AI (XAI) प्रोग्राम सैन्य अनुप्रयोगों के लिए अधिक पारदर्शी AI सिस्टम विकसित करने का लक्ष्य रखता है।
- IBM का AI Explainability 360 टूलकिट विभिन्न उद्योगों में समझाने योग्य AI तकनीकों को लागू करने के लिए ओपन-सोर्स संसाधन प्रदान करता है।
नियमित सुरक्षा ऑडिट
AI सिस्टम की नियमित जाँच कमजोरियों को जल्दी पकड़ने और समय के साथ उन्हें सुरक्षित बनाए रखने में मदद करती है।
- क्या शामिल है: वल्नरेबिलिटी असेसमेंट, पेनिट्रेशन टेस्ट और कोड रिव्यू करें।
- कितनी बार: नियमित रूप से और सिस्टम में बड़े बदलावों के बाद ऑडिट करें।
- क्यों सहायक है: संभावित सुरक्षा खामियों की पहचान करता है और विनियमों का अनुपालन सुनिश्चित करता है।
- वास्तविक उदाहरण:
- Facebook अपने AI-समर्थित कंटेंट मॉडरेशन सिस्टम्स के नियमित सुरक्षा ऑडिट करता है ताकि संभावित कमजोरियों की पहचान व समाधान हो सके।
- यूरोपीय संघ का AI अधिनियम महत्वपूर्ण क्षेत्रों में उपयोग होने वाले उच्च-जोखिम AI सिस्टम्स के लिए अनिवार्य सुरक्षा ऑडिट का प्रस्ताव रखता है।
इन रणनीतियों का उपयोग AI सिस्टम को अधिक सुरक्षित बनाता है और हमलों से बेहतर सुरक्षा देता है। लेकिन बात यह है—AI सुरक्षा "सेट करो और भूल जाओ" वाली चीज़ नहीं है। यह एक सतत प्रक्रिया है।
जैसे-जैसे नए खतरे सामने आते हैं—और यक़ीन मानिए, वे हमेशा आते हैं—व्यवसायों को सतर्क रहना चाहिए। इसका मतलब है कमज़ोरियों की लगातार निगरानी करना, सिस्टम्स को अपडेट करना, और रक्षाओं में सुधार करना।
|
विधि
|
कैसे काम करता है
|
क्यों सहायक है
|
कमज़ोरियाँ
|
|
एडवर्सेरियल ट्रेनिंग
|
बदले हुए डेटा के उदाहरण बनाकर उन्हें AI के प्रशिक्षण में शामिल करें।
|
सिस्टम को धोखा देने की कोशिश करने वाले एडवर्सेरियल अटैक्स के विरुद्ध मजबूती बढ़ती है।
|
सामान्य (क्लीन) डेटा पर AI की सटीकता थोड़ी कम हो सकती है।
|
|
डिफेंसिव डिस्टिलेशन
|
मूल मॉडल के व्यवहार की नकल करने के लिए एक द्वितीयक मॉडल प्रशिक्षित करें, जिससे निर्णय-निर्माण प्रक्रिया स्मूथ हो।
|
मॉडल की कमज़ोरियों का फायदा उठाना हमलावरों के लिए कठिन बनता है।
|
खासतौर पर बड़े मॉडलों के लिए बहुत अधिक कंप्यूटिंग शक्ति चाहिए।
|
|
इनपुट वैलिडेशन एवं सैनिटाइज़ेशन
|
जाँचें कि इनपुट सही फ़ॉर्मैट में हों, अपेक्षित सीमाओं में हों, और हानिकारक तत्व न हों।
|
डेटा पॉइज़निंग रोकता है और AI सिस्टम का सुचारू संचालन सुनिश्चित करता है।
|
कई चरणों पर सावधानीपूर्वक कार्यान्वयन की आवश्यकता।
|
|
एंसेंबल मेथड्स
|
निर्णय लेने के लिए कई मॉडलों की भविष्यवाणियों को मिलाएँ।
|
हमलावरों के लिए सभी मॉडलों से एक साथ समझौता करना कठिन होता है।
|
कई मॉडलों को प्रबंधित और मेंटेन करने हेतु अधिक कंप्यूटिंग संसाधन चाहिए।
|
|
एक्सप्लनेबल AI (XAI)
|
AI निर्णयों को समझाने के लिए LIME, SHAP या अटेंशन मैकेनिज़्म जैसे टूल उपयोग करें।
|
भरोसा बढ़ता है और पूर्वाग्रह या असामान्य व्यवहार जैसी समस्याएँ पहचानना और ठीक करना आसान होता है।
|
सरल, समझाने योग्य मॉडल जटिल मॉडलों जितना अच्छा प्रदर्शन नहीं कर सकते।
|
|
नियमित सुरक्षा ऑडिट
|
कमज़ोरियों की पहचान के लिए वल्नरेबिलिटी असेसमेंट, पेनिट्रेशन टेस्ट और कोड रिव्यू करें।
|
संभावित सुरक्षा खामियों की पहचान करता है और विनियमों का अनुपालन सुनिश्चित करता है।
|
सिस्टम की जटिलता पर निर्भर करते हुए संसाधन-गहन हो सकता है।
|
AI सुरक्षा में नए रुझान
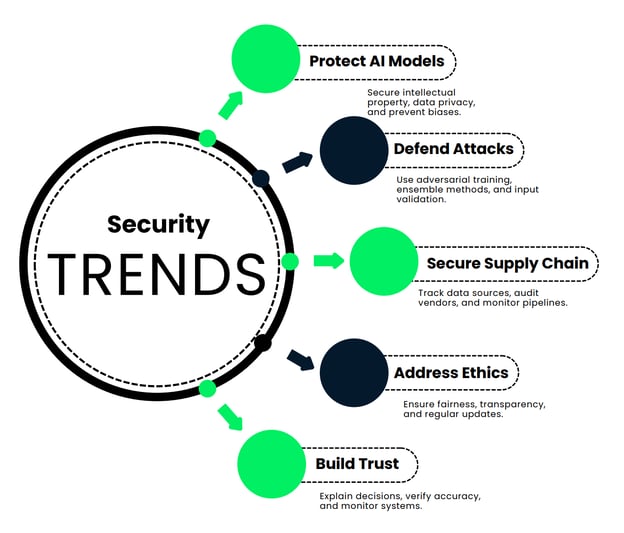
इस खंड में, हम उन नए रुझानों को देख रहे हैं जो AI सिस्टम को सुरक्षित, सटीक और भरोसेमंद बनाए रखते हैं।
AI मॉडलों और डेटा अखंडता की सुरक्षा
सबसे पहले, आइए समझें कि AI मॉडलों और डेटा की सुरक्षा क्यों महत्वपूर्ण है।
- बौद्धिक संपदा की रक्षा: किसी AI मॉडल को बनाने में लगने वाला समय, धन और बुद्धिशक्ति सोचिए। ये सिर्फ़ एल्गोरिद्म नहीं होते; ये बड़े निवेश होते हैं। उन्हें सुरक्षित रखना प्रतियोगियों को आपकी मेहनत चुराने से रोकता है।
- प्रतिस्पर्धात्मक बढ़त बनाए रखना: यदि कोई आपके AI मॉडल तक अनधिकृत पहुंच पा ले, तो वह उसे कॉपी करके बिना विकास पर खर्च किए वही नतीजे पा सकता है।
- डेटा गोपनीयता और अनुपालन: AI अक्सर संवेदनशील डेटा—वित्तीय जानकारी, चिकित्सा रिकॉर्ड, आदि—प्रोसेस करता है। यदि यह डेटा उजागर हो जाए, तो भारी जुर्माने के साथ सार्वजनिक भरोसे में बड़ी कमी आ सकती है। अधिक जानें: Introduction to Data Privacy।
- डेटा पॉइज़निंग को रोकना: हैकर्स आपके प्रशिक्षण डेटा से छेड़छाड़ कर सकते हैं, जिससे आपका AI गलत निर्णय लेने लगे—जैसे धोखाधड़ी को नज़रअंदाज़ करना या निर्दोष गतिविधियों को ख़तरे के रूप में फ़्लैग करना।
- मॉडल इनवर्ज़न अटैक्स को कम करना: सोचिए, यदि हमलावर केवल आपके AI की आउटपुट देखकर निजी ग्राहक विवरण निकाल लें—यह अच्छा नहीं होगा!
- पक्षपातपूर्ण या अनैतिक परिणामों से बचना: समझौता किया हुआ मॉडल अनुचित या हानिकारक निर्णयों तक ले जा सकता है, जो आपकी प्रतिष्ठा को नुकसान पहुँचा सकता है।
- महत्वपूर्ण अवसंरचना की सुरक्षा: स्वास्थ्य, वित्त और राष्ट्रीय सुरक्षा जैसे क्षेत्रों में AI के उपयोग के साथ, सुरक्षा केवल व्यावसायिक चिंता नहीं—यह सार्वजनिक सुरक्षा का मुद्दा भी है।
तो, वास्तव में आप अपने AI को कैसे सुरक्षित रख सकते हैं? ये कुछ मुख्य रणनीतियाँ हैं:
- संवेदनशील जानकारी की सुरक्षा के लिए डेटा एन्क्रिप्शन और अनॉनिमाइज़ेशन का उपयोग करें।
- जानकारी कितने समय तक संग्रहीत होगी, इसे नियंत्रित करने के लिए सख्त डेटा रिटेंशन नीतियाँ लागू करें।
- कमज़ोरियों को जल्दी पकड़ने के लिए नियमित सुरक्षा ऑडिट और मॉनिटरिंग करें।
- हर चरण में सुरक्षा निहित करने वाले प्राइवेसी बाय डिज़ाइन सिद्धांतों के साथ सिस्टम डिज़ाइन करें।
- संवेदनशील जानकारी को इधर-उधर भेजे बिना मॉडल और उसके डेटा की सुरक्षा के लिए फेडरेटेड लर्निंग जैसी उन्नत तकनीकों का उपयोग करें।
इसे एक वास्तविक परिदृश्य से समझते हैं। मान लीजिए, एक बड़ी अंतरराष्ट्रीय बैंक ने धोखाधड़ी वाले लेन-देन का पता लगाने के लिए AI मॉडल विकसित किया है। यह सिस्टम रोज़ाना लाखों लेन-देन संभालता है, संदिग्ध पैटर्न पहचानता है और धोखाधड़ी को फ़्लैग करता है।
बैंक ने इस सिस्टम को बनाने में 5 करोड़ डॉलर और तीन साल लगाए। यदि यह चोरी हो जाए, तो प्रतियोगी बिना एक पैसा लगाए इसका इस्तेमाल कर सकते हैं, जिससे बैंक अपनी बढ़त खो देगा।
यह मॉडल लाखों ग्राहकों के संवेदनशील वित्तीय डेटा को प्रोसेस करता है। कोई भी उल्लंघन इस जानकारी को उजागर कर सकता है, जिससे GDPR जैसे क़ानूनों के तहत भारी जुर्माने लग सकते हैं।
यदि हैकर्स प्रशिक्षण के दौरान नकली डेटा इंजेक्ट कर दें, तो वे AI को कुछ धोखाधड़ी पैटर्न न पहचानने के लिए सिखा सकते हैं, जिससे बैंक असुरक्षित हो जाएगा।
परिष्कृत हमलावर मॉडल की आउटपुट से निजी ग्राहक विवरण भी निकाल सकते हैं।
बैंक इसकी सुरक्षा कैसे करता है?
- वे डेटा को सुरक्षित करने के लिए एंड-टू-एंड एन्क्रिप्शन का उपयोग करते हैं।
- मॉडल तक पहुँच के लिए मल्टी-फैक्टर ऑथेंटिकेशन आवश्यक है और इसे रोल-आधारित नियंत्रणों से सीमित किया जाता है।
- कमज़ोरियों को खोजने के लिए नियमित ऑडिट और पेनिट्रेशन टेस्ट चलाए जाते हैं।
- प्रशिक्षण में उपयोग होने वाला ग्राहक डेटा पूरी तरह अनॉनिमाइज़ किया जाता है।
- असामान्यताओं को पकड़ने के लिए बैंक मॉडल के प्रदर्शन पर लगातार नज़र रखता है।
इससे एक अधिक सुरक्षित, विश्वसनीय AI सिस्टम बनता है जो ग्राहक डेटा को सुरक्षित रखता है और धोखाधड़ी की पहचान प्रभावी रूप से करने के अपने वादे पर खरा उतरता है। यह बैंक और उसके ग्राहकों—दोनों के लिए फ़ायदेमंद है।
इवेज़न और पॉइज़निंग अटैक्स के खिलाफ़ रक्षा
मान लीजिए आप एक उच्च-सुरक्षा सुविधा चला रहे हैं जो हर चीज़ को सुरक्षित रखने के लिए फ़ेशियल रिकग्निशन पर निर्भर है। हालाँकि, हमने जाना है कि AI सिस्टम एडवर्सेरियल इनपुट्स या ज़हरीले प्रशिक्षण डेटा जैसे हमलों के प्रति संवेदनशील हैं। हैकर्स सिस्टम में हेरफेर करके अंदर घुस सकते हैं।
आइए चार प्रमुख रक्षा उपायों को समझें जो हमलावरों को रास्ते में ही रोक सकते हैं:
- एडवर्सेरियल ट्रेनिंग: यह आपके मॉडल को आत्मरक्षा के गुर सिखाने जैसा है। आप बदले हुए इनपुट्स—ऐसी सूक्ष्म तराश-छाँट वाली इमेजेस जो AI को धोखा देने के लिए डिज़ाइन की गई हों—के उदाहरण शामिल करते हैं और उसे उन्हें पहचानने का प्रशिक्षण देते हैं। सोचिए, एक फ़ेशियल रिकग्निशन सिस्टम जो सिर्फ़ चेहरा ही नहीं, बल्कि वे सूक्ष्म पिक्सेल-स्तरीय बदलाव भी भाँप ले जो हमलावर चुपके से डालते हैं। आपका AI इन हमलों के प्रति होशियार बनता है और वास्तविक जीवन में गुमराह नहीं होता।
- एंसेंबल मेथड्स: हमने इनके बारे में पहले बात की है। एक सिस्टम पर निर्भर रहने के बजाय, आप मॉडलों की एक टीम इस्तेमाल करते हैं। हर मॉडल इनपुट को स्वतंत्र रूप से प्रोसेस करता है और उनके परिणाम वोटिंग मैकेनिज़्म से जोड़े जाते हैं। हमलावर केवल एक मॉडल को नहीं, पूरी टीम को छलें—यह आसान नहीं।
- नियमित डेटा जाँच: किसे सफ़ाई पसंद है? फिर भी यह आपके AI के लिए ज़रूरी मेंटेनेंस है। साप्ताहिक ऑडिट यह सुनिश्चित करते हैं कि आपके प्रशिक्षण डेटा में डुप्लिकेट, गलत-लेबल प्रविष्टियाँ या छिपे हुए दुर्भावनापूर्ण इनपुट न हों। और सत्यापित इमेजेस के साथ डेटासेट को ताज़ा रखना सिस्टम को चुस्त रखता है.
- इनपुट वैलिडेशन: किसी इमेज के आपके AI तक पहुँचने से पहले ही वह सुरक्षा चौकी से गुजरती है। यहाँ यह होता है:
- फ़ॉर्मैट और आकार की जाँच।
- छेड़छाड़ के संकेतों के लिए मेटाडेटा का विश्लेषण।
- ज्ञात एडवर्सेरियल पैटर्न्स को फ़्लैग करना।
- अनोमली डिटेक्शन से किसी भी असामान्य चीज़ को पहचानना।
सिस्टम सिर्फ़ स्मार्ट नहीं, सतर्क भी है। हर इनपुट को आगे बढ़ने से पहले वैधता साबित करनी होती है।
AI सप्लाई चेन की सुरक्षा
AI की सुरक्षा का मतलब है डेटा अखंडता का प्रबंधन, स्वामित्व वाले मॉडलों की रक्षा, और यह सुनिश्चित करना कि सब कुछ आपकी मौजूदा साइबरसुरक्षा व्यवस्था के साथ सामंजस्य में हो। साथ ही विकसित होते खतरों, विनियामक अनुपालन, नैतिकता और सप्लाई चेन कमजोरियों को भी संबोधित करना होता है। यहाँ AI लाइफ़साइकल को सुरक्षित करने की कुछ रणनीतियाँ हैं:
- अपने स्रोतों का पता रखें: आपके AI सिस्टम में हर डेटा और हर मॉडल की स्पष्ट उत्पत्ति कहानी होनी चाहिए। दस्तावेज़ करें कि वह कहाँ से आया—विश्वसनीय अस्पताल, शोध संस्थान, या कोई विशेषज्ञ वेंडर। क्यों? क्योंकि स्रोत जानना, भरोसा करने की पहली सीढ़ी है।
- वेंडर्स का ऑडिट करें: थर्ड-पार्टी प्रदाता अहम होते हैं, लेकिन संभावित कमज़ोर कड़ी भी। नियमित ऑडिट करें ताकि वे आपके सुरक्षा मानकों—जैसे HIPAA अनुपालन, डेटा अनॉनिमाइज़ेशन प्रोटोकॉल, या ISO प्रमाणन—पर खरे उतरें।
- डेटा ट्रैकिंग टूल्स का उपयोग करें: आपका डेटा स्थिर नहीं होता। समय के साथ यह बदलता है और कभी-कभी उन बदलावों में त्रुटियाँ या दुर्भावनापूर्ण परिवर्तन भी शामिल होते हैं। स्वचालित डेटा मॉनिटरिंग जैसे टूल बदलावों को ट्रैक कर सकते हैं और अप्रत्याशित शिफ्ट्स को फ़्लैग कर सकते हैं, जिससे आपके डेटासेट साफ़ और सटीक बने रहते हैं।
- डेटा पाइपलाइंस की निगरानी करें: डेटा स्रोत से मॉडल तक जटिल पाइपलाइंस से होकर बहता है, और रास्ते में कोई भी रुकावट मुसीबत खड़ी कर सकती है। रीयल-टाइम डैशबोर्ड्स अनियमितताओं—जैसे डेटा वॉल्यूम में अचानक गिरावट या फ़ीचर में अप्रत्याशित बदलाव—को पकड़ने में मदद कर सकते हैं।
यह रहा एक वास्तविक उदाहरण। मान लें कि कोई हेल्थकेयर कंपनी AI-संचालित डायग्नोस्टिक टूल विकसित कर रही है। इसकी सप्लाई चेन में शामिल हैं:
- पार्टनर अस्पतालों से मरीज डेटा।
- शीर्ष शोध संस्थान से चिकित्सा इमेजिंग डेटासेट्स।
- विशेषज्ञ AI वेंडर से प्री-ट्रेन्ड मॉडल।
वे इस पाइपलाइन को कैसे सुरक्षित करते हैं?
- स्रोत ट्रैकिंग: हर डेटासेट और मॉडल का सूक्ष्म दस्तावेज़ीकरण ताकि ट्रेसबिलिटी सुनिश्चित हो।
- वेंडर ऑडिट: HIPAA अनुपालन की तिमाही जाँच और डेटा अनॉनिमाइज़ेशन सुनिश्चित करना। वेंडर्स का वार्षिक सुरक्षा मूल्यांकन करा कर प्रमाणपत्र बनाए रखना।
- डेटा लीनिएज टूल्स: Anomalo जैसे टूल्स का उपयोग कर मरीज जनसांख्यिकी या इमेजिंग डेटा में अप्रत्याशित बदलावों को पकड़ना।
- पाइपलाइन मॉनिटरिंग: Looker में रीयल-टाइम डैशबोर्ड्स से डेटा फ्लो पर नज़र, ताकि किसी भी अनियमितता को तुरंत फ़्लैग किया जा सके।
इस तरह उनके पास एक सुरक्षित AI सप्लाई चेन होती है जो उनके डायग्नोस्टिक टूल को सटीक, विश्वसनीय और उद्योग मानकों के अनुरूप बनाती है।
नैतिक जोखिमों का समाधान
AI शक्तिशाली है, लेकिन गलत हाथों में यह शक्ति खतरनाक हो सकती है। यदि कोई AI सिस्टम हैक हो जाए या ख़राब डिज़ाइन किया गया हो, तो यह पक्षपातपूर्ण निर्णयों, अनैतिक परिणामों या दुरुपयोग तक ले जा सकता है। यह बड़ी बात है—खासकर तब, जब AI ऐसे निर्णय ले रहा हो जो वास्तविक जीवन को प्रभावित करते हैं, जैसे भर्ती, ऋण या स्वास्थ्य सेवा।
तो, हम AI सिस्टम को अधिक नैतिक और लचीला कैसे बनाते हैं? इसे चार प्रमुख चरणों में बाँटते हैं:
- स्पष्ट नियम और फ़्रेमवर्क विकसित करें: मज़बूत नींव से शुरुआत करें। इसका मतलब है ऐसी नीतियाँ बनाना जो आपके सिस्टम के लिए निष्पक्षता और नैतिकता को परिभाषित करें।
- AI टीमों को नैतिकता का प्रशिक्षण दें: यदि AI बनाने वाले लोग इन मुद्दों पर गंभीरता से सोचने के लिए सक्षम नहीं होंगे, तो आप AI से नैतिक व्यवहार की उम्मीद नहीं कर सकते। एथिक्स ट्रेनिंग टीमों को अवचेतन पूर्वाग्रहों को पहचानने व संबोधित करने, निष्पक्षता समझने और अपने काम के सामाजिक प्रभाव पर विचार करने में मदद करती है।
- AI निर्णयों को पारदर्शी बनाएं: पारदर्शिता का मतलब ऐसे सिस्टम डिज़ाइन करना है जो अपने निर्णय समझा सकें—किन कारकों पर विचार हुआ, उम्मीदवारों की तुलना कैसे हुई, और संभावित चिंताएँ कहाँ हैं। पारदर्शिता भरोसा और जवाबदेही बनाती है।
- AI सिस्टम को नियमित रूप से अपडेट करें: AI "सेट करो और भूल जाओ" नहीं है। नियमित ऑडिट पूर्वाग्रहों को पहचानने व घटाने, निष्पक्षता सुनिश्चित करने और नवीनतम उद्योग मानकों व कानूनी आवश्यकताओं के अनुरूप रहने में मदद करते हैं। निष्पक्षता स्थिर नहीं; यह निरंतर प्रक्रिया है।
यह रहा एक वास्तविक उदाहरण: एक बड़ी टेक कंपनी AI-संचालित भर्ती प्रणाली का उपयोग कर रही है। वे इसे नैतिक कैसे रखते हैं?
- स्पष्ट नियम विकसित करें: वे एक AI एथिक्स पॉलिसी बनाते हैं जो डेटा संग्रहण से लेकर निर्णय-निर्माण तक निष्पक्ष भर्ती के सिद्धांतों को रेखांकित करती है। एक AI एथिक्स बोर्ड इन नीतियों की निगरानी करता है ताकि जवाबदेही बनी रहे।
- टीमों को प्रशिक्षित करें: सिस्टम पर काम करने वाले सभी कर्मचारियों के लिए एथिक्स ट्रेनिंग अनिवार्य है। वे अनजाने पूर्वाग्रह और मशीन लर्निंग में निष्पक्षता पर कोर्स करते हैं और वास्तविक दुविधाओं पर वर्कशॉप में भाग लेते हैं।
- पारदर्शिता: भर्ती प्रणाली में एक्सप्लनेबिलिटी टूल्स शामिल हैं। हर सिफ़ारिश के लिए यह उन कारकों का ब्रेकडाउन देता है जिन्होंने निर्णय को प्रभावित किया—जैसे प्रमुख योग्यताएँ या किसी उम्मीदवार की दूसरों से तुलना। इससे HR मैनेजर्स के लिए निर्णयों की समीक्षा आसान हो जाती है।
- नियमित अपडेट: तिमाही ऑडिट भर्ती निर्णयों का पूर्वाग्रह के लिए विश्लेषण करते हैं और निष्पक्षता में सतत सुधार हेतु एडवर्सेरियल डीबायसिंग जैसी तकनीकों को लागू करते हैं। वे समान रोजगार क़ानूनों और उद्योग की सर्वोत्तम प्रक्रियाओं के नवीनतम संस्करणों से सिस्टम को अपडेट रखते हैं।
यह एक ऐसी भर्ती प्रणाली है जो नैतिक, निष्पक्ष और पारदर्शी है—भले ही संभावित समझौतों का सामना क्यों न हो।
एक्सप्लनेबिलिटी और भरोसे में चुनौतियाँ
AI सिस्टम को अक्सर “ब्लैक बॉक्स” माना जाता है, यानी उनका निर्णय-निर्माण समझना आसान नहीं होता। इससे समस्याएँ पहचानना या भरोसा बनाना कठिन हो सकता है। यदि आप AI टूल पर निर्भर डॉक्टर हैं या उसके निर्णय से प्रभावित मरीज, तो आपको सवाल नहीं, जवाब चाहिए। समाधान है—एक्सप्लनेबिलिटी। यहाँ चार रणनीतियाँ हैं जो AI सिस्टम को अधिक पारदर्शी और भरोसेमंद बनाती हैं:
- XAI टूल्स का उपयोग करें: ये टूल बताते हैं कि AI किसी निष्कर्ष तक कैसे पहुँचा। उदाहरण के लिए, LIME या SHAP दिखा सकते हैं कि किसी विशेष निर्णय को किन कारकों ने प्रभावित किया, जिससे सिस्टम की तर्क-शृंखला अधिक सुलभ हो जाती है।
- डेटा बदलावों को ट्रैक और दस्तावेज़ करें: जब आप हर बदलाव—कौन-सा डेटा जोड़ा, हटाया या संशोधित किया—दर्ज करते हैं, तो आप ट्रेस कर पाते हैं कि इन अपडेट्स का मॉडल के प्रदर्शन पर क्या असर पड़ा।
- नियमित रूप से सटीकता की पुष्टि करें: AI को आँख बंद करके सही न मानें। उसकी आउटपुट को मूल डेटा से मिलाएँ और जहाँ संभव हो, मानव विशेषज्ञों की राय लें। नियमित ऑडिट सुनिश्चित करते हैं कि सिस्टम तीक्ष्ण और निष्पक्ष बना रहे। भरोसा करें, लेकिन सत्यापित भी करें।
- लगातार परीक्षण और मॉनिटरिंग करें: AI “सेट करो और भूल जाओ” टूल नहीं है। विविध इनपुट्स के साथ बार-बार परीक्षण त्रुटियों को जल्दी पकड़ने में मदद करता है और रीयल-टाइम मॉनिटरिंग विभिन्न परिदृश्यों में सुसंगत प्रदर्शन सुनिश्चित करती है।
आइए देखें कि कोई अस्पताल AI डर्मेटोलॉजी डायग्नोस्टिक टूल—जो संभावित त्वचा स्थितियों की पहचान के लिए इमेज रिकग्निशन का उपयोग करता है—में भरोसा कैसे बनाता है।
- XAI टूल्स: अस्पताल LIME का उपयोग करता है, जो यह हाइलाइट करता है कि त्वचा की इमेज के कौन-से हिस्से निदान में सबसे अधिक प्रभावी रहे, ताकि डॉक्टर AI की तर्क-शृंखला समझ सकें और उस पर भरोसा कर सकें।
- डेटा बदलावों का ट्रैक रखना: एक डेटा लीनिएज टूल प्रशिक्षण डेटासेट में सभी अपडेट्स—जैसे नई इमेज जोड़ना या हटाना—लॉग करता है। इससे अस्पताल यह ट्रैक कर पाता है कि इन बदलावों का AI की सटीकता पर समय के साथ क्या प्रभाव पड़ा।
- सटीकता की पुष्टि: हर महीने, त्वचा रोग विशेषज्ञ AI के निदानों के एक रैंडम नमूने की समीक्षा करते हैं, उन्हें मूल मरीज डेटा और अपनी विशेषज्ञ राय से मिलाते हैं। लक्ष्य है कि सिस्टम उच्च स्तर की सटीकता और निष्पक्षता बनाए रखे।
- नियमित परीक्षण और मॉनिटरिंग: IT टीम साप्ताहिक रूप से विविध इमेजेस के साथ परीक्षण करती है, अलग-अलग त्वचा प्रकारों और स्थितियों में AI के प्रदर्शन की जाँच करती है। वे रीयल-टाइम में असामान्य पैटर्न पर भी नज़र रखते हैं ताकि समस्याएँ बढ़ने से पहले ही ठीक हो जाएँ।
यह AI टूल केवल स्मार्ट नहीं, बल्कि समझाने योग्य और भरोसेमंद भी है। डॉक्टर उसके निर्णय समझते हैं, मरीज अपनी देखभाल को लेकर आश्वस्त महसूस करते हैं, और अस्पताल सुनिश्चित करता है कि तकनीक निष्पक्ष और सटीक ढंग से काम करे।
निष्कर्ष
जैसे-जैसे AI हमारे जीवन का बड़ा हिस्सा बनता जा रहा है, उसे सुरक्षित रखना पहले से अधिक महत्वपूर्ण हो गया है। क्यों? क्योंकि वही शक्ति जो AI की क्षमताओं को आगे बढ़ाती है, उसे हमलों का निशाना भी बनाती है। एडवर्सेरियल अटैक्स, डेटा पॉइज़निंग और मॉडल चोरी जैसे खतरे AI के कामकाज को गंभीर रूप से बाधित कर सकते हैं।
तो, हम AI की रक्षा कैसे करें? हमने सीखा कि यह एक-सा सब पर लागू होने वाला समाधान नहीं है। एडवर्सेरियल ट्रेनिंग, नियमित ऑडिट और लेयर्ड सेफ़गार्ड्स जैसी तकनीकें जोखिम घटा सकती हैं और आपके सिस्टम को अधिक मज़बूत बना सकती हैं।
अब आती है जेनरेटिव AI। बड़े भाषा मॉडल शानदार अवसर लाते हैं, लेकिन वे नई कमज़ोरियाँ भी पेश करते हैं। भ्रामक सामग्री पैदा करने से लेकर हानिकारक आउटपुट देने के लिए हेरफेर तक—इन टूल्स की सावधानीपूर्वक निगरानी ज़रूरी है। लेख How to Build Guardrails for Large Language Models में, LLMs को अपेक्षित व्यवहार में रखने के लिए सेफ़्टी उपायों का अन्वेषण किया गया है।
नैतिकता और पारदर्शिता अपरिहार्य हैं। AI सिस्टम निष्पक्ष, समझाने योग्य और भरोसेमंद होने चाहिए। पूर्वाग्रह और दुरुपयोग भरोसे को खोखला कर सकते हैं—और आज की तकनीक-चालित दुनिया में भरोसा ही सब कुछ है। लोग उस तकनीक का उपयोग नहीं करेंगे जिस पर वे भरोसा नहीं करते।
अंततः, आगे बने रहना कुंजी है। AI खतरे लगातार विकसित हो रहे हैं। व्यवसायों को अपनी सुरक्षा रणनीतियों को नियमित रूप से अपडेट करना चाहिए, नए जोखिमों की गति के साथ तालमेल रखते हुए सुरक्षित रहना चाहिए।कुंजी है—सक्रिय रहना, सतर्क रहना, और नैतिकता व पारदर्शिता के प्रति प्रतिबद्ध रहना—और इसी तरह, व्यवसाय भरोसा बना सकते हैं और AI के फ़ायदों का पूरा लाभ उठा सकते हैं।


AI इतनी तेजी से विकसित हो रहा है कि उसकी सुरक्षा चुनौतियों के साथ कदम मिलाना मानो हवा में उड़ते विमान की मरम्मत करने जैसा लगता है। जैसे-जैसे सिस्टम स्मार्ट होते जा रहे हैं और रोज़मर्रा की व्यावसायिक प्रक्रियाओं में गहराई से समाहित हो रहे हैं, वे नए प्रकार के खतरों के प्रति अधिक संवेदनशील भी बनते जा रहे हैं।
मैंने इसे अपने काम में क़रीब से देखा है। कई बार मुझे व्यावसायिक प्रक्रियाओं में ऐसे सुरक्षा छिद्र मिले हैं जिनसे किसी को वह संवेदनशील जानकारी मिल सकती थी जो उन्हें नहीं मिलनी चाहिए थी—खासकर तब, जब AI समाधान बिना उचित सुरक्षा उपायों के जल्दबाज़ी में लागू किए गए थे।
यही इस लेख का विषय है: AI को सुरक्षित रखने के जोखिम, चुनौतियाँ, और सर्वोत्तम प्रक्रियाएँ समझना। AI इतनी तेज़ी से बढ़ रहा है कि यदि हम कमज़ोरियों से आगे नहीं रहे, तो हम उससे मिलने वाले भरोसे और फ़ायदों को खोने का जोखिम उठाते हैं।
यदि आप इस विषय को और विस्तार से सीखना चाहते हैं, तो मैं AI Security and Risk Management कोर्स देखने की सलाह देता/देती हूँ।
नई AI सुरक्षा चुनौतियाँ
AI डेटा पर चलता है। और जितना अधिक डेटा आपका AI इस्तेमाल करता है, उतना बड़ा लक्ष्य बनता है। हैकर्स यह जानते हैं। कल्पना कीजिए कि कोई अस्पताल मरीजों के स्वास्थ्य जोखिमों की भविष्यवाणी के लिए AI का उपयोग कर रहा है। बढ़िया लगता है—तब तक, जब तक कोई सिस्टम हैक न कर दे। अचानक, निजी मरीज रिकॉर्ड डार्क वेब पर बिकने लगते हैं, या उससे भी बुरा, चिकित्सा डेटा में फेरबदल हो जाता है, जो हानिकारक निर्णयों तक ले जा सकता है। संवेदनशील डेटा को एन्क्रिप्ट करना और बैकअप रखना अहम है, लेकिन कई कंपनियाँ नवाचार में इतनी मग्न होती हैं कि ये बुनियादी बातें नज़रअंदाज़ कर देती हैं।
और हैकर्स केवल डेटा चुराते ही नहीं हैं। वे AI मॉडलों से भी छेड़छाड़ कर सकते हैं। उदाहरण के लिए, किसी सेल्फ-ड्राइविंग कार को स्टॉप साइन को स्पीड लिमिट साइन समझने में गुमराह करना। इस प्रकार के हमले को डेटा पॉइज़निंग अटैक कहा जाता है, जहाँ हमलावर सिस्टम में खराब डेटा डालकर उसके निर्णयों को बिगाड़ देते हैं। अगले खंड में हम इसे विस्तार से देखेंगे।
प्रॉम्प्ट इंजेक्शन अटैक भी एक प्रकार का हमला है। ये सूक्ष्म छेड़छाड़ें हैं जो AI को किसी ऐसी बात—या काम—के लिए उकसाती हैं जो उसे नहीं करना चाहिए। हमारे पास प्रॉम्प्ट इंजेक्शन पर एक शानदार लेख है, इसलिए हम इस लेख में बहुत विस्तार में नहीं जाएँगे, लेकिन यह ज़रूर पढ़ने लायक है।
विडंबना यह है कि हैकर्स भी हैकिंग के लिए AI का उपयोग कर रहे हैं। यही वह जगह है जहाँ साइबर सुरक्षा समय के साथ दौड़ बन जाती है—हैकर्स नवाचार करते हैं, और सुरक्षा टीमें उतनी ही तेज़ी से जवाब देती हैं। एनोमली डिटेक्शन जैसे टूल मदद कर सकते हैं, लेकिन वे अचूक नहीं हैं।
क्या आपने यह कहावत सुनी है, "ज़ंजीर उतनी ही मज़बूत होती है जितनी उसकी सबसे कमज़ोर कड़ी"? यह AI पर पूरी तरह लागू होती है। कंपनियाँ अक्सर अपने सिस्टम में प्री-बिल्ट AI टूल्स एकीकृत करती हैं। लेकिन यदि उन टूल्स में से कोई एक समझौता कर लिया जाए तो क्या होगा? कल्पना करें कि सैकड़ों व्यवसायों द्वारा इस्तेमाल किया जाने वाला कोई लोकप्रिय चैटबॉट हैक हो जाए। तब सैकड़ों कंपनियाँ—और उनके समस्त ग्राहक डेटा—जोखिम में हैं। यह एक डिजिटल डोमिनो प्रभाव है।
अंततः, विशेषज्ञता का अंतर भी है। AI अपनाने की रफ्तार बढ़ रही है, लेकिन AI के लिए साइबर सुरक्षा अब भी पीछे-पीछे चल रही है।
AI सुरक्षा खतरे
AI सिस्टम ऐसे गंभीर सुरक्षा खतरों का सामना करते हैं जो उनकी कार्यकुशलता और विश्वसनीयता को प्रभावित कर सकते हैं। आइए प्रमुख खतरों पर नज़र डालते हैं।
एडवर्सेरियल अटैक्स
एडवर्सेरियल अटैक्स, AI द्वारा प्रोसेस किए जाने वाले इनपुट्स में छोटी, चुपके से की गई बदलावों के ज़रिए सिस्टम को धोखा देते हैं। ये बदलाव इतने सूक्ष्म होते हैं कि इंसान अक्सर उन्हें नोटिस भी नहीं कर पाते, लेकिन AI पूरी तरह भ्रमित होकर ग़लत निर्णय ले सकता है।
उदाहरण के लिए:
इन हमलों के लिए हमलावर को AI के आंतरिक कामकाज का पता होना ज़रूरी नहीं होता, जो इन्हें पकड़ना और रोकना और भी कठिन बना देता है।
अब कुछ वास्तविक उदाहरण देखते हैं।
यह आरेख चिकित्सा इमेजिंग AI सिस्टम पर एक एडवर्सेरियल अटैक को दर्शाता है। मूल एक्स-रे, जिसे सही ढंग से "फेफड़ों के कैंसर का उच्च जोखिम" के रूप में वर्गीकृत किया गया था, में सूक्ष्म एडवर्सेरियल शोर जोड़कर इसे "स्वस्थ फेफड़े" के रूप में गलत वर्गीकृत करा दिया गया।
एक बेहतरीन लेख है Adversarial Machine Learning, जो मशीन लर्निंग मॉडलों की कमज़ोरियों का फ़ायदा उठाने वाले हमलों का अध्ययन करता है और उनसे बचाव के उपाय विकसित करता है।
पॉइज़निंग अटैक्स
पॉइज़निंग अटैक्स AI सिस्टम के प्रशिक्षण चरण को निशाना बनाते हैं, जहाँ मॉडल निर्णय लेना सीखता है। हमलावर प्रशिक्षण सेट में भ्रष्ट या भ्रामक डेटा घुसा देते हैं ताकि AI को गलत व्यवहार करने या पक्षपातपूर्ण परिणाम देने के लिए प्रभावित किया जा सके। ये हमले इसलिए कारगर होते हैं क्योंकि वे AI की सीखने की नींव से छेड़छाड़ करते हैं, और अक्सर कोई स्पष्ट निशान नहीं छोड़ते।
इसमें शामिल हो सकता है:
ये सूक्ष्म बदलाव AI को कुछ परिस्थितियों में विफल कर सकते हैं या उसे हमलावर के हित में काम करने पर मजबूर कर सकते हैं। चूँकि हमला प्रशिक्षण के दौरान होता है, मॉडल के तैनात होने के बाद इसे पहचानना कठिन होता है।
कुछ वास्तविक उदाहरण देखें:
यह आरेख एक ऐसे पॉइज़निंग अटैक को दर्शाता है जो झूठे और सही बीमा दावों को वर्गीकृत करने वाली AI प्रणाली पर किया गया है। पहले पैनल में, सिस्टम साफ़ प्रशिक्षण डेटासेट का उपयोग कर झूठे (लाल) और सही (काला) दावों को सही ढंग से अलग करता है। दूसरे पैनल में, दुर्भावनापूर्ण रूप से गलत-लेबल किया गया डेटा (“ज़हर”) निर्णय सीमा को खिसका देता है, जिससे झूठे दावे सही के रूप में गलत वर्गीकृत होने लगते हैं और सिस्टम की विश्वसनीयता व सुरक्षा से समझौता होता है।
मॉडल एक्सट्रैक्शन अटैक्स
मॉडल एक्सट्रैक्शन अटैक में हमलावर, AI मॉडल को रिवर्स-इंजीनियर करके उसके काम करने के तरीके का पता लगा लेते हैं। वे एकत्रित इनपुट और आउटपुट का उपयोग कर सिस्टम के डिज़ाइन और व्यवहार की नकल बनाते हैं।
एक बार जब वे मॉडल की एक प्रतिकृति बना लेते हैं, तो वे यह कर सकते हैं:
उदाहरण के लिए, यदि चोरी किया गया मॉडल निजी ग्राहक डेटा पर प्रशिक्षित था, तो हमलावर उन ग्राहकों के बारे में व्यक्तिगत विवरणों की भविष्यवाणी कर सकता है या अपने उपयोग के लिए मॉडल का कस्टमाइज़्ड संस्करण बना सकता है।
कुछ वास्तविक उदाहरण देखें:
यह आरेख एक मॉडल एक्सट्रैक्शन अटैक दर्शाता है, जहाँ हमलावर क्वेरी भेजकर और प्रेडिक्शंस एकत्रित करके पीड़ित AI मॉडल के साथ इंटरैक्ट करता है। हमलावर संकलित डेटा का उपयोग कर एक प्रतिकृति मॉडल प्रशिक्षित करता है और अंततः मूल सिस्टम का चुराया हुआ संस्करण पुनर्निर्मित कर लेता है।
AI सुरक्षा के बचाव उपाय
पिछले खंडों में हमने बताया कि जैसे-जैसे AI आम होता जा रहा है, हमलों से बचाने के लिए मज़बूत सुरक्षा उपाय लागू करना ज़रूरी है। आइए कुछ प्रभावी तरीकों पर बात करते हैं जो AI को अधिक सुरक्षित बनाते हैं।
एडवर्सेरियल ट्रेनिंग
इस विधि में मॉडलों को चालाकी से बदले गए इनपुट्स (एडवर्सेरियल उदाहरण) पहचानना और संभालना सिखाया जाता है। जब आप ऐसे उदाहरणों के साथ मॉडल को प्रशिक्षित करते हैं, तो वह कुछ प्रकार के हमलों के प्रति अधिक प्रतिरोधी हो जाता है।
डिफेंसिव डिस्टिलेशन
LLM डिस्टिलेशन में एक द्वितीयक मॉडल को मूल मॉडल के व्यवहार की नकल करने के लिए प्रशिक्षित किया जाता है ताकि हमलावरों के लिए उसे प्रभावित करना कठिन हो जाए।
इनपुट वैलिडेशन और सैनिटाइज़ेशन
AI सिस्टम में जाने वाला डेटा साफ़ और सुरक्षित हो—यह सुनिश्चित करना, उसे दुर्भावनापूर्ण इनपुट्स से बचाने की कुंजी है।
एंसेंबल मेथड्स
कई अलग-अलग AI मॉडलों को साथ में उपयोग करना (एंसेंबल) सिस्टम को अधिक सुरक्षित बना सकता है। भले ही एक मॉडल पर हमला हो जाए, बाकी बैकअप दे सकते हैं।
एक्सप्लनेबल AI (XAI)
AI सिस्टम को समझाने योग्य बनाना लोगों को यह समझने में मदद करता है कि वे कैसे काम करते हैं और किसी भी कमज़ोरी या असामान्य व्यवहार का पता चलता है। आप इस विषय को विस्तार से Explainable AI in Python कोर्स में देख सकते हैं।
नियमित सुरक्षा ऑडिट
AI सिस्टम की नियमित जाँच कमजोरियों को जल्दी पकड़ने और समय के साथ उन्हें सुरक्षित बनाए रखने में मदद करती है।
इन रणनीतियों का उपयोग AI सिस्टम को अधिक सुरक्षित बनाता है और हमलों से बेहतर सुरक्षा देता है। लेकिन बात यह है—AI सुरक्षा "सेट करो और भूल जाओ" वाली चीज़ नहीं है। यह एक सतत प्रक्रिया है।
जैसे-जैसे नए खतरे सामने आते हैं—और यक़ीन मानिए, वे हमेशा आते हैं—व्यवसायों को सतर्क रहना चाहिए। इसका मतलब है कमज़ोरियों की लगातार निगरानी करना, सिस्टम्स को अपडेट करना, और रक्षाओं में सुधार करना।
विधि
कैसे काम करता है
क्यों सहायक है
कमज़ोरियाँ
एडवर्सेरियल ट्रेनिंग
बदले हुए डेटा के उदाहरण बनाकर उन्हें AI के प्रशिक्षण में शामिल करें।
सिस्टम को धोखा देने की कोशिश करने वाले एडवर्सेरियल अटैक्स के विरुद्ध मजबूती बढ़ती है।
सामान्य (क्लीन) डेटा पर AI की सटीकता थोड़ी कम हो सकती है।
डिफेंसिव डिस्टिलेशन
मूल मॉडल के व्यवहार की नकल करने के लिए एक द्वितीयक मॉडल प्रशिक्षित करें, जिससे निर्णय-निर्माण प्रक्रिया स्मूथ हो।
मॉडल की कमज़ोरियों का फायदा उठाना हमलावरों के लिए कठिन बनता है।
खासतौर पर बड़े मॉडलों के लिए बहुत अधिक कंप्यूटिंग शक्ति चाहिए।
इनपुट वैलिडेशन एवं सैनिटाइज़ेशन
जाँचें कि इनपुट सही फ़ॉर्मैट में हों, अपेक्षित सीमाओं में हों, और हानिकारक तत्व न हों।
डेटा पॉइज़निंग रोकता है और AI सिस्टम का सुचारू संचालन सुनिश्चित करता है।
कई चरणों पर सावधानीपूर्वक कार्यान्वयन की आवश्यकता।
एंसेंबल मेथड्स
निर्णय लेने के लिए कई मॉडलों की भविष्यवाणियों को मिलाएँ।
हमलावरों के लिए सभी मॉडलों से एक साथ समझौता करना कठिन होता है।
कई मॉडलों को प्रबंधित और मेंटेन करने हेतु अधिक कंप्यूटिंग संसाधन चाहिए।
एक्सप्लनेबल AI (XAI)
AI निर्णयों को समझाने के लिए LIME, SHAP या अटेंशन मैकेनिज़्म जैसे टूल उपयोग करें।
भरोसा बढ़ता है और पूर्वाग्रह या असामान्य व्यवहार जैसी समस्याएँ पहचानना और ठीक करना आसान होता है।
सरल, समझाने योग्य मॉडल जटिल मॉडलों जितना अच्छा प्रदर्शन नहीं कर सकते।
नियमित सुरक्षा ऑडिट
कमज़ोरियों की पहचान के लिए वल्नरेबिलिटी असेसमेंट, पेनिट्रेशन टेस्ट और कोड रिव्यू करें।
संभावित सुरक्षा खामियों की पहचान करता है और विनियमों का अनुपालन सुनिश्चित करता है।
सिस्टम की जटिलता पर निर्भर करते हुए संसाधन-गहन हो सकता है।
AI सुरक्षा में नए रुझान
इस खंड में, हम उन नए रुझानों को देख रहे हैं जो AI सिस्टम को सुरक्षित, सटीक और भरोसेमंद बनाए रखते हैं।
AI मॉडलों और डेटा अखंडता की सुरक्षा
सबसे पहले, आइए समझें कि AI मॉडलों और डेटा की सुरक्षा क्यों महत्वपूर्ण है।
तो, वास्तव में आप अपने AI को कैसे सुरक्षित रख सकते हैं? ये कुछ मुख्य रणनीतियाँ हैं:
इसे एक वास्तविक परिदृश्य से समझते हैं। मान लीजिए, एक बड़ी अंतरराष्ट्रीय बैंक ने धोखाधड़ी वाले लेन-देन का पता लगाने के लिए AI मॉडल विकसित किया है। यह सिस्टम रोज़ाना लाखों लेन-देन संभालता है, संदिग्ध पैटर्न पहचानता है और धोखाधड़ी को फ़्लैग करता है।
बैंक ने इस सिस्टम को बनाने में 5 करोड़ डॉलर और तीन साल लगाए। यदि यह चोरी हो जाए, तो प्रतियोगी बिना एक पैसा लगाए इसका इस्तेमाल कर सकते हैं, जिससे बैंक अपनी बढ़त खो देगा।
यह मॉडल लाखों ग्राहकों के संवेदनशील वित्तीय डेटा को प्रोसेस करता है। कोई भी उल्लंघन इस जानकारी को उजागर कर सकता है, जिससे GDPR जैसे क़ानूनों के तहत भारी जुर्माने लग सकते हैं।
यदि हैकर्स प्रशिक्षण के दौरान नकली डेटा इंजेक्ट कर दें, तो वे AI को कुछ धोखाधड़ी पैटर्न न पहचानने के लिए सिखा सकते हैं, जिससे बैंक असुरक्षित हो जाएगा।
परिष्कृत हमलावर मॉडल की आउटपुट से निजी ग्राहक विवरण भी निकाल सकते हैं।
बैंक इसकी सुरक्षा कैसे करता है?
इससे एक अधिक सुरक्षित, विश्वसनीय AI सिस्टम बनता है जो ग्राहक डेटा को सुरक्षित रखता है और धोखाधड़ी की पहचान प्रभावी रूप से करने के अपने वादे पर खरा उतरता है। यह बैंक और उसके ग्राहकों—दोनों के लिए फ़ायदेमंद है।
इवेज़न और पॉइज़निंग अटैक्स के खिलाफ़ रक्षा
मान लीजिए आप एक उच्च-सुरक्षा सुविधा चला रहे हैं जो हर चीज़ को सुरक्षित रखने के लिए फ़ेशियल रिकग्निशन पर निर्भर है। हालाँकि, हमने जाना है कि AI सिस्टम एडवर्सेरियल इनपुट्स या ज़हरीले प्रशिक्षण डेटा जैसे हमलों के प्रति संवेदनशील हैं। हैकर्स सिस्टम में हेरफेर करके अंदर घुस सकते हैं।
आइए चार प्रमुख रक्षा उपायों को समझें जो हमलावरों को रास्ते में ही रोक सकते हैं:
सिस्टम सिर्फ़ स्मार्ट नहीं, सतर्क भी है। हर इनपुट को आगे बढ़ने से पहले वैधता साबित करनी होती है।
AI सप्लाई चेन की सुरक्षा
AI की सुरक्षा का मतलब है डेटा अखंडता का प्रबंधन, स्वामित्व वाले मॉडलों की रक्षा, और यह सुनिश्चित करना कि सब कुछ आपकी मौजूदा साइबरसुरक्षा व्यवस्था के साथ सामंजस्य में हो। साथ ही विकसित होते खतरों, विनियामक अनुपालन, नैतिकता और सप्लाई चेन कमजोरियों को भी संबोधित करना होता है। यहाँ AI लाइफ़साइकल को सुरक्षित करने की कुछ रणनीतियाँ हैं:
यह रहा एक वास्तविक उदाहरण। मान लें कि कोई हेल्थकेयर कंपनी AI-संचालित डायग्नोस्टिक टूल विकसित कर रही है। इसकी सप्लाई चेन में शामिल हैं:
वे इस पाइपलाइन को कैसे सुरक्षित करते हैं?
इस तरह उनके पास एक सुरक्षित AI सप्लाई चेन होती है जो उनके डायग्नोस्टिक टूल को सटीक, विश्वसनीय और उद्योग मानकों के अनुरूप बनाती है।
नैतिक जोखिमों का समाधान
AI शक्तिशाली है, लेकिन गलत हाथों में यह शक्ति खतरनाक हो सकती है। यदि कोई AI सिस्टम हैक हो जाए या ख़राब डिज़ाइन किया गया हो, तो यह पक्षपातपूर्ण निर्णयों, अनैतिक परिणामों या दुरुपयोग तक ले जा सकता है। यह बड़ी बात है—खासकर तब, जब AI ऐसे निर्णय ले रहा हो जो वास्तविक जीवन को प्रभावित करते हैं, जैसे भर्ती, ऋण या स्वास्थ्य सेवा।
तो, हम AI सिस्टम को अधिक नैतिक और लचीला कैसे बनाते हैं? इसे चार प्रमुख चरणों में बाँटते हैं:
यह रहा एक वास्तविक उदाहरण: एक बड़ी टेक कंपनी AI-संचालित भर्ती प्रणाली का उपयोग कर रही है। वे इसे नैतिक कैसे रखते हैं?
यह एक ऐसी भर्ती प्रणाली है जो नैतिक, निष्पक्ष और पारदर्शी है—भले ही संभावित समझौतों का सामना क्यों न हो।
एक्सप्लनेबिलिटी और भरोसे में चुनौतियाँ
AI सिस्टम को अक्सर “ब्लैक बॉक्स” माना जाता है, यानी उनका निर्णय-निर्माण समझना आसान नहीं होता। इससे समस्याएँ पहचानना या भरोसा बनाना कठिन हो सकता है। यदि आप AI टूल पर निर्भर डॉक्टर हैं या उसके निर्णय से प्रभावित मरीज, तो आपको सवाल नहीं, जवाब चाहिए। समाधान है—एक्सप्लनेबिलिटी। यहाँ चार रणनीतियाँ हैं जो AI सिस्टम को अधिक पारदर्शी और भरोसेमंद बनाती हैं:
आइए देखें कि कोई अस्पताल AI डर्मेटोलॉजी डायग्नोस्टिक टूल—जो संभावित त्वचा स्थितियों की पहचान के लिए इमेज रिकग्निशन का उपयोग करता है—में भरोसा कैसे बनाता है।
यह AI टूल केवल स्मार्ट नहीं, बल्कि समझाने योग्य और भरोसेमंद भी है। डॉक्टर उसके निर्णय समझते हैं, मरीज अपनी देखभाल को लेकर आश्वस्त महसूस करते हैं, और अस्पताल सुनिश्चित करता है कि तकनीक निष्पक्ष और सटीक ढंग से काम करे।
निष्कर्ष
जैसे-जैसे AI हमारे जीवन का बड़ा हिस्सा बनता जा रहा है, उसे सुरक्षित रखना पहले से अधिक महत्वपूर्ण हो गया है। क्यों? क्योंकि वही शक्ति जो AI की क्षमताओं को आगे बढ़ाती है, उसे हमलों का निशाना भी बनाती है। एडवर्सेरियल अटैक्स, डेटा पॉइज़निंग और मॉडल चोरी जैसे खतरे AI के कामकाज को गंभीर रूप से बाधित कर सकते हैं।
तो, हम AI की रक्षा कैसे करें? हमने सीखा कि यह एक-सा सब पर लागू होने वाला समाधान नहीं है। एडवर्सेरियल ट्रेनिंग, नियमित ऑडिट और लेयर्ड सेफ़गार्ड्स जैसी तकनीकें जोखिम घटा सकती हैं और आपके सिस्टम को अधिक मज़बूत बना सकती हैं।
अब आती है जेनरेटिव AI। बड़े भाषा मॉडल शानदार अवसर लाते हैं, लेकिन वे नई कमज़ोरियाँ भी पेश करते हैं। भ्रामक सामग्री पैदा करने से लेकर हानिकारक आउटपुट देने के लिए हेरफेर तक—इन टूल्स की सावधानीपूर्वक निगरानी ज़रूरी है। लेख How to Build Guardrails for Large Language Models में, LLMs को अपेक्षित व्यवहार में रखने के लिए सेफ़्टी उपायों का अन्वेषण किया गया है।
नैतिकता और पारदर्शिता अपरिहार्य हैं। AI सिस्टम निष्पक्ष, समझाने योग्य और भरोसेमंद होने चाहिए। पूर्वाग्रह और दुरुपयोग भरोसे को खोखला कर सकते हैं—और आज की तकनीक-चालित दुनिया में भरोसा ही सब कुछ है। लोग उस तकनीक का उपयोग नहीं करेंगे जिस पर वे भरोसा नहीं करते।
अंततः, आगे बने रहना कुंजी है। AI खतरे लगातार विकसित हो रहे हैं। व्यवसायों को अपनी सुरक्षा रणनीतियों को नियमित रूप से अपडेट करना चाहिए, नए जोखिमों की गति के साथ तालमेल रखते हुए सुरक्षित रहना चाहिए।कुंजी है—सक्रिय रहना, सतर्क रहना, और नैतिकता व पारदर्शिता के प्रति प्रतिबद्ध रहना—और इसी तरह, व्यवसाय भरोसा बना सकते हैं और AI के फ़ायदों का पूरा लाभ उठा सकते हैं।