
Kursus
Keamanan AI dan Manajemen Risiko
2 jam
11.8K
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleAI dan ML biasanya digunakan secara bergantian. Namun jika saya harus mendefinisikannya dan menunjukkan perbedaannya secara singkat, saya akan mengatakan bahwa AI merujuk pada teknologi yang membangun mesin untuk meniru fungsi kognitif yang terkait dengan kecerdasan manusia, sementara ML merujuk pada subkumpulan algoritma AI yang belajar dan meningkatkan kemampuan dari data.
Dalam artikel ini, saya ingin menelusuri penerapan teknik pembelajaran mesin dalam keamanan siber, menampilkan beragam use case serta tantangan keterjelasan, interpretabilitas, dan ketangguhan yang harus diatasi untuk memanfaatkan potensinya.
Deteksi dan respons ancaman mengacu pada deteksi ancaman siber terhadap jaringan atau sistem, diikuti dengan strategi mitigasi yang cepat dan efektif. Proses ini melibatkan pendeteksian perilaku anomali dalam jaringan dan sistem, mengidentifikasi intrusi tidak sah, dan menganalisis sampel malware untuk melindungi sistem kita.
Mendeteksi anomali mengacu pada identifikasi pola dalam data yang tidak sesuai dengan konsep perilaku normal yang terdefinisi dengan baik.
Konsep mendasar ini berlaku di berbagai bidang, dan keamanan siber tidak terkecuali. Saya menggunakan deteksi anomali untuk mengidentifikasi beragam aktivitas berbahaya seperti mendeteksi eksfiltrasi data, serangan Distributed Denial of Service (DDoS), infeksi malware, dan lainnya.Beragam algoritma pembelajaran mesin, seperti Local outlier factor (LOF), Isolation forest, One-class support vector machine (OC-SVM), telah digunakan untuk mendeteksi anomali. Namun, memilih teknik yang tepat untuk mengidentifikasi outlier adalah tugas kompleks yang memerlukan pertimbangan cermat terhadap beberapa faktor, termasuk:
Kita akan mengeksplorasi bagaimana kita memilih teknik pembelajaran mesin yang tepat dan juga menjelaskan bagaimana teknik tersebut mendeteksi aktivitas keamanan siber yang berbahaya. Fokus kita akan pada dua penerapan penting dalam keamanan siber: deteksi intrusi dan analisis malware.
Sistem deteksi intrusi (IDS) adalah mata dan telinga jaringan serta sistem komputer, memantau dan menganalisis lalu lintas jaringan (IDS berbasis jaringan) dan panggilan sistem (IDS berbasis host) untuk aktivitas berbahaya.
Sepanjang eksperimen saya, saya menyaksikan kekuatan pendekatan deteksi anomali untuk kedua sistem dalam mendeteksi keberadaan ancaman baru atau yang sebelumnya tidak dikenal yang lolos dari teknik berbasis tanda tangan, yang bergantung pada pola serangan yang telah ditentukan untuk deteksi.
Sebelum menyelami IDS berbasis host, penting untuk memahami apa itu panggilan sistem. Ini pada dasarnya adalah permintaan yang dibuat oleh suatu program kepada sistem operasi untuk menjalankan tugas tertentu. Misalkan Anda menggunakan editor teks untuk mengubah file pada sistem operasi Linux. Di balik layar, editor teks Anda meminta untuk membuka file menggunakan panggilan sistem open(), menulis perubahan ke dalamnya menggunakan write(), lalu menyimpannya dengan menutup file menggunakan close().
Sementara panggilan sistem editor teks itu lugas dan dapat diprediksi, urutan panggilan sistem pelaku jahat sering kali menipu. Program berbahaya mungkin menggunakan rangkaian seperti open(), write() untuk menjatuhkan file tersembunyi, lalu menggunakan execve() untuk mengeksekusinya dengan hak istimewa yang ditingkatkan. Ini diikuti dengan panggilan terkait jaringan seperti socket() untuk berpotensi membangun saluran command-and-control.
Untuk mengatasinya, urutan panggilan sistem sering diubah menjadi representasi fitur statis yang cocok untuk algoritma pembelajaran mesin. Namun, Anda mungkin bertanya-tanya, teknik pembelajaran mana yang paling sesuai untuk melatih model pembelajaran mesin dalam kasus ini?
Pilihan teknik pembelajaran sangat bergantung pada ketersediaan label. Jika tersedia kumpulan data seimbang yang terdiri dari urutan panggilan sistem normal dan anomali, saya tentu akan memilih model deteksi anomali terawasi seperti Support Vector Machines (SVM).
Sebaliknya, jika tidak ada data berlabel, saya dapat menggunakan model pembelajaran tak terawasi seperti Isolation Forest. Untuk skenario di mana hanya perilaku normal yang terwakili dalam data pelatihan, saya mencari teknik pembelajaran semi-terawasi seperti One-Class SVM atau DBSCAN.
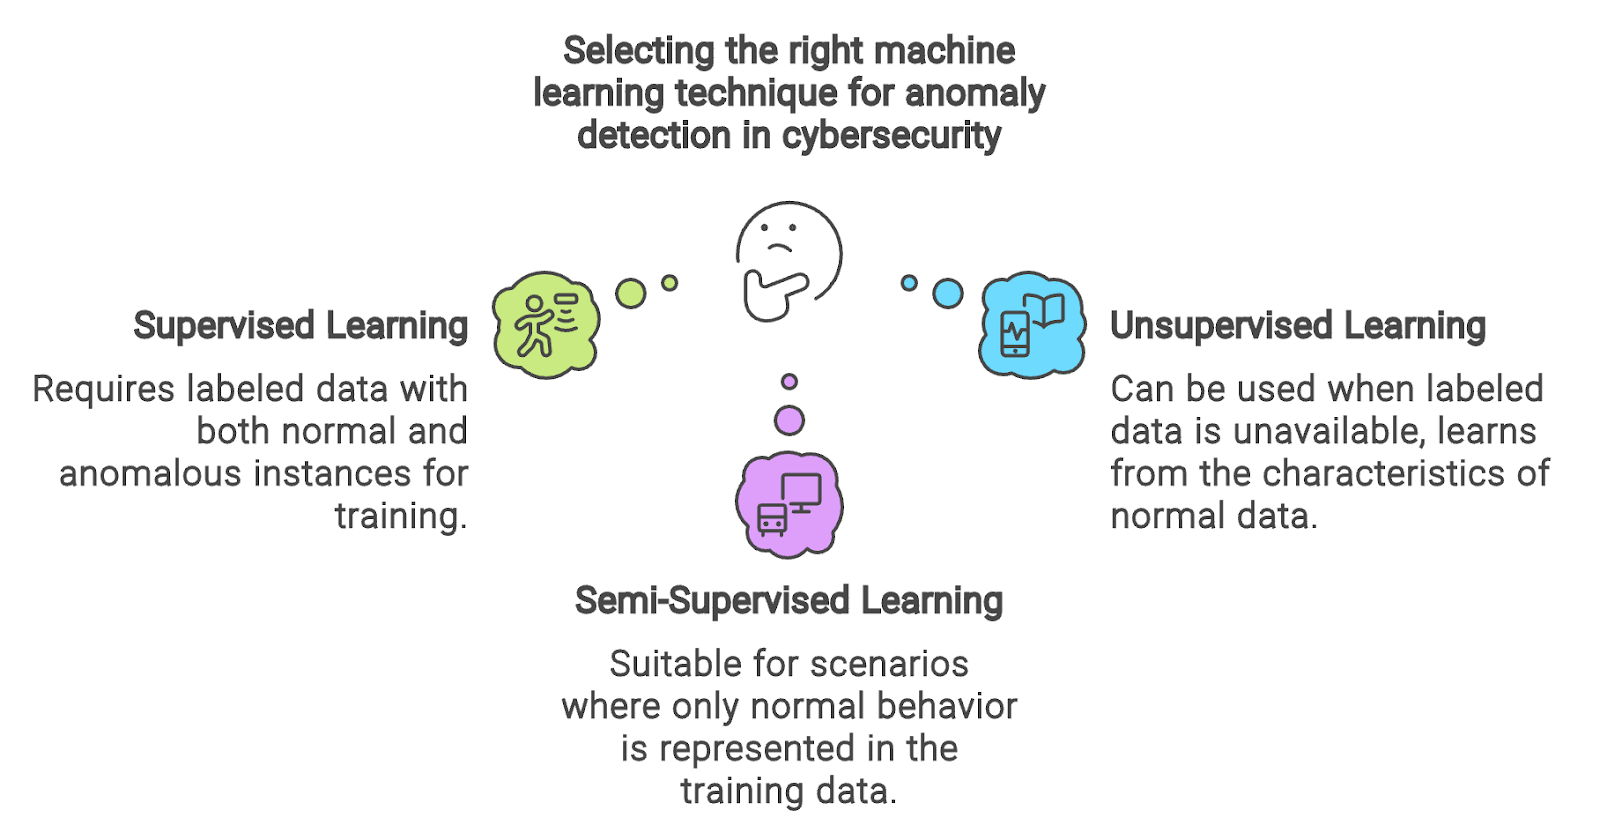
Diagram dibuat dengan Napkin.ai
Sekarang setelah kita memahami bagaimana ML diterapkan pada IDS berbasis host, mari beralih ke ranah IDS berbasis jaringan. Sementara sistem berbasis host berfokus pada mesin individu, IDS berbasis jaringan mengidentifikasi intrusi dalam data jaringan; yaitu, alih-alih menganalisis panggilan sistem, IDS jaringan memeriksa aktivitas pencurian informasi dan gangguan jaringan dengan memantau statistik aliran jaringan, data payload, dan header paket.
Sekilas pada tabel berikut dapat membantu Anda mendapatkan gambaran tentang seperti apa kumpulan data aliran jaringan.
|
Port Tujuan |
Port Sumber |
Durasi Aliran (ms) |
Total Paket Maju |
Total Paket Mundur |
Label |
|
54865 |
9910 |
6 |
5000 |
600 |
0 |
|
54810 |
9010 |
2 |
2000 |
200 |
1 |
Statistik aliran jaringan normal dan abnormal sintetis.
Setiap baris dalam kumpulan data merepresentasikan sesi komunikasi jaringan independen antara dua titik akhir, tanpa hubungan bawaan dengan aliran lain dalam kumpulan data.
Setiap aliran didefinisikan oleh atribut seperti nomor port sumber dan tujuan, durasi aliran dalam milidetik, dan total jumlah paket yang dipertukarkan dalam kedua arah. Label kategorikal menunjukkan apakah aliran jaringan diklasifikasikan sebagai anomali atau serangan, memberikan ground truth penting untuk model deteksi intrusi.
Perlu dicatat, setiap baris merepresentasikan aliran jaringan independen tanpa ketergantungan berurutan atau relasional pada aliran jaringan lain dalam kumpulan data.
Mengingat sifat aliran jaringan yang independen, kumpulan data dapat dimasukkan setelah beberapa teknik rekayasa fitur ke dalam algoritma pembelajaran mesin untuk deteksi anomali. Seperti dibahas sebelumnya dalam konteks IDS berbasis host, pemilihan teknik pembelajaran mesin yang sesuai bergantung pada ketersediaan data berlabel.
Sebelum memasuki analisis malware, kita harus terlebih dahulu menjelaskan apa itu malware dan bagaimana cara kerjanya.
Malware adalah istilah untuk perangkat lunak berbahaya atau executable biner yang dirancang untuk menjalankan niat jahat penyerang. Potongan kode ini dengan sengaja mengeksploitasi kerentanan pada sistem target untuk mengompromikan integritasnya, mencuri data sensitif, menghapus data, dan bahkan mengenkripsi data untuk tebusan. Malware dapat hadir dalam banyak kategori, termasuk virus, worm, spyware, trojan, ransomware, dan lain-lain.
Untuk memahami jenis malware, fungsionalitasnya, dan potensi dampaknya, beberapa fitur diekstrak dari analisis statis dan dinamis lalu dimasukkan ke dalam algoritma pembelajaran mesin yang sesuai.
Pertimbangkan analisis malware pada executable Windows, yaitu Portable Executables (PE). Kita dapat mengekstrak beragam fitur yang berasal dari analisis dinamis dan statis PE seperti urutan byte, API/panggilan Sistem, opcode, jaringan, sistem file, register CPU, karakteristik file PE, dan string, kemudian memasukkannya ke dalam model pembelajaran mesin terawasi, tak terawasi, dan semi-terawasi yang sesuai untuk mendeteksi malware.
Untuk mengurangi risiko terpapar serangan siber, kita harus dengan cepat mengidentifikasi, menilai, dan menangani potensi kelemahan keamanan dalam jaringan, komputer, dan aplikasi kita. Mari kita lihat peran yang dimainkan oleh algoritma AI dan ML dalam meningkatkan manajemen kerentanan melalui pemindaian kerentanan, manajemen patch, dan penilaian risiko.
Sebagai peneliti keamanan siber, saya sering mengembangkan alat kustom untuk mengotomatisasi tugas keamanan siber seperti parser log lalu lintas jaringan, fuzzer, dan lainnya.
Meskipun alat-alat ini dapat meningkatkan operasi keamanan kami secara signifikan, penting untuk menempatkannya pada pemindaian kerentanan yang ketat sebelum digunakan dan dibagikan dengan rekan-rekan saya.
Jika tidak, penyerang dapat mengeksploitasi kerentanan yang belum ditemukan dan belum ditambal dalam skrip kustom saya untuk mendapatkan akses tidak sah, mengompromikan informasi sensitif, atau mengganggu layanan di perusahaan kami.
Model pembelajaran mesin memiliki kemampuan melihat gambaran besar. Model tersebut unggul dalam mengekstraksi fitur bermakna dari kumpulan data besar dengan menemukan pola dan korelasi halus. Dengan pemikiran ini, saya mulai mengeksplorasinya untuk melihat apakah mereka mampu mengotomatisasi deteksi kerentanan, melakukan analisis lebih cepat, dan mengidentifikasi kerentanan yang sebelumnya belum diungkap.
Untuk membangun model deteksi kerentanan berbasis ML, saya mulai dengan mengumpulkan berbagai jenis data rentan dan tidak rentan untuk melatih model dari berbagai sumber, termasuk NVD (National Vulnerability Database), OWASP, dll.
Koleksi tersebut kemudian dipraproses dan di-embed untuk dimasukkan ke dalam model yang dipilih. Masukan dapat direpresentasikan sebagai sebuah Graf atau Pohon yang menunjukkan hubungan antara berbagai elemen kode, seperti Code Property Graph (CPG) atau Abstract Syntax Trees (AST).
Masukan juga dapat memiliki representasi berbasis token, di mana kode sumber diubah menjadi vektor token. Berbagai teknik embedding kemudian dapat diterapkan, termasuk Word2Vec, Graph embedding, One hot embedding, fitur N-gram, dll.
Seperti dijelaskan pada penerapan sebelumnya, pemilihan model pembelajaran mesin dan teknik pembelajarannya terutama bergantung pada ketersediaan label. Pada fase pelatihan, kumpulan data deteksi kerentanan dipisahkan menjadi set pelatihan dan validasi, dan model belajar dari data berlabel.
Parameter model diperbarui secara iteratif bergantung pada kesalahan prediksi menggunakan teknik optimisasi. Setelah model menyelesaikan proses pembelajarannya, kemampuannya untuk mendeteksi kerentanan diukur menggunakan data yang belum pernah dilihat. Indikator kinerja utama seperti akurasi, presisi, recall, dan skor F1 dihitung untuk menilai kemampuan model mendeteksi kerentanan.
Setelah mendeteksi kerentanan dalam skrip kustom saya, penilaian risiko yang komprehensif sangat penting. Jika kontrol keamanan yang ada mencegah eksploitasi kerentanan yang ditemukan atau konsekuensi potensialnya minimal, risikonya mungkin dapat diterima.
Sebagai alternatif, menghindari penggunaan kode yang dikembangkan sama sekali juga dapat dipertimbangkan untuk menghilangkan risiko eksploitasi. Namun, jika eliminasi total tidak praktis, menerapkan strategi mitigasi sangatlah penting.
Selanjutnya, kita akan mengeksplorasi penambalan perangkat lunak yang rentan sebagai taktik mitigasi utama.
Meskipun menangani semua kerentanan yang terbuka dan kritis adalah ideal, hal itu sering kali tidak praktis. Diperlukan pendekatan yang lebih strategis. Dengan menggunakan pembelajaran mesin, kita dapat secara proaktif memprediksi kerentanan mana yang paling mungkin dieksploitasi hingga menyebabkan insiden keamanan. Ini memungkinkan kita memprioritaskan upaya penambalan.
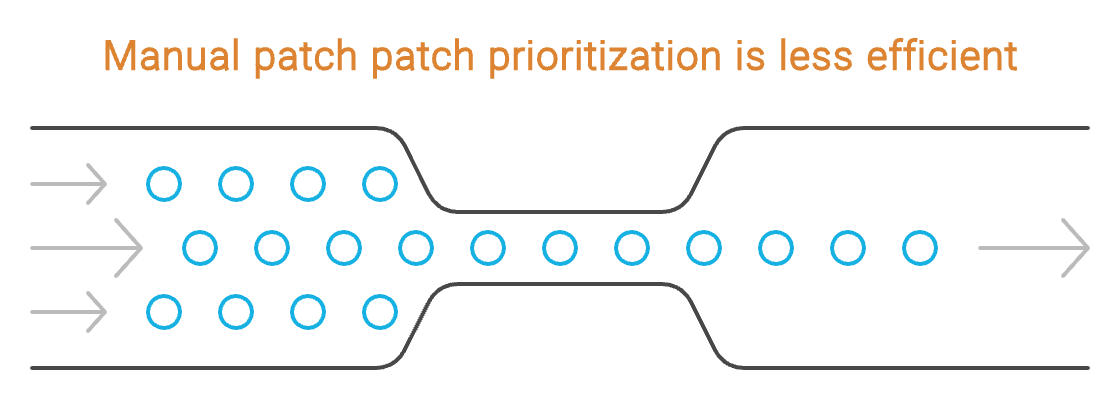
Dibuat dengan Napkin.ai
Untuk merampingkan proses prioritisasi patch, kami memanfaatkan model berbasis pohon Exploit Prediction Scoring System (EPSS) yang telah dilatih sebelumnya, yang menggabungkan informasi kerentanan dengan aktivitas eksploitasi di dunia nyata untuk memprediksi kemungkinan penyerang akan mencoba menggunakan kerentanan tertentu selama tiga puluh hari ke depan.
Model pembelajaran mesin EPSS mengidentifikasi pola dan hubungan antara informasi kerentanan, seperti CVSS, dan aktivitas eksploitasi untuk secara matematis mengidentifikasi kemungkinan penyerang akan menggunakan suatu kerentanan.
Setelah prioritisasi kerentanan, patch menjalani proses akuisisi, validasi, dan pengujian yang ketat untuk mengurangi risiko operasional. Penerapan patch adalah proses kompleks yang bergantung pada beberapa faktor, termasuk:
Mengingat skala dan keragaman lingkungan TI modern, penerapan patch secara manual sering kali menyita tenaga dan memakan waktu. Otomatisasi bertenaga AI dapat merampingkan proses ini dengan secara cerdas memilih dan menerapkan patch yang sesuai ke setiap sistem berdasarkan faktor-faktor kritis tersebut.
Algoritma pengelompokan, seperti K-means, dapat dimanfaatkan dalam kasus ini untuk mengelompokkan sistem serupa guna penerapan patch yang lebih efisien.
Penilaian risiko siber penting untuk mengidentifikasi, mengevaluasi, dan memitigasi potensi ancaman dan kerentanan yang terdeteksi.
Karena pendekatan tradisional sering kali kurang berhasil menemukan indikator risiko siber yang tidak dapat diprediksi, para peneliti mulai beralih ke pembelajaran mesin.
Dengan menggunakan ML terawasi dan klasifikasi multi-kelas, peneliti dapat meningkatkan penilaian risiko siber melalui analisis komprehensif terhadap faktor-faktor kunci.
Sebagaimana diuraikan dalam tabel di bawah, faktor-faktor tersebut mencakup investasi keamanan siber, karakteristik tenaga kerja, riwayat serangan, kerentanan infrastruktur, penasihat eksternal, dan risiko terkait. Kerangka kerja bukti konsep SecRiskAI berbasis ML mereka menunjukkan potensi ML dalam memprediksi kemungkinan terjadinya serangan DDoS atau phishing.
|
Informasi |
Contoh |
|
Pendapatan |
2,500,000 |
|
Investasi Keamanan Siber |
500,000 |
|
Serangan yang Berhasil |
5 |
|
Serangan yang Gagal |
10 |
|
Jumlah Karyawan |
4,450 |
|
Pelatihan Karyawan |
Sedang |
|
Kerentanan yang Diketahui |
9 |
|
Penasihat Keamanan Siber Eksternal |
Tidak |
|
Risiko |
Rendah |
Contoh atribut kunci untuk penilaian risiko siber (Sumber)
Sekarang mari jelajahi bagaimana AI dan ML mengubah respons insiden. Kita akan melihat bagaimana keduanya mengotomatisasi alur kerja respons insiden, mengurangi waktu respons, secara proaktif mengungkap ancaman tersembunyi, dan meningkatkan analisis forensik untuk menelusuri asal-usul dan dampak serangan siber.
Saya telah menyaksikan langsung bagaimana sistem SOAR dirancang untuk menerima peringatan dari sistem Security Information and Event Management (SIEM) dan mengaktifkan playbook yang sesuai yang mengotomatisasi dan mengoordinasikan serangkaian tugas keamanan.
Tugas-tugas ini dapat mencakup tindakan investigatif, seperti memeriksa reputasi URL atau mengambil detail pengguna dan aset, serta tindakan respons, seperti memblokir alamat IP pada firewall atau menghentikan proses berbahaya pada endpoint.
Namun, saat ini kami menghadapi keterbatasan signifikan pada sistem ini. Analis keamanan diharuskan untuk secara manual mendefinisikan, membuat, dan mengubah playbook, dan pemilihan di antara beberapa playbook diatur oleh aturan yang ditetapkan oleh analis keamanan.
Untuk mengatasi keterbatasan ini, saya telah melihat bagaimana integrasi AI dan ML ke dalam platform SOC dapat merevolusi proses ini, memungkinkan kami menghasilkan playbook secara otomatis yang dapat secara efektif
merespons peringatan yang tidak dikenal.
Ini tidak hanya meningkatkan efisiensi respons kami tetapi juga memberdayakan analis untuk fokus pada lebih banyak tugas. Dengan menggunakan algoritma ML, kita juga dapat melatihnya untuk menghitung biaya penalti dari setiap tindakan respons bergantung pada peringatan yang diterima dan memilih respons dengan penalti terendah.
Bayangkan betapa menegangkannya menyaring jutaan log, mencoba mengidentifikasi potensi ancaman.
Sekarang, perbesar tantangan tersebut ke skala tingkat perusahaan, di mana setiap log harus diperiksa satu per satu dan diklasifikasikan sebagai berbahaya atau jinak.
Dengan mengintegrasikan pembelajaran mesin ke dalam proses, kita dapat membuat tugas ini lebih sederhana dan mempercepat deteksi ancaman. Algoritma AI dan ML, yaitu SVM, Random Forest, dapat dilatih untuk menganalisis dan mengategorikan log secara efisien, memungkinkan identifikasi ancaman yang cepat dan mengurangi beban pada tim keamanan.
Seiring data digital terus tumbuh dalam volume dan kompleksitas, integrasi AI dan ML ke dalam forensik digital—analisis bukti digital untuk menyelidiki kejahatan siber—menjadi esensial.
Integrasi ini memungkinkan kita meningkatkan kecepatan, akurasi, dan efektivitas dalam mengidentifikasi dan merespons ancaman siber.
AI dan ML dapat digunakan dalam triase forensik, misalnya. Dalam kasus ini, kami menggunakan algoritma ML untuk mengklasifikasikan dan mengategorikan sejumlah besar file digital berdasarkan relevansinya dengan sebuah investigasi.
Integrasi AI dalam keamanan siber menghadirkan peluang signifikan. Namun, penting juga untuk mengakui tantangan dan keterbatasan yang melekat.
Banyak sistem AI rentan terhadap serangan adversarial, yaitu poisoning, evasion, ekstraksi model, prompt injection, dan inference, yang mengeksploitasi kerentanannya.
Dalam serangan ini, lawan dengan saksama menambahkan gangguan pada masukan yang tidak terlihat oleh manusia namun dapat menyebabkan model membuat prediksi yang salah. Ini menimbulkan kekhawatiran keselamatan tentang penerapan sistem ini di lingkungan kritis keselamatan, dan keamanan siber tidak terkecuali.
Untuk secara efektif melawan serangan ini, kami menggunakan berbagai mekanisme defensif seperti pelatihan adversarial, distilasi defensif, dan masking gradien.
Meskipun algoritma AI menunjukkan efektivitas dalam mencapai hasil dan prediksi, saya kesulitan memahami mekanisme kerja internalnya.
Ini sangat penting di bidang saya karena mempercayakan pilihan kritis kepada sistem yang tidak dapat dijelaskan menghadirkan risiko yang jelas.
Di sini, Explainable AI (XAI) menawarkan jalan ke depan untuk mengembangkan sistem keamanan siber yang didorong AI dengan keterjelasan yang lebih besar sambil mempertahankan kinerja tinggi. Dengan menyediakan transparansi dalam pengambilan keputusan AI, XAI membantu saya membuat analisis yang berinformasi baik dan mengambil tindakan yang paling tepat dalam menanggapi insiden keamanan.
Kemajuan terbaru dalam teknik XAI, yaitu analisis kepentingan fitur dan visualisasi pohon keputusan, membuat transparansi ini dapat dicapai.
Setiap kali saya memilih kumpulan data untuk melatih solusi keamanan siber berbasis AI saya, saya memastikan bahwa kumpulan data tersebut tidak bias. Jika tidak, model yang saya kembangkan dapat menghasilkan keluaran yang tidak adil atau diskriminatif. Saya menerapkan teknik prapemrosesan data untuk mengidentifikasi dan menghapus bias, menyajikan pelatihan dalam data, dan menerapkan teknik keadilan untuk mengevaluasi keluaran model atas potensi bias.
Jika Anda sudah membaca sejauh ini, Anda telah melihat bagaimana AI dan ML mengubah cara kita melindungi komputer, perangkat seluler, jaringan, dan aplikasi. Anda telah menyaksikan bagaimana keduanya memberdayakan tim keamanan, mendeteksi ancaman lebih cepat, dan memperkuat berbagai alat keamanan siber.
Dan inilah yang menarik: saya pikir kita baru saja memulainya.
Masa depan keamanan siber terletak pada evolusi berkelanjutan AI dan ML, terutama pada model bahasa besar (LLM). Karena batas token yang diperluas, kemampuan interpretasi kode, dan analisis mendetail, model-model canggih ini akan meningkatkan kemampuan kita untuk menganalisis dan merespons ancaman dengan meningkatkan skala analisis malware dengan kecepatan dan akurasi yang lebih tinggi.
Pertimbangkan kasus model Gemini 1.5 yang saat ini digunakan untuk mendeteksi malware dalam file berukuran besar. Meski tidak memiliki pelatihan khusus keamanan siber, model ini dapat menyelesaikan tugas terkait melalui rekayasa prompt, pembelajaran dalam konteks, dan rantai pemikiran.
Kita juga mulai melihat sekilas masa depan itu melalui fine-tuning LLM berbobot- terbuka, termasuk Llama, untuk tugas terkait keamanan siber seperti Hackmentor.
Dalam blog ini, kita telah mengkaji bagaimana alat keamanan siber berbasis AI dan ML berguna untuk menghadapi sifat ancaman siber modern yang dinamis dan kompleks. Alat-alat ini efektif dalam mendeteksi, menanggapi, dan memitigasi risiko melalui penerapan terarah dalam deteksi ancaman, manajemen kerentanan, dan respons insiden.
Namun, kita juga harus mempertimbangkan tantangan signifikan dan implikasi etis yang terkait dengan pengembangan dan penerapan solusi keamanan siber berbasis AI.
Terlepas dari tantangan ini, kemajuan berkelanjutan teknologi AI dan ML menjanjikan penguatan pertahanan kita terhadap ancaman siber yang terus berkembang.
Pelajari lebih lanjut tentang keamanan data!
Kursus
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt




