Program
Bisnis bergantung pada data yang akurat untuk mengambil keputusan—setidaknya, seharusnya begitu. Pipeline data yang gagal atau data yang tidak andal dapat sangat mengganggu proses organisasi.
Bayangkan skenario ini:
Tim pemasaran menggunakan data pelanggan untuk membuat iklan tertarget, tetapi karena masalah data yang tidak terdeteksi, informasi yang kedaluwarsa atau salah terkirim, bahkan mungkin ke orang yang tidak tepat.
Kesalahan itu mungkin tidak terlihat hingga pelanggan mulai mengajukan keluhan. Saat itu, sudah terlambat. Kerusakan telah terjadi—waktu dan uang sudah terbuang, dan kemungkinan diperlukan lebih banyak sumber daya untuk menangani dampaknya.
Data observability berupaya mencegah hal ini terjadi. Dalam artikel ini, kami akan membahas caranya. Mari kita mulai!
Apa itu Data Observability?
Data observability mengacu pada kemampuan untuk memantau dan memahami kesehatan data Anda saat data bergerak melalui pipeline dan sistem. Tujuan utamanya adalah memastikan data tetap akurat, konsisten, dan andal—sehingga potensi masalah dapat dideteksi dan diselesaikan sebelum menimbulkan persoalan yang lebih besar.
Sebagai contoh, jika Anda bagian dari tim penjualan dan bergantung pada laporan harian untuk melacak performa dan menentukan langkah selanjutnya, masalah apa pun pada data yang menyuplai laporan tersebut dapat menggagalkan seluruh strategi Anda. Data observability memungkinkan Anda menangkap masalah ini secara real time, memperbaikinya, dan menjaga semuanya tetap berjalan lancar.
Intinya, data observability adalah memantau data Anda saat bergerak melalui berbagai sistem untuk memastikan data tersebut akurat dan mengalir sebagaimana mestinya. Yang Anda lakukan adalah menemukan masalah sebelum memengaruhi keputusan penting.
Secara khusus, data observability membantu:
- Menjaga kualitas data: Secara otomatis mendeteksi data yang hilang atau tidak akurat, sehingga tim dapat memperbaiki masalah sebelum berujung pada keputusan yang buruk.
- Mencegah downtime data: Memantau pipeline terhadap anomali (misalnya penurunan volume, skema yang rusak) dan memberi peringatan ke tim sebelum gangguan membesar.
- Tata kelola dan kepatuhan: Mengidentifikasi pelanggaran kualitas atau keamanan data, membantu memenuhi regulasi privasi seperti GDPR atau CCPA.
- Membangun kepercayaan pada data: Memberikan transparansi tentang bagaimana data dikumpulkan, diproses, dan dikelola, sehingga menumbuhkan keyakinan dalam pengambilan keputusan.
Pilar-Pilar Data Observability
Data observability dibangun di atas lima pilar utama: Kesegaran (freshness), distribusi, volume, skema, dan garis keturunan (lineage). Bersama-sama, pilar ini memastikan pipeline data berjalan lancar dan data tetap akurat, lengkap, dan andal.
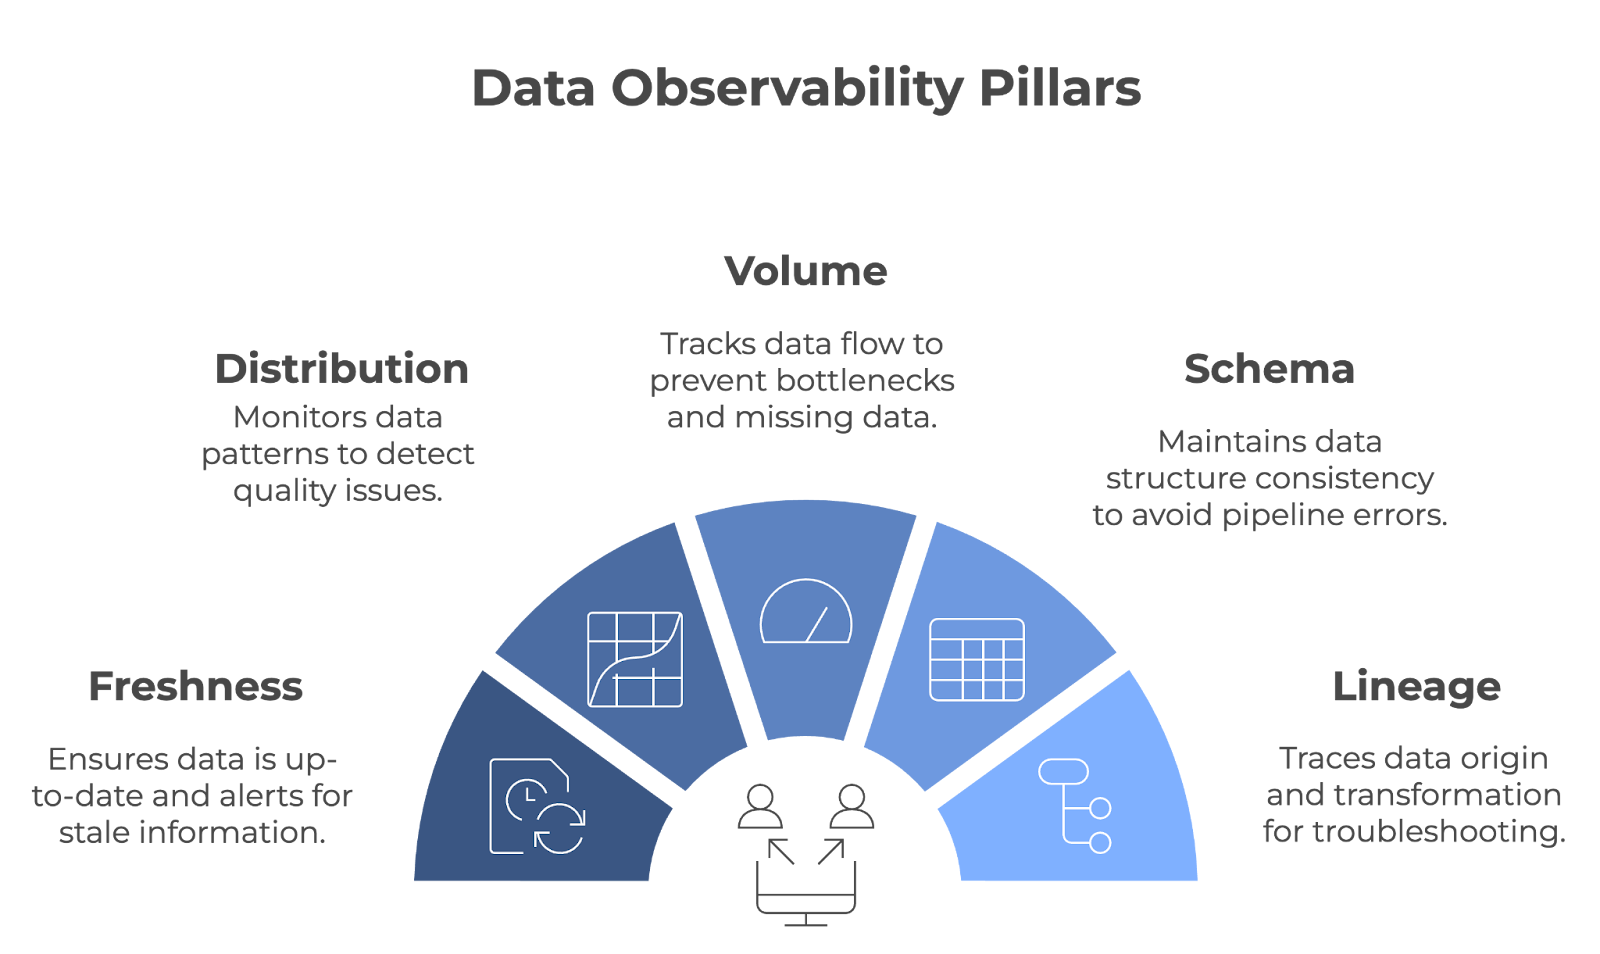
Lima pilar data observability. Gambar oleh Penulis (dibuat dengan napkin.ai)
Mari kita bahas masing-masing pilar secara detail!
Freshness
Freshness memberi tahu seberapa mutakhir data Anda. Pilar ini melacak kapan data terakhir diperbarui dan memberi peringatan jika data menjadi kedaluwarsa. Pilar ini penting bagi tim yang mengandalkan data real-time atau hampir real-time untuk mengambil keputusan.
- Contoh: Bayangkan peritel yang menyesuaikan tingkat persediaan berdasarkan data penjualan langsung. Jika data itu tidak diperbarui tepat waktu, perusahaan bisa berakhir dengan stok terlalu banyak atau terlalu sedikit. Freshness membantu mencegah hal ini dengan memastikan keputusan didasarkan pada informasi paling terbaru.
Distribusi
Distribusi mengacu pada pelacakan pola dan nilai spesifik dalam data Anda (misalnya mean, median, deviasi standar, dll.). Memantau nilai-nilai ini membantu mendeteksi saat ada sesuatu yang tampak janggal, yang dapat menjadi tanda masalah kualitas data. Pemeriksaan distribusi yang rutin menjamin data tetap konsisten dari waktu ke waktu.
- Contoh: Sebuah platform online kemungkinan menganalisis metrik keterlibatan pelanggan. Untuk memeriksa konsistensi, mereka dapat memantau distribusi data untuk metrik seperti durasi sesi, tingkat konversi, dll. Lonjakan atau penurunan mendadak pada metrik ini bisa menandakan masalah pada proses pengumpulan data atau kesalahan sistem yang mendasarinya.
Volume
Volume data mengacu pada jumlah data yang mengalir melalui suatu sistem. Metrik ini dilacak untuk memastikan jumlah data yang diharapkan diambil dan diproses tanpa penurunan atau lonjakan yang tidak terduga. Volume data dipantau untuk dengan cepat mendeteksi masalah seperti data hilang atau kemacetan pada pipeline.
- Contoh: Perusahaan logistik yang mengandalkan data GPS dari armada kendaraan akan memantau volume data lokasi yang dikirimkan. Jika volume data turun secara tak terduga, hal itu bisa mengindikasikan kegagalan komunikasi dengan kendaraan tertentu, yang menyebabkan celah dalam pelacakan.
Skema
Observability skema melacak struktur data—penting untuk menjaga agar tetap konsisten dari waktu ke waktu. Ketika skema berubah secara tak terduga, pipeline data Anda bisa rusak dan menyebabkan kesalahan dalam pemrosesan.
- Contoh: Bayangkan tim pemasaran Anda mengelompokkan pelanggan berdasarkan usia dan lokasi. Untuk mencegah pipeline data rusak, tim Anda perlu memastikan bahwa perubahan pada skema (misalnya mengganti nama kolom, mengubah tipe data, dll.) tidak menyebabkan kesalahan pada sistem pelaporan mereka. Perubahan yang tidak terdeteksi dapat berujung pada segmentasi pelanggan yang keliru.
Lineage
Lineage memberikan pandangan yang jelas tentang dari mana data Anda berasal, bagaimana data diubah, dan ke mana akhirnya data tersebut bermuara. Ini penting untuk pemecahan masalah dan menjaga kualitas data dalam sistem yang kompleks. Saat masalah muncul, lineage memungkinkan Anda menelusuri titik data kembali melalui pipeline untuk menemukan sumber persoalan.
- Contoh: Di sebuah bank, data lineage dapat digunakan untuk menelusuri titik data tertentu, seperti saldo rekening, kembali ke sumbernya. Jika terjadi perbedaan, lineage memungkinkan data engineer mengidentifikasi di mana dalam pipeline masalah tersebut terjadi.
Cara Kerja Data Observability
Sepanjang artikel ini, kami menyinggung bahwa data observability secara aktif memantau pipeline data, mengirim peringatan saat masalah muncul, dan membantu tim dengan cepat menemukan akar penyebab masalah.
Mari telusuri bagaimana setiap komponen bekerja dalam praktik!
Memantau pipeline data
Alat data observability mendeteksi kesalahan dengan terus-menerus memantau pipeline data. Alat ini dapat melacak banyak aspek pipeline data, tetapi biasanya dikonfigurasi untuk berfokus pada metrik atau area spesifik yang paling kritis bagi kebutuhan organisasi.
Alat ini sering terintegrasi dengan teknologi seperti Apache Kafka, Apache Airflow, atau layanan berbasis cloud seperti AWS Glue atau Google Cloud Dataflow untuk mengumpulkan wawasan di berbagai tahap pipeline. Misalnya:
- Validasi skema: Alat seperti Great Expectations dapat memberlakukan aturan skema, menjamin data yang masuk mematuhi format yang telah ditentukan (misalnya tipe data, keberadaan kolom, dan batas panjang).
- Deteksi anomali: Platform seperti Monte Carlo atau Databand.ai menggunakan machine learning untuk mengidentifikasi pola tidak biasa pada volume data, waktu pemrosesan, atau distribusi yang bisa menandakan masalah.
- Pelacakan lineage: Alat seperti OpenLineage atau Apache Atlas memvisualisasikan aliran data melalui sistem, sehingga lebih mudah menelusuri dampak perubahan atau kesalahan.
Peringatan dan otomatisasi
Apa gunanya mendeteksi masalah dengan cepat jika tidak ada yang diberi tahu? Alat data observability secara otomatis memberi peringatan kepada pihak yang tepat dan terkadang mengambil tindakan berdasarkan konfigurasi yang telah ditentukan.
Peringatan ini sering dikonfigurasi berdasarkan ambang batas atau pemicu, seperti catatan yang hilang, perubahan skema, atau keterlambatan data yang tidak terduga. Misalnya:
- Jika sebuah pipeline di Apache Airflow gagal, alat observability dapat mendeteksi penurunan volume data secara tiba-tiba dan otomatis memberi tahu tim data engineering melalui Slack.
- Beberapa platform, seperti Datafold atau Soda, menawarkan opsi perbaikan otomatis. Misalnya, sistem dapat mengembalikan dataset ke status terverifikasi terakhir atau mengalihkan data masuk ke lokasi penyimpanan cadangan menggunakan alat cloud seperti AWS Lambda.
Analisis akar penyebab
Analisis akar penyebab adalah proses sistematis untuk mengidentifikasi alasan mendasar di balik suatu masalah. Dalam konteks data observability, ini melibatkan penelusuran masalah data kembali ke asalnya alih-alih hanya menangani gejalanya.
Platform data observability sering menyediakan kemampuan diagnostik yang kaya, berintegrasi dengan sistem manajemen log seperti Elasticsearch atau platform pemantauan seperti Prometheus dan Grafana untuk menampilkan detail granular. Misalnya:
- Sebuah alat dapat menelusuri transformasi yang gagal di dbt kembali ke ketidakcocokan skema di database sumber.
- Dengan menganalisis data lineage, platform dapat menyoroti laporan atau dasbor hilir mana yang terdampak, sehingga tim dapat memprioritaskan perbaikan sesuai kebutuhan.
Alat untuk Data Observability
Sering kali, data engineer menerapkan fitur observability secara internal. Namun, saat ini tersedia beberapa alat andal yang memungkinkan tim menerapkan data observability siap pakai secara efektif. Mari lihat yang paling populer!
Monte Carlo
Monte Carlo adalah platform data observability yang kuat, dirancang untuk membantu tim menjaga kesehatan sistem data mereka. Dibuat oleh tim mantan insinyur dari perusahaan seperti LinkedIn dan Facebook, platform ini lahir dari keinginan untuk menyelesaikan tantangan meningkatnya downtime data. Platform ini menyediakan:
- Pemeriksaan kualitas data otomatis: Melacak perubahan skema, freshness, volume, dan distribusi untuk mendeteksi anomali.
- Analisis akar penyebab: Membantu tim menemukan sumber masalah, seperti pipeline yang rusak atau data yang hilang.
- Lineage data end-to-end: Memvisualisasikan aliran data untuk memahami dampak perubahan atau gangguan.
Monte Carlo terintegrasi dengan alat seperti Snowflake, dbt, dan Looker, sehingga ideal untuk tim yang bekerja di ekosistem data modern.
Bigeye
Bigeye didirikan pada 2020 oleh sekelompok data engineer. Ini adalah platform data observability yang dirancang untuk menjaga kualitas dan keandalan data sepanjang siklus hidupnya.
Platform ini berfokus pada otomatisasi pemantauan kualitas data, deteksi anomali, dan penyelesaian masalah data untuk menjaga aliran pipeline data tetap lancar serta memastikan para pemangku kepentingan dapat mengandalkan data yang akurat untuk pengambilan keputusan. Fitur-fiturnya meliputi:
- Pemantauan yang dapat dikustomisasi: Memungkinkan tim menetapkan ambang batas spesifik untuk metrik seperti kelengkapan, freshness, dan akurasi data.
- Deteksi anomali: Menggunakan machine learning untuk mengidentifikasi outlier atau perubahan tak terduga pada data.
- Alat kolaborasi: Menyediakan peringatan dan laporan yang terintegrasi dengan Slack dan Jira untuk memperlancar penyelesaian masalah.
Databand
Databand adalah platform data observability untuk secara proaktif mengelola kesehatan data dengan memberikan visibilitas ke dalam pipeline data. Didirikan pada 2019, Databand dibuat untuk menangani meningkatnya kompleksitas dan skala lingkungan data.
Platform ini dibangun untuk membantu data engineer mendeteksi masalah secara real time, memahami aliran data, dan menjamin akurasi dataset di seluruh organisasi. Fitur-fiturnya adalah:
- Pemantauan pipeline: Melacak metrik seperti runtime, volume data, dan error di berbagai alat seperti Apache Airflow dan Spark.
- Analisis dampak data: Menyoroti ketergantungan hilir untuk memprioritaskan perbaikan yang kritis.
- Kemampuan integrasi: Bekerja dengan platform seperti BigQuery, Kafka, dan Kubernetes untuk visibilitas end-to-end.
Datadog
Datadog adalah platform pemantauan dan analitik berbasis cloud yang menyediakan observability secara real time. Didirikan pada 2010 oleh Olivier Pomel dan Alexis Lê-Quôc, Datadog dibuat untuk menangani kompleksitas aplikasi cloud modern.
Datadog ideal untuk perusahaan yang membutuhkan pemantauan komprehensif di berbagai sistem. Platform ini sangat berguna bagi perusahaan cloud-native atau yang memiliki sistem terdistribusi kompleks. Fitur-fiturnya meliputi:
- Pemantauan terpadu: Melacak metrik, log, dan trace di seluruh aplikasi, infrastruktur, dan pipeline data.
- Peringatan real time: Mengirim notifikasi yang dapat dikustomisasi melalui email, Slack, atau PagerDuty.
- Ekosistem integrasi: Mendukung lebih dari 500 integrasi, termasuk AWS, Google Cloud, dan Docker.
Perbandingan Alat Data Observability
|
Alat |
Area fokus |
Integrasi |
Ideal untuk |
|
Monte Carlo |
Kualitas data, deteksi anomali, data lineage |
Snowflake, dbt, Looker |
Ekosistem data modern yang membutuhkan observability otomatis |
|
Bigeye |
Pemantauan kualitas data, deteksi anomali, UI ramah pengguna |
Slack, Jira, data lake dan gudang data utama |
Industri dengan kebutuhan keandalan data tinggi (misalnya, keuangan, kesehatan) |
|
Databand |
Pemantauan pipeline, analisis dampak data, peringatan real time |
Apache Airflow, Spark, BigQuery, Kafka |
Tim yang mengelola aliran data kompleks ber-volume tinggi |
|
Datadog |
Pemantauan terpadu, peringatan real time, dukungan cloud-native |
AWS, Google Cloud, Docker, Kubernetes |
Perusahaan dengan sistem terdistribusi atau setup cloud-native |
Praktik Terbaik untuk Menerapkan Data Observability
Untuk menerapkan data observability secara efektif, fokuslah pada praktik terbaik berikut:
Mulai dari pipeline berdampak tinggi
Fokuslah memantau pipeline data yang paling kritis terlebih dahulu—yang berdampak bisnis paling besar. Anda dapat memitigasi risiko dengan memastikan pipeline ini sehat sambil secara bertahap membangun strategi observability yang lebih luas di pipeline lainnya.
Tetapkan metrik dan KPI yang jelas
Metrik yang didefinisikan dengan jelas adalah kunci untuk mengevaluasi kesehatan data—Anda harus tahu seperti apa wujud keberhasilan (dan kegagalan). Metrik ini harus selaras dengan tujuan keseluruhan perusahaan untuk mencerminkan hal yang benar-benar penting. Kejelasan ini akan membantu Anda tetap fokus dan mengevaluasi kemajuan secara efektif.
Otomatisasi pemantauan kualitas data
Sistem pemantauan dan peringatan mengurangi intervensi manual dan meningkatkan waktu respons. Sistem otomatis dapat mendeteksi masalah lebih awal dan memicu tindakan segera untuk mencegah downtime data. Jadikan otomatisasi sebagai prioritas.
Integrasikan observability dengan proses yang ada
Menyematkan observability ke dalam proses harian Anda memungkinkan respons yang lebih cepat dan efektif, sehingga pengelolaan data menjadi lebih proaktif dan tidak reaktif.
Kesimpulan
Data observability sangat penting untuk membangun pipeline data yang berkualitas tinggi dan andal. Dengan terus memantau aspek-aspek kritis dari data, tim dapat mengidentifikasi dan menangani masalah sebelum berdampak pada hasil bisnis. Seiring data terus mendorong keputusan bisnis, observability akan tetap menjadi elemen inti untuk mengelola dan mengoptimalkan pipeline data.
Untuk sepenuhnya memahami pentingnya observability dan menerapkannya secara efektif, perlu memahami konsep terkait seperti arsitektur data, tata kelola, dan manajemen. Jika Anda ingin memperdalam pengetahuan:
- Understanding Modern Data Architecture memberikan wawasan tentang bagaimana data disusun dan dikelola dalam organisasi.
- Jelajahi Data Governance Concepts untuk memahami bagaimana kebijakan dan proses memastikan kualitas, keamanan, dan kepatuhan data.
- Pelajari prinsip yang lebih luas tentang pengelolaan data secara efektif dengan Data Management Concepts.
Akhirnya, jika Anda baru di bidang ini, Understanding Data Engineering adalah titik awal yang bagus untuk mengeksplorasi bagaimana pipeline data dirancang dan dipelihara!
FAQs
Apa perbedaan antara data observability dan pemantauan data?
Pemantauan data berfokus pada pelacakan metrik atau sistem tertentu, sementara data observability memberi pemahaman yang lebih mendalam tentang bagaimana data berperilaku sepanjang siklus hidupnya. Artinya, data observability memberikan wawasan ke akar penyebab masalah data, sehingga menawarkan pandangan yang lebih komprehensif daripada sekadar pemantauan.
Industri apa yang paling diuntungkan dari data observability?
Industri dengan kebutuhan keandalan data tinggi—seperti keuangan, kesehatan, e-niaga, dan logistik—sangat diuntungkan dari data observability. Industri-industri ini sangat bergantung pada data yang akurat dan tepat waktu untuk kepatuhan, kepuasan pelanggan, dan efisiensi operasional.
Bagaimana alat data observability menangani pipeline data real-time vs. batch?
Alat data observability dapat memantau pipeline real-time maupun batch. Untuk data real-time, alat ini melacak metrik seperti latensi, throughput, dan anomali saat terjadi. Untuk pipeline batch, alat ini memastikan kelengkapan data, memvalidasi kepatuhan skema, dan memeriksa anomali setelah setiap run.
Apa saja tantangan dalam menerapkan data observability?
Beberapa tantangan umum mencakup memilih alat yang tepat untuk tumpukan data Anda, menyelaraskan praktik observability dengan tujuan bisnis, dan mengelola overhead tambahan dari pemantauan pipeline yang kompleks. Memastikan dukungan tim dan mengalokasikan sumber daya untuk penyiapan dan pemeliharaan juga krusial untuk penerapan yang berhasil.

