
数据可观测性的五大支柱
数据可观测性建立在五大关键支柱之上:新鲜度、分布、体量、架构和血缘。它们共同确保数据管道稳定运行,并让数据保持准确、完整与可靠。
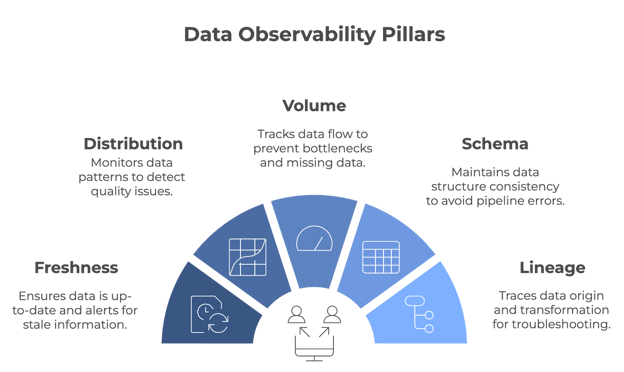
数据可观测性的五大支柱。图片由作者创作(使用 napkin.ai)
让我们逐一深入了解!
新鲜度(Freshness)
新鲜度告诉您数据的最新程度。它跟踪数据上次更新的时间,并在数据变得陈旧时发出警报。对于依赖实时或准实时数据做决策的团队而言,这一支柱尤为重要。
- 示例: 设想一家零售商根据实时销量调整库存。如果数据未能及时更新,公司可能会备货过多或过少。新鲜度可以确保决策基于最新信息,从而避免此类问题。
分布(Distribution)
分布是指跟踪数据中的模式和具体取值(如均值、中位数、标准差等)。监控这些值有助于发现异常情况,可能预示着数据质量问题。定期进行分布检查可确保数据随时间保持一致性。
- 示例: 一家在线平台通常会分析客户参与度指标。为检查一致性,他们可能监控会话时长、转化率等指标的数据分布。此类指标的骤升或骤降,可能表明数据采集过程存在问题或底层系统出错。
体量(Volume)
数据体量指系统中流动的数据量。跟踪该指标是为了确保数据按预期被摄取与处理,且不会出现意外的骤降或激增。通过监控数据体量,可以快速发现诸如数据缺失或管道瓶颈等问题。
- 示例: 一家依赖车队GPS数据的物流公司会监控位置数据的传输体量。如果数据体量意外下降,可能意味着部分车辆通信失败,导致追踪出现空白。
架构(Schema)
架构可观测性用于跟踪数据的结构——保持其随时间一致至关重要。当架构出现意外变化时,可能会破坏数据管道并导致处理错误。
- 示例: 假设市场团队按年龄和地区对客户分群。为防止数据管道出错,团队需要确保对架构的变更(如重命名列、修改数据类型等)不会在报表系统中引发错误。任何未被注意到的变化都可能导致错误的客户分群。
血缘(Lineage)
血缘提供关于数据来源、转换方式及去向的清晰视图。这对于在复杂系统中排障与维护数据质量至关重要。问题出现时,血缘可以让您沿管道回溯数据点,找到问题根源。
- 示例: 在银行中,数据血缘可用于追踪某个特定数据点(如账户余额)的来源。若出现不一致,血缘能帮助数据工程师定位问题发生在管道的哪一环。
数据可观测性的工作原理
整篇文章中,我们都提到数据可观测性会主动监控数据管道,在问题出现时发送警报,并帮助团队快速找到问题根源。
下面来看看各个组成部分在实践中如何运作!
监控数据管道
数据可观测性工具通过对数据管道的持续监控来发现错误。它们可以跟踪管道的多个方面,但通常会按组织需求配置,聚焦于最关键的指标或领域。
这些工具常与Apache Kafka、Apache Airflow等技术,或AWS Glue、Google Cloud Dataflow 等云服务集成,在管道的不同阶段获取洞察。例如:
- 架构校验:如 Great Expectations 等工具可强制执行架构规则,确保入库数据遵循预定义格式(如数据类型、列是否存在、长度限制)。
- 异常检测:如 Monte Carlo 或 Databand.ai 等平台利用机器学习识别数据体量、处理时间或分布的异常模式,提示潜在问题。
- 血缘追踪:如 OpenLineage 或 Apache Atlas 等工具可可视化数据在系统中的流动,便于追踪变更或错误的影响范围。
告警与自动化
若快速发现问题却无人知晓,又有何意义?数据可观测性工具会自动通知合适的人,并可根据预设配置采取行动。
这些告警通常基于阈值或触发条件进行配置,例如记录缺失、架构变化或意外的数据延迟。例如:
- 如果 Apache Airflow 中的某条管道失败,可观测性工具可能会检测到数据体量骤降,并通过 Slack 自动通知数据工程团队。
- 部分平台(如 Datafold 或 Soda)提供自动修复选项。例如,系统可以将数据集回滚到上次验证通过的状态,或使用 AWS Lambda 等云工具将入库数据重路由到备份存储位置。
根因分析
根因分析是一种系统化流程,用于识别问题或故障的根本原因。在数据可观测性的语境下,它强调将数据问题追溯到起点,而非只处理表面症状。
数据可观测性平台通常具备丰富的诊断能力,并与 Elasticsearch 等日志管理系统或 Prometheus、Grafana 等监控平台集成,以呈现更细粒度的信息。例如:
- 某工具可能将dbt中的一次转换失败追溯到源数据库中的架构不匹配。
- 通过分析血缘数据,平台可以突出显示受影响的下游报告或仪表板,帮助团队据此优先修复。
数据可观测性工具
很多时候,数据工程师会在内部实现可观测性功能。不过,如今也有多款强大的工具,可让团队高效开箱即用地实施数据可观测性。让我们看看最受欢迎的几款!
Monte Carlo
Monte Carlo是一款强大的数据可观测性平台,旨在帮助团队维护数据系统的健康。它由来自 LinkedIn、Facebook 等公司的前工程师创建,旨在解决日益突出的数据停机挑战。其提供:
- 自动化数据质量检查:跟踪架构变化、新鲜度、体量与分布,以检测异常。
- 根因分析:帮助团队定位问题源头,如管道损坏或数据缺失。
- 端到端数据血缘:可视化数据流,了解变更或中断的影响。
Monte Carlo 可与 Snowflake、dbt、Looker 等工具集成,非常适合在现代数据生态中工作的团队。
Bigeye
Bigeye由一群数据工程师于 2020 年创立。这是一款旨在整个生命周期内维护数据质量与可靠性的数据可观测性平台。
该平台专注于自动化数据质量监控、异常检测和数据问题的解决,以确保数据管道顺畅运行,并让相关方能够依赖准确数据进行决策。其功能包括:
- 可自定义监控:允许团队为数据完整性、新鲜度与准确性等指标设定特定阈值。
- 异常检测:使用机器学习识别异常值或数据中的意外变化。
- 协作工具:提供可与 Slack 与 Jira 集成的告警与报告,以简化问题解决。
Databand
Databand是一款数据可观测性平台,通过提供对数据管道的可见性,主动管理数据健康。它成立于 2019 年,旨在应对数据环境日益增长的复杂性与规模。
该平台旨在帮助数据工程师实时发现问题、理解数据流,并确保组织范围内数据集的准确性。其功能包括:
- 管道监控:在 Apache Airflow 与 Spark 等工具上跟踪运行时长、数据体量与错误等指标。
- 数据影响分析:突出下游依赖关系,以便优先处理关键修复。
- 集成功能:与 BigQuery、Kafka、Kubernetes 等平台协作,实现端到端可见性。
Datadog
Datadog是一款基于云的监控与分析平台,提供实时可观测性。由 Olivier Pomel 与 Alexis Lê-Quôc 于 2010 年创立,Datadog 旨在应对现代云应用的复杂性。
Datadog 非常适合需要对多种系统进行全面监控的公司。该平台对云原生公司或拥有复杂分布式系统的组织尤其有用。其功能包括:
- 统一监控:跨应用、基础设施与数据管道跟踪指标、日志与追踪。
- 实时告警:通过电子邮件、Slack 或 PagerDuty 发送可自定义通知。
- 集成生态:支持 500 多种集成,包括 AWS、Google Cloud 与 Docker。
数据可观测性工具对比
|
工具 |
重点领域 |
集成 |
理想适用对象 |
|
Monte Carlo |
数据质量、异常检测、数据血缘 |
Snowflake、dbt、Looker |
需要自动化可观测性的现代数据生态 |
|
Bigeye |
数据质量监控、异常检测、友好 UI |
Slack、Jira、主流数据湖与数仓 |
对数据可靠性要求高的行业(如金融、医疗) |
|
Databand |
管道监控、数据影响分析、实时告警 |
Apache Airflow、Spark、BigQuery、Kafka |
管理高体量、复杂数据流的团队 |
|
Datadog |
统一监控、实时告警、云原生支持 |
AWS、Google Cloud、Docker、Kubernetes |
拥有分布式系统或云原生架构的公司 |
实施数据可观测性的最佳实践
要高效实施数据可观测性,请关注以下最佳实践:
从高影响力管道入手
优先监控最关键、业务影响最大的 数据管道。通过确保这些管道健康运行来降低风险,同时逐步在其他管道上构建更广泛的可观测性策略。
设定清晰的指标与 KPI
明确定义的指标是评估数据健康的关键——您必须知道成功(与失败)是什么样子。这些指标需与公司整体目标保持一致,以反映真正重要的内容。清晰的标准有助于保持专注并有效评估进展。
自动化数据质量监控
监控与告警系统可减少人工介入并提升响应速度。自动化系统能及早发现问题并触发即时行动,防止数据停机。请将自动化置于优先位置。
将可观测性融入现有流程
将可观测性嵌入日常流程,使您能够更快速且更有效地响应,从而让数据管理更具前瞻性而非被动应对。
结语
数据可观测性是构建高质量、可靠数据管道的关键。通过持续监控数据的关键方面,团队可以在问题影响业务结果之前识别并解决它们。随着数据持续驱动业务决策,可观测性将始终是管理与优化数据管道的核心要素。
要充分理解可观测性的重要性并有效实施,需掌握数据架构、治理与管理等相关概念。如果您想深化您的知识:
- Understanding Modern Data Architecture 课程可帮助您了解组织内数据的结构与管理方式。
- 探索Data Governance Concepts,了解策略与流程如何确保数据质量、安全与合规。
- 通过Data Management Concepts 学习更广泛的数据高效管理原则。
最后,如果您是该领域的新手,Understanding Data Engineering 是了解数据管道如何设计与维护的绝佳起点!
FAQs
数据可观测性与数据监控有何区别?
数据监控侧重于跟踪特定指标或系统,而数据可观测性让您更深入地理解数据在其全生命周期中的行为。换言之,数据可观测性可洞察数据问题的根本原因,因此比简单的监控更全面。
哪些行业最能受益于数据可观测性?
对数据可靠性要求高的行业——如金融、医疗、电商与物流——从数据可观测性中受益显著。这些行业高度依赖准确及时的数据来满足合规、客户满意与运营效率的需求。
数据可观测性工具如何处理实时与批处理数据管道?
数据可观测性工具既可监控实时管道,也可监控批处理管道。对于实时数据,它们会在事件发生时跟踪延迟、吞吐量与异常等指标。对于批处理管道,它们会在每次运行后检查数据完整性、验证架构合规性并检测异常。
实施数据可观测性会遇到哪些挑战?
常见挑战包括为您的数据技术栈选择合适的工具、将可观测性实践与业务目标对齐,以及管理对复杂管道进行监控所带来的额外开销。确保团队达成共识并为搭建与维护分配资源,也是成功实施的关键。

企业依赖准确的数据来做决策——或者至少应该如此。数据管道故障或数据不可靠会显著扰乱组织流程。
设想这样的场景:
市场团队使用客户数据投放定向广告,但由于一个未被发现的数据问题,过时或错误的信息被发出,甚至可能发给了错误的人。
错误可能要等到客户开始投诉才被注意到。到那时为时已晚。损失已经造成——时间和金钱都被浪费了,而且还需要更多资源来收拾残局。
数据可观测性旨在防止这种情况发生。本文将讨论如何实现。我们开始吧!
什么是数据可观测性?
数据可观测性是指在数据通过管道和系统流动时,监控并理解其健康状况的能力。其主要目标是确保数据保持准确、一致且可靠——这样就能在问题扩大之前发现并解决潜在问题。
例如,如果您在销售团队,依赖每日报告来跟踪业绩并决定下一步行动,那么为这些报告提供数据的任何问题都可能打乱您的整体策略。数据可观测性可让您实时捕捉这些问题、进行修复,并保持业务顺畅运转。
因此,从本质上讲,数据可观测性就是在数据跨越不同系统流动时进行监控,以确保其准确且按预期流转。您所做的,就是在问题影响关键决策之前将其识别出来。
具体而言,数据可观测性有助于: