Leerpad
Bedrijven zijn afhankelijk van nauwkeurige data om beslissingen te nemen—of in elk geval zouden ze dat moeten zijn. Een falende datapijplijn of onbetrouwbare data kan bedrijfsprocessen flink verstoren.
Stel je dit scenario eens voor:
Een marketingteam gebruikt klantdata om gerichte advertenties te maken, maar door een onopgemerkt dataprobleem wordt verouderde of onjuiste informatie verstuurd—misschien zelfs naar de verkeerde mensen.
De fout valt mogelijk pas op wanneer klanten klachten indienen. Dan ben je te laat. De schade is al aangericht—tijd en geld zijn verspild, en er zijn waarschijnlijk nog meer middelen nodig om de nasleep op te lossen.
Data-observeerbaarheid wil dit voorkomen. In dit artikel bespreken we hoe. Laten we erin duiken!
Wat is data-observeerbaarheid?
Data-observeerbaarheid is het vermogen om de gezondheid van je data te monitoren en te begrijpen terwijl deze door pijplijnen en systemen beweegt. Het primaire doel is om data accuraat, consistent en betrouwbaar te houden—zodat potentiële problemen worden gedetecteerd en opgelost voordat ze grotere kwesties veroorzaken.
Als je bijvoorbeeld in het salesteam zit en dagelijks rapporten nodig hebt om prestaties te volgen en vervolgstappen te bepalen, kan elk probleem met de data achter die rapporten je hele strategie uit koers brengen. Data-observeerbaarheid stelt je in staat om deze issues in realtime op te sporen, te verhelpen en alles soepel te laten verlopen.
In de kern betekent data-observeerbaarheid dus dat je je data monitort terwijl die door verschillende systemen beweegt, om te garanderen dat deze accuraat is en stroomt zoals verwacht. Je probeert problemen te signaleren voordat ze cruciale besluiten beïnvloeden.
Concreet helpt data-observeerbaarheid bij:
- Datakwaliteit behouden: Ontdek automatisch ontbrekende of onjuiste data, zodat teams problemen kunnen oplossen voordat ze tot slechte beslissingen leiden.
- Datadowntime voorkomen: Monitor pijplijnen op afwijkingen (bijv. dalingen in volume, kapotte schema’s) en alarmeer teams voordat verstoringen escaleren.
- Governance en compliance: Identificeer datakwaliteits- of beveiligingsinbreuken en voldoe zo aan privacyregels zoals GDPR of CCPA.
- Vertrouwen in data opbouwen: Bied transparantie in hoe data wordt verzameld, verwerkt en beheerd, wat vertrouwen in besluitvorming vergroot.
De pijlers van data-observeerbaarheid
Data-observeerbaarheid is gebouwd op vijf kernpijlers: versheid, distributie, volume, schema en herkomst. Samen zorgen deze pijlers ervoor dat datapijplijnen soepel draaien en data accuraat, compleet en betrouwbaar blijft.
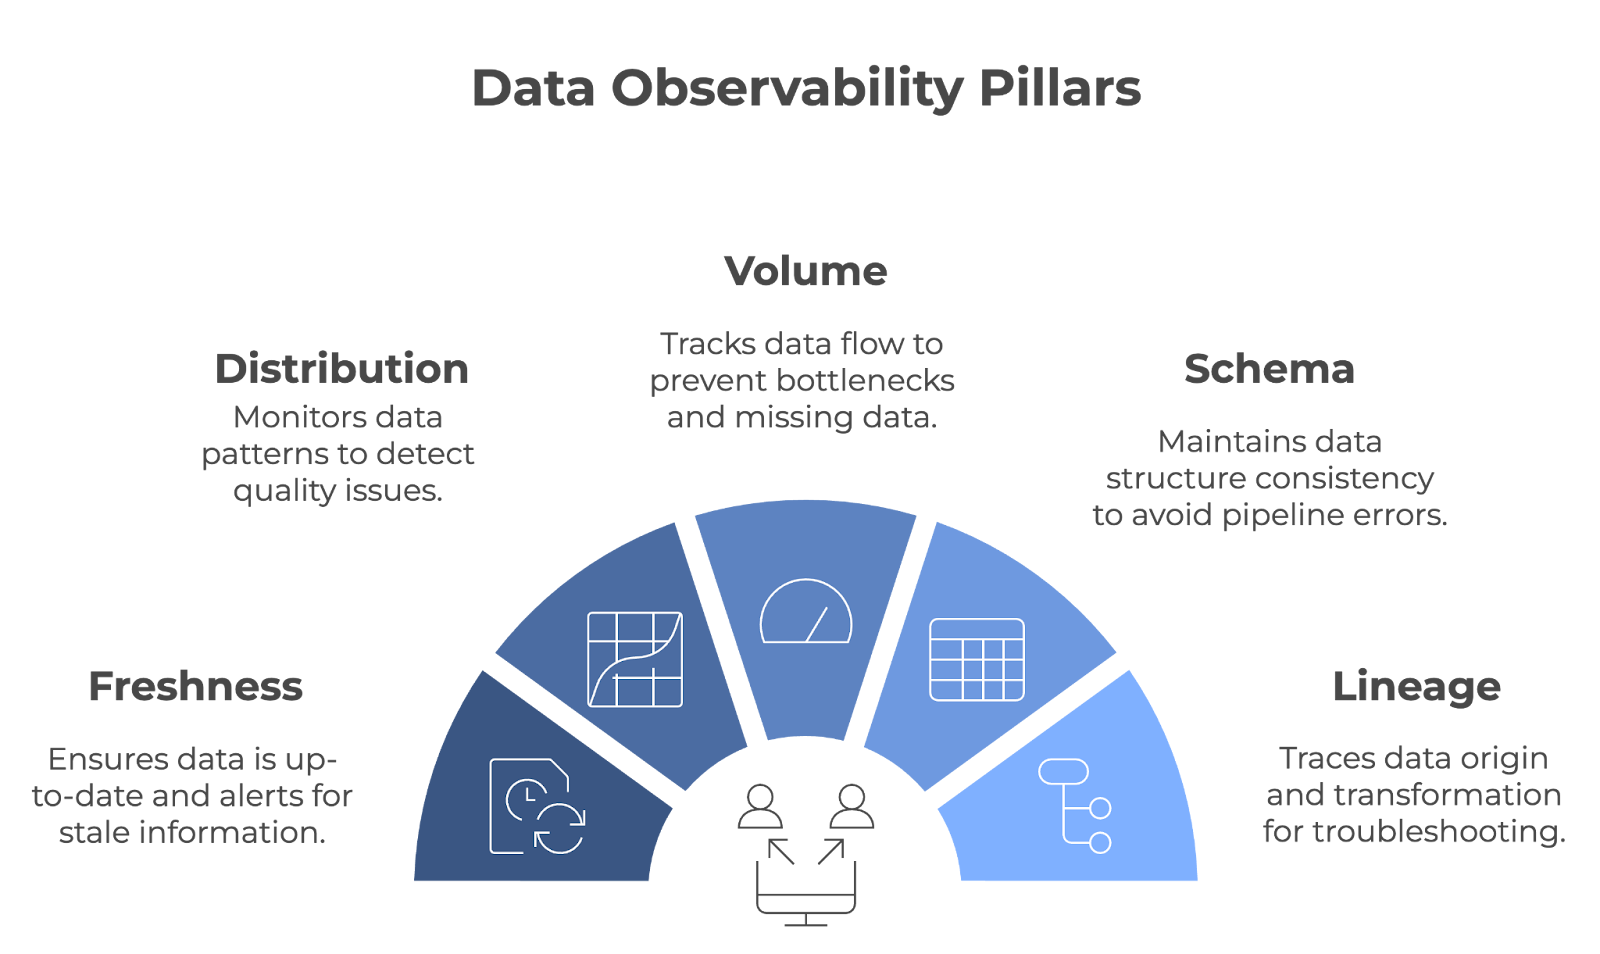
De vijf pijlers van data-observeerbaarheid. Afbeelding door de auteur (gemaakt met napkin.ai)
Laten we elke pijler in detail bekijken!
Versheid
Versheid vertelt je hoe up-to-date je data is. Het houdt bij wanneer data voor het laatst is bijgewerkt en waarschuwt als die verouderd raakt. Deze pijler is belangrijk voor teams die voor beslissingen vertrouwen op (bijna) realtime data.
- Voorbeeld: Stel je een retailer voor die voorraadniveaus bijstelt op basis van live verkoopdata. Als die data niet op tijd wordt bijgewerkt, eindigt het bedrijf met te veel of te weinig voorraad. Versheid helpt dit te voorkomen door te zorgen dat beslissingen op de laatste informatie zijn gebaseerd.
Distributie
Distributie verwijst naar het volgen van de patronen en specifieke waarden in je data (bijv. gemiddelde, mediaan, standaarddeviatie, enz.). Het monitoren hiervan helpt te zien wanneer iets niet klopt, wat kan wijzen op datakwaliteitsproblemen. Regelmatige distributiechecks zorgen ervoor dat data door de tijd heen consistent blijft.
- Voorbeeld: Een online platform zal waarschijnlijk klantbetrokkenheidsstatistieken analyseren. Om consistentie te checken, monitoren ze distributies voor metrics als sessieduur, conversieratio’s, enz. Een plotselinge piek of daling kan duiden op problemen in het dataverzamelingsproces of een onderliggende systeemfout.
Volume
Datavolume is de hoeveelheid data die door een systeem stroomt. Deze maat wordt gevolgd om te garanderen dat de verwachte hoeveelheid data wordt ingeladen en verwerkt zonder onverwachte dalingen of pieken. Het monitoren van volume helpt snel issues te detecteren, zoals ontbrekende data of knelpunten in pijplijnen.
- Voorbeeld: Een logistiek bedrijf dat vertrouwt op gps-data van een wagenpark monitort het volume locatiegegevens dat wordt verzonden. Daalt het volume onverwacht, dan kan dat wijzen op communicatieproblemen met bepaalde voertuigen, wat leidt tot hiaten in tracking.
Schema
Schema-observeerbaarheid volgt de structuur van de data—het is belangrijk dat die door de tijd heen consistent blijft. Onverwachte schemawijzigingen kunnen je datapijplijnen breken en tot verwerkingsfouten leiden.
- Voorbeeld: Stel dat je marketingteam klanten segmenteert op leeftijd en locatie. Om te voorkomen dat je pijplijn breekt, moet je team ervoor zorgen dat wijzigingen in het schema (bijv. kolommen hernoemen, datatypes wijzigen, enz.) geen fouten veroorzaken in het rapportagesysteem. Onopgemerkte wijzigingen kunnen leiden tot foutieve segmentatie.
Herkomst
Herkomst geeft een helder beeld van waar je data vandaan komt, hoe deze wordt getransformeerd en waar die terechtkomt. Dit is cruciaal voor troubleshooting en het behouden van datakwaliteit in complexe systemen. Wanneer zich problemen voordoen, kun je met herkomst data terug door de pijplijn traceren om de bron te vinden.
- Voorbeeld: In een bank kan dataherkomst worden gebruikt om een specifieke datapunt, zoals een rekeningsaldo, terug naar de bron te herleiden. Bij afwijkingen kunnen data engineers zo achterhalen waar in de pijplijn het probleem ontstond.
Hoe data-observeerbaarheid werkt
In dit artikel hebben we al aangestipt dat data-observeerbaarheid datapijplijnen actief monitort, waarschuwingen verstuurt bij issues en teams helpt snel de hoofdoorzaak te vinden.
Laten we bekijken hoe elk onderdeel in de praktijk werkt!
Datapijplijnen monitoren
Tools voor data-observeerbaarheid signaleren fouten door de pijplijnen continu te monitoren. Ze kunnen veel aspecten van een pijplijn volgen, maar worden doorgaans geconfigureerd om te focussen op de metrics of onderdelen die voor de organisatie het belangrijkst zijn.
Deze tools integreren vaak met technologieën zoals Apache Kafka, Apache Airflow, of clouddiensten zoals AWS Glue of Google Cloud Dataflow om inzichten te verzamelen in verschillende stadia van de pijplijn. Bijvoorbeeld:
- Schemavalidatie: Tools zoals Great Expectations kunnen schemaregels afdwingen en garanderen dat inkomende data voldoet aan vooraf gedefinieerde formats (bijv. datatypes, aanwezigheid van kolommen, en lengterestricties).
- Anomaliedetectie: Platforms zoals Monte Carlo of Databand.ai gebruiken machine learning om ongebruikelijke patronen te identificeren in datavolume, verwerkingstijden of distributies die op een probleem kunnen wijzen.
- Herkomsttracking: Tools zoals OpenLineage of Apache Atlas visualiseren hoe data door systemen stroomt, waardoor het eenvoudiger wordt de impact van wijzigingen of fouten te traceren.
Alerts en automatisering
Wat heb je aan snelle detectie als niemand het weet? Tools voor observeerbaarheid waarschuwen automatisch de juiste mensen en ondernemen soms actie op basis van vooraf ingestelde configuraties.
Deze alerts worden vaak ingericht op basis van drempels of triggers, zoals ontbrekende records, schemawijzigingen of onverwachte datavertragingen. Bijvoorbeeld:
- Als een pijplijn in Apache Airflow faalt, kan een observeerbaarheidstool een plotselinge daling in datavolume detecteren en het data engineering-team automatisch via Slack informeren.
- Sommige platforms, zoals Datafold of Soda, bieden automatische herstelopties. Zo kan een systeem een dataset terugzetten naar de laatst geverifieerde staat of binnenkomende data omleiden naar een back-uplocatie met cloudtools zoals AWS Lambda.
Oorzaakanalyse
Oorzaakanalyse is een systematisch proces om de fundamentele reden achter een probleem te identificeren. In de context van data-observeerbaarheid betekent dit dat je een dataprobleem naar de oorsprong herleidt in plaats van alleen de symptomen aan te pakken.
Platforms voor data-observeerbaarheid bieden vaak uitgebreide diagnostiek en integreren met logmanagementsystemen zoals Elasticsearch of monitoringplatforms zoals Prometheus en Grafana om details op fijn niveau te tonen. Bijvoorbeeld:
- Een tool kan een mislukte transformatie in dbt herleiden tot een schema-mismatch in een brondatabase.
- Door herkomstdData te analyseren kan het platform aangeven welke downstream-rapporten of -dashboards zijn getroffen, zodat teams prioriteiten kunnen stellen.
Tools voor data-observeerbaarheid
Vaak bouwen data engineers observeerbaarheidsfuncties in-house. Er zijn echter diverse krachtige tools beschikbaar waarmee teams out-of-the-box data-observeerbaarheid effectief kunnen inzetten. Laten we de populairste bekijken!
Monte Carlo
Monte Carlo is een krachtige data-observeerbaarheidsplatform dat teams helpt de gezondheid van hun datasystemen te behouden. Opgezet door voormalige engineers van bedrijven als LinkedIn en Facebook, is het platform gebouwd vanuit de wens om de groeiende uitdaging van datadowntime op te lossen. Het biedt:
- Geautomatiseerde datakwaliteitscontroles: Volgt schemawijzigingen, versheid, volume en distributie om anomalieën te detecteren.
- Oorzaakanalyse: Helpt teams de bron van issues te vinden, zoals kapotte pijplijnen of ontbrekende data.
- End-to-end dataherkomst: Visualiseert datastromen om de impact van wijzigingen of verstoringen te begrijpen.
Monte Carlo integreert met tools zoals Snowflake, dbt en Looker, en is daarmee ideaal voor teams in moderne data-ecosystemen.
Bigeye
Bigeye werd in 2020 opgericht door een groep data engineers. Het is een data-observeerbaarheidsplatform dat is ontworpen om de kwaliteit en betrouwbaarheid van data gedurende de hele levenscyclus te waarborgen.
Het platform richt zich op het automatiseren van datakwaliteitsmonitoring, anomaliedetectie en het oplossen van dataproblemen, zodat pijplijnen soepel blijven lopen en stakeholders op nauwkeurige data kunnen vertrouwen. Functies zijn onder meer:
- Aanpasbare monitoring: Laat teams specifieke drempels instellen voor metrics zoals datacompleetheid, versheid en nauwkeurigheid.
- Anomaliedetectie: Gebruikt machine learning om uitschieters of onverwachte veranderingen in data te identificeren.
- Samenwerkingstools: Biedt alerts en rapporten die integreren met Slack en Jira om het oplossen van issues te stroomlijnen.
Databand
Databand is een platform voor data-observeerbaarheid om de datahealth proactief te beheren door zichtbaarheid in datapijplijnen te bieden. Opgericht in 2019, is Databand ontwikkeld om de toenemende complexiteit en schaal van dataomgevingen aan te pakken.
Het platform helpt data engineers issues in realtime te detecteren, datastromen te begrijpen en de nauwkeurigheid van datasets door de hele organisatie heen te garanderen. Functies zijn:
- Pijplijnmonitoring: Volgt metrics zoals looptijd, datavolume en fouten in tools zoals Apache Airflow en Spark.
- Data-impactanalyse: Markeert downstream-afhankelijkheden om kritieke fixes te prioriteren.
- Integratiemogelijkheden: Werkt met platforms zoals BigQuery, Kafka en Kubernetes voor end-to-end zichtbaarheid.
Datadog
Datadog is een cloudgebaseerd monitoring- en analyseplatform dat realtime observeerbaarheid biedt. Opgericht in 2010 door Olivier Pomel en Alexis Lê-Quôc, is Datadog ontwikkeld om de complexiteit van moderne cloudapplicaties aan te pakken.
Datadog is ideaal voor bedrijven die uitgebreide monitoring over diverse systemen nodig hebben. Het platform is bijzonder nuttig voor cloud-native bedrijven of organisaties met complexe, gedistribueerde systemen. Functies zijn onder meer:
- Geünificeerde monitoring: Volgt metrics, logs en traces in applicaties, infrastructuur en datapijplijnen.
- Realtime waarschuwingen: Stuurt aanpasbare notificaties via e-mail, Slack of PagerDuty.
- Integratie-ecosysteem: Ondersteunt meer dan 500 integraties, waaronder AWS, Google Cloud en Docker.
Vergelijking van tools voor data-observeerbaarheid
|
Tool |
Focusgebieden |
Integraties |
Ideaal voor |
|
Monte Carlo |
Datakwaliteit, anomaliedetectie, dataherkomst |
Snowflake, dbt, Looker |
Moderne data-ecosystemen die geautomatiseerde observeerbaarheid nodig hebben |
|
Bigeye |
Datakwaliteitsmonitoring, anomaliedetectie, gebruiksvriendelijke UI |
Slack, Jira, grote datalakes en -warehouses |
Sectoren met hoge eisen aan databetrouwbaarheid (bijv. finance, zorg) |
|
Databand |
Pijplijnmonitoring, data-impactanalyse, realtime alerts |
Apache Airflow, Spark, BigQuery, Kafka |
Teams die hoogvolume, complexe datastromen beheren |
|
Datadog |
Geünificeerde monitoring, realtime alerts, cloud-native support |
AWS, Google Cloud, Docker, Kubernetes |
Bedrijven met gedistribueerde systemen of cloud-native setups |
Best practices voor het implementeren van data-observeerbaarheid
Richt je op deze best practices om data-observeerbaarheid effectief te implementeren:
Begin met impactvolle pijplijnen
Monitor eerst de meest kritieke datapijplijnen—die met de grootste zakelijke impact. Zo beperk je risico’s door te zorgen dat deze pijplijnen gezond zijn, terwijl je stapsgewijs een bredere observeerbaarheidsstrategie uitrolt over andere pijplijnen.
Stel duidelijke metrics en KPI’s vast
Duidelijke metrics zijn cruciaal om datagezondheid te beoordelen—je moet weten hoe succes (en falen) eruitziet. Deze metrics moeten aansluiten bij de overkoepelende bedrijfsdoelen om te weerspiegelen wat echt telt. Die duidelijkheid helpt je gefocust te blijven en voortgang effectief te evalueren.
Automatiseer datakwaliteitsmonitoring
Monitoring- en waarschuwingssystemen verminderen handmatig werk en verbeteren de reactietijd. Geautomatiseerde systemen detecteren issues vroeg en starten direct acties om datadowntime te voorkomen. Maak automatisering een prioriteit.
Integreer observeerbaarheid in bestaande processen
Door observeerbaarheid in je dagelijkse processen te verankeren, kun je sneller en effectiever reageren, waardoor databeheer proactiever en minder reactief wordt.
Conclusie
Data-observeerbaarheid is cruciaal om hoogwaardige, betrouwbare datapijplijnen te bouwen. Door kritieke aspecten van data continu te monitoren, kunnen teams problemen identificeren en oplossen voordat ze zakelijke resultaten beïnvloeden. Naarmate data steeds meer beslissingen aanstuurt, blijft observeerbaarheid een kernelement voor het beheren en optimaliseren van datapijplijnen.
Om het belang van observeerbaarheid volledig te begrijpen en dit effectief te implementeren, is het nodig verwante concepten zoals data-architectuur, governance en management te kennen. Wil je je kennis verdiepen:
- Understanding Modern Data Architecture biedt inzichten in hoe data binnen organisaties wordt gestructureerd en beheerd.
- Verken Data Governance Concepts om te begrijpen hoe beleid en processen datakwaliteit, security en compliance borgen.
- Leer over de bredere principes van effectief databeheer met Data Management Concepts.
Ben je tot slot nieuw in het vakgebied, dan is Understanding Data Engineering een uitstekend startpunt om te ontdekken hoe datapijplijnen worden ontworpen en onderhouden!
FAQs
Wat is het verschil tussen data-observeerbaarheid en datamonitoring?
Datamonitoring richt zich op het volgen van specifieke metrics of systemen, terwijl data-observeerbaarheid je een dieper begrip geeft van hoe data zich gedraagt gedurende de levenscyclus. Observeerbaarheid biedt namelijk inzicht in de hoofdoorzaak van dataproblemen en geeft zo een completer beeld dan simpele monitoring.
Welke sectoren profiteren het meest van data-observeerbaarheid?
Sectoren met hoge eisen aan databetrouwbaarheid—zoals finance, zorg, e-commerce en logistiek—profiteren sterk van data-observeerbaarheid. Deze sectoren zijn afhankelijk van nauwkeurige en tijdige data voor compliance, klanttevredenheid en operationele efficiëntie.
Hoe gaan tools voor data-observeerbaarheid om met realtime- versus batch-datapijplijnen?
Tools voor data-observeerbaarheid kunnen zowel realtime- als batchpijplijnen monitoren. Voor realtime data volgen ze metrics zoals latency, throughput en anomalieën zodra die zich voordoen. Voor batchpijplijnen controleren ze datacompleetheid, valideren ze schemacompliance en checken ze op anomalieën na elke run.
Wat zijn uitdagingen bij het implementeren van data-observeerbaarheid?
Veelvoorkomende uitdagingen zijn onder meer het kiezen van de juiste tools voor je datastack, het afstemmen van observeerbaarheidspraktijken op bedrijfsdoelen en het managen van de extra overhead van het monitoren van complexe pijplijnen. Team-betrokkenheid borgen en middelen toewijzen voor setup en onderhoud zijn ook cruciaal voor succesvolle implementatie.


