Chuyển đến nội dung chính
Kỹ thuật Dữ liệu
Khoa học Dữ liệu

Giải thích về Khả năng Quan sát Dữ liệu: Khái niệm, Công cụ & Thực tiễn Tốt nhất

Hiểu khả năng quan sát dữ liệu là gì, vì sao quan trọng và cách dùng nó để giám sát, tối ưu pipeline dữ liệu một cách hiệu quả!
Kurtis Pykes 's photo
Kurtis Pykes
Đã cập nhật · 15 phút đọc

Khám phá cùng AI

ChatGPTClaudePerplexity

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.

Doanh nghiệp phụ thuộc vào dữ liệu chính xác để ra quyết định—hoặc ít nhất là nên như vậy. Một pipeline dữ liệu bị lỗi hoặc dữ liệu không đáng tin cậy có thể làm gián đoạn đáng kể các quy trình trong tổ chức.

Hãy hình dung tình huống sau:

Một đội ngũ marketing sử dụng dữ liệu khách hàng để tạo quảng cáo nhắm mục tiêu, nhưng do một vấn đề dữ liệu không được phát hiện, thông tin lỗi thời hoặc sai lệch được gửi đi, thậm chí có thể tới nhầm đối tượng.

Lỗi có thể không bị phát hiện cho đến khi khách hàng bắt đầu khiếu nại. Lúc đó thì đã muộn. Thiệt hại đã xảy ra—thời gian và tiền bạc đã bị lãng phí, và nhiều nguồn lực hơn có khả năng sẽ cần để xử lý hậu quả.

Khả năng quan sát dữ liệu nhằm ngăn điều này xảy ra. Trong bài viết này, chúng ta sẽ thảo luận cách thức thực hiện. Bắt đầu nhé!

Khả năng Quan sát Dữ liệu là gì?

Khả năng quan sát dữ liệu đề cập đến khả năng theo dõi và hiểu tình trạng sức khỏe của dữ liệu khi nó di chuyển qua các pipeline và hệ thống. Mục tiêu chính là đảm bảo dữ liệu luôn chính xác, nhất quán và đáng tin cậy—giúp phát hiện và xử lý các vấn đề tiềm ẩn trước khi chúng gây ra vấn đề lớn hơn.

Ví dụ, nếu bạn là thành viên đội ngũ bán hàng và dựa vào báo cáo hằng ngày để theo dõi hiệu suất và xác định bước tiếp theo, mọi trục trặc với dữ liệu cung cấp cho các báo cáo đó có thể làm chệch hướng toàn bộ chiến lược. Khả năng quan sát dữ liệu cho phép bạn phát hiện các vấn đề này theo thời gian thực, khắc phục và giữ cho mọi thứ vận hành trơn tru.

Tựu chung lại, cốt lõi của khả năng quan sát dữ liệu là giám sát dữ liệu khi nó di chuyển qua các hệ thống khác nhau để đảm bảo dữ liệu chính xác và lưu chuyển như kỳ vọng. Bạn đang tìm ra các vấn đề trước khi chúng ảnh hưởng đến những quyết định quan trọng.

Cụ thể, khả năng quan sát dữ liệu giúp:

  • Duy trì chất lượng dữ liệu: Tự động phát hiện dữ liệu thiếu hoặc không chính xác, giúp đội ngũ khắc phục trước khi dẫn đến quyết định sai lầm.
  • Ngăn chặn thời gian chết của dữ liệu: Giám sát pipeline để phát hiện bất thường (ví dụ: giảm đột ngột về khối lượng, schema bị hỏng) và cảnh báo đội ngũ trước khi gián đoạn leo thang.
  • Quản trị và tuân thủ: Xác định các vi phạm về chất lượng hoặc bảo mật dữ liệu, hỗ trợ đáp ứng các quy định về quyền riêng tư như GDPR hoặc CCPA.
  • Xây dựng niềm tin vào dữ liệu: Cung cấp sự minh bạch về cách dữ liệu được thu thập, xử lý và quản lý, từ đó củng cố sự tự tin trong ra quyết định.

Các Trụ cột của Khả năng Quan sát Dữ liệu

Khả năng quan sát dữ liệu được xây dựng trên năm trụ cột chính: Độ mới, phân phối, khối lượng, schema và nguồn gốc (lineage). Cùng nhau, các trụ cột này đảm bảo pipeline dữ liệu vận hành trơn tru và dữ liệu luôn chính xác, đầy đủ, đáng tin cậy. 
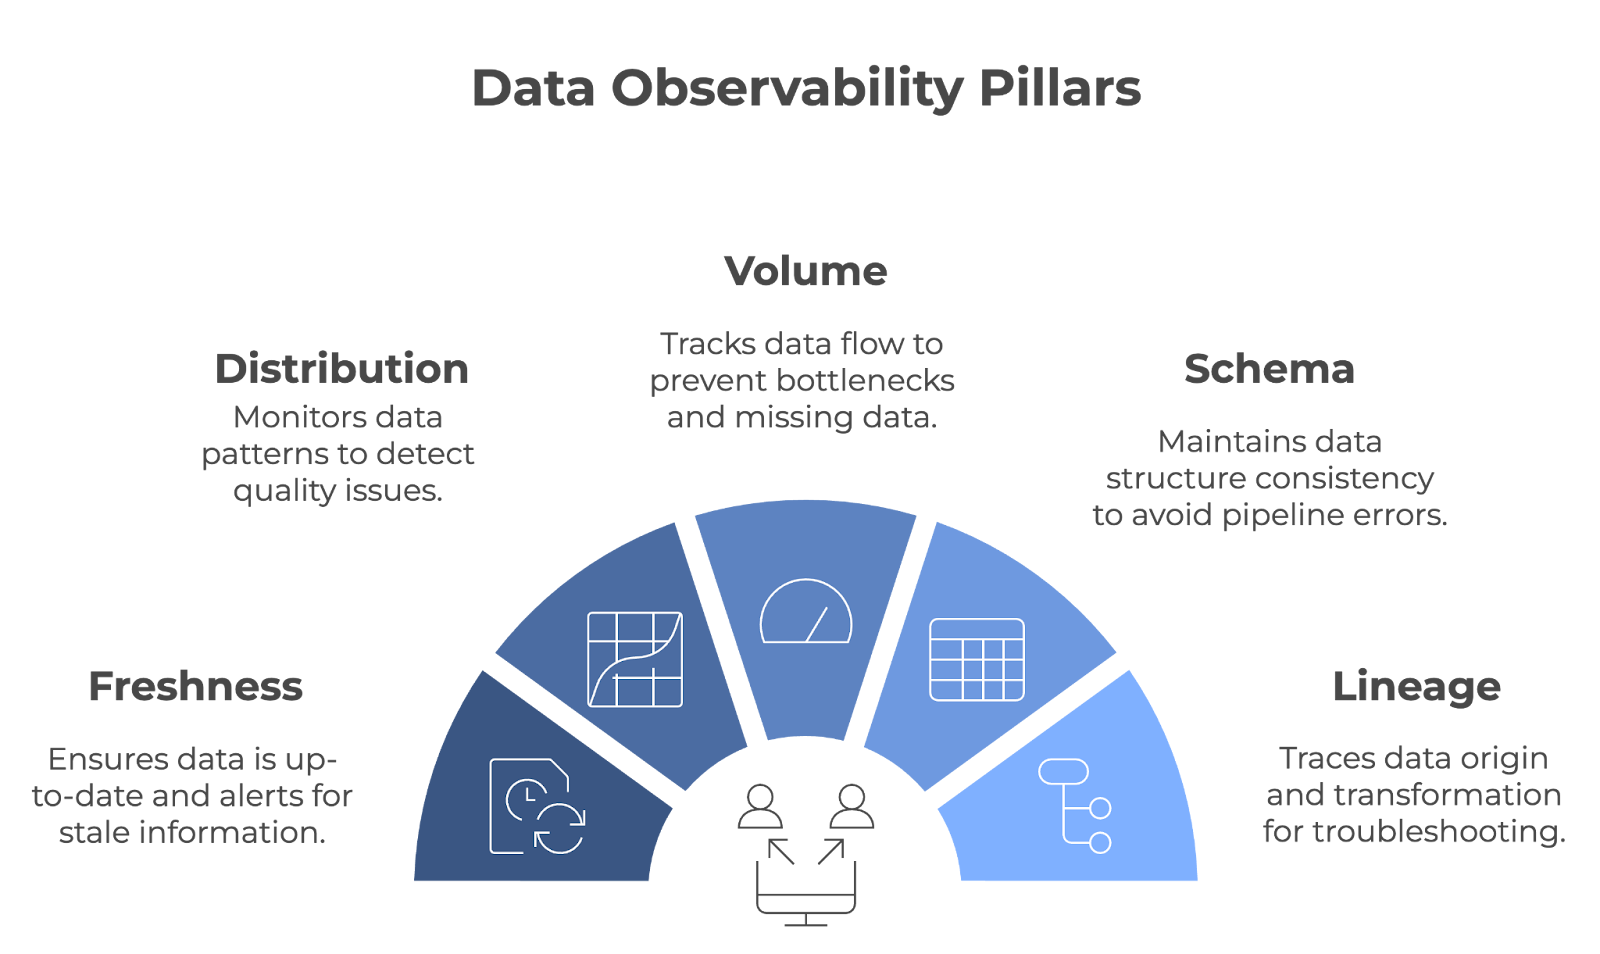
Hình minh họa cho thấy năm trụ cột của khả năng quan sát dữ liệu

Năm trụ cột của khả năng quan sát dữ liệu. Ảnh: Tác giả (tạo với napkin.ai)

Hãy cùng xem chi tiết từng trụ cột!

Độ mới (Freshness)

Độ mới cho biết dữ liệu của bạn được cập nhật gần đây đến mức nào. Nó theo dõi thời điểm dữ liệu được cập nhật lần cuối và cảnh báo nếu dữ liệu trở nên lỗi thời. Trụ cột này quan trọng đối với các đội ngũ dựa vào dữ liệu thời gian thực hoặc gần thời gian thực để ra quyết định.

  • Ví dụ: Hãy tưởng tượng một nhà bán lẻ điều chỉnh tồn kho dựa trên dữ liệu bán hàng trực tiếp. Nếu dữ liệu không được cập nhật kịp thời, công ty có thể dư hoặc thiếu hàng. Độ mới giúp ngăn điều này bằng cách đảm bảo quyết định dựa trên thông tin mới nhất.

Phân phối (Distribution)

Phân phối đề cập đến việc theo dõi các mẫu và giá trị cụ thể trong dữ liệu của bạn (ví dụ: trung bình, trung vị, độ lệch chuẩn, v.v.). Giám sát các giá trị này giúp phát hiện điều bất thường, có thể là dấu hiệu của vấn đề chất lượng dữ liệu. Kiểm tra phân phối thường xuyên đảm bảo dữ liệu nhất quán theo thời gian.

  • Ví dụ: Một nền tảng trực tuyến có thể phân tích các chỉ số tương tác của khách hàng. Để kiểm tra tính nhất quán, họ có thể theo dõi phân phối dữ liệu cho các chỉ số như thời lượng phiên, tỷ lệ chuyển đổi, v.v. Một đột biến tăng hoặc giảm đột ngột có thể báo hiệu vấn đề trong quy trình thu thập dữ liệu hoặc lỗi hệ thống cơ bản.

Khối lượng (Volume)

Khối lượng dữ liệu đề cập đến lượng dữ liệu chảy qua hệ thống. Chỉ số này được theo dõi để đảm bảo lượng dữ liệu dự kiến đang được nạp và xử lý mà không có biến động bất thường. Khối lượng dữ liệu được giám sát để nhanh chóng phát hiện các vấn đề như thiếu dữ liệu hoặc nút thắt cổ chai trong pipeline. 

  • Ví dụ: Một công ty logistics dựa vào dữ liệu GPS từ đội xe sẽ giám sát khối lượng dữ liệu vị trí được truyền. Nếu khối lượng dữ liệu giảm bất thường, đó có thể là dấu hiệu lỗi liên lạc với một số phương tiện, dẫn đến lỗ hổng theo dõi.

Schema

Quan sát schema theo dõi cấu trúc dữ liệu—điều quan trọng là cấu trúc phải nhất quán theo thời gian. Khi schema thay đổi ngoài dự kiến, nó có thể làm vỡ pipeline dữ liệu và dẫn đến lỗi trong xử lý.

  • Ví dụ: Giả sử đội marketing của bạn phân khúc khách hàng theo độ tuổi và vị trí. Để tránh pipeline dữ liệu bị hỏng, đội cần đảm bảo các thay đổi schema (ví dụ: đổi tên cột, thay đổi kiểu dữ liệu, v.v.) không gây lỗi trong hệ thống báo cáo. Bất kỳ thay đổi nào không được chú ý có thể dẫn đến phân khúc khách hàng sai lệch.

Nguồn gốc (Lineage)

Lineage cung cấp cái nhìn rõ ràng về dữ liệu đến từ đâu, được biến đổi như thế nào và đi đến đâu. Điều này then chốt cho việc khắc phục sự cố và duy trì chất lượng dữ liệu trong các hệ thống phức tạp. Khi phát sinh vấn đề, lineage cho phép truy vết điểm dữ liệu ngược theo pipeline để tìm nguồn gốc lỗi.

  • Ví dụ: Trong một ngân hàng, lineage có thể được dùng để truy vết một điểm dữ liệu cụ thể, như số dư tài khoản, về nguồn của nó. Nếu phát sinh sai lệch, lineage cho phép kỹ sư dữ liệu xác định vị trí trong pipeline nơi vấn đề xảy ra.

Khả năng Quan sát Dữ liệu Hoạt động như thế nào

Xuyên suốt bài viết, chúng ta đã nhắc đến việc khả năng quan sát dữ liệu chủ động giám sát các pipeline dữ liệu, gửi cảnh báo khi có vấn đề và giúp đội ngũ nhanh chóng tìm ra nguyên nhân gốc rễ.

Hãy khám phá cách từng thành phần vận hành trong thực tiễn!

Giám sát các pipeline dữ liệu

Các công cụ quan sát dữ liệu phát hiện lỗi bằng cách liên tục giám sát các pipeline dữ liệu. Chúng có thể theo dõi nhiều khía cạnh của một pipeline, nhưng thường được cấu hình để tập trung vào các chỉ số hoặc khu vực quan trọng nhất với nhu cầu của tổ chức.

Các công cụ này thường tích hợp với các công nghệ như Apache Kafka, Apache Airflow, hoặc các dịch vụ đám mây như AWS Glue hay Google Cloud Dataflow để thu thập thông tin ở nhiều giai đoạn của pipeline. Ví dụ:

  • Xác thực schema: Các công cụ như Great Expectations có thể áp đặt các quy tắc schema, đảm bảo dữ liệu đến tuân theo định dạng đã định (ví dụ: kiểu dữ liệu, sự hiện diện của cột và giới hạn độ dài).
  • Phát hiện bất thường: Các nền tảng như Monte Carlo hoặc Databand.ai sử dụng máy học để nhận diện mẫu bất thường về khối lượng dữ liệu, thời gian xử lý hoặc phân phối có thể báo hiệu vấn đề.
  • Theo dõi lineage: Các công cụ như OpenLineage hoặc Apache Atlas trực quan hóa cách dữ liệu luân chuyển qua hệ thống, giúp dễ dàng truy vết tác động của thay đổi hoặc lỗi.

Cảnh báo và tự động hóa

Phát hiện vấn đề nhanh để làm gì nếu không ai được thông báo? Các công cụ quan sát dữ liệu tự động cảnh báo đúng người và đôi khi thực hiện hành động dựa trên cấu hình định sẵn.

Các cảnh báo này thường được cấu hình dựa trên ngưỡng hoặc trình kích hoạt, như thiếu bản ghi, thay đổi schema, hoặc chậm trễ dữ liệu bất thường. Chẳng hạn:

  • Nếu một pipeline trong Apache Airflow thất bại, công cụ quan sát có thể phát hiện sự sụt giảm đột ngột về khối lượng dữ liệu và tự động thông báo cho đội kỹ sư dữ liệu qua Slack.
  • Một số nền tảng như Datafold hoặc Soda cung cấp tùy chọn khắc phục tự động. Ví dụ, hệ thống có thể quay lui dataset về trạng thái đã được xác minh gần nhất hoặc chuyển hướng dữ liệu đến bộ nhớ dự phòng bằng các công cụ đám mây như AWS Lambda.

Phân tích nguyên nhân gốc rễ

Phân tích nguyên nhân gốc rễ là quy trình có hệ thống nhằm xác định lý do căn bản đằng sau một vấn đề. Trong bối cảnh khả năng quan sát dữ liệu, điều này liên quan đến việc truy vết vấn đề dữ liệu về nguồn gốc của nó thay vì chỉ xử lý triệu chứng.

Các nền tảng quan sát dữ liệu thường cung cấp khả năng chẩn đoán phong phú, tích hợp với hệ thống quản lý log như Elasticsearch hoặc nền tảng giám sát như Prometheus và Grafana để hiển thị chi tiết ở mức hạt mịn. Ví dụ:

  • Một công cụ có thể truy vết một phép biến đổi thất bại trong dbt về sự không khớp schema trong cơ sở dữ liệu nguồn.
  • Bằng cách phân tích dữ liệu lineage, nền tảng có thể làm nổi bật các báo cáo hoặc bảng điều khiển downstream bị ảnh hưởng, giúp đội ngũ ưu tiên sửa chữa phù hợp.

Công cụ cho Khả năng Quan sát Dữ liệu

Thường thì kỹ sư dữ liệu tự triển khai các tính năng quan sát tại chỗ. Tuy nhiên, hiện có nhiều công cụ mạnh mẽ giúp đội ngũ triển khai khả năng quan sát dữ liệu sẵn có một cách hiệu quả. Hãy xem những công cụ phổ biến nhất!

Monte Carlo

Monte Carlo là nền tảng khả năng quan sát dữ liệu mạnh mẽ được thiết kế để giúp đội ngũ duy trì sức khỏe hệ thống dữ liệu. Được tạo ra bởi nhóm kỹ sư từng làm việc tại các công ty như LinkedIn và Facebook, nền tảng ra đời nhằm giải quyết thách thức ngày càng tăng của thời gian chết dữ liệu. Nó cung cấp:

  • Kiểm tra chất lượng dữ liệu tự động: Theo dõi thay đổi schema, độ mới, khối lượng và phân phối để phát hiện bất thường.
  • Phân tích nguyên nhân gốc rễ: Giúp đội ngũ xác định nguồn gốc vấn đề, như pipeline bị hỏng hoặc thiếu dữ liệu.
  • Lineage dữ liệu end-to-end: Trực quan hóa luồng dữ liệu để hiểu tác động của thay đổi hoặc gián đoạn.

Monte Carlo tích hợp với các công cụ như Snowflake, dbt và Looker, lý tưởng cho đội ngũ làm việc trong hệ sinh thái dữ liệu hiện đại.

Bigeye

Bigeye được thành lập năm 2020 bởi một nhóm kỹ sư dữ liệu. Đây là nền tảng khả năng quan sát dữ liệu được thiết kế để duy trì chất lượng và độ tin cậy của dữ liệu trong suốt vòng đời.

Nền tảng tập trung vào tự động hóa giám sát chất lượng dữ liệu, phát hiện bất thường và xử lý sự cố dữ liệu để giữ cho pipeline vận hành trơn tru và đảm bảo các bên liên quan có thể dựa vào dữ liệu chính xác để ra quyết định. Tính năng bao gồm:

  • Giám sát tùy chỉnh: Cho phép đội ngũ đặt ngưỡng cụ thể cho các chỉ số như tính đầy đủ, độ mới và độ chính xác của dữ liệu.
  • Phát hiện bất thường: Sử dụng máy học để nhận diện ngoại lệ hoặc thay đổi bất ngờ trong dữ liệu.
  • Công cụ cộng tác: Cung cấp cảnh báo và báo cáo tích hợp với Slack và Jira để tinh gọn việc xử lý sự cố.

Databand

Databand là nền tảng khả năng quan sát dữ liệu nhằm chủ động quản lý sức khỏe dữ liệu bằng cách cung cấp khả năng quan sát các pipeline dữ liệu. Thành lập năm 2019, Databand ra đời để giải quyết mức độ phức tạp và quy mô ngày càng tăng của môi trường dữ liệu.

Nền tảng được xây dựng để giúp kỹ sư dữ liệu phát hiện vấn đề theo thời gian thực, hiểu luồng dữ liệu và đảm bảo độ chính xác của các bộ dữ liệu trên toàn tổ chức. Tính năng gồm có:

  • Giám sát pipeline: Theo dõi các chỉ số như thời gian chạy, khối lượng dữ liệu và lỗi trên các công cụ như Apache Airflow và Spark.
  • Phân tích tác động dữ liệu: Làm nổi bật các phụ thuộc downstream để ưu tiên các sửa lỗi quan trọng.
  • Khả năng tích hợp: Hoạt động với các nền tảng như BigQuery, Kafka và Kubernetes để có cái nhìn end-to-end.

Datadog

Datadog là nền tảng phân tích và giám sát dựa trên đám mây cung cấp khả năng quan sát theo thời gian thực. Được thành lập năm 2010 bởi Olivier Pomel và Alexis Lê-Quốc, Datadog ra đời để giải quyết sự phức tạp của các ứng dụng đám mây hiện đại. 

Datadog lý tưởng cho các công ty cần giám sát toàn diện trên nhiều hệ thống. Nền tảng đặc biệt hữu ích cho các công ty cloud-native hoặc có hệ thống phân tán phức tạp. Tính năng gồm:

  • Giám sát hợp nhất: Theo dõi chỉ số, log và trace trên ứng dụng, hạ tầng và pipeline dữ liệu.
  • Cảnh báo thời gian thực: Gửi thông báo tùy chỉnh qua email, Slack hoặc PagerDuty.
  • Hệ sinh thái tích hợp: Hỗ trợ hơn 500 tích hợp, bao gồm AWS, Google Cloud và Docker.

So sánh Công cụ Khả năng Quan sát Dữ liệu

Công cụ

Trọng tâm

Tích hợp

Lý tưởng cho

Monte Carlo

Chất lượng dữ liệu, phát hiện bất thường, lineage dữ liệu

Snowflake, dbt, Looker

Hệ sinh thái dữ liệu hiện đại cần khả năng quan sát tự động

Bigeye

Giám sát chất lượng dữ liệu, phát hiện bất thường, giao diện thân thiện

Slack, Jira, các data lake và kho dữ liệu lớn

Ngành có nhu cầu độ tin cậy dữ liệu cao (ví dụ: tài chính, y tế)

Databand

Giám sát pipeline, phân tích tác động dữ liệu, cảnh báo thời gian thực

Apache Airflow, Spark, BigQuery, Kafka

Đội ngũ quản lý luồng dữ liệu phức tạp, khối lượng lớn

Datadog

Giám sát hợp nhất, cảnh báo thời gian thực, hỗ trợ cloud-native

AWS, Google Cloud, Docker, Kubernetes

Công ty có hệ thống phân tán hoặc thiết lập cloud-native

Thực tiễn Tốt nhất khi Triển khai Khả năng Quan sát Dữ liệu

Để triển khai khả năng quan sát dữ liệu hiệu quả, hãy tập trung vào các thực tiễn tốt nhất sau:

Bắt đầu với các pipeline có tác động cao

Tập trung giám sát trước các pipeline dữ liệu quan trọng nhất—những pipeline có ảnh hưởng lớn nhất đến kinh doanh. Bạn có thể giảm thiểu rủi ro bằng cách đảm bảo các pipeline này khỏe mạnh trong khi dần xây dựng chiến lược quan sát rộng hơn cho các pipeline khác.

Đặt ra chỉ số và KPI rõ ràng

Các chỉ số được xác định rõ là chìa khóa để đánh giá sức khỏe dữ liệu—bạn phải biết thế nào là thành công (và thất bại). Các chỉ số này cần phù hợp với mục tiêu tổng thể của công ty để phản ánh điều thực sự quan trọng. Sự rõ ràng này sẽ giúp bạn tập trung và đánh giá tiến độ một cách hiệu quả.

Tự động hóa giám sát chất lượng dữ liệu

Hệ thống giám sát và cảnh báo giúp giảm can thiệp thủ công và cải thiện thời gian phản hồi. Hệ thống tự động có thể phát hiện vấn đề sớm và kích hoạt hành động tức thời để ngăn thời gian chết của dữ liệu. Hãy ưu tiên tự động hóa.

Tích hợp khả năng quan sát vào quy trình hiện có

Đưa khả năng quan sát vào quy trình hằng ngày giúp bạn phản hồi nhanh hơn và hiệu quả hơn, từ đó quản lý dữ liệu chủ động thay vì bị động.

Kết luận

Khả năng quan sát dữ liệu là chìa khóa để xây dựng pipeline dữ liệu chất lượng cao, đáng tin cậy. Bằng cách liên tục giám sát các khía cạnh quan trọng của dữ liệu, đội ngũ có thể xác định và xử lý vấn đề trước khi chúng ảnh hưởng đến kết quả kinh doanh. Khi dữ liệu tiếp tục thúc đẩy quyết định, khả năng quan sát sẽ vẫn là yếu tố cốt lõi để quản lý và tối ưu hóa các pipeline dữ liệu.

Để nắm bắt đầy đủ tầm quan trọng của khả năng quan sát và triển khai hiệu quả, cần hiểu các khái niệm liên quan như kiến trúc dữ liệu, quản trị và quản lý dữ liệu. Nếu bạn muốn đào sâu kiến thức:

Cuối cùng, nếu bạn mới bắt đầu trong lĩnh vực này, Understanding Data Engineering là điểm khởi đầu tuyệt vời để khám phá cách các pipeline dữ liệu được thiết kế và vận hành!

FAQs

Sự khác biệt giữa khả năng quan sát dữ liệu và giám sát dữ liệu là gì?

Giám sát dữ liệu tập trung vào việc theo dõi các chỉ số hoặc hệ thống cụ thể, trong khi khả năng quan sát dữ liệu mang đến hiểu biết sâu hơn về cách dữ liệu cư xử trong suốt vòng đời. Cụ thể, khả năng quan sát dữ liệu cung cấp thông tin chi tiết về nguyên nhân gốc rễ của các vấn đề dữ liệu, do đó mang lại cái nhìn toàn diện hơn so với giám sát đơn thuần.

Ngành nào hưởng lợi nhiều nhất từ khả năng quan sát dữ liệu?

Những ngành có nhu cầu độ tin cậy dữ liệu cao—chẳng hạn tài chính, y tế, thương mại điện tử và logistics—được hưởng lợi đáng kể từ khả năng quan sát dữ liệu. Các ngành này phụ thuộc rất nhiều vào dữ liệu chính xác và kịp thời cho tuân thủ, sự hài lòng của khách hàng và hiệu quả vận hành.

Các công cụ quan sát dữ liệu xử lý pipeline dữ liệu thời gian thực so với batch như thế nào?

Các công cụ quan sát dữ liệu có thể giám sát cả pipeline thời gian thực và batch. Với dữ liệu thời gian thực, chúng theo dõi các chỉ số như độ trễ, thông lượng và bất thường ngay khi xảy ra. Với pipeline batch, chúng đảm bảo tính đầy đủ của dữ liệu, xác thực tuân thủ schema và kiểm tra bất thường sau mỗi lần chạy.

Những thách thức nào khi triển khai khả năng quan sát dữ liệu?

Một số thách thức phổ biến bao gồm lựa chọn công cụ phù hợp với ngăn xếp dữ liệu, điều chỉnh thực tiễn quan sát với mục tiêu kinh doanh và quản lý chi phí phát sinh khi giám sát các pipeline phức tạp. Đảm bảo sự ủng hộ của đội ngũ và phân bổ nguồn lực cho thiết lập và bảo trì cũng rất quan trọng để triển khai thành công.


Kurtis Pykes 's photo
Author
Kurtis Pykes
LinkedIn
Chủ đề
Kỹ thuật Dữ liệu
Khoa học Dữ liệu

Tìm hiểu thêm về quản trị dữ liệu với các khóa học này! 

Lộ trình

Cơ bản về Quản trị Dữ liệu

10 giờ
Khám phá bí quyết quản trị dữ liệu: Quản lý, bảo mật và bảo vệ dữ liệu một cách hiệu quả.
Xem chi tiếtBắt Đầu Khóa Học

Tạo tài khoản miễn phí của bạn

Luyện tập và Lộ trình tiến trình của bạn.

Tiếp Tục Với Google
Bằng cách tiếp tục, bạn chấp nhận Điều khoản sử dụng, Chính sách bảo mật và việc dữ liệu của bạn được lưu trữ tại Hoa Kỳ.
Xem thêm
Liên quan

blog

Claude Opus 4.6: Tính năng, Điểm chuẩn, Bài kiểm tra thực hành và hơn thế nữa

Mô hình mới nhất của Anthropic dẫn đầu ở mã hóa tác tử và lập luận phức tạp. Thêm vào đó, nó có cửa sổ ngữ cảnh 1M.
Matt Crabtree's photo

Matt Crabtree

10 phút

Xem thêm