Vai al contenuto principale
Data Engineering
Data Science

Osservabilità dei dati: concetti, strumenti e best practice

Capisci cos’è l’osservabilità dei dati, perché è importante e come usarla per monitorare e ottimizzare efficacemente le tue pipeline di dati!
Kurtis Pykes 's photo
Kurtis Pykes
Aggiornato · 15 min leggi

Scopri con l'IA

ChatGPTClaudePerplexity

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.

Le aziende dipendono da dati accurati per prendere decisioni—o almeno, così dovrebbe essere. Una pipeline di dati fallita o dati inaffidabili possono compromettere in modo significativo i processi organizzativi.

Immagina questo scenario:

Un team marketing usa i dati dei clienti per creare annunci mirati, ma a causa di un problema sui dati passato inosservato, vengono inviate informazioni obsolete o errate, magari persino alle persone sbagliate.

L’errore potrebbe non essere notato finché i clienti non iniziano a presentare reclami. A quel punto, è troppo tardi. Il danno è fatto—tempo e denaro sono già stati sprecati e probabilmente serviranno ancora più risorse per gestire le conseguenze.

L’osservabilità dei dati mira a evitare che ciò accada. In questo articolo, vedremo come. Iniziamo!

Che cos’è l’osservabilità dei dati?

L’osservabilità dei dati è la capacità di monitorare e comprendere lo stato di salute dei tuoi dati mentre attraversano pipeline e sistemi. Il suo obiettivo principale è garantire che i dati rimangano accurati, coerenti e affidabili—così da poter rilevare e risolvere i potenziali problemi prima che si trasformino in criticità maggiori.

Per esempio, se fai parte del team vendite e ti affidi a report giornalieri per monitorare le performance e definire le prossime mosse, qualunque problema sui dati che alimentano quei report potrebbe mandare all’aria l’intera strategia. L’osservabilità dei dati ti permette di intercettare questi problemi in tempo reale, risolverli e mantenere tutto fluido.

In sostanza, l’osservabilità dei dati significa monitorare i tuoi dati mentre passano attraverso sistemi diversi per assicurarsi che siano accurati e scorrano come previsto. L’obiettivo è individuare qualsiasi problema prima che influenzi decisioni critiche.

In particolare, l’osservabilità dei dati aiuta a:

  • Mantenere la qualità dei dati: Rilevare automaticamente dati mancanti o imprecisi, permettendo ai team di risolvere i problemi prima che portino a decisioni sbagliate.
  • Prevenire i periodi di inattività dei dati: Monitorare le pipeline per anomalie (ad es. cali di volume, schemi interrotti) e avvisare i team prima che le interruzioni peggiorino.
  • Governance e conformità: Individuare problemi di qualità o violazioni della sicurezza dei dati, aiutando a rispettare normative sulla privacy come GDPR o CCPA.
  • Costruire fiducia nei dati: Fornire trasparenza su come i dati vengono raccolti, elaborati e gestiti, favorendo fiducia nel processo decisionale.

I pilastri dell’osservabilità dei dati

L’osservabilità dei dati si fonda su cinque pilastri chiave: freschezza, distribuzione, volume, schema e lineage. Insieme, questi pilastri assicurano che le pipeline di dati funzionino in modo fluido e che i dati restino accurati, completi e affidabili. 
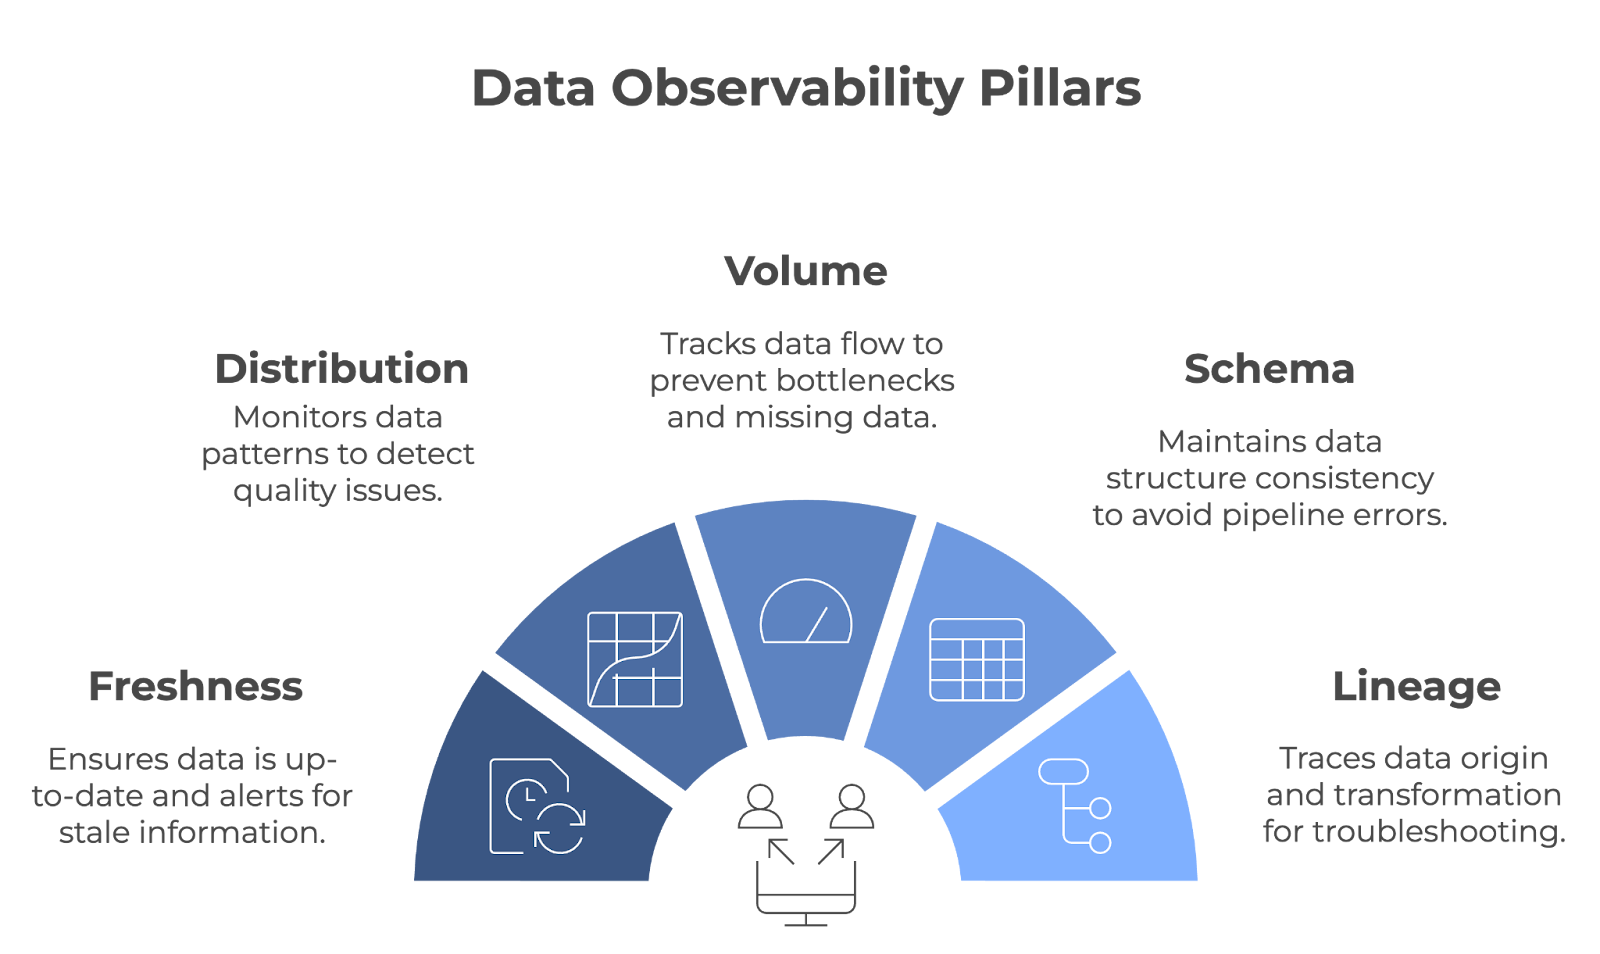
Grafico che mostra i cinque pilastri dell’osservabilità dei dati

I cinque pilastri dell’osservabilità dei dati. Immagine dell’autore (creata con napkin.ai)

Esaminiamo ciascun pilastro nel dettaglio!

Freschezza

La freschezza indica quanto sono aggiornati i tuoi dati. Traccia quando i dati sono stati aggiornati l’ultima volta e ti avvisa se diventano obsoleti. Questo pilastro è importante per i team che si basano su dati in tempo reale o quasi per prendere decisioni.

  • Esempio: Immagina un rivenditore che regola i livelli di inventario in base ai dati di vendita in tempo reale. Se quei dati non vengono aggiornati in tempo, l’azienda potrebbe ritrovarsi con troppa o troppo poca merce. La freschezza aiuta a prevenire ciò assicurando che le decisioni si basino sulle informazioni più recenti.

Distribuzione

La distribuzione si riferisce al tracciamento dei pattern e dei valori specifici nei tuoi dati (ad es. media, mediana, deviazione standard, ecc.). Monitorare questi valori aiuta a individuare quando qualcosa non torna, segnale potenziale di problemi di qualità. Controlli regolari della distribuzione garantiscono che i dati rimangano coerenti nel tempo.

  • Esempio: Una piattaforma online analizzerebbe probabilmente le metriche di engagement dei clienti. Per verificare la coerenza, potrebbe monitorare le distribuzioni di metriche come durata della sessione, tassi di conversione, ecc. Un picco o un calo improvviso in queste metriche potrebbe indicare problemi nel processo di raccolta dati o un errore di sistema sottostante.

Volume

Il volume dei dati si riferisce alla quantità di dati che fluisce attraverso un sistema. Questa metrica viene tracciata per assicurarsi che la quantità prevista di dati venga acquisita ed elaborata senza cali o picchi inattesi. Il volume viene monitorato per rilevare rapidamente problemi come dati mancanti o colli di bottiglia nella pipeline. 

  • Esempio: Un’azienda di logistica che si affida ai dati GPS di una flotta di veicoli monitorerebbe il volume dei dati di localizzazione trasmessi. Se il volume cala inaspettatamente, potrebbe indicare guasti di comunicazione con alcuni veicoli, con conseguenti lacune nel tracciamento.

Schema

L’osservabilità dello schema monitora la struttura dei dati—è importante che resti coerente nel tempo. Quando lo schema cambia inaspettatamente, può interrompere le pipeline e portare a errori di elaborazione.

  • Esempio: Immagina che il tuo team marketing segmenti i clienti per età e località. Per evitare che la pipeline si rompa, il team dovrebbe assicurarsi che le modifiche allo schema (ad es. rinomina di colonne, variazione di tipi di dato, ecc.) non causino errori nel sistema di reportistica. Qualsiasi modifica non rilevata potrebbe portare a segmentazioni clienti errate.

Lineage

La lineage fornisce una visione chiara dell’origine dei tuoi dati, di come vengono trasformati e dove finiscono. È fondamentale per il troubleshooting e il mantenimento della qualità in sistemi complessi. Quando si presentano problemi, la lineage consente di risalire ai punti dati lungo la pipeline per trovare la fonte dell’errore.

  • Esempio: In una banca, la lineage dei dati potrebbe essere usata per tracciare un dato specifico, come il saldo di un conto, fino alla sua origine. Se emergono discrepanze, la lineage permette ai data engineer di identificare dove nella pipeline si è verificato il problema.

Come funziona l’osservabilità dei dati

In tutto l’articolo, abbiamo accennato al fatto che l’osservabilità dei dati monitora attivamente le pipeline, invia avvisi quando sorgono problemi e aiuta i team a trovare rapidamente la causa radice.

Vediamo come funziona ciascun componente nella pratica!

Monitoraggio delle pipeline di dati

Gli strumenti di osservabilità rilevano gli errori monitorando costantemente le pipeline. Possono tracciare molti aspetti di una pipeline, ma in genere vengono configurati per concentrarsi su metriche o aree specifiche più critiche per le esigenze dell’organizzazione.

Questi strumenti spesso si integrano con tecnologie come Apache Kafka, Apache Airflow, o servizi cloud come AWS Glue o Google Cloud Dataflow per raccogliere insight nelle varie fasi della pipeline. Per esempio:

  • Validazione dello schema: Strumenti come Great Expectations possono imporre regole di schema, garantendo che i dati in ingresso rispettino formati predefiniti (ad es. tipi di dato, presenza di colonne e restrizioni di lunghezza).
  • Rilevamento anomalie: Piattaforme come Monte Carlo o Databand.ai usano il machine learning per identificare pattern insoliti nel volume dei dati, nei tempi di elaborazione o nelle distribuzioni che potrebbero segnalare un problema.
  • Tracciamento della lineage: Strumenti come OpenLineage o Apache Atlas visualizzano come i dati fluiscono tra i sistemi, facilitando la risalita all’impatto di modifiche o errori.

Avvisi e automazione

A che serve rilevare in fretta i problemi se nessuno viene informato? Gli strumenti di osservabilità inviano automaticamente avvisi alle persone giuste e talvolta intraprendono azioni basate su configurazioni predefinite.

Questi avvisi sono spesso configurati su soglie o trigger, come record mancanti, cambiamenti di schema o ritardi inattesi dei dati. Per esempio:

  • Se una pipeline in Apache Airflow fallisce, uno strumento di osservabilità potrebbe rilevare un calo improvviso del volume dei dati e notificare automaticamente il team di data engineering via Slack.
  • Alcune piattaforme, come Datafold o Soda, offrono opzioni di remediation automatica. Per esempio, un sistema potrebbe ripristinare un dataset al suo ultimo stato verificato o reindirizzare i dati in ingresso verso un’area di storage di backup usando strumenti cloud come AWS Lambda.

Analisi della causa radice

L’analisi della causa radice è un processo sistematico per identificare il motivo fondamentale alla base di un problema. Nel contesto dell’osservabilità dei dati, significa risalire all’origine del problema invece di limitarci a trattarne i sintomi.

Le piattaforme di osservabilità offrono spesso ricche capacità diagnostiche, integrandosi con sistemi di gestione dei log come Elasticsearch o piattaforme di monitoraggio come Prometheus e Grafana per far emergere dettagli granulari. Per esempio:

  • Uno strumento potrebbe collegare una trasformazione fallita in dbt a una mancata corrispondenza di schema in un database sorgente.
  • Analizzando i dati di lineage, la piattaforma può evidenziare quali report o dashboard a valle sono interessati, permettendo ai team di dare priorità alle correzioni.

Strumenti per l’osservabilità dei dati

Spesso i data engineer implementano internamente funzioni di osservabilità. Tuttavia, oggi sono disponibili diversi strumenti potenti che consentono ai team di implementare in modo efficace l’osservabilità dei dati pronta all’uso. Vediamo i più popolari!

Monte Carlo

Monte Carlo è una potente piattaforma di osservabilità dei dati progettata per aiutare i team a mantenere in salute i loro sistemi dati. Creata da un team di ex ingegneri di aziende come LinkedIn e Facebook, la piattaforma nasce dal desiderio di risolvere la crescente sfida dei periodi di inattività dei dati. Offre:

  • Controlli automatici di qualità dei dati: Traccia cambiamenti di schema, freschezza, volume e distribuzione per rilevare anomalie.
  • Analisi della causa radice: Aiuta i team a individuare l’origine dei problemi, come pipeline interrotte o dati mancanti.
  • Lineage dei dati end-to-end: Visualizza il flusso dei dati per comprendere l’impatto di cambiamenti o interruzioni.

Monte Carlo si integra con strumenti come Snowflake, dbt e Looker, risultando ideale per team che lavorano in ecosistemi dati moderni.

Bigeye

Bigeye è stata fondata nel 2020 da un gruppo di data engineer. È una piattaforma di osservabilità dei dati pensata per mantenere qualità e affidabilità dei dati lungo tutto il loro ciclo di vita.

La piattaforma si concentra sull’automazione del monitoraggio della qualità, del rilevamento delle anomalie e della risoluzione dei problemi per mantenere fluide le pipeline e garantire che gli stakeholder possano fare affidamento su dati accurati per le loro decisioni. Tra le funzionalità:

  • Monitoraggio personalizzabile: Consente ai team di impostare soglie specifiche per metriche come completezza, freschezza e accuratezza dei dati.
  • Rilevamento anomalie: Usa il machine learning per identificare outlier o cambiamenti inattesi nei dati.
  • Strumenti di collaborazione: Fornisce avvisi e report che si integrano con Slack e Jira per semplificare la risoluzione dei problemi.

Databand

Databand è una piattaforma di osservabilità dei dati per gestire in modo proattivo la salute dei dati fornendo visibilità sulle pipeline. Fondata nel 2019, Databand è stata creata per affrontare la crescente complessità e scala degli ambienti dati.

La piattaforma è stata costruita per aiutare i data engineer a rilevare i problemi in tempo reale, comprendere il flusso dei dati e garantire l’accuratezza dei dataset in tutta l’organizzazione. Le sue funzionalità sono:

  • Monitoraggio delle pipeline: Traccia metriche come runtime, volume dei dati ed errori attraverso strumenti come Apache Airflow e Spark.
  • Analisi dell’impatto dei dati: Evidenzia le dipendenze a valle per dare priorità alle correzioni critiche.
  • Capacità di integrazione: Funziona con piattaforme come BigQuery, Kafka e Kubernetes per una visibilità end-to-end.

Datadog

Datadog è una piattaforma cloud di monitoraggio e analisi che offre osservabilità in tempo reale. Fondata nel 2010 da Olivier Pomel e Alexis Lê-Quôc, Datadog è nata per affrontare la complessità delle moderne applicazioni cloud. 

Datadog è ideale per aziende che necessitano di un monitoraggio completo su vari sistemi. La piattaforma è particolarmente utile per aziende cloud-native o con sistemi complessi e distribuiti. Tra le funzionalità:

  • Monitoraggio unificato: Traccia metriche, log e trace tra applicazioni, infrastruttura e pipeline di dati.
  • Alerting in tempo reale: Invia notifiche personalizzabili via email, Slack o PagerDuty.
  • Ecosistema di integrazioni: Supporta oltre 500 integrazioni, tra cui AWS, Google Cloud e Docker.

Confronto degli strumenti di osservabilità dei dati

Strumento

Aree di focus

Integrazioni

Ideale per

Monte Carlo

Qualità dei dati, rilevamento anomalie, data lineage

Snowflake, dbt, Looker

Ecosistemi dati moderni che necessitano di osservabilità automatizzata

Bigeye

Monitoraggio qualità dei dati, rilevamento anomalie, interfaccia intuitiva

Slack, Jira, principali data lake e data warehouse

Settori con elevati requisiti di affidabilità dei dati (ad es. finanza, sanità)

Databand

Monitoraggio pipeline, analisi impatto dei dati, avvisi in tempo reale

Apache Airflow, Spark, BigQuery, Kafka

Team che gestiscono flussi di dati complessi e ad alto volume

Datadog

Monitoraggio unificato, alerting in tempo reale, supporto cloud-native

AWS, Google Cloud, Docker, Kubernetes

Aziende con sistemi distribuiti o configurazioni cloud-native

Best practice per implementare l’osservabilità dei dati

Per implementare efficacemente l’osservabilità dei dati, concentrati su queste best practice:

Parti dalle pipeline a maggior impatto

Concentra il monitoraggio prima sulle pipeline più critiche—quelle con il maggiore impatto sul business. Puoi mitigare il rischio assicurandoti che queste pipeline siano sane, mentre costruisci gradualmente una strategia di osservabilità più ampia sulle altre pipeline.

Definisci metriche e KPI chiari

Metriche ben definite sono fondamentali per valutare la salute dei dati—devi sapere cosa significa successo (e fallimento). Queste metriche devono allinearsi agli obiettivi dell’azienda per riflettere ciò che conta davvero. Questa chiarezza ti aiuterà a restare focalizzato e a valutare i progressi in modo efficace.

Automatizza il monitoraggio della qualità dei dati

Sistemi di monitoraggio e alerting riducono l’intervento manuale e migliorano i tempi di risposta. I sistemi automatici possono rilevare i problemi in anticipo e avviare azioni immediate per prevenire l’inattività dei dati. Fai dell’automazione una priorità.

Integra l’osservabilità nei processi esistenti

Incorporare l’osservabilità nei processi quotidiani ti consente di rispondere più rapidamente ed efficacemente, rendendo la gestione dei dati più proattiva e meno reattiva.

Conclusione

L’osservabilità dei dati è fondamentale per costruire pipeline di dati di alta qualità e affidabili. Monitorando continuamente gli aspetti critici dei dati, i team possono individuare e risolvere i problemi prima che impattino sui risultati di business. Poiché i dati continuano a guidare le decisioni, l’osservabilità resterà un elemento centrale per gestire e ottimizzare le pipeline.

Per comprendere appieno l’importanza dell’osservabilità e implementarla efficacemente, è necessario conoscere concetti correlati come architettura dei dati, governance e data management. Se vuoi approfondire le tue competenze:

Infine, se sei nuovo nel campo, Understanding Data Engineering è un ottimo punto di partenza per esplorare come vengono progettate e mantenute le pipeline di dati!

FAQs

Qual è la differenza tra osservabilità dei dati e data monitoring?

Il data monitoring si concentra sul tracciamento di metriche o sistemi specifici, mentre l’osservabilità dei dati ti offre una comprensione più profonda di come i dati si comportano lungo il loro ciclo di vita. In particolare, l’osservabilità fornisce insight sulla causa radice dei problemi sui dati, offrendo quindi una visione più completa rispetto al semplice monitoraggio.

Quali settori beneficiano maggiormente dell’osservabilità dei dati?

I settori con elevati requisiti di affidabilità dei dati—come finanza, sanità, e-commerce e logistica—traggono grande beneficio dall’osservabilità dei dati. Questi settori dipendono fortemente da dati accurati e tempestivi per conformità, soddisfazione del cliente ed efficienza operativa.

Come gestiscono gli strumenti di osservabilità dei dati le pipeline in tempo reale rispetto a quelle batch?

Gli strumenti di osservabilità possono monitorare sia pipeline in tempo reale sia batch. Per i dati in tempo reale, tracciano metriche come latenza, throughput e anomalie man mano che si verificano. Per le pipeline batch, garantiscono la completezza dei dati, validano la conformità dello schema e verificano le anomalie dopo ogni esecuzione.

Quali sono alcune sfide nell’implementare l’osservabilità dei dati?

Alcune sfide comuni includono la scelta degli strumenti giusti per il tuo stack dati, l’allineamento delle pratiche di osservabilità agli obiettivi di business e la gestione dell’overhead aggiuntivo nel monitoraggio di pipeline complesse. Ottenere il buy-in del team e allocare risorse per setup e manutenzione sono anch’essi fattori critici per un’implementazione di successo.


Kurtis Pykes 's photo
Author
Kurtis Pykes
LinkedIn
Argomenti
Data Engineering
Data Science

Approfondisci la data governance con questi corsi! 

Programma

Fondamenti di governance dei dati

10 ore
Svela i segreti della governance dei dati: gestisci, proteggi e proteggi i dati in modo efficace.
Vedi i dettagliInizia Il Corso

Crea il tuo account gratuito

Pratica and corso your progress.

Continua Con Google
Continuando, accetti i nostri Termini di utilizzo, la nostra Informativa sulla privacy e che i tuoi dati siano conservati negli Stati Uniti.
Mostra altro
Correlato

blog

Che cos'è Snowflake? Guida per principianti alla piattaforma dati cloud

Esplora le basi di Snowflake, la piattaforma dati cloud. Scopri la sua architettura, le sue funzionalità e come integrarla nelle tue pipeline di dati.
Tim Lu's photo

Tim Lu

12 min

blog

Tokenizzazione nel NLP: come funziona, sfide e casi d'uso

Guida al preprocessing NLP nel machine learning. Copriamo spaCy, i transformer di Hugging Face e come funziona la tokenizzazione in casi d'uso reali.
Abid Ali Awan's photo

Abid Ali Awan

10 min

blog

I 15 migliori server MCP remoti che ogni AI builder dovrebbe conoscere nel 2026

Scopri i 15 migliori server MCP remoti che stanno trasformando lo sviluppo AI nel 2026. Scopri come migliorano automazione, ragionamento, sicurezza e velocità dei workflow.
Abid Ali Awan's photo

Abid Ali Awan

15 min

Mostra altro

