
डेटा ऑब्ज़र्वेबिलिटी के स्तंभ
डेटा ऑब्ज़र्वेबिलिटी पाँच प्रमुख स्तंभों पर आधारित है: फ्रेशनैस, डिस्ट्रीब्यूशन, वॉल्यूम, स्कीमा और लिनिएज। साथ मिलकर, ये स्तंभ सुनिश्चित करते हैं कि डेटा पाइपलाइनें सुचारू रूप से चलें और डेटा सटीक, पूर्ण और भरोसेमंद बना रहे।
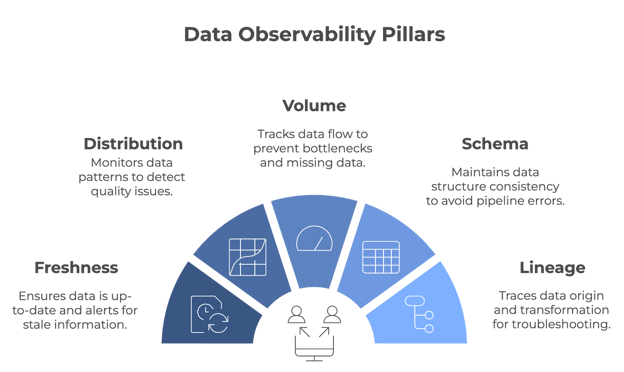
डेटा ऑब्ज़र्वेबिलिटी के पाँच स्तंभ। चित्र: लेखक (napkin.ai से बनाया गया)
आइए प्रत्येक स्तंभ को विस्तार से समझते हैं!
Freshness
फ्रेशनैस बताता है कि आपका डेटा कितना अद्यतन है। यह ट्रैक करता है कि डेटा आख़िरी बार कब अपडेट हुआ और बासी होने पर अलर्ट करता है। यह स्तंभ उन टीमों के लिए अहम है जो रियल-टाइम या निकट रियल-टाइम डेटा पर निर्णय लेने के लिए निर्भर हैं।
- उदाहरण: एक रिटेलर को लें जो लाइव बिक्री डेटा के आधार पर इन्वेंट्री स्तर समायोजित करता है। यदि वह डेटा समय पर अपडेट नहीं होता, तो कंपनी के पास बहुत अधिक या बहुत कम स्टॉक हो सकता है। फ्रेशनैस यह सुनिश्चित करके इसे रोकने में मदद करता है कि निर्णय नवीनतम जानकारी के आधार पर हों।
Distribution
डिस्ट्रीब्यूशन से तात्पर्य आपके डेटा में पैटर्न और विशिष्ट मानों (जैसे, मीन, मेडियन, स्टैंडर्ड डिविएशन आदि) को ट्रैक करने से है। इन मानों की निगरानी से तब अनियमितताएँ पकड़ में आती हैं जब कुछ गलत दिखता है, जो डेटा गुणवत्ता मुद्दों का संकेत हो सकता है। नियमित डिस्ट्रीब्यूशन जाँच यह सुनिश्चित करती है कि समय के साथ डेटा सुसंगत बना रहे।
- उदाहरण: एक ऑनलाइन प्लेटफ़ॉर्म संभवतः ग्राहक एंगेजमेंट मेट्रिक्स का विश्लेषण करेगा। स्थिरता जाँचने के लिए वे सत्र अवधि, कन्वर्ज़न रेट आदि जैसी मेट्रिक्स के लिए डेटा डिस्ट्रीब्यूशन की निगरानी कर सकते हैं। इन मेट्रिक्स में अचानक स्पाइक या गिरावट डेटा संग्रह प्रक्रिया में समस्या या किसी अंदरूनी सिस्टम त्रुटि का संकेत दे सकती है।
Volume
डेटा वॉल्यूम से आशय सिस्टम से होकर गुजरने वाले डेटा की मात्रा से है। इस मेट्रिक को इसलिए ट्रैक किया जाता है ताकि यह सुनिश्चित हो कि अपेक्षित मात्रा में डेटा बिना किसी अप्रत्याशित गिरावट या उछाल के इन्गेस्ट और प्रोसेस हो रहा है। वॉल्यूम की निगरानी से गायब डेटा या पाइपलाइन बॉटलनेक्स जैसी समस्याएँ जल्दी पकड़ी जा सकती हैं।
- उदाहरण: एक लॉजिस्टिक्स कंपनी, जो वाहनों के बेड़े से GPS डेटा पर निर्भर करती है, प्रेषित लोकेशन डेटा के वॉल्यूम की निगरानी करेगी। यदि डेटा वॉल्यूम अप्रत्याशित रूप से घटता है, तो यह कुछ वाहनों के साथ संचार विफलता का संकेत हो सकता है, जिससे ट्रैकिंग में खामियाँ आ सकती हैं।
Schema
स्कीमा ऑब्ज़र्वेबिलिटी डेटा की संरचना को ट्रैक करती है—यह ज़रूरी है कि समय के साथ वह सुसंगत बनी रहे। जब आपका स्कीमा अप्रत्याशित रूप से बदलता है, तो यह डेटा पाइपलाइनों को तोड़ सकता है और प्रोसेसिंग में त्रुटियों का कारण बन सकता है।
- उदाहरण: मान लीजिए आपकी मार्केटिंग टीम उम्र और लोकेशन के आधार पर ग्राहकों का सेगमेंटेशन करती है। डेटा पाइपलाइन टूटने से बचाने के लिए टीम को यह सुनिश्चित करना होगा कि स्कीमा में बदलाव (जैसे, कॉलम का नाम बदलना, डेटा टाइप बदलना आदि) उनकी रिपोर्टिंग प्रणाली में त्रुटि न पैदा करें। कोई भी अनदेखा बदलाव गलत ग्राहक सेगमेंटेशन का कारण बन सकता है।
Lineage
लिनिएज यह स्पष्ट दृश्य प्रदान करता है कि आपका डेटा कहाँ से आता है, कैसे ट्रांसफ़ॉर्म होता है और अंततः कहाँ पहुँचता है। यह जटिल प्रणालियों में समस्या निवारण और डेटा गुणवत्ता बनाए रखने के लिए अहम है। जब समस्याएँ उत्पन्न होती हैं, तो लिनिएज आपको पाइपलाइन के माध्यम से डेटा बिंदुओं को वापस ट्रेस करने देता है ताकि समस्या के स्रोत का पता लगाया जा सके।
- उदाहरण: किसी बैंक में, डेटा लिनिएज का उपयोग किसी विशिष्ट डेटा बिंदु, जैसे खाते की शेष राशि, को उसके स्रोत तक ट्रेस करने के लिए किया जा सकता है। यदि विसंगतियाँ सामने आती हैं, तो लिनिएज डेटा इंजीनियरों को यह पहचानने में मदद करता है कि पाइपलाइन के किस चरण में समस्या हुई।
डेटा ऑब्ज़र्वेबिलिटी कैसे काम करती है
पूरे लेख में, हमने उल्लेख किया है कि डेटा ऑब्ज़र्वेबिलिटी सक्रिय रूप से डेटा पाइपलाइनों की निगरानी करती है, समस्या आने पर अलर्ट भेजती है और टीमों को जल्दी से जड़ कारण खोजने में मदद करती है।
आइए देखें कि प्रत्येक घटक व्यवहार में कैसे काम करता है!
डेटा पाइपलाइनों की निगरानी
डेटा ऑब्ज़र्वेबिलिटी टूल्स निरंतर डेटा पाइपलाइनों की निगरानी करके त्रुटियों का पता लगाते हैं। वे डेटा पाइपलाइन के कई पहलुओं को ट्रैक कर सकते हैं, लेकिन प्रायः संगठन की आवश्यकताओं के लिए सबसे महत्वपूर्ण मेट्रिक्स या क्षेत्रों पर फोकस करने हेतु कॉन्फ़िगर किए जाते हैं।
ये टूल्स अक्सर Apache Kafka, Apache Airflow जैसी तकनीकों या AWS Glue या Google Cloud Dataflow जैसी क्लाउड सेवाओं के साथ इंटीग्रेट होते हैं ताकि पाइपलाइन के विभिन्न चरणों में अंतर्दृष्टि एकत्र कर सकें। उदाहरण के लिए:
- स्कीमा वैलिडेशन: Great Expectations जैसे टूल्स स्कीमा नियमों को लागू कर सकते हैं, यह सुनिश्चित करते हुए कि आने वाला डेटा पूर्वनिर्धारित फ़ॉर्मैट्स (जैसे, डेटा टाइप, कॉलम उपस्थिति और लंबाई प्रतिबंध) के अनुरूप हो।
- अनॉमली डिटेक्शन: Monte Carlo या Databand.ai जैसे प्लेटफ़ॉर्म मशीन लर्निंग का उपयोग करके डेटा वॉल्यूम, प्रोसेसिंग समय या डिस्ट्रीब्यूशन्स में असामान्य पैटर्न की पहचान करते हैं जो किसी समस्या का संकेत हो सकते हैं।
- लिनिएज ट्रैकिंग: OpenLineage या Apache Atlas जैसे टूल्स यह विज़ुअलाइज़ करते हैं कि डेटा प्रणालियों के माध्यम से कैसे प्रवाहित होता है, जिससे बदलावों या त्रुटियों के प्रभाव को ट्रेस करना आसान हो जाता है।
अलर्ट्स और ऑटोमेशन
यदि किसी को सूचना ही न मिले तो समस्याओं का जल्दी पता चलने का क्या लाभ? डेटा ऑब्ज़र्वेबिलिटी टूल्स स्वतः ही सही लोगों को अलर्ट भेजते हैं और कभी-कभी पूर्व-परिभाषित कॉन्फ़िगरेशन के आधार पर कार्रवाई भी करते हैं।
ये अलर्ट प्रायः थ्रेशहोल्ड्स या ट्रिगर्स के आधार पर कॉन्फ़िगर किए जाते हैं, जैसे रिकॉर्ड्स का गायब होना, स्कीमा परिवर्तन, या अप्रत्याशित डेटा देरी। उदाहरण के लिए:
- यदि Apache Airflow में कोई पाइपलाइन विफल हो जाती है, तो कोई ऑब्ज़र्वेबिलिटी टूल डेटा वॉल्यूम में अचानक गिरावट का पता लगाकर Slack के माध्यम से डेटा इंजीनियरिंग टीम को स्वतः सूचित कर सकता है।
- कुछ प्लेटफ़ॉर्म, जैसे Datafold या Soda, स्वचालित सुधार विकल्प प्रदान करते हैं। उदाहरण के लिए, कोई सिस्टम किसी डेटासेट को उसकी आख़िरी सत्यापित स्थिति में रोलबैक कर सकता है या AWS Lambda जैसे क्लाउड टूल्स का उपयोग करके आने वाले डेटा को बैकअप स्टोरेज लोकेशन पर रीरूट कर सकता है।
रूट कॉज़ एनालिसिस
रूट कॉज़ एनालिसिस किसी समस्या के मूल कारण की पहचान करने की एक व्यवस्थित प्रक्रिया है। डेटा ऑब्ज़र्वेबिलिटी के संदर्भ में, इसका अर्थ है समस्या के लक्षणों को ही संबोधित करने के बजाय उसे उसके मूल स्रोत तक ट्रेस करना।
डेटा ऑब्ज़र्वेबिलिटी प्लेटफ़ॉर्म अक्सर समृद्ध डायग्नोस्टिक क्षमताएँ प्रदान करते हैं, जो Elasticsearch जैसे लॉग प्रबंधन सिस्टम या Prometheus और Grafana जैसे मॉनिटरिंग प्लेटफ़ॉर्म के साथ इंटीग्रेट होकर सूक्ष्म विवरण सामने लाते हैं। उदाहरण के लिए:
- कोई टूल dbt में विफल ट्रांसफ़ॉर्मेशन को स्रोत डेटाबेस में स्कीमा मिसमैच तक ट्रेस कर सकता है।
- लिनिएज डेटा का विश्लेषण करके, प्लेटफ़ॉर्म यह हाइलाइट कर सकता है कि कौन-सी डाउनस्ट्रीम रिपोर्टें या डैशबोर्ड प्रभावित हैं, जिससे टीमें उसी अनुरूप सुधारों को प्राथमिकता दे सकें।
डेटा ऑब्ज़र्वेबिलिटी के टूल्स
अक्सर, डेटा इंजीनियर इन-हाउस ऑब्ज़र्वेबिलिटी फीचर्स लागू करते हैं। हालाँकि, आज कई शक्तिशाली टूल्स उपलब्ध हैं जो टीमों को तैयार-उपयोग के रूप में प्रभावी डेटा ऑब्ज़र्वेबिलिटी लागू करने में सक्षम बनाते हैं। आइए सबसे लोकप्रिय विकल्पों पर नज़र डालें!
Monte Carlo
Monte Carlo एक शक्तिशाली डेटा ऑब्ज़र्वेबिलिटी प्लेटफ़ॉर्म है, जिसे टीमों को उनके डेटा सिस्टम्स के स्वास्थ्य को बनाए रखने में मदद करने के लिए डिज़ाइन किया गया है। LinkedIn और Facebook जैसी कंपनियों के पूर्व इंजीनियरों की टीम द्वारा बनाया गया, यह प्लेटफ़ॉर्म डेटा डाउनटाइम की बढ़ती चुनौती को सुलझाने की इच्छा से विकसित किया गया। यह प्रदान करता है:
- स्वचालित डेटा गुणवत्ता जाँच: स्कीमा परिवर्तन, फ्रेशनैस, वॉल्यूम और डिस्ट्रीब्यूशन को ट्रैक करके अनॉमलीज़ का पता लगाना।
- रूट कॉज़ एनालिसिस: टूटी पाइपलाइन या गायब डेटा जैसी समस्याओं के स्रोत का पता लगाने में टीमों की मदद करता है।
- एंड-टू-एंड डेटा लिनिएज: डेटा फ़्लो का विज़ुअलाइज़ेशन, ताकि बदलावों या व्यवधानों के प्रभाव को समझा जा सके।
Monte Carlo Snowflake, dbt और Looker जैसे टूल्स के साथ इंटीग्रेट होता है, जिससे यह आधुनिक डेटा इकोसिस्टम में काम करने वाली टीमों के लिए उपयुक्त बनता है।
Bigeye
Bigeye की स्थापना 2020 में डेटा इंजीनियरों के एक समूह ने की थी। यह एक डेटा ऑब्ज़र्वेबिलिटी प्लेटफ़ॉर्म है, जिसे डेटा के जीवनचक्र भर उसकी गुणवत्ता और विश्वसनीयता बनाए रखने के लिए डिज़ाइन किया गया है।
यह प्लेटफ़ॉर्म डेटा गुणवत्ता मॉनिटरिंग, अनॉमली डिटेक्शन और डेटा समस्याओं के समाधान को स्वचालित करने पर केंद्रित है, ताकि डेटा पाइपलाइनों का प्रवाह सुचारू बना रहे और स्टेकहोल्डर्स निर्णय लेने के लिए सटीक डेटा पर भरोसा कर सकें। इसकी विशेषताएँ शामिल हैं:
- कस्टमाइज़ेबल मॉनिटरिंग: डेटा पूर्णता, फ्रेशनैस और सटीकता जैसी मेट्रिक्स के लिए विशिष्ट थ्रेशहोल्ड सेट करने की सुविधा।
- अनॉमली डिटेक्शन: डेटा में आउटलायर्स या अप्रत्याशित बदलावों की पहचान के लिए मशीन लर्निंग का उपयोग।
- कोलैबोरेशन टूल्स: Slack और Jira के साथ इंटीग्रेटेड अलर्ट्स और रिपोर्ट्स, जिससे समस्या समाधान सुव्यवस्थित हो।
Databand
Databand एक डेटा ऑब्ज़र्वेबिलिटी प्लेटफ़ॉर्म है, जो डेटा पाइपलाइनों में दृश्यता प्रदान करके डेटा स्वास्थ्य का सक्रिय प्रबंधन संभव बनाता है। 2019 में स्थापित, Databand को डेटा वातावरण की बढ़ती जटिलता और पैमाने को संबोधित करने के लिए बनाया गया था।
यह प्लेटफ़ॉर्म डेटा इंजीनियरों की मदद के लिए बनाया गया है ताकि वे रियल टाइम में समस्याओं का पता लगा सकें, डेटा के प्रवाह को समझ सकें और पूरे संगठन में डेटासेट्स की सटीकता सुनिश्चित कर सकें। इसकी विशेषताएँ हैं:
- पाइपलाइन मॉनिटरिंग: Apache Airflow और Spark जैसे टूल्स में रनटाइम, डेटा वॉल्यूम और त्रुटियों जैसी मेट्रिक्स को ट्रैक करना।
- डेटा इम्पैक्ट एनालिसिस: डाउनस्ट्रीम डिपेंडेंसीज़ को हाइलाइट करना ताकि महत्वपूर्ण सुधारों को प्राथमिकता दी जा सके।
- इंटीग्रेशन क्षमताएँ: एंड-टू-एंड विज़िबिलिटी के लिए BigQuery, Kafka और Kubernetes जैसे प्लेटफ़ॉर्म्स के साथ काम करता है।
Datadog
Datadog एक क्लाउड-आधारित मॉनिटरिंग और एनालिटिक्स प्लेटफ़ॉर्म है जो रियल-टाइम ऑब्ज़र्वेबिलिटी प्रदान करता है। 2010 में Olivier Pomel और Alexis Lê-Quôc द्वारा स्थापित, Datadog आधुनिक क्लाउड एप्लिकेशनों की जटिलता को संबोधित करने के लिए बनाया गया था।
Datadog उन कंपनियों के लिए आदर्श है जिन्हें विभिन्न प्रणालियों में व्यापक मॉनिटरिंग की आवश्यकता होती है। यह प्लेटफ़ॉर्म विशेष रूप से क्लाउड-नेटिव कंपनियों या जटिल, वितरित प्रणालियों वाली संस्थाओं के लिए उपयोगी है। इसकी विशेषताएँ शामिल हैं:
- यूनिफ़ाइड मॉनिटरिंग: एप्लिकेशन, इन्फ्रास्ट्रक्चर और डेटा पाइपलाइनों में मेट्रिक्स, लॉग्स और ट्रेसेज़ को ट्रैक करना।
- रियल-टाइम अलर्टिंग: ईमेल, Slack या PagerDuty के माध्यम से कस्टमाइज़ेबल सूचनाएँ भेजना।
- इंटीग्रेशन इकोसिस्टम: 500 से अधिक इंटीग्रेशन्स का समर्थन, जिनमें AWS, Google Cloud और Docker शामिल हैं।
डेटा ऑब्ज़र्वेबिलिटी टूल्स की तुलना
|
टूल |
फोकस क्षेत्र |
इंटीग्रेशन्स |
किसके लिए आदर्श |
|
Monte Carlo |
डेटा गुणवत्ता, अनॉमली डिटेक्शन, डेटा लिनिएज |
Snowflake, dbt, Looker |
स्वचालित ऑब्ज़र्वेबिलिटी की आवश्यकता वाले आधुनिक डेटा इकोसिस्टम |
|
Bigeye |
डेटा गुणवत्ता मॉनिटरिंग, अनॉमली डिटेक्शन, उपयोगकर्ता-अनुकूल UI |
Slack, Jira, प्रमुख डेटा लेक्स और वेयरहाउस |
उच्च डेटा विश्वसनीयता आवश्यकताओं वाले उद्योग (जैसे, वित्त, स्वास्थ्य सेवा) |
|
Databand |
पाइपलाइन मॉनिटरिंग, डेटा इम्पैक्ट एनालिसिस, रियल-टाइम अलर्ट्स |
Apache Airflow, Spark, BigQuery, Kafka |
हाई-वॉल्यूम, जटिल डेटा स्ट्रीम्स संभालने वाली टीमें |
|
Datadog |
यूनिफ़ाइड मॉनिटरिंग, रियल-टाइम अलर्टिंग, क्लाउड-नेटिव सपोर्ट |
AWS, Google Cloud, Docker, Kubernetes |
वितरित प्रणालियों या क्लाउड-नेटिव सेटअप वाली कंपनियाँ |
डेटा ऑब्ज़र्वेबिलिटी लागू करने की सर्वोत्तम प्रथाएँ
डेटा ऑब्ज़र्वेबिलिटी को प्रभावी ढंग से लागू करने के लिए, इन सर्वोत्तम प्रथाओं पर ध्यान दें:
उच्च-प्रभाव वाली पाइपलाइनों से शुरुआत करें
सबसे अहम डेटा पाइपलाइनों की निगरानी पर पहले फोकस करें—वे, जिनका व्यवसाय पर सबसे अधिक प्रभाव है। इन पाइपलाइनों को स्वस्थ रखकर आप जोखिम को कम कर सकते हैं, और धीरे-धीरे अन्य पाइपलाइनों में व्यापक ऑब्ज़र्वेबिलिटी रणनीति विकसित कर सकते हैं।
स्पष्ट मेट्रिक्स और KPI निर्धारित करें
डेटा स्वास्थ्य का मूल्यांकन करने के लिए स्पष्ट रूप से परिभाषित मेट्रिक्स महत्वपूर्ण हैं—आपको पता होना चाहिए कि सफलता (और विफलता) कैसी दिखती है। ये मेट्रिक्स कंपनी के समग्र लक्ष्यों के साथ संरेखित होने चाहिए ताकि वे वास्तव में महत्वपूर्ण बातों को दर्शाएँ। यह स्पष्टता आपको केंद्रित रहने और प्रगति का प्रभावी मूल्यांकन करने में मदद करेगी।
डेटा गुणवत्ता मॉनिटरिंग को स्वचालित करें
मॉनिटरिंग और अलर्टिंग सिस्टम मैन्युअल हस्तक्षेप को कम करते हैं और प्रतिक्रिया समय में सुधार लाते हैं। स्वचालित सिस्टम समस्याओं का जल्दी पता लगा सकते हैं और डेटा डाउनटाइम रोकने के लिए तत्काल कार्रवाई ट्रिगर कर सकते हैं। ऑटोमेशन को प्राथमिकता दें।
मौजूदा प्रक्रियाओं के साथ ऑब्ज़र्वेबिलिटी को एकीकृत करें
दैनिक प्रक्रियाओं में ऑब्ज़र्वेबिलिटी को एम्बेड करने से आप तेज़ और अधिक प्रभावी ढंग से प्रतिक्रिया दे पाते हैं, जिससे डेटा प्रबंधन अधिक प्रैक्टिव और कम रिएक्टिव बनता है।
निष्कर्ष
उच्च-गुणवत्ता और भरोसेमंद डेटा पाइपलाइनें बनाने के लिए डेटा ऑब्ज़र्वेबिलिटी महत्वपूर्ण है। डेटा के अहम पहलुओं की निरंतर निगरानी करके टीमें समस्याओं की पहचान कर सकती हैं और उन्हें व्यापारिक परिणामों को प्रभावित करने से पहले ही संबोधित कर सकती हैं। जैसे-जैसे डेटा व्यापारिक निर्णयों को आगे बढ़ाता रहेगा, ऑब्ज़र्वेबिलिटी डेटा पाइपलाइनों के प्रबंधन और अनुकूलन का प्रमुख तत्व बनी रहेगी।
ऑब्ज़र्वेबिलिटी के महत्व को पूरी तरह समझने और उसे प्रभावी ढंग से लागू करने के लिए, डेटा आर्किटेक्चर, गवर्नेंस और मैनेजमेंट जैसे संबंधित कॉन्सेप्ट्स को समझना आवश्यक है। यदि आप अपना ज्ञान गहरा करना चाहते हैं:
- Understanding Modern Data Architecture यह बताता है कि संगठनों में डेटा की संरचना और प्रबंधन कैसे होता है।
- Data Governance Concepts का अन्वेषण करें, ताकि समझ सकें कि नीतियाँ और प्रक्रियाएँ डेटा गुणवत्ता, सुरक्षा और अनुपालन कैसे सुनिश्चित करती हैं।
- Data Management Concepts के साथ डेटा को प्रभावी ढंग से प्रबंधित करने के व्यापक सिद्धांतों के बारे में जानें।
अंत में, यदि आप इस क्षेत्र में नए हैं, तो Understanding Data Engineering यह जानने के लिए एक उत्कृष्ट शुरुआती बिंदु है कि डेटा पाइपलाइनें कैसे डिज़ाइन और मेंटेन की जाती हैं!
FAQs
डेटा ऑब्ज़र्वेबिलिटी और डेटा मॉनिटरिंग में क्या अंतर है?
डेटा मॉनिटरिंग विशिष्ट मेट्रिक्स या प्रणालियों को ट्रैक करने पर केंद्रित होती है, जबकि डेटा ऑब्ज़र्वेबिलिटी आपको डेटा के उसके पूरे जीवनचक्र में व्यवहार की गहरी समझ देती है। यानी, डेटा ऑब्ज़र्वेबिलिटी डेटा समस्याओं के मूल कारणों पर अंतर्दृष्टि प्रदान करती है, इस प्रकार केवल मॉनिटरिंग की तुलना में अधिक व्यापक दृष्टिकोण देती है।
डेटा ऑब्ज़र्वेबिलिटी से किन उद्योगों को सबसे अधिक लाभ होता है?
उच्च डेटा विश्वसनीयता आवश्यकताओं वाले उद्योग—जैसे वित्त, स्वास्थ्य सेवा, ई-कॉमर्स और लॉजिस्टिक्स—डेटा ऑब्ज़र्वेबिलिटी से अत्यधिक लाभान्वित होते हैं। ये उद्योग अनुपालन, ग्राहक संतुष्टि और परिचालन दक्षता के लिए सटीक और समय पर डेटा पर बहुत अधिक निर्भर रहते हैं।
डेटा ऑब्ज़र्वेबिलिटी टूल्स रियल-टाइम बनाम बैच डेटा पाइपलाइनों को कैसे संभालते हैं?
डेटा ऑब्ज़र्वेबिलिटी टूल्स रियल-टाइम और बैच दोनों प्रकार की पाइपलाइनों की निगरानी कर सकते हैं। रियल-टाइम डेटा के लिए, वे लेटेंसी, थ्रूपुट और अनॉमलीज़ जैसी मेट्रिक्स को होने के साथ ही ट्रैक करते हैं। बैच पाइपलाइनों के लिए, वे डेटा पूर्णता सुनिश्चित करते हैं, स्कीमा अनुपालन का सत्यापन करते हैं और हर रन के बाद अनॉमलीज़ की जाँच करते हैं।
डेटा ऑब्ज़र्वेबिलिटी लागू करने में कुछ चुनौतियाँ क्या हैं?
कुछ आम चुनौतियों में आपके डेटा स्टैक के लिए सही टूल्स का चयन करना, ऑब्ज़र्वेबिलिटी प्रथाओं को व्यावसायिक लक्ष्यों के साथ संरेखित करना और जटिल पाइपलाइनों की निगरानी के अतिरिक्त ओवरहेड का प्रबंधन शामिल है। टीम की सहमति सुनिश्चित करना और सेटअप व मेंटेनेंस के लिए संसाधन आवंटित करना भी सफल इम्प्लीमेंटेशन के लिए महत्वपूर्ण है।

व्यवसाय निर्णय लेने के लिए सटीक डेटा पर निर्भर करते हैं—या कम से कम, उन्हें करना चाहिए। एक विफल डेटा पाइपलाइन या अविश्वसनीय डेटा संगठनात्मक प्रक्रियाओं को गंभीर रूप से बाधित कर सकता है।
इस परिदृश्य की कल्पना करें:
एक मार्केटिंग टीम लक्षित विज्ञापन बनाने के लिए ग्राहक डेटा का उपयोग करती है, लेकिन एक अनदेखी डेटा समस्या के कारण पुरानी या गलत जानकारी भेज दी जाती है, संभवतः गलत लोगों को भी।
यह त्रुटि तब तक अनदेखी रह सकती है जब तक ग्राहक शिकायतें दर्ज करना शुरू नहीं करते। तब तक बहुत देर हो चुकी होती है। नुकसान हो चुका होता है—समय और पैसे पहले ही बर्बाद हो चुके होते हैं, और परिणामों से निपटने के लिए और भी संसाधनों की आवश्यकता पड़ सकती है।
डेटा ऑब्ज़र्वेबिलिटी का उद्देश्य ऐसी स्थिति को रोकना है। इस लेख में, हम चर्चा करेंगे कि कैसे। आइए शुरू करें!
डेटा ऑब्ज़र्वेबिलिटी क्या है?
डेटा ऑब्ज़र्वेबिलिटी से आशय पाइपलाइनों और प्रणालियों के माध्यम से चलते समय आपके डेटा के स्वास्थ्य की निगरानी और उसे समझने की क्षमता से है। इसका प्राथमिक लक्ष्य यह सुनिश्चित करना है कि डेटा सटीक, सुसंगत और भरोसेमंद बना रहे—ताकि संभावित समस्याओं का पता चल सके और वे बड़े मुद्दों का रूप लेने से पहले हल की जा सकें।
उदाहरण के लिए, यदि आप सेल्स टीम का हिस्सा हैं और प्रदर्शन को ट्रैक करने और आगे के कदम तय करने के लिए दैनिक रिपोर्टों पर निर्भर हैं, तो उन रिपोर्टों को फ़ीड करने वाले डेटा में किसी भी समस्या से आपकी पूरी रणनीति बिगड़ सकती है। डेटा ऑब्ज़र्वेबिलिटी आपको इन समस्याओं को रियल टाइम में पकड़ने, ठीक करने और काम को सुचारू रूप से जारी रखने में सक्षम बनाती है।
इस प्रकार, मूल रूप से, डेटा ऑब्ज़र्वेबिलिटी का मतलब है विभिन्न प्रणालियों से गुजरते समय आपके डेटा की निगरानी करना ताकि यह सुनिश्चित हो कि वह सटीक है और अपेक्षा के अनुरूप प्रवाहित हो रहा है। आप बस इतना करते हैं कि किसी भी समस्या को महत्वपूर्ण निर्णयों को प्रभावित करने से पहले पहचान लेते हैं।
विशेष रूप से, डेटा ऑब्ज़र्वेबिलिटी मदद करती है: