

Khóa học
Làm việc với DeepSeek trong Python
3 giờ
1.4K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleVào tháng 1 năm 2025, DeepSeek phát hành DeepSeek-R1, bước tiếp theo trong nỗ lực phát triển các mô hình suy luận. Đây là bản nâng cấp từ DeepSeek-R1-Lite-Preview trước đó và cho thấy họ nghiêm túc cạnh tranh với o1 của OpenAI.
Kể từ đó, DeepSeek tiếp tục cải thiện mô hình. Tháng 5 năm 2025, họ phát hành DeepSeek-R1-0528, phiên bản nâng cấp với hiệu năng benchmark tốt hơn, ít ảo giác hơn và có các khả năng mới như gọi hàm và hỗ trợ xuất JSON.
Dù DeepSeek có thể hơi chậm hơn đối thủ ở một số khía cạnh, tính mở nguồn và mức giá thấp đáng kể khiến nó trở thành lựa chọn hấp dẫn cho cộng đồng AI.
Trong bài viết này, tôi sẽ phân tích các tính năng chính của DeepSeek-R1, quy trình phát triển, các mô hình chưng cất, cách truy cập, giá, và so sánh với các mô hình của OpenAI.
Tôi viết bài này vào đúng ngày DeepSeek-R1 ra mắt, và hiện đã cập nhật thêm phần về những hệ quả sau đó—tác động đến thị trường chứng khoán, kinh tế học của AI (gồm nghịch lý Jevons và xu hướng hàng hóa hóa các mô hình AI), cùng cáo buộc của OpenAI rằng DeepSeek đã chưng cất mô hình của họ. Tôi cũng bổ sung phần cập nhật về DeepSeek-R1-0528 mới.
Chúng tôi thường xuyên cập nhật cho độc giả những tin tức mới nhất về AI qua The Median, bản tin miễn phí mỗi thứ Sáu tóm lược các câu chuyện nổi bật trong tuần. Đăng ký để luôn nắm bắt chỉ trong vài phút mỗi tuần:
DeepSeek-R1 là một mô hình suy luận mã nguồn mở do DeepSeek, một công ty AI của Trung Quốc, phát triển để giải quyết các nhiệm vụ đòi hỏi suy luận logic, giải toán và ra quyết định theo thời gian thực.
Điểm khác biệt giữa các mô hình suy luận như DeepSeek-R1 và o1 của OpenAI so với các mô hình ngôn ngữ truyền thống là khả năng cho thấy cách chúng đi đến kết luận.
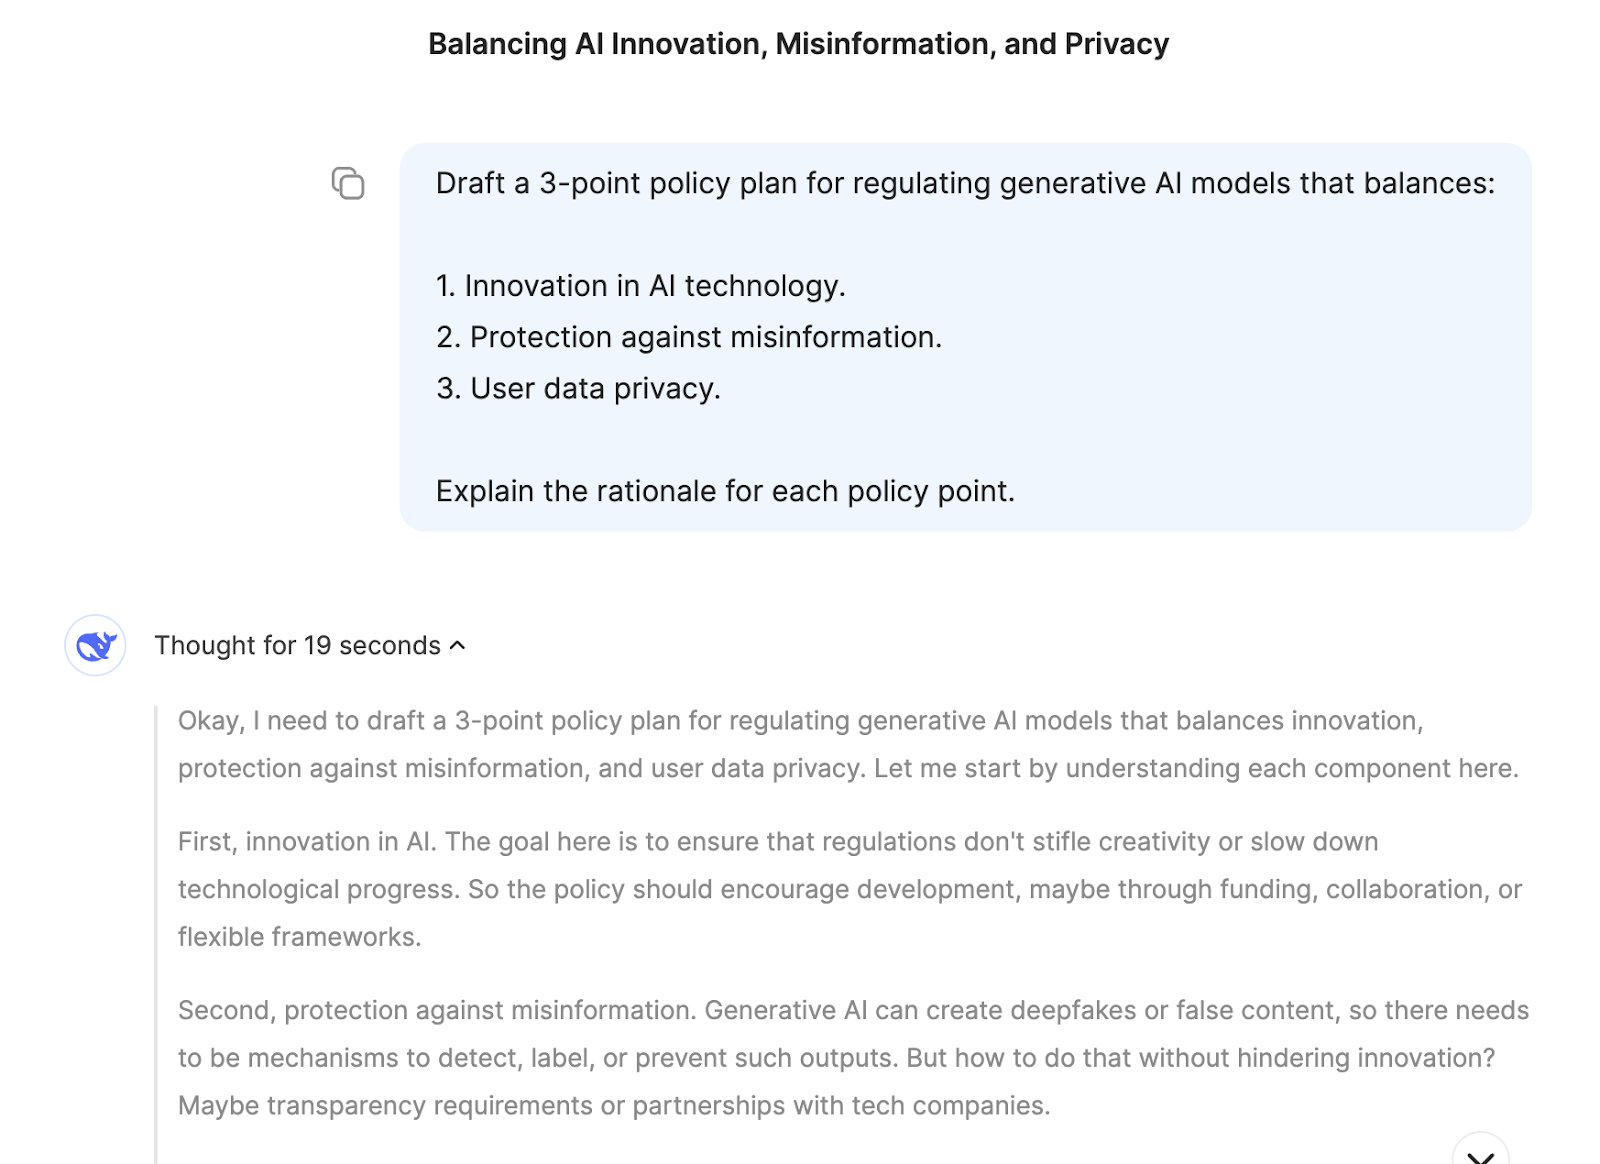
Với DeepSeek-R1, bạn có thể theo dõi lập luận của mô hình, giúp việc hiểu và, nếu cần, phản biện đầu ra trở nên dễ dàng hơn. Năng lực này tạo lợi thế cho các mô hình suy luận trong những lĩnh vực cần tính giải thích, như nghiên cứu hoặc ra quyết định phức tạp.
Điều khiến DeepSeek-R1 đặc biệt cạnh tranh và hấp dẫn là tính chất mã nguồn mở. Không như các mô hình độc quyền, mã nguồn mở cho phép nhà phát triển và nhà nghiên cứu khám phá, chỉnh sửa và triển khai trong một số giới hạn kỹ thuật nhất định, như yêu cầu tài nguyên.
Phần này tôi sẽ trình bày quy trình phát triển DeepSeek-R1, bắt đầu từ tiền nhiệm của nó, DeepSeek-R1-Zero.
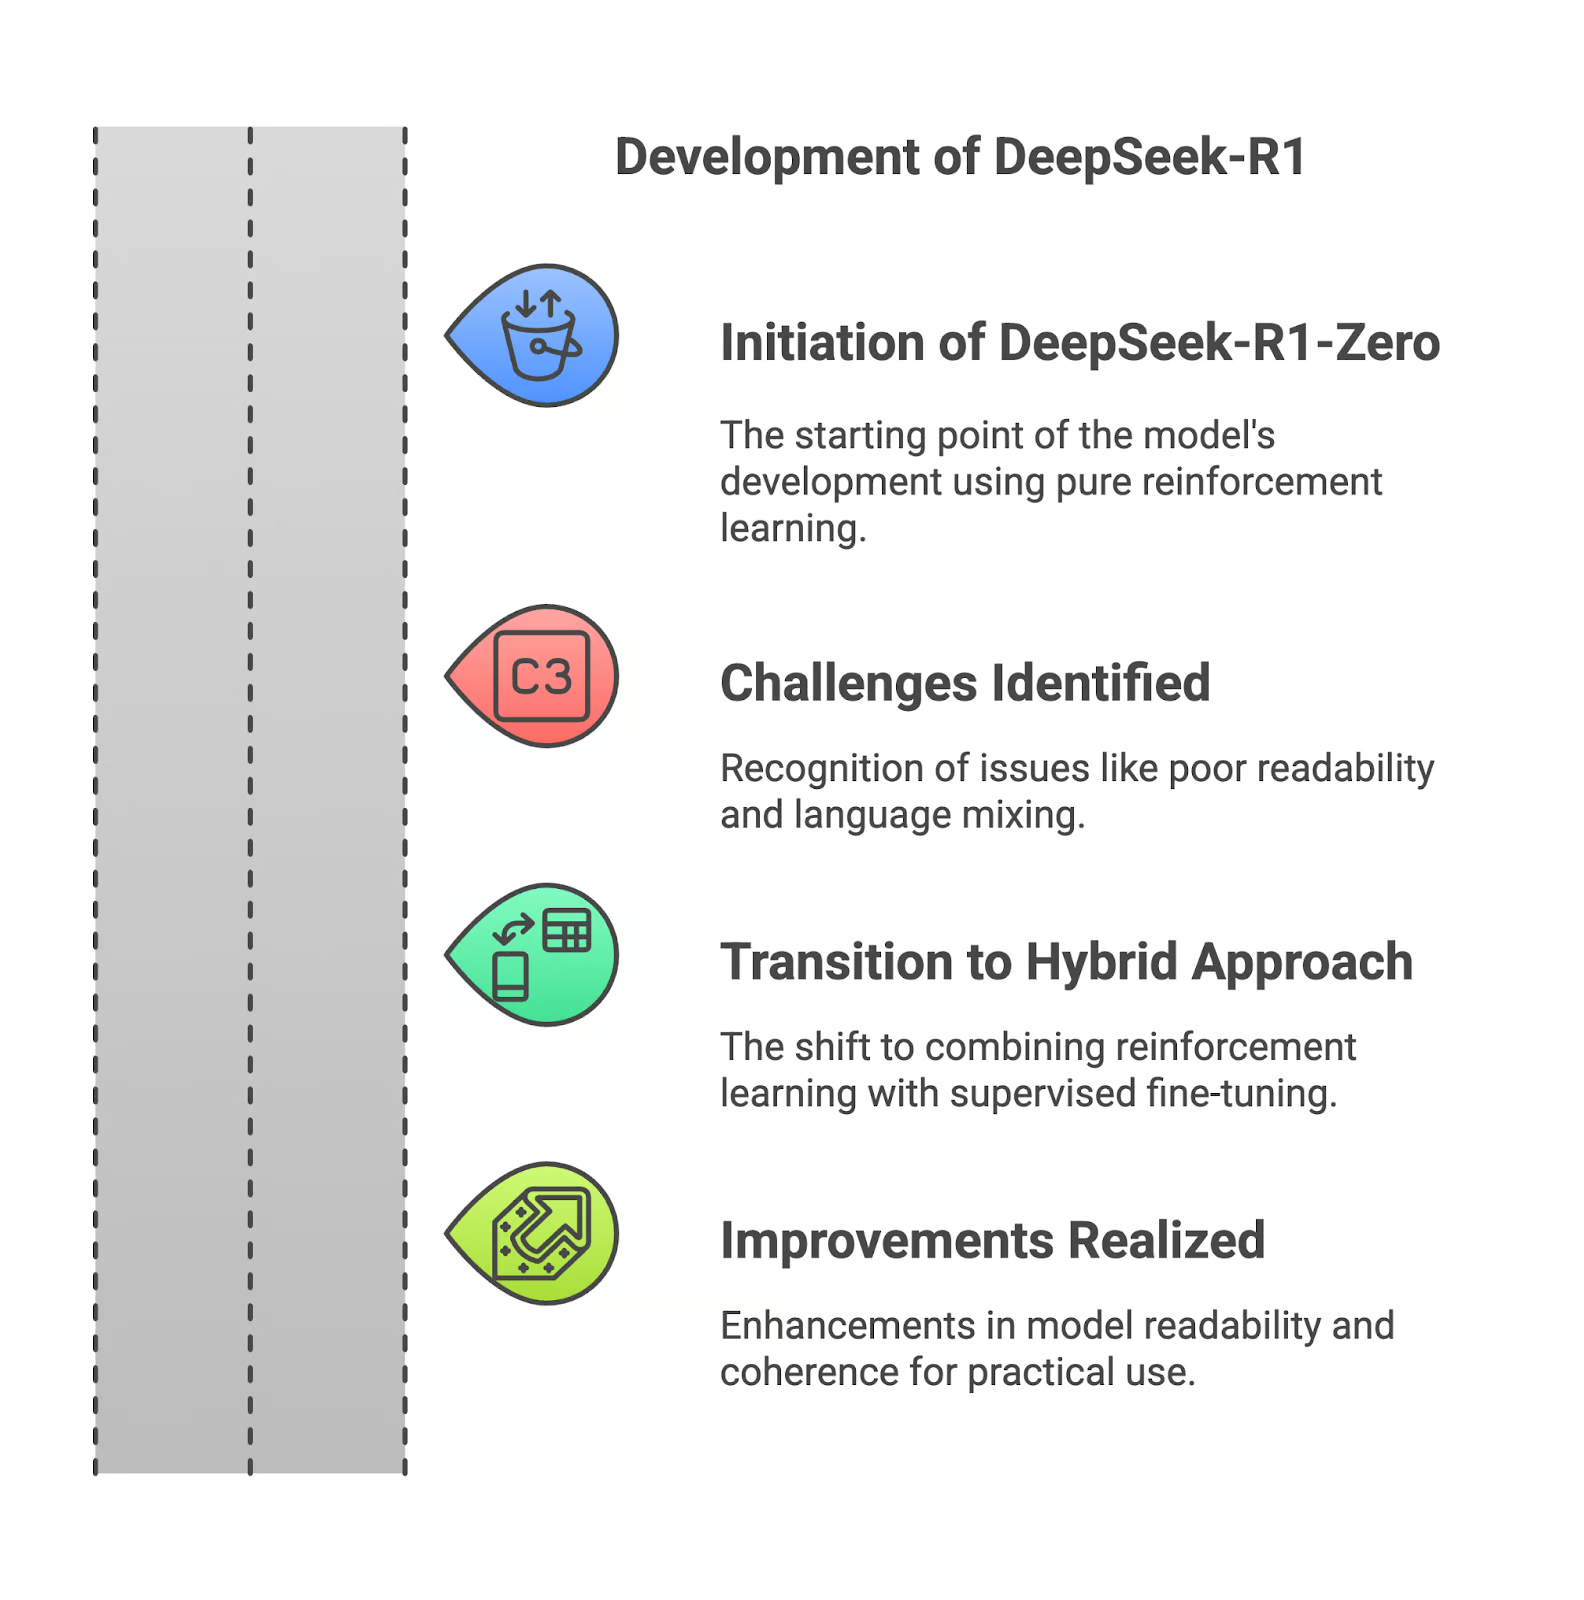
DeepSeek-R1 khởi đầu với R1-Zero, một mô hình được huấn luyện hoàn toàn bằng học tăng cường. Dù cách tiếp cận này giúp mô hình phát triển năng lực suy luận mạnh, nó cũng có nhược điểm lớn: đầu ra khó đọc và đôi khi trộn lẫn ngôn ngữ trong câu trả lời. Những hạn chế này khiến R1-Zero kém thực dụng trong ứng dụng thực tế.
Phụ thuộc hoàn toàn vào học tăng cường tạo ra đầu ra hợp lý về logic nhưng kém cấu trúc. Thiếu dẫn dắt từ dữ liệu giám sát, mô hình gặp khó trong việc truyền đạt mạch lạc quá trình suy luận. Đây là rào cản đối với người dùng cần sự rõ ràng và chính xác.
Để khắc phục, DeepSeek đã thay đổi hướng phát triển R1 bằng cách kết hợp học tăng cường với tinh chỉnh có giám sát. Cách tiếp cận lai này sử dụng bộ dữ liệu được tuyển chọn, cải thiện khả năng đọc và tính mạch lạc của mô hình. Các vấn đề như trộn ngôn ngữ và suy luận rời rạc giảm đáng kể, giúp mô hình phù hợp hơn cho thực tế.
Nếu bạn muốn tìm hiểu thêm về quá trình phát triển DeepSeek-R1, tôi khuyên đọc bài công bố.
Chưng cất trong AI là quá trình tạo các mô hình nhỏ hơn, hiệu quả hơn từ mô hình lớn, giữ lại phần lớn sức mạnh suy luận trong khi giảm nhu cầu tính toán. DeepSeek áp dụng kỹ thuật này để tạo một loạt mô hình chưng cất từ R1, dựa trên kiến trúc Qwen và Llama.
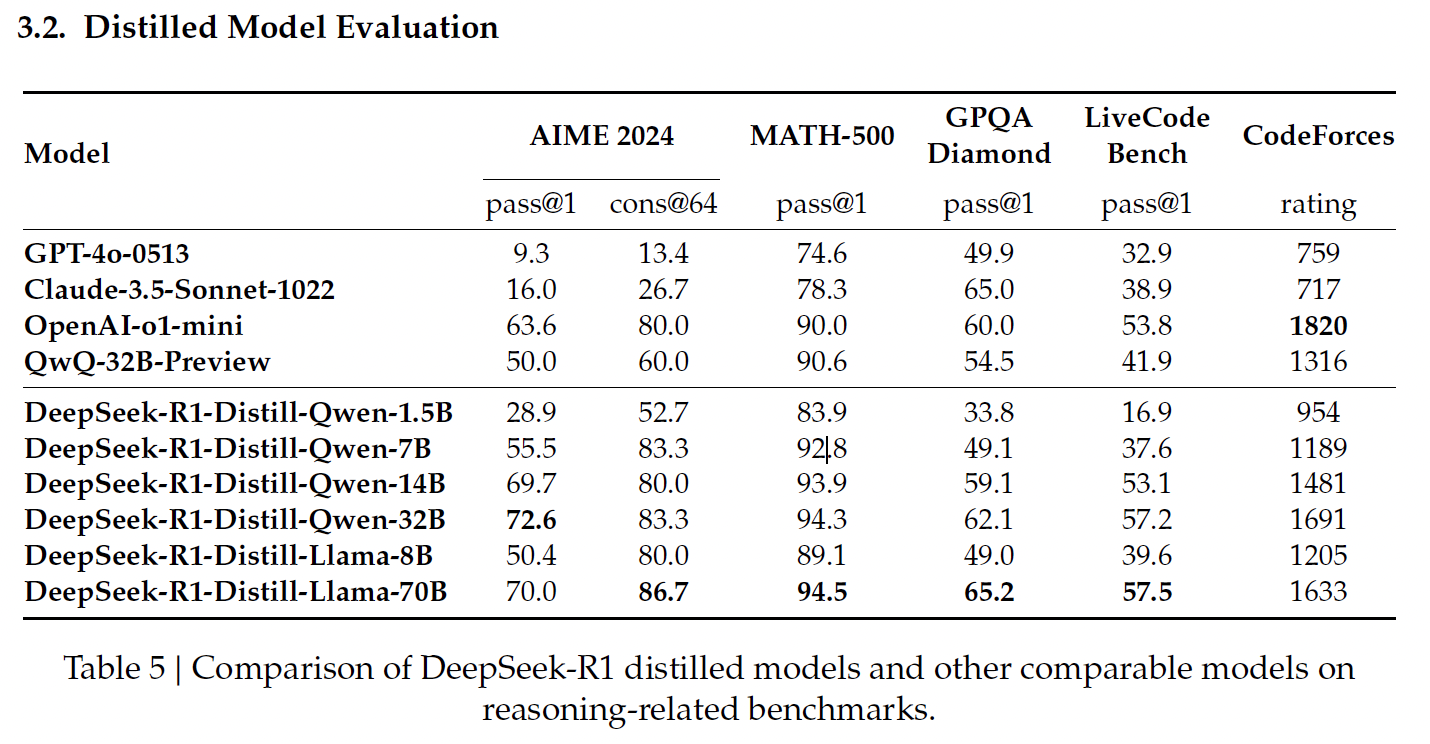
Nguồn: bài công bố của DeepSeek
Các mô hình chưng cất dựa trên Qwen của DeepSeek tập trung vào hiệu quả và khả năng mở rộng, cân bằng giữa hiệu năng và yêu cầu tính toán.
Đây là mô hình chưng cất nhỏ nhất, đạt 83,9% trên MATH-500. MATH-500 kiểm tra khả năng giải các bài toán trình độ trung học với suy luận logic và lời giải nhiều bước. Kết quả cho thấy mô hình xử lý tốt các tác vụ toán cơ bản dù kích thước gọn nhẹ.
Tuy nhiên, hiệu năng của nó giảm đáng kể trên LiveCodeBench (16,9%), bộ đo lường năng lực lập trình, nhấn mạnh hạn chế trong các nhiệm vụ lập trình.
Qwen-7B nổi bật trên MATH-500 với 92,8%, thể hiện khả năng suy luận toán học mạnh. Nó cũng đạt kết quả khá trên GPQA Diamond (49,1%), đánh giá khả năng trả lời câu hỏi thực chứng, cho thấy sự cân bằng giữa suy luận toán và thực chứng.
Tuy vậy, kết quả trên LiveCodeBench (37,6%) và CodeForces (xếp hạng 1189) gợi ý nó kém phù hợp cho các tác vụ lập trình phức tạp.
Mô hình này đạt kết quả tốt trên MATH-500 (93,9%), phản ánh khả năng xử lý bài toán phức tạp. Điểm 59,1% trên GPQA Diamond cũng cho thấy năng lực suy luận thực chứng.
Hiệu năng trên LiveCodeBench (53,1%) và CodeForces (xếp hạng 1481) cho thấy vẫn còn dư địa cải thiện về lập trình và suy luận chuyên biệt cho mã.
Mô hình dựa trên Qwen lớn nhất đạt điểm cao nhất trong nhóm trên AIME 2024 (72,6%), đánh giá suy luận toán nhiều bước nâng cao. Nó cũng xuất sắc trên MATH-500 (94,3%) và GPQA Diamond (62,1%), thể hiện sức mạnh cả về suy luận toán và thực chứng.
Kết quả trên LiveCodeBench (57,2%) và CodeForces (xếp hạng 1691) cho thấy tính đa dụng nhưng vẫn chưa tối ưu cho lập trình so với các mô hình chuyên mã.
Các mô hình chưng cất dựa trên Llama của DeepSeek ưu tiên hiệu năng cao và năng lực suy luận nâng cao, đặc biệt xuất sắc ở những nhiệm vụ đòi hỏi độ chính xác toán học và thực chứng.
Llama-8B thể hiện tốt trên MATH-500 (89,1%) và khá trên GPQA Diamond (49,0%), cho thấy khả năng xử lý suy luận toán và thực chứng. Tuy nhiên, điểm thấp hơn ở các benchmark lập trình như LiveCodeBench (39,6%) và CodeForces (xếp hạng 1205) làm nổi bật hạn chế so với các mô hình dựa trên Qwen ở tác vụ lập trình.
Mô hình chưng cất lớn nhất, Llama-70B, đạt hiệu năng hàng đầu trên MATH-500 (94,5%)—tốt nhất trong tất cả các mô hình chưng cất—và đạt 86,7% trên AIME 2024, là lựa chọn xuất sắc cho suy luận toán nâng cao.
Nó cũng đạt kết quả tốt trên LiveCodeBench (57,5%) và CodeForces (xếp hạng 1633), cho thấy năng lực lập trình vượt trội hơn phần lớn mô hình khác. Ở lĩnh vực này, nó ngang tầm o1-mini hoặc GPT-4o của OpenAI.
Bạn có thể truy cập DeepSeek-R1 qua hai cách chính: nền tảng web DeepSeek Chat và DeepSeek API, cho phép bạn chọn phương án phù hợp nhất.
Nền tảng DeepSeek Chat cung cấp cách tương tác đơn giản với DeepSeek-R1. Bạn có thể đi thẳng đến trang chat hoặc nhấp Start Now trên trang chủ.
Sau khi đăng ký, bạn có thể chọn chế độ “Deep Think” để trải nghiệm khả năng suy luận từng bước của Deepseek-R1.
Để tích hợp DeepSeek-R1 vào ứng dụng của bạn, DeepSeek API cung cấp quyền truy cập theo lập trình.
Để bắt đầu, bạn cần lấy khóa API bằng cách đăng ký trên DeepSeek Platform.
API tương thích với định dạng của OpenAI, nên việc tích hợp sẽ đơn giản nếu bạn quen với công cụ của OpenAI. Bạn có thể xem hướng dẫn chi tiết tại tài liệu API của DeepSeek.
Tính đến tháng 5 năm 2025, nền tảng chat miễn phí khi dùng mô hình R1.
API cung cấp hai mô hình—deepseek-chat (DeepSeek-V3) và deepseek-reasoner (DeepSeek-R1)—với cơ cấu giá sau (trên mỗi 1M token):
|
MÔ HÌNH |
ĐỘ DÀI NGỮ CẢNH |
TỐI ĐA COT TOKENS |
TỐI ĐA TOKEN ĐẦU RA |
1M TOKEN GIÁ INPUT (CACHE HIT) |
1M TOKEN GIÁ INPUT (CACHE MISS) |
1M TOKEN GIÁ OUTPUT |
|
deepseek-chat |
64K |
- |
8K |
$0.07 $0.014 |
$0.27 $0.14 |
$1.10 $0.28 |
|
deepseek-reasoner |
64K |
32K |
8K |
$0.14 |
$0.55 |
$2.19 |
Nguồn: trang giá của DeepSeek
Để có thông tin giá mới nhất và hiểu cách tính chi phí suy luận CoT (Chain-of-Thought), hãy truy cập trang giá của DeepSeek.
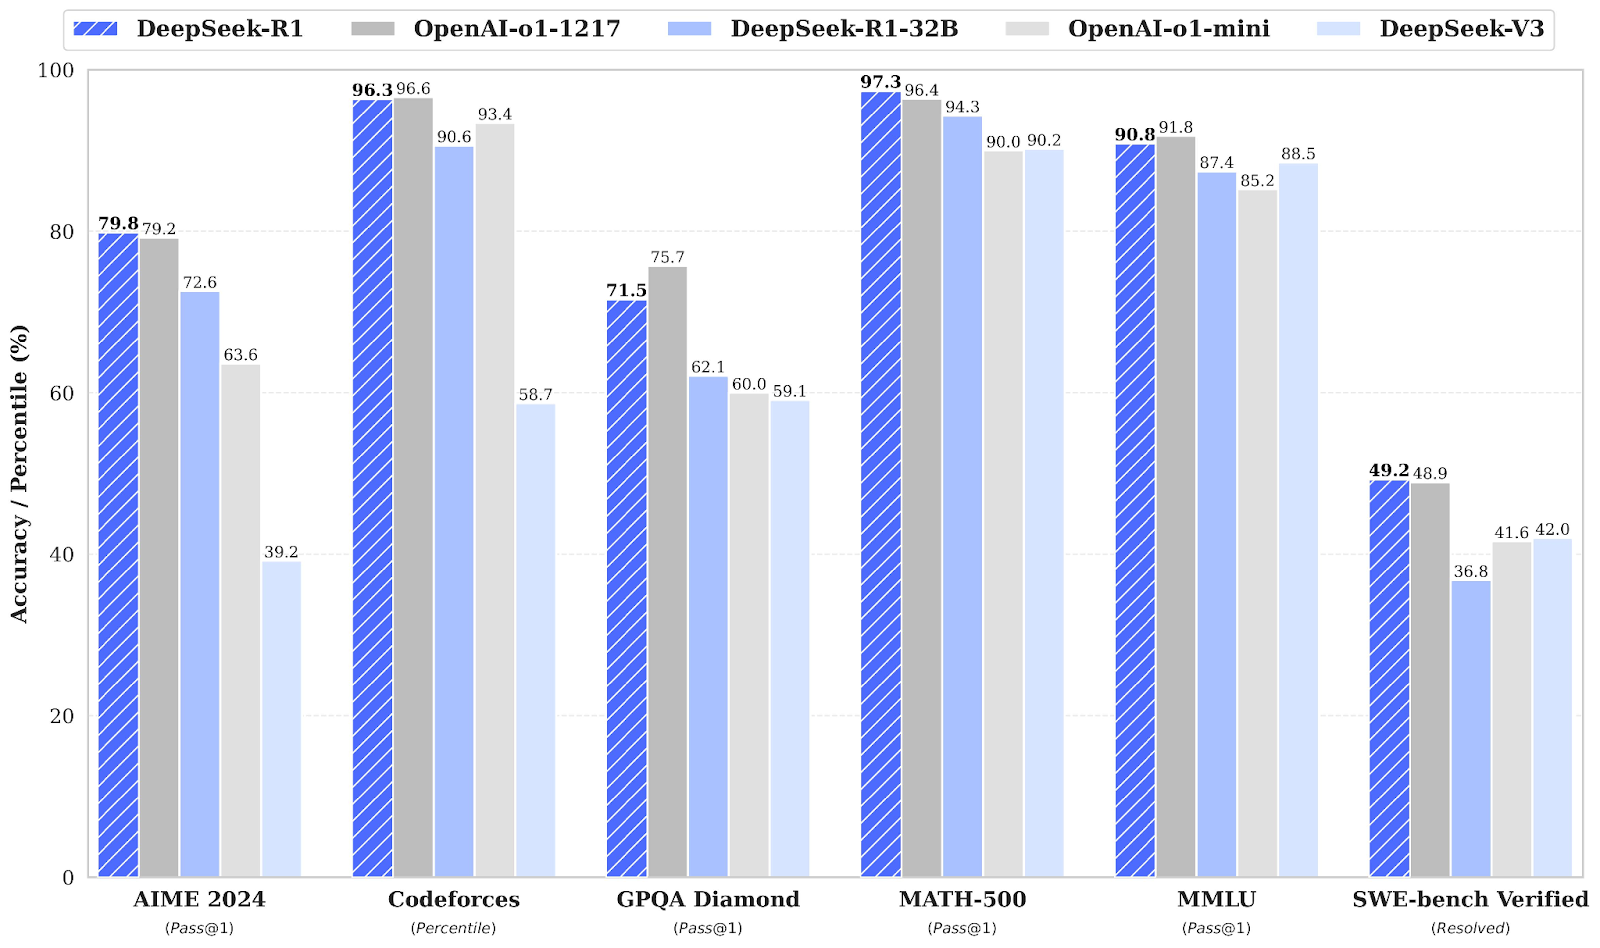
DeepSeek-R1 cạnh tranh trực tiếp với OpenAI o1 trên nhiều benchmark, thường bắt kịp hoặc vượt o1 của OpenAI.
Nguồn: bài công bố của DeepSeek
Ở các benchmark toán, DeepSeek-R1 thể hiện mạnh mẽ. Trên AIME 2024—đánh giá suy luận toán nhiều bước nâng cao—DeepSeek-R1 đạt 79,8%, nhỉnh hơn o1-1217 của OpenAI ở mức 79,2%.
Trên MATH-500, DeepSeek-R1 dẫn đầu với 97,3%, nhỉnh hơn đôi chút so với o1-1217 của OpenAI ở 96,4%. Benchmark này kiểm tra các bài toán đa dạng trình độ trung học đòi hỏi suy luận chi tiết.
Benchmark Codeforces đánh giá khả năng lập trình và suy luận thuật toán của mô hình, thể hiện dưới dạng phần trăm so với người tham gia. OpenAI o1-1217 dẫn đầu với 96,6%, trong khi DeepSeek-R1 đạt 96,3%—chênh lệch rất nhỏ.
Benchmark SWE-bench Verified đánh giá suy luận trong các tác vụ kỹ nghệ phần mềm. DeepSeek-R1 đạt 49,2%, nhỉnh hơn đôi chút so với 48,9% của OpenAI o1-1217. Kết quả này đặt DeepSeek-R1 thành đối thủ mạnh ở các tác vụ suy luận chuyên biệt như kiểm chứng phần mềm.
Về suy luận thực chứng, GPQA Diamond đo khả năng trả lời câu hỏi kiến thức tổng quát. DeepSeek-R1 đạt 71,5%, thấp hơn o1-1217 của OpenAI ở 75,7%, cho thấy lợi thế nhẹ của OpenAI trong nhiệm vụ thực chứng.
Trên MMLU—benchmark bao quát nhiều lĩnh vực và đánh giá năng lực hiểu biết đa nhiệm—o1-1217 của OpenAI nhỉnh hơn đôi chút, đạt 91,8% so với 90,8% của DeepSeek-R1.
Việc ra mắt DeepSeek-R1 gây tác động sâu rộng, ảnh hưởng đến thị trường chứng khoán, định hình lại kinh tế học AI và làm bùng nổ tranh cãi về phương thức phát triển mô hình.
Việc DeepSeek giới thiệu mô hình R1 với năng lực AI tiên tiến nhưng chi phí chỉ bằng một phần nhỏ so với đối thủ đã khiến giá cổ phiếu của nhiều công ty công nghệ Mỹ lớn giảm mạnh.
Chẳng hạn, Nvidia giảm gần 18% giá trị cổ phiếu, tương đương mất khoảng 600 tỷ USD vốn hóa. Đà giảm xuất phát từ lo ngại của nhà đầu tư rằng các mô hình AI hiệu quả của DeepSeek có thể làm giảm nhu cầu về phần cứng hiệu năng cao vốn do các công ty như Nvidia cung cấp.
Các mô hình mở trọng số như DeepSeek-R1 đang kéo chi phí xuống và buộc các công ty AI phải suy nghĩ lại chiến lược định giá. Điều này thể hiện rõ qua mức giá chênh lệch:
Một số lãnh đạo ngành dẫn chiếu đến nghịch lý Jevons—ý tưởng rằng khi hiệu quả tăng, tổng mức tiêu thụ có thể tăng chứ không giảm. CEO Microsoft Satya Nadella cũng ám chỉ điều này, cho rằng khi AI rẻ hơn, nhu cầu sẽ bùng nổ.
Tuy vậy, tôi đánh giá cao quan điểm cân bằng này từ The Economist, cho rằng hiệu ứng Jevons hoàn toàn là hiếm và phụ thuộc việc giá có phải rào cản chính cho việc ứng dụng hay không. Khi chỉ “5% doanh nghiệp Mỹ hiện dùng AI và 7% có kế hoạch áp dụng”, hiệu ứng Jevons có lẽ sẽ thấp. Nhiều doanh nghiệp vẫn thấy tích hợp AI là khó hoặc chưa cần thiết.
Bên cạnh tác động gây xáo trộn, DeepSeek cũng ở tâm điểm tranh cãi. OpenAI cáo buộc DeepSeek đã chưng cất các mô hình của họ—về bản chất là trích xuất tri thức từ hệ thống độc quyền của OpenAI và tái tạo hiệu năng trong một mô hình gọn nhẹ, hiệu quả hơn.
Đến nay, OpenAI chưa đưa ra bằng chứng trực tiếp cho tuyên bố này và với nhiều người, cáo buộc trông giống một động thái chiến lược nhằm trấn an nhà đầu tư trong bối cảnh AI đang thay đổi.
Ngày 28 tháng 5 năm 2025, DeepSeek phát hành phiên bản nâng cấp của mô hình suy luận: DeepSeek-R1-0528. Bản cập nhật này mang đến một số cải tiến quan trọng:
Mặc dù có các bổ sung này, điểm cuối API không thay đổi—DeepSeek-R1-0528 tương thích ngược hoàn toàn. Nhà phát triển có thể tiếp tục dùng cùng giao diện, đồng thời hưởng lợi từ mô hình mới.
Bạn có thể thử trên nền tảng DeepSeek Chat hoặc khám phá trọng số nguồn mở trên Hugging Face.
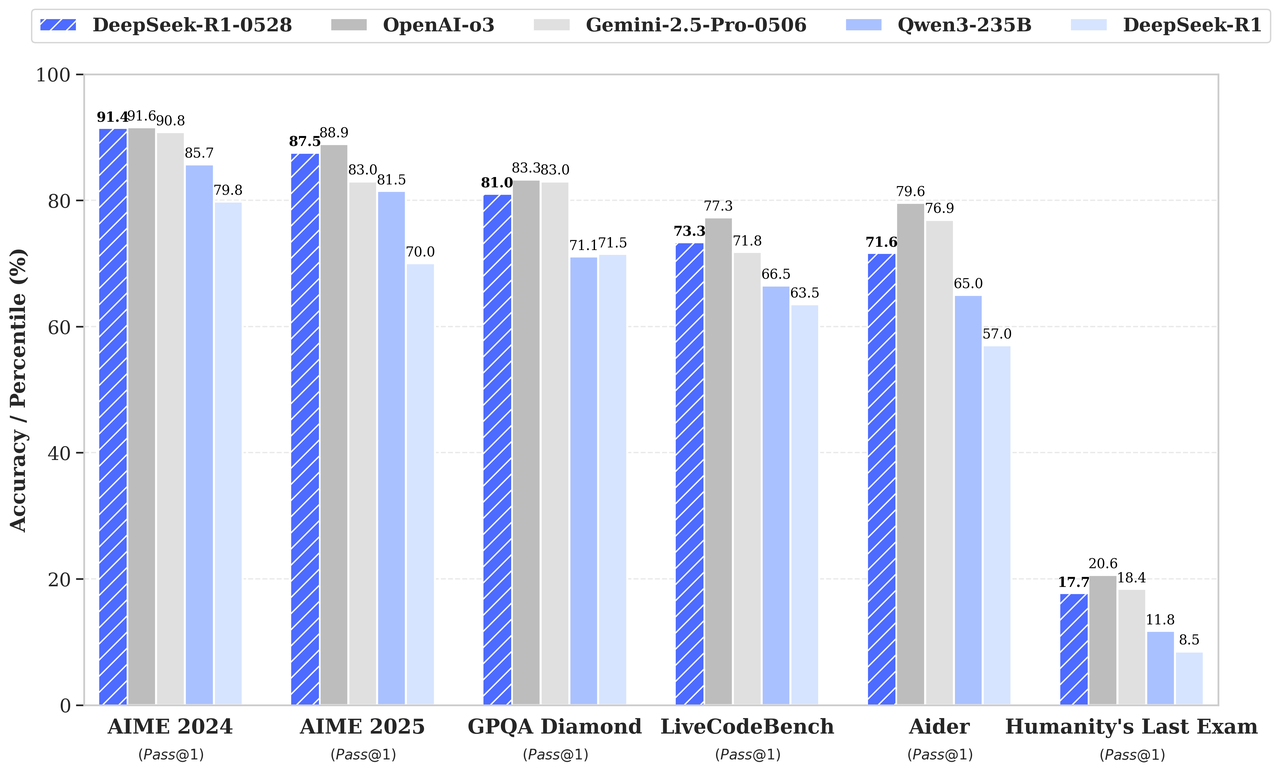
Theo biểu đồ benchmark trong thông báo phát hành, DeepSeek-R1-0528 vượt phiên bản trước và cạnh tranh mạnh với o3 của OpenAI và Gemini 2.5 Pro:
Nguồn: DeepSeek
DeepSeek-R1 là một đối thủ mạnh trong mảng AI tập trung vào suy luận, đạt hiệu năng ngang ngửa o1 của OpenAI. Dù o1 của OpenAI có thể nhỉnh hơn nhẹ ở lập trình và suy luận thực chứng, tôi cho rằng bản chất mã nguồn mở và chi phí truy cập hiệu quả khiến DeepSeek-R1 trở thành lựa chọn hấp dẫn.
Học AI với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
