
Kursus
Retrieval Augmented Generation (RAG) dengan LangChain
3 jam
20.9K
DeepSeek-R1-Lite-Preview adalah alat AI, mirip dengan ChatGPT, yang dibuat oleh perusahaan Tiongkok bernama DeepSeek. Perusahaan mengumumkan model baru ini di X pada 20 November (tautan tweet) dan membagikan beberapa detail di halaman dokumentasi.
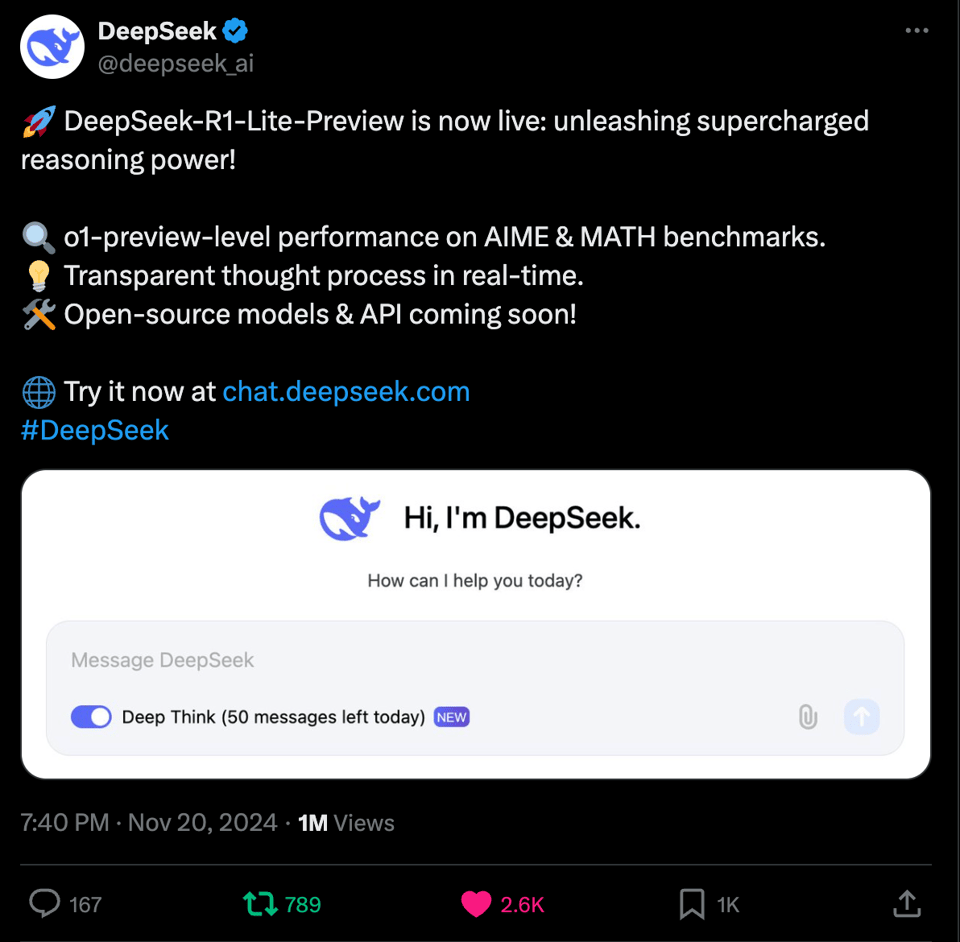
DeepSeek-R1-Lite-Preview ditujukan untuk sangat mahir menyelesaikan masalah penalaran kompleks dalam matematika, pengkodean, dan logika. Model ini menampilkan langkah-langkah berpikirnya selangkah demi selangkah agar Anda dapat memahami bagaimana ia memperoleh jawaban, yang membantu meningkatkan kepercayaan pengguna.
Anda dapat mencobanya secara gratis di situs mereka, chat.deepseek.com, tetapi Anda dibatasi hingga 50 pesan per hari dalam mode lanjutannya yang disebut “Deep Think”. DeepSeek juga berencana membagikan sebagian alat ini ke publik agar orang lain dapat menggunakannya atau membangunnya lebih lanjut.
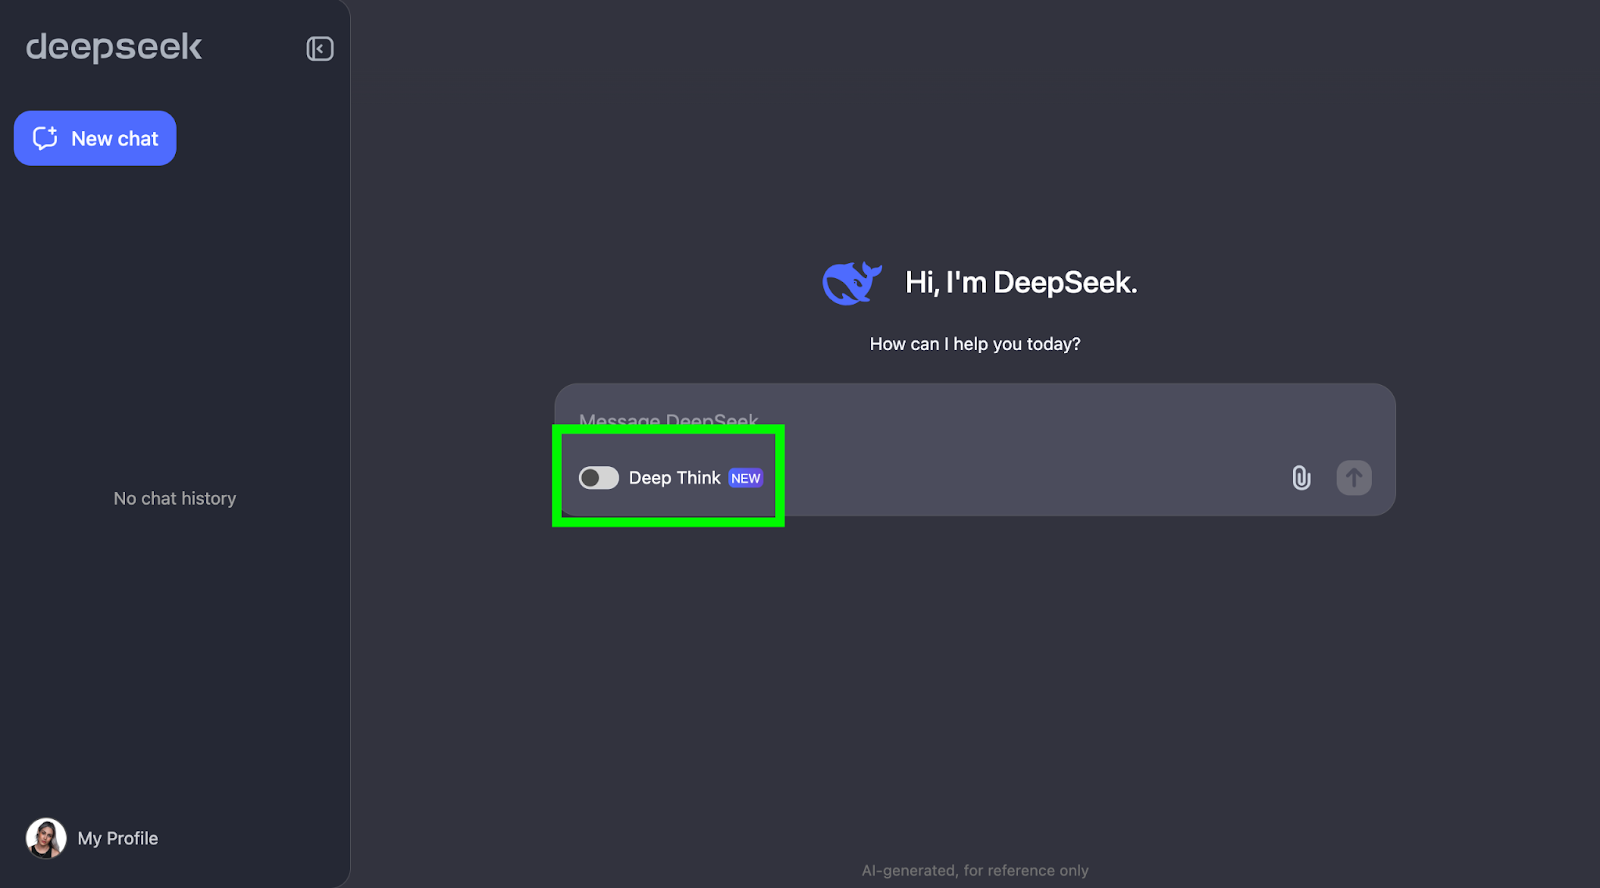
Anda dapat mulai menggunakan DeepSeek-R1-Lite-Preview dengan mengikuti dua langkah ini:
Untuk melihat kemampuan DeepSeek-R1-Lite-Preview, mari kita uji! Saya akan melalui serangkaian tantangan yang menonjolkan keterampilan penalarannya, dimulai dari pertanyaan stroberi yang sederhana namun terkenal: Berapa kali huruf “r” muncul dalam 'strawberry'?
Pertanyaan ini terlihat sederhana, tetapi LLM (bahkan GPT-4o) secara historis sering kesulitan menjawabnya dengan benar—biasanya mereka menjawab bahwa hanya ada dua kemunculan huruf “r.”
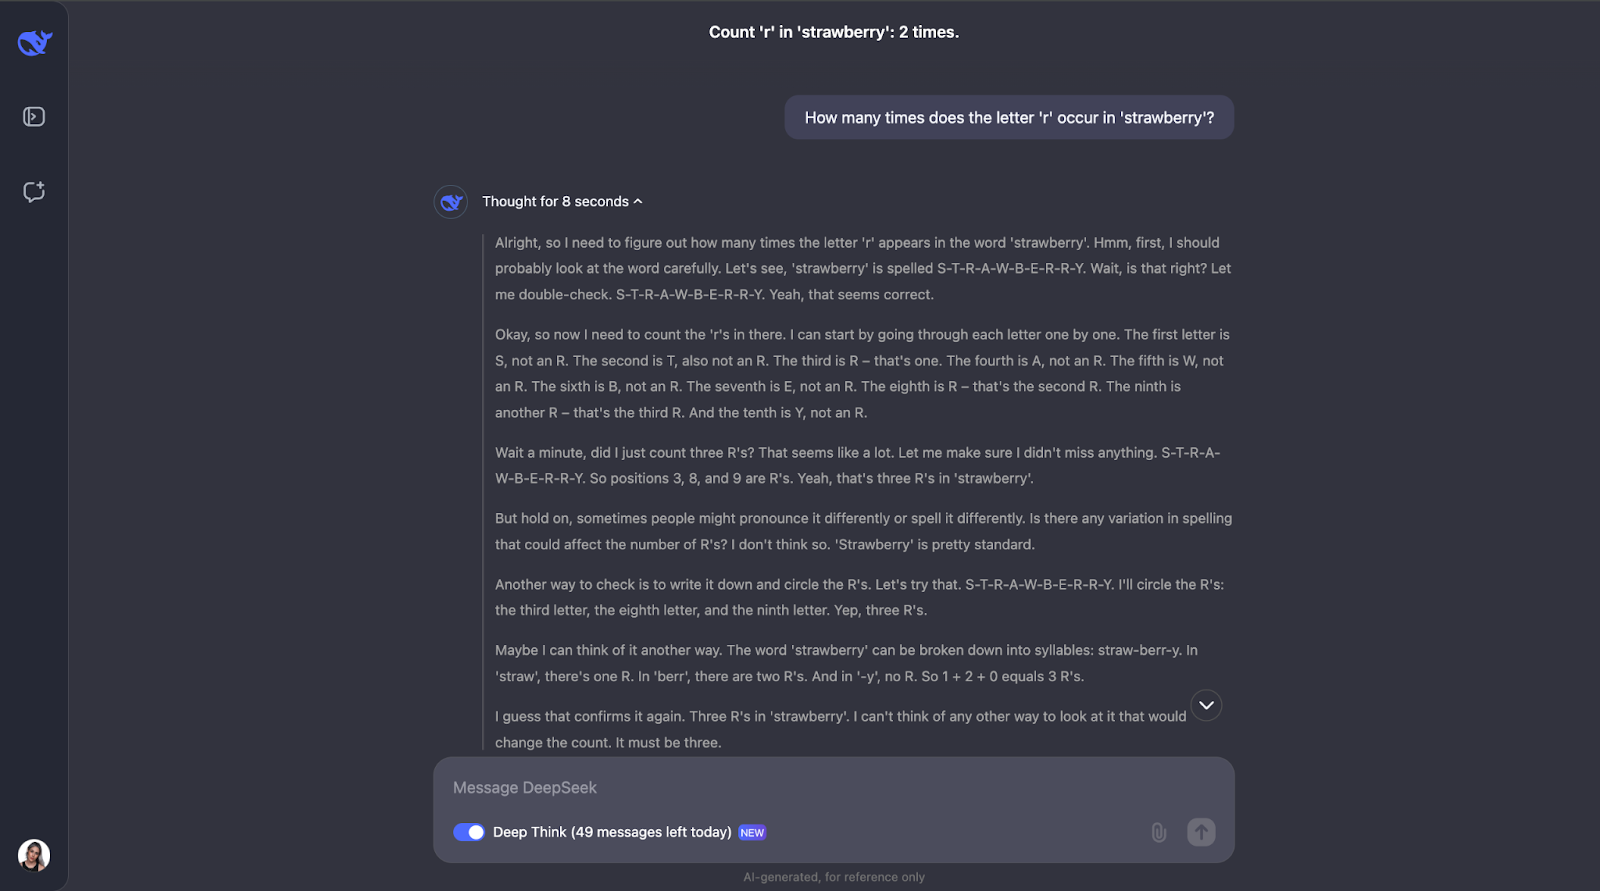
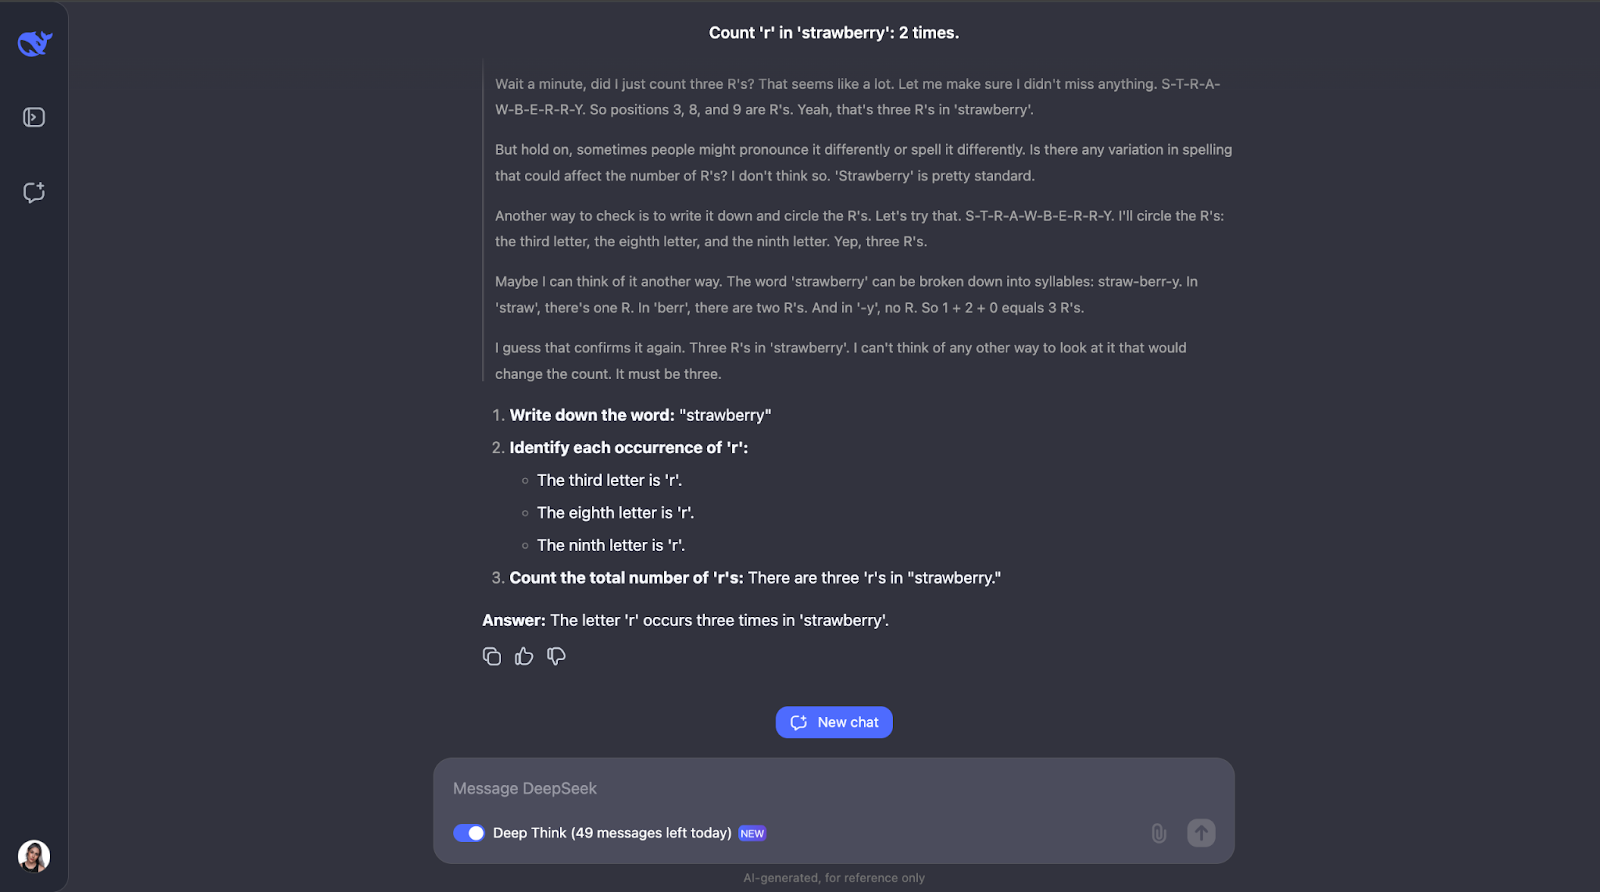
Wah, baiklah – saya tidak menyangka proses penalarannya akan sepanjang ini untuk tugas yang tampaknya lugas. Saya pikir setelah menghitung huruf 'r' dan mengidentifikasi posisinya dalam kata, seharusnya sudah berhenti. Tapi yang menarik bagi saya adalah ia tidak berhenti di situ. Ia memeriksa ulang hitungannya beberapa kali dan bahkan mempertimbangkan hal-hal seperti bagaimana orang mungkin mengucapkan atau mengeja kata tersebut secara berbeda – yang menurut saya agak berlebihan, terutama bagian pengucapannya. Namun itu menunjukkan betapa cermat dan berhati-hatinya! Ia juga menjelaskan setiap langkah sehingga saya bisa mengikuti alur pikirnya dan melihat bagaimana ia sampai pada jawabannya.
Saya akan menguji DeepSeek-R1-Lite-Preview pada tiga soal matematika.
Mengacu pada klaim DeepSeek yang sangat mahir dalam penalaran matematika, mari mulai dengan soal geometri sederhana.
"Jika sebuah segitiga memiliki sisi dengan panjang 3, 4, dan 5, berapakah luasnya?"
Soal ini membutuhkan pengetahuan tentang teorema Pythagoras dan rumus Heron. Saya berharap DeepSeek-R1-Lite-Preview menunjukkan langkah kerjanya, mungkin seperti ini:
Mari lihat apa yang terjadi!
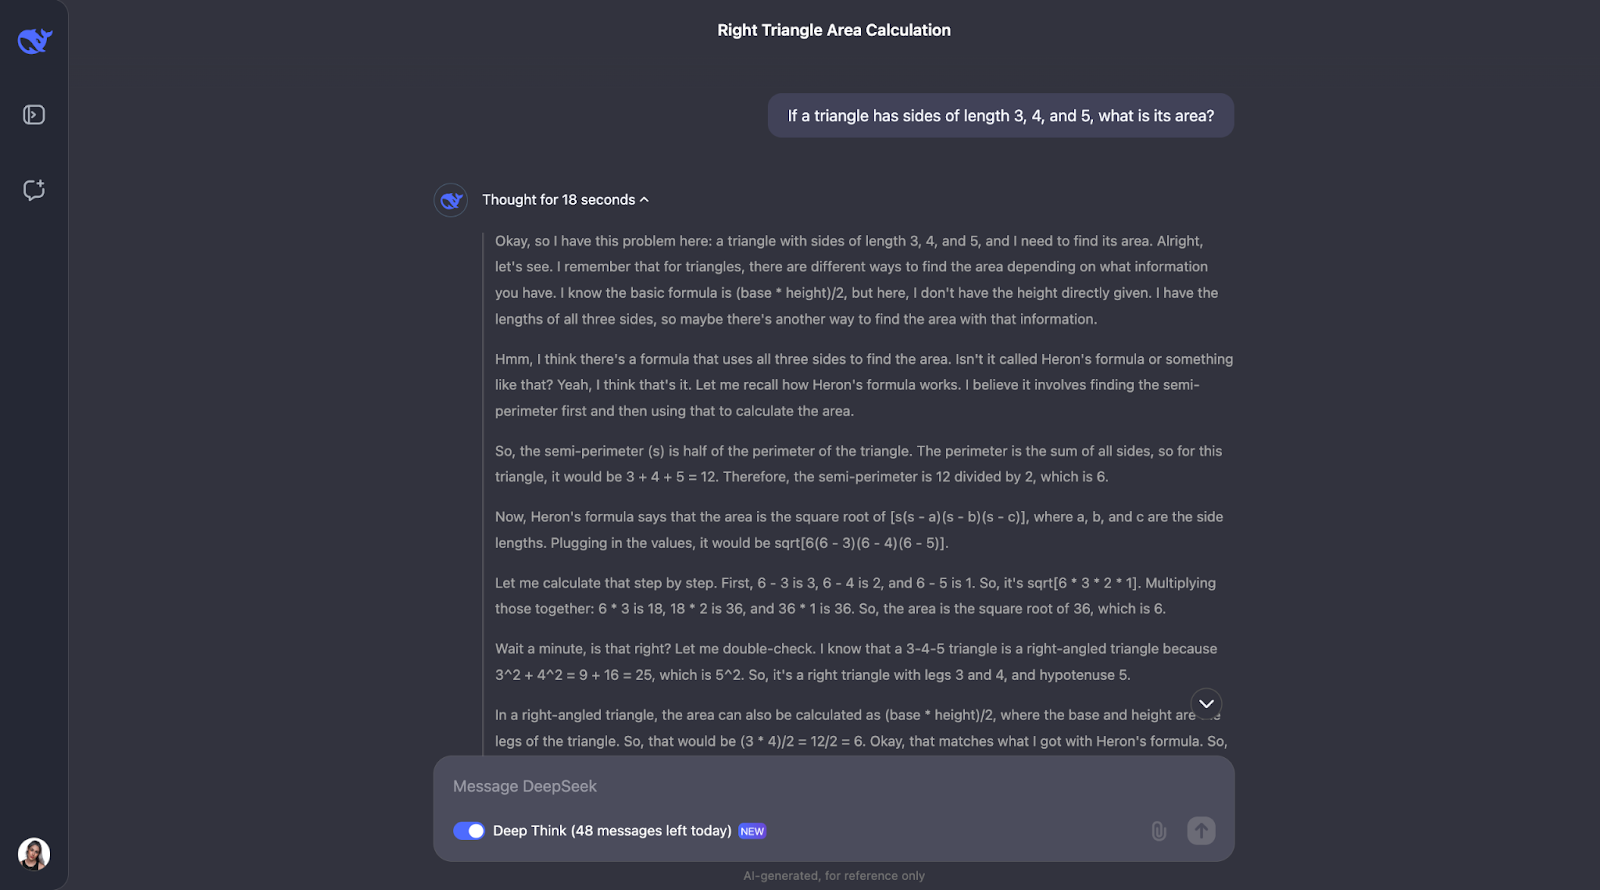
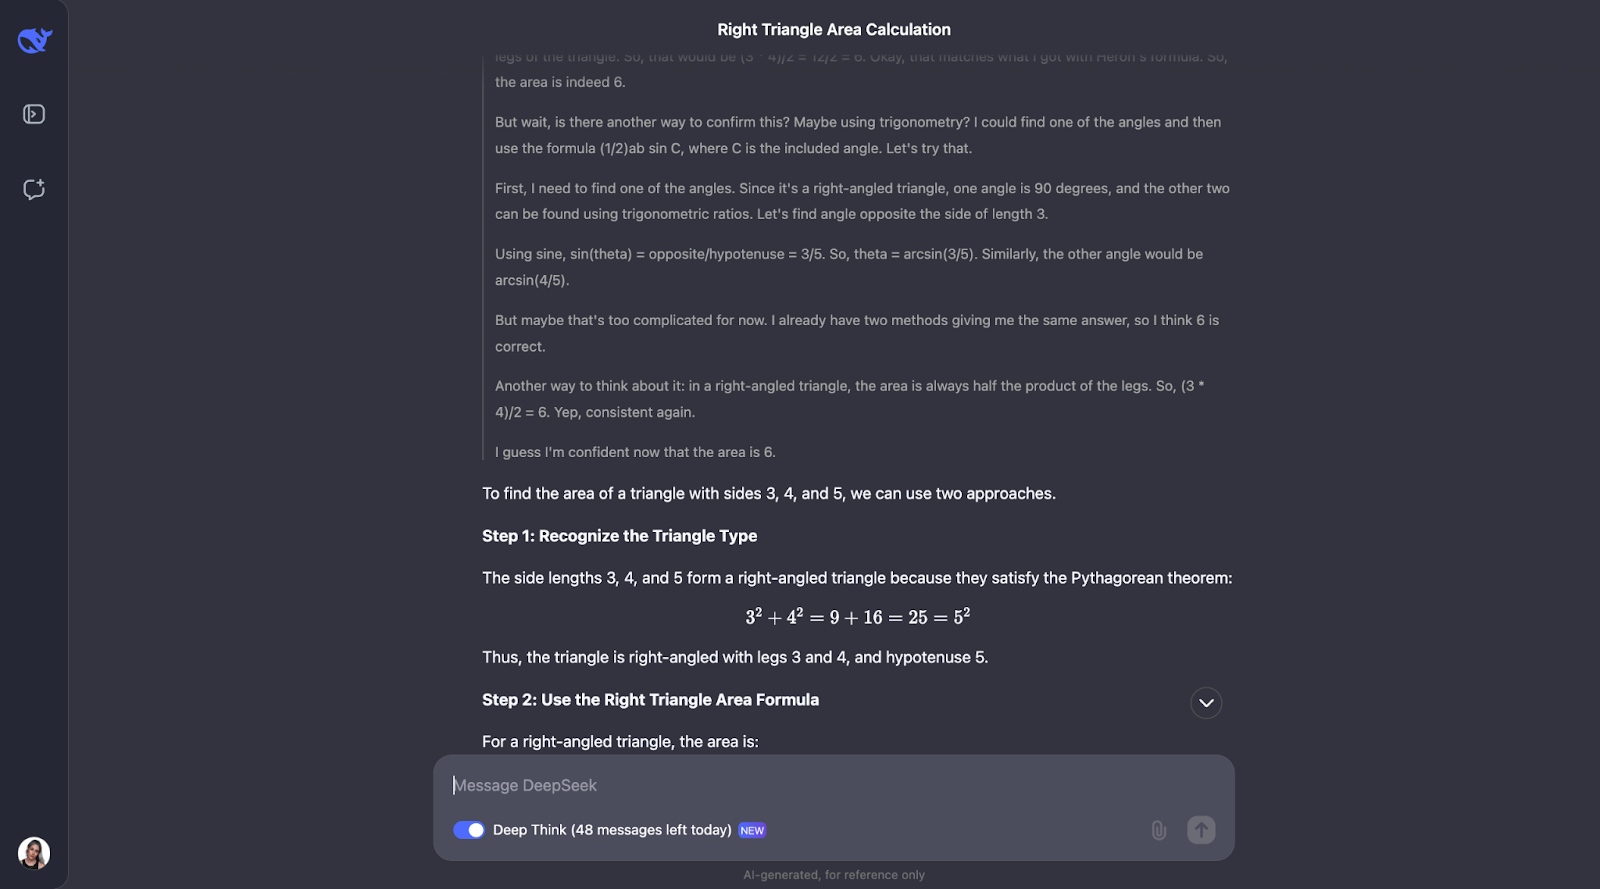
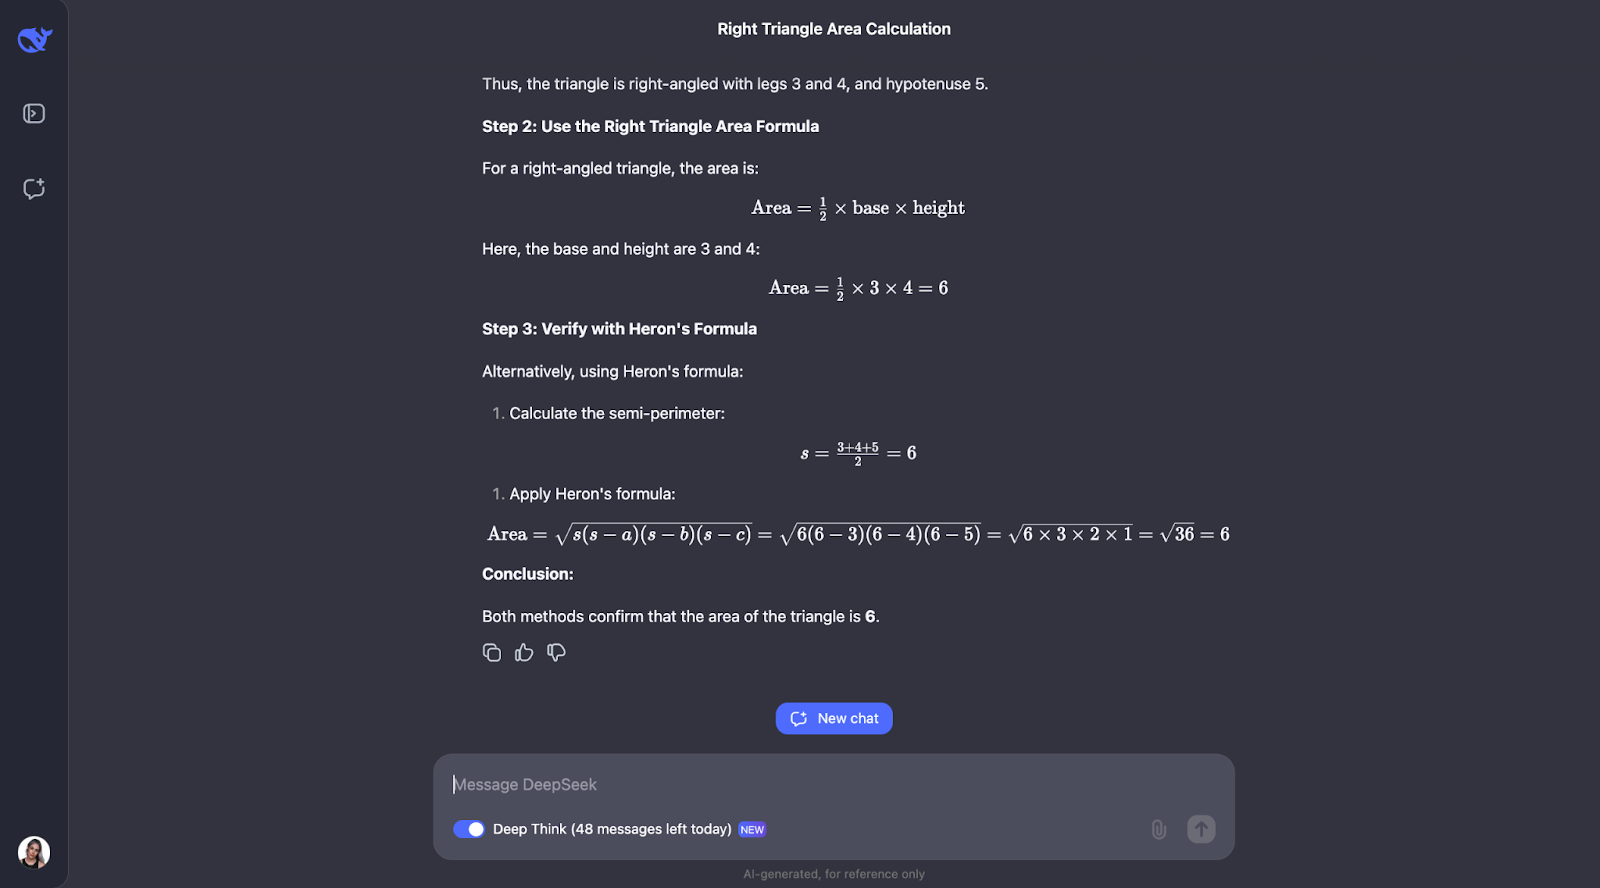
Baik, menariknya, ia melakukan pemeriksaan seperti yang saya prediksi—meski dalam urutan berbeda. Ia juga mempertimbangkan penggunaan trigonometri dengan menghitung sudut dan mencoba rumus lain. Menurut saya, menarik bahwa pada akhirnya ia memutuskan hal itu tidak diperlukan karena dua metode pertama sudah mengonfirmasi jawabannya.
Baik penjelasan maupun keluarannya sangat jelas dan mudah diikuti, yang membuat saya berpikir model ini akan sangat bagus ditanamkan dalam asisten untuk siswa matematika, misalnya. Untuk kasus penggunaan ini, mungkin proses berpikir dapat ditampilkan terlebih dahulu, dan siswa dapat berinteraksi dengannya, menyatakan apakah mereka memahaminya atau tidak sebelum melanjutkan ke jawaban akhir.
Mari beralih ke uji matematika yang lebih kompleks untuk melihat apakah ada perbedaan dalam performa dan alur pikir.
“Buktikan bahwa jumlah kebalikan dari bilangan Fibonacci konvergen ke nilai hingga.”
Tes ini menantang pemahaman model tentang konsep matematika lanjutan, seperti kekonvergenan deret dan sifat-sifat bilangan Fibonacci. Mari kita coba! Demi keterbacaan, saya hanya akan menampilkan bagian awal dan akhir jawaban (tetapi silakan coba sendiri dengan prompt yang sama):
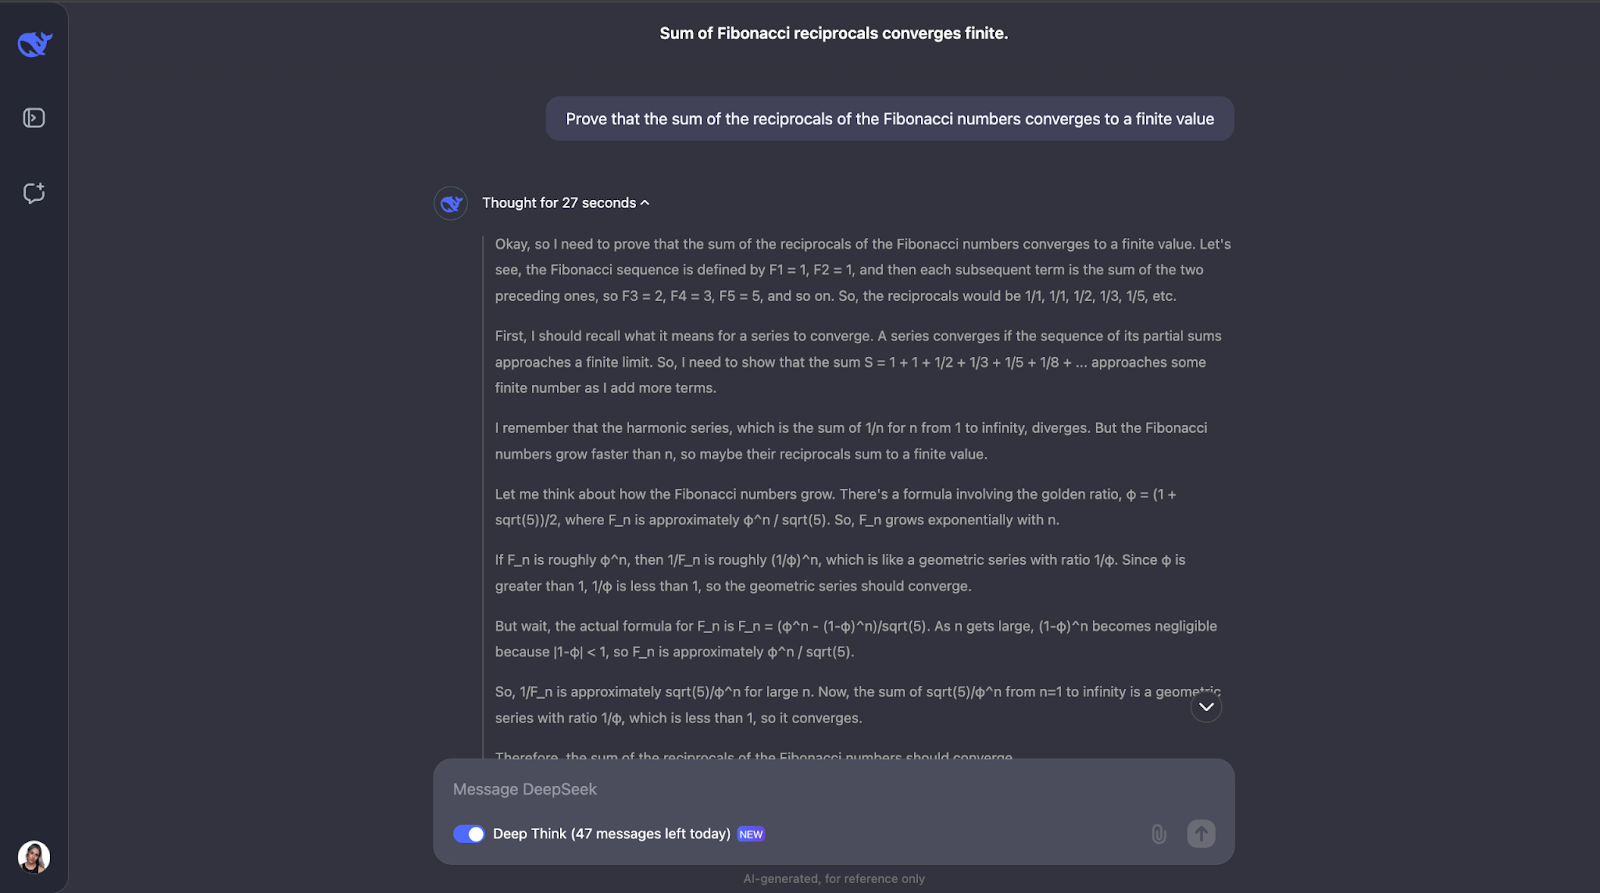
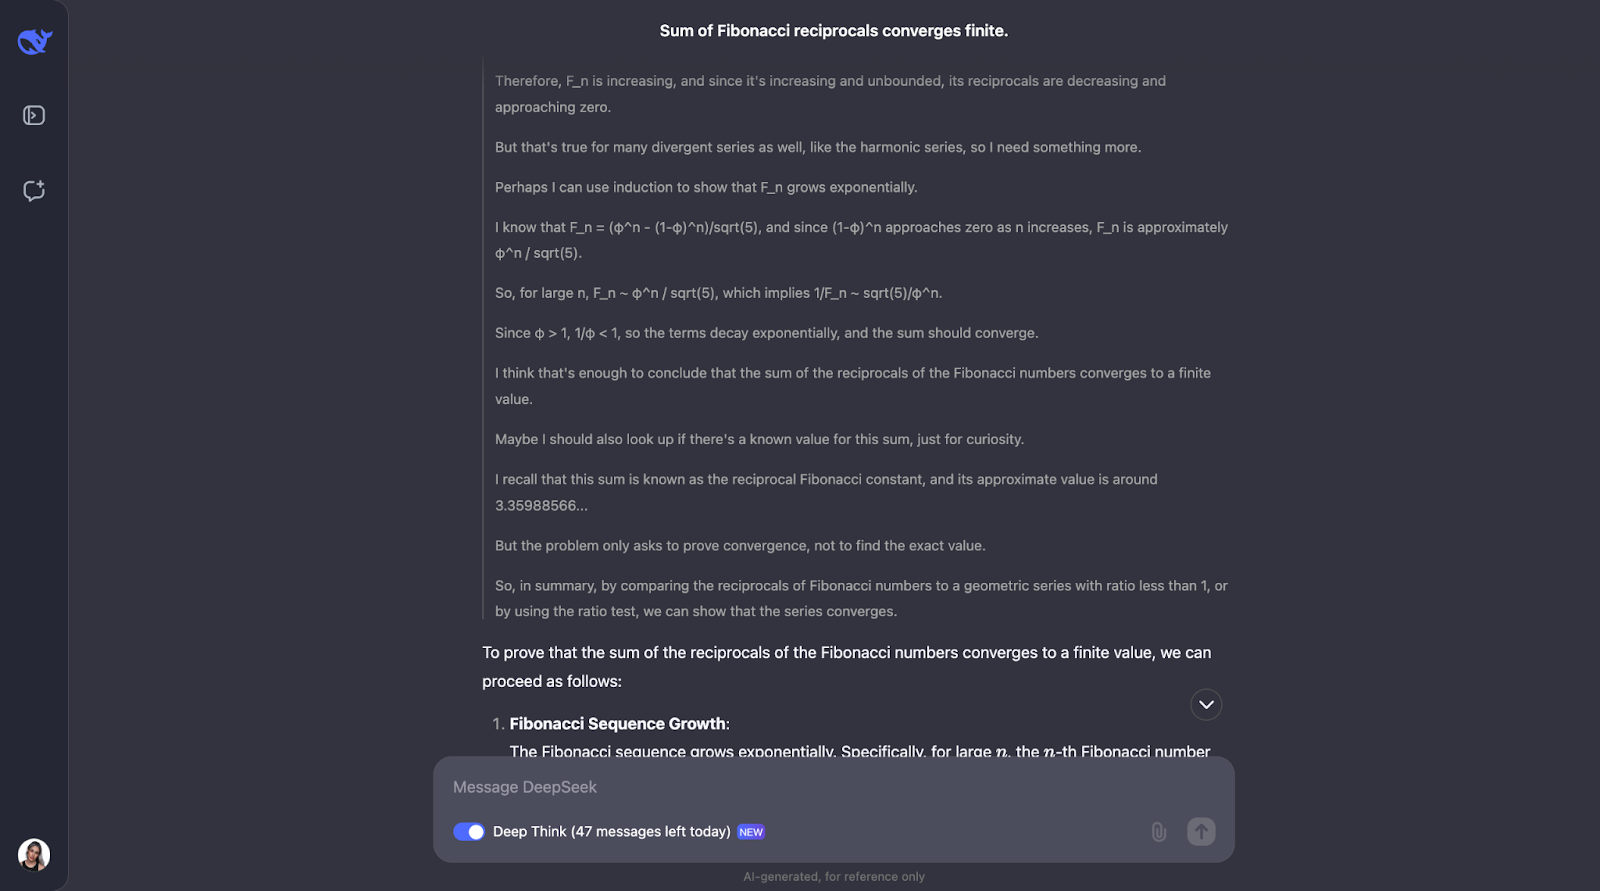
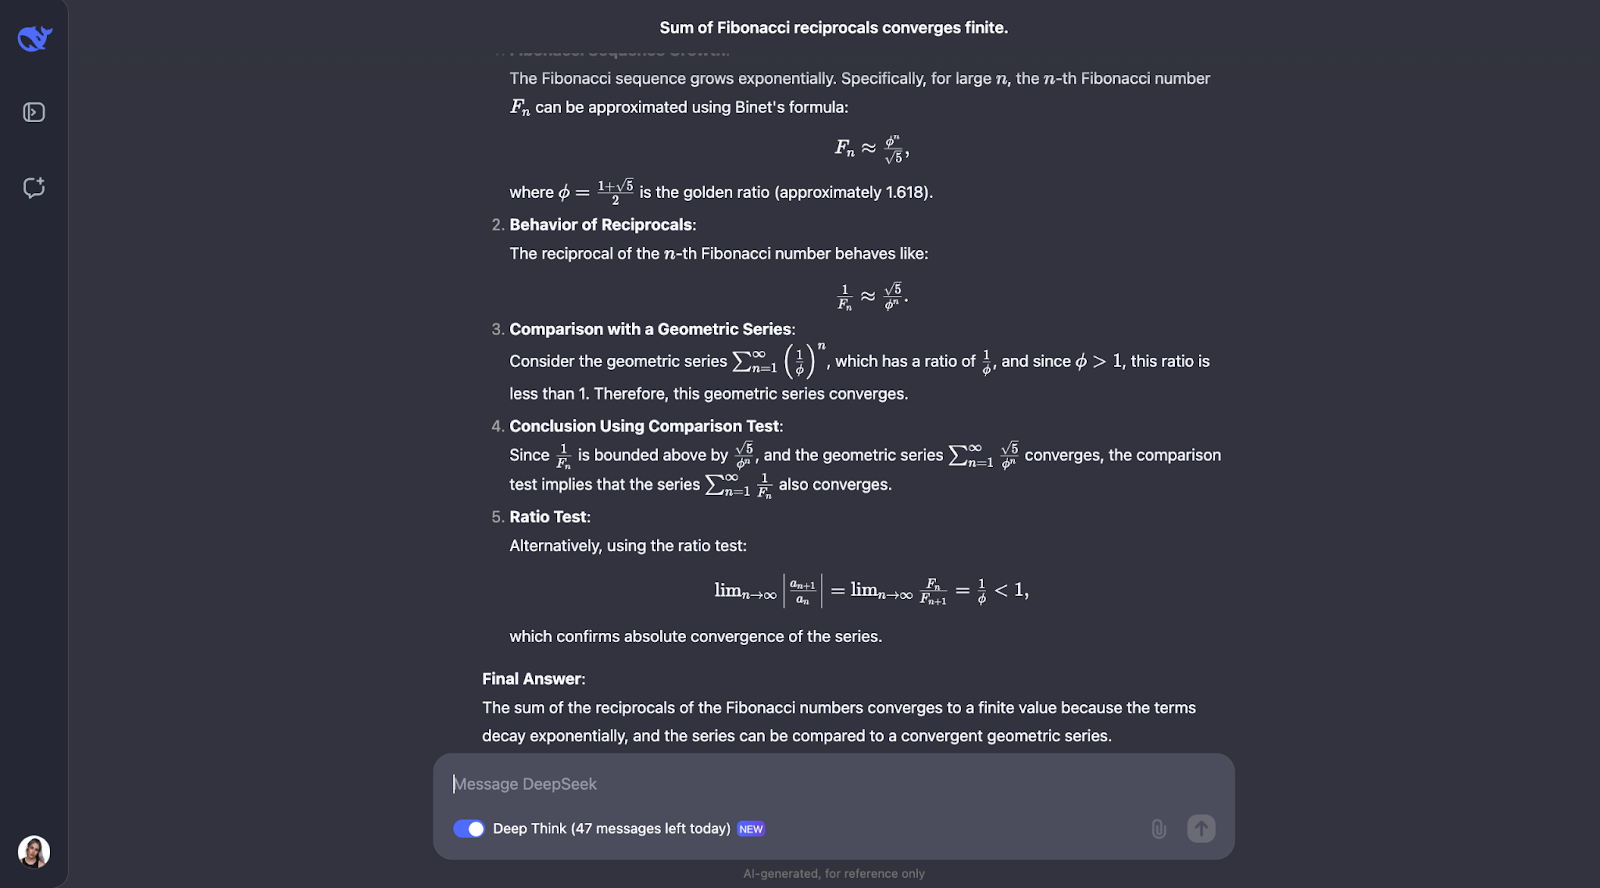
Baik, ini alur pikir yang bagus—saya sangat suka bagaimana ia terlebih dahulu memastikan memahami konsep kunci seperti kebalikan (reciprocal) dan kekonvergenan. Lalu, DeepSeek-R1-Lite-Preview mendekati masalah ini dengan melihat bagaimana pertumbuhan bilangan Fibonacci dan menggunakan uji perbandingan, yang umum digunakan untuk menguji apakah suatu deret konvergen atau tidak.
Ia membandingkan kebalikan bilangan Fibonacci dengan deret geometri. Karena kebalikan bilangan Fibonacci menurun bahkan lebih cepat daripada deret geometri dengan rasio umum kurang dari 1, model menyimpulkan bahwa jumlah kebalikan tersebut juga konvergen ke nilai hingga. Untuk lebih memastikan, ia menggunakan yang disebut uji rasio.
Uji ini memeriksa apakah limit rasio suku berurutan kurang dari 1. Jika ya, deretnya konvergen. Model menghitung rasio ini untuk kebalikan bilangan Fibonacci dan menemukan bahwa nilainya memang kurang dari 1.
Ia bahkan menyebutkan ada nilai yang dikenal untuk jumlah ini yang disebut konstanta Fibonacci kebalikan, sekitar 3,3598. Namun untuk masalah ini, kita hanya perlu tahu bahwa jumlahnya hingga, bukan nilai pastinya—jadi ini informasi tambahan yang saya juga anggap menarik. Saya sangat suka bagaimana solusi disajikan dalam keluaran. Jelas dan langkah demi langkah.
Sejauh ini, saya terkesan dengan tugas-tugas matematisnya.
Saya akan mencoba soal geometri diferensial—karena bidang PhD saya di area ini, jadi saya tidak bisa menahan diri untuk melakukan sedikit uji. Tidak terlalu kompleks, hanya latihan klasik yang mungkin Anda temui di matematika sarjana.
“Pertimbangkan permukaan S di R³ diparameterkan oleh
φ(u,v) = (u cos v, u sin v, ln u)
untuk u > 0 dan 0 ≤ v < 2π.
a) Hitung bentuk fundamental pertama dari S.
b) Tentukan apakah S merupakan permukaan minimal.
c) Temukan kelengkungan Gauss K dan kelengkungan rata-rata H dari S.”
Yang saya harapkan dari DeepSeek-R1-Lite-Preview adalah memberikan solusi langkah demi langkah, menampilkan semua perhitungan dan menjelaskan makna setiap hasil serta definisi konsep utama seperti bentuk fundamental, permukaan minimal, dan berbagai kelengkungan.
Agar blog ini tetap mudah dibaca, saya hanya bisa menampilkan bagian awal dan akhir jawaban, tetapi saya mendorong Anda untuk mencoba prompt tersebut sendiri:
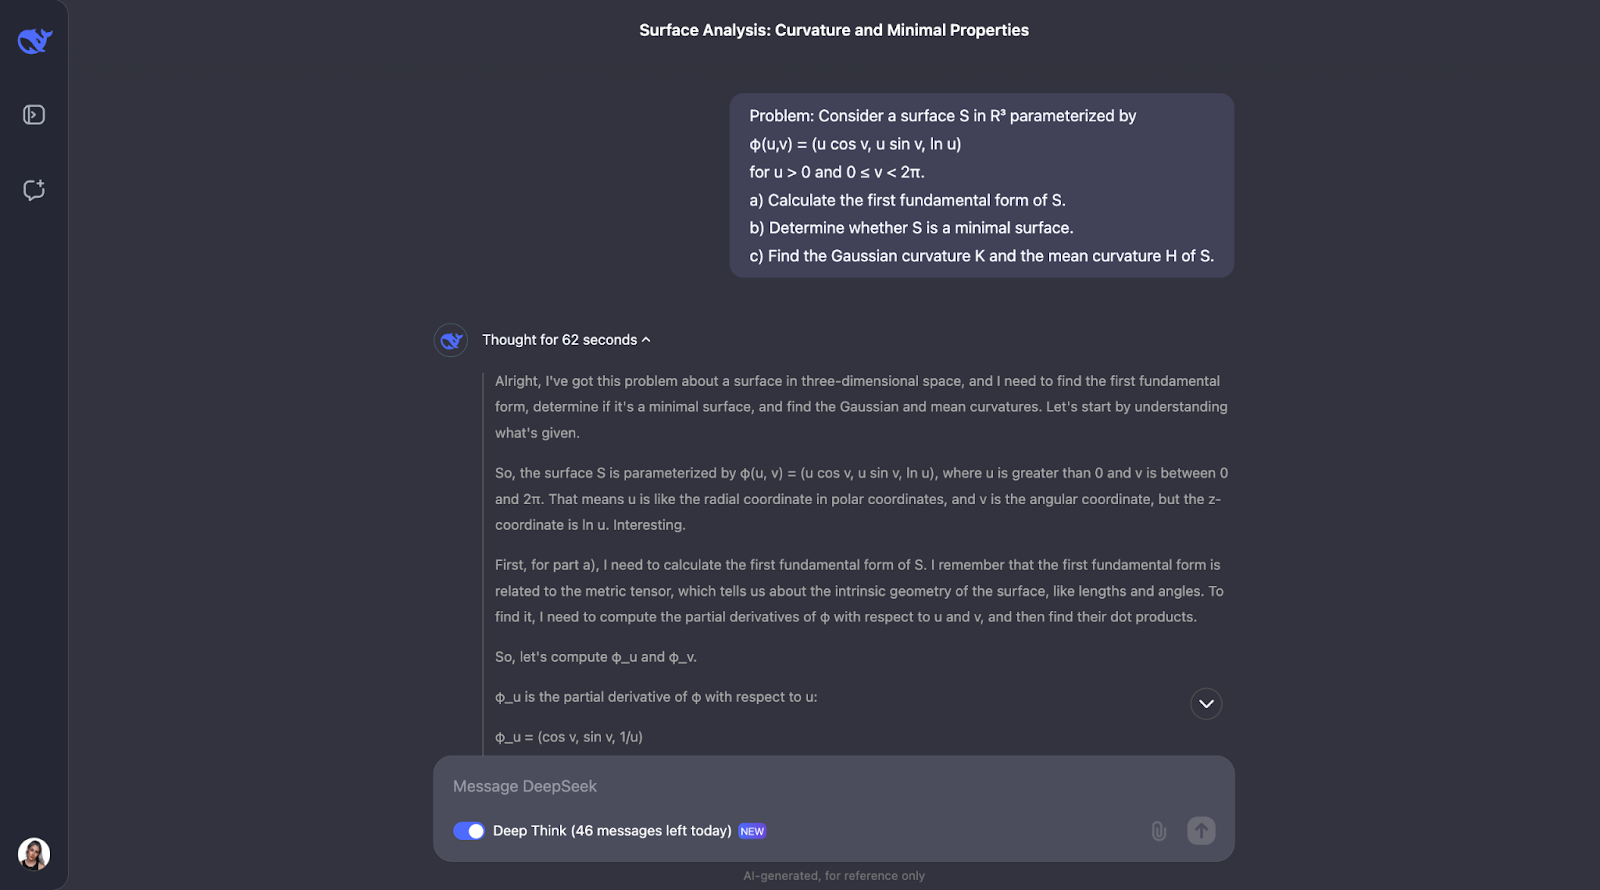
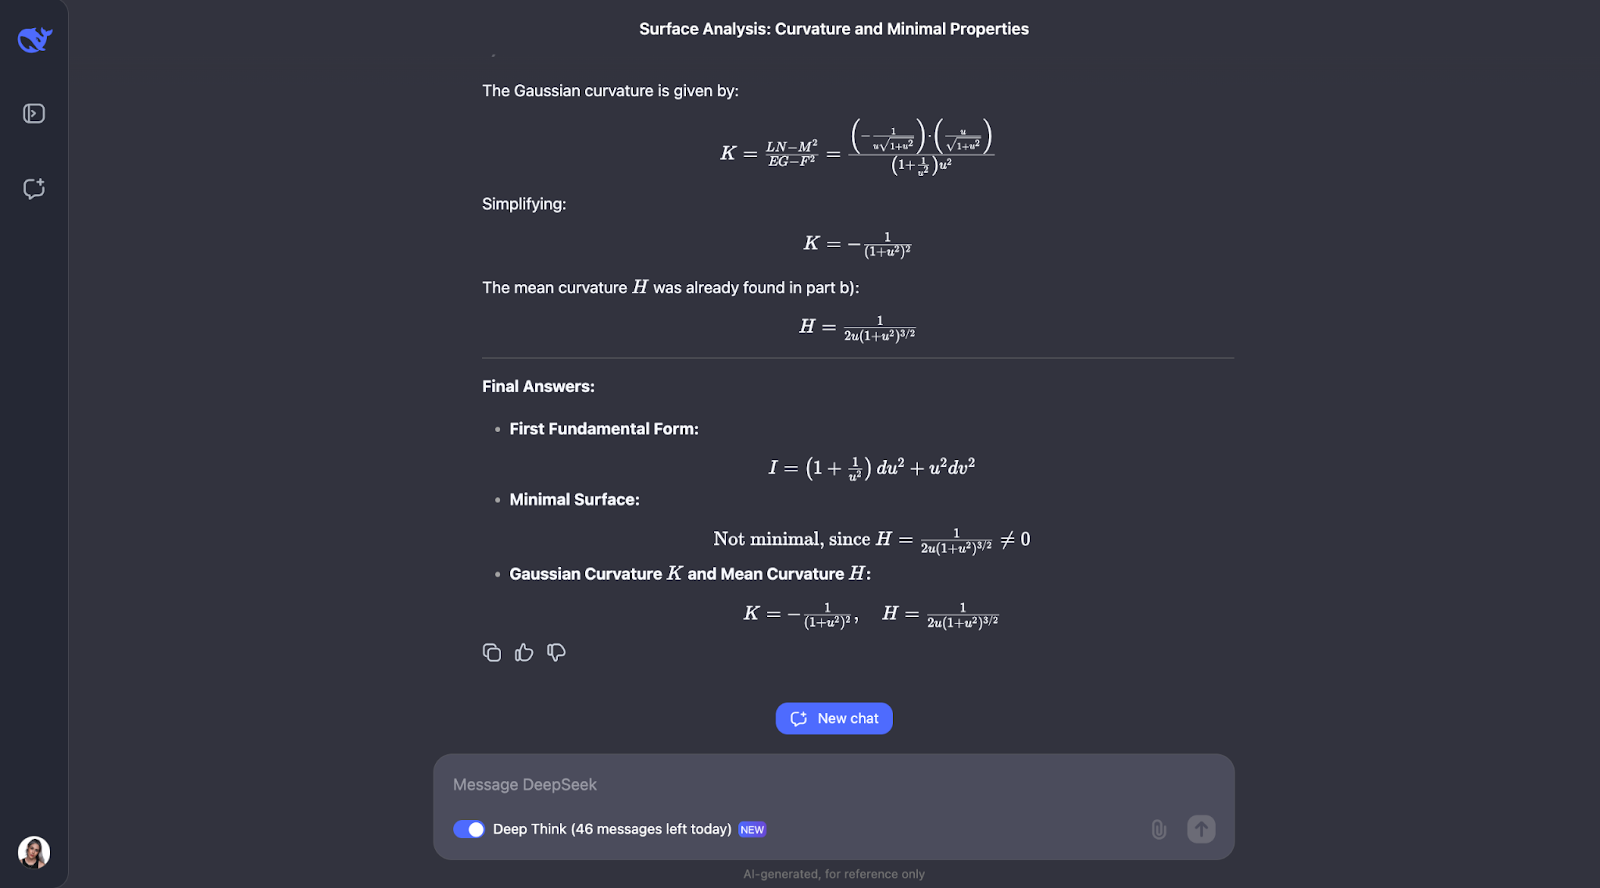
Pendekatan langkah demi langkah menggunakan rumus geometri yang terkenal dan menerapkannya secara langsung, sehingga penalarannya mudah diikuti. Namun, saya berharap ia memeriksa pemahamannya sendiri terhadap konsep utama dalam masalah ini, yang tidak tampak dalam alur pikirnya. Untuk bagian B, ia mengambil pendekatan alternatif dan mengidentifikasi bahwa permukaan yang terlibat adalah permukaan putar, yang merupakan sentuhan yang bagus.
Ada juga momen ketika ia mengomentari rotasi dan menyadari bahwa ia sudah memiliki N, vektor normal, yang bisa bertentangan dengan notasi koefisien untuk bentuk fundamental kedua. Saya ingin melihat saran notasi yang lebih baik, karena menggunakan huruf yang sama untuk dua hal bukan praktik yang baik!
Saat menghitung kelengkungan rata-rata, ia menyadari nilainya tidak nol dan mempertanyakan apakah perhitungannya benar. Untuk teliti, ia mencoba metode lain untuk memeriksa ulang pekerjaannya.
Sekali lagi, keluarannya sangat jelas dan mudah diikuti. Di semua contoh ini, mengesankan melihat bagaimana ia secara konsisten memeriksa ulang perhitungan menggunakan metode berbeda. Proses berpikirnya selalu terperinci, logis, dan mudah dipahami!
Sekarang mari beralih ke uji pengkodean.
Yang pertama akan saya uji adalah:
“Implementasikan sebuah fungsi di Python yang menemukan substring palindromik terpanjang dalam sebuah string. Fungsi harus memiliki kompleksitas waktu yang lebih baik daripada O(n^3).”
Saya mencoba mengevaluasi kemampuan model dalam merancang algoritma yang efisien dan mengimplementasikannya dalam kode. Saya berharap ada solusi menggunakan pemrograman dinamis atau algoritma Manacher, dengan penjelasan yang jelas tentang pendekatan dan analisis kompleksitas waktu.
Keluaran sangat-sangat panjang, dan saya hanya menampilkan bagian awal dan akhirnya:
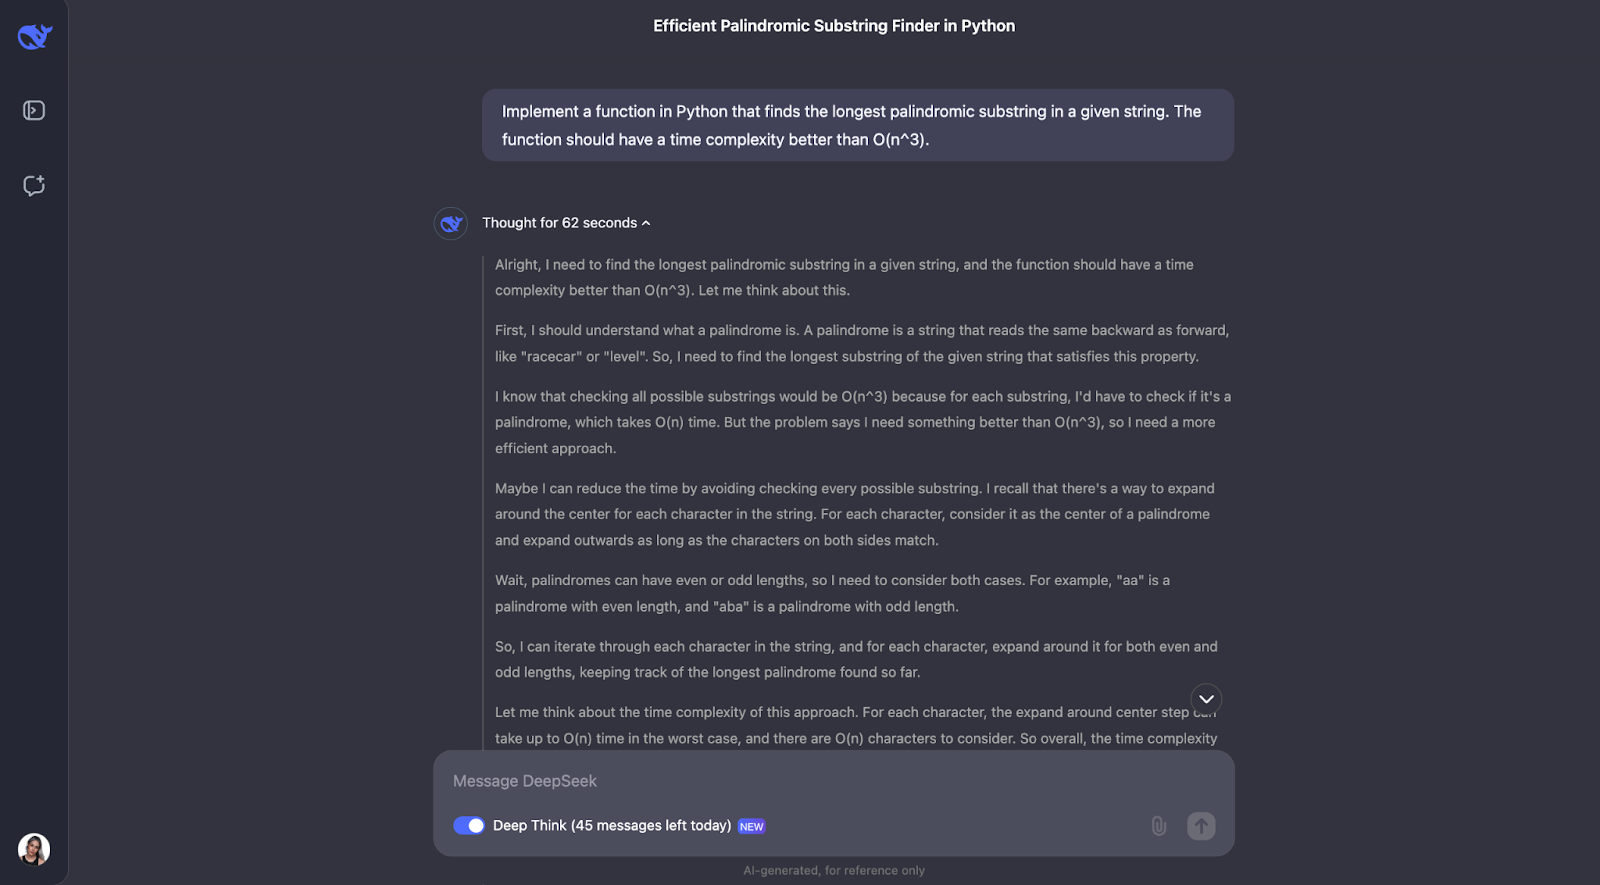
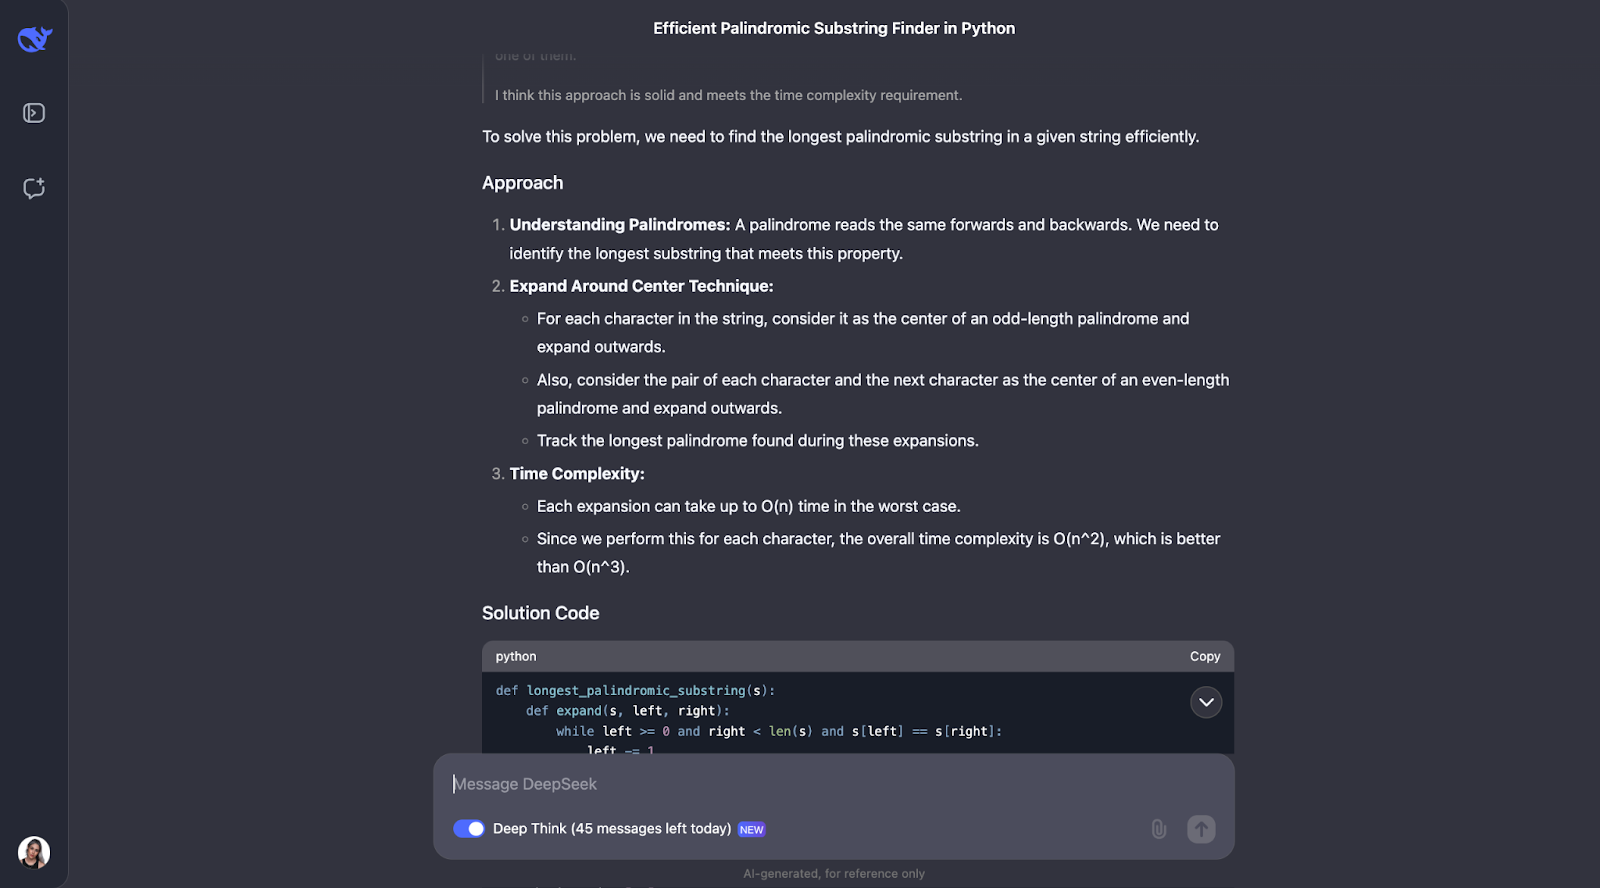
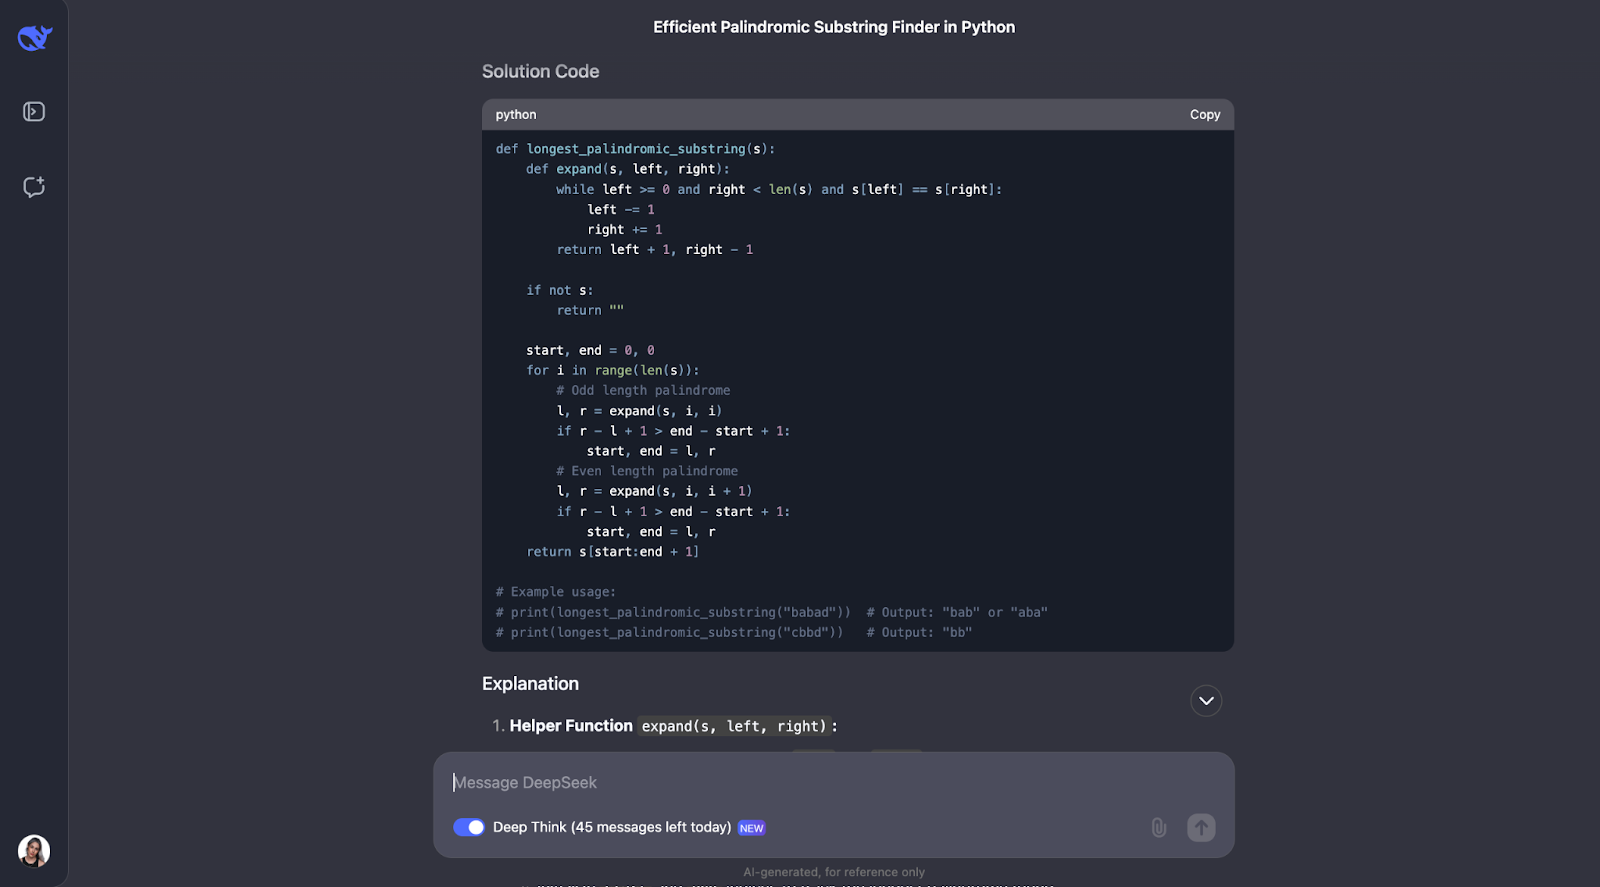
Saya pikir model ini melakukan pekerjaan yang sangat baik dalam menyelesaikan masalah menemukan substring palindromik terpanjang. Pendekatannya cerdas, efisien, dan dijelaskan dengan jelas.
Alih-alih brute force semua kemungkinan substring, yang akan lambat, ia menggunakan teknik cerdas "mengembang di sekitar pusat". Metode ini menangani palindrom berdurasi ganjil seperti "aba" dan yang genap seperti "abba." Ia melacak palindrom terpanjang yang ditemukan seiring proses berjalan. Hasilnya adalah algoritma yang berjalan dalam waktu O(n^2), jauh lebih cepat daripada solusi O(n^3).
Yang paling mengesankan bagi saya dari jawaban ini adalah cara penyajiannya yang sangat jelas. DeepSeek memecah masalah menjadi langkah-langkah yang mudah dipahami, menjelaskan alur pikirnya secara detail, dan bahkan menyertakan contoh praktis. Misalnya, ia menunjukkan bagaimana algoritma mengembang di sekitar pusat pada "racecar" atau "abba" untuk menemukan palindrom yang benar. Fungsi pembantu untuk mengembang di sekitar pusat sangat bagus menurut saya—membuat kode modular dan mudah diikuti.
Meski begitu, saya berharap ia mempertimbangkan algoritma Manacher, yang lebih cepat dengan O(n). Memang lebih kompleks untuk diimplementasikan, tetapi berguna untuk kasus di mana performa sangat penting, dan saya berharap model ini menyinggungnya.
Saya juga memperhatikan bahwa keluaran tidak secara eksplisit membahas bagaimana algoritma menangani kasus khusus, seperti string kosong atau string dengan semua karakter identik (mis., "aaaa"). Kasus-kasus ini akan berfungsi–tetapi saya berharap setidaknya dibahas.
Terakhir, saya pikir bagus bahwa ia mengomentari keluaran yang diharapkan untuk contoh penggunaan. Namun, saat saya menjalankan kodenya, hanya opsi pertama untuk contoh penggunaan pertama yang dicetak. Akan lebih baik jika kode mempertimbangkan semua solusi yang mungkin dan semuanya dicetak.
Mari coba masalah pengkodean lain dalam bahasa pemrograman berbeda.
“Tulis sebuah fungsi di JavaScript yang menentukan apakah suatu bilangan adalah prima”
Demi keterbacaan, saya hanya menampilkan bagian awal dan akhir (meskipun rantai pikirnya sedikit lebih pendek kali ini):
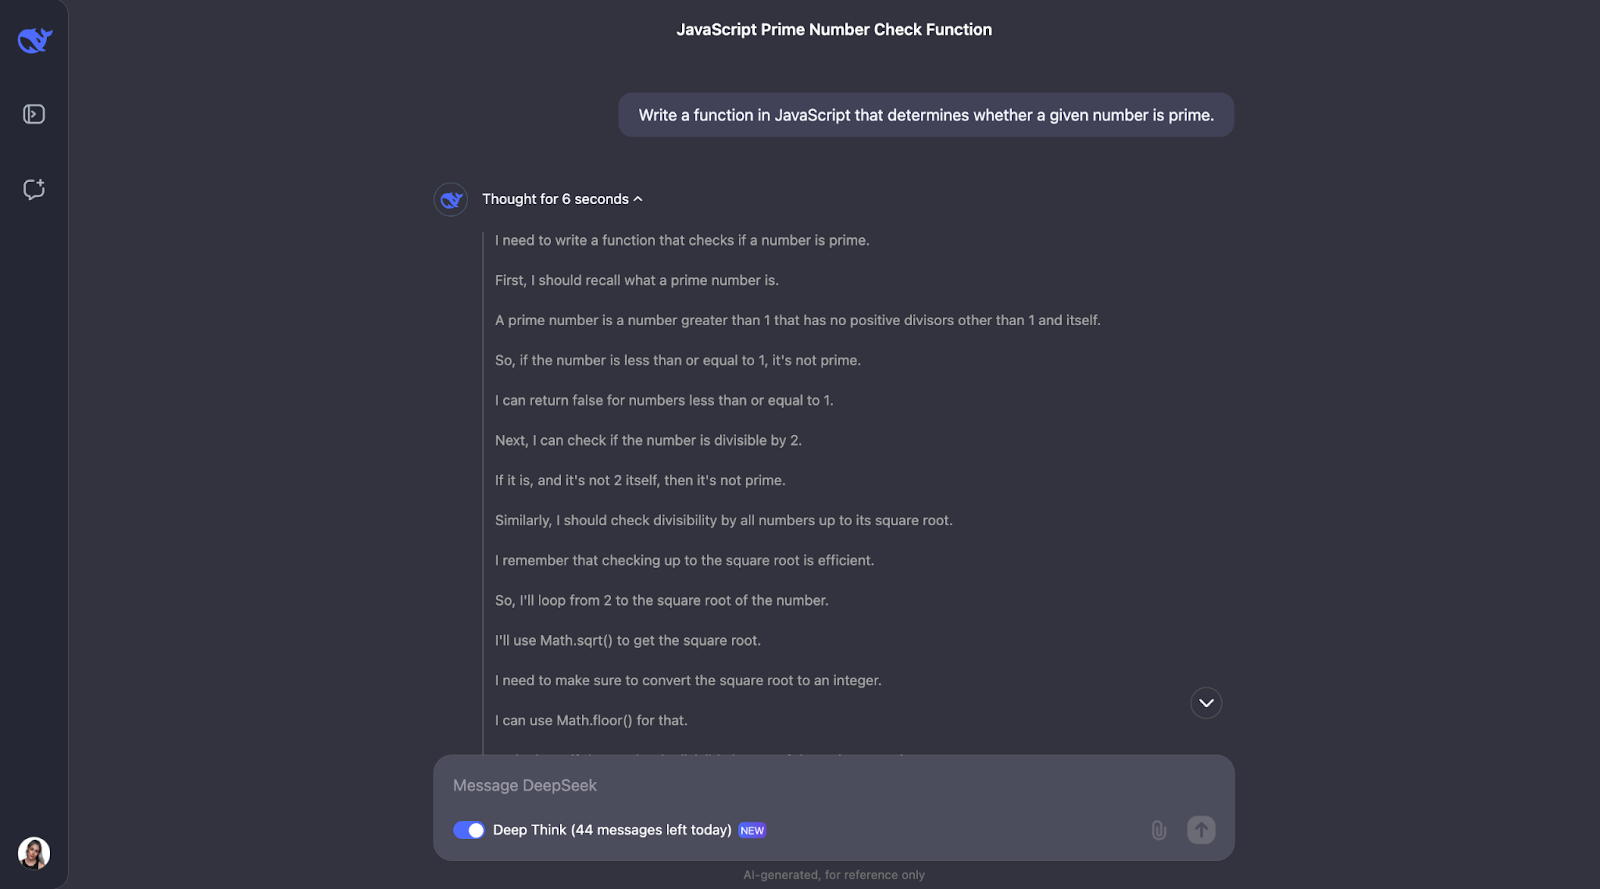
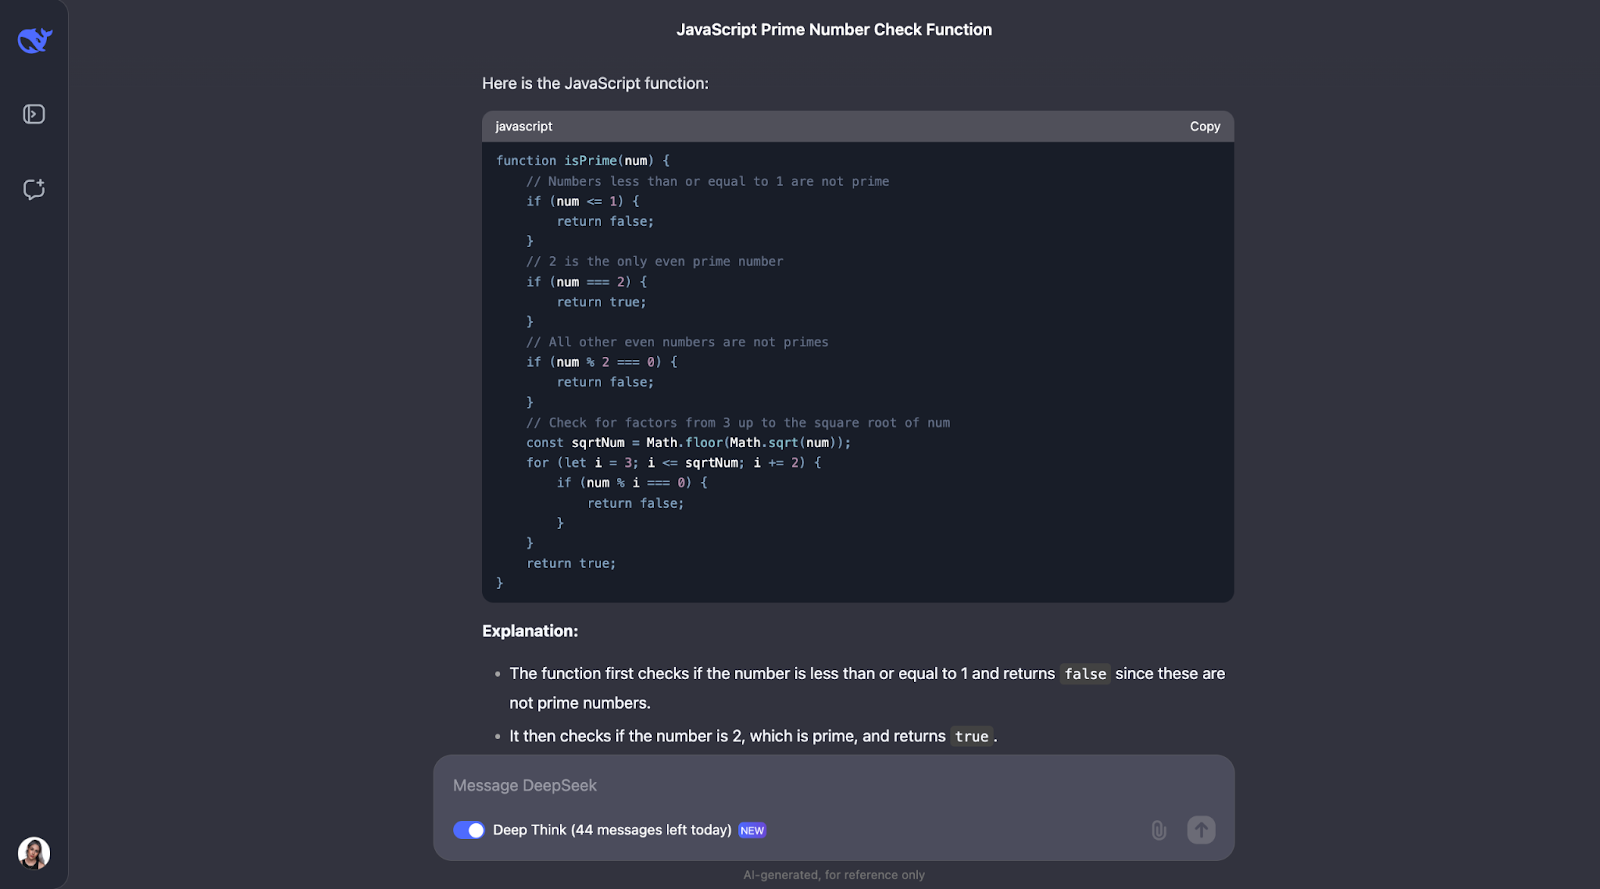
Saya pikir kita bisa melihat pola alur pikir di sini. Sebagian besar waktu, ia memulai dengan mendefinisikan konsep kunci yang muncul dalam masalah. Jadi, misalnya, untuk masalah ini, ia mendefinisikan apa itu bilangan prima.
Setelah itu, alur pikirnya masuk akal dan sampai pada langkah-langkah yang dioptimalkan. Pertama, ia mencakup dasar-dasarnya: bilangan kurang dari atau sama dengan 1 bukan prima, dan 2 adalah satu-satunya bilangan prima genap. Dari sana, ia memeriksa apakah bilangan tersebut habis dibagi oleh bilangan ganjil mana pun hingga akar kuadrat bilangan tersebut. Ini menghemat waktu karena menghindari perhitungan yang tidak perlu. Selain itu, alih-alih menguji setiap bilangan, ia melewati semua bilangan genap di atas 2, sehingga prosesnya makin cepat. Fungsi ini menggunakan Math.sqrt untuk mencari akar kuadrat, yang membatasi seberapa jauh perlu memeriksa, sehingga tetap efisien dan sederhana.
Sekali lagi, ia juga menguji dengan contoh kecil, seperti pada masalah sebelumnya, seperti bilangan prima dan bukan prima yang sudah dikenal, untuk memastikan fungsinya bekerja sebagaimana mestinya.
Masih ada ruang perbaikan. Misalnya, fungsi tersebut tidak memeriksa apakah input benar-benar sebuah angka, sehingga bisa menangani error dengan lebih baik. Ia juga bisa menyertakan jalan pintas untuk bilangan yang diakhiri dengan 0 atau 5, yang jelas bukan prima (kecuali 5 sendiri). Menambahkan sedikit penjelasan tentang mengapa ia melewati bilangan genap atau hanya memeriksa hingga akar kuadrat juga akan membantu pemula memahaminya lebih baik, menurut saya.
Terakhir, saya berharap kodenya memiliki beberapa contoh uji penggunaan, seperti yang diberikan pada kode Python di uji sebelumnya.
Sekarang mari lanjut ke uji penalaran logis.
Saya akan menguji teka-teki klasik:
"Seorang pria harus menyeberangi sungai dengan seekor serigala, seekor kambing, dan seikat kubis. Perahunya hanya dapat membawa dirinya dan satu barang lain. Jika ditinggal berdua, serigala akan memakan kambing, dan kambing akan memakan kubis. Bagaimana ia bisa membawa semuanya menyeberang dengan aman?"
Saya berharap model memberikan jawaban berikut:
Namun mari lihat bagaimana ia menangani alur pikirnya, karena saya tidak yakin apa yang diharapkan!
Saya perlu memangkas keluaran ini juga demi keterbacaan:
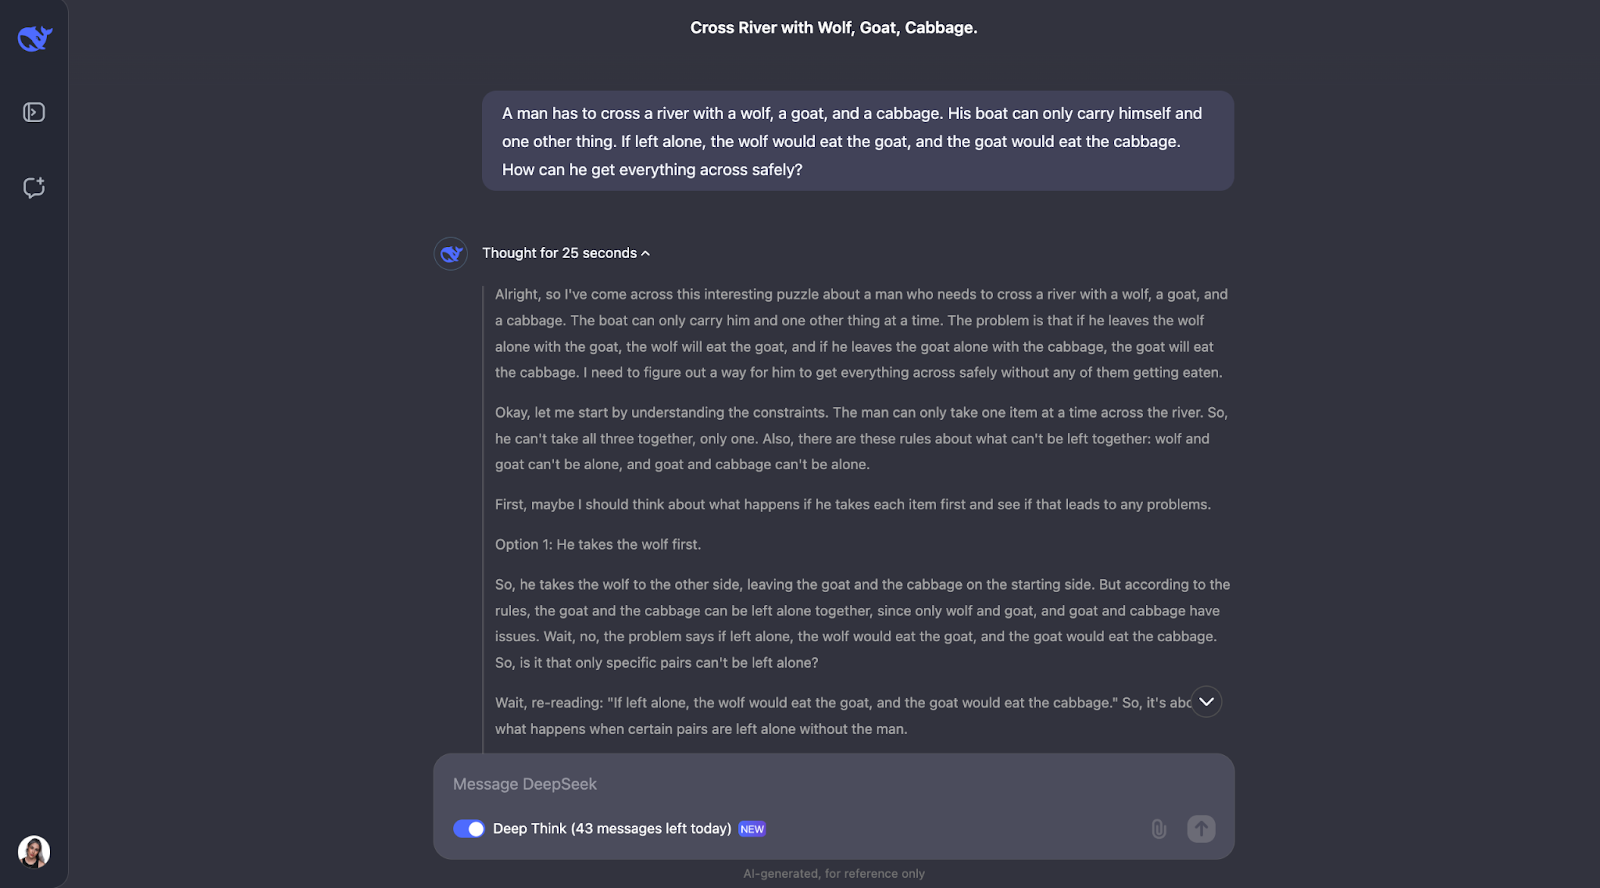
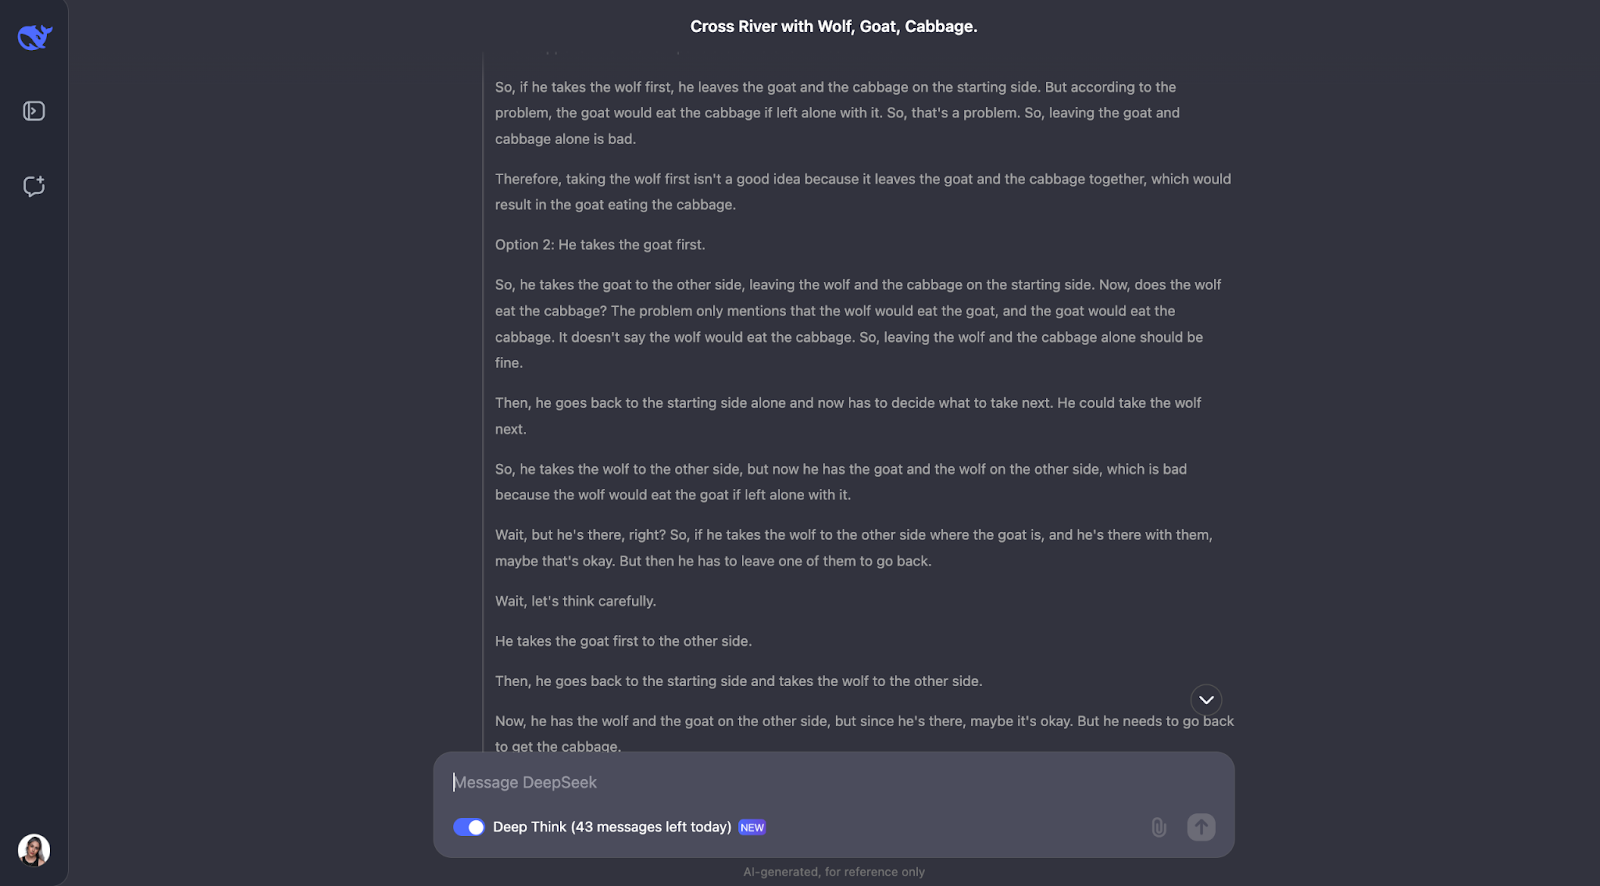
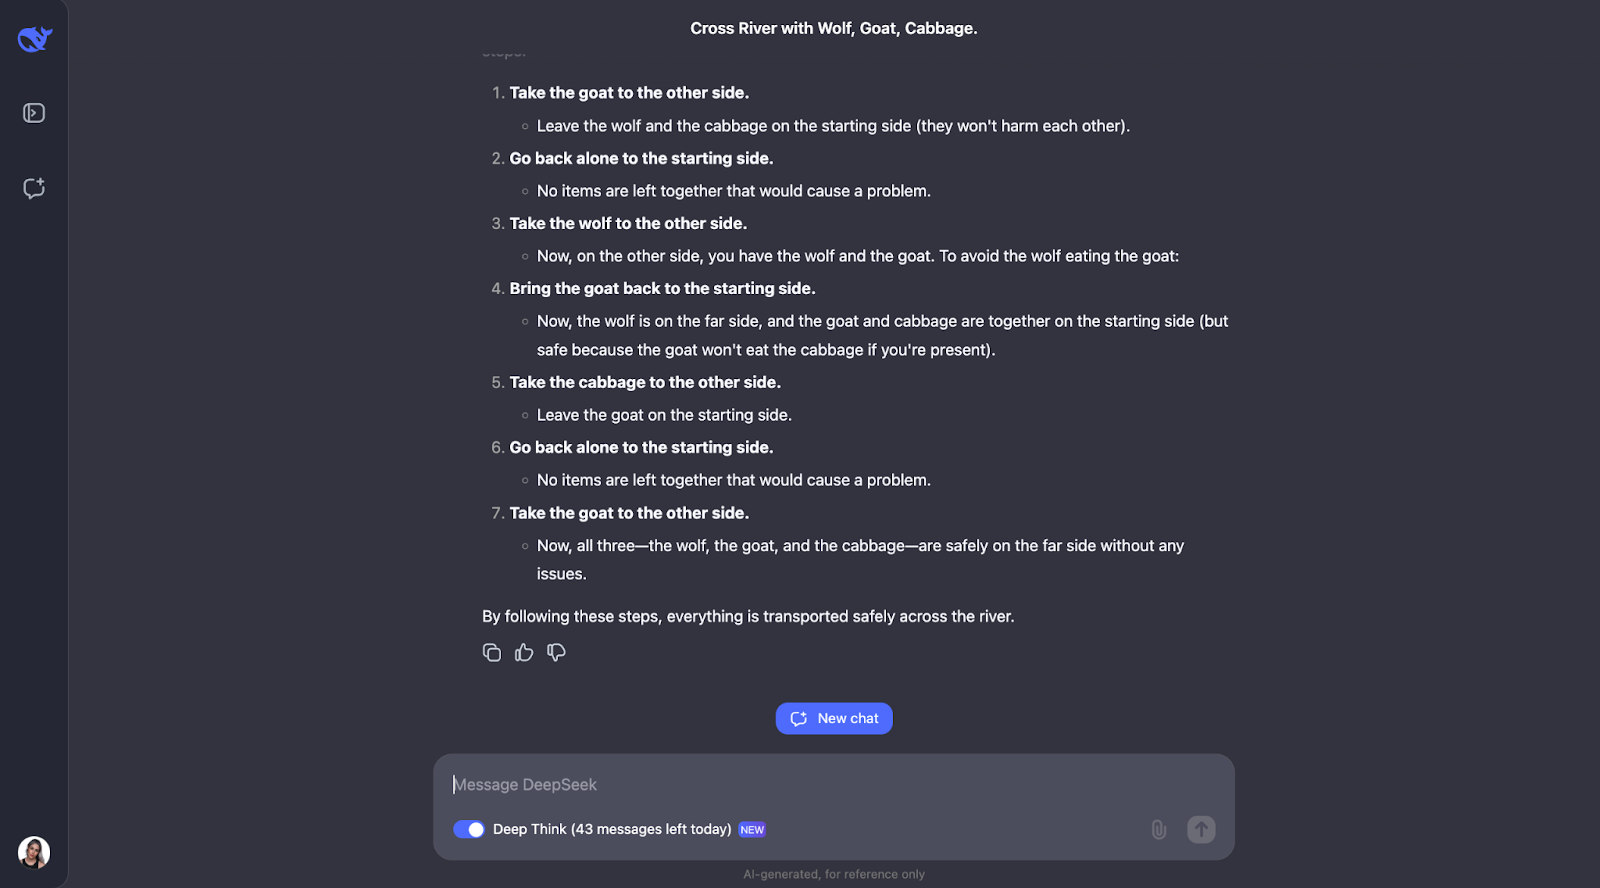
Model ini melakukan pekerjaan hebat dalam menyelesaikan teka-teki menyeberang sungai klasik ini. Ia berpikir cermat tentang aturan dan memeriksa berbagai kemungkinan. Ia memahami bahwa beberapa pasangan, seperti serigala dan kambing atau kambing dan kubis, tidak boleh ditinggal berdua. Ia juga meninjau kendala di awal. Dari sini, ia melihat apa yang terjadi jika pria tersebut membawa setiap item menyeberang terlebih dahulu dan menilai apakah itu menimbulkan masalah.
Yang saya rasa sangat bagus adalah bagaimana model menyesuaikan rencananya ketika sesuatu tidak berhasil. Misalnya, saat mencoba membawa serigala terlebih dahulu, lalu menyadari itu menimbulkan masalah, dan kemudian menata ulang langkah-langkahnya. Metode coba-coba ini terasa sangat mirip dengan cara kita, sebagai manusia, menyelesaikan teka-teki tersebut.
Pada akhirnya, model menghasilkan solusi yang tepat dan menjelaskannya dengan cara yang jelas, langkah demi langkah.
Mari coba yang lain:
“Anda memiliki 12 bola, semuanya identik secara tampilan. Satu bola lebih berat atau lebih ringan daripada yang lain. Dengan menggunakan neraca, temukan bola yang berbeda dan tentukan apakah lebih berat atau lebih ringan hanya dalam tiga kali penimbangan.”
Teka-teki logika klasik ini menguji kemampuan model untuk menyusun strategi optimal menggunakan penalaran deduktif. Mari kita lihat apa yang terjadi. Kali ini keluarannya sangat-sangat panjang, jadi saya harus langsung ke jawaban:
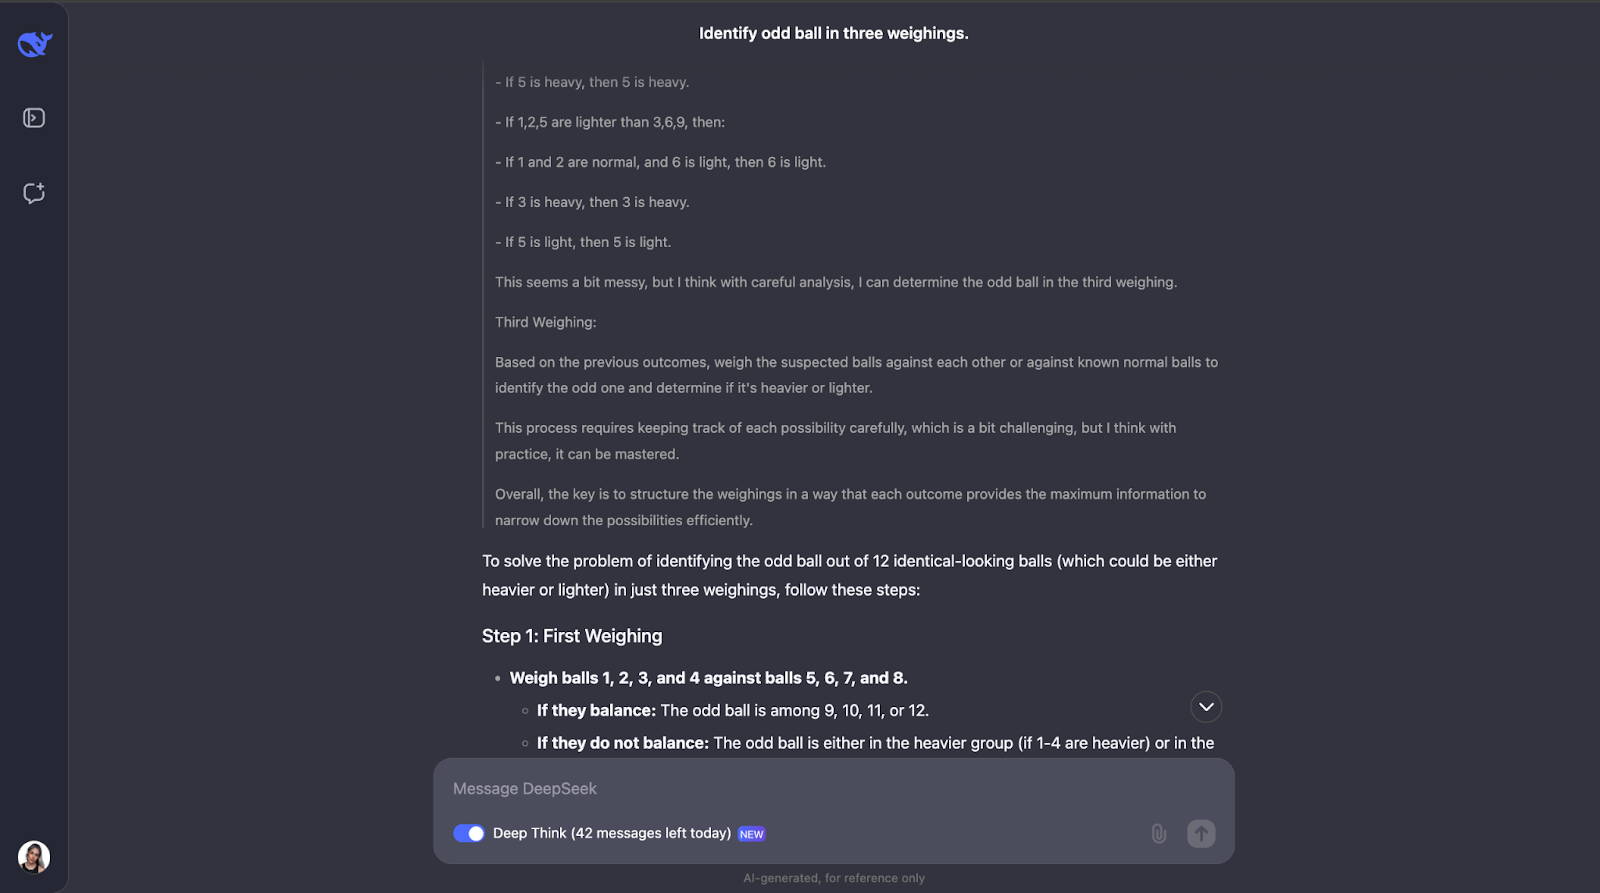
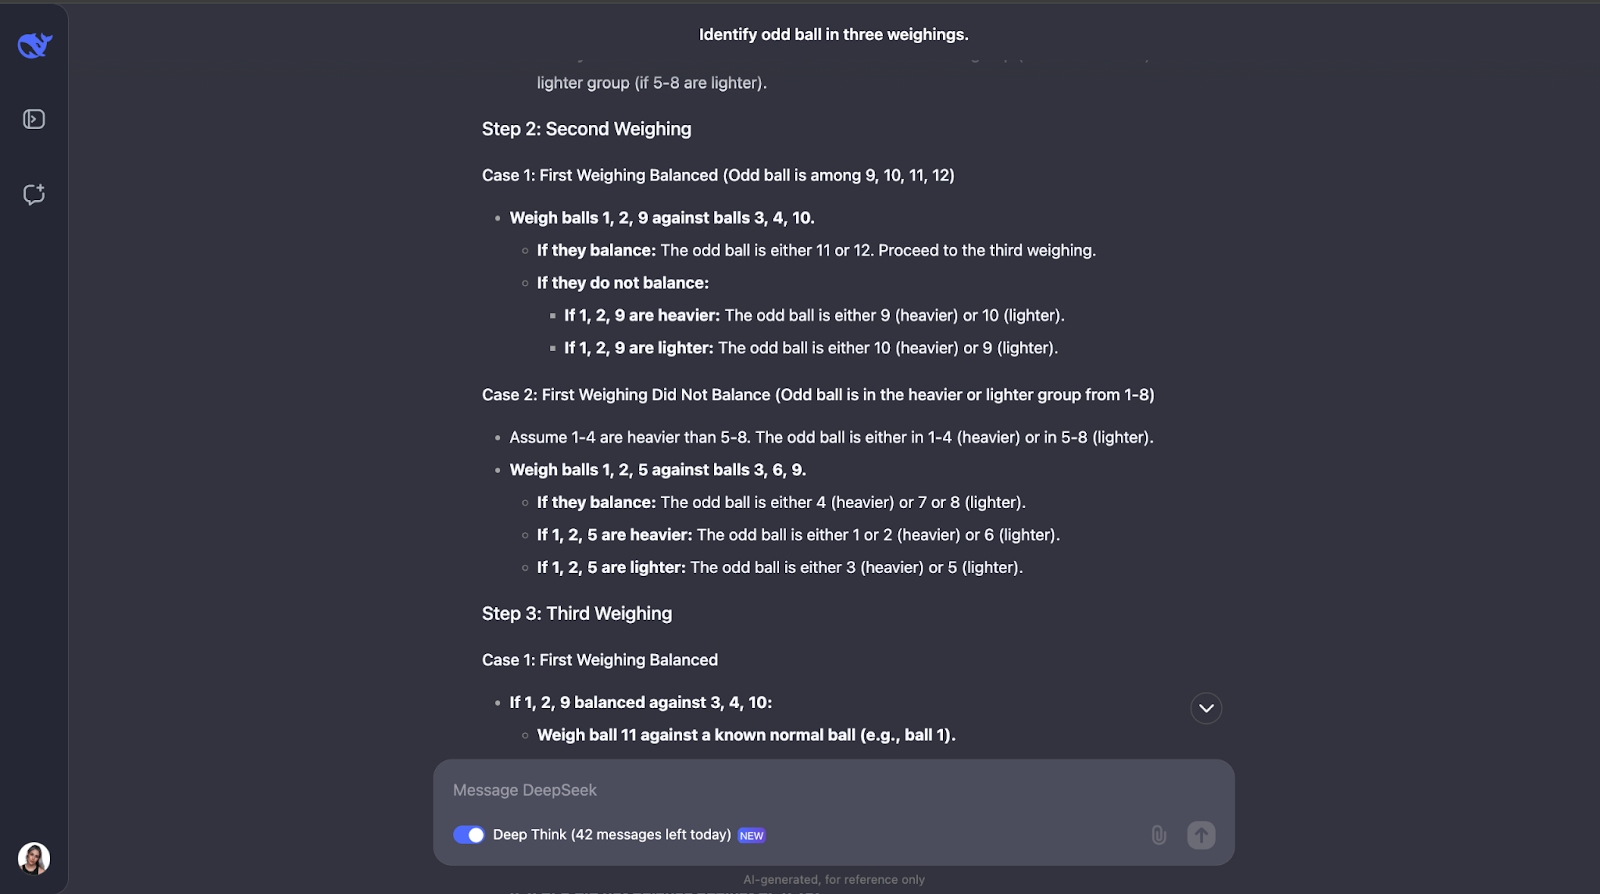
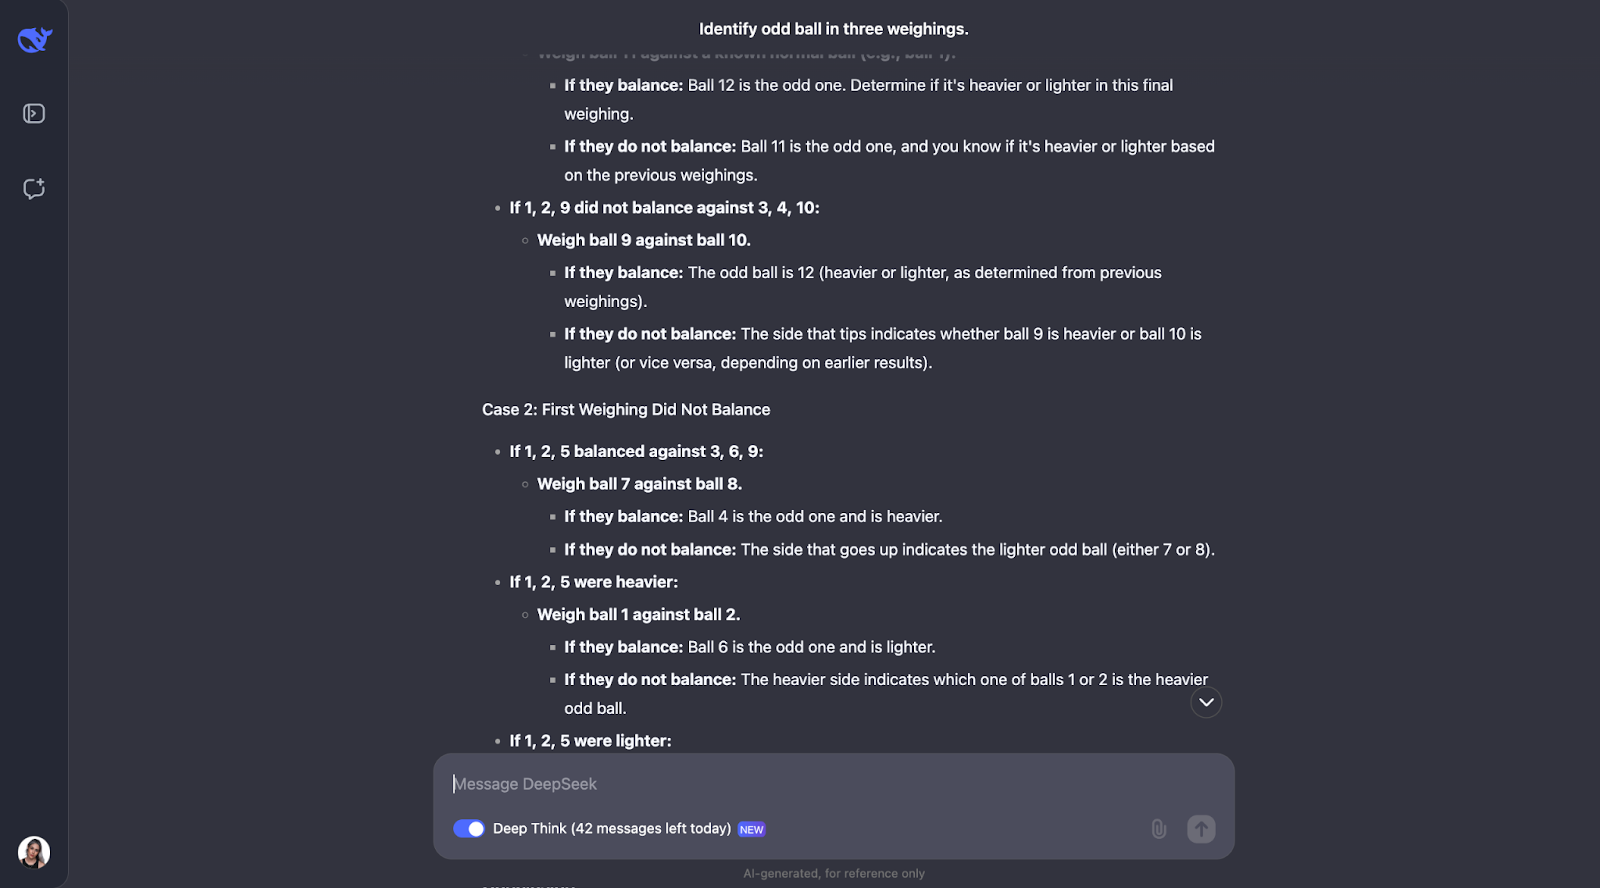
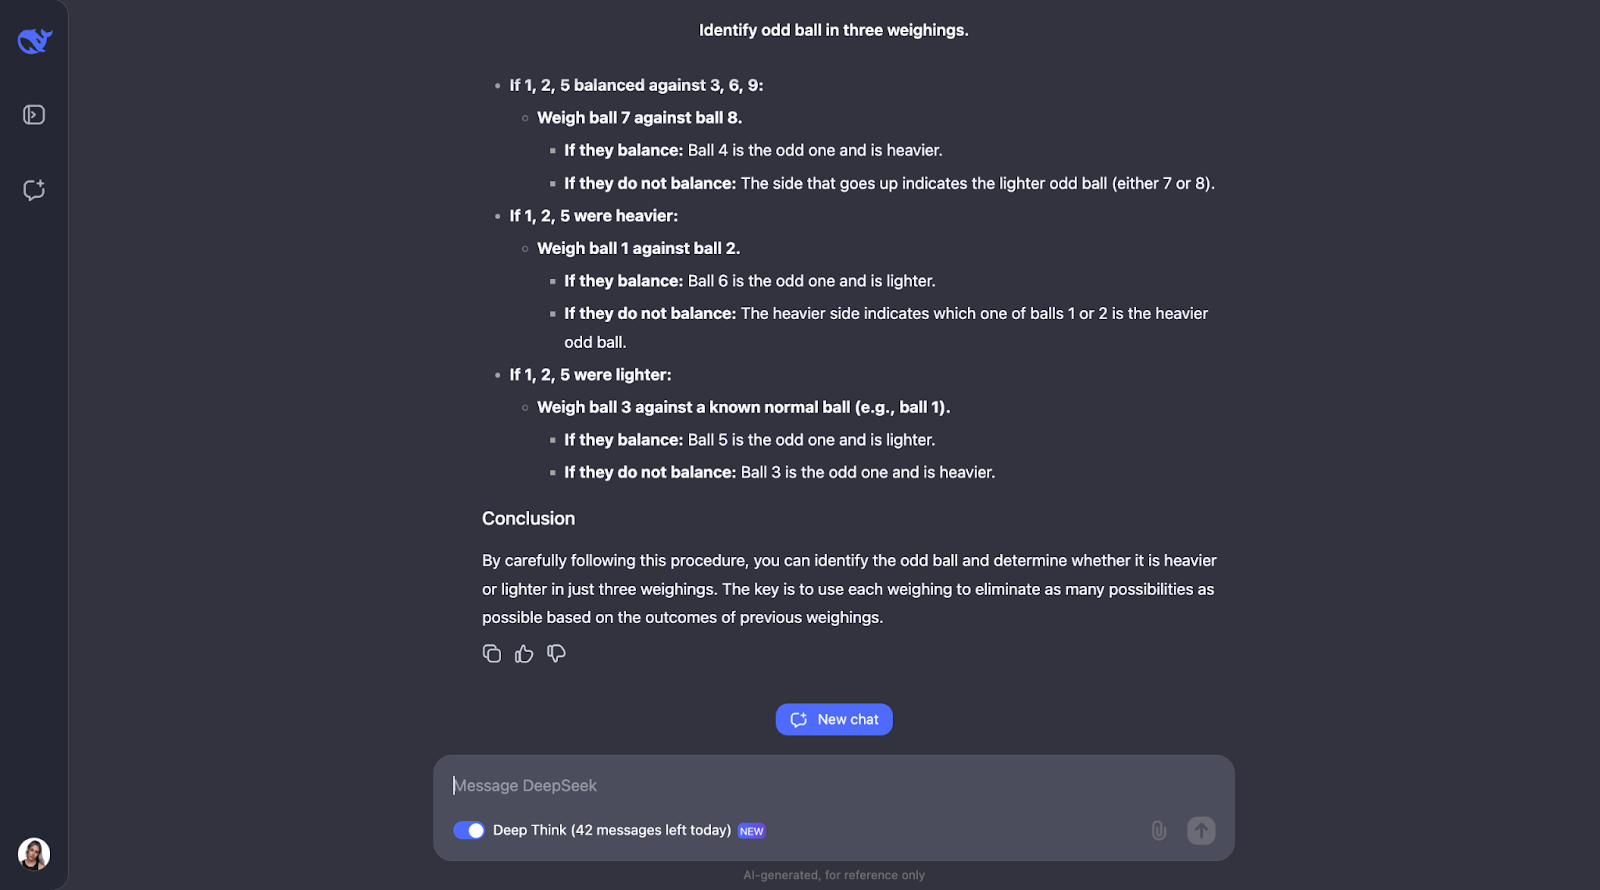
Ini satu lagi yang benar-benar saya remehkan panjang keluarannya! Model menyadari bahwa menyelesaikan teka-teki ini membutuhkan perencanaan yang cermat karena Anda hanya mendapat tiga kali percobaan. Ia juga menghitung jumlah keluaran dan kemungkinan.
Pendekatan model ini cerdas karena setiap penimbangan mengeliminasi sebanyak mungkin kemungkinan. Ia merencanakan semua hasil—apakah neraca seimbang atau miring—dan menyesuaikan langkah berikutnya berdasarkan apa yang terjadi. Sangat terperinci tetapi langkah-langkahnya jelas dan logis, sehingga sangat mudah untuk diikuti, meskipun panjang,
Satu hal yang sangat saya sukai adalah ketika pendekatan mulai terasa terlalu kompleks, ia menerapkan pendekatan yang lebih sistematis atau lebih sederhana. Namun, menurut saya untuk masalah seperti ini, di mana Anda perlu melacak berbagai kasus, hasil, dan kemungkinan, menambahkan diagram atau bagan mungkin membantu orang memvisualisasikan alur pikir dan memahami keluaran dengan lebih baik.
Di bagian ini, saya akan membandingkan DeepSeek dengan model lain seperti o1-preview dan GPT-4o dalam hal performa pada berbagai tolok ukur. Masing-masing berfokus pada keterampilan berbeda, sehingga kita bisa melihat model mana yang terbaik untuk apa. Mari lihat tolok ukur yang diukur oleh DeepSeek:
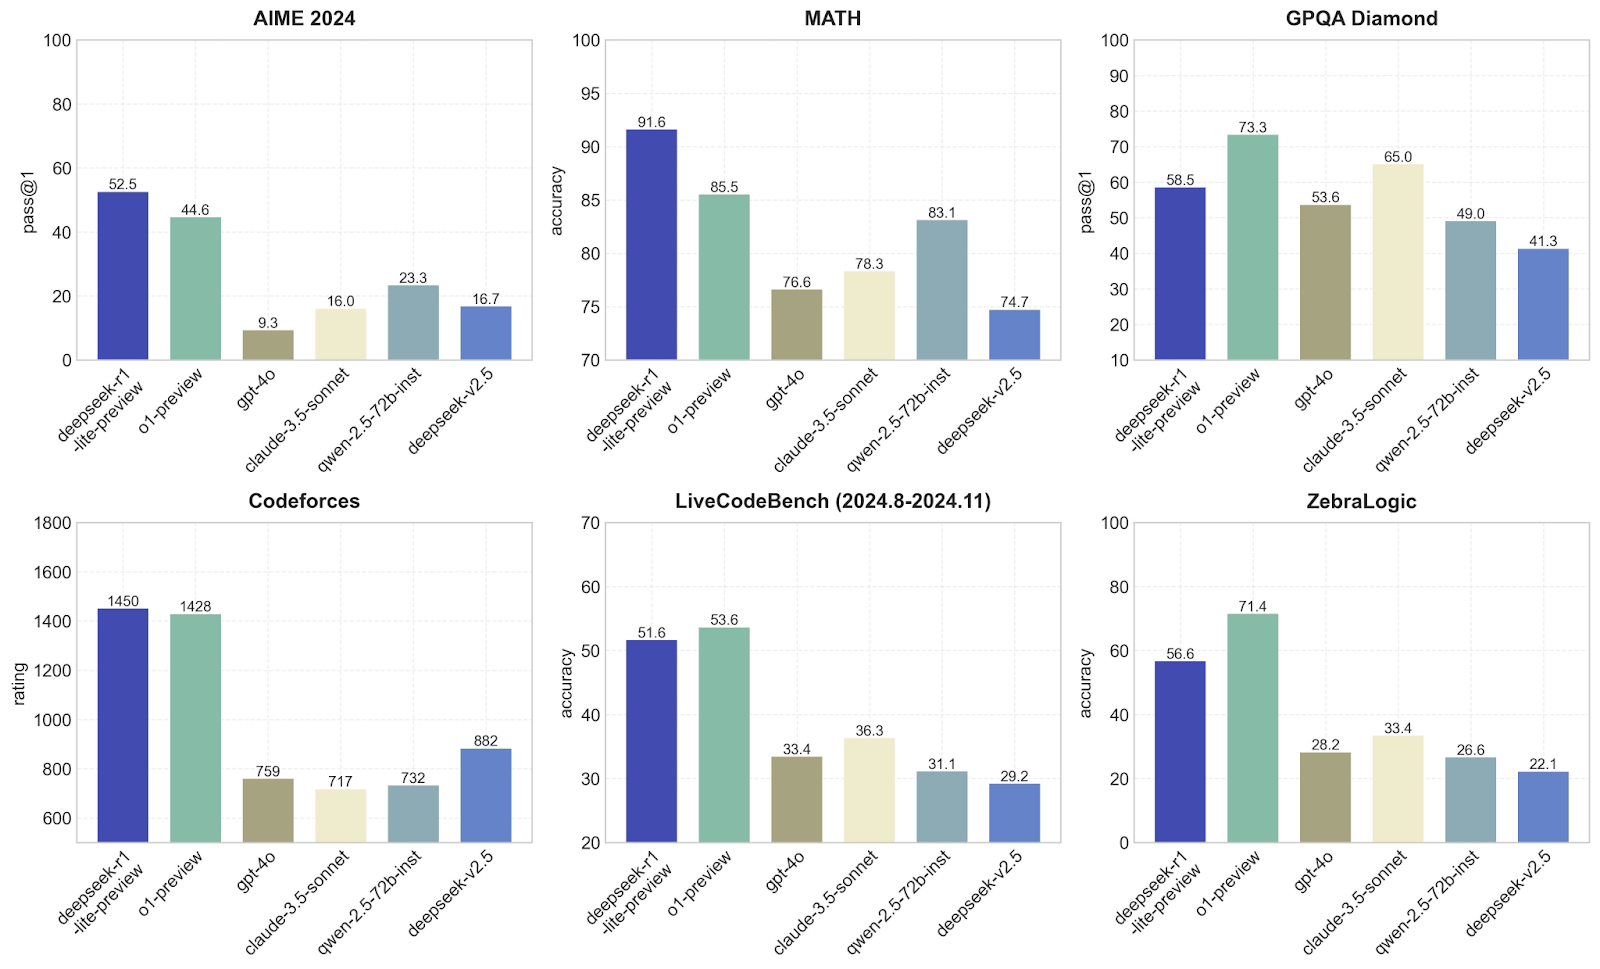
DeepSeek-r1-lite-preview jelas yang terbaik di sini, dengan pass@1 sebesar 52,5, diikuti oleh o1-preview di 44,6. Model lain, seperti GPT-4o dan claude-3.5-sonnet, berkinerja jauh lebih buruk, dengan skor di bawah 23. Ini menunjukkan bahwa model DeepSeek-r1-lite-preview cukup baik dalam menangani soal matematika atau logika tingkat lanjut yang spesifik pada tolok ukur AIME, yang tidak mengherankan bagi saya setelah pengujian yang saya lakukan.
DeepSeek-v1 kembali mendominasi dengan akurasi mengesankan 91,6, jauh di depan o1-preview (85,5) dan jauh lebih baik daripada model lain seperti GPT-4o, yang kesulitan mencapai 76,6. Ini menunjukkan bahwa DeepSeek sangat hebat dalam menyelesaikan soal matematika, yang menegaskan hipotesis saya dari bukti empiris pada pengujian yang saya lakukan sebelumnya–tidak ada kejutan sejauh ini!
Di sini, o1-preview berkinerja lebih baik daripada DeepSeek-v1, dengan pass@1 sebesar 73,3 dibandingkan 58,5. Model lain, seperti GPT-4o, tertinggal di 53,6. Ini menunjukkan bahwa o1-preview lebih cocok untuk tugas yang melibatkan menjawab pertanyaan atau memecahkan masalah berdasarkan penalaran logis. DeepSeek tetap solid namun tidak sebaik o1-preview.
Untuk pemrograman kompetitif, DeepSeek-v1 (1450) dan 01-preview (1428) hampir imbang di posisi teratas, sementara model lain seperti GPT-4o hanya mencetak sekitar 759. Seperti yang diharapkan, ini menunjukkan bahwa kedua model ini sangat baik dalam memahami dan menghasilkan kode untuk tantangan pemrograman.
Ini menguji kemampuan pengkodean dari waktu ke waktu, dan o1-preview sedikit unggul dari DeepSeek-v1 (53,6 vs. 51,6). Model lain, seperti GPT-4o, tertinggal jauh di 33,4. Sekali lagi, ini menunjukkan bahwa DeepSeek dan 01-preview sama-sama cocok untuk pengkodean tetapi 01-preview sedikit lebih baik untuk tugas-tugas ini.
o1-preview memimpin di sini dengan akurasi 71,4, dibandingkan 56,6 untuk DeepSeek-v1. Model lain jauh lebih buruk. Ini menunjukkan bahwa o1-preview lebih baik dalam menangani tugas logika abstrak seperti ZebraLogic, yang membutuhkan pemikiran lebih kreatif atau out-of-the-box, sejalan dengan hasil yang saya dapatkan dari pengujian karena kreativitas jelas bukan keunggulan DeepSeek-v1.
Grafik-grafik ini menguatkan bahwa DeepSeek-v1 luar biasa dalam tantangan matematika dan pemrograman. Saya akan mengatakan bahwa o1-preview lebih seimbang dan berkinerja baik di rentang tugas yang lebih luas, sehingga lebih serbaguna.
Sekarang mari lihat grafik ini:
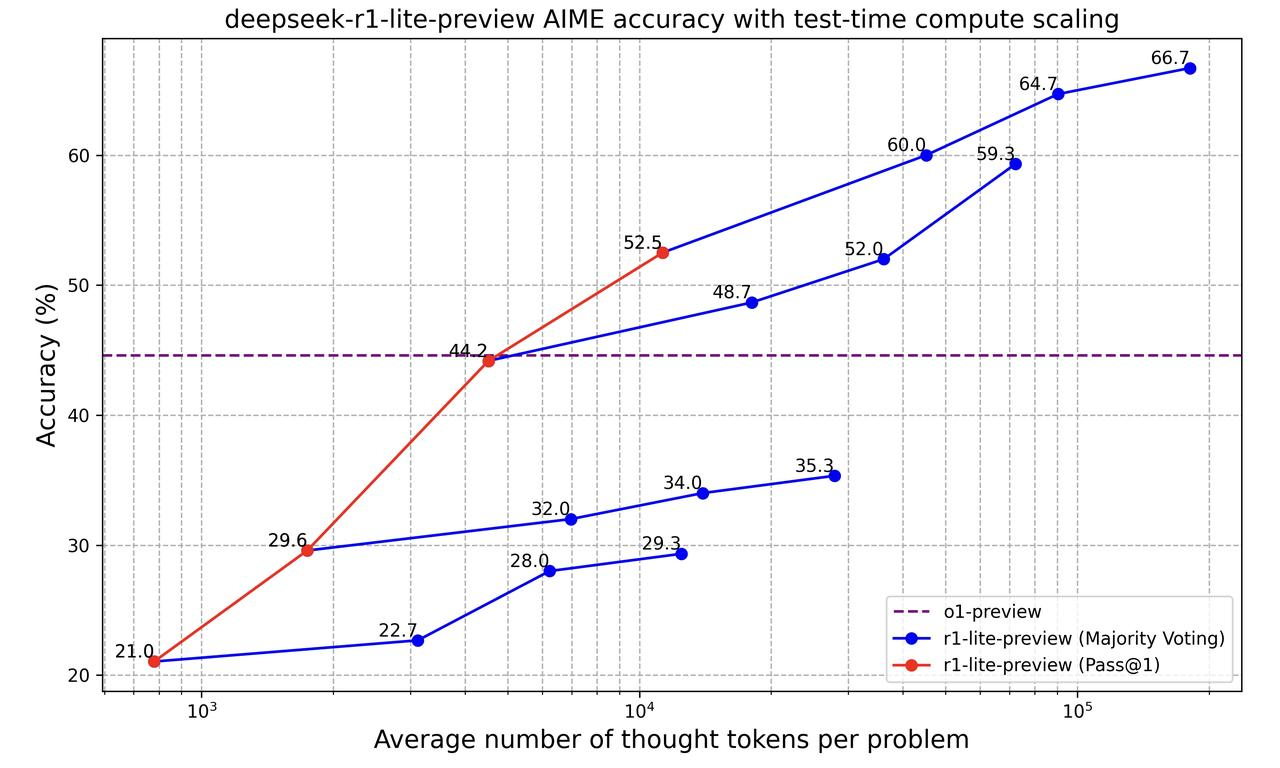
Grafik ini menunjukkan bagaimana model "deepseek-r1-lite-preview" menjadi lebih baik dalam memecahkan masalah saat memproses lebih banyak informasi (diukur dengan jumlah "token pikiran" yang digunakan). Ini membandingkan dua cara akurasi model diukur:
Garis putus-putus ungu merepresentasikan model o1-preview yang memiliki akurasi stabil. Pada awalnya, o1-preview lebih baik, tetapi ketika DeepSeek r1-lite-preview diizinkan menggunakan lebih banyak token pikiran, ia melampaui o1-preview dan menjadi jauh lebih akurat.
Jadi pada dasarnya, grafik ini menunjukkan bahwa membiarkan DeepSeek r1-lite-preview berpikir lebih lama dan mencoba beberapa kali meningkatkan akurasinya.
Apakah DeepSeek-r1-lite-preview lebih baik daripada o1-preview dari OpenAI? Yah, tergantung tugasnya. Saya akan bilang ya untuk masalah matematika dan pengkodean. Untuk penalaran logis, itu tergantung pada tugasnya.
Yang benar-benar mengejutkan saya adalah bagaimana ia menalar melalui beberapa tes. Ini benar-benar membuat saya berpikir tentang apa artinya sebuah model "berpikir" dan bagaimana ia menyusun pendekatan penalarannya.
Jika Anda penasaran dengan model ini, mengapa tidak mencobanya sendiri? Uji pada tugas yang Anda minati dan lihat bagaimana performanya—Anda mungkin akan sama terkejutnya seperti saya!
Pelajari AI dengan kursus-kursus ini!
Kursus
Program
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Javier Canales Luna
14 mnt
blogs
Hugo Bowne-Anderson
13 mnt




