
什么是 DeepSeek-R1-Lite-Preview?
DeepSeek-R1-Lite-Preview 是一款类似于 ChatGPT 的 AI 工具,由中国公司 DeepSeek 开发。该公司于 11 月 20 日在 X 上发布了这一新模型(推文链接),并在一页文档中分享了一些细节。
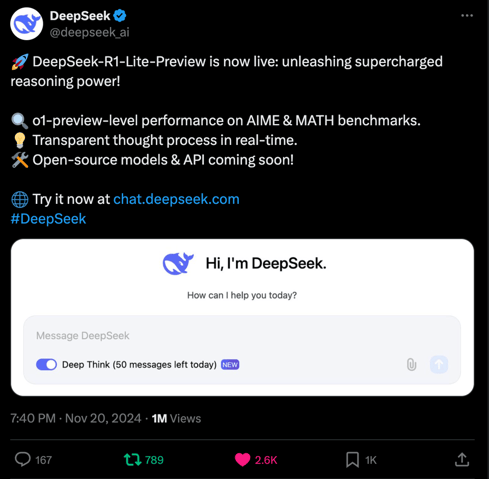
DeepSeek-R1-Lite-Preview 旨在出色解决数学、编程和逻辑中的复杂推理问题。它会逐步展示自己的思考过程,让您了解答案的来由,从而提升信任度。
您可以在其官网 chat.deepseek.com 免费试用,但其名为“Deep Think”的高级模式每天限 50 条消息。DeepSeek 还计划将该工具的部分内容向公众开放,便于他人使用或在其基础上构建。
如何使用 DeepSeek-R1-Lite-Preview
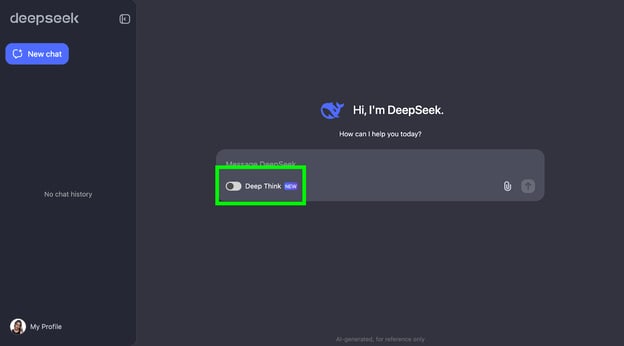
按照以下两步即可开始使用 DeepSeek-R1-Lite-Preview:
- 访问 DeepSeek 聊天页并登录。
- 启用 "Deep Think."
草莓测试
为了看看 DeepSeek-R1-Lite-Preview 的能力,让我们来做个测试!我会逐步进行一系列挑战来展示它的推理能力,先从一个简单但著名的草莓问题开始: 字母“r”在“strawberry”中出现了多少次?"
这个问题看似简单,但大语言模型(即便是 GPT-4o)历来容易出错——它们通常回答只有两个字母 r 的出现次数。
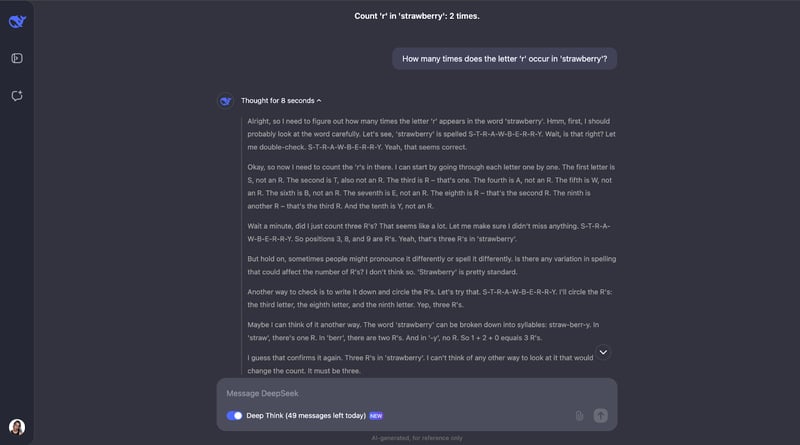
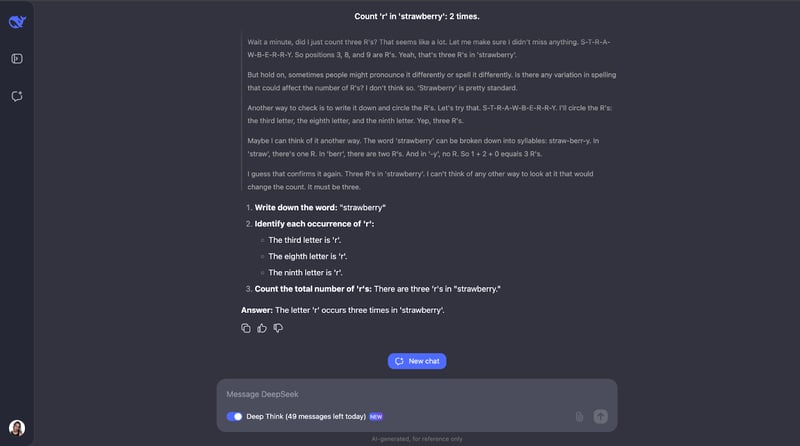
哇,说实话,我没想到这样一个看似直接的任务会出现如此冗长的推理过程。我本以为在数清字母“r”并标出其位置后就会结束。但有趣的是它并没有止步于此。它又复核了几次计数,甚至考虑了人们可能的不同发音或拼写——我觉得这有点多余,尤其是发音那部分。但这也体现了它的谨慎与周全!它还解释了每一步,让我能跟上它的思路,看到它如何得出答案。
数学推理
我将用三个数学问题来测试 DeepSeek-R1-Lite-Preview。
三角形面积
既然 DeepSeek 声称在数学推理方面很强,我们先从一个简单的几何问题开始。
"若一个三角形的三边长为 3、4、5,它的面积是多少?"
这个问题需要用到勾股定理和海伦公式。我预计 DeepSeek-R1-Lite-Preview 会展示解题步骤,大致如下:
- 识别为 3-4-5 直角三角形
- 计算半周长:s = (3 + 4 + 5) / 2 = 6
- 应用海伦公式:Area = √(s(s-a)(s-b)(s-c))
- 代入:Area = √(6(6-3)(6-4)(6-5)) = √(6 * 3 * 2 * 1) = √36 = 6
- 验证:直角三角形面积 = (底 * 高) / 2 = (3 * 4) / 2 = 6
看看会发生什么!
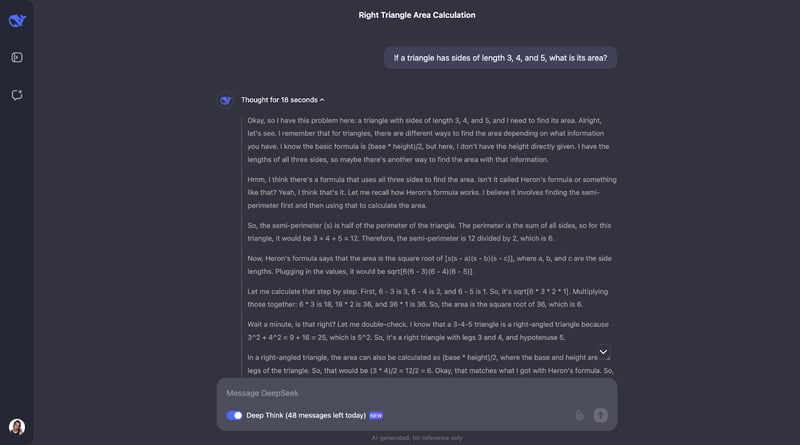
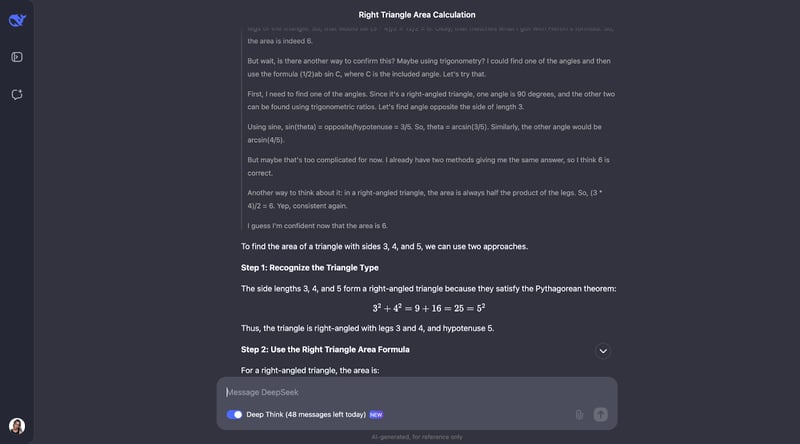
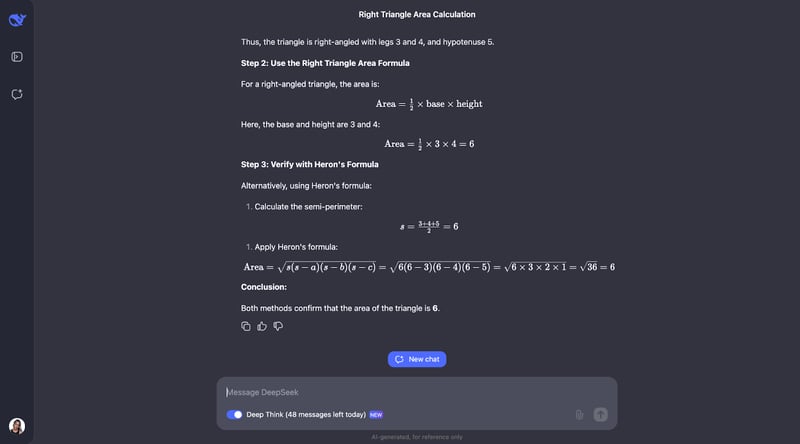
好吧,有意思的是,它确实做了我预测的检查——虽然顺序不同。它还考虑了通过计算角度并采用另一种公式的三角函数方法。我觉得很有意思,最终它认为没必要,因为前两种方法已经验证了答案。
解题思路和输出都异常清晰、易于跟进,这让我觉得将其嵌入到数学学习助手中会非常棒。对于这种用例,也许可以先展示思路,让学生与其互动,确认是否理解,再给出最终答案。
数学证明
接下来做一个更复杂的数学测试,看看表现与思路是否有差异。
“证明斐波那契数的倒数之和收敛到有限值。”
这个测试考查模型对高级数学概念的理解,例如级数收敛性和斐波那契数的性质。试试看!为保证可读性,我只展示答案的开头和结尾(但欢迎您用相同的提示词自行尝试):
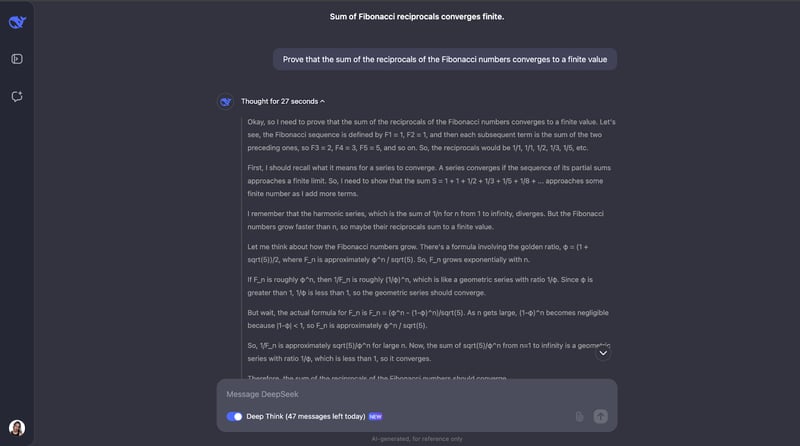
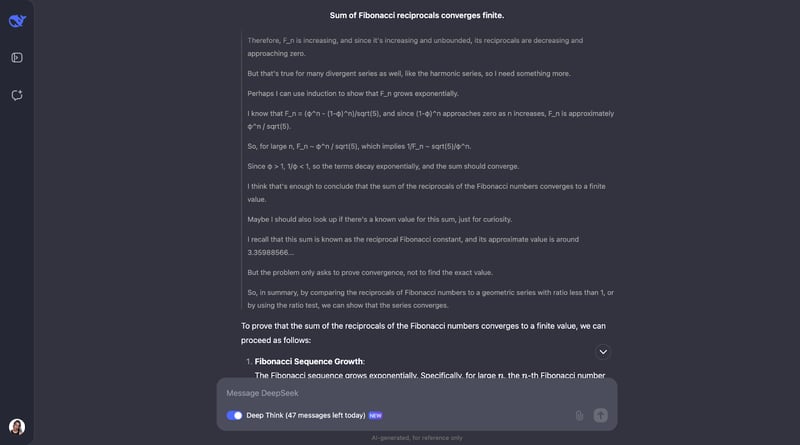
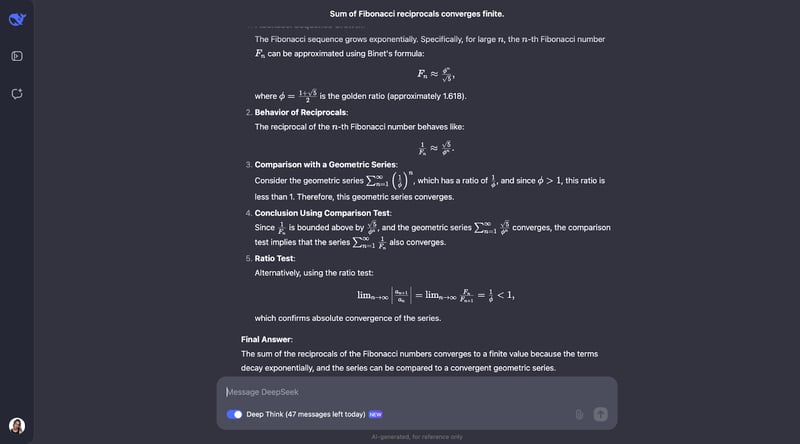
好的,这是一条很棒的思路——我尤其喜欢它先确认了关键概念的理解,如倒数与收敛。随后,DeepSeek-R1-Lite-Preview 通过考察斐波那契数的增长并使用比较判别法来处理问题,这是一种常见的判断级数是否收敛的方法。
它将斐波那契数倒数与几何级数进行比较。由于斐波那契数的倒数衰减速度甚至快于公比小于 1 的几何级数,模型据此得出倒数和也收敛到有限值。为更稳妥,它还使用了比值判别法。
该检验会看相邻项之比的极限是否小于 1;若小于 1 则级数收敛。模型计算了斐波那契数倒数的相邻项比值,发现确实小于 1。
它甚至提到该和有一个已知常数,称为“斐波那契倒数常数”,约为 3.3598。但对本题而言,我们只需知道该和是有限的,而非具体数值——这算是额外信息,我也觉得很有趣。输出中的解答呈现我很喜欢,清晰且循序渐进。
到目前为止,我对它在数学任务上的表现印象深刻。
微分几何
我想尝试一道微分几何题——毕竟我的博士研究在这一领域,所以忍不住小测一下。不算太复杂,就是本科数学里常见的一道经典练习。
“考虑 R³ 中的一条曲面 S,其参数化为
φ(u,v) = (u cos v, u sin v, ln u)
其中 u > 0 且 0 ≤ v < 2π。
a) 计算 S 的第一基本形式。
b) 判断 S 是否为极小曲面。
c) 求 S 的高斯曲率 K 和平均曲率 H。”
我预计 DeepSeek-R1-Lite-Preview 会给出逐步求解,展示所有计算,并解释每个结果的意义,以及诸如基本形式、极小曲面和不同曲率等关键概念的定义。
为保持本文可读性,我只能展示答案的第一部分和最后一部分,但也鼓励您自行尝试该提示词:
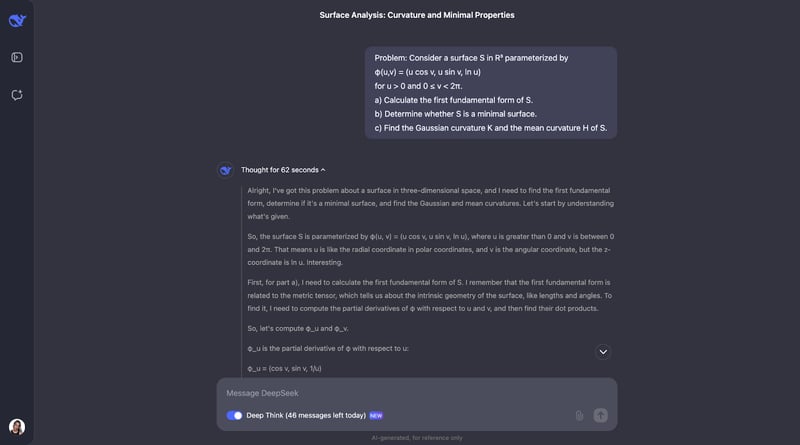
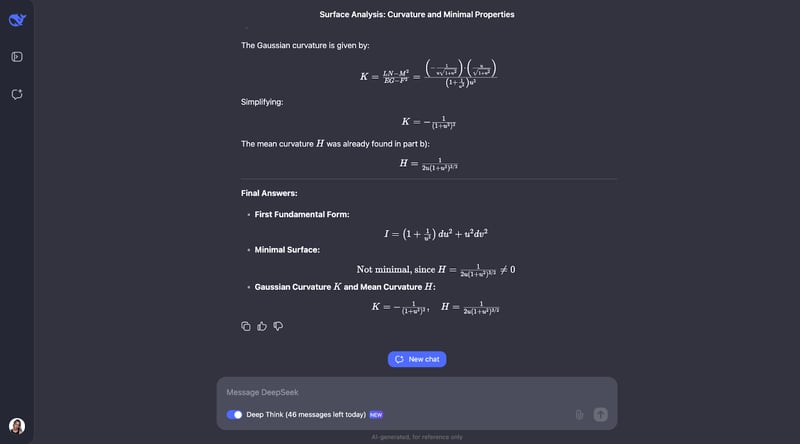
这套逐步方法应用了众所周知的几何公式并直接套用,因此推理易于跟进。不过我原本期望它能像之前一样,先自检对题中主要概念的理解,而这并未出现在思路中。对于第 B 问,它采用了另一种方法,识别出该曲面是旋转曲面,这一点很加分。
还有一处它谈到旋转并意识到自己已经有了 N(法向量),这可能与第二基本形式系数的记号冲突。我更希望能看到它提出更好的记号建议,因为同一字母一物二用并非好习惯!
在计算平均曲率时,它注意到结果不为零,并质疑计算是否正确。为求稳妥,它又尝试了另一种方法进行复核。
再次强调,输出非常清晰易懂。在所有示例中,它都会用不同方法反复核对计算,令人印象深刻。思路始终详尽、合乎逻辑、易于理解!
编程测试
接下来进入编程测试。
Python
我要测试的第一个问题是:
“用 Python 实现一个函数,找出给定字符串中最长的回文子串。函数的时间复杂度要优于 O(n^3)。”
我想评估模型设计高效算法并将其实现为代码的能力。我预计会看到使用动态规划或 Manacher 算法的解法,并附有清晰的思路说明和时间复杂度分析。
输出非常非常长,我只展示开头和结尾部分:
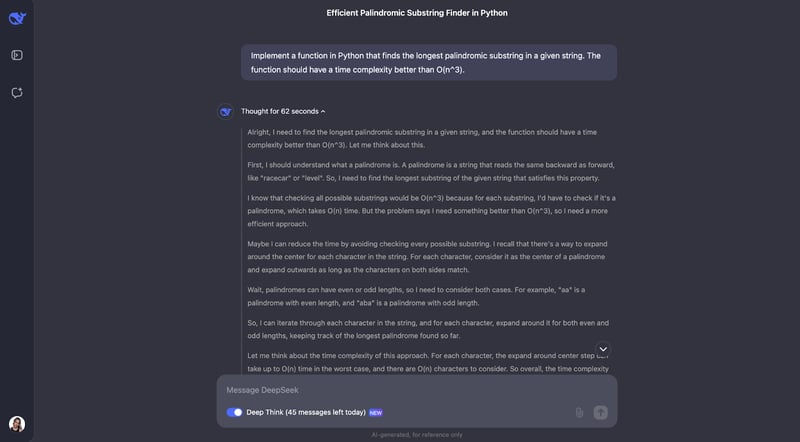
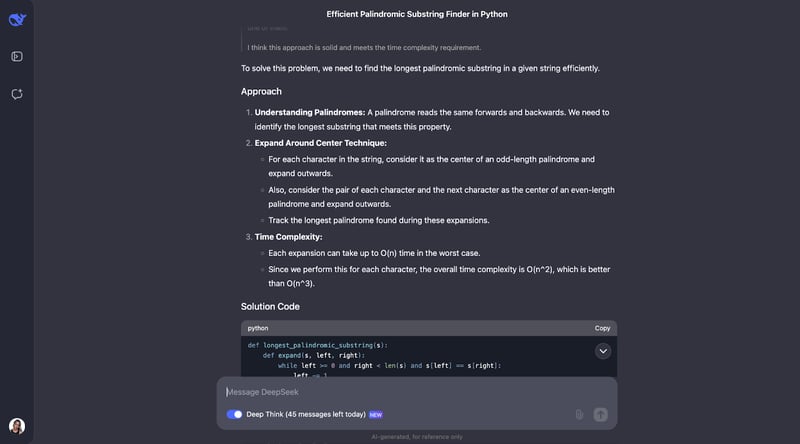
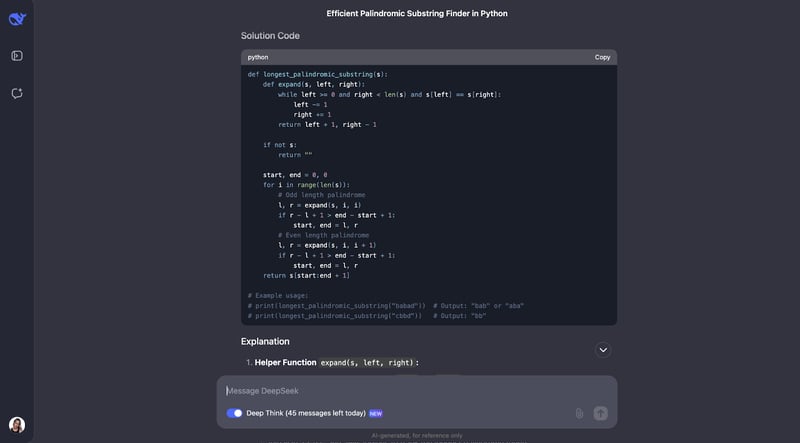
我认为该模型在解决最长回文子串问题上表现出色。它的思路聪明高效,解释也很清楚。
它没有暴力枚举所有子串(那样会很慢),而是采用了巧妙的“以中心扩展”技巧。该方法同时处理奇数长度回文(如“aba”)和偶数长度回文(如“abba”)。在过程中它会持续记录当前找到的最长回文。最终算法时间复杂度为 O(n^2),远快于 O(n^3) 的方案。
让我最佩服的是答案的呈现方式。DeepSeek 将问题拆解为易懂的步骤,详细解释了思路,甚至包含实际示例。例如,它展示了算法如何围绕“racecar”或“abba”的中心扩展以找到正确的回文。用于围绕中心扩展的辅助函数我尤其喜欢——让代码模块化、易于理解。
不过,我原本以为它会考虑 Manacher 算法,这是一种更快的 O(n) 解法。确实更复杂,但在性能至关重要的场景中很有用,我本期待模型能指出这一点。
我也注意到输出没有明确讨论算法如何处理特殊情况,比如空字符串或所有字符相同的字符串(如“aaaa”)。这些情况其实能工作——但我原本以为它至少会讨论一下。
最后,我觉得它对示例用法的期望输出做了说明这点很好。不过当我运行代码时,第一个示例用法只打印了其中一个备选结果。若代码能考虑并打印所有可能答案就更好了。
JavaScript
换个编程语言再试一道题。
“用 JavaScript 编写一个函数,判断给定数字是否为质数”
为保证可读性,我只展示开头和结尾(虽然这次思路稍短一些):
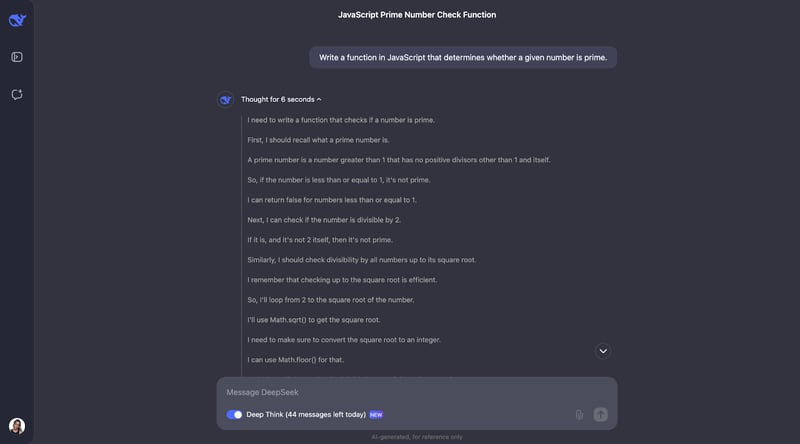
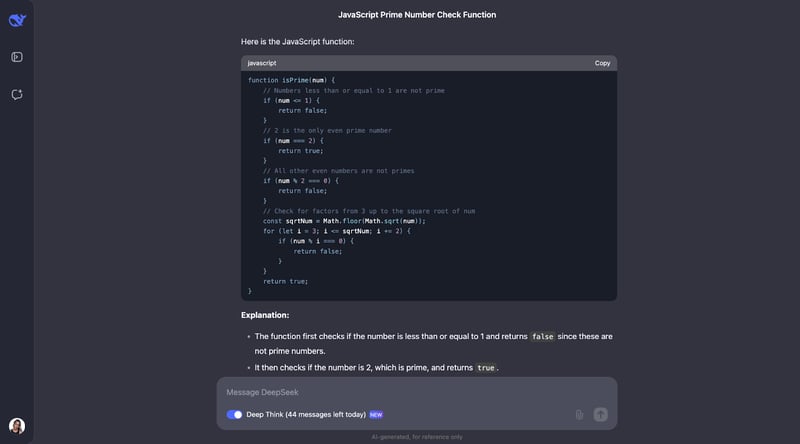
我想我们已经能看出它思考的模式了。多数情况下,它会先定义题目中出现的关键概念。比如本题先定义什么是质数。
之后的思路也合理,并得出优化步骤。首先覆盖基础:小于等于 1 的数不是质数,2 是唯一的偶质数。然后检查该数是否能被不超过其平方根的奇数整除。这样可以节省时间,避免不必要的计算。而且它不再测试 2 之后的所有偶数,进一步加速。函数使用 Math.sqrt 求平方根,从而限定检查范围,既高效又简洁。
同样,它也像前一个问题那样用一些小例子进行测试,比如已知的素数和合数,以确保按预期工作。
当然仍有改进空间。例如,函数没有检查输入是否为数字,因此可以做更好的错误处理。它也可以加入一些快捷判断,比如尾数为 0 或 5 的数显然不是质数(5 本身除外)。另外,我认为若能再多解释一下为什么要跳过偶数、为何只检查到平方根,也会更有助于初学者理解。
最后,我原本期待像前一个 Python 测试那样,代码能附上示例用法测试。
逻辑推理
接下来进行逻辑推理测试。
狼、羊与白菜
我将测试一个经典谜题:
"某人要带着一只狼、一只羊和一棵白菜过河。船一次只能载他自己和另一件物品。若单独留下,狼会吃羊,羊会吃白菜。他如何才能安全把三者都带到对岸?"
我预计模型会给出如下答案:
- 开始:人、狼、羊、白菜在同一岸
- 带羊过河(狼与白菜在一起是安全的)
- 人空手返回
- 带狼过河
- 把羊带回(狼和羊不能单独留下)
- 带白菜过河
- 人空手返回
- 再带羊过河
- 结束:全部安全到达对岸
不过让我们看看它的思路如何展开,我不太确定会发生什么!
为保证可读性,我也需要截断这段输出:
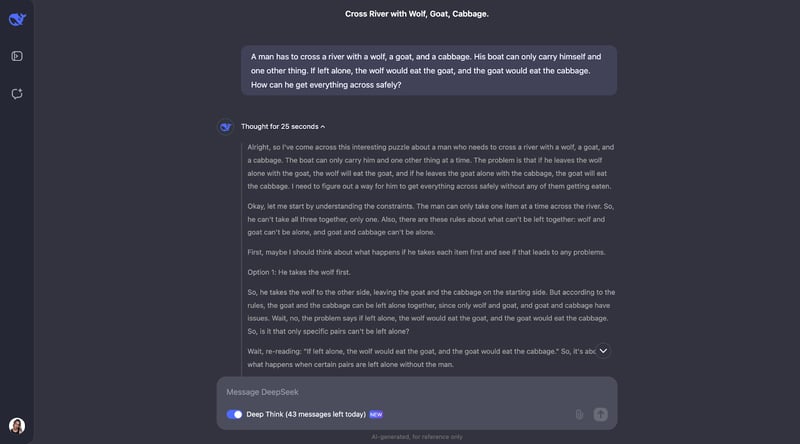
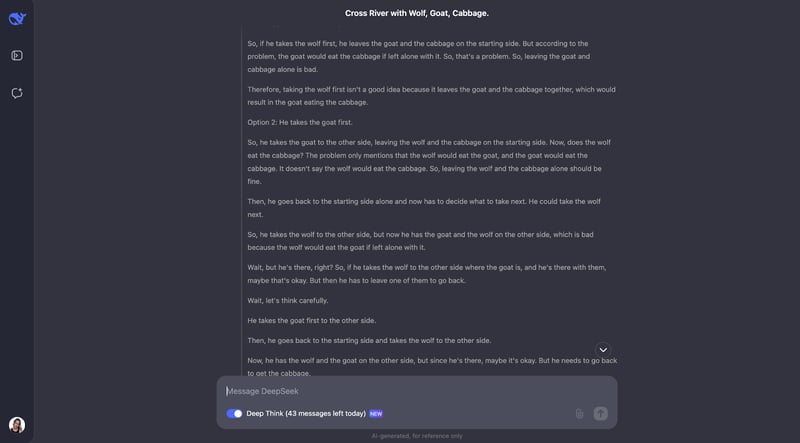
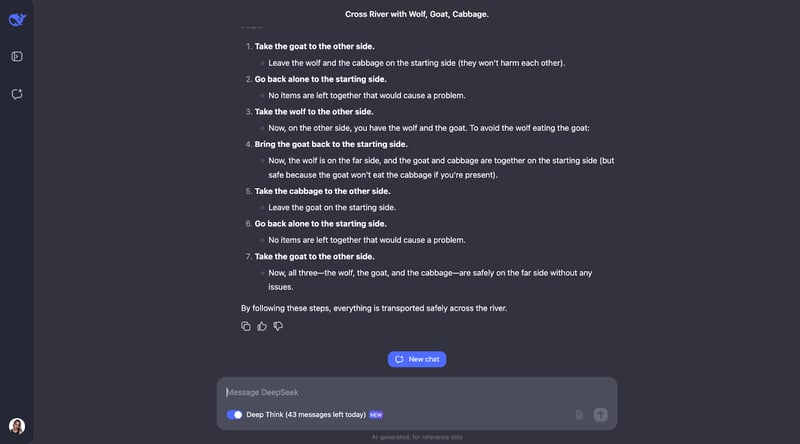
该模型很好地解决了这道经典的渡河谜题。它仔细思考规则并检查各种可能。它明白像狼与羊、羊与白菜这样的组合不能单独留下。它也在开头回顾了约束条件。在此基础上,它考察了若先带每个物品过河会发生什么,并判断是否会产生问题。
我特别喜欢的是,当某种方案行不通时,它会调整计划。比如当尝试先带狼过河发现会引发麻烦时,它会重新思考步骤。这种试错方式很像我们人类解决此类谜题的过程。
最终,模型给出了正确解法,并以清晰的步骤进行说明。
称球问题
再来一道:
“你有 12 个外观完全相同的球,其中一个球比其他球要重或轻。使用天平,在仅用三次称量的情况下找出这个特殊的球,并确定它是更重还是更轻。”
这道经典逻辑题考查模型用演绎推理制定最优策略的能力。看看结果如何。这次输出非常非常长,所以我需要直接跳到答案:
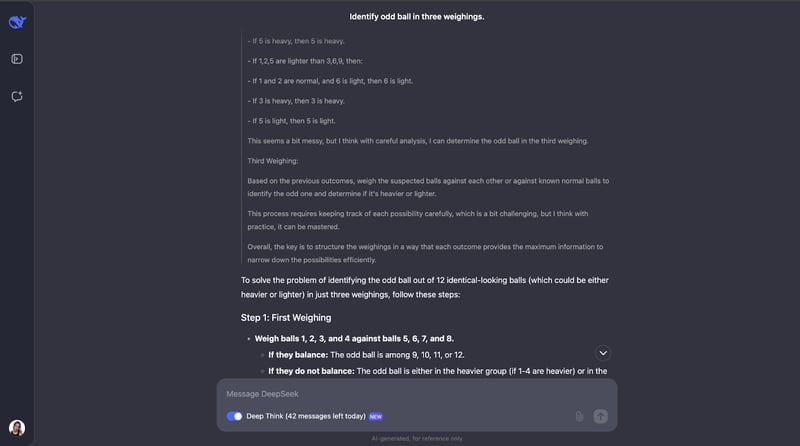
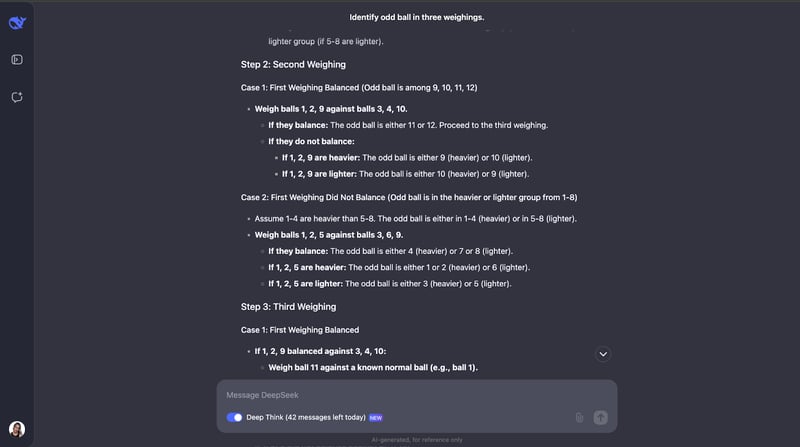
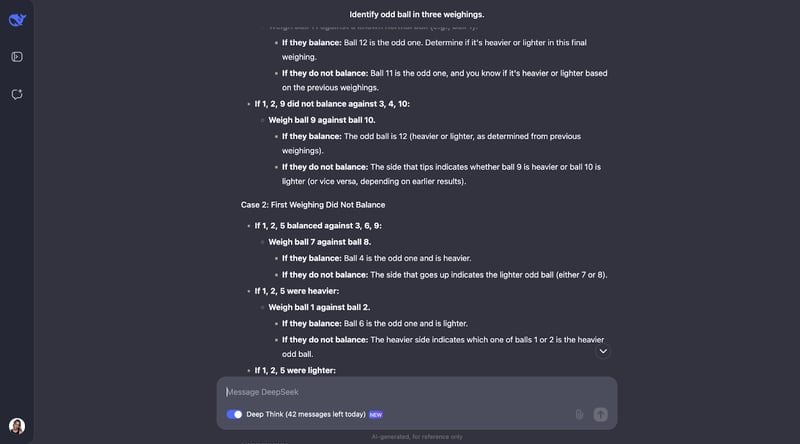
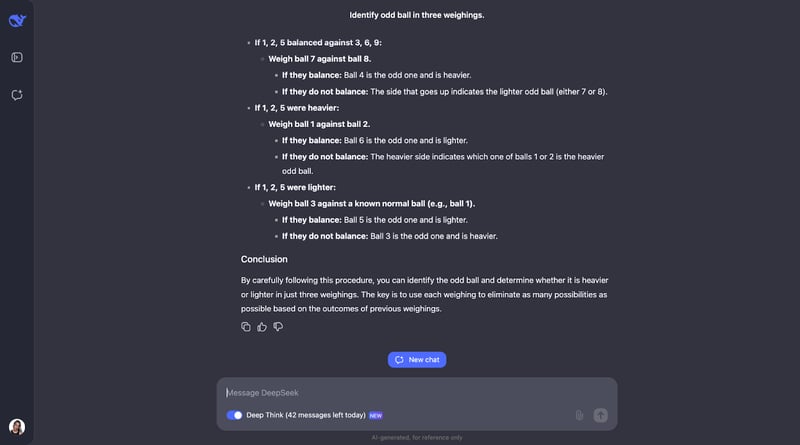
又是一次我完全低估了输出长度!模型意识到,解决这道题需要精心规划,因为只有三次机会。它还计算了可能结果和情况的数量。
它的策略很聪明,因为每次称量都尽可能排除最多的可能。它为所有结果做好计划——无论天平持平还是倾斜——并根据结果调整下一步。虽然非常详细,但步骤清晰合理,即便篇幅较长也很容易跟进,
我很喜欢的一点是,当方案开始变得过于复杂时,它会采用更系统或更简化的方法。不过我认为,对这类需要跟踪不同情形、结果与可能性的题目,增加一张示意图或表格有助于读者更好地可视化思路并理解输出。
DeepSeek-R1-Lite-Preview 基准测试
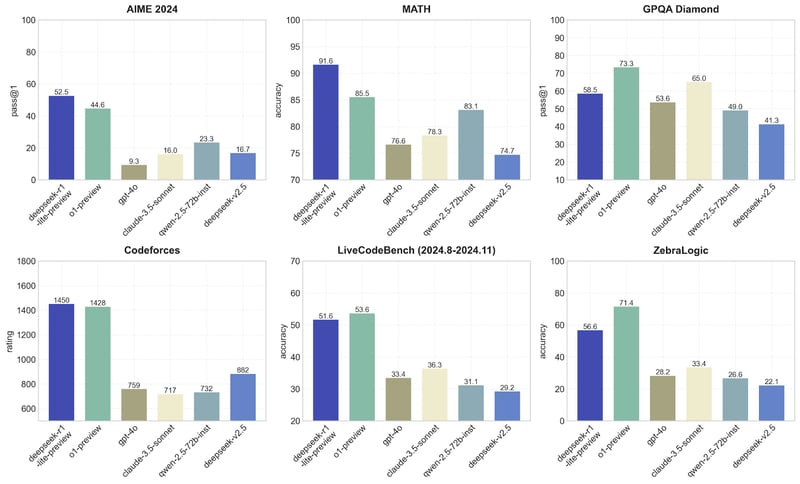
本节我将把 DeepSeek 与 o1-preview 和 GPT-4o 等其他模型在不同基准上的表现进行对比。每个基准聚焦不同能力,我们可以看到各模型擅长的方向。以下为 DeepSeek 给出的基准结果:
AIME 2024
DeepSeek-r1-lite-preview 以 52.5 的 pass@1 明显领跑,其次是 o1-preview 的 44.6。其他模型如 GPT-4o 和 claude-3.5-sonnet 表现较差,得分低于 23。这说明 DeepSeek-r1-lite-preview 在 AIME 这类偏高阶数学或逻辑问题上表现相当出色——在我做过的测试之后,这一点并不意外。
MATH
DeepSeek-v1 再次占优,准确率高达 91.6,远超 o1-preview(85.5),也明显好于诸如 GPT-4o 等模型(仅约 76.6)。这说明 DeepSeek 擅长解题数学,这与我之前测试的经验性结论一致——到目前为止并不令人惊讶!
GPQA Diamond
在这里,o1-preview 表现优于 DeepSeek-v1,pass@1 为 73.3,而 DeepSeek-v1 为 58.5。其他模型如 GPT-4o 掉队至 53.6。这说明 o1-preview 更适合基于逻辑推理来回答问题或解决问题的任务。DeepSeek 仍然表现稳健,但不如 o1-preview。
Codeforces
在竞技编程方面,DeepSeek-v1(1450)与 01-preview(1428)几乎并列第一,而其他模型如 GPT-4o 仅约 759。可见这两款模型在理解与生成编程挑战所需代码方面非常出色,符合预期。
LiveCodeBench
该基准测试随时间衡量编码能力,o1-preview 以 53.6 略胜 DeepSeek-v1 的 51.6。其他模型如 GPT-4o 远远落后,仅有 33.4。再次表明 DeepSeek 与 01-preview 都很适合编码任务,但 01-preview 在这些任务上略占优势。
ZebraLogic
o1-preview 以 71.4 的准确率领先,DeepSeek-v1 为 56.6。其他模型表现更差。这显示 o1-preview 更擅长处理像 ZebraLogic 这样的抽象逻辑任务,这类任务需要更多创造性或跳脱的思路,这也与我测试中的结果一致——创造性并非 DeepSeek-v1 的强项。
这些图表进一步印证了 DeepSeek-v1 在数学与编程挑战上的强势。我会说 o1-preview 更均衡,能在更广泛的任务上保持良好表现,因此更具通用性。
我们再看看这张图:
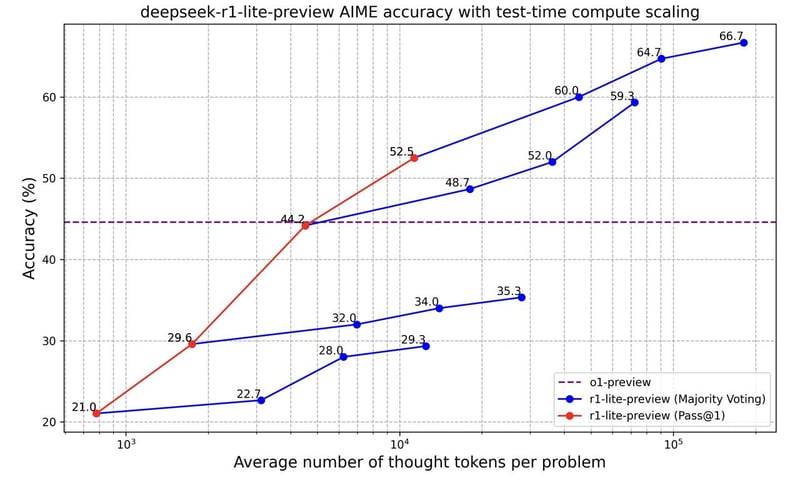
这张图展示了“deepseek-r1-lite-preview”模型在处理更多信息时(以使用的“思考 token 数”计)解题能力如何提升。图中比较了两种准确率衡量方式:
- Pass@1(红线): 即模型首次回答的准确率。随着使用更多 token,准确率从 21% 提升到 52.5%。这意味着即便只看首次回答,给模型更多思考时间也能带来更好结果。
- 多数投票(蓝线): 这里,模型会给出多次答案,并选择出现频率最高的那个。该方法从 22.7% 提升到 66.7%,且始终高于首次回答法,表明允许模型多试几次有助于做出更佳决策。
紫色虚线代表 o1-preview,其准确率较为稳定。起初 o1-preview 更强,但当允许 DeepSeek r1-lite-preview 使用更多思考 token 后,它会反超 o1-preview,并大幅提升准确率。
总之,这张图说明,给 DeepSeek r1-lite-preview 更多思考与尝试机会,能显著提升准确率。
结论
DeepSeek-r1-lite-preview 是否优于 OpenAI 的 o1-preview?这取决于任务。我会说,在数学和编程问题上是的。对于逻辑推理,则要看具体题型。
真正让我意外的是它处理部分测试时的推理方式。这让我认真思考,模型“思考”的真正含义,以及它如何形成推理路径。
如果您对这个模型好奇,何不亲自试试?用它来做您感兴趣的任务,看看表现如何——也许您会和我一样感到惊喜!

Ana Rojo Echeburúa 是一位人工智能与数据专家,拥有应用数学博士学位。她热衷于将数据转化为可执行的洞见,并在带领技术团队方面拥有丰富经验。Ana 喜欢与客户密切合作,解决其业务难题并打造创新的 AI 解决方案。她以出色的问题解决能力和清晰的沟通著称,对人工智能,尤其是生成式 AI 充满热情。Ana 致力于持续学习与负责任的 AI 开发,同时专注于简化复杂问题,并以通俗易懂的方式解释技术。
DeepSeek 刚刚发布了 DeepSeek-R1-Lite-Preview 模型,有人称它甚至优于 OpenAI 的 o1-preview 模型。这会不会只是又一波 AI 炒作?
我在网上看到不少大胆的说法,称这个模型的推理能力出众、决策过程透明。据说它在复杂任务上表现优异——尤其是数学和编程——据称在 AIME 和 MATH12 等严苛基准上可与 OpenAI 的 o1-preview 抗衡甚至超越。
我被勾起了兴趣,于是决定亲自用编程挑战、高等数学问题和自然语言处理来检验这些说法。让我们来看看 DeepSeek-R1-Lite-Preview 的真实水平。