
कोर्स
LangChain के साथ Retrieval Augmented Generation (RAG)
3 घंटा
20.9K
DeepSeek-R1-Lite-Preview एक AI टूल है, जो ChatGPT जैसा है, और इसे चीनी कंपनी DeepSeek ने बनाया है। कंपनी ने इस नए मॉडल की घोषणा X पर 20 नवंबर को की (ट्वीट लिंक) और एक दस्तावेज़ पेज पर कुछ विवरण साझा किए।
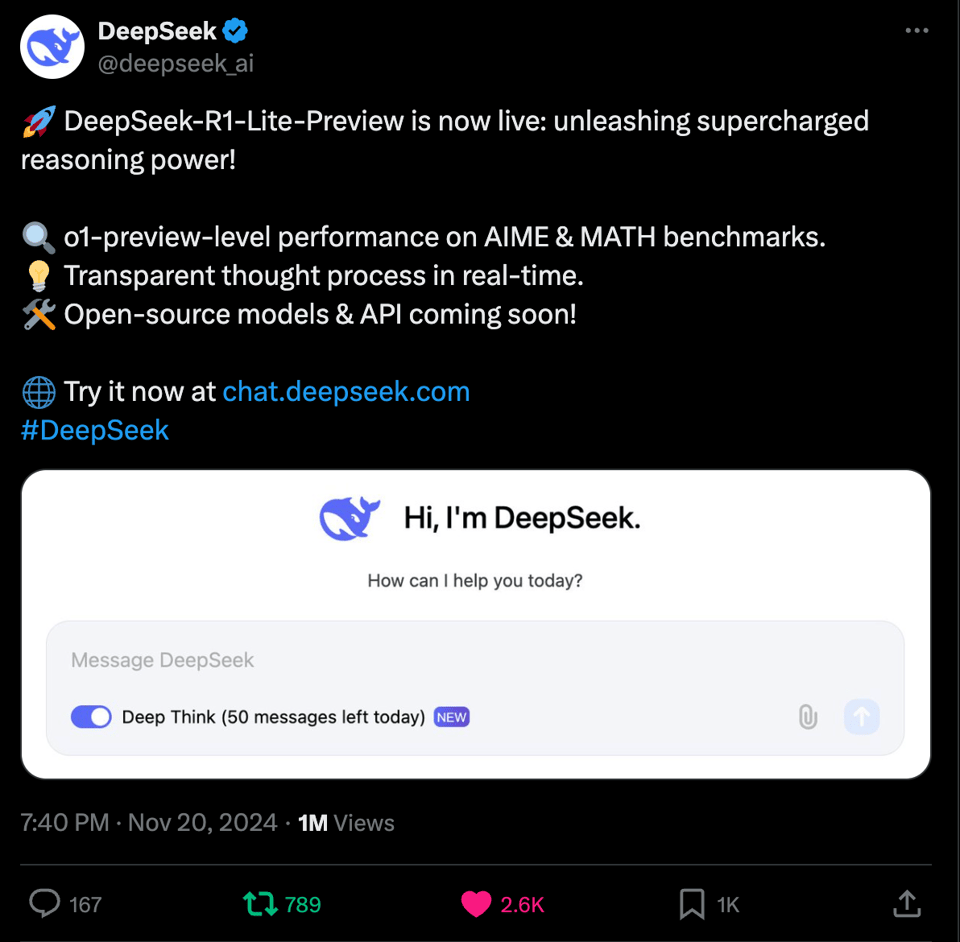
DeepSeek-R1-Lite-Preview का उद्देश्य गणित, कोडिंग और तर्क में जटिल समस्याओं को हल करने में बेहतरीन होना है। यह कदम-दर-कदम दिखाता है कि वह कैसे सोचता है ताकि आप समझ सकें कि वह उत्तर तक कैसे पहुंचा, जिससे भरोसा बढ़ता है।
आप इसे उनकी वेबसाइट chat.deepseek.com पर मुफ्त में आज़मा सकते हैं, लेकिन उसके उन्नत मोड “Deep Think” में आप प्रतिदिन 50 संदेशों तक सीमित हैं। DeepSeek इस टूल के कुछ हिस्से सार्वजनिक रूप से साझा करने की भी योजना बना रहा है ताकि अन्य लोग इसे उपयोग या इस पर निर्माण कर सकें।
आप इन दो चरणों का पालन करके DeepSeek-R1-Lite-Preview का उपयोग शुरू कर सकते हैं:
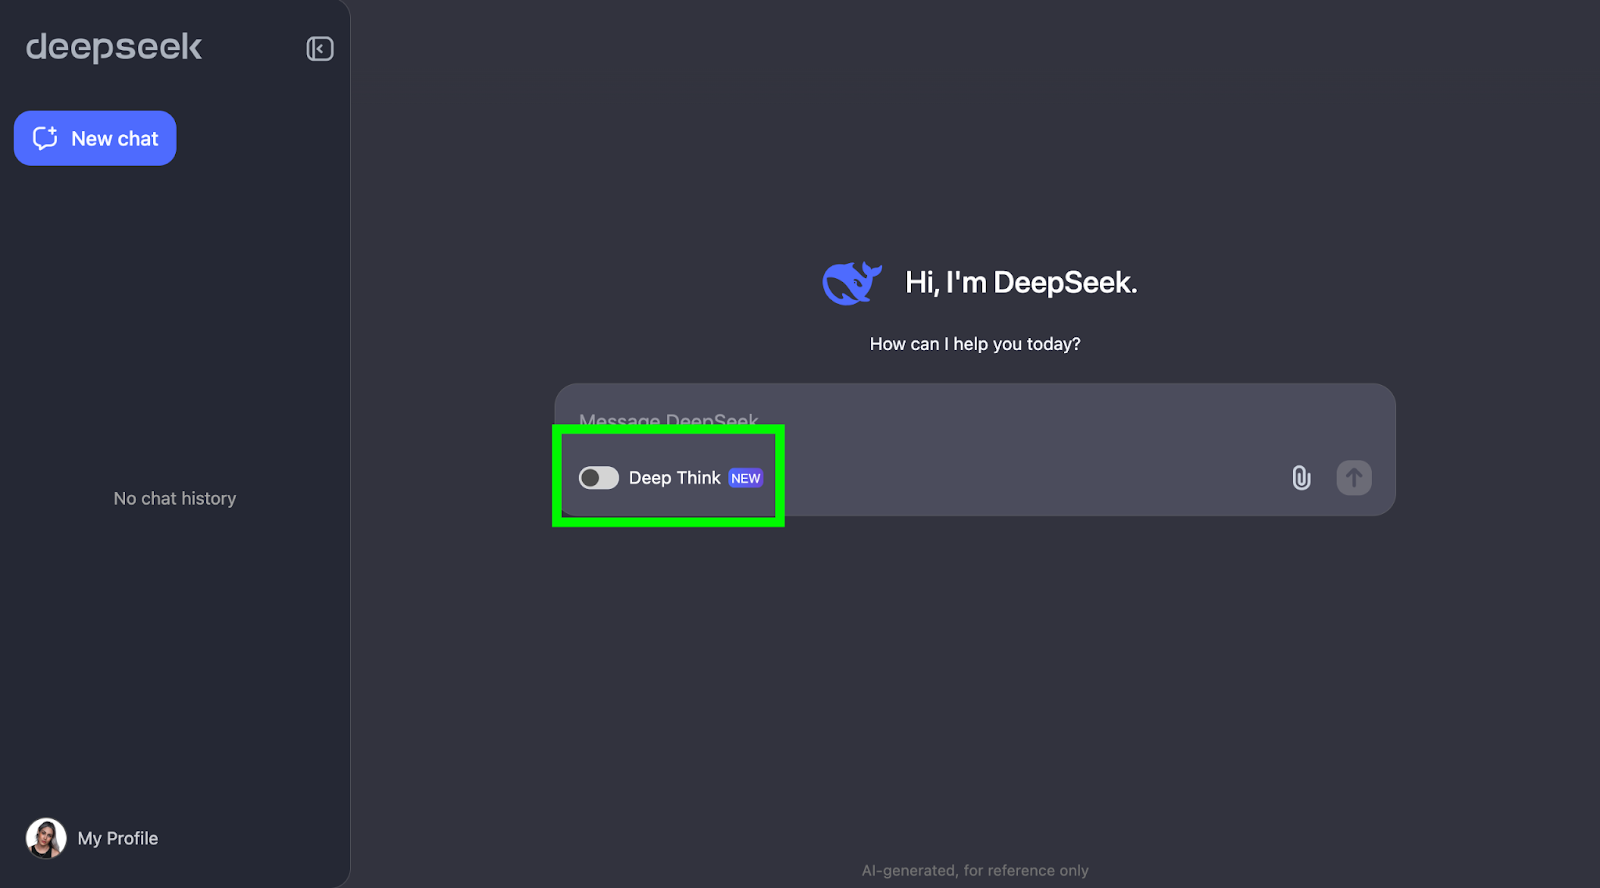
यह देखने के लिए कि DeepSeek-R1-Lite-Preview क्या कर सकता है, चलिए इसे परखते हैं! मैं इसकी तर्क क्षमता दिखाने वाली चुनौतियों की एक श्रृंखला से गुजरूंगा, शुरुआत करते हैं उस सरल पर मशहूर स्ट्रॉबेरी प्रश्न से: 'strawberry' में अक्षर “r” कितनी बार आता है?
यह प्रश्न आसान लगता है, लेकिन LLMs (यहां तक कि GPT-4o भी) इसे सही जवाब देने में पारंपरिक रूप से जूझते रहे हैं—वे आम तौर पर जवाब देते हैं कि अक्षर “r” केवल दो बार आता है।
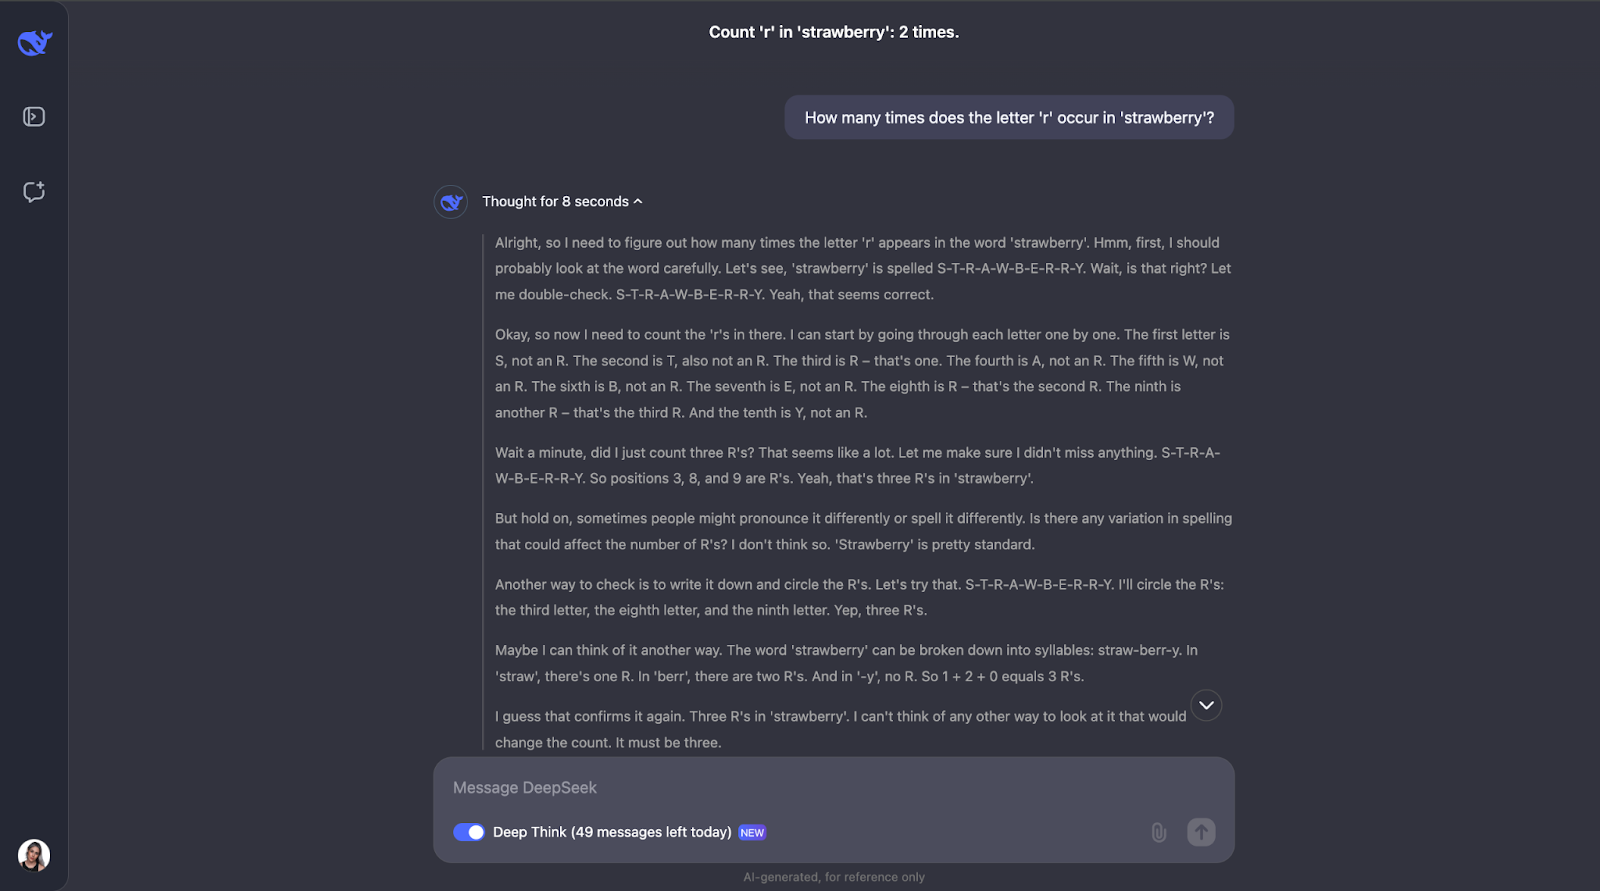
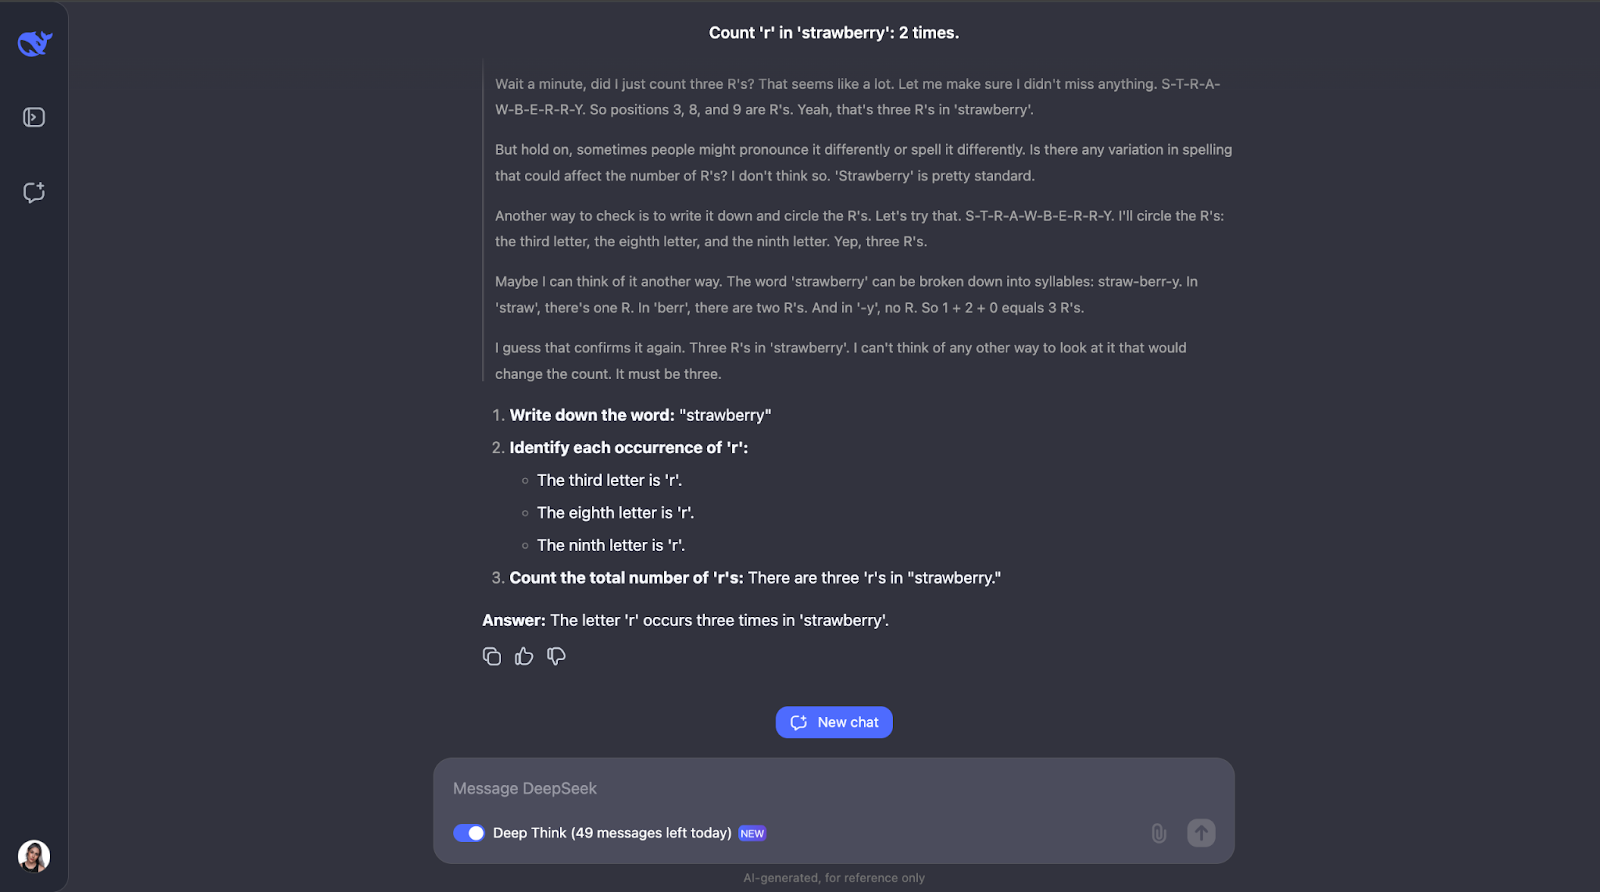
वाह, ठीक है – मैंने इतनी सीधी लगने वाली समस्या के लिए इतनी लंबी तर्क-प्रक्रिया की उम्मीद नहीं की थी। मुझे लगा था कि 'r' की गिनती कर और शब्द में उसकी स्थिति पहचानने के बाद यह रुक जाएगा। लेकिन दिलचस्प यह है कि यह वहीं नहीं रुका। इसने दो-तीन बार गिनती को दोबारा जाँचा और यहां तक कि यह भी विचार किया कि लोग शब्द का उच्चारण या वर्तनी अलग-अलग तरीके से कर सकते हैं – जो मुझे कुछ हद तक अनावश्यक लगा, खासकर उच्चारण वाला हिस्सा। पर यह जरूर दिखाता है कि यह कितना सतर्क और सोच-समझकर काम करता है! इसने हर कदम समझाया ताकि मैं इसकी सोच समझ सकूं और देख सकूं कि यह उत्तर तक कैसे पहुंचा।
मैं DeepSeek-R1-Lite-Preview को तीन गणित समस्याओं पर परखूंगा।
क्योंकि DeepSeek का दावा है कि वह गणितीय तर्क में बहुत अच्छा है, तो एक सरल ज्यामितीय समस्या से शुरुआत करते हैं।
"यदि किसी त्रिभुज की भुजाएँ 3, 4, और 5 हैं, तो उसका क्षेत्रफल क्या होगा?"
इस समस्या के लिए पाइथागोरस प्रमेय और हीरोन के सूत्र का ज्ञान आवश्यक है। मुझे उम्मीद है कि DeepSeek-R1-Lite-Preview अपने चरण दिखाएगा, शायद इस तरह:
देखते हैं क्या होता है!
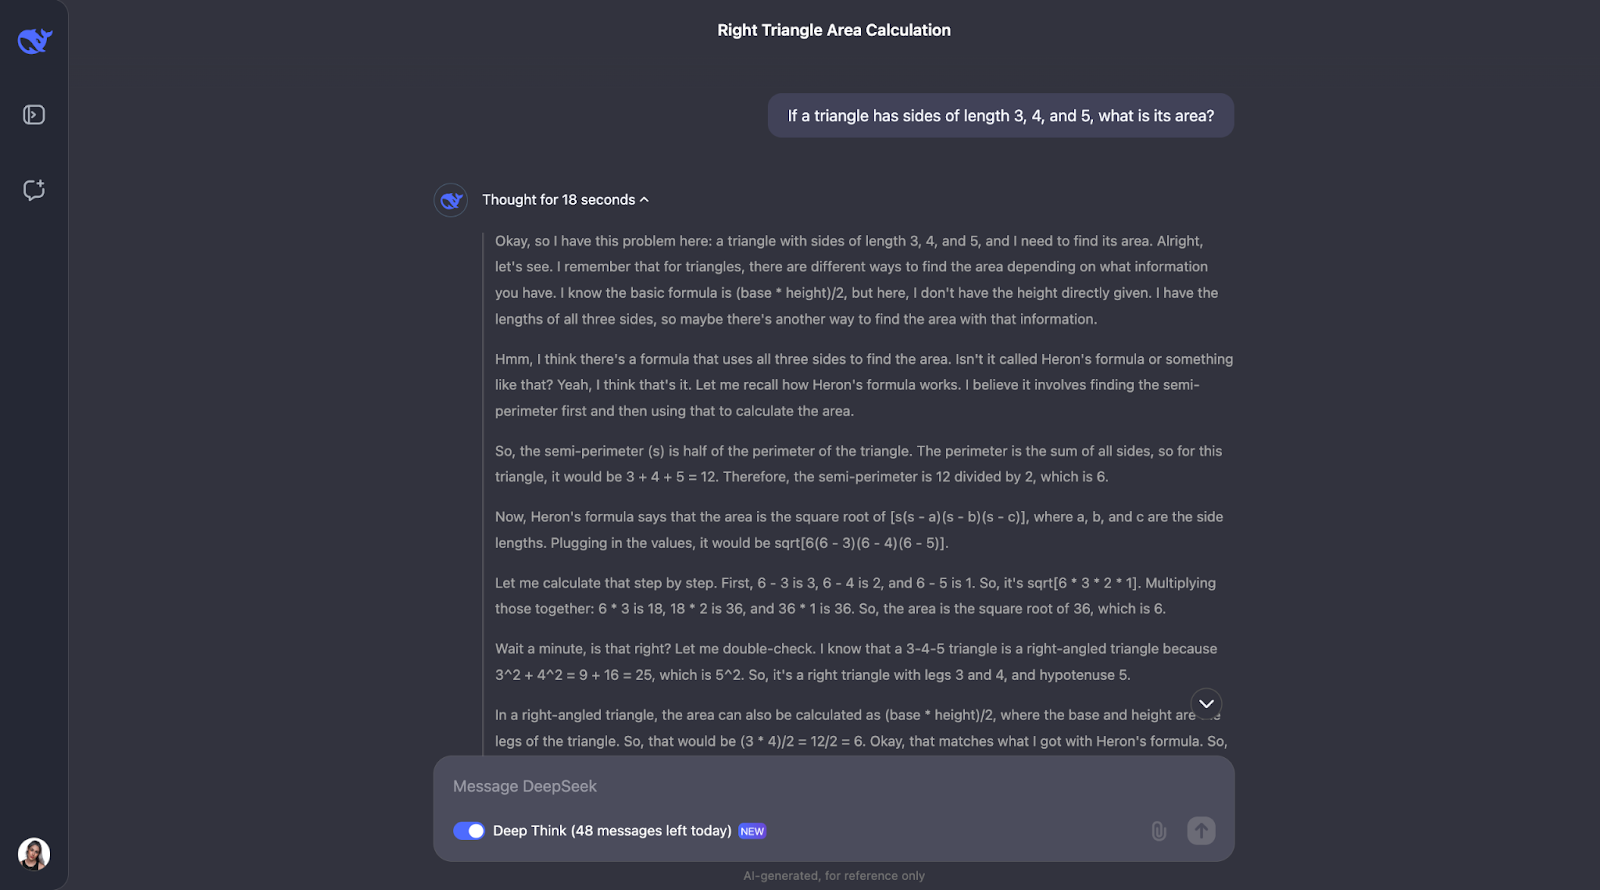
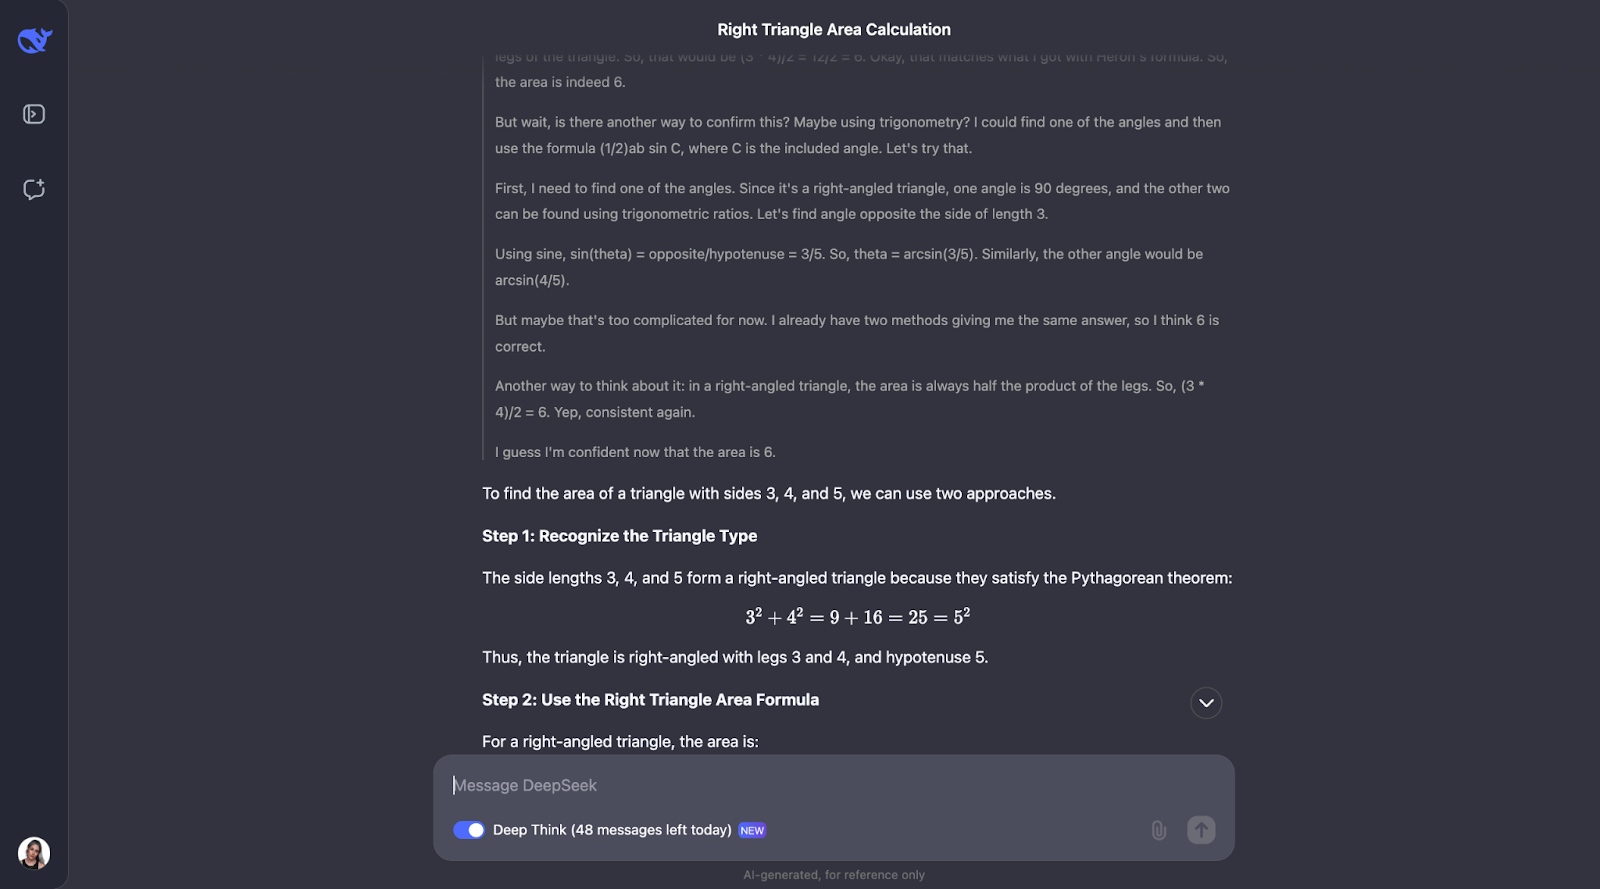
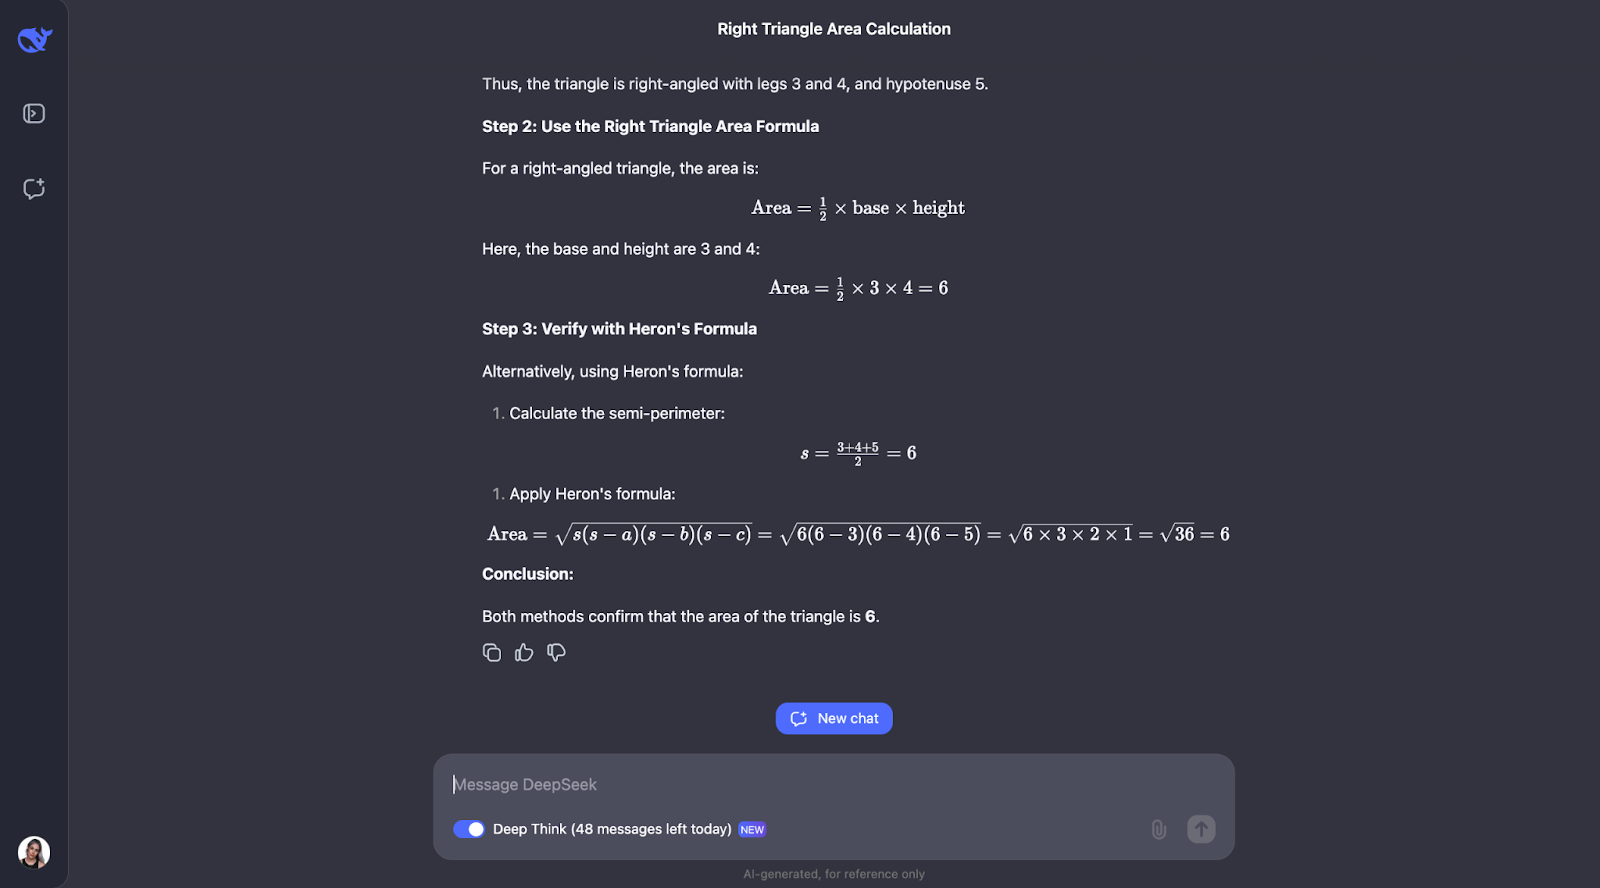
ठीक है, दिलचस्प रूप से, इसने वे जाँचें कीं जिनकी मैंने उम्मीद की थी—हालाँकि अलग क्रम में। इसने कोण निकालकर त्रिकोणमिति का उपयोग करने और दूसरा सूत्र आज़माने पर भी विचार किया। मुझे यह अच्छा लगा कि अंततः इसने तय किया कि इसकी ज़रूरत नहीं क्योंकि पहले दो तरीकों ने ही उत्तर की पुष्टि कर दी थी।
व्याख्या और परिणाम दोनों विशेष रूप से स्पष्ट और अनुसरण करने में आसान थे, जिससे मुझे लगता है कि यह मॉडल, उदाहरण के लिए, किसी गणित छात्र के सहायक में एम्बेड करने के लिए शानदार रहेगा। इस उपयोग-मामले में, शायद पहले सोच-प्रक्रिया दिखाई जा सकती है, और छात्र उससे संवाद कर यह बताए कि उसने समझा या नहीं, फिर अंतिम उत्तर पर आगे बढ़ा जाए।
अब एक अधिक जटिल गणित परीक्षण पर चलते हैं ताकि प्रदर्शन और सोच-प्रक्रिया में कोई अंतर दिखे तो समझ सकें।
“सिद्ध करें कि फिबोनाची संख्याओं के प्रतिलोमों का योग एक सीमित मान पर अभिसरित होता है।”
यह परीक्षा श्रृंखला-अभिसरण और फिबोनाची संख्याओं के गुणों जैसे उन्नत गणितीय सिद्धांतों की मॉडल की समझ को परखती है। चलिए इसे आज़माते हैं! पठनीयता के लिए, मैं केवल उत्तर के पहले और अंतिम हिस्से को पोस्ट करूंगा (लेकिन आप चाहें तो उसी प्रॉम्प्ट के साथ खुद भी आज़मा सकते हैं):
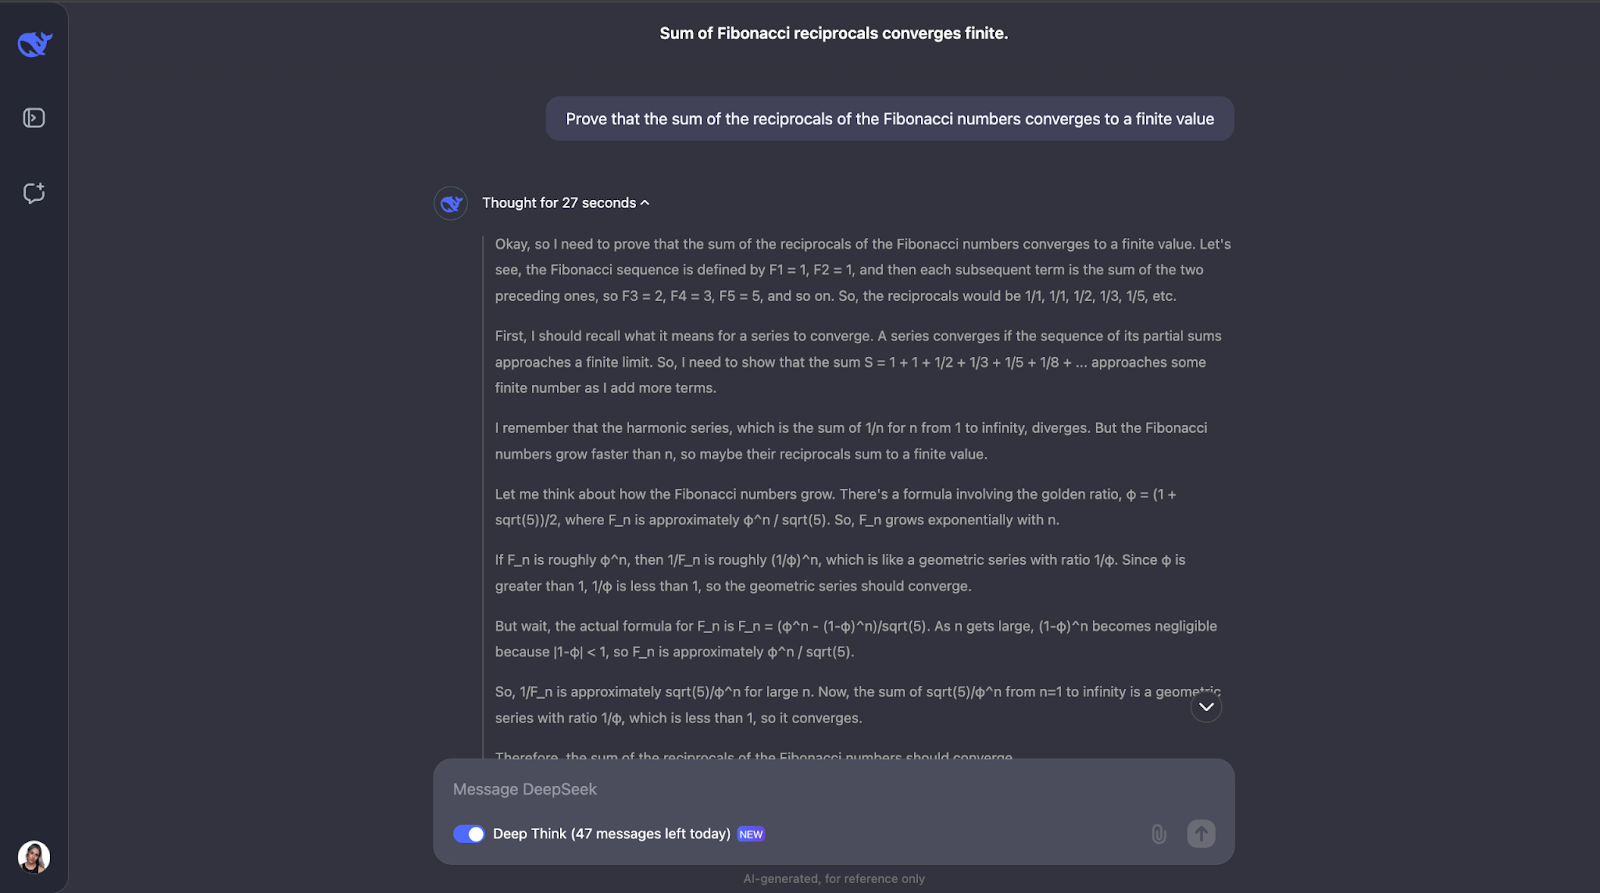
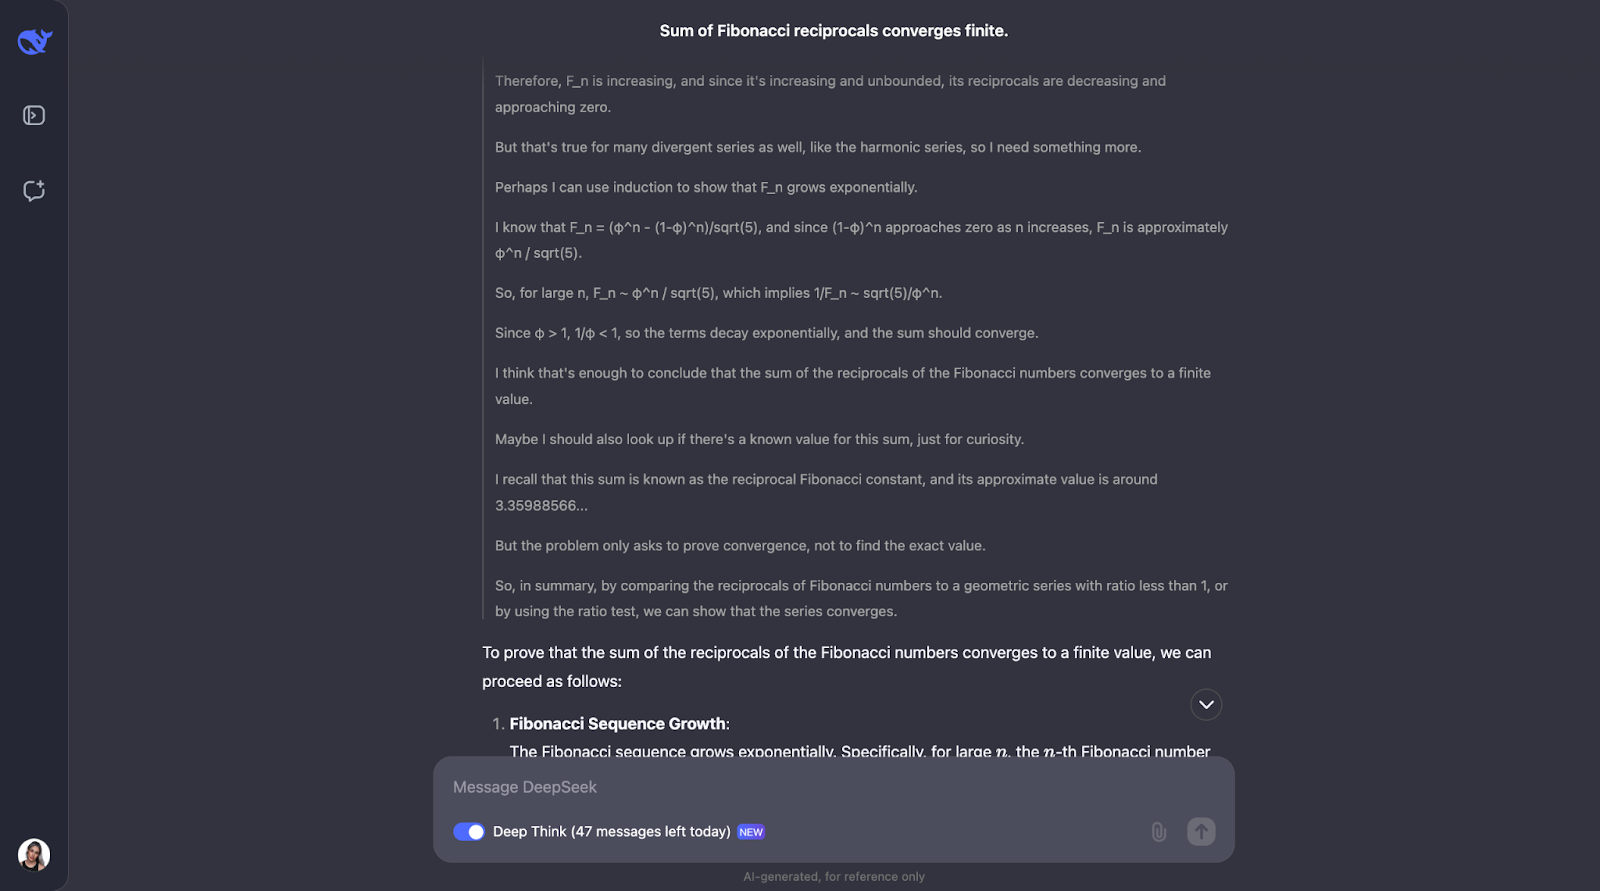
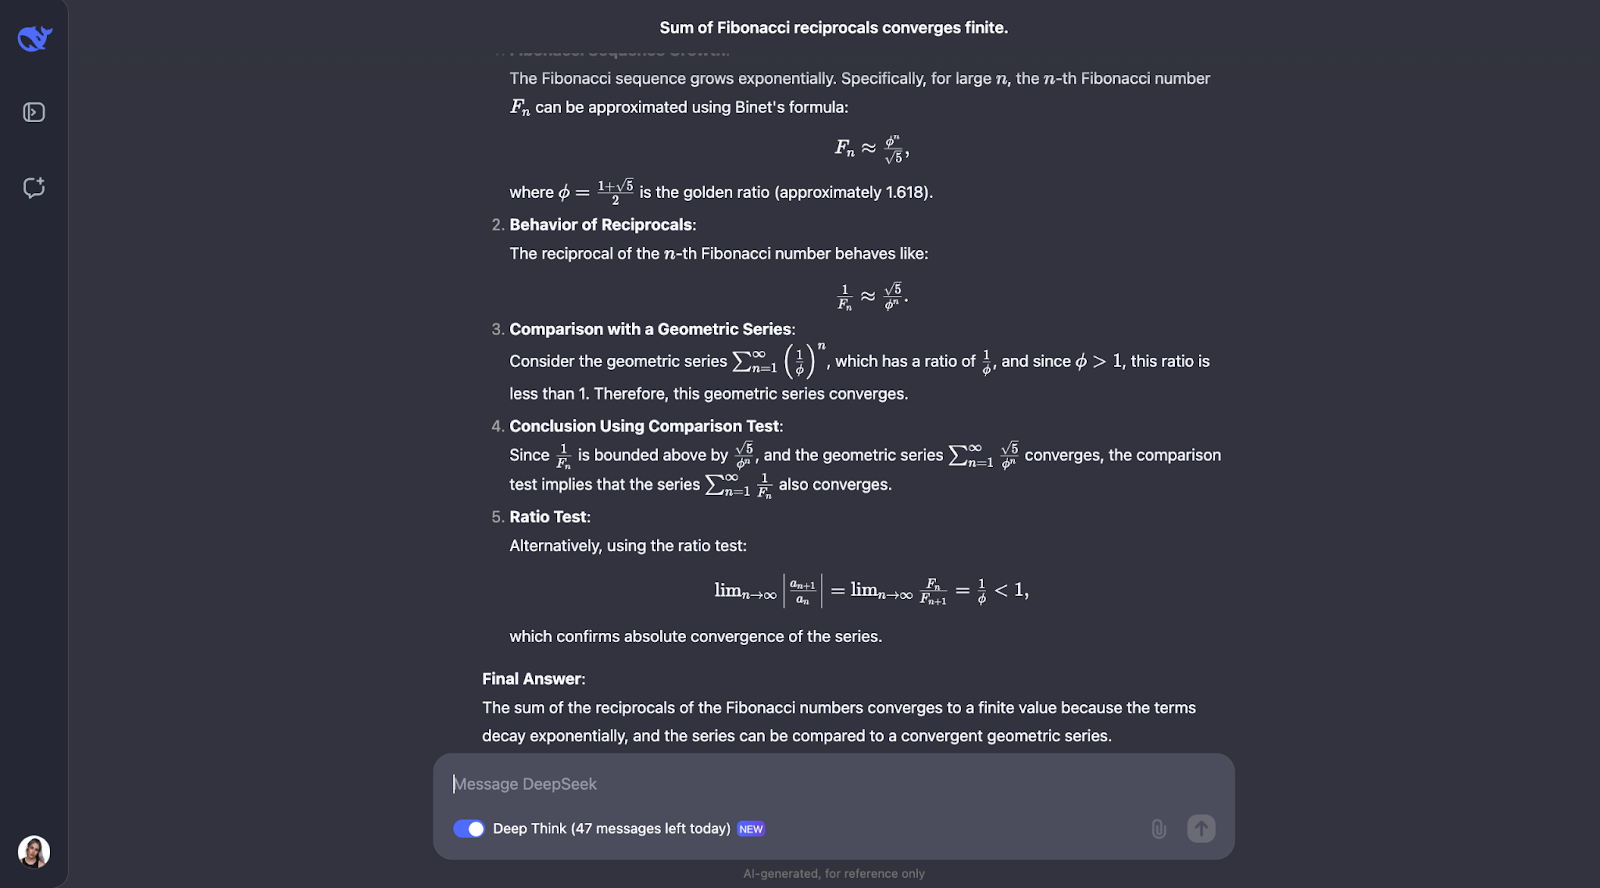
ठीक है, यह एक बढ़िया सोच-श्रृंखला है—मुझे यह बहुत पसंद आया कि इसने पहले सुनिश्चित किया कि वह प्रतिलोम और अभिसरण जैसे प्रमुख सिद्धांतों को समझता है। फिर DeepSeek-R1-Lite-Preview ने इस समस्या को फिबोनाची संख्याओं की वृद्धि देखकर और तुलना परीक्षण का उपयोग करके हल किया, जो यह जाँचने का एक सामान्य तरीका है कि कोई श्रेणी अभिसरित होती है या नहीं।
इसने फिबोनाची संख्याओं के प्रतिलोमों की तुलना एक गुणोत्तर श्रेणी से की। क्योंकि फिबोनाची के प्रतिलोम 1 से कम समान अनुपात वाली गुणोत्तर श्रेणी से भी तेज घटते हैं, मॉडल ने निष्कर्ष निकाला कि प्रतिलोमों का योग भी एक सीमित मान पर अभिसरित होता है। अतिरिक्त पक्का करने के लिए, इसने अनुपात परीक्षण भी लगाया।
यह परीक्षण देखता है कि क्रमागत पदों के अनुपात की सीमा 1 से कम है या नहीं। यदि है, तो श्रेणी अभिसरित होती है। मॉडल ने फिबोनाची के प्रतिलोमों के लिए यह अनुपात निकाला और पाया कि यह सचमुच 1 से कम है।
इसने यह भी उल्लेख किया कि इस योग का एक ज्ञात मान है जिसे reciprocal Fibonacci constant कहा जाता है, जो लगभग 3.3598 है। लेकिन इस समस्या के लिए हमें केवल यह जानना था कि योग सीमित है, सटीक मान नहीं—तो यह अतिरिक्त जानकारी थी जो मुझे भी रोचक लगी। मुझे आउटपुट में समाधान प्रस्तुत करने का तरीका बहुत पसंद आया। यह स्पष्ट है और क्रमबद्ध तरीके से दिया गया है।
अब तक, मैं गणितीय कार्यों से प्रभावित हूँ।
मैं अब डिफरेंशियल ज्यामिति की एक समस्या आज़माने जा रहा/रही हूँ—क्योंकि मेरा पीएचडी इसी क्षेत्र में है, तो मैं यह छोटा सा परीक्षण किए बिना नहीं रह सका/सकी। कुछ अधिक जटिल नहीं, बस एक क्लासिक अभ्यास जो आप स्नातक गणित में देख सकते हैं।
“R³ में एक सतह S पर विचार करें जिसका पैरामीट्रीकरण है
φ(u,v) = (u cos v, u sin v, ln u)
जहाँ u > 0 और 0 ≤ v < 2π।
a) S का प्रथम मौलिक रूप (first fundamental form) निकालें।
b) निर्धारित करें कि क्या S एक न्यूनतम सतह (minimal surface) है।
c) S का गॉस वक्रता K और माध्य वक्रता H निकालें।”
मुझे उम्मीद है कि DeepSeek-R1-Lite-Preview चरण-दर-चरण समाधान देगा, सभी गणनाएँ दिखाएगा और प्रत्येक परिणाम के महत्व के साथ-साथ प्रथम मौलिक रूप, न्यूनतम सतह, और विभिन्न वक्रताओं जैसे मुख्य सिद्धांतों की परिभाषाएँ भी समझाएगा।
इस ब्लॉग को पठनीय रखने के लिए, मैं उत्तर का केवल पहला और अंतिम भाग ही दिखा पाऊंगा/पाऊंगी, लेकिन मैं आपको प्रॉम्प्ट खुद आज़माने के लिए प्रोत्साहित करता/करती हूँ:
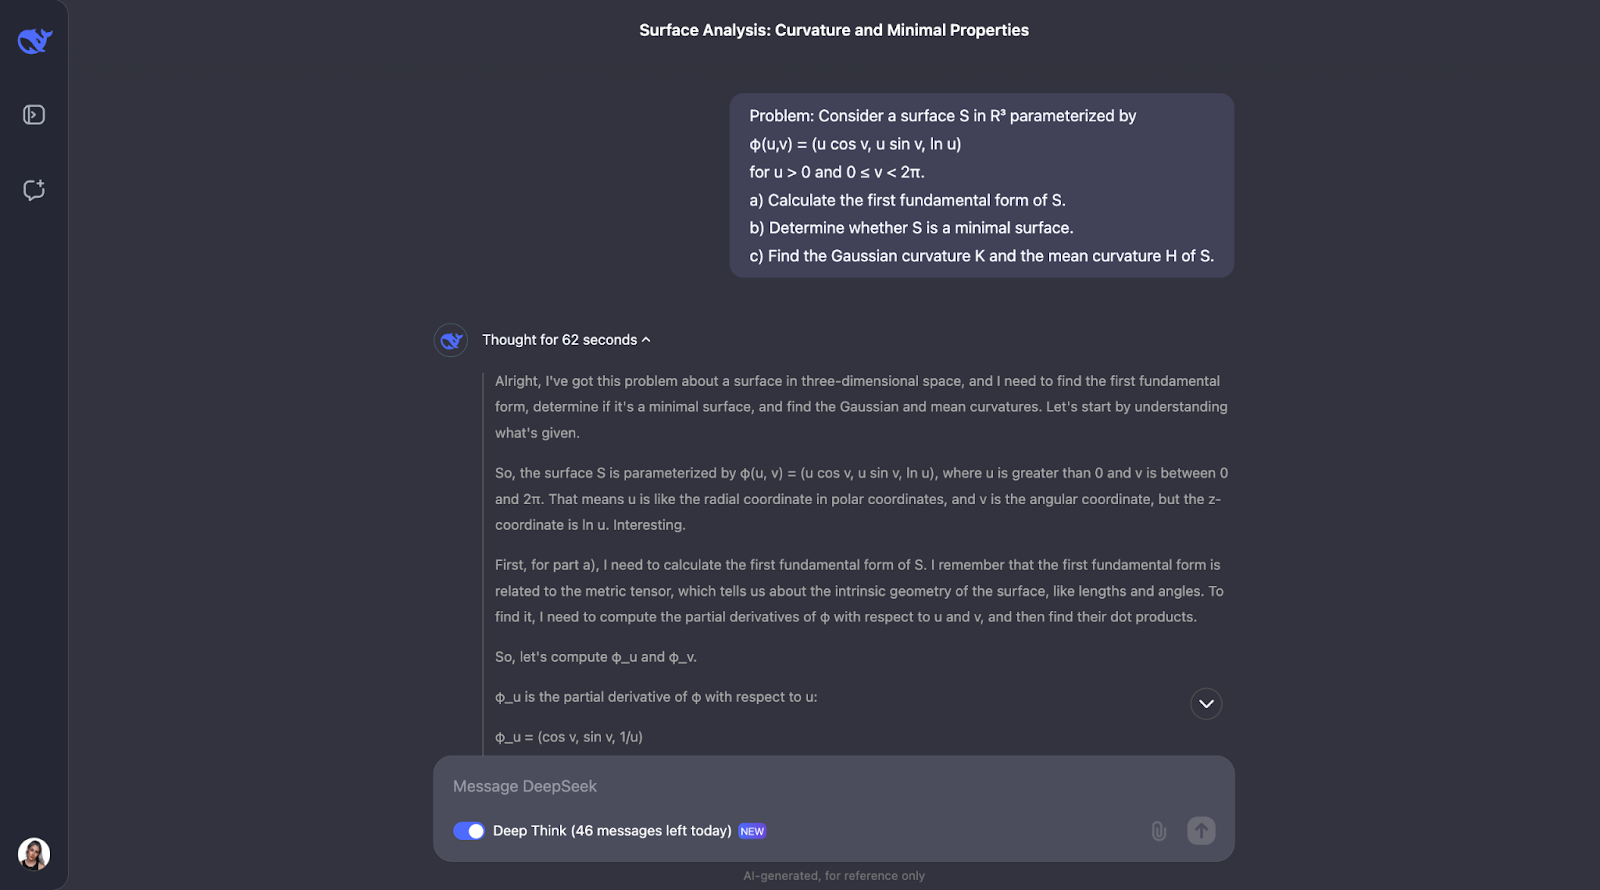
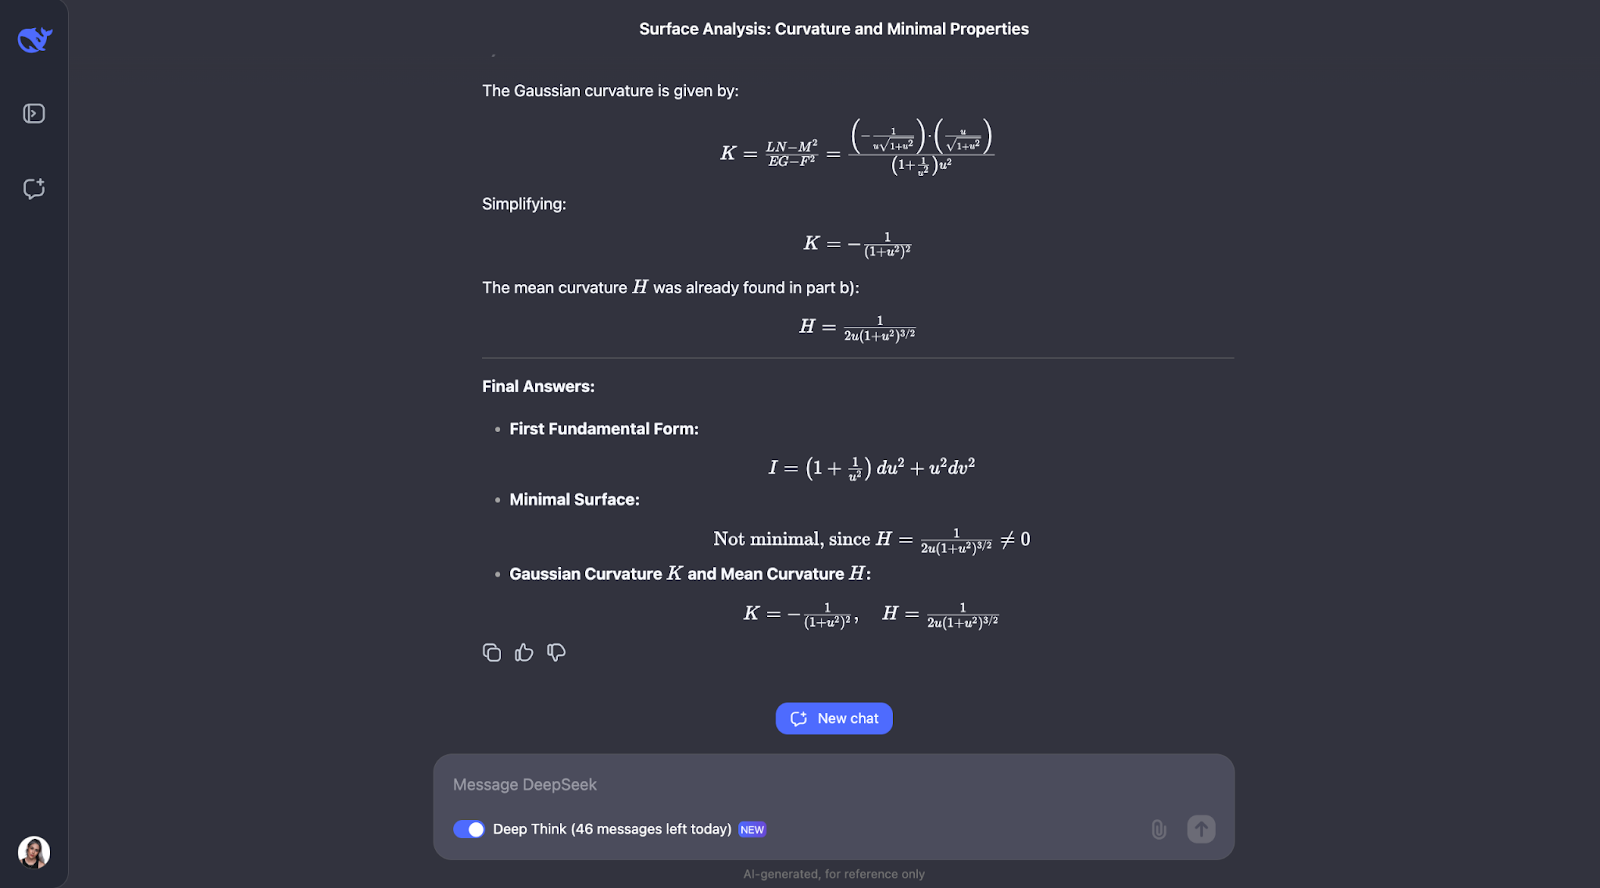
चरण-दर-चरण विधि सुप्रसिद्ध ज्यामितीय सूत्रों का सीधा उपयोग करती है, जिससे तर्क का अनुसरण करना आसान हो जाता है। हालांकि, मुझे उम्मीद थी कि यह समस्या में शामिल मुख्य अवधारणाओं के प्रति अपनी समझ की जाँच करेगा, जो सोच-श्रृंखला का हिस्सा नहीं था। भाग B के लिए, यह वैकल्पिक दृष्टिकोण अपनाता है और पहचानता है कि यह सतह घूर्णन की सतह (surface of revolution) है, जो अच्छी बात है।
एक जगह यह घूर्णन पर टिप्पणी करता है और समझता है कि उसके पास पहले से N, यानी नोर्मल वेक्टर, है, जो दूसरे मौलिक रूप के गुणांक के संकेतांकन से टकरा सकता है। मैं बेहतर संकेतांकन का सुझाव देखना पसंद करता/करती, क्योंकि एक ही अक्षर का दो चीज़ों के लिए उपयोग करना अच्छी प्रथा नहीं है!
जब यह माध्य वक्रता निकालता है, तो नोटिस करता है कि यह शून्य नहीं है और पूछताछ करता है कि कहीं गणना गलत तो नहीं। पूरी तरह सुनिश्चित होने के लिए, यह अपना काम दोबारा जाँचने को दूसरा तरीका आज़माता है।
फिर से, आउटपुट बहुत स्पष्ट और अनुसरण करने में आसान है। इन सभी उदाहरणों में, यह प्रभावशाली रहा है कि यह अलग-अलग तरीकों से लगातार गणनाओं को दोबारा जाँचता है। सोच-प्रक्रिया हमेशा विस्तृत, तार्किक और समझने में आसान रहती है!
अब कोडिंग परीक्षणों पर चलते हैं।
पहला परीक्षण होगा:
“Python में एक फ़ंक्शन लागू करें जो दिए गए स्ट्रिंग में सबसे लंबा palindromic substring खोजे। फ़ंक्शन की समय जटिलता O(n^3) से बेहतर होनी चाहिए.”
मैं मॉडल की सक्षम एल्गोरिथ्म-डिज़ाइन और उसे कोड में लागू करने की क्षमता का आकलन करना चाहता/चाहती हूँ। मुझे डायनेमिक प्रोग्रामिंग या Manacher के एल्गोरिथ्म का उपयोग करते हुए समाधान की उम्मीद है, जिसमें दृष्टिकोण की स्पष्ट व्याख्या और समय जटिलता का विश्लेषण शामिल हो।
आउटपुट बहुत-बहुत लंबा था, और मैं केवल पहले और अंतिम हिस्से दिखा रहा/रही हूँ:
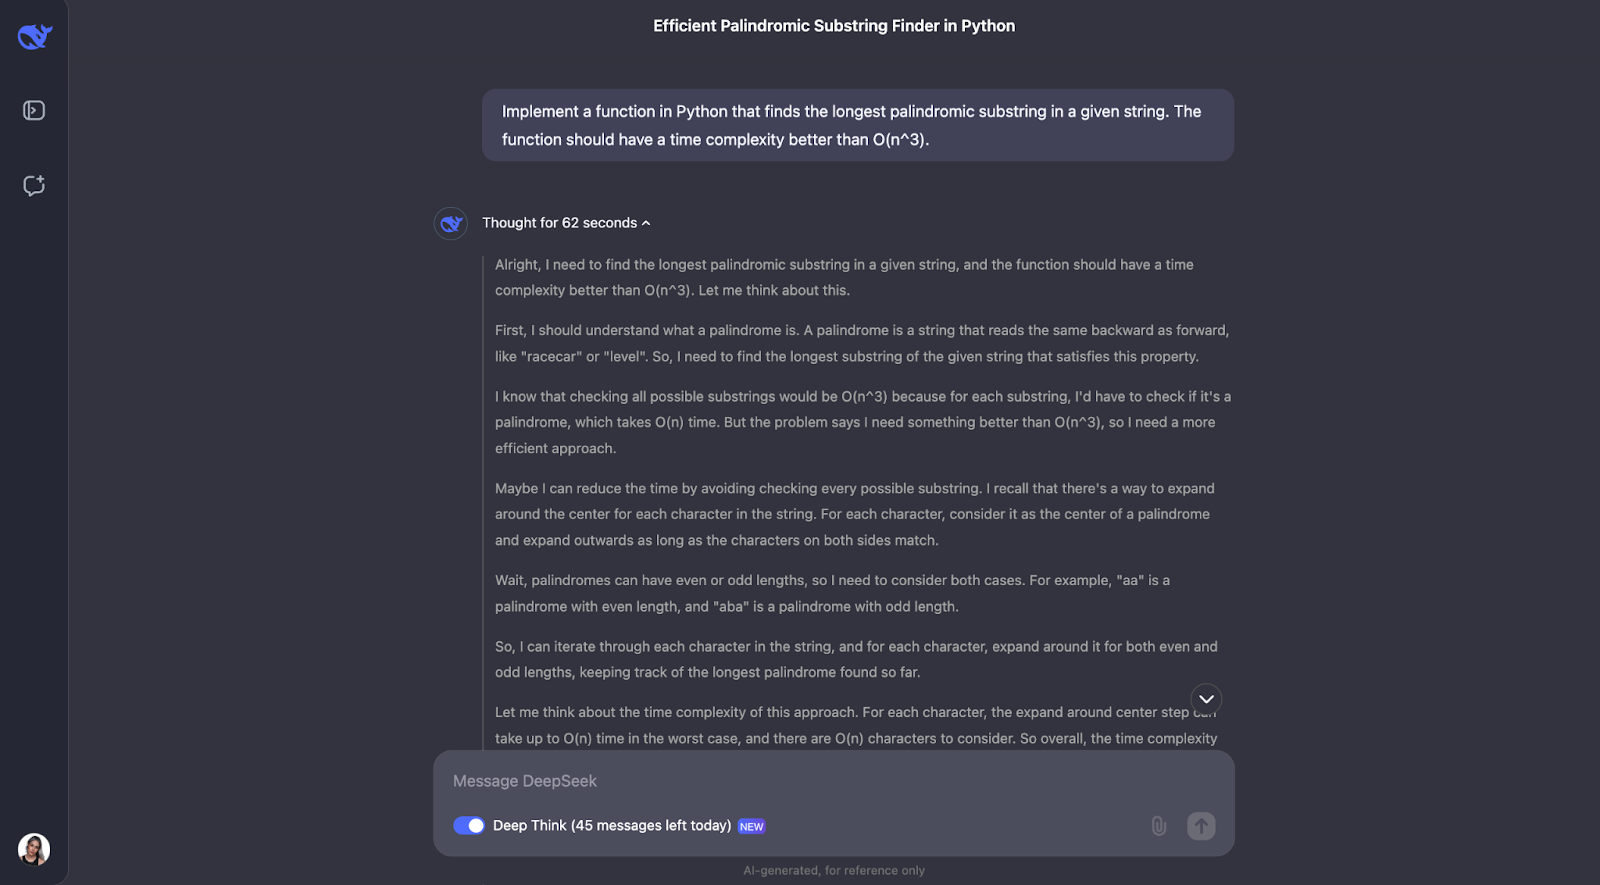
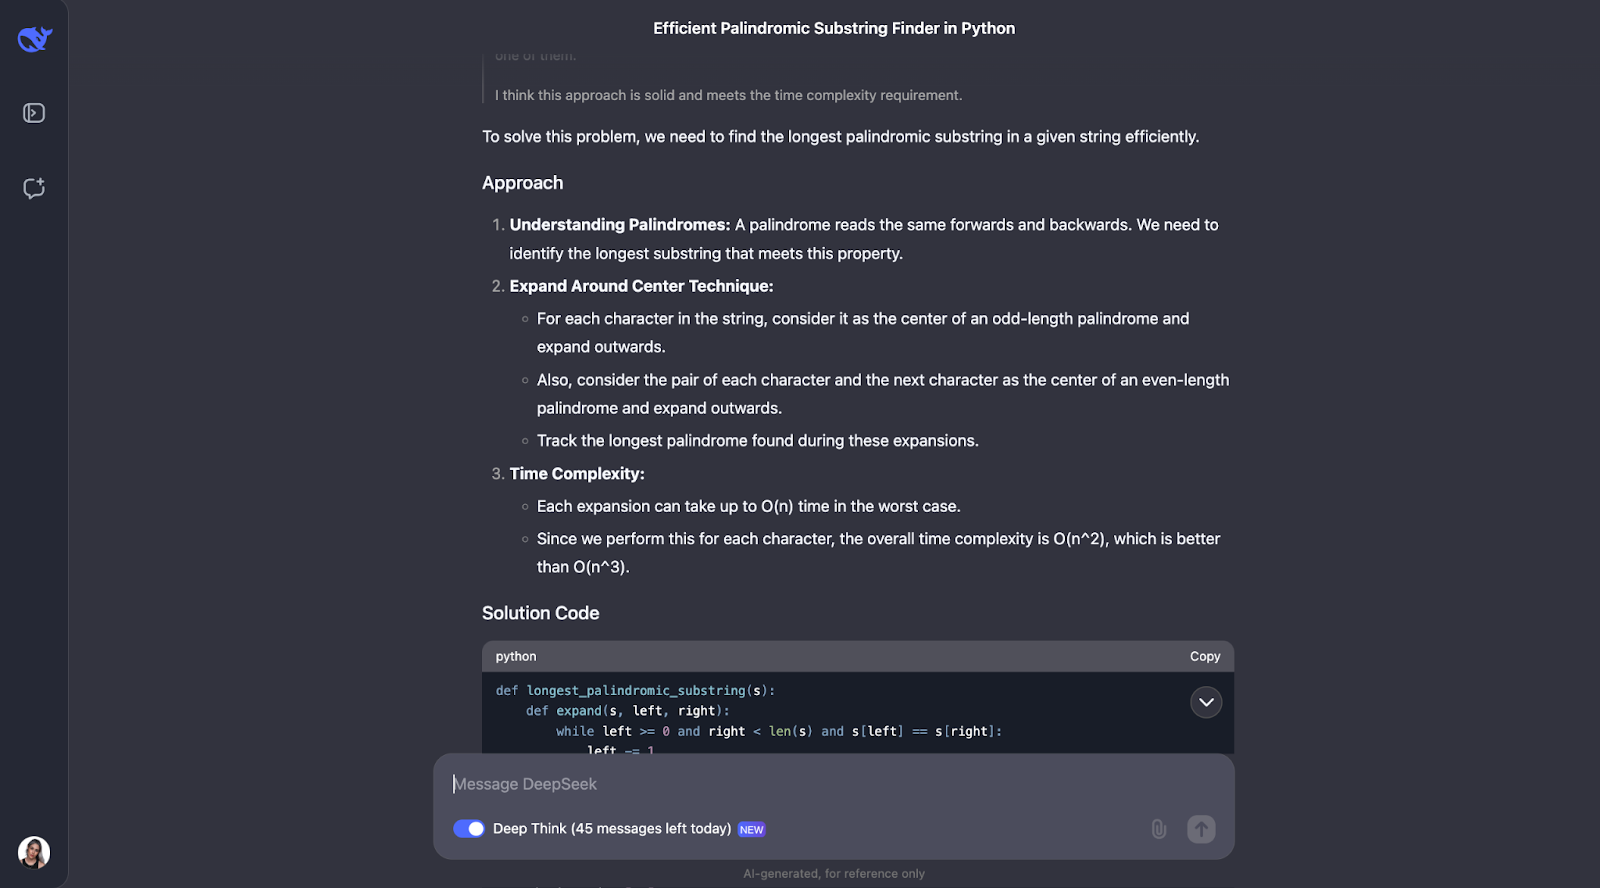
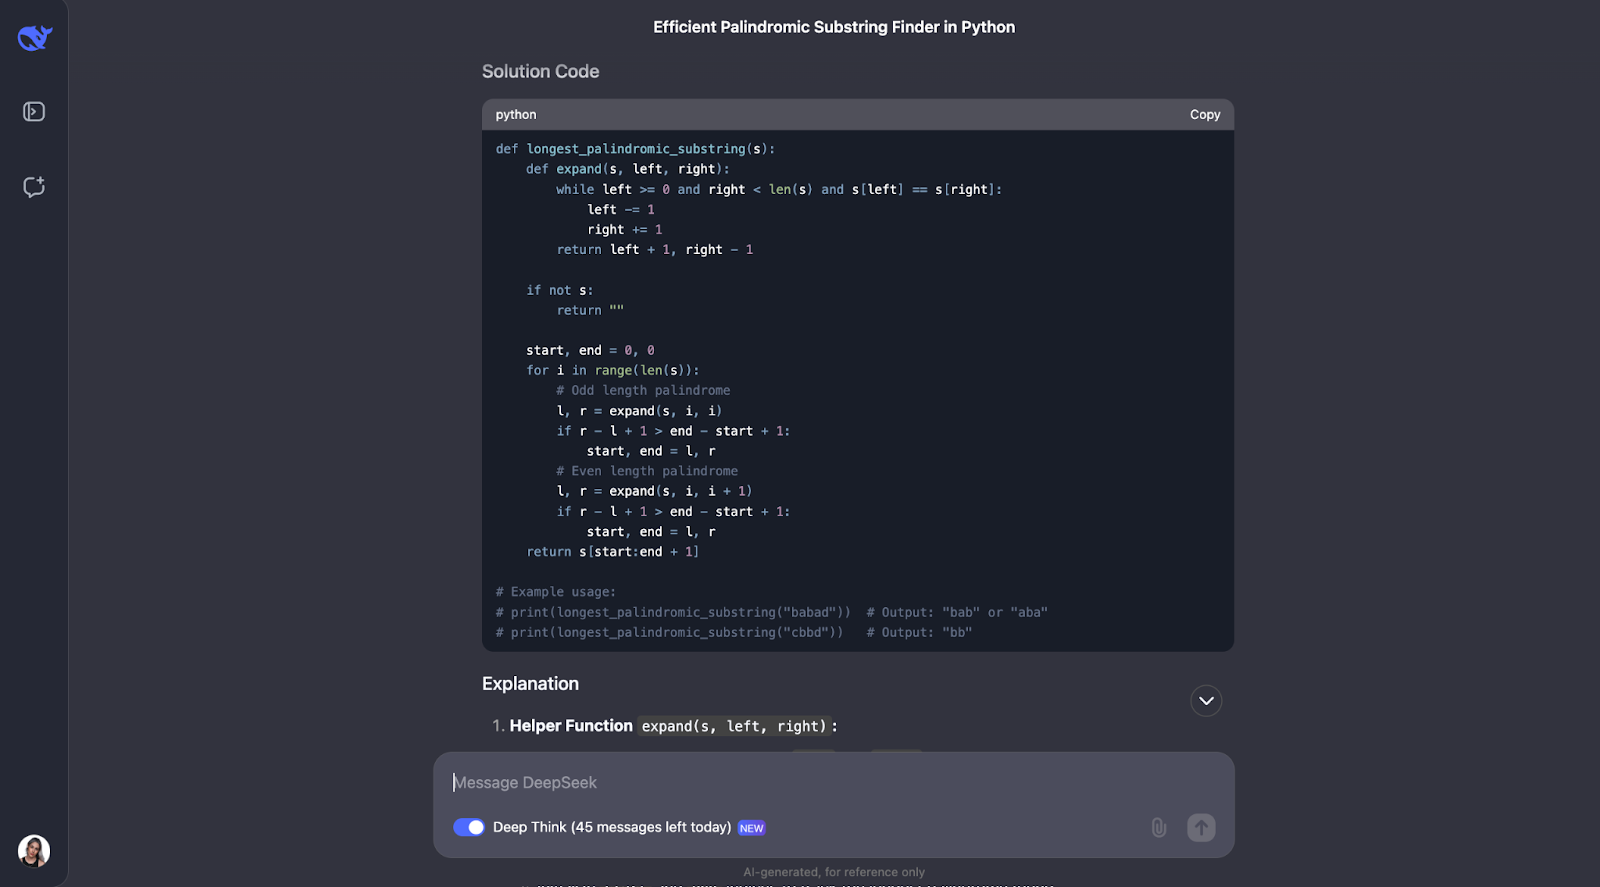
मुझे लगता है कि मॉडल ने सबसे लंबा palindromic substring खोजने की समस्या बहुत अच्छे से हल की। इसका दृष्टिकोण स्मार्ट, कुशल और स्पष्ट रूप से समझाया गया था।
हर संभावित substring को brute-force करने के बजाय, जो धीमा होता, इसने चतुर “केंद्र के आसपास फैलाएँ” तकनीक का उपयोग किया। यह तरीका विषम लंबाई के palindrome जैसे "aba" और सम लंबाई वाले जैसे "abba" दोनों को संभालता है। यह चलते-चलते सबसे लंबे palindrome का ट्रैक रखता है। परिणाम O(n^2) समय में चलने वाला एल्गोरिथ्म था, जो O(n^3) समाधान से कहीं तेज है।
इस उत्तर में जो बात मुझे सबसे ज्यादा प्रभावित करती है, वह है प्रस्तुति की स्पष्टता। DeepSeek ने समस्या को समझने योग्य चरणों में तोड़ा, अपनी सोच को विस्तार से समझाया, और व्यावहारिक उदाहरण भी दिए। उदाहरण के लिए, इसने दिखाया कि एल्गोरिथ्म "racecar" या "abba" के केंद्र के आसपास कैसे फैलता है ताकि सही palindrome मिल सके। केंद्र के आसपास फैलने वाले सहायक फ़ंक्शन ने कोड को मॉड्यूलर और अनुसरण करने में आसान बना दिया—यह मुझे खास तौर पर अच्छा लगा।
फिर भी, मैं उम्मीद करता/करती कि यह Manacher के एल्गोरिथ्म पर भी विचार करता, जो O(n) का तेज़ समाधान है। इसे लागू करना निश्चित रूप से अधिक जटिल है, लेकिन जब प्रदर्शन अहम हो, तब उपयोगी है, और मुझे उम्मीद थी कि मॉडल कम से कम इसका उल्लेख करेगा।
मैंने यह भी नोटिस किया कि आउटपुट ने स्पष्ट रूप से यह नहीं बताया कि एल्गोरिथ्म विशेष मामलों को कैसे संभालता है, जैसे खाली स्ट्रिंग या सभी समान वर्णों वाली स्ट्रिंग (जैसे, "aaaa")। ये मामले काम करेंगे–लेकिन मैं उम्मीद करता/करती कि कम से कम इन पर चर्चा होती।
अंत में, मुझे अच्छा लगा कि इसने उदाहरण उपयोगों के लिए अपेक्षित आउटपुट पर टिप्पणी की। हालांकि, जब मैंने कोड चलाया, तो पहले उदाहरण उपयोग के लिए केवल पहला विकल्प ही प्रिंट हुआ। अच्छा होता यदि कोड सभी संभावित समाधानों पर विचार करता और उन सभी को प्रिंट करता।
अब एक अलग प्रोग्रामिंग भाषा में एक अलग कोडिंग समस्या आज़माते हैं।
“JavaScript में एक फ़ंक्शन लिखें जो यह निर्धारित करे कि दी गई संख्या अभाज्य (prime) है या नहीं”
पठनीयता के लिए, मैं केवल पहला और अंतिम भाग दिखा रहा/रही हूँ (हालांकि इस बार सोच-श्रृंखला थोड़ी छोटी थी):
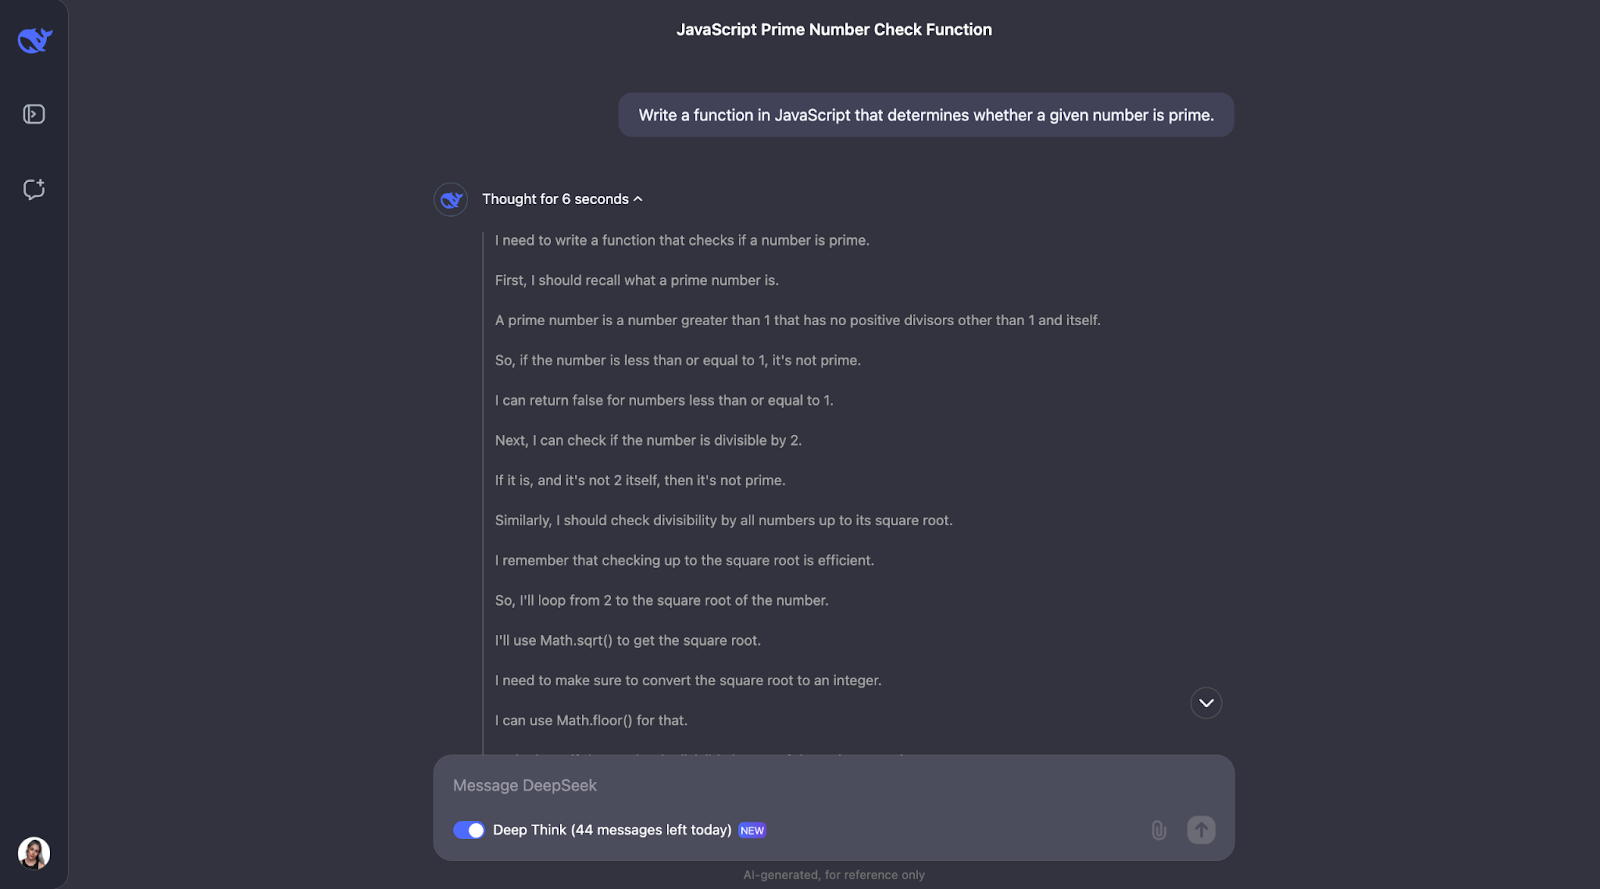
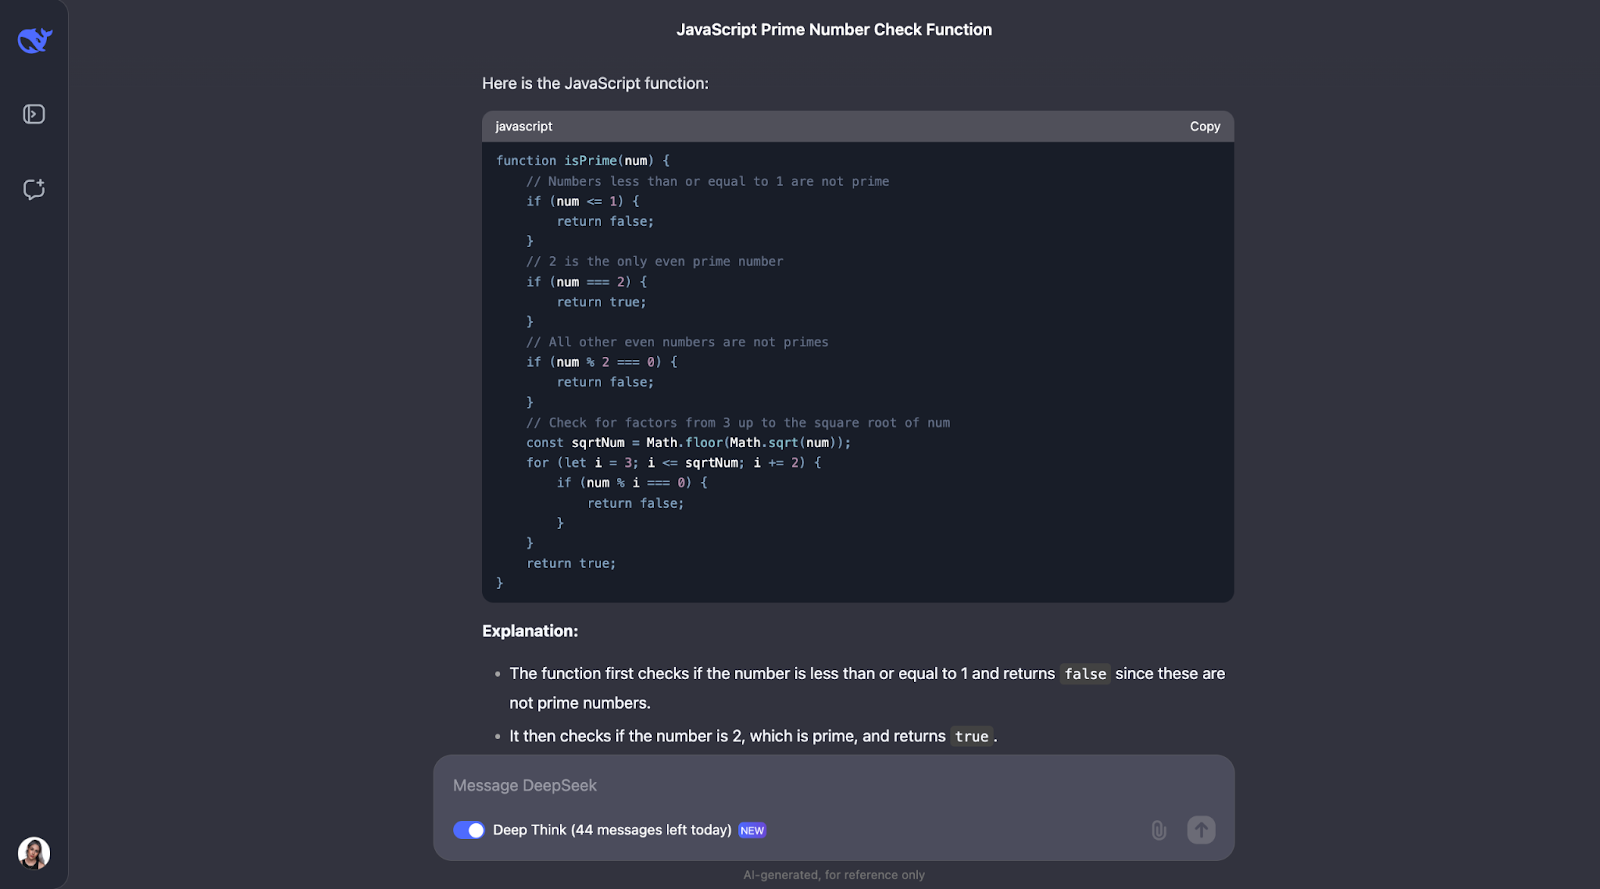
मुझे लगता है कि यहाँ हम सोच-प्रक्रिया का एक पैटर्न देख सकते हैं। अधिकतर समय, यह समस्या में आने वाली मुख्य अवधारणाओं को परिभाषित करके शुरू करता है। तो, उदाहरण के लिए, इस समस्या में यह बताता है कि अभाज्य संख्या क्या होती है।
उसके बाद, सोच-प्रक्रिया तार्किक है और अनुकूलित चरणों तक पहुँचती है। पहले यह बुनियादी बातें कवर करता है: 1 से कम या बराबर संख्याएँ अभाज्य नहीं होतीं, और 2 एकमात्र सम अभाज्य संख्या है। इसके बाद, यह जाँचता है कि क्या संख्या अपने वर्गमूल तक के किसी विषम संख्या से विभाजित होती है। यह समय बचाता है क्योंकि अनावश्यक गणनाएँ टल जाती हैं। साथ ही, हर संख्या की जाँच करने के बजाय, यह 2 के बाद सभी सम संख्याओं को छोड़ देता है, जिससे प्रक्रिया और तेज होती है। फ़ंक्शन Math.sqrt का उपयोग वर्गमूल निकालने के लिए करता है, जो जाँच की सीमा तय कर दक्षता और सादगी बनाए रखता है।
फिर, इसने छोटे उदाहरणों के साथ भी परीक्षण किया, ठीक पिछले प्रश्न की तरह, जैसे ज्ञात अभाज्य और अभाज्य-न-होने वाली संख्याएँ, ताकि सुनिश्चित हो सके कि यह अपेक्षा के अनुसार काम करता है।
हालाँकि, सुधार की गुंजाइश है। उदाहरण के लिए, फ़ंक्शन यह नहीं जाँचता कि इनपुट वास्तव में संख्या है या नहीं, तो त्रुटि-संभाल बेहतर हो सकती है। यह 0 या 5 पर समाप्त होने वाली संख्याओं जैसे शॉर्टकट भी शामिल कर सकता है, जो स्पष्ट रूप से अभाज्य नहीं हैं (5 को छोड़कर)। मुझे लगता है कि यह भी बताया जाता कि यह सम संख्याओं को क्यों छोड़ता है या केवल वर्गमूल तक ही क्यों जाँचता है, तो शुरुआती लोगों को और बेहतर समझ में आता।
अंत में, मुझे उम्मीद थी कि कोड में कुछ उदाहरण उपयोग परीक्षण भी होंगे, जैसे पिछले Python कोड में थे।
अब तार्किक तर्क परीक्षणों पर चलते हैं।
मैं एक क्लासिक पहेली परखने जा रहा/रही हूँ:
"एक आदमी को एक भेड़िये, एक बकरी, और एक पत्ता गोभी के साथ नदी पार करनी है। उसकी नाव में केवल वह खुद और एक और चीज़ ही जा सकती है। यदि अकेले छोड़ दिया जाए, तो भेड़िया बकरी को खा जाएगा, और बकरी पत्ता गोभी को खा जाएगी। वह सबको सुरक्षित पार कैसे कराए?"
मैं अपेक्षा करूँगा/करूँगी कि मॉडल यह उत्तर दे:
लेकिन देखते हैं कि यह अपनी सोच-प्रक्रिया को कैसे संभालता है, क्योंकि मुझे पक्का नहीं है कि क्या उम्मीद करूँ!
मुझे पठनीयता के लिए इस आउटपुट को भी संक्षिप्त करना पड़ेगा:
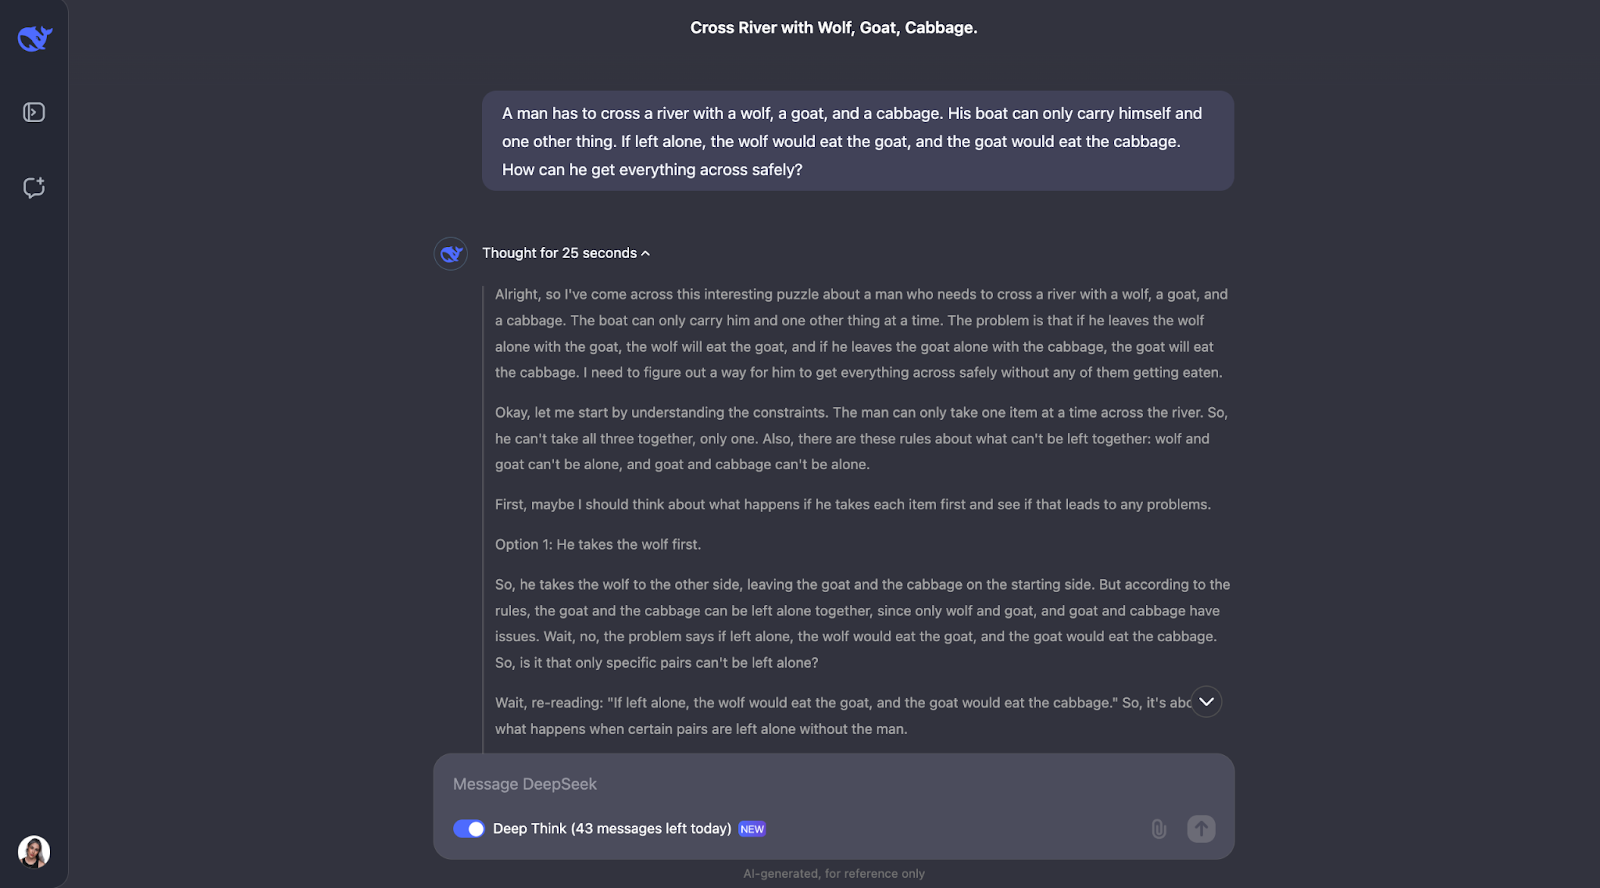
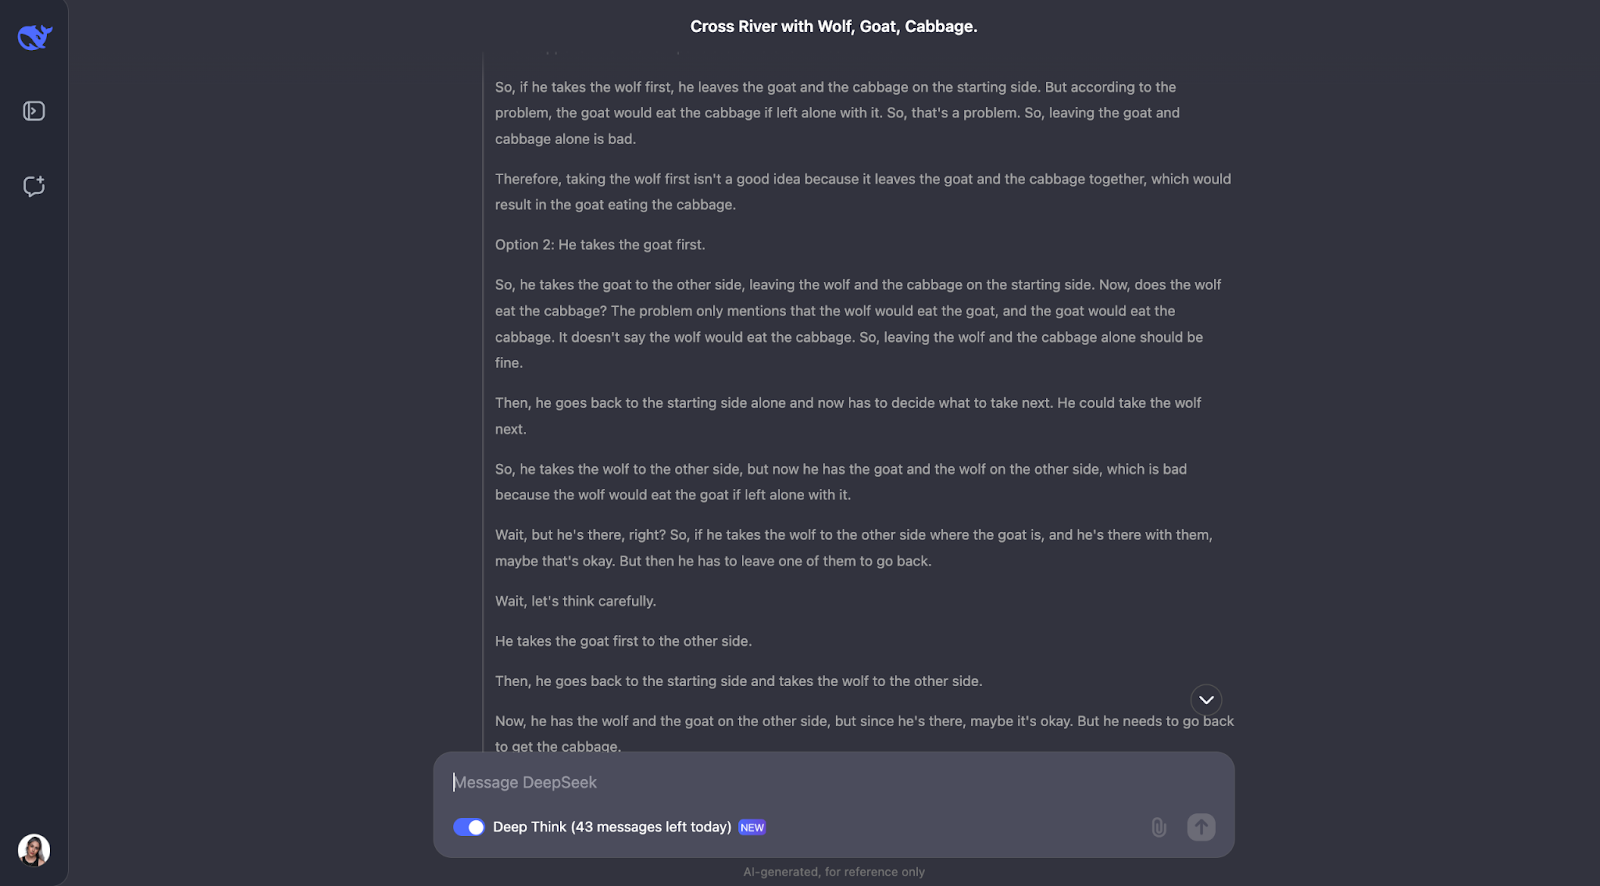
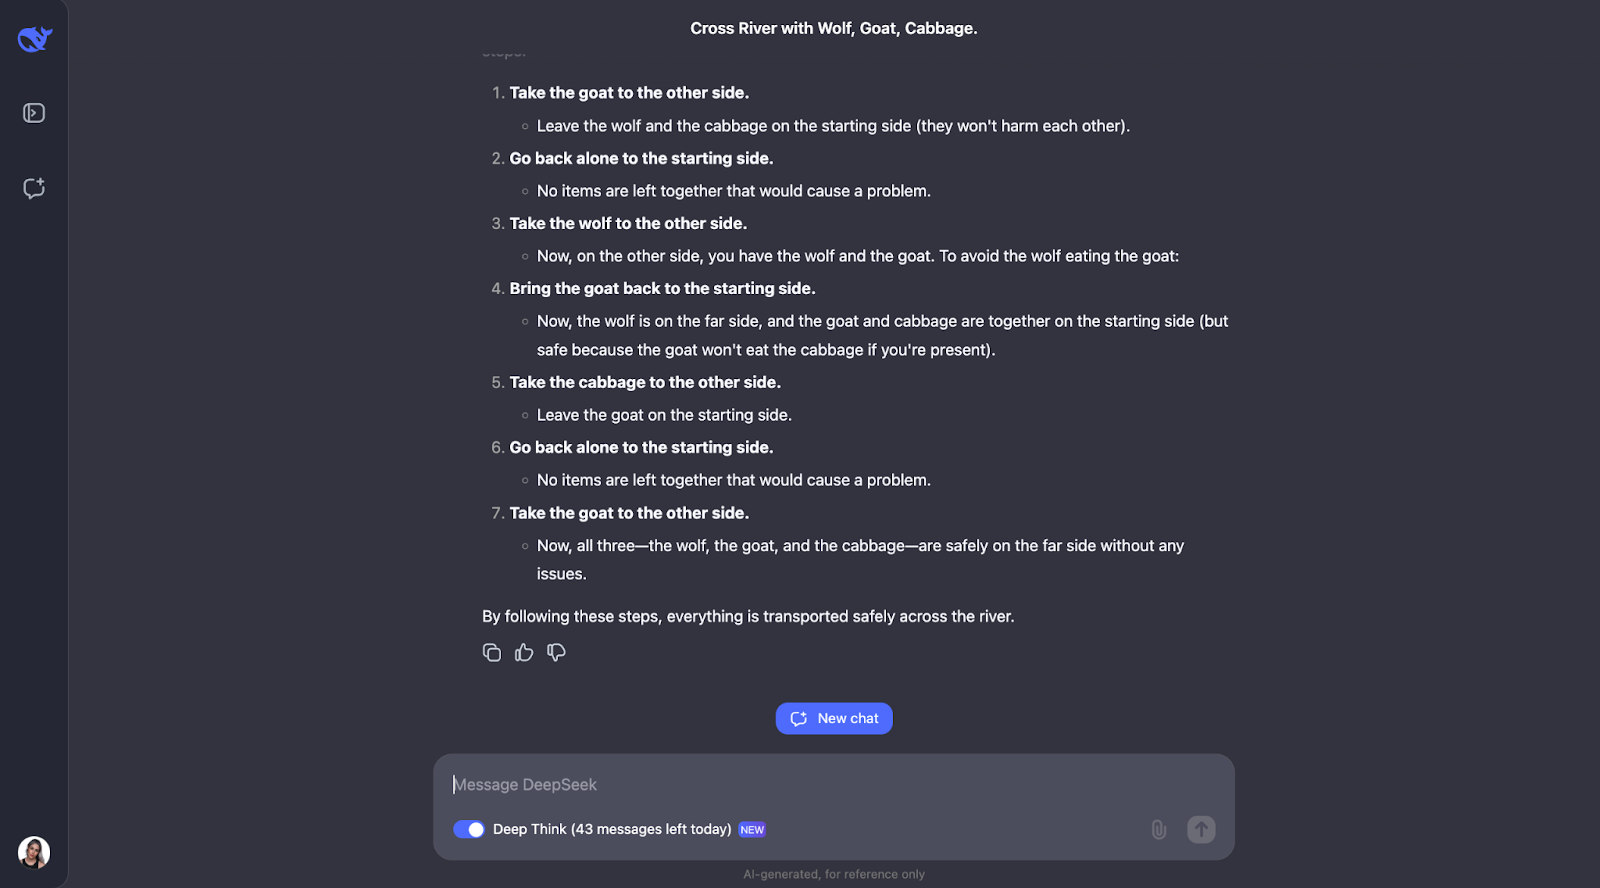
मॉडल इस क्लासिक नदी-पार पहेली को बहुत अच्छे से हल करता है। यह नियमों पर सावधानी से सोचता है और अलग-अलग संभावनाओं की जाँच करता है। इसे समझ है कि कुछ जोड़ियाँ, जैसे भेड़िया और बकरी या बकरी और पत्ता गोभी, को अकेला नहीं छोड़ा जा सकता। यह शुरुआत में बाधाओं की समीक्षा भी करता है। इसके आधार पर, यह देखता है कि यदि आदमी पहले किस वस्तु को पार ले जाए, तो क्या-क्या दिक्कतें पैदा होंगी।
मुझे जो बात अच्छी लगी, वह है कि जब कोई तरीका काम नहीं करता, तो मॉडल अपनी योजना समायोजित करता है। उदाहरण के लिए, जब वह पहले भेड़िये को ले जाने की कोशिश करता है, लेकिन महसूस करता है कि इससे परेशानी होती है, तो वह चरणों पर फिर से विचार करता है। यह परीक्षण-और-त्रुटि का तरीका बहुत मानवीय लगता है।
अंत में, मॉडल सही समाधान देता है और उसे स्पष्ट, चरण-दर-चरण तरीके से समझाता है।
एक और कोशिश करते हैं:
“आपके पास 12 गेंदें हैं, जो दिखने में समान हैं। एक गेंद बाकी से या तो भारी है या हल्की। एक तुला तराजू का उपयोग करते हुए, केवल तीन तोल में उस अलग गेंद को खोजें और तय करें कि वह भारी है या हल्की।”
यह क्लासिक तर्क पहेली मॉडल की निष्कर्षण-आधारित सर्वोत्तम रणनीति बनाने की क्षमता परखती है। देखते हैं क्या होता है। इस बार आउटपुट बहुत-बहुत लंबा था, इसलिए मुझे सीधे उत्तर पर आना पड़ेगा:
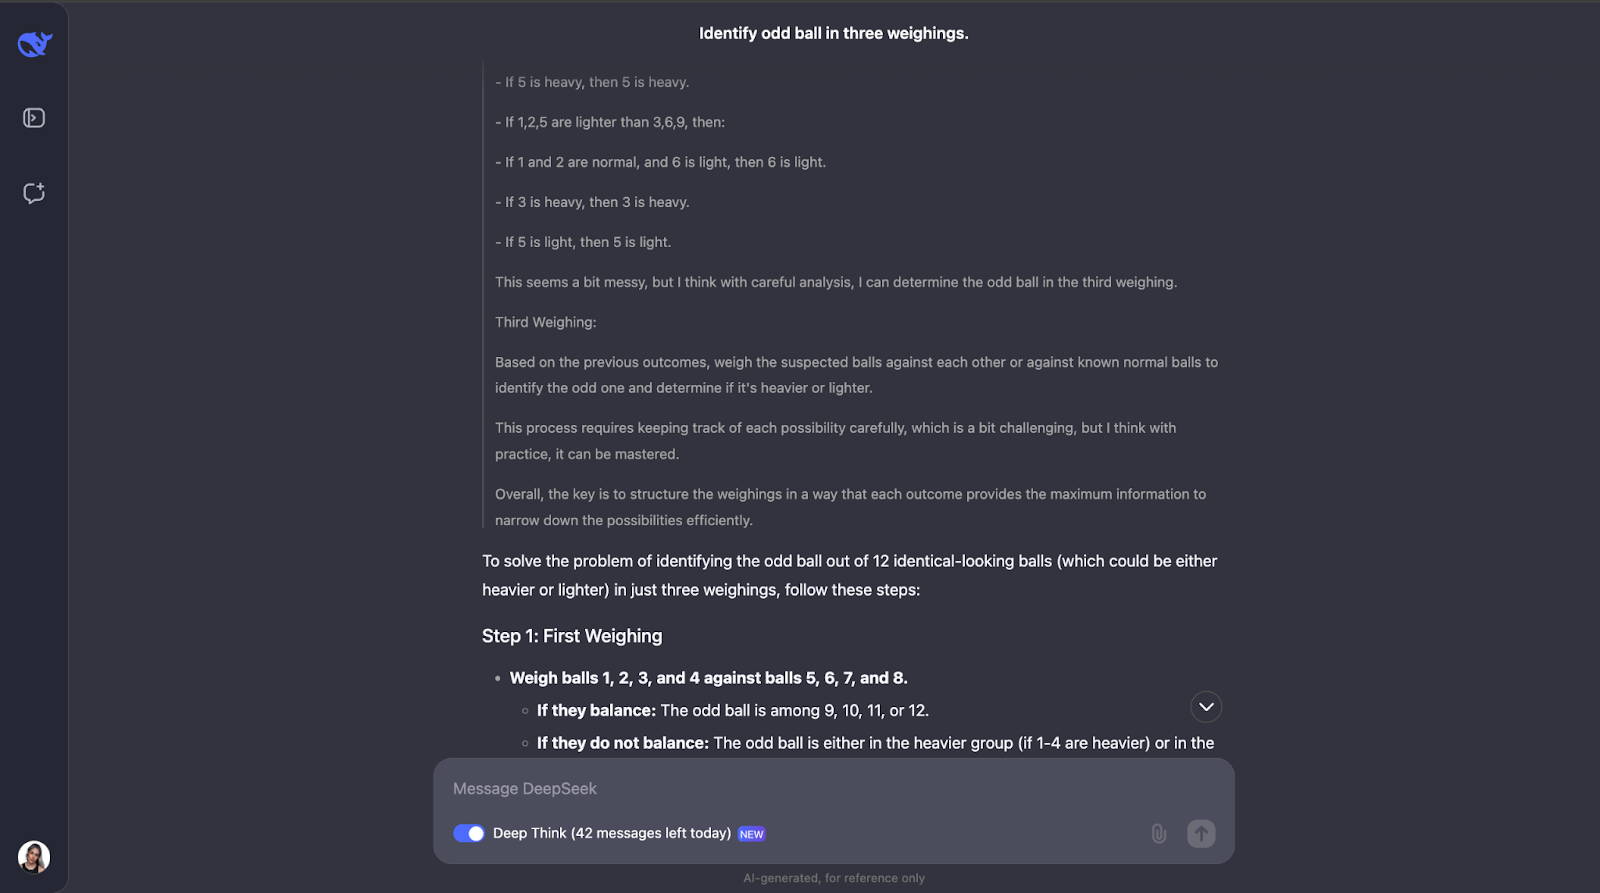
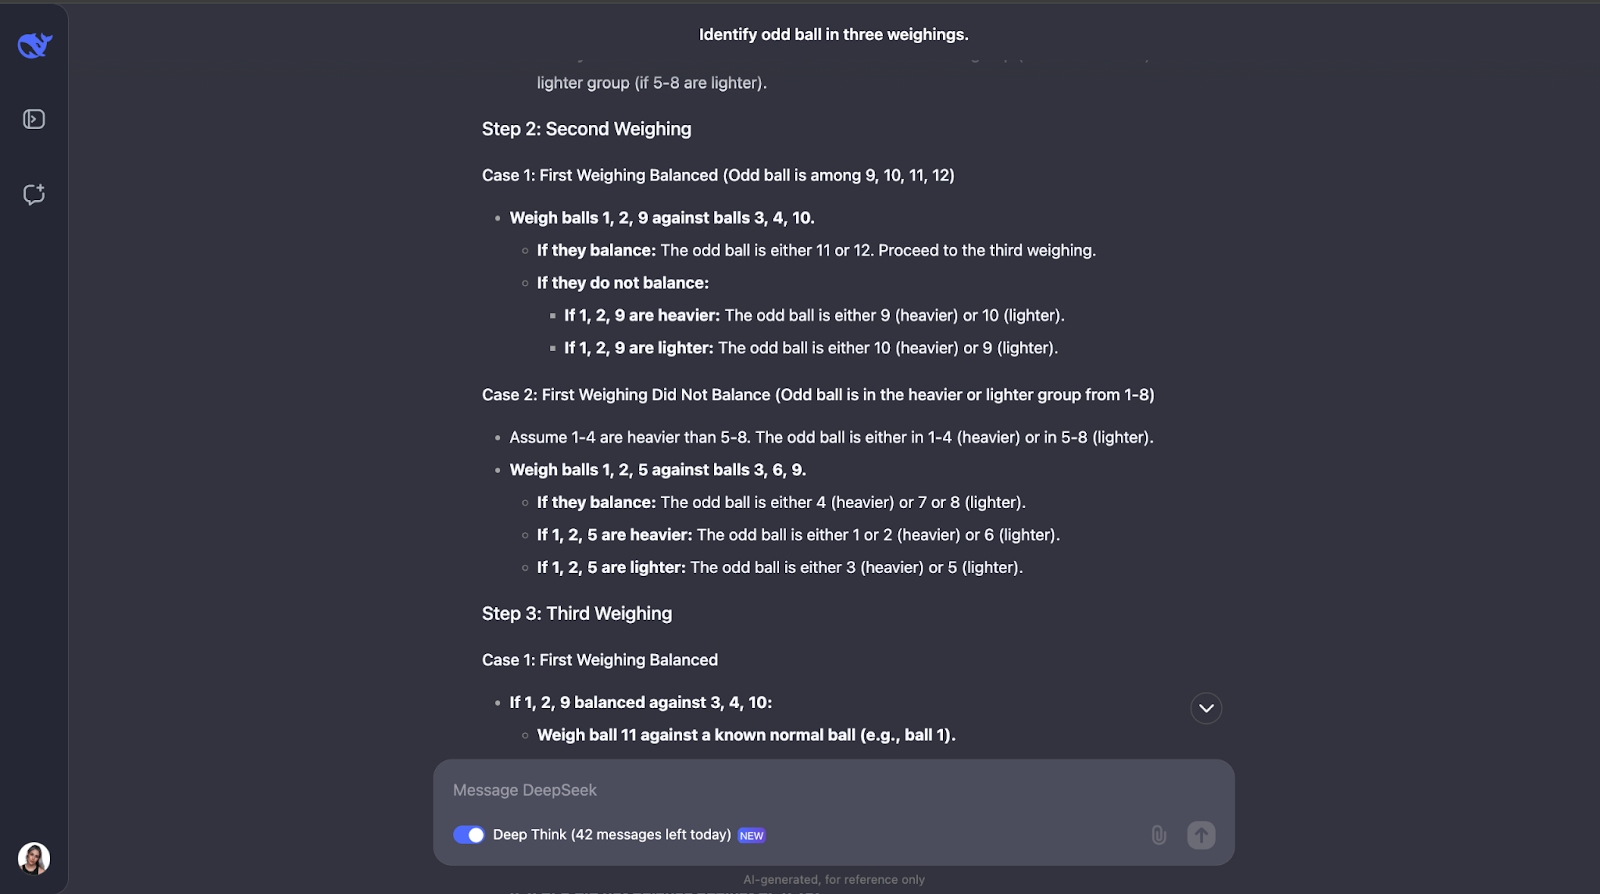
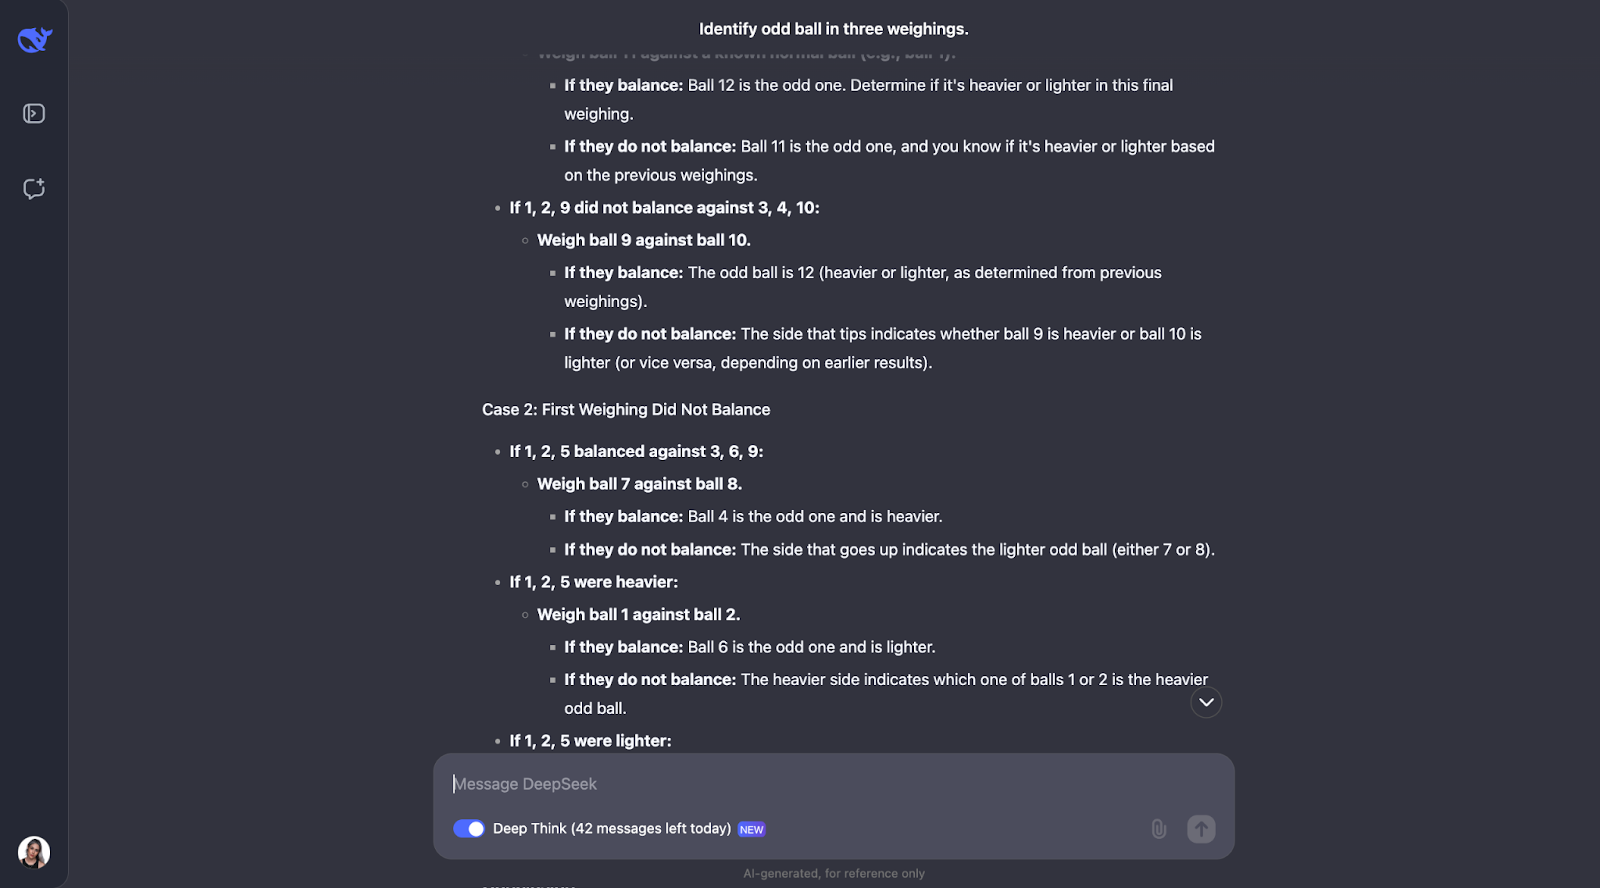
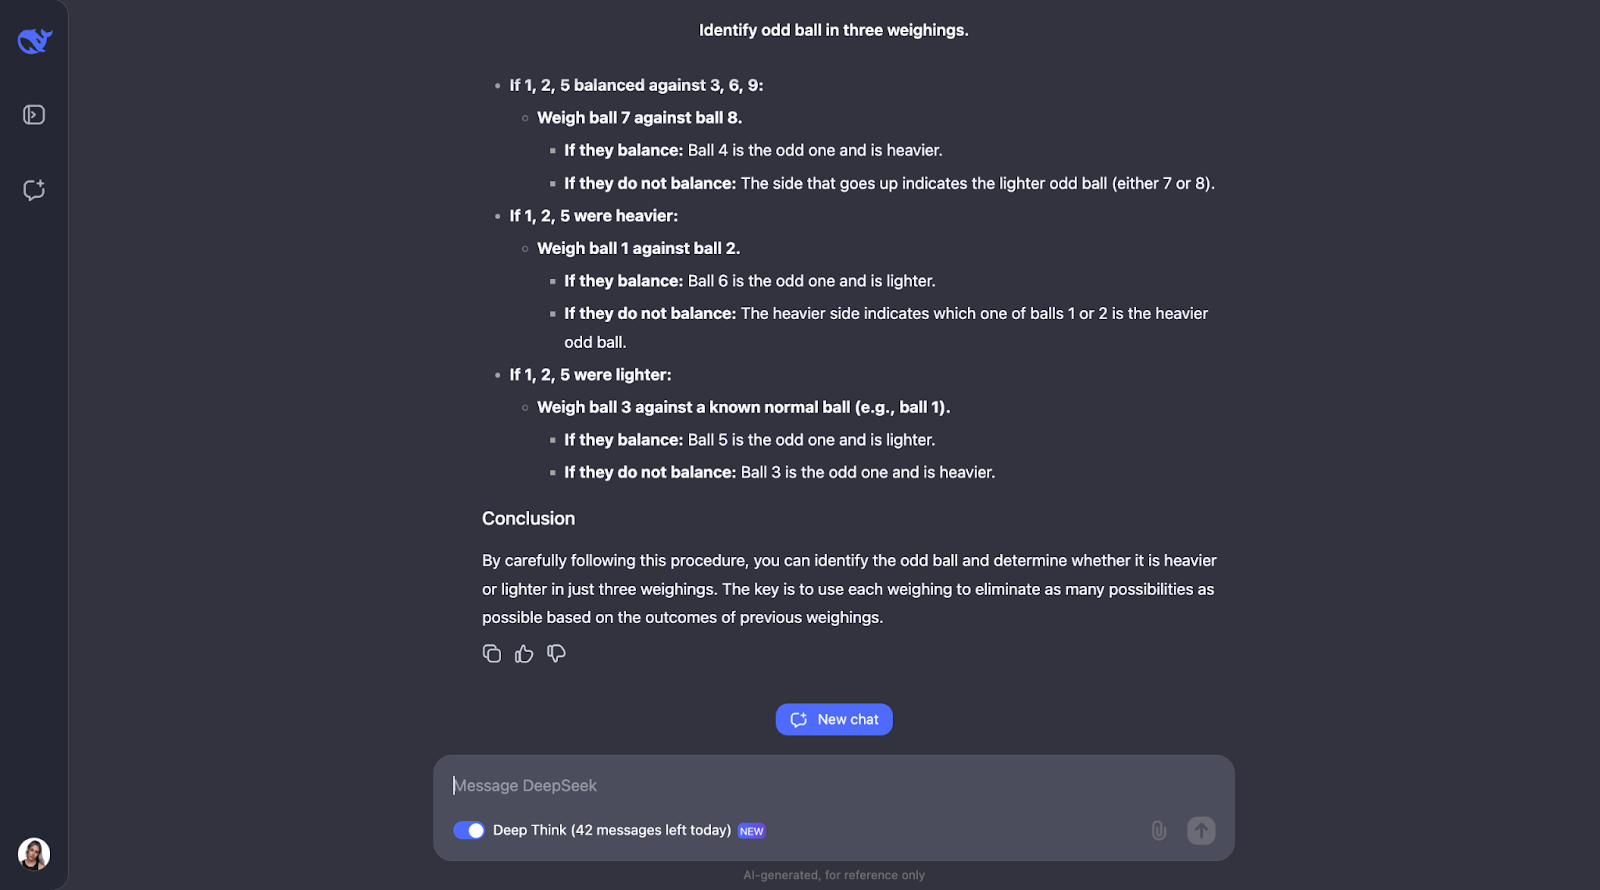
एक और उदाहरण जिसमें मैंने आउटपुट की लंबाई को कम आँका! मॉडल समझता है कि इस पहेली को हल करने के लिए सावधानीपूर्वक योजना की ज़रूरत है क्योंकि आपके पास केवल तीन मौके हैं। यह परिणामों और संभावनाओं की संख्या भी गिनता है।
मॉडल का दृष्टिकोण चतुर है क्योंकि हर तोल में यथासंभव अधिक संभावनाएँ समाप्त हो जाती हैं। यह सभी परिणामों के लिए योजना बनाता है—चाहे तराजू संतुलित रहे या झुके—और जो होता है उसके आधार पर अगला कदम समायोजित करता है। यह बहुत विस्तार से है, लेकिन कदम स्पष्ट और तार्किक हैं, जिससे अनुसरण करना आसान हो जाता है, भले ही यह लंबा हो,
मुझे यह बात बहुत अच्छी लगी कि जब तरीका कुछ ज्यादा जटिल होने लगता है, तो यह अधिक व्यवस्थित या सरल तरीका अपनाता है। हालांकि, इस तरह की समस्याओं में, जहाँ अलग-अलग मामलों, परिणामों और संभावनाओं पर नजर रखनी होती है, कोई आरेख या चार्ट जोड़ना लोगों को सोच-प्रक्रिया को देखने और आउटपुट को बेहतर समझने में मदद कर सकता है।
इस खंड में, मैं DeepSeek की तुलना अन्य मॉडलों जैसे o1-preview और GPT-4o से विभिन्न बेंचमार्क पर प्रदर्शन के आधार पर करूँगा/करूँगी। प्रत्येक बेंचमार्क अलग कौशल पर केंद्रित है, ताकि हम देख सकें कि कौन से मॉडल किन कार्यों में सर्वश्रेष्ठ हैं। आइए DeepSeek द्वारा मापे गए बेंचमार्क देखें:
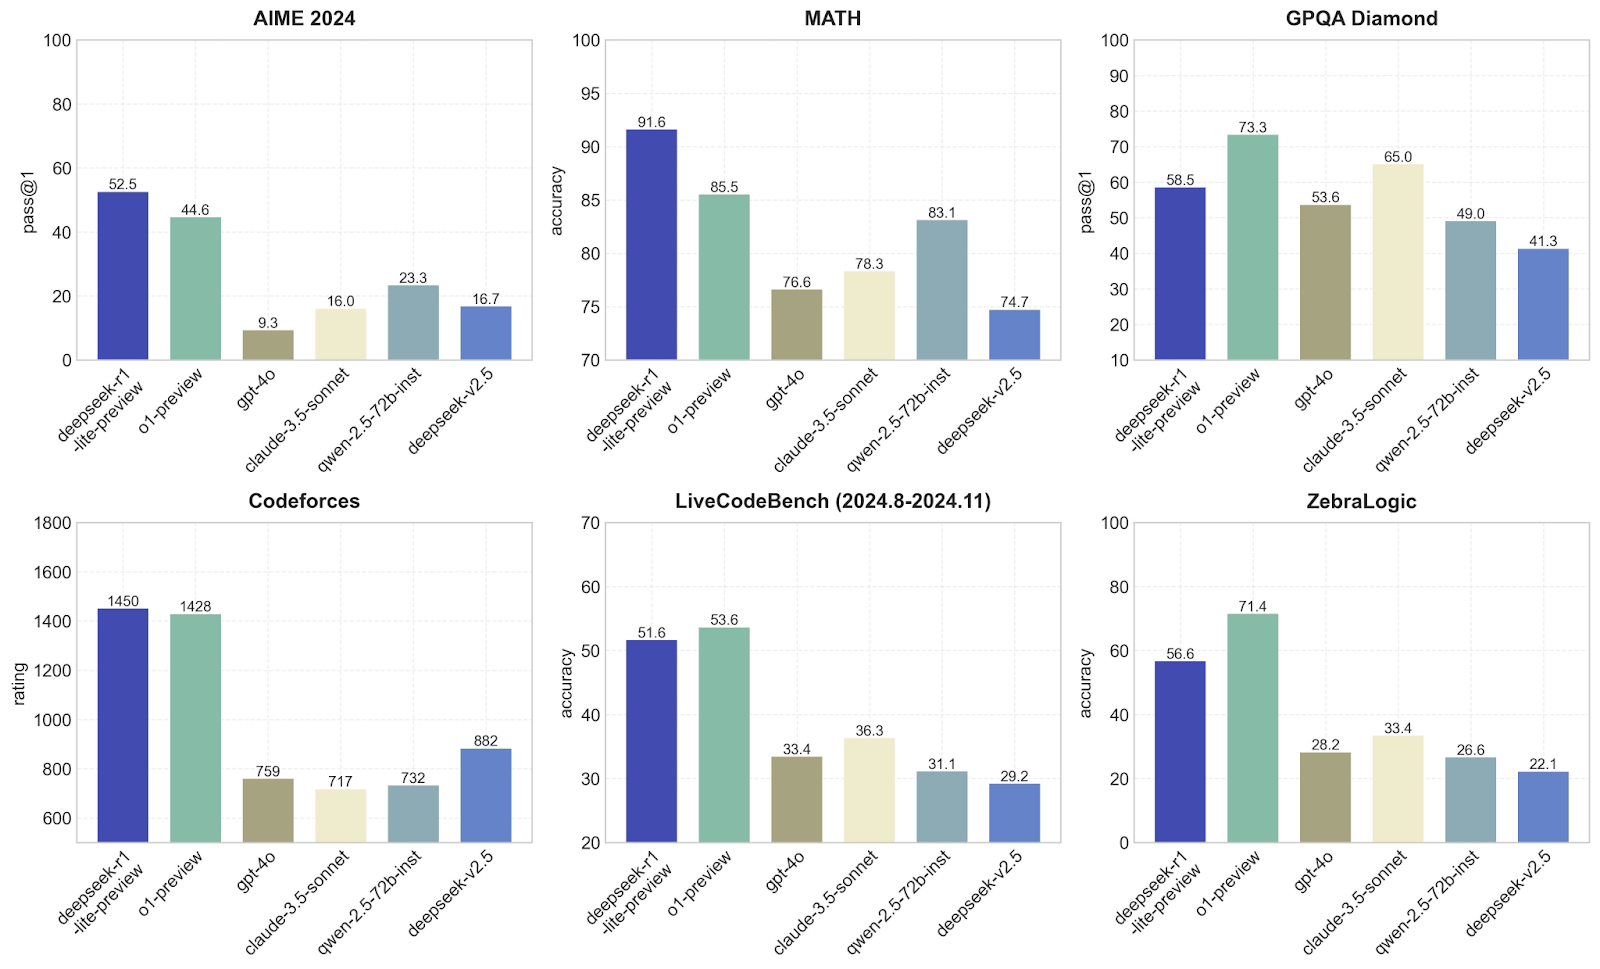
DeepSeek-r1-lite-preview यहाँ स्पष्ट रूप से सबसे अच्छा है, pass@1 52.5 के साथ, उसके बाद o1-preview 44.6 पर है। अन्य मॉडल, जैसे GPT-4o और claude-3.5-sonnet, काफी पीछे हैं, 23 से कम स्कोर के साथ। यह सुझाव देता है कि DeepSeek-r1-lite-preview मॉडल AIME बेंचमार्क के विशिष्ट उन्नत गणित या तर्क समस्याओं को संभालने में काफी अच्छा है, जो मेरे द्वारा किए गए परीक्षणों के बाद मुझे आश्चर्यजनक नहीं लगता।
DeepSeek-v1 फिर से 91.6 की प्रभावशाली शुद्धता के साथ हावी है, o1-preview (85.5) से काफी आगे और GPT-4o जैसे अन्य मॉडलों से बहुत बेहतर, जो 76.6 तक पहुँचने में भी संघर्ष करते हैं। यह दिखाता है कि DeepSeek गणितीय समस्याएँ हल करने में बेहतरीन है, जो मेरे पहले किए गए परीक्षणों के अनुभवजन्य सबूतों से निकले अनुमान की पुष्टि करता है–अब तक कोई आश्चर्य नहीं!
यहाँ, o1-preview DeepSeek-v1 से बेहतर करता है, pass@1 73.3 के साथ जबकि DeepSeek-v1 का 58.5 है। GPT-4o जैसे अन्य मॉडल 53.6 पर पीछे रह जाते हैं। यह दर्शाता है कि o1-preview ऐसे कार्यों के लिए अधिक उपयुक्त है जिनमें तर्क पर आधारित प्रश्नों का उत्तर देना या समस्याएँ सुलझाना शामिल है। DeepSeek अभी भी ठोस प्रदर्शन करता है लेकिन o1-preview जितना अच्छा नहीं।
प्रतिस्पर्धी प्रोग्रामिंग के लिए, DeepSeek-v1 (1450) और 01-preview (1428) लगभग शीर्ष स्थान के लिए बराबरी पर हैं, जबकि GPT-4o जैसे अन्य मॉडल केवल लगभग 759 अंक हासिल करते हैं। अपेक्षित रूप से, यह दिखाता है कि ये दोनों मॉडल प्रोग्रामिंग चुनौतियों के लिए कोड समझने और उत्पन्न करने में उत्कृष्ट हैं।
यह समय के साथ कोडिंग क्षमताओं का परीक्षण करता है, और o1-preview थोड़े अंतर से DeepSeek-v1 (53.6 बनाम 51.6) से आगे है। अन्य मॉडल, जैसे GPT-4o, 33.4 पर काफी पीछे हैं। फिर से, यह दिखाता है कि DeepSeek और 01-preview दोनों कोडिंग के लिए उपयुक्त हैं, लेकिन 01-preview इन कार्यों में थोड़ा बेहतर है।
यहाँ o1-preview 71.4 की शुद्धता के साथ आगे है, जबकि DeepSeek-v1 56.6 पर है। अन्य मॉडल बहुत खराब प्रदर्शन करते हैं। यह दिखाता है कि o1-preview ZebraLogic जैसे अमूर्त तर्क कार्यों को संभालने में बेहतर है, जिनमें अधिक रचनात्मक या अलग ढंग से सोचने की आवश्यकता होती है, जो मेरे परीक्षणों के परिणामों से मेल खाता है क्योंकि रचनात्मकता निश्चित रूप से DeepSeek-v1 की ताकत नहीं थी।
ये ग्राफ़ पुष्टि करते हैं कि DeepSeek-v1 गणित और प्रोग्रामिंग चुनौतियों में अद्भुत है। मैं कहूँगा/कहूँगी कि o1-preview अधिक संतुलित है और कार्यों की व्यापक रेंज में अच्छा प्रदर्शन करता है, जो इसे अधिक बहुमुखी बनाता है।
अब इस ग्राफ़ पर नज़र डालें:
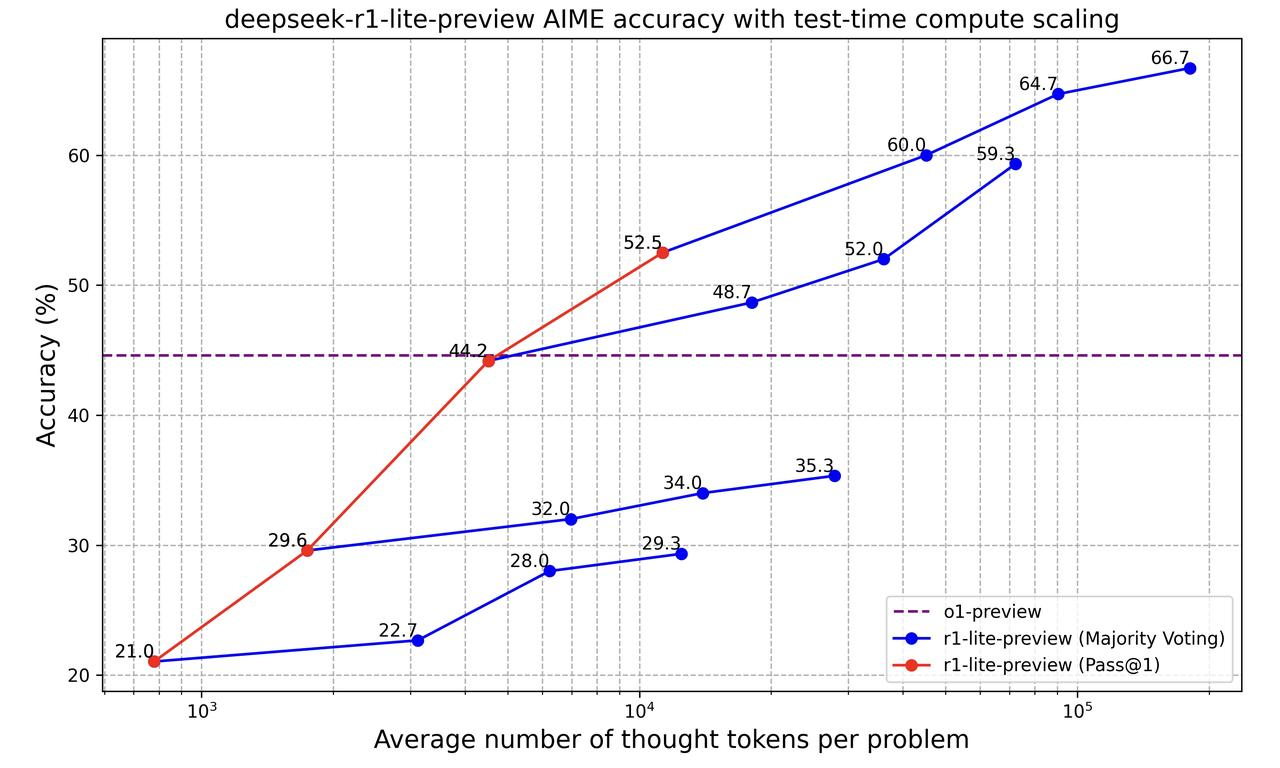
यह ग्राफ दिखाता है कि “deepseek-r1-lite-preview” मॉडल समस्याएँ हल करने में कैसे बेहतर होता जाता है जब वह अधिक जानकारी संसाधित करता है (जिसे वह जितने “thought tokens” उपयोग करता है, उससे मापा गया है)। यह मॉडल की शुद्धता मापने के दो तरीकों की तुलना करता है:
टूटी-बिंदीदार बैंगनी रेखा o1-preview मॉडल का प्रतिनिधित्व करती है जिसकी शुद्धता स्थिर है। शुरू में o1-preview बेहतर है, पर जैसे-जैसे DeepSeek r1-lite-preview को अधिक thought tokens उपयोग करने दिए जाते हैं, वह o1-preview को पीछे छोड़ देता है और कहीं अधिक सटीक हो जाता है।
संक्षेप में, यह ग्राफ दिखाता है कि DeepSeek r1-lite-preview को अधिक सोचने और कई बार प्रयास करने देने से उसकी शुद्धता बढ़ती है।
क्या DeepSeek-r1-lite-preview OpenAI के o1-preview से बेहतर है? खैर, यह कार्य पर निर्भर करता है। मैं कहूँगा/कहूँगी कि गणित और कोडिंग समस्याओं के लिए हाँ। तार्किक तर्क के लिए, यह कार्य के प्रकार पर निर्भर करता है।
मुझे जो सच में चौंकाने वाला लगा, वह था कुछ परीक्षणों में इसकी तर्क-प्रक्रिया। इसने वास्तव में मुझे यह सोचने पर मजबूर किया कि किसी मॉडल के “सोचने” का क्या मतलब है और वह अपनी तर्क-पद्धतियाँ कैसे विकसित करता है।
यदि आप इस मॉडल के बारे में उत्सुक हैं, तो क्यों न आप इसे खुद परखें? जिन कार्यों में आपकी रुचि है, उन पर इसे आज़माएँ और देखें कि यह कैसा प्रदर्शन करता है—हो सकता है आपको यह उतना ही चौंकाने वाला लगे जितना मुझे लगा!
इन कोर्सेज़ के साथ एआई सीखें!
कोर्स
लर्निंग पाथ
कोर्स