
Khóa học
Retrieval Augmented Generation (RAG) với LangChain
3 giờ
21.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleDeepSeek-R1-Lite-Preview là một công cụ AI, tương tự như ChatGPT, do công ty Trung Quốc DeepSeek tạo ra. Họ công bố mô hình mới này trên X vào ngày 20 tháng 11 (liên kết tweet) và chia sẻ một vài chi tiết trên trang tài liệu.
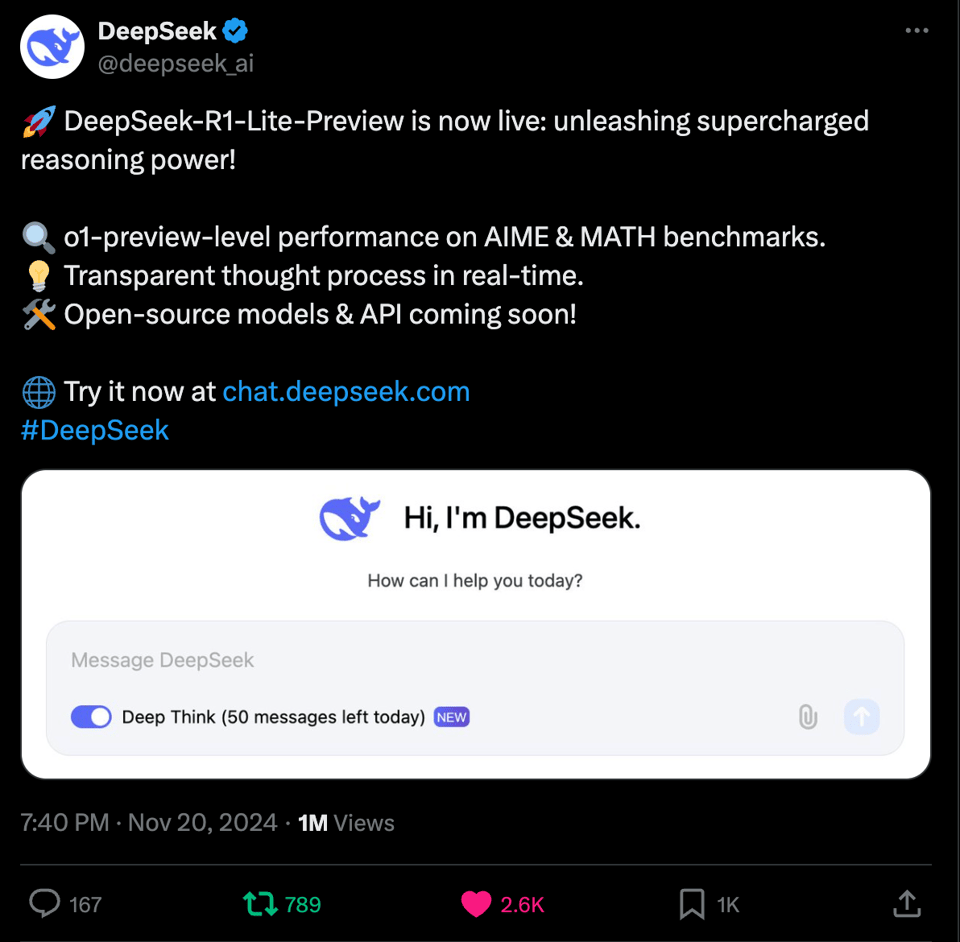
DeepSeek-R1-Lite-Preview được thiết kế để giải tốt các bài toán lập luận phức tạp về toán, mã hóa và logic. Nó hiển thị từng bước cách nó suy nghĩ để bạn hiểu được cách mô hình đi đến câu trả lời, từ đó giúp tăng độ tin cậy.
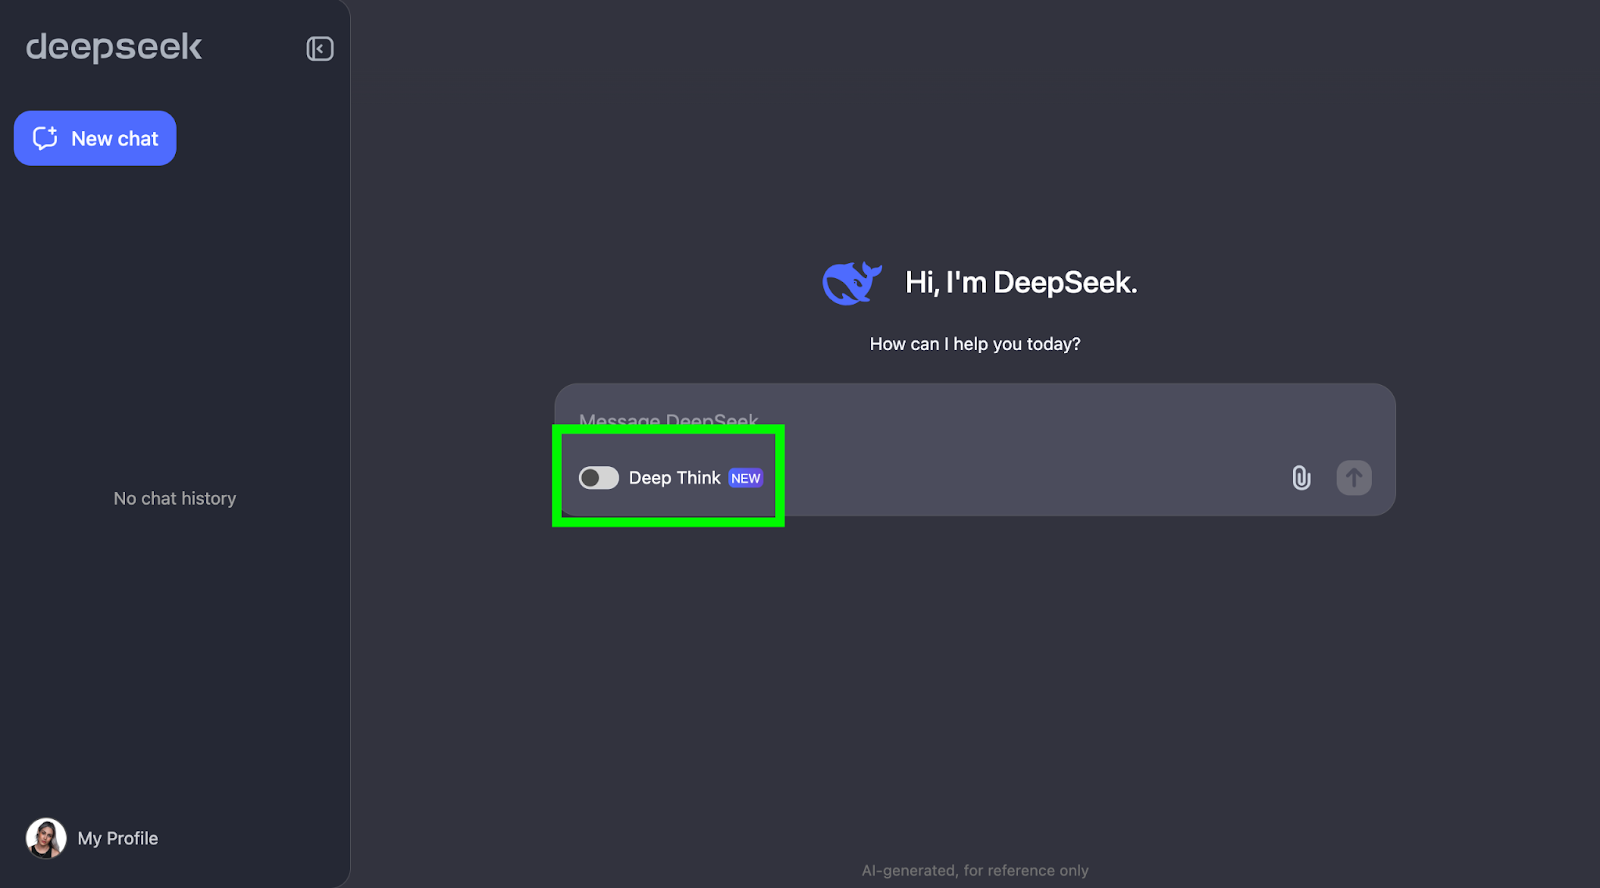
Bạn có thể dùng thử miễn phí trên trang web của họ, chat.deepseek.com, nhưng bị giới hạn 50 tin nhắn mỗi ngày trong chế độ nâng cao gọi là “Deep Think”. DeepSeek cũng có kế hoạch chia sẻ một phần công cụ này cho cộng đồng để mọi người có thể sử dụng hoặc phát triển tiếp.
Bạn có thể bắt đầu sử dụng DeepSeek-R1-Lite-Preview theo hai bước sau:
Để xem DeepSeek-R1-Lite-Preview có thể làm gì, hãy thử nghiệm! Tôi sẽ thực hiện một loạt thử thách để phô diễn khả năng lập luận của nó, bắt đầu với câu hỏi đơn giản nhưng nổi tiếng về dâu tây: Chữ “r” xuất hiện bao nhiêu lần trong từ 'strawberry'?
Câu hỏi này trông có vẻ dễ, nhưng các LLM (ngay cả GPT-4o) từ trước đến nay thường gặp khó khi trả lời đúng—chúng thường trả lời rằng chỉ có hai lần xuất hiện chữ “r”.
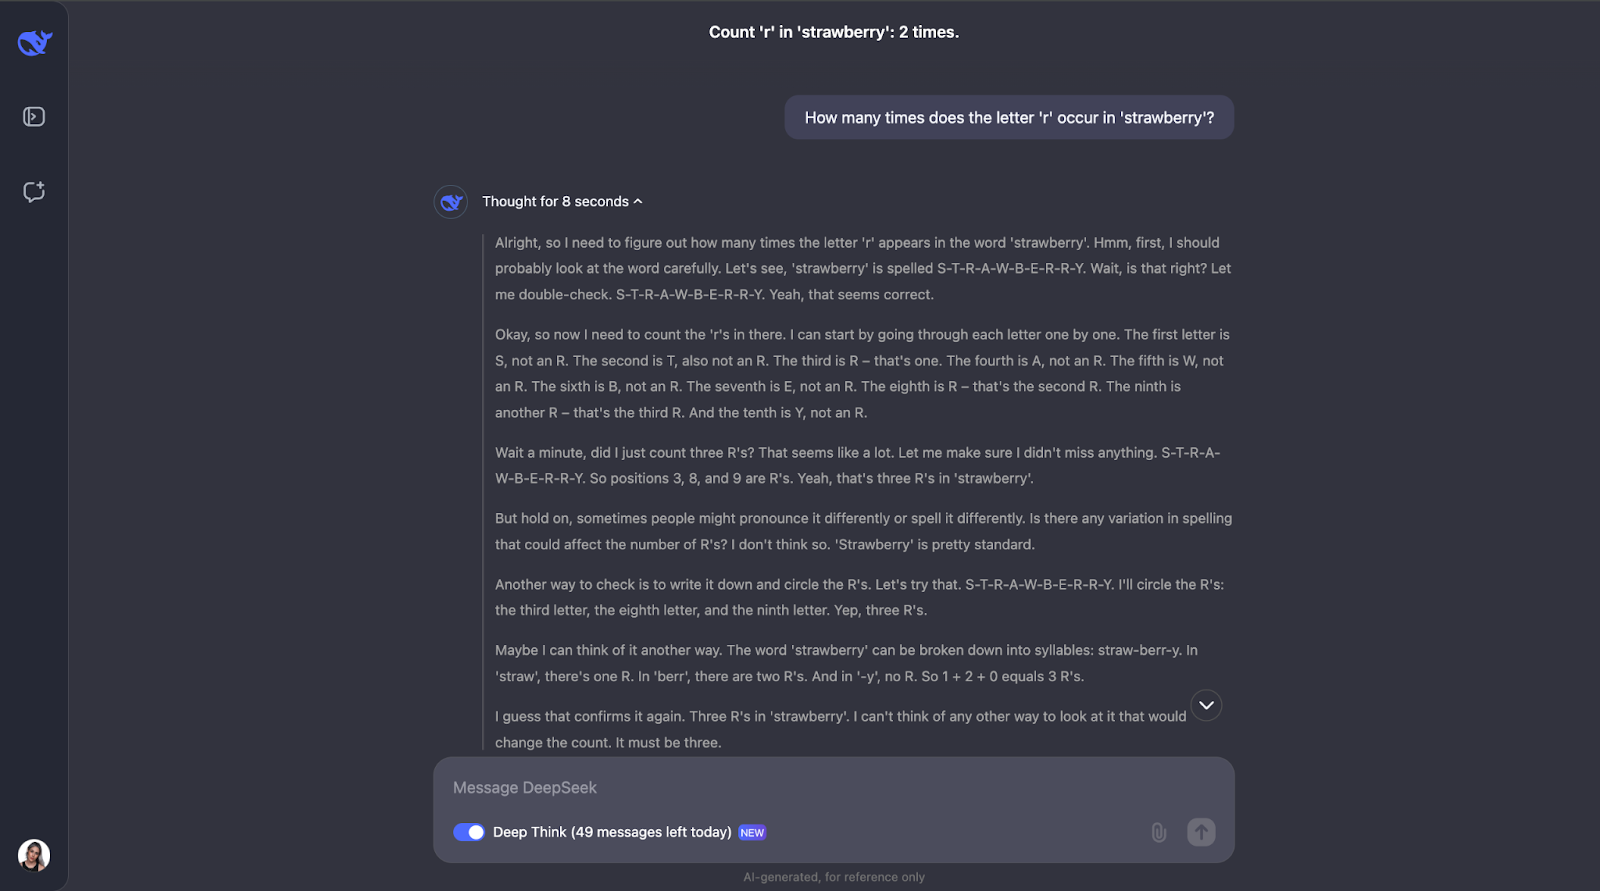
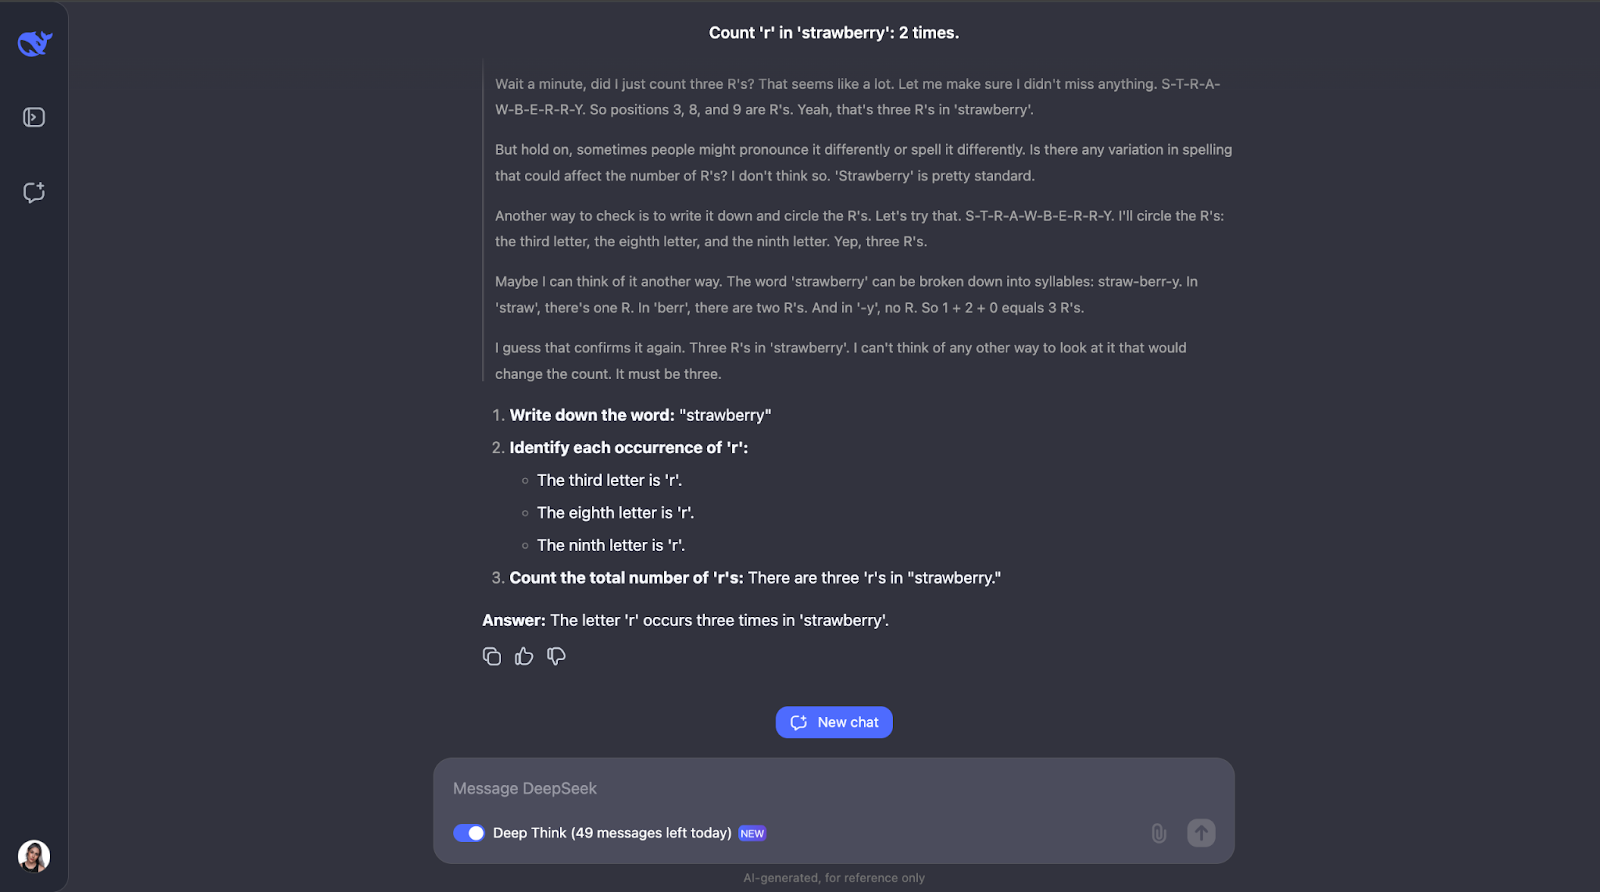
Wow, được rồi – tôi không ngờ lại có một quá trình lập luận dài như vậy cho một nhiệm vụ tưởng như đơn giản. Tôi nghĩ rằng sau khi đếm chữ 'r' và xác định vị trí của nó trong từ, mô hình sẽ dừng lại. Nhưng điều thú vị là nó không dừng ở đó. Nó kiểm tra chéo việc đếm vài lần và thậm chí còn cân nhắc cách con người có thể phát âm hoặc đánh vần từ này khác nhau – điều mà tôi cho là hơi thừa, đặc biệt là phần phát âm. Nhưng như vậy cho thấy nó rất cẩn trọng và chu đáo! Nó cũng giải thích từng bước để tôi có thể theo dõi mạch suy nghĩ và thấy cách nó đi đến câu trả lời.
Tôi sẽ kiểm tra DeepSeek-R1-Lite-Preview với ba bài toán.
Với tuyên bố của DeepSeek về khả năng lập luận toán học mạnh, hãy bắt đầu với một bài hình học đơn giản.
"Nếu một tam giác có các cạnh dài 3, 4 và 5, diện tích của nó là bao nhiêu?"
Bài này cần kiến thức về định lý Pythagoras và công thức Heron. Tôi kỳ vọng DeepSeek-R1-Lite-Preview sẽ trình bày các bước, có thể như sau:
Hãy xem chuyện gì xảy ra!
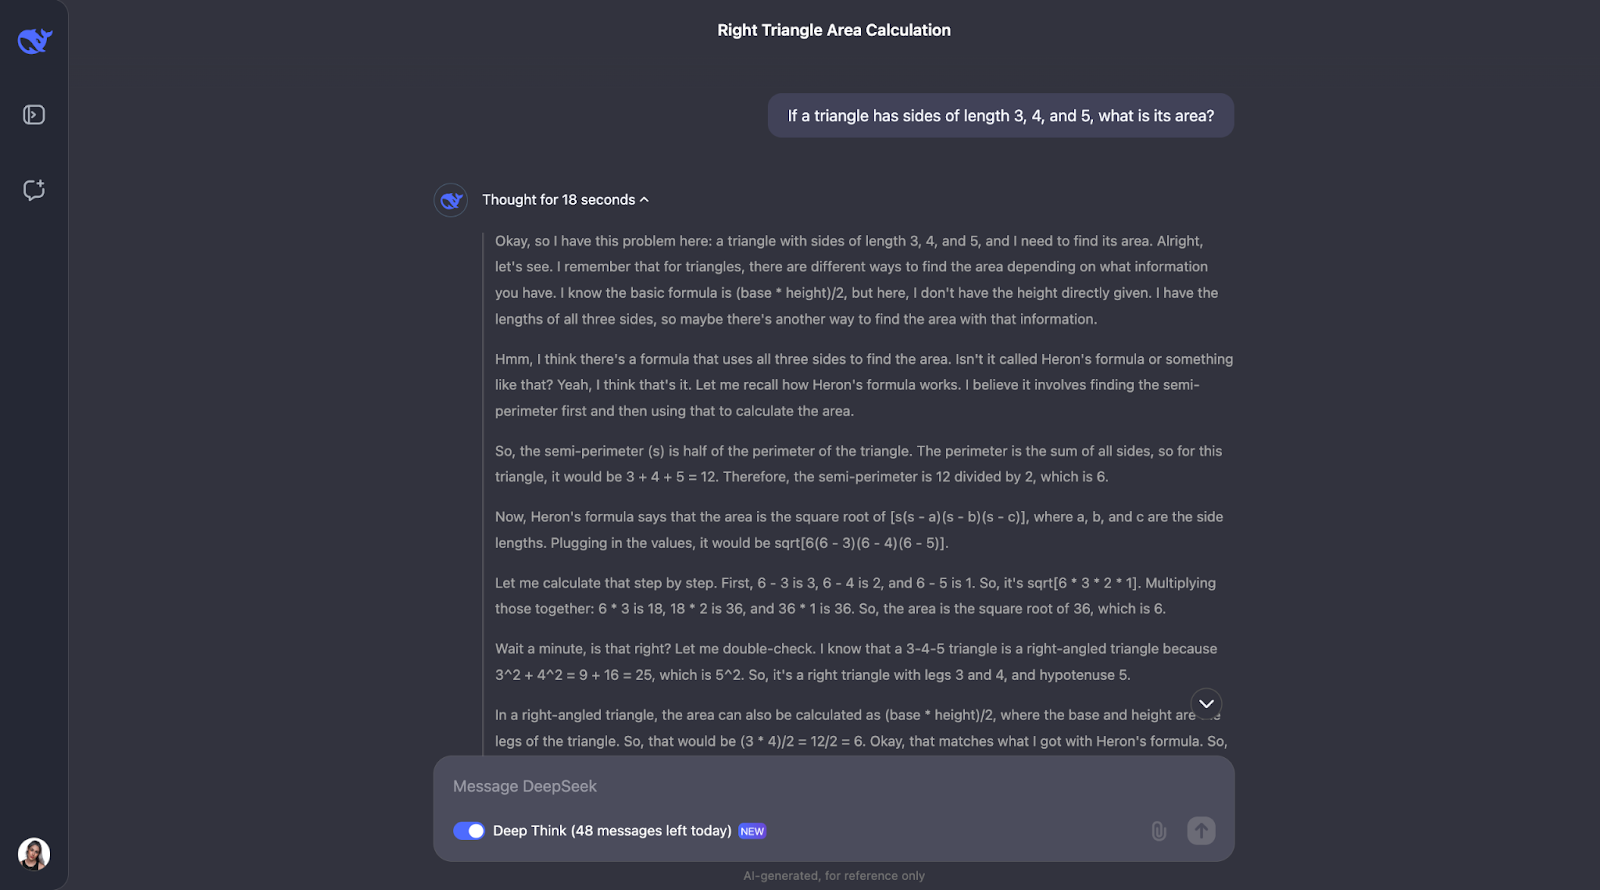
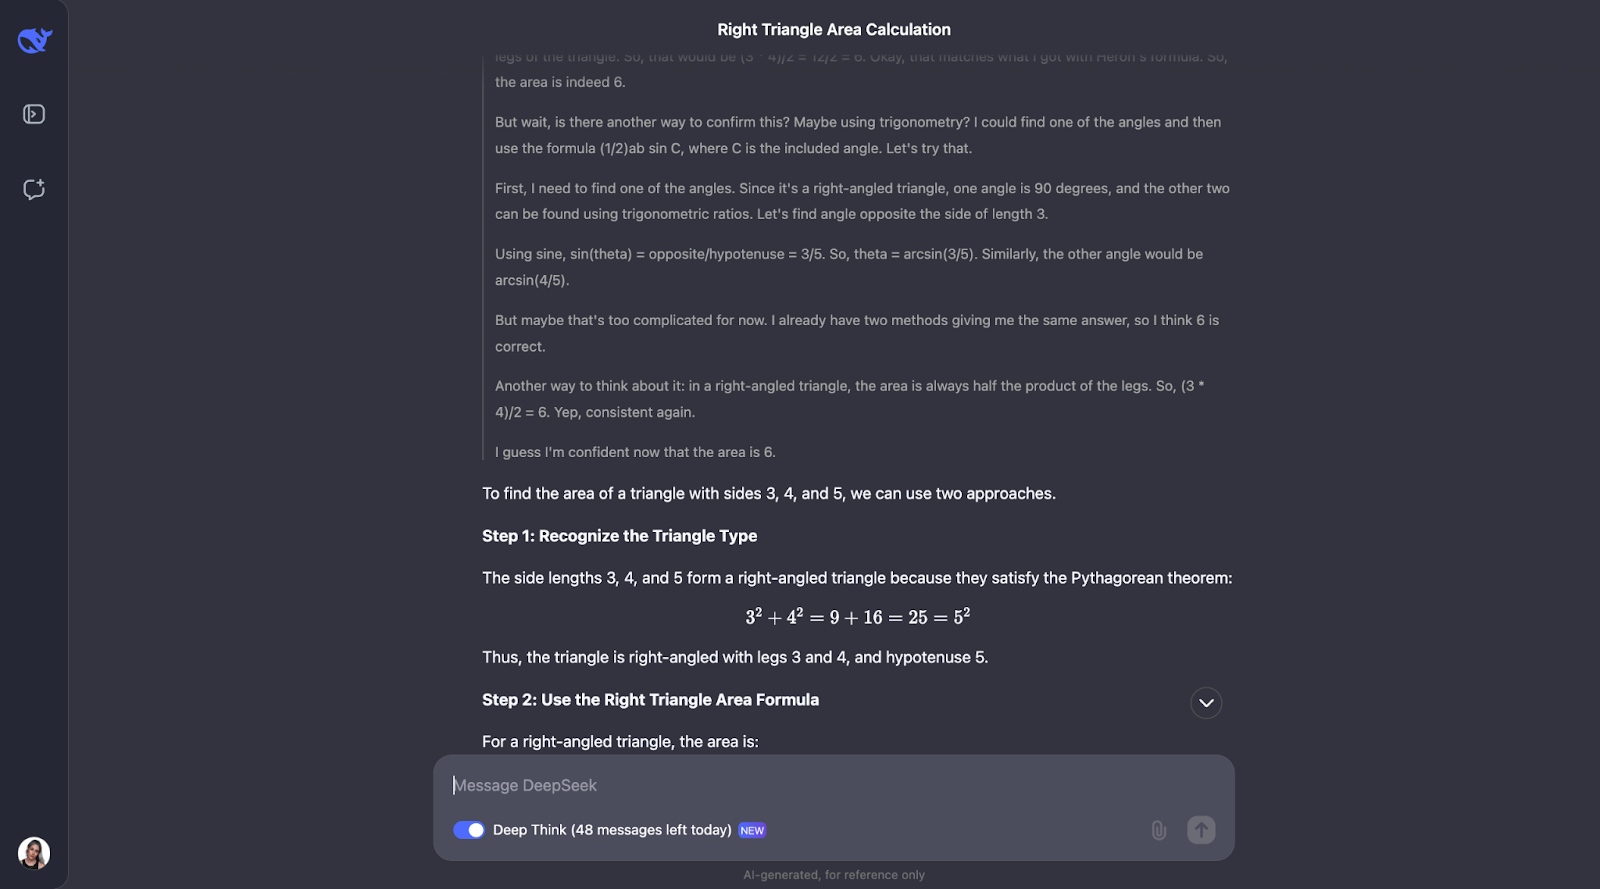
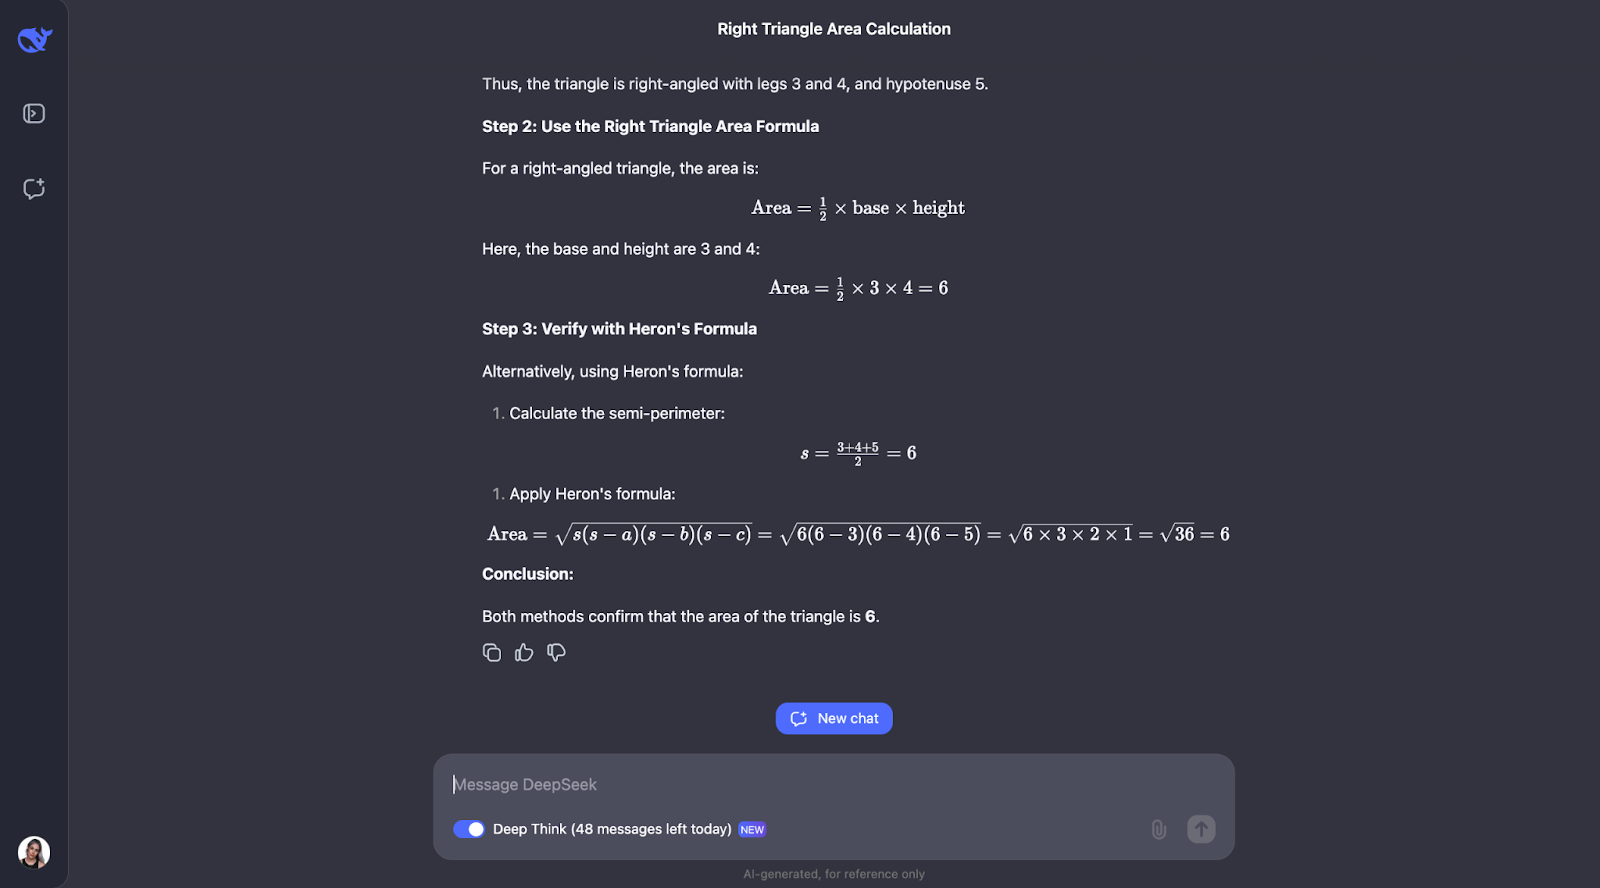
Được rồi, điều thú vị là nó thực hiện các bước kiểm tra mà tôi dự đoán—dù theo thứ tự khác. Nó cũng cân nhắc dùng lượng giác bằng cách tính góc và thử công thức khác. Tôi thấy rất hay khi cuối cùng nó quyết định không cần vì hai phương pháp đầu đã xác nhận đáp án.
Phần giải thích và kết quả đều đặc biệt rõ ràng, dễ theo dõi, khiến tôi nghĩ đây sẽ là một mô hình tuyệt vời để tích hợp vào trợ lý học toán cho học sinh, chẳng hạn. Với trường hợp này, có lẽ nên hiển thị trước quá trình suy nghĩ để học sinh tương tác, xác nhận đã hiểu rồi mới chuyển tới đáp án cuối.
Chuyển sang một bài kiểm tra toán học phức tạp hơn để xem hiệu năng và mạch suy nghĩ có gì khác.
“Chứng minh rằng tổng các nghịch đảo của dãy Fibonacci hội tụ đến một giá trị hữu hạn.”
Bài này thách thức hiểu biết của mô hình về các khái niệm toán học nâng cao như hội tụ chuỗi và tính chất của Fibonacci. Hãy thử nhé! Để dễ đọc, tôi chỉ đăng phần đầu và phần cuối câu trả lời (nhưng bạn có thể thử với cùng gợi ý):
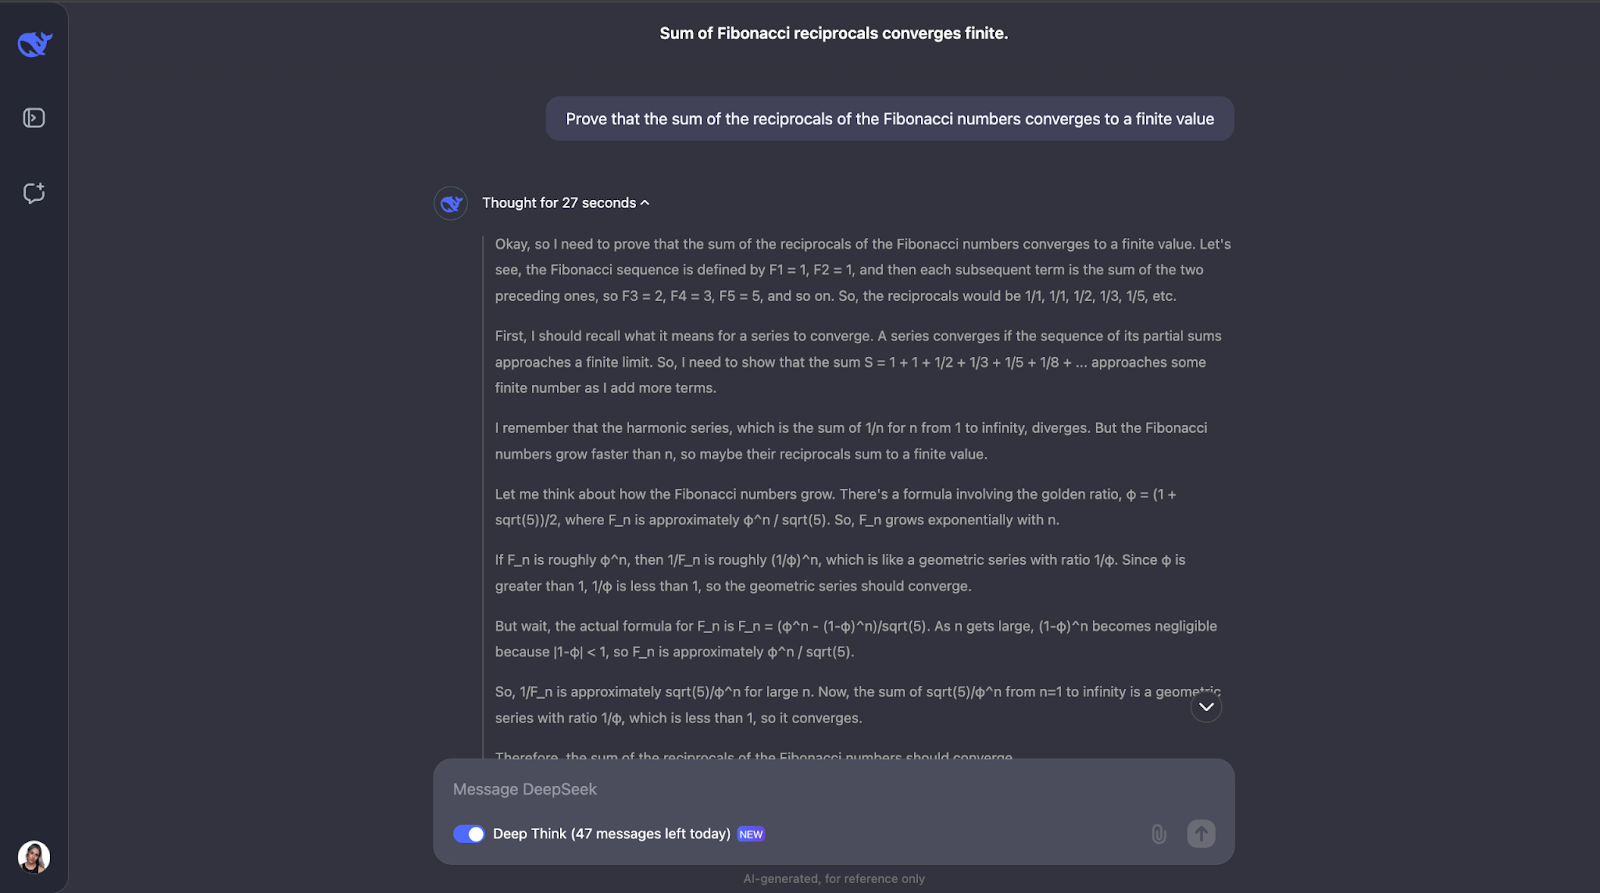
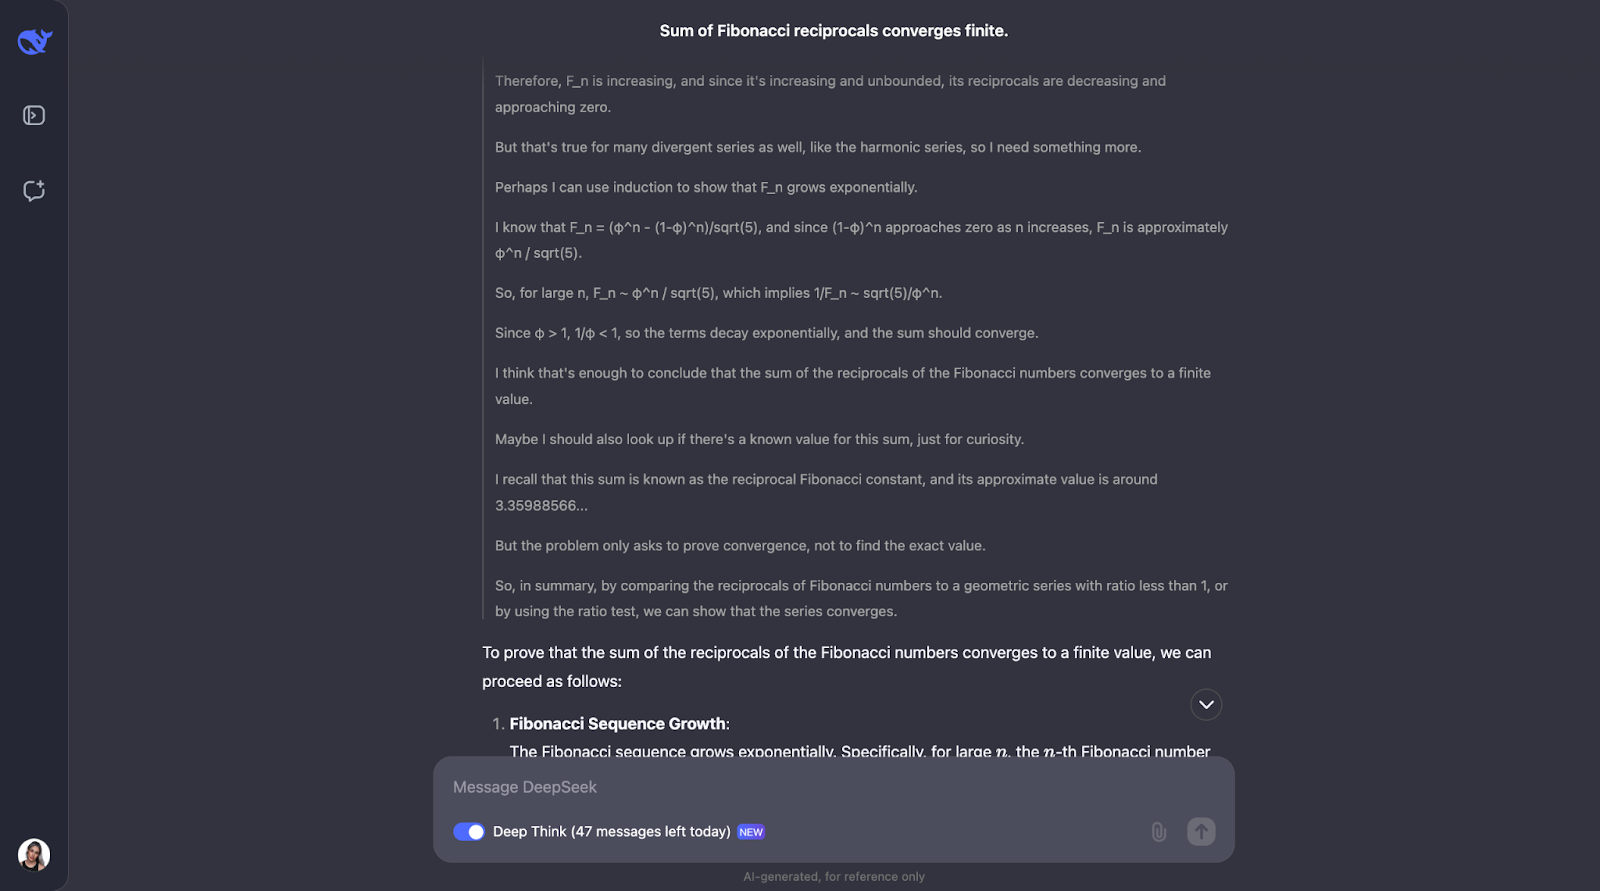
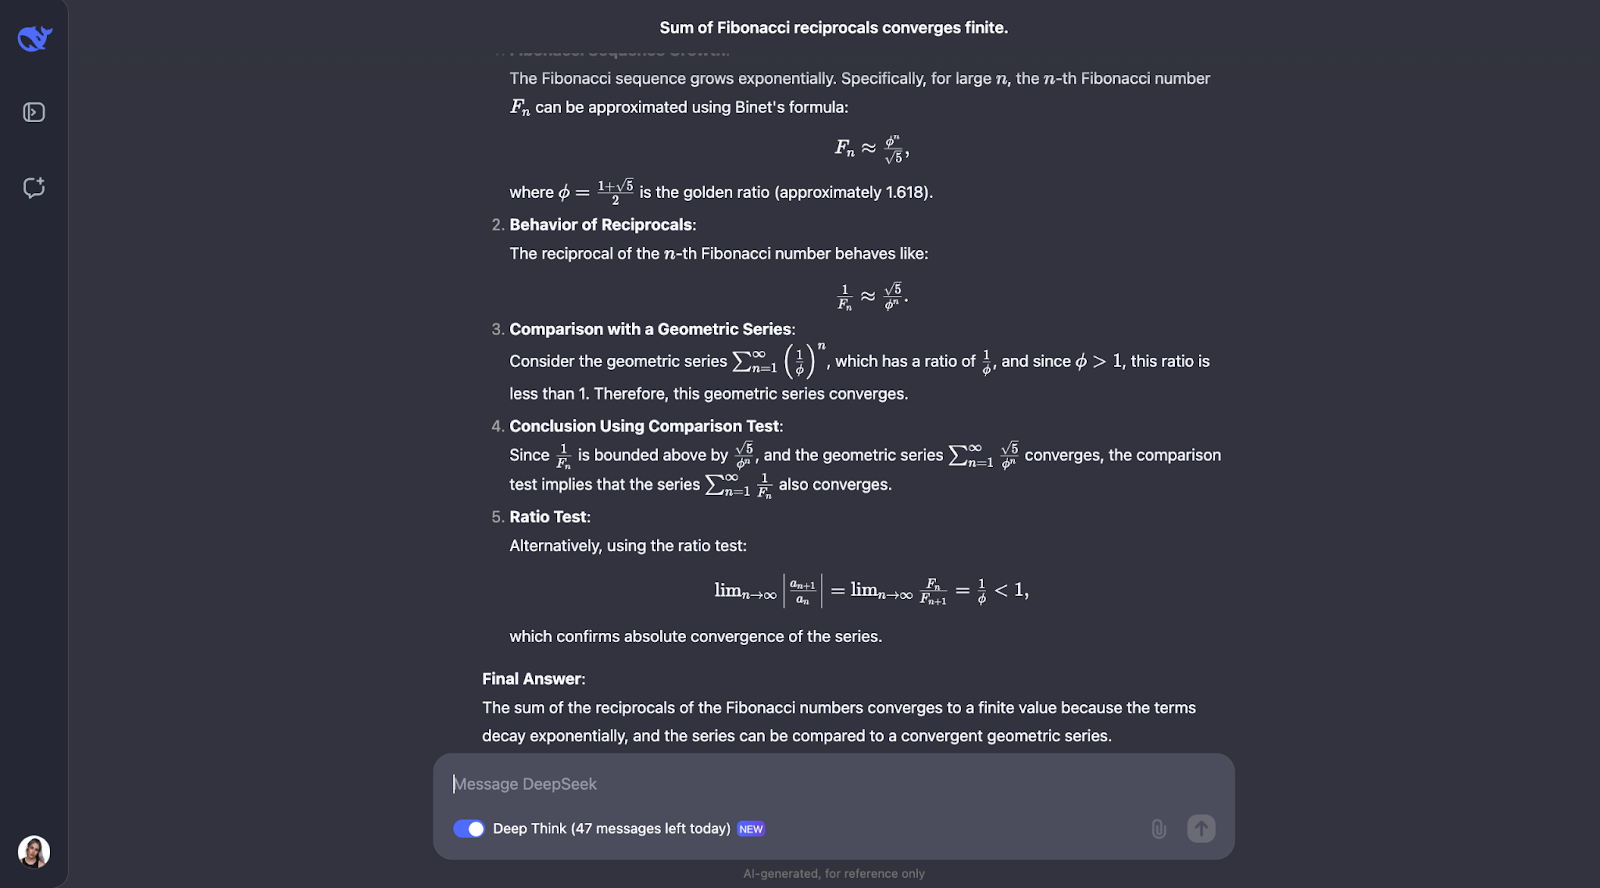
Được rồi, đây là một mạch suy luận rất tốt—tôi rất thích cách nó đầu tiên đảm bảo hiểu đúng các khái niệm then chốt như nghịch đảo và hội tụ. Sau đó, DeepSeek-R1-Lite-Preview tiếp cận bằng cách xem xét tốc độ tăng của Fibonacci và dùng phép so sánh, một cách phổ biến để kiểm tra chuỗi có hội tụ hay không.
Nó so sánh nghịch đảo của Fibonacci với một chuỗi hình học. Vì các nghịch đảo này giảm còn nhanh hơn một chuỗi hình học có công bội nhỏ hơn 1, mô hình kết luận tổng cũng hội tụ về giá trị hữu hạn. Để chắc chắn hơn, nó dùng thêm phép thử tỉ số.
Phép thử này kiểm tra giới hạn của tỉ số hai số hạng liên tiếp có nhỏ hơn 1 không. Nếu có, chuỗi hội tụ. Mô hình tính tỉ số này cho các nghịch đảo của Fibonacci và thấy nó thực sự nhỏ hơn 1.
Nó còn nhắc đến việc tổng này có một giá trị đã biết gọi là hằng số Fibonacci nghịch đảo, xấp xỉ 3,3598. Nhưng với bài này, ta chỉ cần biết tổng là hữu hạn, không cần giá trị chính xác—nên đây là thông tin thêm khá thú vị. Tôi rất thích cách lời giải được trình bày trong phần kết quả: rõ ràng và theo từng bước.
Đến lúc này, tôi ấn tượng với các tác vụ toán học.
Tôi sẽ thử một bài hình học vi phân—vì tiến sĩ của tôi thuộc lĩnh vực này nên không thể bỏ qua một bài test nhỏ. Không quá phức tạp, chỉ là một bài cổ điển mà sinh viên năm đầu có thể gặp.
“Xét một mặt S trong R³ được tham số hóa bởi
φ(u,v) = (u cos v, u sin v, ln u)
với u > 0 và 0 ≤ v < 2π.
a) Tính dạng cơ bản thứ nhất của S.
b) Xác định S có phải là mặt tối thiểu hay không.
c) Tìm độ cong Gaussian K và độ cong trung bình H của S.”
Tôi kỳ vọng DeepSeek-R1-Lite-Preview đưa ra lời giải từng bước, thể hiện đầy đủ phép tính và giải thích ý nghĩa của từng kết quả, cũng như định nghĩa các khái niệm chính như dạng cơ bản, mặt tối thiểu và các loại độ cong.
Để bài viết dễ đọc, tôi chỉ có thể hiển thị phần đầu và phần cuối câu trả lời, nhưng khuyến khích bạn tự thử gợi ý:
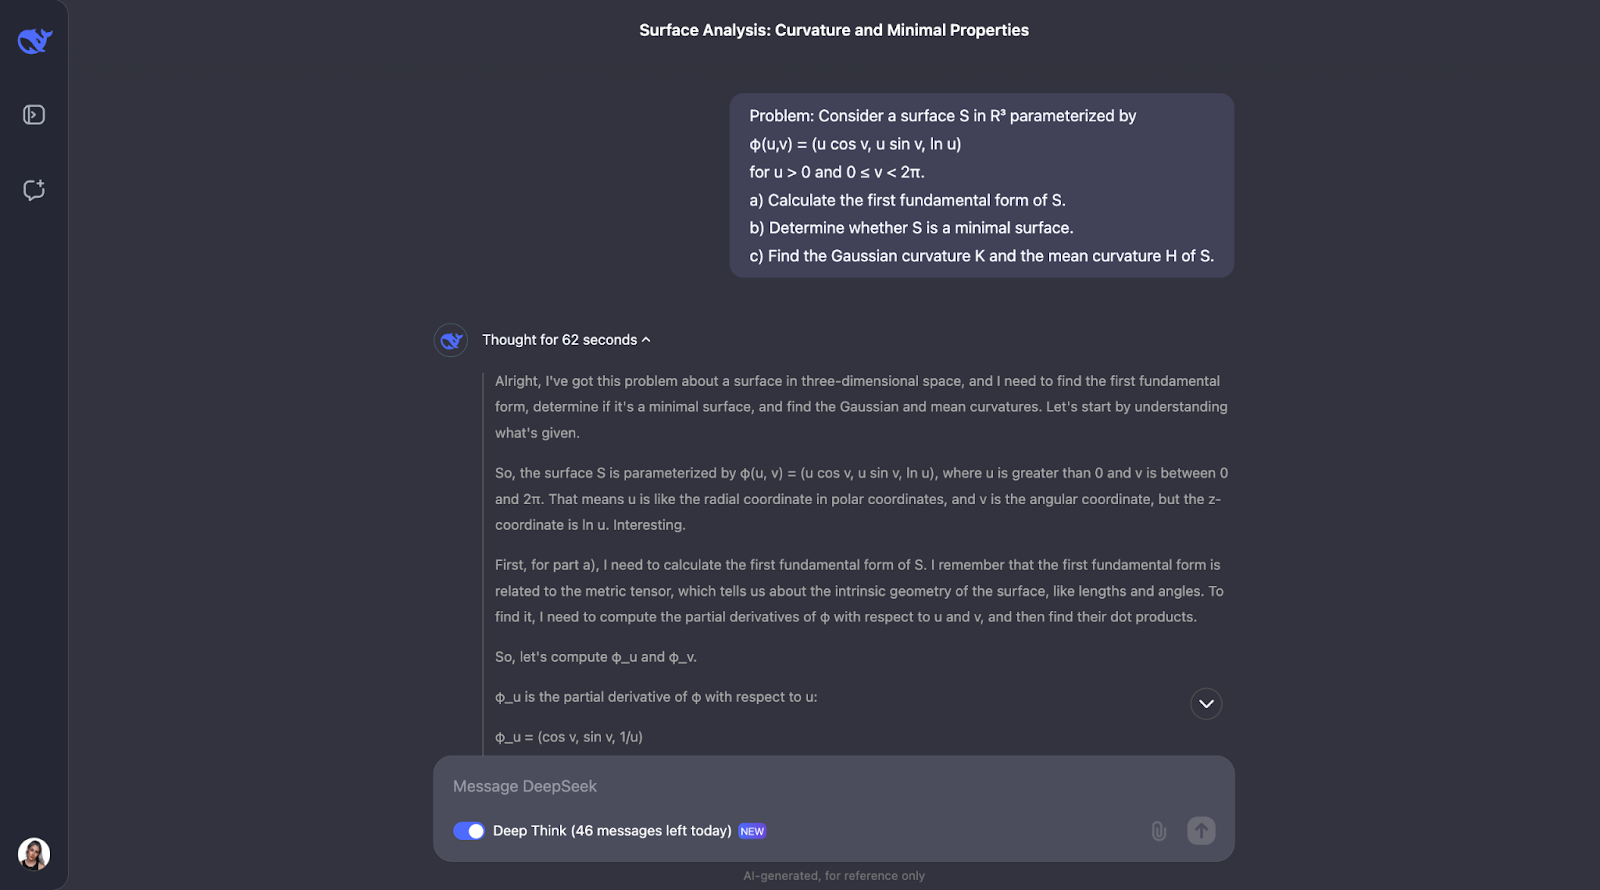
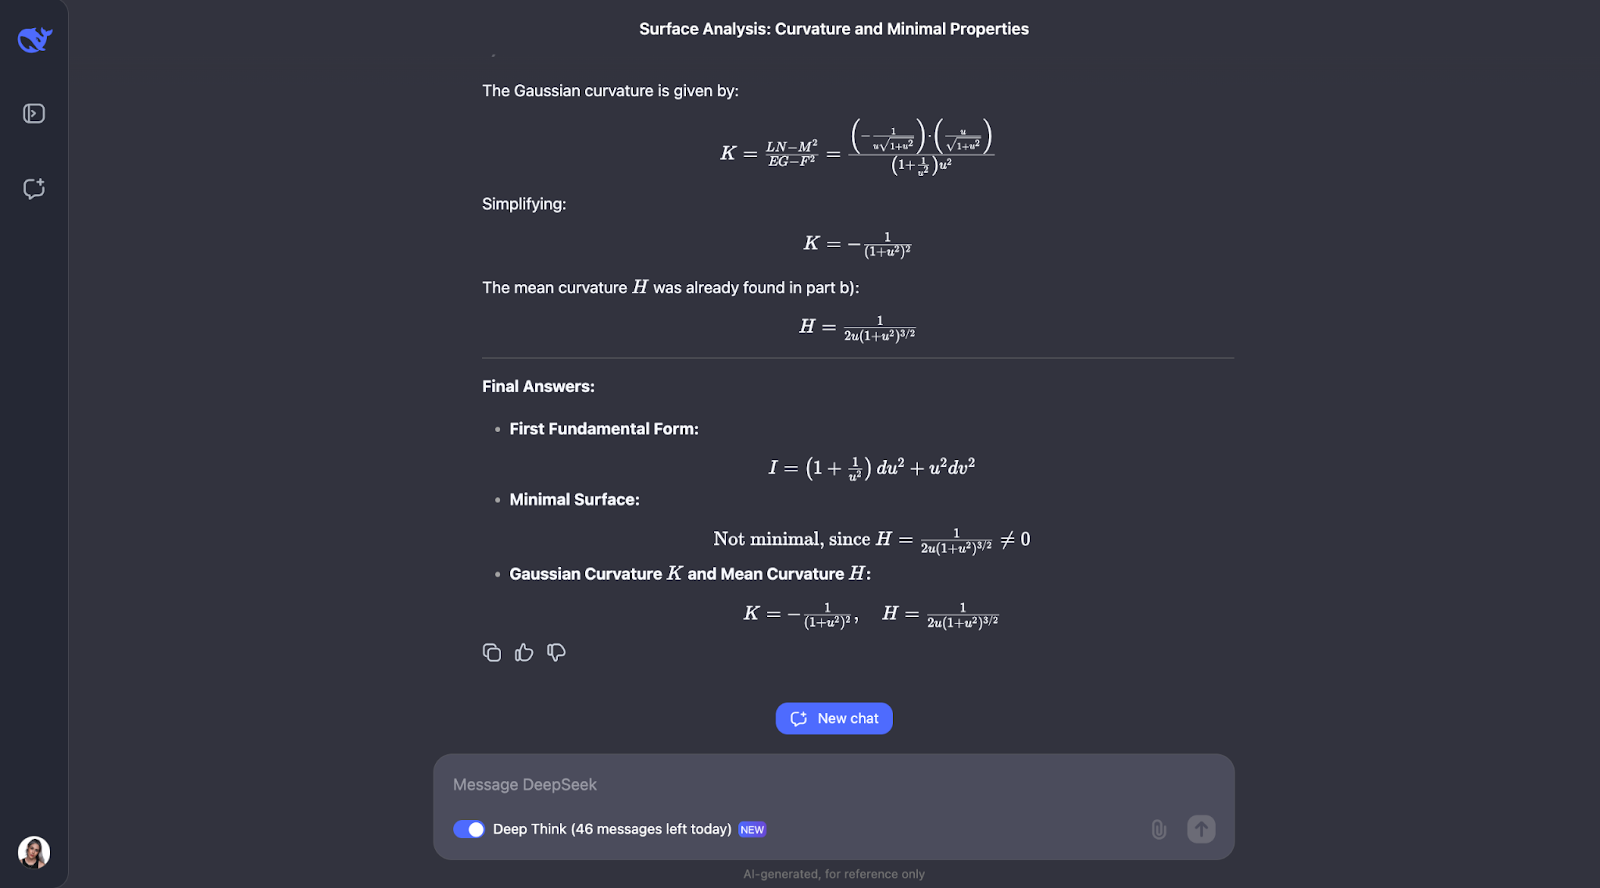
Cách tiếp cận từng bước sử dụng các công thức hình học quen thuộc và áp dụng trực tiếp, giúp mạch lập luận dễ theo dõi. Tuy nhiên, tôi kỳ vọng nó sẽ tự kiểm tra hiểu biết về các khái niệm chính trong bài, điều này không xuất hiện trong mạch suy nghĩ. Ở phần B, nó chọn cách khác và nhận diện mặt là mặt tròn xoay, khá thú vị.
Cũng có lúc nó bàn về phép quay và nhận ra mình đã có N, vectơ pháp tuyến, có thể gây xung đột với ký hiệu hệ số của dạng cơ bản thứ hai. Tôi muốn thấy đề xuất ký hiệu tốt hơn, vì dùng cùng một chữ cho hai thứ là không hay!
Khi tính độ cong trung bình, nó nhận thấy kết quả không bằng 0 và nghi ngờ phép tính. Để cẩn thận, nó thử phương pháp khác để kiểm tra chéo.
Một lần nữa, phần kết quả rất rõ ràng và dễ theo dõi. Qua tất cả ví dụ, thật ấn tượng khi thấy nó liên tục kiểm tra chéo phép tính bằng các phương pháp khác nhau. Quá trình suy nghĩ luôn chi tiết, logic và dễ hiểu!
Giờ hãy chuyển sang các bài kiểm tra mã hóa.
Bài đầu tiên tôi sẽ thử là:
“Cài đặt một hàm trong Python để tìm xâu con đối xứng (palindromic) dài nhất trong một chuỗi cho trước. Hàm nên có độ phức tạp thời gian tốt hơn O(n^3).”
Tôi muốn đánh giá khả năng thiết kế thuật toán hiệu quả và triển khai bằng mã của mô hình. Tôi kỳ vọng một lời giải dùng quy hoạch động hoặc thuật toán Manacher, kèm giải thích rõ ràng về cách tiếp cận và phân tích độ phức tạp thời gian.
Kết quả rất rất dài, và tôi chỉ hiển thị phần đầu và phần cuối:
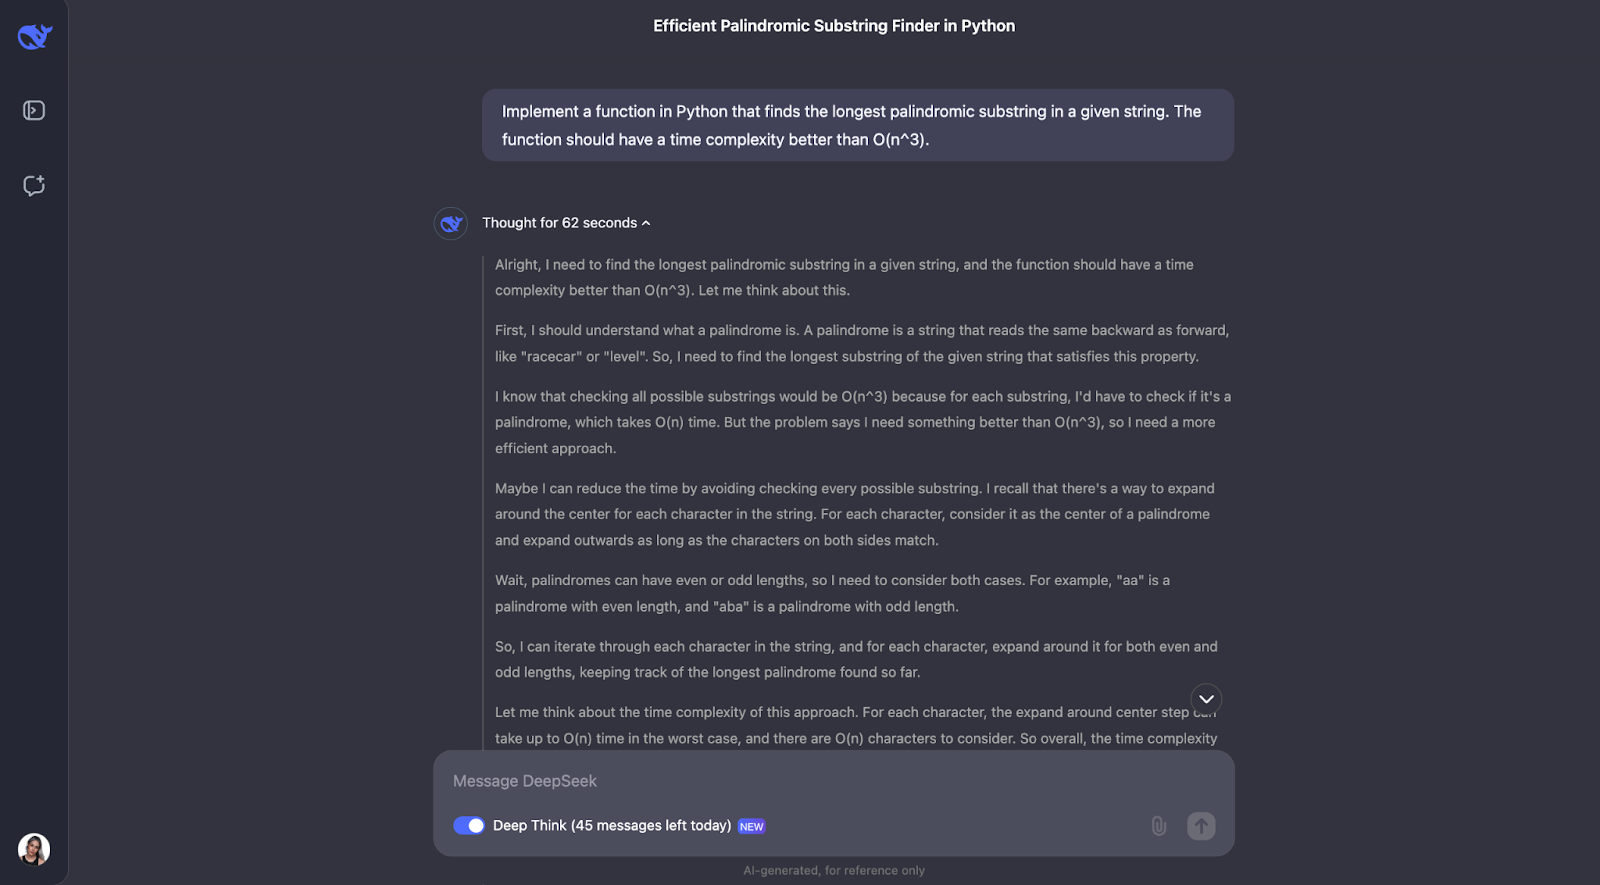
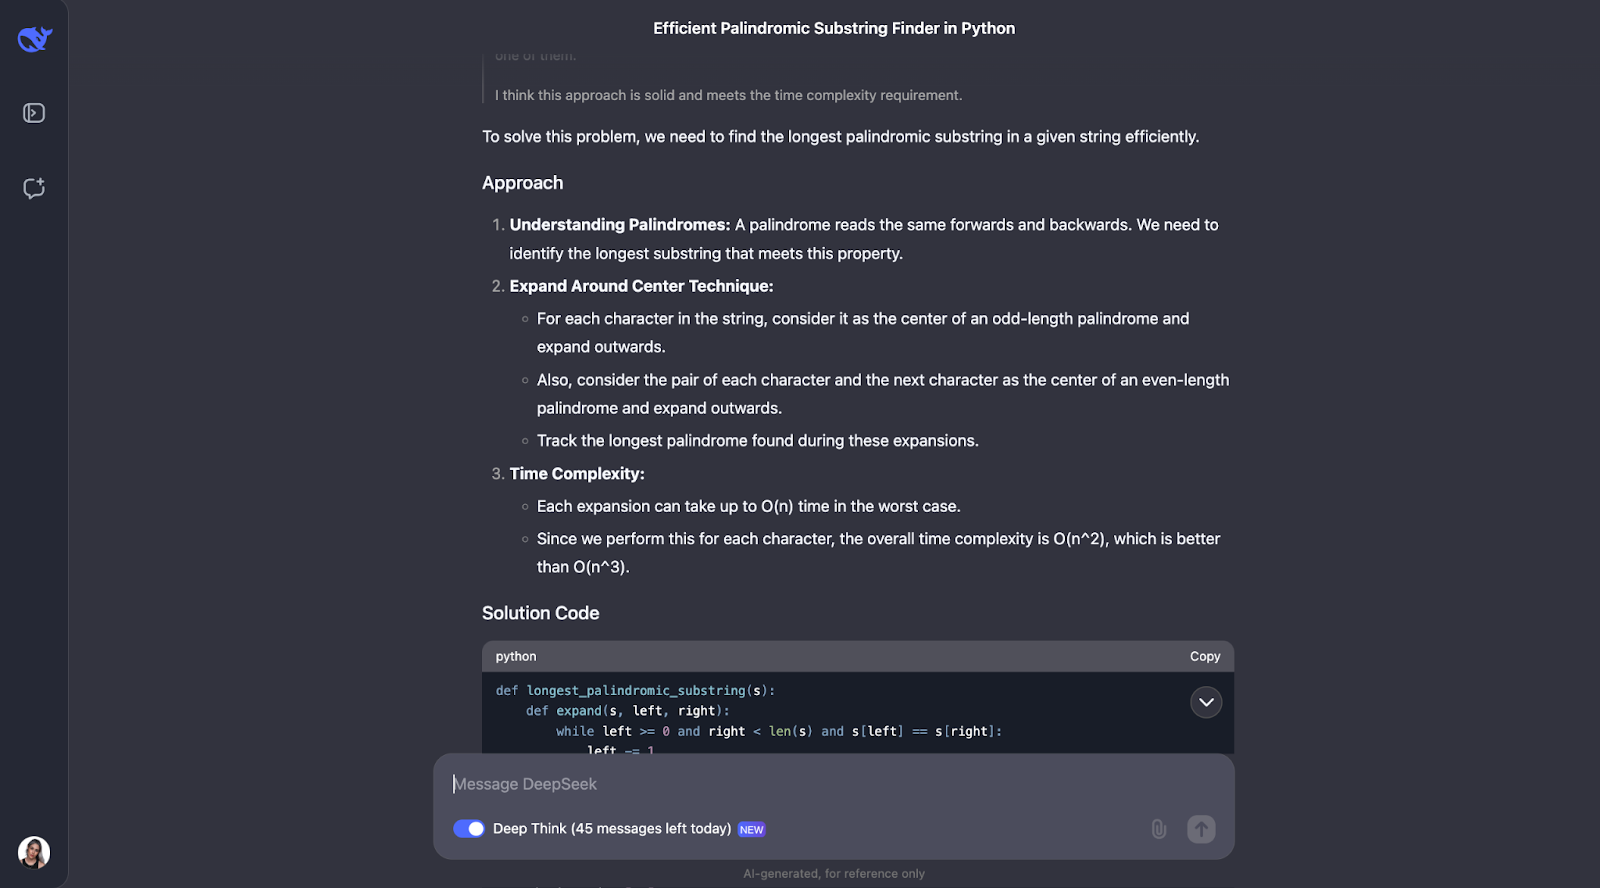
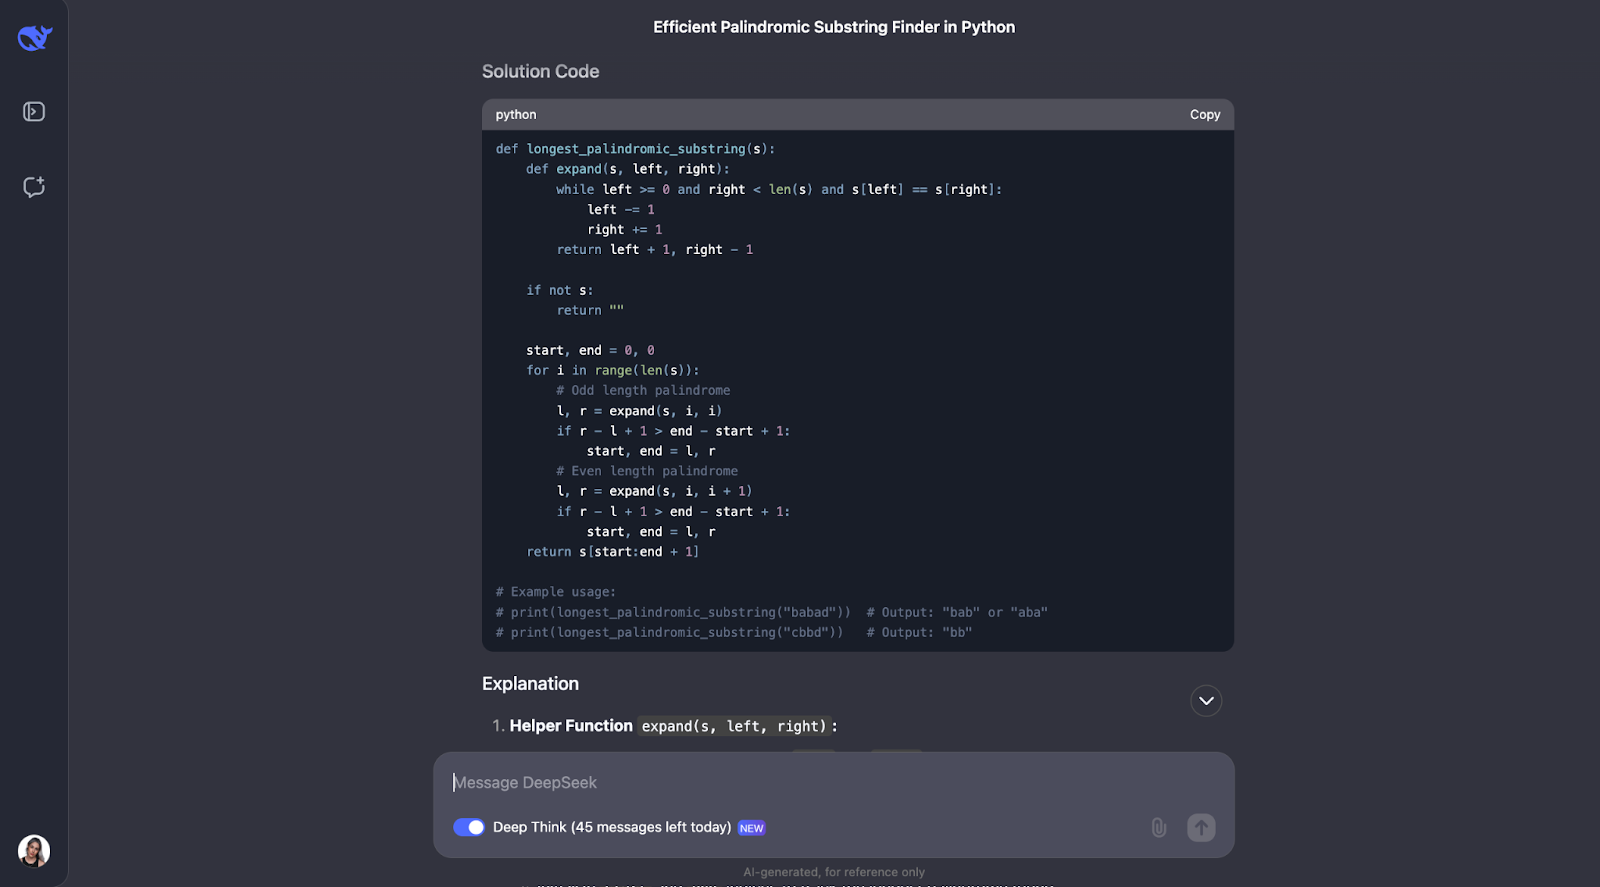
Tôi nghĩ mô hình đã làm rất tốt khi giải bài toán tìm xâu con đối xứng dài nhất. Cách tiếp cận thông minh, hiệu quả và giải thích rõ ràng.
Thay vì thử mọi xâu con có thể có (rất chậm), nó dùng kỹ thuật “mở rộng quanh tâm”. Cách này xử lý cả palindrome độ dài lẻ như "aba" và độ dài chẵn như "abba". Nó theo dõi xâu dài nhất tìm được khi duyệt. Kết quả là thuật toán chạy trong O(n^2), nhanh hơn nhiều so với O(n^3).
Điều khiến tôi ấn tượng nhất là cách trình bày rất rõ ràng. DeepSeek phân rã vấn đề thành các bước dễ hiểu, giải thích tỉ mỉ mạch suy nghĩ và còn đưa ví dụ thực tế. Chẳng hạn, nó cho thấy thuật toán mở rộng quanh tâm của "racecar" hay "abba" để tìm palindrome. Hàm phụ để mở rộng quanh tâm theo tôi là rất hay—giúp mã có cấu trúc và dễ theo dõi.
Tuy vậy, tôi kỳ vọng nó sẽ cân nhắc thuật toán Manacher, nhanh hơn với O(n). Chắc chắn khó triển khai hơn, nhưng hữu ích khi yêu cầu hiệu năng cao, và tôi mong mô hình sẽ chỉ ra điều này.
Tôi cũng nhận thấy phần kết quả không nói rõ cách thuật toán xử lý các trường hợp đặc biệt, như chuỗi rỗng hoặc chuỗi toàn ký tự giống nhau (ví dụ, "aaaa"). Các trường hợp này vẫn chạy được—nhưng tôi mong nó sẽ bàn qua ít nhất.
Cuối cùng, tôi thấy hay khi nó bình luận về đầu ra kỳ vọng cho ví dụ sử dụng. Tuy nhiên, khi tôi chạy, chỉ tùy chọn đầu tiên của ví dụ thứ nhất được in ra. Sẽ tuyệt hơn nếu mã xét tất cả phương án và in ra toàn bộ.
Hãy thử một bài mã hóa khác ở ngôn ngữ khác.
“Viết một hàm trong JavaScript xác định một số cho trước có phải số nguyên tố hay không”
Để dễ đọc, tôi chỉ hiển thị phần đầu và phần cuối (dù mạch suy nghĩ lần này ngắn hơn một chút):
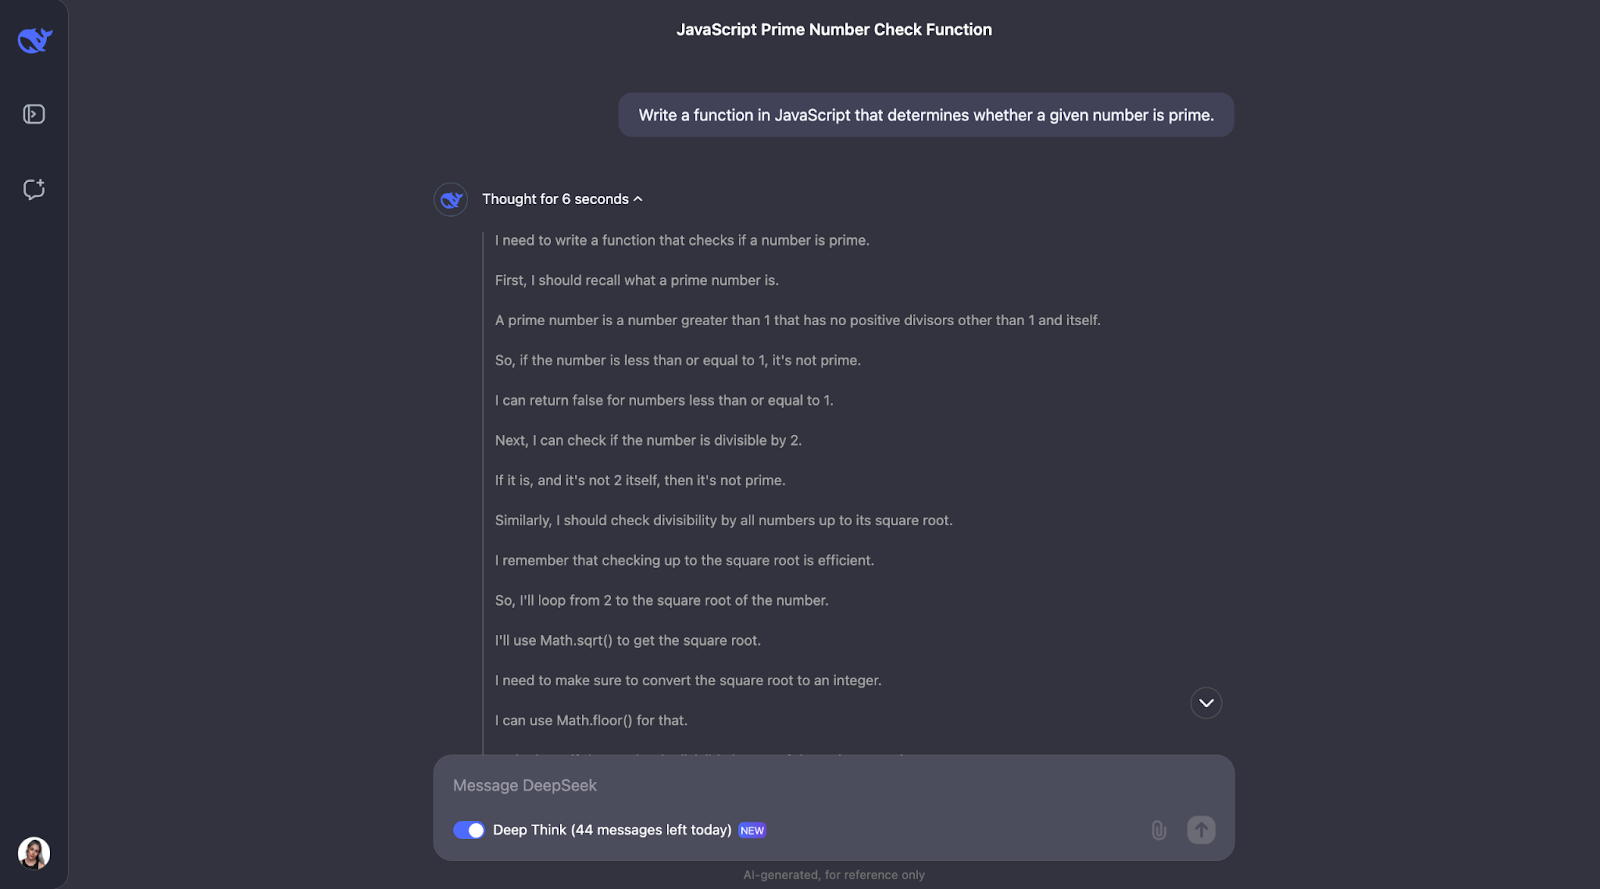
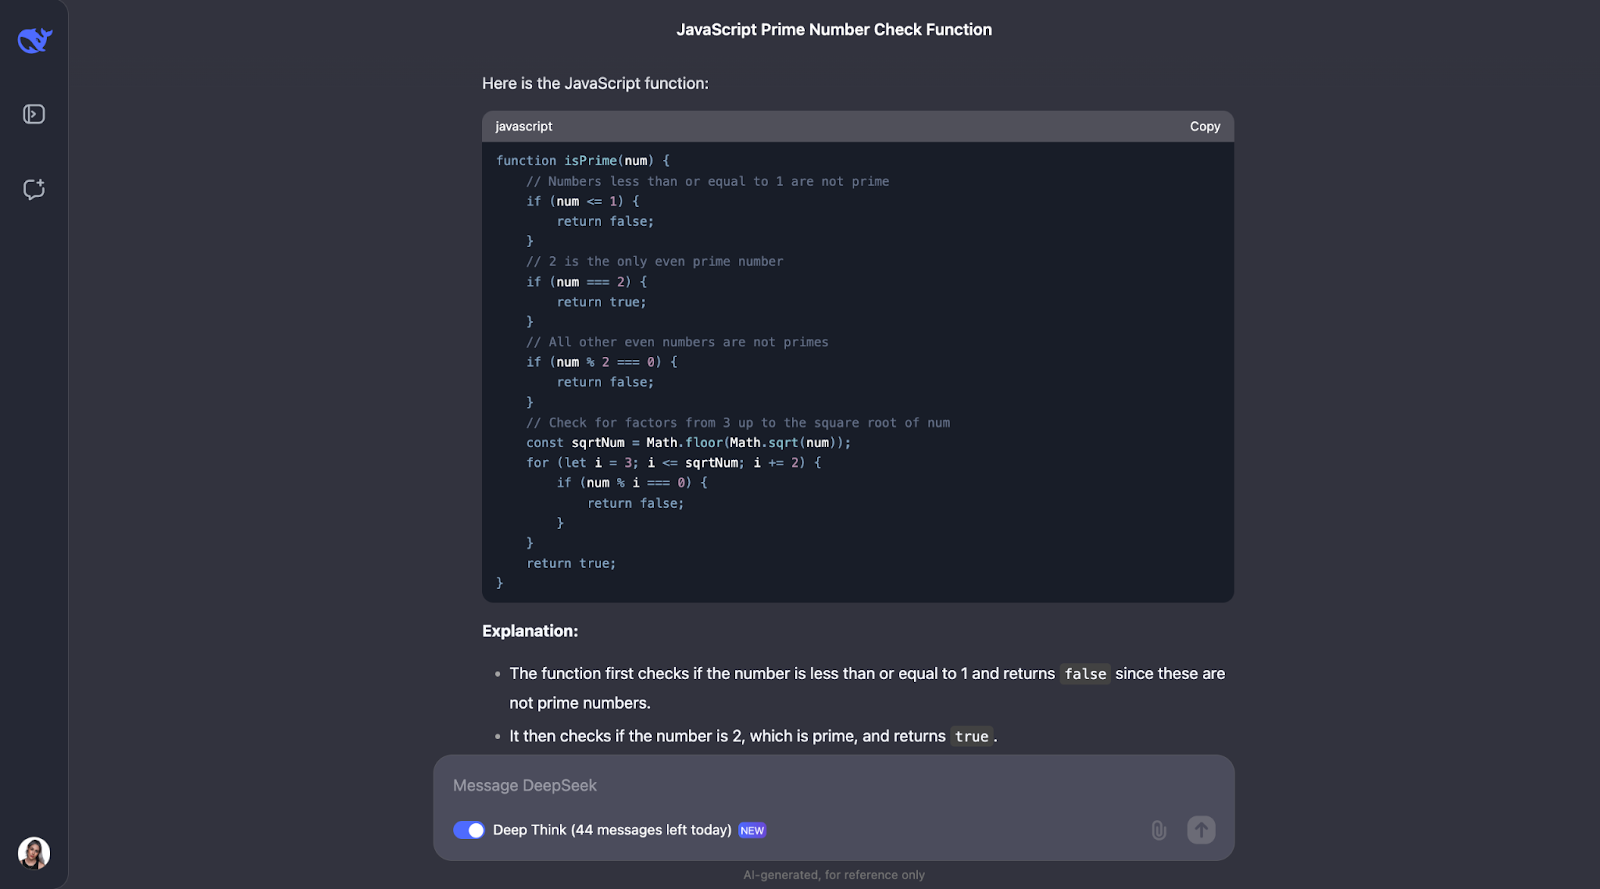
Tôi nghĩ có thể thấy một khuôn mẫu cho mạch suy nghĩ. Phần lớn thời gian, nó bắt đầu bằng việc định nghĩa các khái niệm then chốt xuất hiện trong bài. Ví dụ, với bài này, nó định nghĩa số nguyên tố là gì.
Sau đó, mạch suy nghĩ có lý và đi tới các bước tối ưu. Trước hết là cơ bản: các số nhỏ hơn hoặc bằng 1 không phải nguyên tố, và 2 là số chẵn nguyên tố duy nhất. Từ đó, nó kiểm tra xem số có chia hết cho số lẻ nào tới căn bậc hai của số hay không. Điều này tiết kiệm thời gian vì tránh tính toán không cần thiết. Ngoài ra, thay vì thử mọi số, nó bỏ qua tất cả số chẵn sau 2, giúp nhanh hơn nữa. Hàm dùng Math.sqrt để lấy căn bậc hai, giới hạn phạm vi cần kiểm tra, giữ cho thuật toán hiệu quả và đơn giản.
Giống bài trước, nó cũng kiểm thử với ví dụ nhỏ—các số nguyên tố và không nguyên tố đã biết—để đảm bảo hoạt động như kỳ vọng.
Vẫn còn chỗ cải thiện. Ví dụ, hàm chưa kiểm tra đầu vào có thực sự là số hay không, nên có thể xử lý lỗi tốt hơn. Nó cũng có thể thêm lối tắt cho các số tận cùng bằng 0 hoặc 5—rõ ràng không phải nguyên tố (trừ chính số 5). Thêm chút giải thích vì sao bỏ qua số chẵn hoặc chỉ kiểm đến căn bậc hai cũng sẽ giúp người mới hiểu hơn, theo tôi.
Cuối cùng, tôi kỳ vọng mã có vài kiểm thử ví dụ sử dụng, giống như phần Python ở bài trước.
Giờ hãy chuyển sang các bài kiểm tra lập luận logic.
Tôi sẽ thử một câu đố kinh điển:
"Một người đàn ông phải qua sông cùng một con sói, một con dê và một cây bắp cải. Thuyền của ông chỉ chở được ông và một thứ khác. Nếu để một mình, sói sẽ ăn dê, và dê sẽ ăn bắp cải. Làm thế nào để đưa tất cả qua sông an toàn?"
Tôi kỳ vọng mô hình đưa ra câu trả lời sau:
Nhưng hãy xem nó xử lý mạch suy nghĩ thế nào, vì tôi cũng không chắc sẽ ra sao!
Tôi cũng cần rút gọn đầu ra lần này cho dễ đọc:
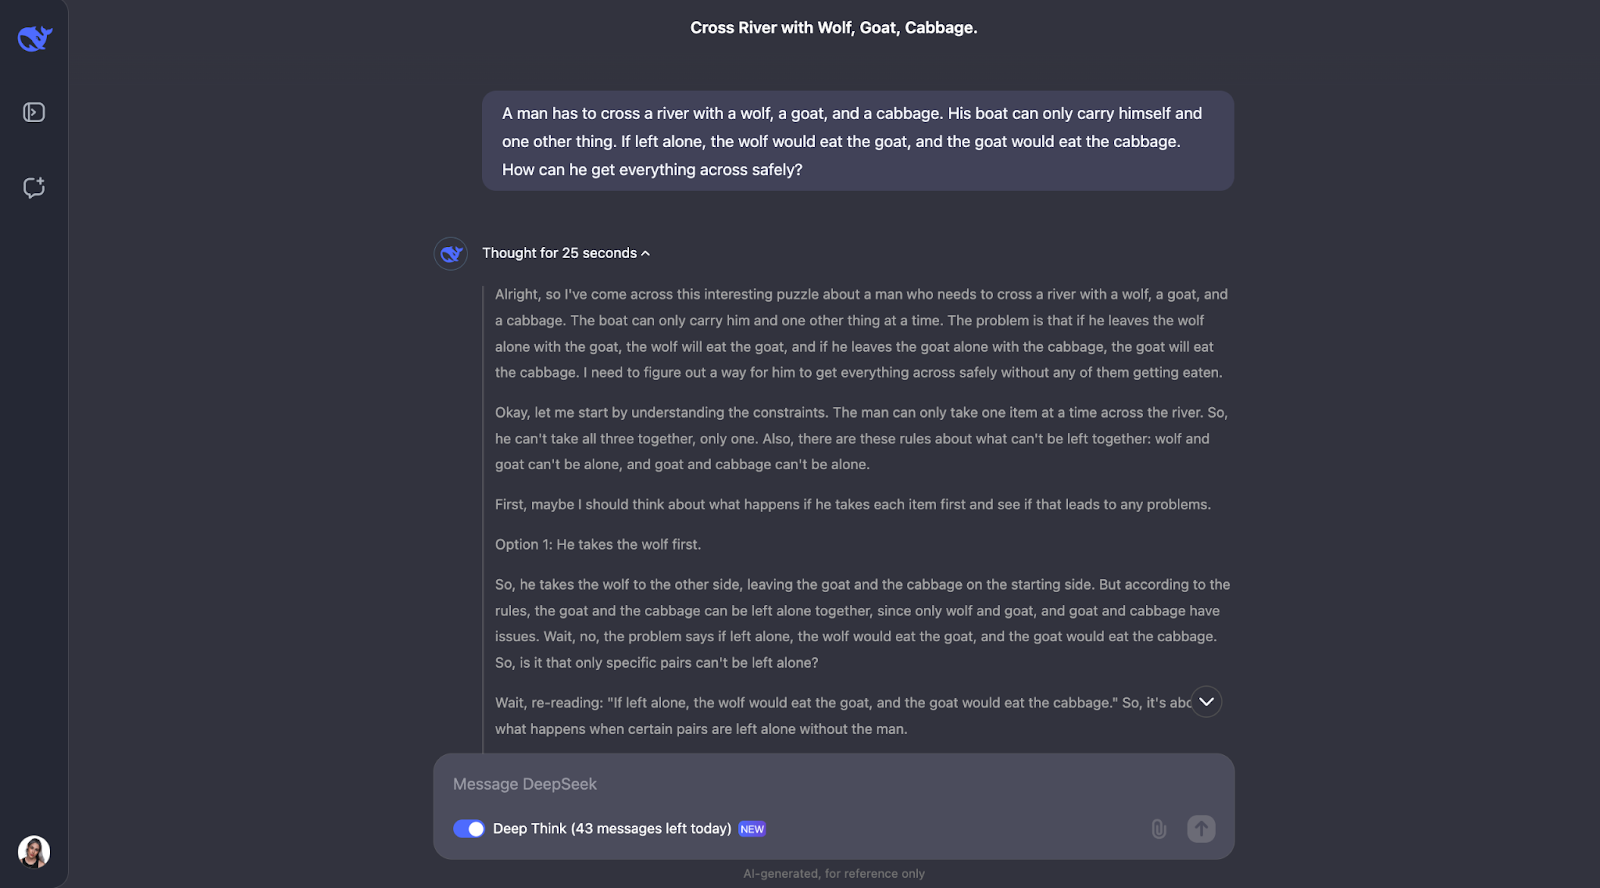
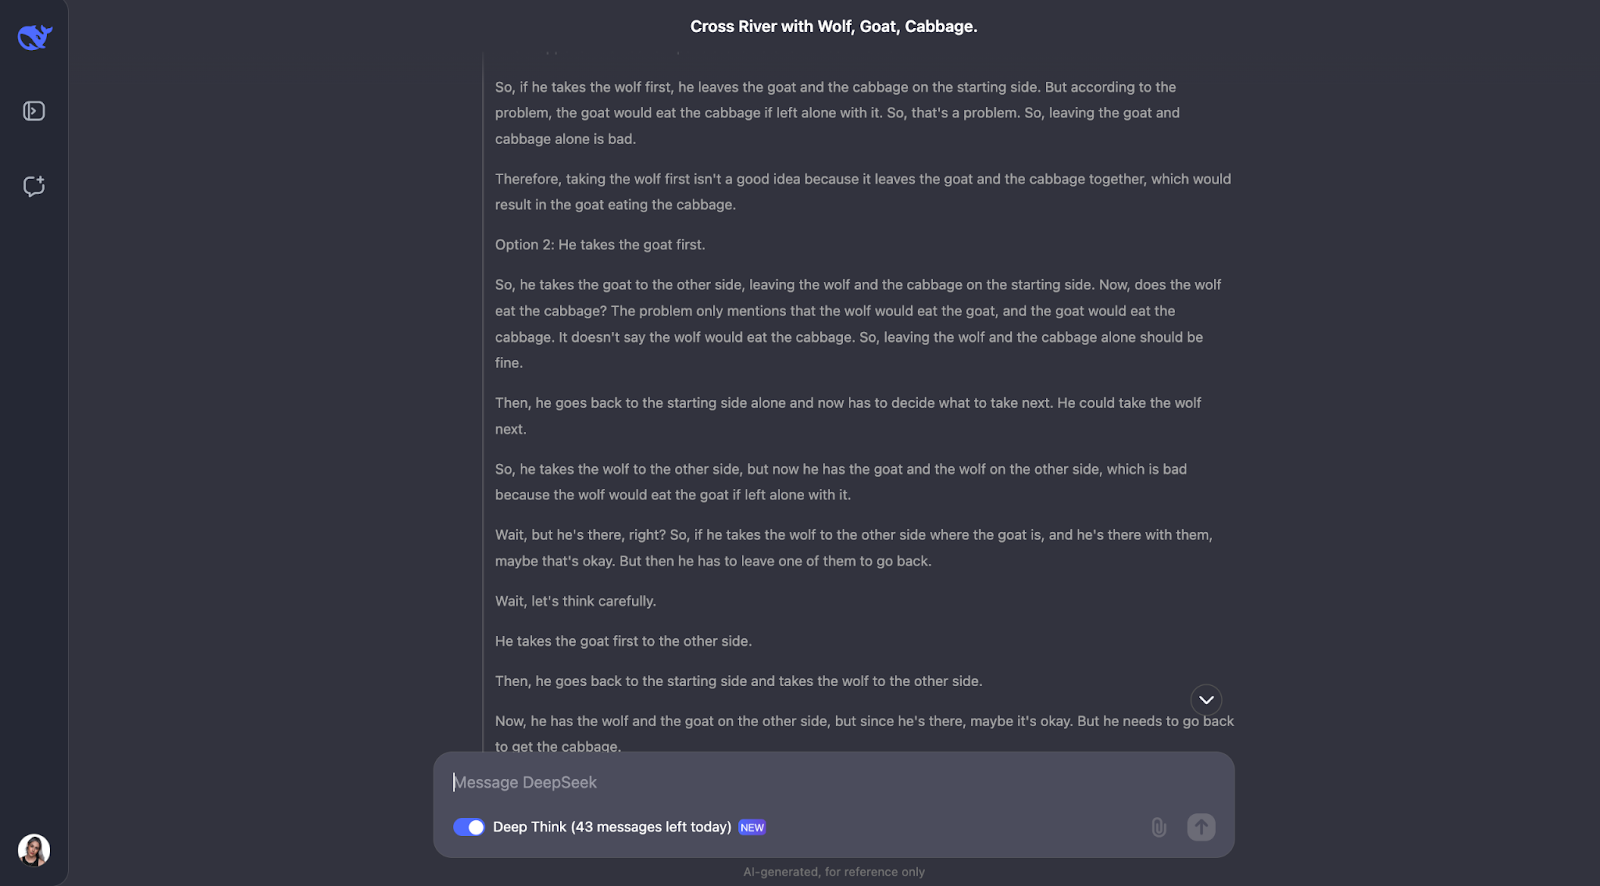
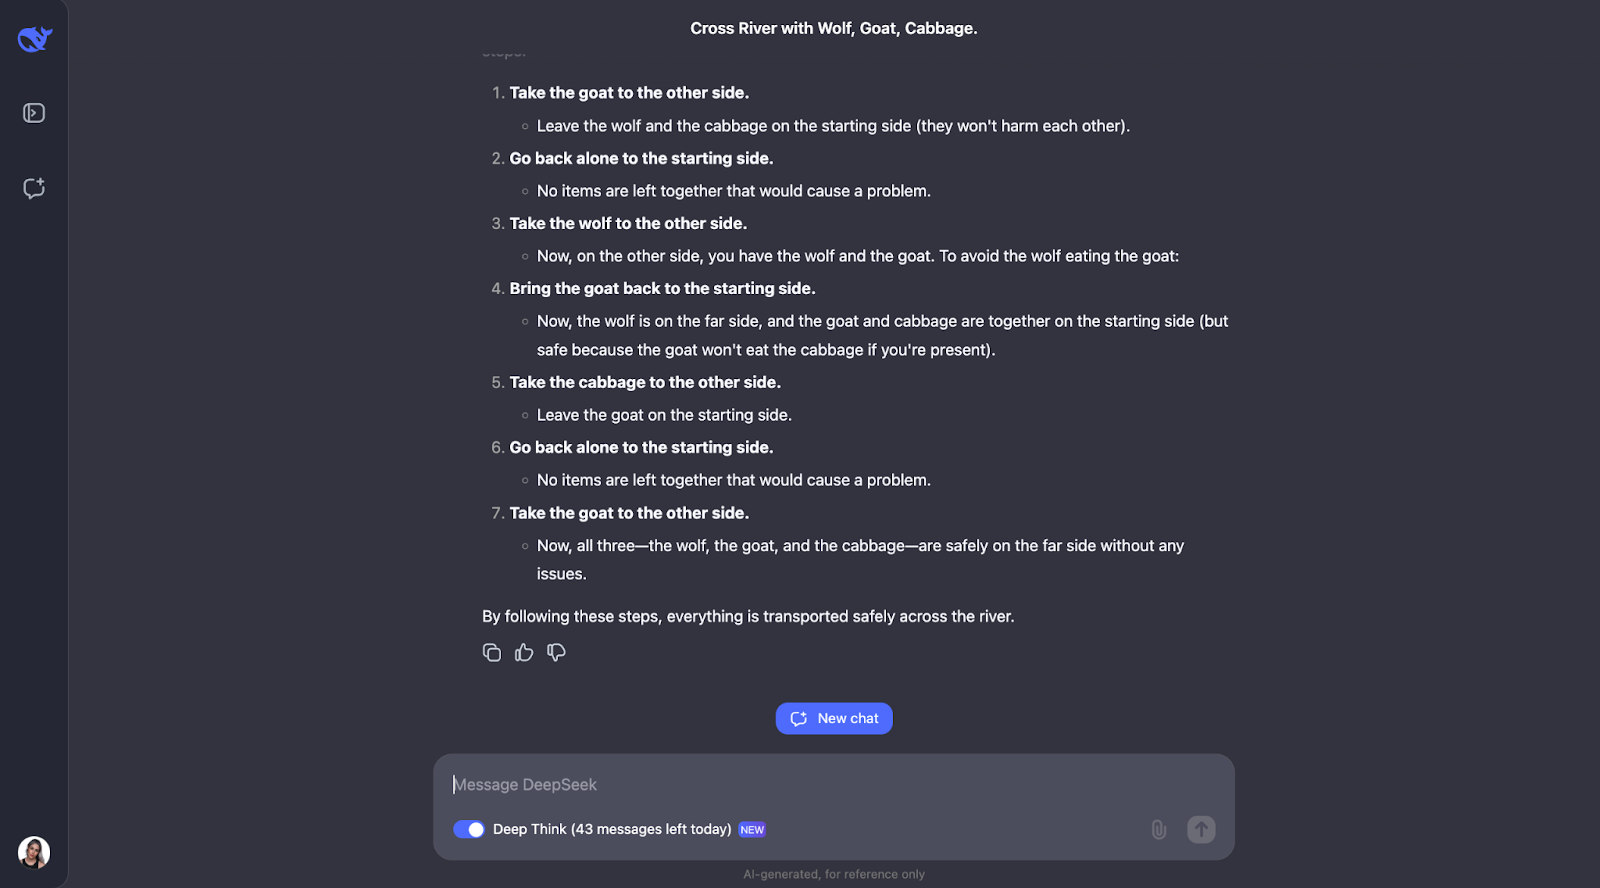
Mô hình làm rất tốt khi giải câu đố qua sông kinh điển này. Nó suy xét cẩn thận các quy tắc và kiểm tra nhiều khả năng. Nó hiểu rằng một số cặp như sói–dê hoặc dê–bắp cải không thể để lại với nhau. Nó cũng rà soát các ràng buộc ngay từ đầu. Từ đó, nó xem xét nếu người đàn ông đưa từng món sang trước thì điều gì sẽ xảy ra và liệu có gây vấn đề không.
Điều tôi thấy hay là mô hình điều chỉnh kế hoạch khi có phương án không ổn. Ví dụ, khi thử chở sói trước rồi nhận ra gây rắc rối, nó suy nghĩ lại các bước. Cách thử–sai này khá giống với cách con người chúng ta tự giải câu đố.
Cuối cùng, mô hình đưa ra lời giải đúng và giải thích rõ ràng theo từng bước.
Thử thêm một câu nữa:
“Bạn có 12 viên bi, nhìn giống hệt nhau. Một viên nặng hơn hoặc nhẹ hơn những viên còn lại. Dùng cân đĩa, hãy tìm viên khác biệt và xác định nó nặng hơn hay nhẹ hơn chỉ với ba lần cân.”
Câu đố logic kinh điển này kiểm tra khả năng xây dựng chiến lược tối ưu dựa trên suy luận diễn dịch. Hãy xem kết quả. Lần này đầu ra rất rất dài, nên tôi sẽ chuyển thẳng tới đáp án:
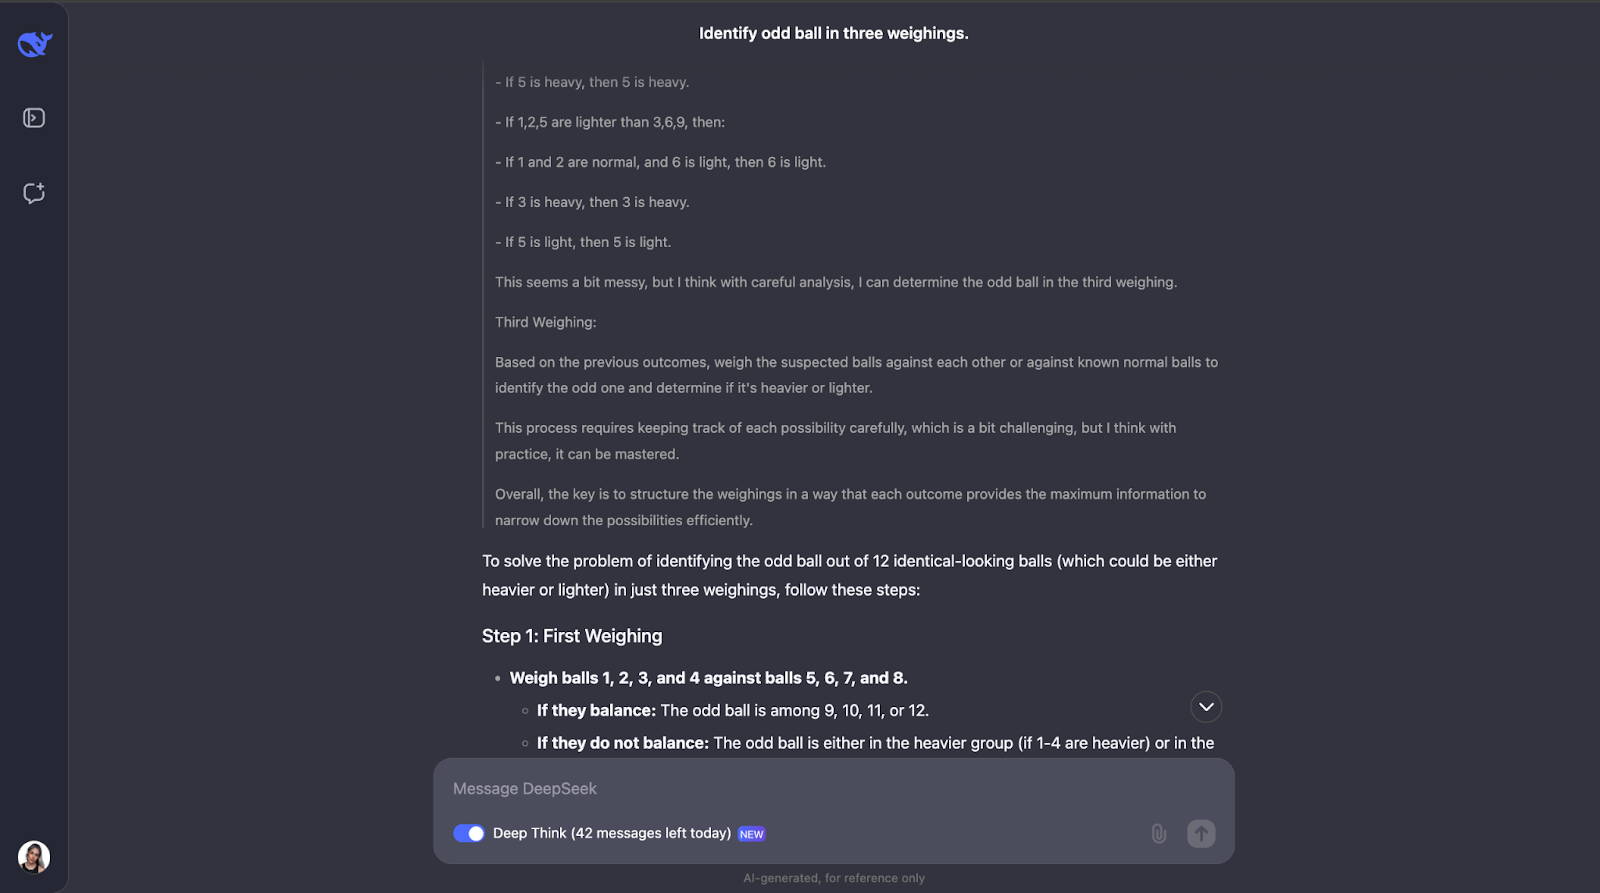
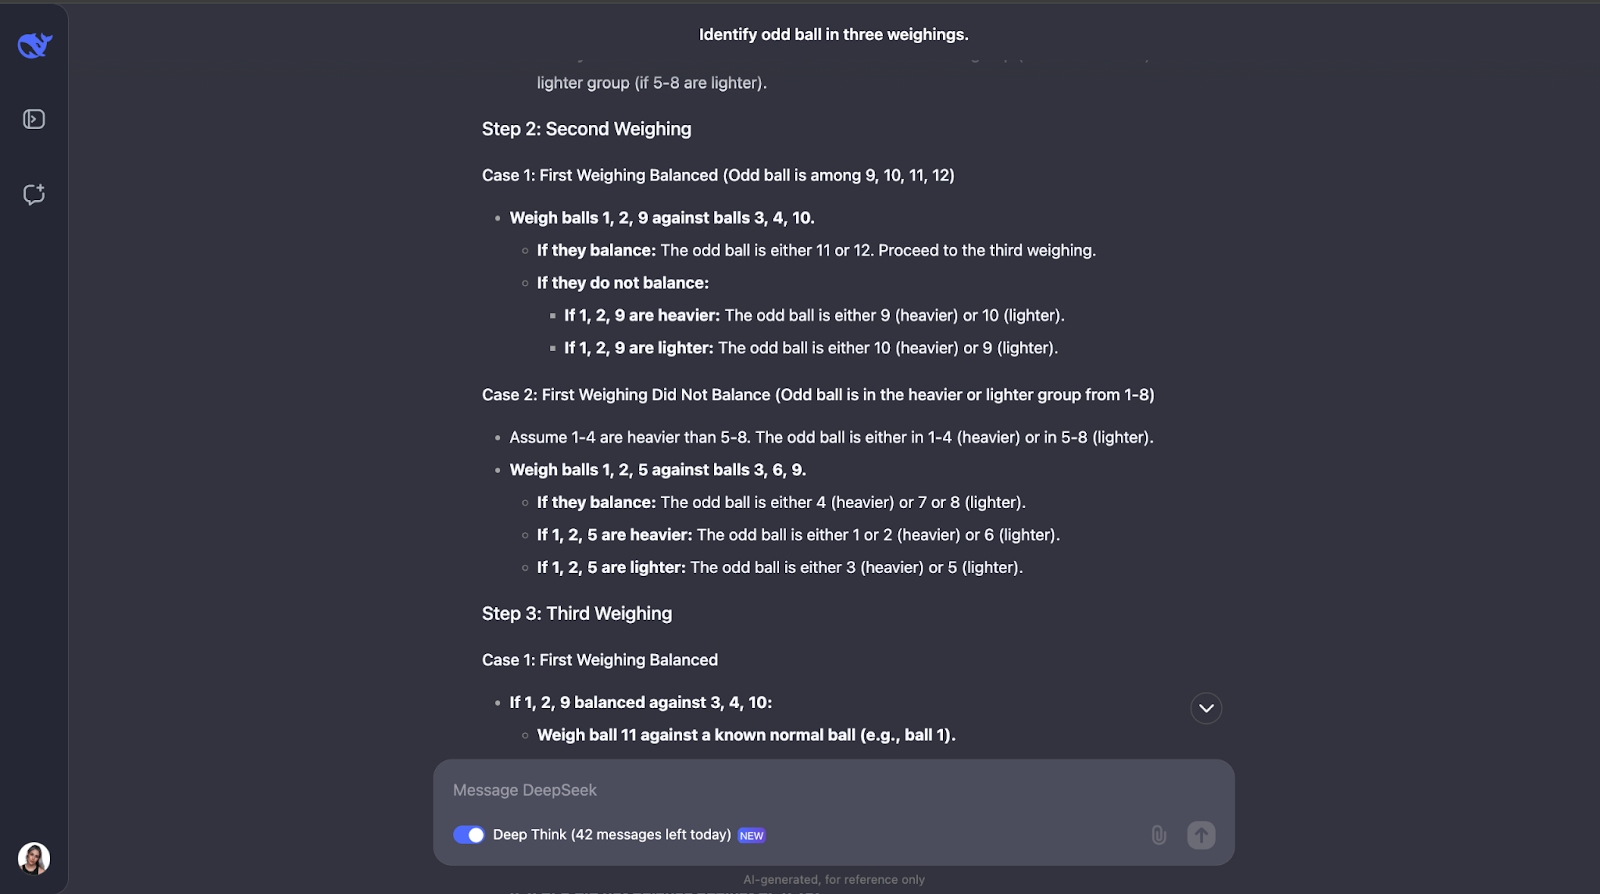
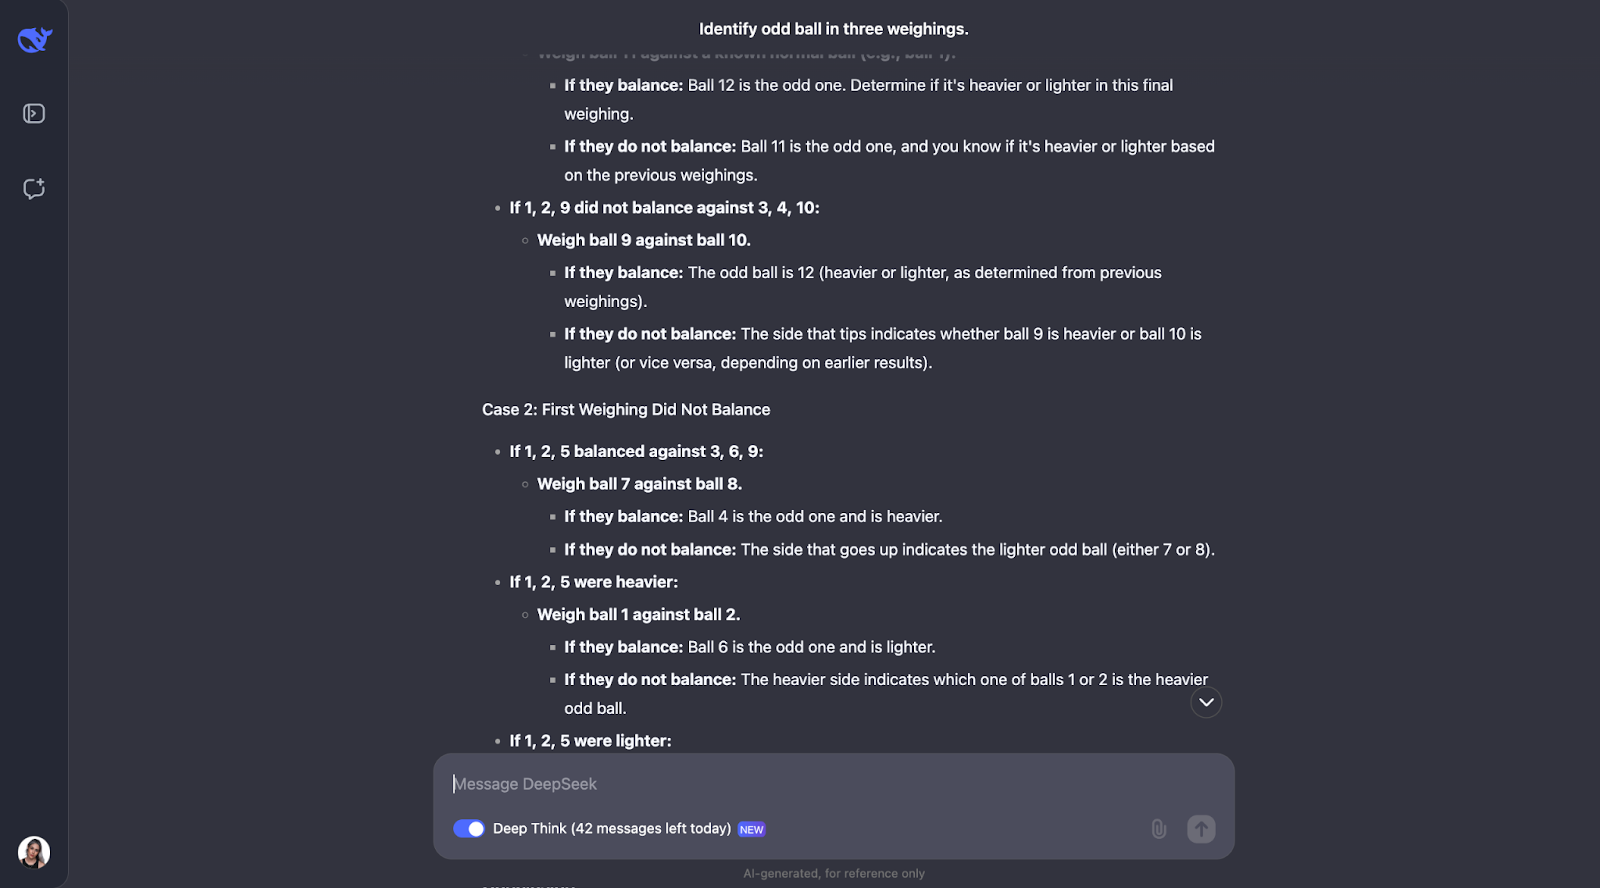
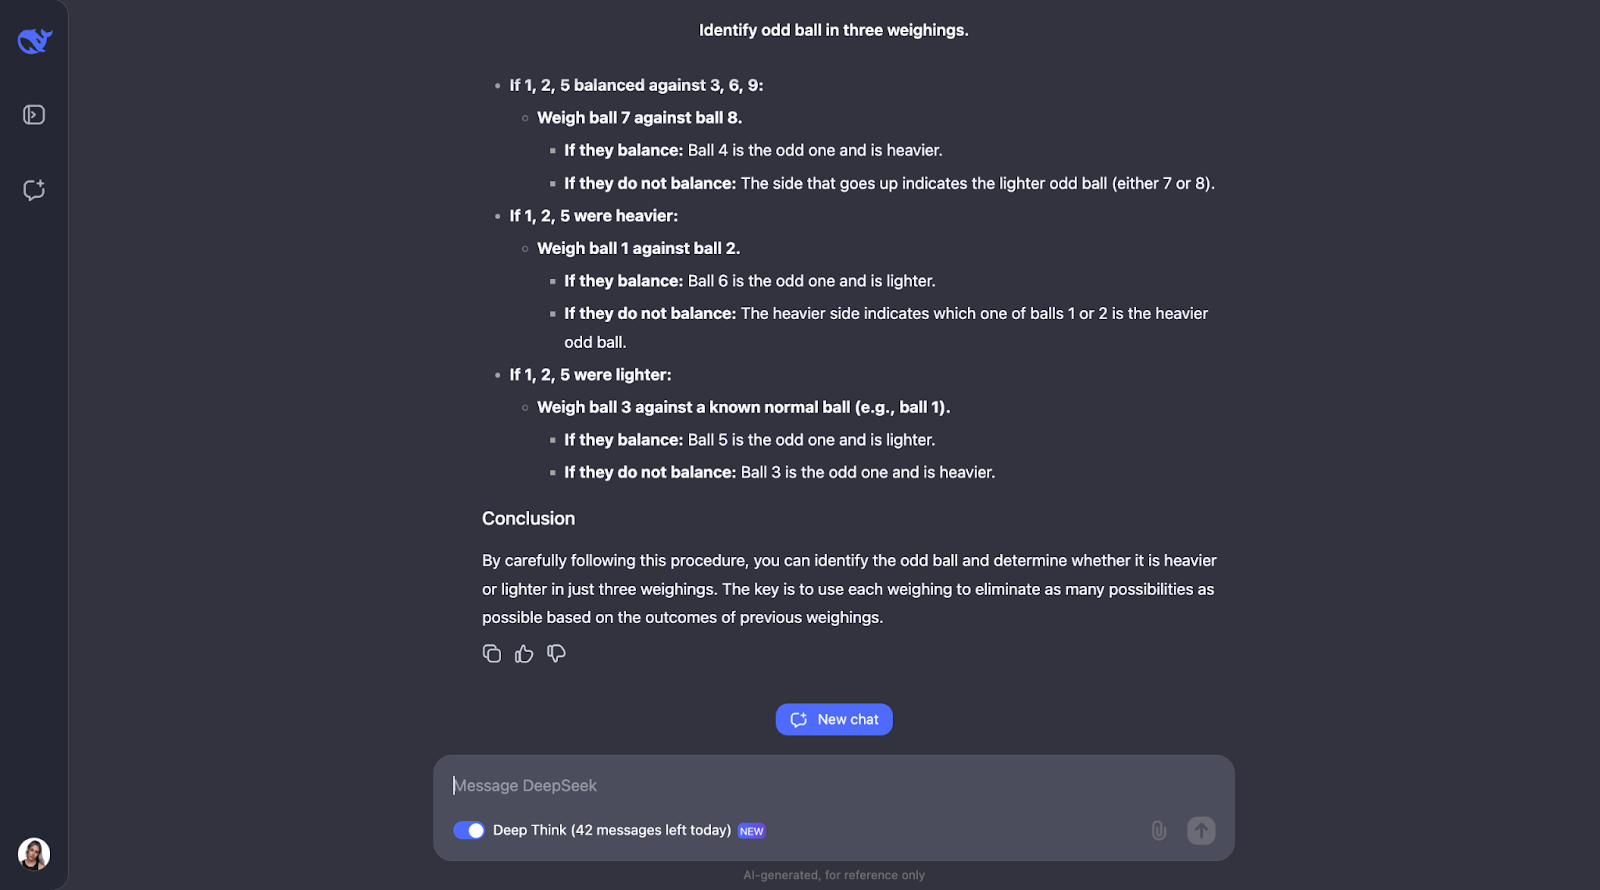
Lại thêm một lần tôi đã đánh giá thấp độ dài của đầu ra! Mô hình nhận ra rằng để giải câu đố này cần lập kế hoạch cẩn thận vì bạn chỉ có ba lần cân. Nó cũng tính số kết quả có thể xảy ra và số tình huống.
Cách tiếp cận của mô hình thông minh vì mỗi lần cân đều loại trừ được nhiều khả năng nhất có thể. Nó lập kế hoạch cho mọi kết quả—cân thăng bằng hay lệch—và điều chỉnh bước tiếp theo dựa trên những gì xảy ra. Rất chi tiết nhưng các bước rõ ràng, logic, nên rất dễ theo dõi dù khá dài,
Một điểm tôi thích là khi cách làm bắt đầu trở nên quá phức tạp, nó chuyển sang phương pháp hệ thống hoặc đơn giản hơn. Tuy nhiên, với các bài như thế này—cần theo dõi nhiều trường hợp, kết quả và khả năng—thêm sơ đồ hoặc bảng có thể giúp hình dung mạch suy nghĩ và hiểu đầu ra tốt hơn.
Trong phần này, tôi sẽ so sánh DeepSeek với các mô hình khác như o1-preview và GPT-4o về hiệu năng trên các thang đo khác nhau. Mỗi thang đo tập trung vào một kỹ năng khác nhau, giúp ta thấy mô hình nào mạnh ở mảng nào. Đây là các thang đo do DeepSeek công bố:
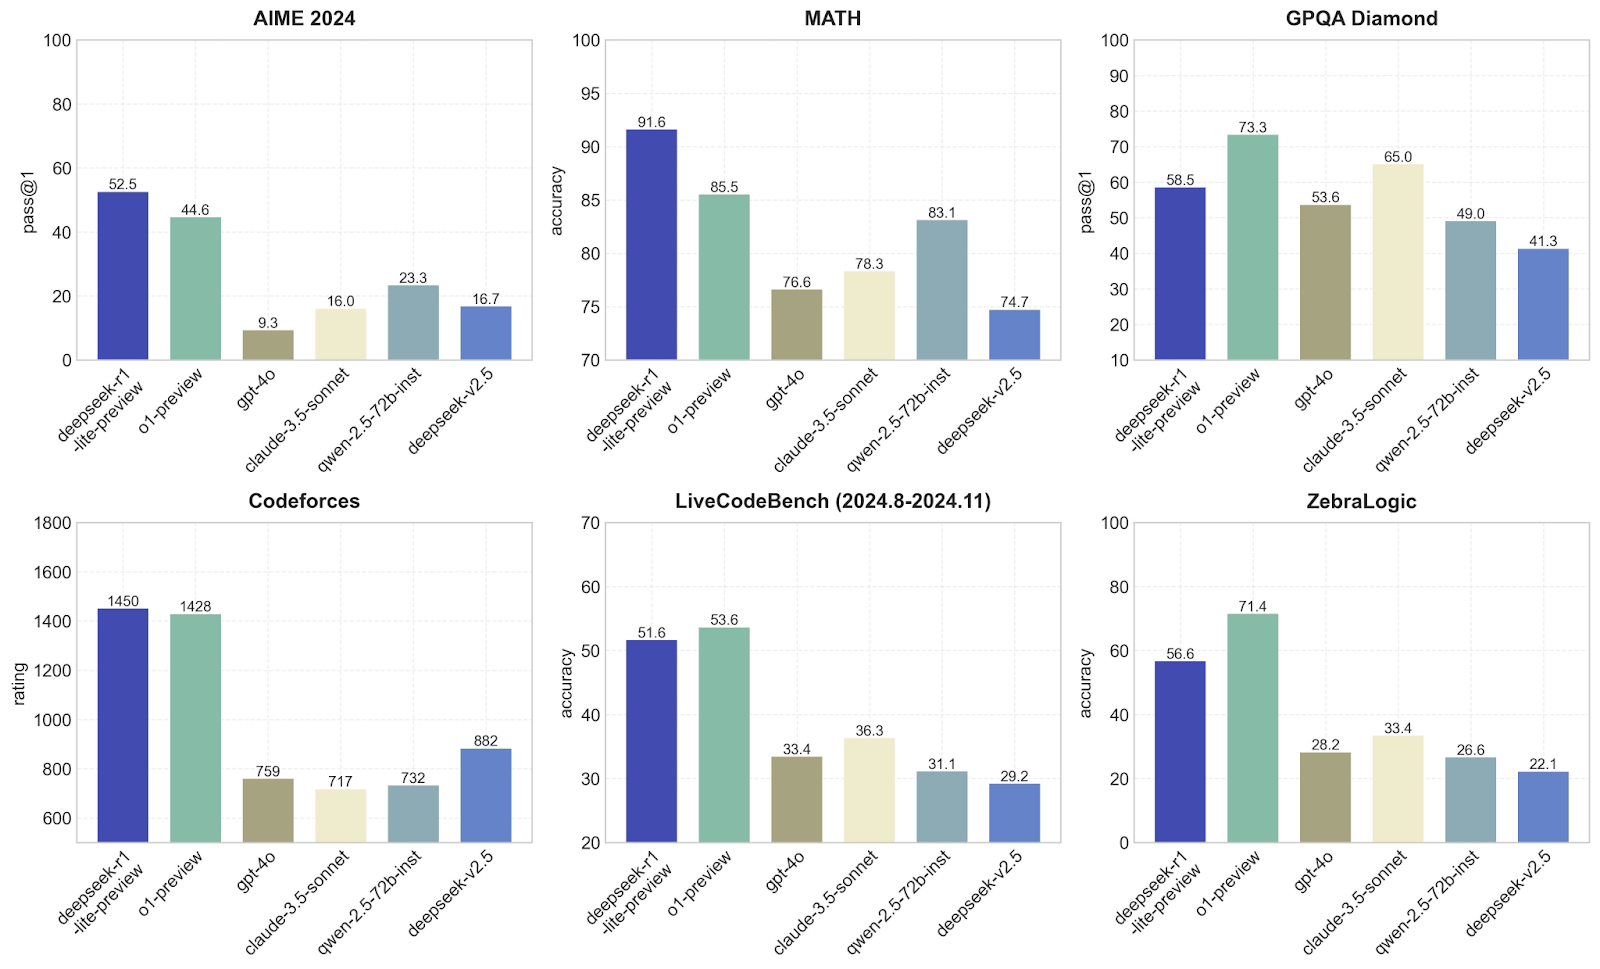
DeepSeek-r1-lite-preview rõ ràng tốt nhất ở đây, với pass@1 là 52,5, theo sau là o1-preview ở mức 44,6. Các mô hình khác như GPT-4o và claude-3.5-sonnet kém hơn nhiều, dưới 23. Điều này gợi ý rằng DeepSeek-r1-lite-preview khá giỏi trong các bài toán toán học hoặc logic nâng cao đặc thù của thang đo AIME, điều mà tôi không ngạc nhiên sau các thử nghiệm đã làm.
DeepSeek-v1 lại dẫn đầu với độ chính xác ấn tượng 91,6, vượt xa o1-preview (85,5) và tốt hơn nhiều so với các mô hình khác như GPT-4o, chỉ đạt khoảng 76,6. Điều này cho thấy DeepSeek rất mạnh trong giải toán, xác nhận giả thuyết từ bằng chứng thực nghiệm trong các bài test trước—chưa có gì bất ngờ!
Ở đây, o1-preview làm tốt hơn DeepSeek-v1, với pass@1 là 73,3 so với 58,5. Các mô hình khác như GPT-4o tụt lại ở 53,6. Điều này cho thấy o1-preview phù hợp hơn với các tác vụ trả lời câu hỏi hoặc giải bài dựa trên lập luận logic. DeepSeek vẫn ổn nhưng không bằng o1-preview.
Với lập trình thi đấu, DeepSeek-v1 (1450) và 01-preview (1428) gần như đồng hạng đầu, trong khi các mô hình khác như GPT-4o chỉ khoảng 759. Như dự đoán, điều này cho thấy hai mô hình này rất xuất sắc trong việc hiểu và sinh mã cho thử thách lập trình.
Thang đo này kiểm tra khả năng mã hóa theo thời gian, và o1-preview nhỉnh hơn chút so với DeepSeek-v1 (53,6 so với 51,6). Các mô hình khác như GPT-4o kém xa, ở mức 33,4. Lần nữa, điều này cho thấy cả DeepSeek và 01-preview đều phù hợp với tác vụ mã hóa, nhưng 01-preview nhỉnh hơn một chút.
o1-preview dẫn đầu với độ chính xác 71,4, so với 56,6 của DeepSeek-v1. Các mô hình khác kém hơn nhiều. Điều này cho thấy o1-preview giỏi hơn ở các tác vụ logic trừu tượng như ZebraLogic, đòi hỏi tư duy sáng tạo hoặc “lệch chuẩn” hơn, phù hợp với kết quả tôi thu được khi khả năng sáng tạo không phải thế mạnh của DeepSeek-v1.
Những biểu đồ này củng cố rằng DeepSeek-v1 rất mạnh ở toán và thử thách lập trình. Tôi cho rằng o1-preview cân bằng hơn và hoạt động tốt trên dải tác vụ rộng hơn, nhờ đó linh hoạt hơn.
Giờ hãy xem biểu đồ này:
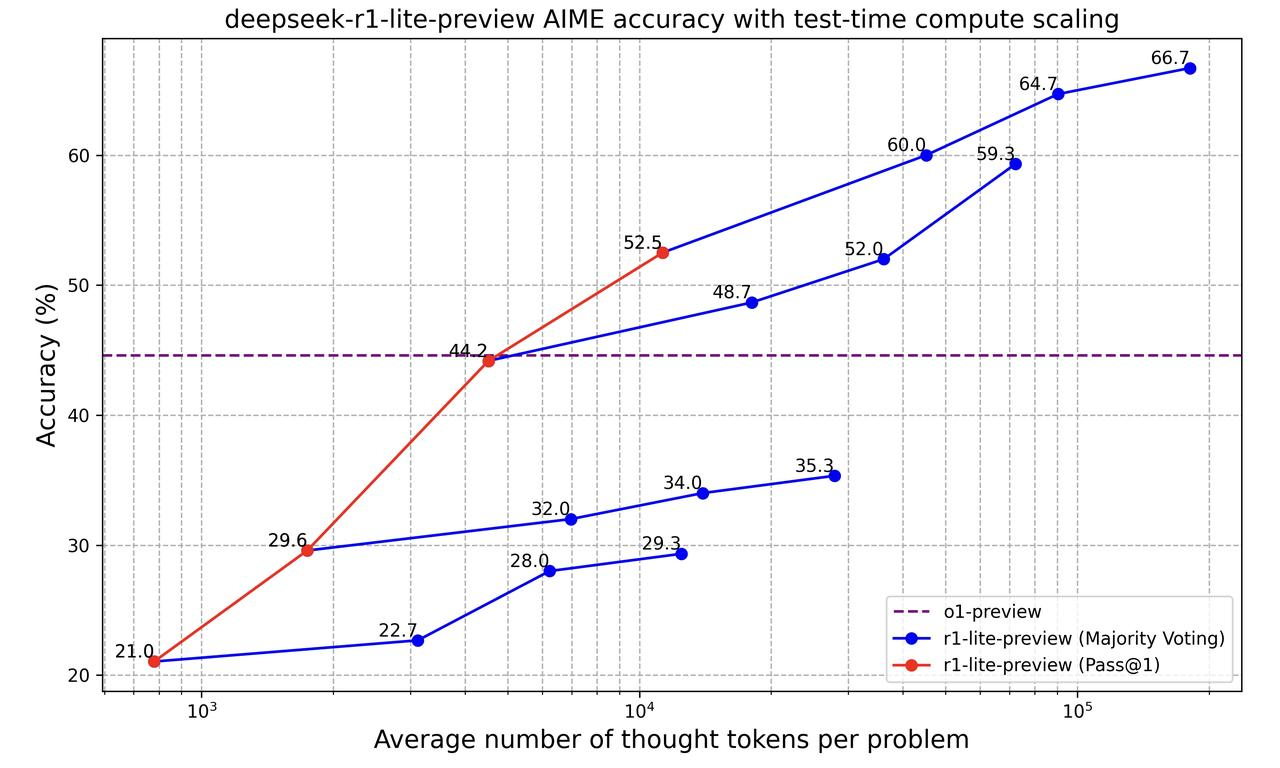
Biểu đồ này cho thấy mô hình "deepseek-r1-lite-preview" cải thiện khả năng giải quyết vấn đề khi xử lý nhiều thông tin hơn (đo bằng số "token suy nghĩ" nó dùng). Nó so sánh hai cách đo độ chính xác của mô hình:
Đường tím đứt nét biểu diễn mô hình o1-preview có độ chính xác ổn định. Ban đầu, o1-preview tốt hơn, nhưng khi DeepSeek r1-lite-preview được phép dùng nhiều token suy nghĩ hơn, nó vượt o1-preview và chính xác hơn đáng kể.
Tóm lại, biểu đồ cho thấy cho DeepSeek r1-lite-preview thêm “thời gian nghĩ” và cho thử nhiều lần sẽ cải thiện độ chính xác.
DeepSeek-r1-lite-preview có tốt hơn o1-preview của OpenAI không? Còn tùy vào tác vụ. Tôi cho là có đối với toán và mã hóa. Với lập luận logic, còn tùy bài.
Điều khiến tôi bất ngờ là cách nó lập luận qua một số bài kiểm tra. Nó khiến tôi suy nghĩ về ý nghĩa thực sự của việc một mô hình “nghĩ” và cách nó đưa ra các cách tiếp cận lập luận.
Nếu bạn tò mò về mô hình này, sao không tự thử? Hãy kiểm tra trên các tác vụ bạn quan tâm và xem nó hoạt động thế nào—biết đâu bạn cũng sẽ ngạc nhiên như tôi!
Học AI với những khóa học này!
Khóa học
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
