
DeepSeek-R1-Lite-Preview Nedir?
DeepSeek-R1-Lite-Preview, ChatGPT’ye benzer bir yapay zeka aracıdır ve Çinli şirket DeepSeek tarafından geliştirildi. Şirket bu yeni modeli X’te 20 Kasım’da duyurdu (tweet bağlantısı) ve bir dokümantasyon sayfasında birkaç detay paylaştı.
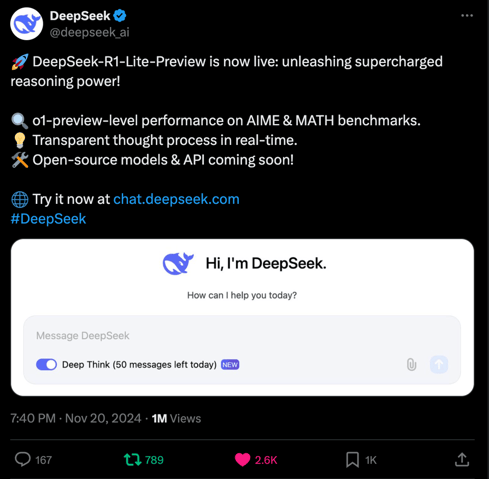
DeepSeek-R1-Lite-Preview; matematik, kodlama ve mantıktaki karmaşık akıl yürütme problemlerini çözmede çok iyi olmak üzere tasarlanmıştır. Adım adım nasıl düşündüğünü göstererek yanıtlara nasıl ulaştığını anlamanızı sağlar; bu da güveni artırır.
Bunu web sitelerinde, chat.deepseek.com adresinde ücretsiz deneyebilirsiniz; ancak “Deep Think” adlı gelişmiş modda günde 50 mesajla sınırlısınız. DeepSeek ayrıca bu aracın bazı kısımlarını kamuya açmayı ve başkalarının kullanmasına ya da üzerine inşa etmesine imkân tanımayı planlıyor.
DeepSeek-R1-Lite-Preview Nasıl Kullanılır
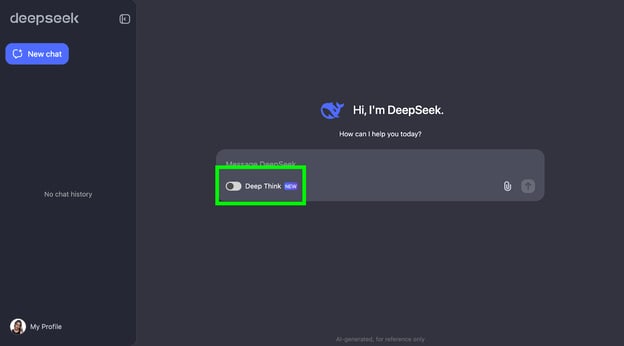
DeepSeek-R1-Lite-Preview’ı şu iki adımla kullanmaya başlayabilirsiniz:
- DeepSeek sohbet sayfasını ziyaret edin ve oturum açın.
- "Deep Think" modunu etkinleştirin.
Çilek Testi
DeepSeek-R1-Lite-Preview neler yapabiliyor görelim, hadi teste tabi tutalım! Akıl yürütme becerilerini gösterecek bir dizi örnekten geçeceğim; basit ama meşhur çilek sorusuyla başlayalım: 'strawberry' kelimesinde “r” harfi kaç kez geçer?
Bu soru basit görünebilir, ancak BDM’ler (GPT-4o bile) bunu doğru yanıtlamakta geleneksel olarak zorlanmıştır—genellikle letter “r.” harfinin sadece iki kez geçtiğini söylerler.
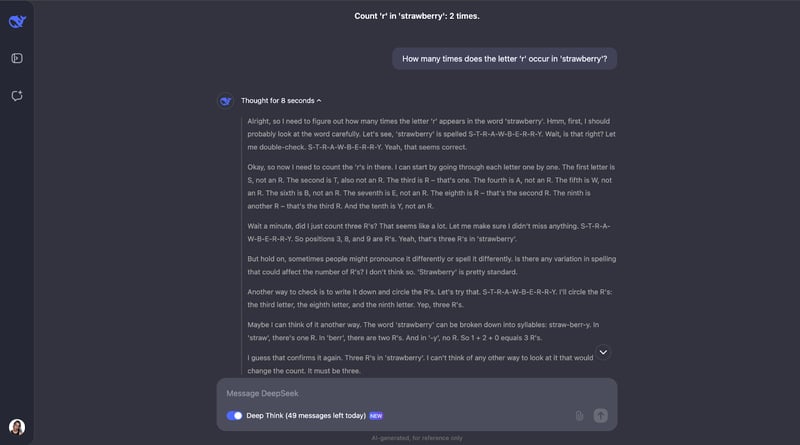
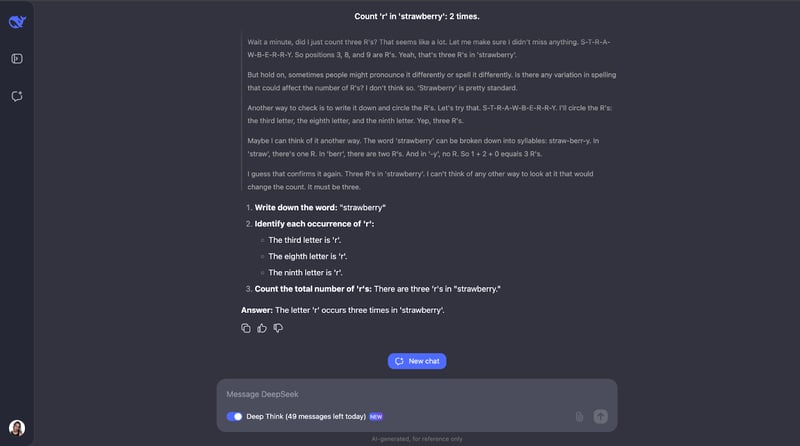
Vay canına, tamam – ilk bakışta basit görünen bir görev için bu kadar uzun bir akıl yürütme süreci beklemiyordum. 'r' harfini sayıp kelimedeki konumlarını belirledikten sonra duracağını düşünmüştüm. Ama ilgimi çeken, orada durmamış olması. Sayımı birkaç kez yeniden kontrol etti ve insanların kelimeyi farklı telaffuz etmesi ya da yazması gibi olasılıkları bile dikkate aldı – ki bence özellikle telaffuz kısmı biraz gereksiz. Yine de bu, ne kadar dikkatli ve özenli olduğunu gösteriyor! Ayrıca her adımı açıklayarak düşünce sürecini takip edebilmemi ve sonuca nasıl ulaştığını görmemi sağladı.
Matematiksel Akıl Yürütme
DeepSeek-R1-Lite-Preview’ı üç matematik problemiyle test edeceğim.
Üçgen alanı
DeepSeek’in matematiksel akıl yürütmede çok iyi olduğu iddiası göz önüne alındığında, basit bir geometri sorusuyla başlayalım.
"Kenar uzunlukları 3, 4 ve 5 olan bir üçgenin alanı nedir?"
Bu problem Pisagor teoremi ve Heron formülünü bilmeyi gerektirir. DeepSeek-R1-Lite-Preview’ın çalışmasını göstermesini beklerdim, örneğin şöyle:
- Bunun 3-4-5 dik üçgen olduğunu fark et
- Yarı çevreyi hesapla: s = (3 + 4 + 5) / 2 = 6
- Heron formülünü uygula: Alan = √(s(s-a)(s-b)(s-c))
- Değerleri yerine koy: Alan = √(6(6-3)(6-4)(6-5)) = √(6 * 3 * 2 * 1) = √36 = 6
- Doğrula: Dik üçgen alanı = (taban * yükseklik) / 2 = (3 * 4) / 2 = 6
Bakalım ne olur!
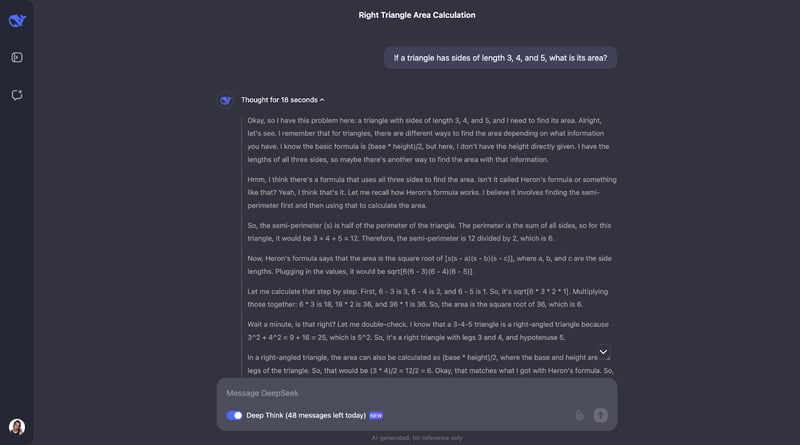
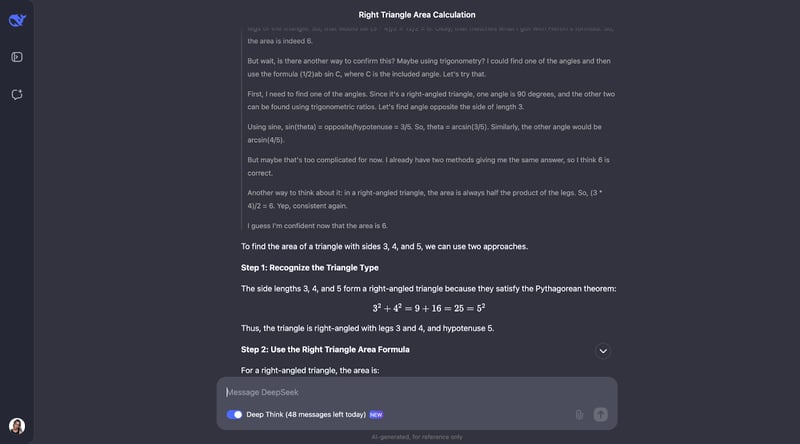
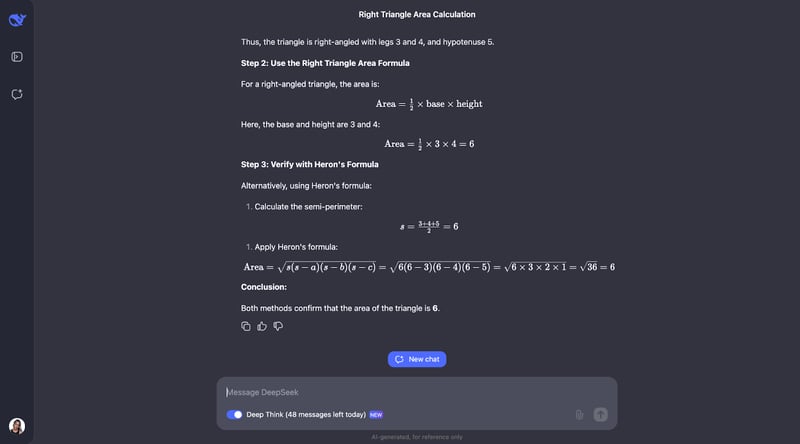
Tamam, ilginç bir şekilde, öngördüğüm kontrolleri yapıyor—gerçi farklı bir sırayla. Ayrıca açıları hesaplayıp başka bir formül deneyerek trigonometriden yararlanmayı da düşündü. Sonunda, ilk iki yöntemin cevabı zaten doğruladığını görüp bunun gerekli olmadığına karar vermesi bence ilginç.
Hem açıklama hem de çıktı özellikle net ve takip etmesi kolaydı; bu da bunun, örneğin bir matematik öğrencisi asistanına gömülecek harika bir model olacağını düşündürüyor. Bu özel kullanım senaryosu için, belki de düşünce süreci önce gösterilip öğrenci bunun anlaşılıp anlaşılmadığını onayladıktan sonra nihai cevaba geçilebilir.
Matematik ispatı
Performans ve düşünce sürecinde fark olup olmadığını görmek için daha karmaşık bir matematik testine geçelim.
“Fibonacci sayıların karşılıklılarının toplamının sonlu bir değere yakınsadığını ispatlayın.”
Bu test, serilerin yakınsaması ve Fibonacci sayıların özellikleri gibi ileri düzey matematik kavramlarını modelin ne kadar anladığını sınar. Deneyelim! Okunabilirlik adına, yanıtın sadece ilk ve son kısmını paylaşacağım (ama aynı istemle kendiniz de deneyebilirsiniz):
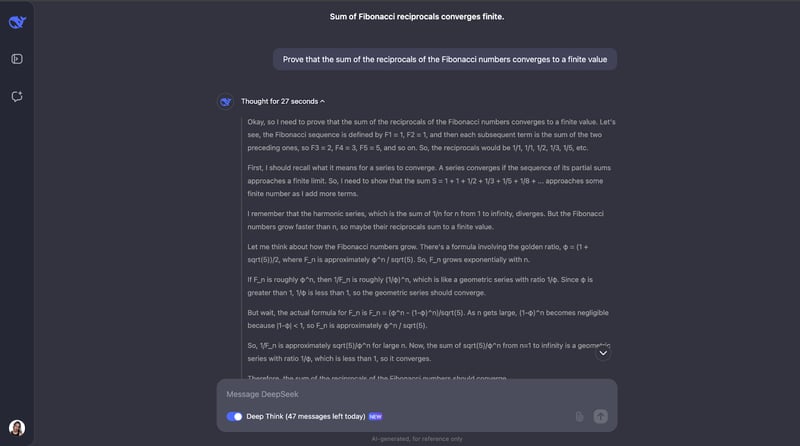
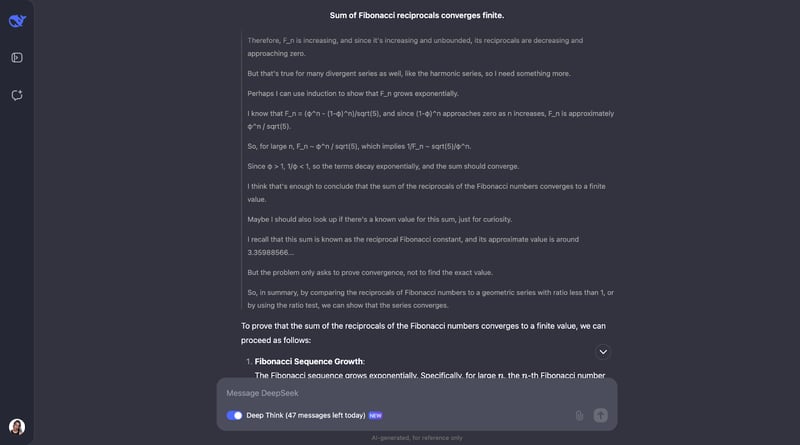
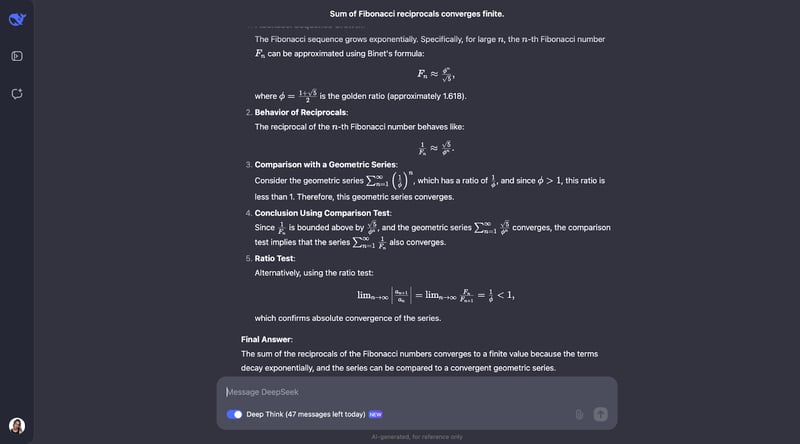
Tamam, bu harika bir düşünce zinciri—önce karşılıklı (reciprocal) ve yakınsama gibi temel kavramları anladığından emin olmasını çok beğendim. Ardından DeepSeek-R1-Lite-Preview, Fibonacci sayıların büyümesini inceleyip karşılaştırma testi kullandı; bu, bir serinin yakınsayip yakınsamadığını sınamanın yaygın bir yoludur.
Fibonacci sayıların karşılıklılarını bir geometrik seriyle karşılaştırdı. Fibonacci karşılıklıları 1’den küçük ortak oranlı bir geometrik seriden bile daha hızlı azaldığı için, bu toplamın da sonlu bir değere yakınsadığı sonucuna vardı. Ek güvence için oran testini de kullandı.
Bu test, ardışık terimlerin oranının limitinin 1’den küçük olup olmadığını kontrol eder. Küçükse seri yakınsar. Model, Fibonacci karşılıklıları için bu oranı hesapladı ve gerçekten 1’den küçük olduğunu buldu.
Hatta bu toplamın yaklaşık 3,3598 olan “karşılıklı Fibonacci sabiti” diye bilinen bir değeri olduğundan da bahsetti. Ancak bu problem için toplamın tam değerini değil, sonlu olup olmadığını bilmemiz yeterliydi—dolayısıyla bu, ilginç bulduğum ek bir bilgiydi. Çözümün çıktıda sunuluş biçimini çok beğendim. Açık ve adım adım ilerliyor.
Şimdilik, matematik görevleri beni etkiledi.
Diferansiyel geometri
Bir diferansiyel geometri sorusu deneyeceğim—doktoram bu alanda olduğu için küçük bir test yapmadan duramadım. Aşırı karmaşık olmayan, lisans düzeyi matematikte karşılaşılabilecek klasik bir alıştırma.
“R³’te
φ(u,v) = (u cos v, u sin v, ln u)
ile parametrik verilmiş bir yüzey S düşünün
(u > 0 ve 0 ≤ v < 2π için).
a) S’nin birinci temel formunu hesaplayın.
b) S’nin minimal yüzey olup olmadığını belirleyin.
c) S’nin Gauss eğriliği K ve ortalama eğriliği H’yi bulun.”
DeepSeek-R1-Lite-Preview’dan bekleyeceğim şey; adım adım bir çözüm sunması, tüm hesaplamaları göstermesi ve temel form, minimal yüzey ve farklı eğrilikler gibi ana kavramların tanımlarının yanı sıra her sonucun önemini açıklamasıdır.
Bu blog okunabilir kalsın diye sadece yanıtın ilk ve son kısmını gösterebileceğim; yine de istemi kendiniz denemenizi öneririm:
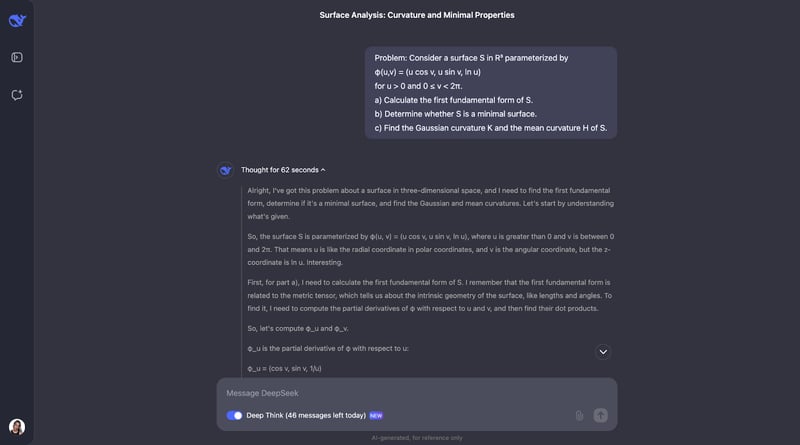
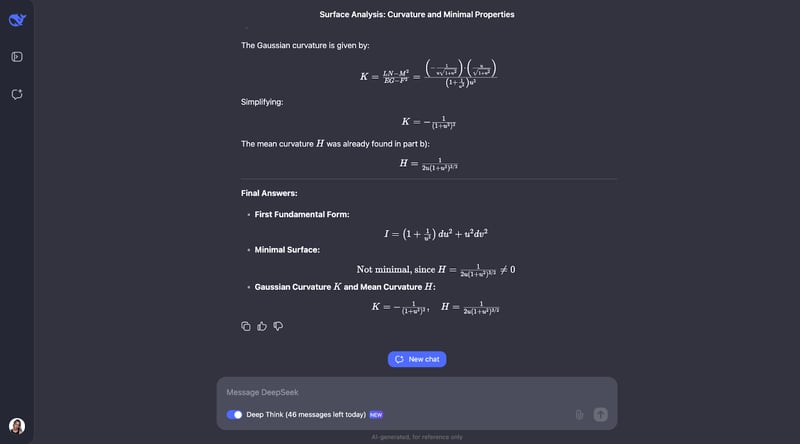
Adım adım yaklaşım iyi bilinen geometrik formülleri doğrudan uygular; bu da akıl yürütmeyi takip etmeyi kolaylaştırır. Ancak, problemdeki ana kavramlara ilişkin kendi anlayışını kontrol etmesini beklerdim; bu, düşünce zincirinin bir parçası değil. B şıkkında alternatif bir yaklaşım benimseyip söz konusu yüzeyin bir dönel yüzey olduğunu saptaması hoş bir dokunuş.
Ayrıca dönüşten bahsederken normal vektör olan N’in hâlihazırda elde olduğunu fark ettiği ve bunun ikinci temel formun katsayısı gösterimiyle çakışabileceği bir an var. Aynı harfi iki farklı şey için kullanmak iyi bir uygulama olmadığından, daha iyi bir gösterim önerisi görmeyi isterdim!
Ortalama eğriliği hesaplarken sıfır olmadığını fark ediyor ve hesabın doğruluğunu sorguluyor. Titiz olmak için, işini ikinci bir yöntemle yeniden kontrol ediyor.
Yine çıktı çok net ve takip etmesi kolay. Tüm bu örneklerde, hesaplamaları farklı yöntemlerle tutarlı biçimde yeniden kontrol etmesi etkileyici oldu. Düşünce süreci her zaman ayrıntılı, mantıklı ve anlaşılır!
Kodlama Testi
Şimdi kodlama testlerine geçelim.
Python
İlk test edeceğim soru şu:
“Verilen bir dizgede en uzun palindromik alt dizgeyi bulan bir Python fonksiyonu yazın. Fonksiyonun zaman karmaşıklığı O(n^3)’ten daha iyi olmalıdır.”
Modelin verimli algoritmalar tasarlayıp bunları koda dökme yeteneğini değerlendirmeye çalışıyorum. Dinamik programlama ya da Manacher algoritması kullanan, yaklaşımı net açıklayan ve zaman karmaşıklığı analizini içeren bir çözüm beklerdim.
Çıktı çok çok uzundu, sadece ilk ve son kısımları paylaşıyorum:
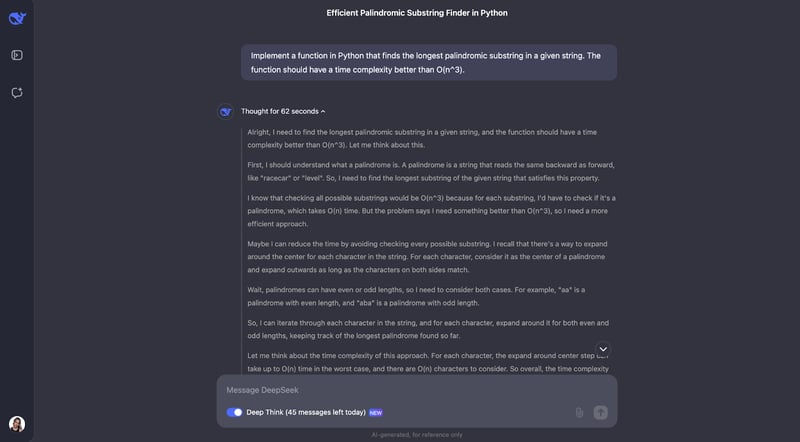
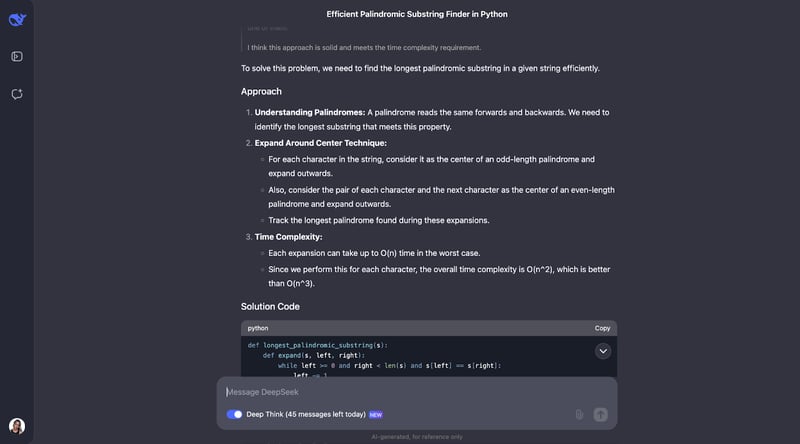
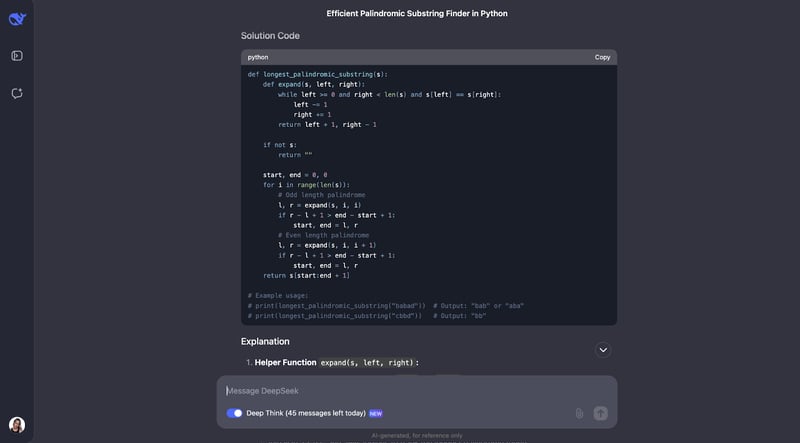
Modelin, en uzun palindromik alt dizgeyi bulma problemini çözmede harika bir iş çıkardığını düşünüyorum. Yaklaşımı akıllıca, verimli ve net açıklanmış.
Tüm olası alt dizgeleri kaba kuvvetle denemek yerine, zeki bir "merkez etrafında genişletme" tekniği kullandı. Bu yöntem, "aba" gibi tek uzunluklu ve "abba" gibi çift uzunluklu palindromları ele aldı. Giderken bulduğu en uzun palindromu takip etti. Sonuçta O(n^2) zamanda çalışan, O(n^3) çözüme göre çok daha hızlı bir algoritma elde edildi.
Bu yanıtta beni en çok etkileyen, sunumunun ne kadar açık olması. DeepSeek problemi anlaşılır adımlara böldü, düşünce sürecini ayrıntılı açıkladı ve pratik örnekler de ekledi. Örneğin algoritmanın, doğru palindromu bulmak için "racecar" veya "abba"nın merkezinde nasıl genişlediğini gösterdi. Merkez etrafında genişleme için yardımcı fonksiyon bence özellikle güzeldi—kodu modüler ve takip etmesi kolay kıldı.
Yine de, O(n) süreli daha hızlı bir çözüm olan Manacher algoritmasını da düşünmesini beklerdim. Uygulaması kesinlikle daha karmaşıktır; ancak performansın kritik olduğu durumlar için kullanışlıdır ve modelin buna değinmesini beklerdim.
Ayrıca, algoritmanın özel durumları nasıl ele aldığı (boş dize ya da tüm karakterleri aynı olan bir dize, ör. "aaaa" gibi) hakkında çıktıda açık bir tartışma olmadığını fark ettim. Bu durumlar çalışır–ama en azından değinmesini beklerdim.
Son olarak, örnek kullanımlar için beklenen çıktıya yorum yapması güzel; fakat kodu çalıştırdığımda, ilk örnek kullanım için sadece ilk seçenek yazdırıldı. Kod tüm olası çözümleri dikkate alsa ve hepsini yazdırsa harika olurdu.
JavaScript
Başka bir programlama dilinde farklı bir kodlama sorusu deneyelim.
“Verilen bir sayının asal olup olmadığını belirleyen bir JavaScript fonksiyonu yazın”
Okunabilirlik adına, sadece ilk ve son kısmı gösteriyorum (bu kez düşünce zinciri biraz daha kısaydı):
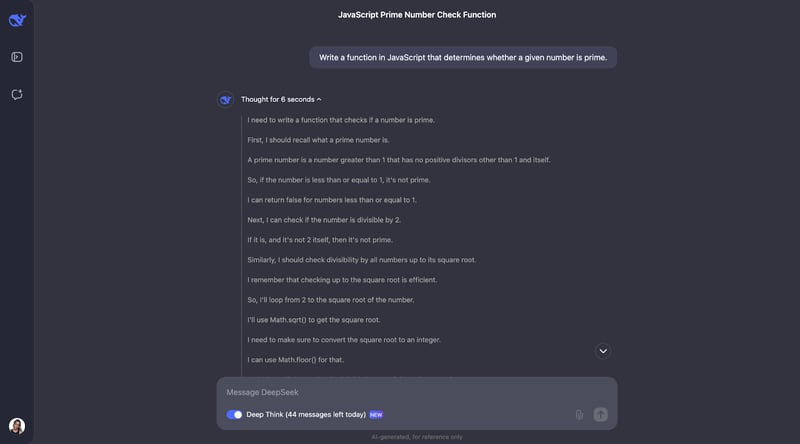
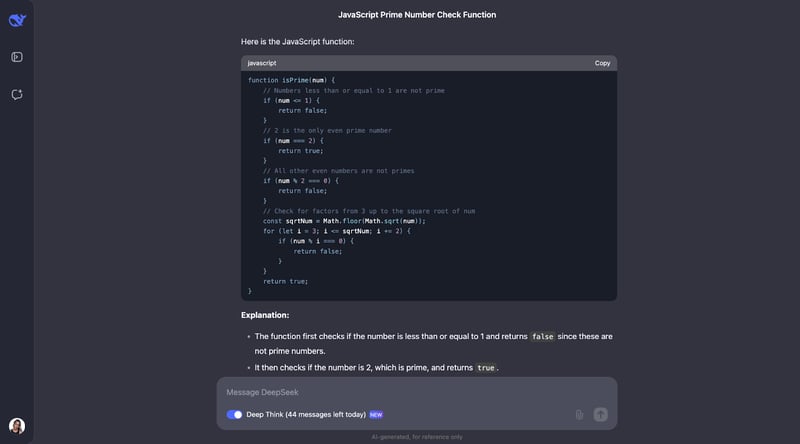
Bence burada düşünce sürecinde bir örüntü görüyoruz. Çoğu zaman problemde geçen ana kavramları tanımlayarak başlıyor. Örneğin bu problemde, asal sayının ne olduğunu tanımlıyor.
Bundan sonra düşünce süreci mantıklı ve optimize adımlara ulaşıyor. Önce temel noktaları kapsıyor: 1’e eşit veya daha küçük sayılar asal değildir ve 2 tek asal sayıdır. Oradan, sayının kareköküne kadar olan tek sayılara bölünüp bölünmediğini kontrol eder. Bu, gereksiz hesaplamalardan kaçındığı için zaman kazandırır. Ayrıca 2’den sonra tüm çift sayıları test etmek yerine onları atlayarak süreci daha da hızlandırır. Fonksiyon, ne kadar ileri kontrol etmesi gerektiğini sınırlamak için Math.sqrt kullanır; bu da onu verimli ve basit tutar.
Yine, önceki problemde olduğu gibi, çalıştığından emin olmak için küçük örneklerle; bilinen asal ve asal olmayan sayılarla test etti.
Yine de geliştirme payı var. Örneğin fonksiyon, girdinin gerçekten sayı olup olmadığını kontrol etmiyor; bu yüzden hataları daha iyi ele alabilirdi. Ayrıca 0 veya 5 ile biten sayılar (5 hariç) gibi bariz asal olmayanlar için kısa yollar eklenebilir. Neden çift sayıları atlattığı ya da neden yalnızca kareköküne kadar kontrol ettiği konusunda biraz daha açıklama eklemek de özellikle yeni başlayanlara yardımcı olur, diye düşünüyorum.
Son olarak, tıpkı önceki testteki Python kodunda olduğu gibi, kodun bazı örnek kullanım testlerine de sahip olmasını beklerdim.
Mantıksal Akıl Yürütme
Şimdi mantıksal akıl yürütme testlerine geçelim.
Kurt, keçi ve lahana problemi
Klasik bir bilmeceyi test edeceğim:
"Bir adamın, bir kurt, bir keçi ve bir lahana ile nehir geçmesi gerekiyor. Teknesi sadece kendisini ve başka bir şeyi taşıyabiliyor. Yalnız kalırlarsa kurt keçiyi, keçi de lahanayı yer. Her şeyi güvenle karşıya nasıl geçirir?"
Modelin şu cevabı vermesini beklerdim:
- Başlangıç: Adam, Kurt, Keçi, Lahana aynı tarafta
- Adam keçiyi karşıya geçirir (Kurt ve Lahana birlikte güvende)
- Adam tek başına geri döner
- Adam kurdu karşıya geçirir
- Adam keçiyi geri getirir (Kurt ve Keçi yalnız bırakılamaz)
- Adam lahanayı karşıya geçirir
- Adam tek başına geri döner
- Adam keçiyi karşıya geçirir
- Bitiş: Hepsi güvenle karşıda
Ama bakalım düşünce sürecini nasıl ele alıyor; ne bekleyeceğimden emin değilim!
Bu çıktıyı da okunabilirlik için kısaltmam gerekecek:
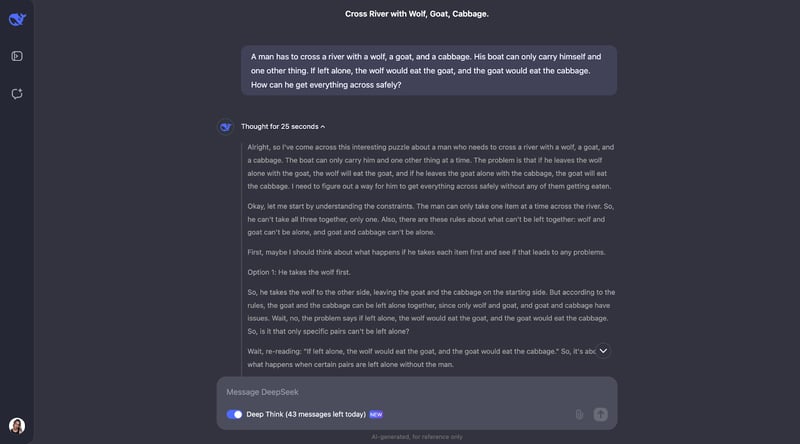
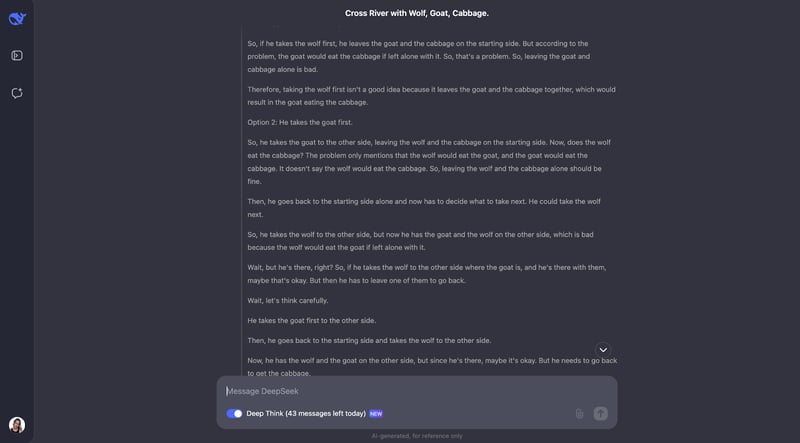
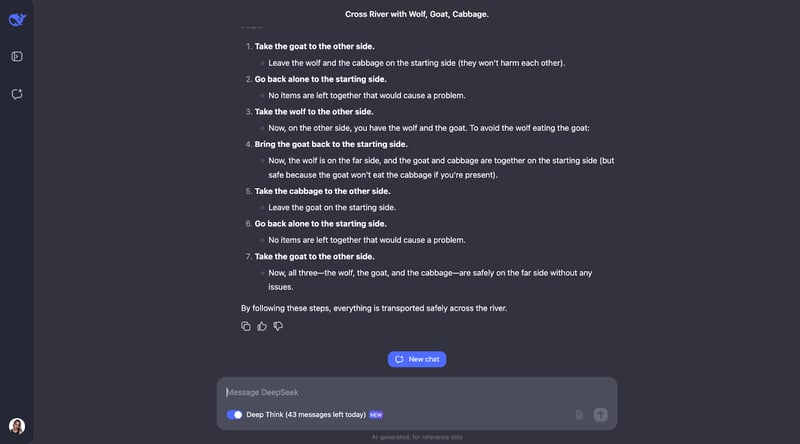
Model, bu klasik nehir geçiş bilmecesini çözmede harika bir iş çıkarıyor. Kuralları dikkatle düşünüyor ve farklı olasılıkları kontrol ediyor. Kurtla keçinin ya da keçiyle lahananın yalnız bırakılamayacağını anlıyor. Başta kısıtları gözden geçiriyor. Buradan hareketle adamın önce her bir nesneyi karşıya götürmesi hâlinde neler olacağını inceliyor ve sorun yaratıp yaratmadığını belirliyor.
Modelin hoşuma giden yanı, bir şey işe yaramadığında planını ayarlaması. Örneğin önce kurdu götürmeyi denediğinde bunun sorun çıkardığını fark edip adımları yeniden düşünmesi. Bu deneme-yanılma yöntemi, bilmeceyi bizim gibi insanların çözme biçimine oldukça benziyor.
Sonunda model doğru çözüme ulaşıyor ve bunu açık, adım adım bir şekilde açıklıyor.
Top tartma bilmecesi
Bir tane daha deneyelim:
“Görünüş olarak aynı 12 topunuz var. Toplardan biri diğerlerinden ya daha ağır ya da daha hafif. Terazi kullanarak, yalnızca üç tartıda aykırı topu bulun ve daha ağır mı daha hafif mi olduğunu belirleyin.”
Bu klasik mantık bilmecesi, çıkarımsal akıl yürütmeyle en iyi stratejiyi bulma becerisini sınar. Bakalım ne olacak. Bu sefer çıktı çok çok uzundu; o yüzden doğrudan sonuca geçeceğim:
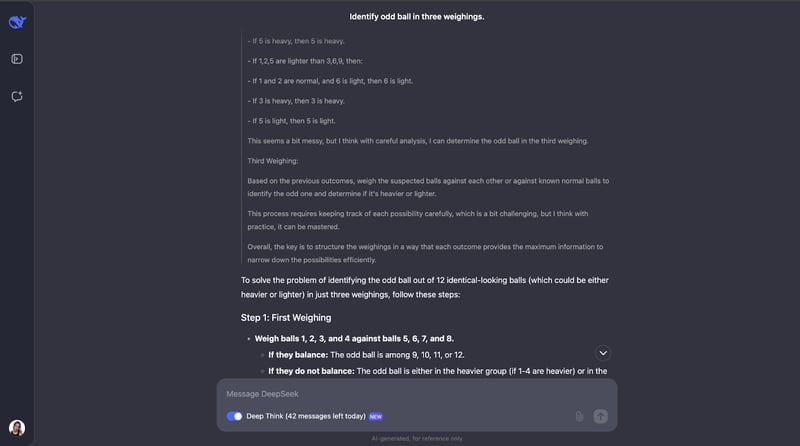
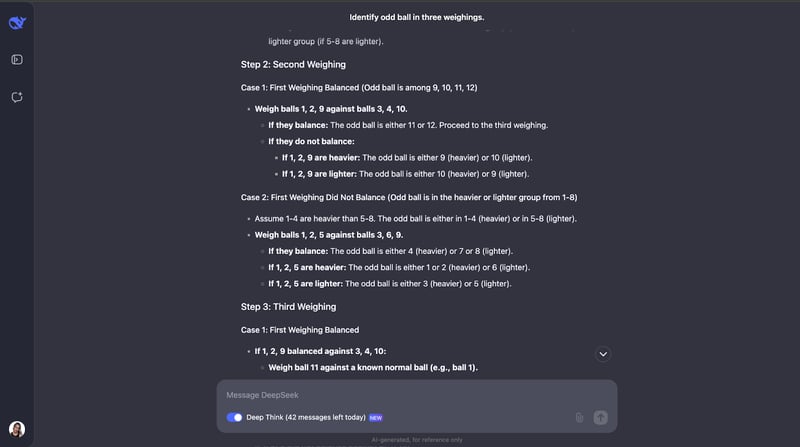
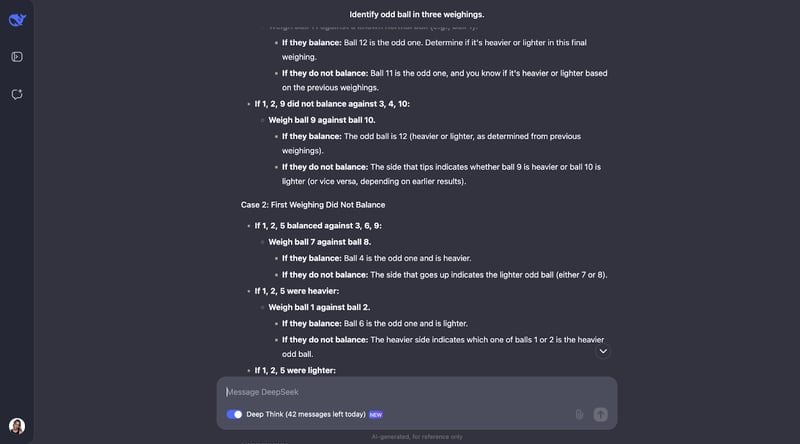
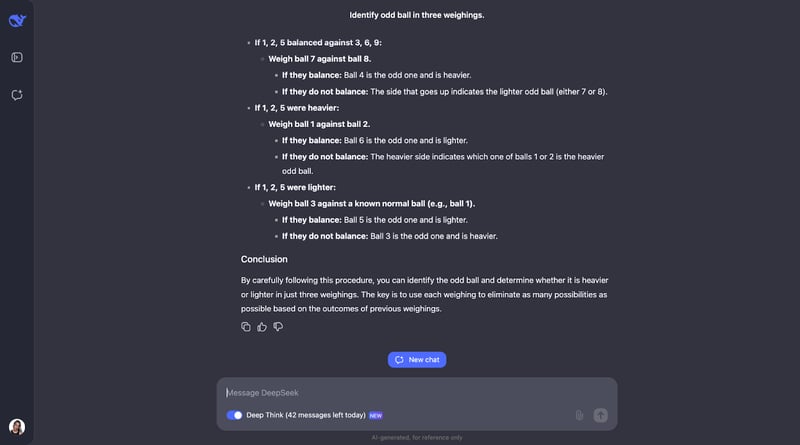
Bir diğerinde de çıktının uzunluğunu tamamen hafife almışım! Model, bu bilmeceyi çözmek için sadece üç deneme hakkı olduğundan dikkatli planlama gerektiğini fark ediyor. Olası sonuçların ve ihtimallerin sayısını da hesaplıyor.
Modelin yaklaşımı akıllıca; çünkü her tartımda mümkün olduğunca çok ihtimali eliyor. Terazinin dengede kalması ya da bir tarafa kayması dâhil tüm sonuçlar için plan yapıyor ve olanlara göre bir sonraki adımı ayarlıyor. Oldukça ayrıntılı; ama adımlar net ve mantıklı, bu yüzden uzun olsa da takip etmesi kolay.
En beğendiğim şeylerden biri, yaklaşım fazla karmaşıklaşmaya başladığında daha sistematik ya da daha basit bir yönteme geçmesi. Ancak bu tür, farklı durumları, sonuçları ve olasılıkları takip etmeyi gerektiren problemler için bir diyagram ya da çizelge eklemek; düşünce sürecini görselleştirmeye ve çıktıyı daha iyi anlamaya yardımcı olabilir.
DeepSeek-R1-Lite-Preview Kıyaslamaları
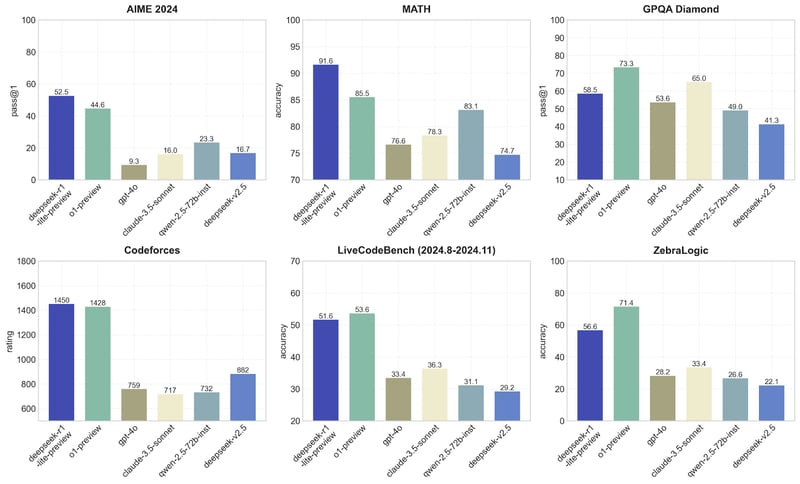
Bu bölümde, DeepSeek’i o1-preview ve GPT-4o gibi diğer modellerle farklı kıyaslamalardaki performans bakımından karşılaştıracağım. Her biri farklı bir beceriye odaklanır; böylece hangi modelin hangi alanda daha iyi olduğunu görebiliriz. İşte DeepSeek’in ölçtüğü kıyaslamalar:
AIME 2024
DeepSeek-r1-lite-preview burada açık ara en iyi; pass@1 değeri 52,5, onu 44,6 ile o1-preview izliyor. GPT-4o ve claude-3.5-sonnet gibi diğer modeller 23’ün altında kalarak çok daha kötü performans gösteriyor. Bu, DeepSeek-r1-lite-preview modelinin AIME kıyaslamalarına özgü ileri düzey matematik veya mantık problemlerini ele almakta oldukça iyi olduğunu düşündürüyor; yaptığım testlerden sonra buna şaşırmıyorum.
MATH
DeepSeek-v1 yine 91,6 gibi etkileyici bir doğrulukla öne çıkıyor; o1-preview (85,5) geride kalıyor ve GPT-4o gibi diğer modeller 76,6’yı yakalamakta zorlanıyor. Bu, DeepSeek’in matematik problemlerini çözmede harika olduğunu gösteriyor; önceki testlerdeki ampirik kanıtlardan çıkardığım sonucu doğruluyor–şimdilik sürpriz yok!
GPQA Diamond
Burada o1-preview, 73,3 pass@1 ile DeepSeek-v1’den daha iyi (58,5). GPT-4o gibi diğer modeller 53,6’da kalıyor. Bu, o1-preview’ın mantıksal akıl yürütmeye dayalı soruları yanıtlamak ya da problemleri çözmek için daha uygun olduğunu gösteriyor. DeepSeek yine sağlam bir performans sergilese de o1-preview kadar iyi değil.
Codeforces
Rekabetçi programlamada DeepSeek-v1 (1450) ve 01-preview (1428) zirve için neredeyse başa baş; GPT-4o gibi diğer modeller ise yalnızca 759 civarında puan alıyor. Beklendiği gibi, bu iki modelin programlama zorlukları için kodu anlama ve üretmede mükemmel olduğunu gösteriyor.
LiveCodeBench
Bu, zaman içindeki kodlama yeteneklerini test eder ve o1-preview, DeepSeek-v1’i az farkla geride bırakır (53,6’ya karşı 51,6). GPT-4o gibi diğer modeller 33,4 ile oldukça geride kalır. Yine, her iki modelin de kodlamaya uygun olduğunu, ancak bu görevlerde 01-preview’ın biraz daha iyi olduğunu gösterir.
ZebraLogic
o1-preview burada %71,4 doğrulukla lider; DeepSeek-v1 ise %56,6’da kalıyor. Diğer modeller çok daha kötü. Bu, o1-preview’ın, daha yaratıcı ya da alışılmışın dışında düşünmeyi gerektiren ZebraLogic gibi soyut mantık görevlerini ele almakta daha iyi olduğunu gösteriyor; bu da yaptığım testlerden aldığım sonuçlarla uyumlu; zira yaratıcılık kesinlikle DeepSeek-v1’in güçlü yanı değildi.
Bu grafikler, DeepSeek-v1’in matematik ve programlama zorluklarında müthiş olduğunu doğruluyor. O1-preview’ın ise daha dengeli olduğunu ve daha geniş bir görev yelpazesinde iyi performans gösterdiğini; dolayısıyla daha çok yönlü olduğunu söyleyebilirim.
Şimdi şu grafiğe bakalım:
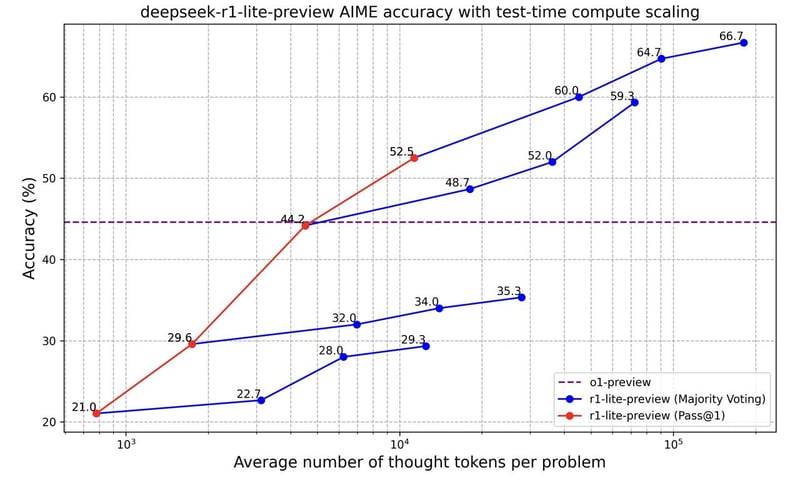
Bu grafik, "deepseek-r1-lite-preview" modelinin daha fazla bilgi işledikçe (kullandığı "düşünce belirteci" sayısıyla ölçülür) problem çözmede nasıl daha iyi hale geldiğini gösteriyor. Modelin doğruluğunun ölçüldüğü iki yöntemi karşılaştırıyor:
- Pass@1 (kırmızı çizgi): Modelin ilk yanıtındaki doğruluğudur. Daha fazla belirteç kullandıkça doğruluğu %21’den %52,5’e çıkar. Bu, modelin yalnızca ilk yanıtı için bile daha fazla düşünme süresi olduğunda daha iyi iş çıkardığı anlamına gelir.
- Çoğunluk oylaması (mavi çizgi): Model birden çok yanıt verir ve en çok önerdiğini (çoğunluk oyu) seçer. Bu yöntem %22,7’den başlar ve daha fazla belirteçle %66,7’ye yükselir. İlk yanıt yaklaşımından her zaman daha doğrudur; bu da modele birden fazla deneme şansı vermenin daha iyi kararlar almasına yardımcı olduğunu gösterir.
Kesikli mor çizgi, sabit bir doğruluğa sahip o1-preview modelini temsil eder. Başta o1-preview daha iyidir; ancak DeepSeek r1-lite-preview’a daha fazla düşünce belirteci kullanma izni verildikçe o1-preview’ı geride bırakır ve çok daha doğru hale gelir.
Özetle bu grafik, DeepSeek r1-lite-preview’ın daha fazla düşünmesine ve birden çok kez denemesine izin vermenin doğruluğunu artırdığını gösteriyor.
Sonuç
DeepSeek-r1-lite-preview, OpenAI’ın o1-preview modelinden daha mı iyi? Göreve bağlı. Matematik ve kodlama problemleri için evet derim. Mantıksal akıl yürütmede ise göreve bağlıdır.
Beni gerçekten şaşırtan, bazı testlerde nasıl akıl yürüttüğü oldu. Bir modelin “düşünmesi”nin aslında ne anlama geldiğini ve akıl yürütme yaklaşımlarını nasıl geliştirdiğini yeniden düşünmeme sebep oldu.
Bu model hakkında meraklıysanız, neden kendiniz test etmiyorsunuz? İlginizi çeken görevlerde deneyin ve nasıl performans gösterdiğini görün—benim gibi sizi de şaşırtabilir!

Ana Rojo Echeburúa, Uygulamalı Matematik alanında doktora derecesine sahip bir yapay zeka ve veri uzmanıdır. Verileri eyleme dönüştürülebilir içgörülere çevirmeyi sever ve teknik ekipleri yönetme konusunda geniş deneyime sahiptir. Ana, müşterilerle yakın çalışarak onların iş sorunlarını çözmekten ve yenilikçi yapay zeka çözümleri geliştirmekten keyif alır. Sorun çözme becerileri ve açık iletişimiyle tanınan Ana, özellikle üretken yapay zeka olmak üzere yapay zekaya tutkuyla bağlıdır. Sürekli öğrenmeye ve etik yapay zeka geliştirmeye, ayrıca karmaşık sorunları basitleştirmeye ve teknolojiyi anlaşılır biçimde açıklamaya kendini adamıştır.


DeepSeek, DeepSeek-R1-Lite-Preview modelini yeni piyasaya sürdü ve bazıları bunun OpenAI’ın o1-preview modelinden bile daha iyi olduğunu iddia ediyor. Bu sadece yeni bir yapay zeka abartısı dalgası mı?
Çevrimiçi ortamda bu modelin olağanüstü akıl yürütme yetenekleri ve şeffaf karar verme süreci hakkında iddialı yorumlar gördüm. Karmaşık görevlerde—özellikle matematik ve kodlamada—çok başarılı olduğu, AIME ve MATH12 gibi zorlu kıyaslamalarda OpenAI’ın o1-preview modeline denk geldiği hatta onu aştığı söyleniyor.
Merak ettim ve bu iddiaları; kodlama soruları, ileri düzey matematik problemleri ve doğal dil işleme üzerinde bizzat test etmeye karar verdim. Haydi DeepSeek-R1-Lite-Preview gerçekte ne kadar iyi görelim.