
Last chance! 50% off DataCamp Premium
Sale ends in
DeepSeek-R1-Lite-Preview è uno strumento di IA, simile a ChatGPT, creato dall’azienda cinese DeepSeek. L’azienda ha annunciato questo nuovo modello su X il 20 novembre (link al tweet) e ha condiviso alcuni dettagli su una pagina di documentazione.
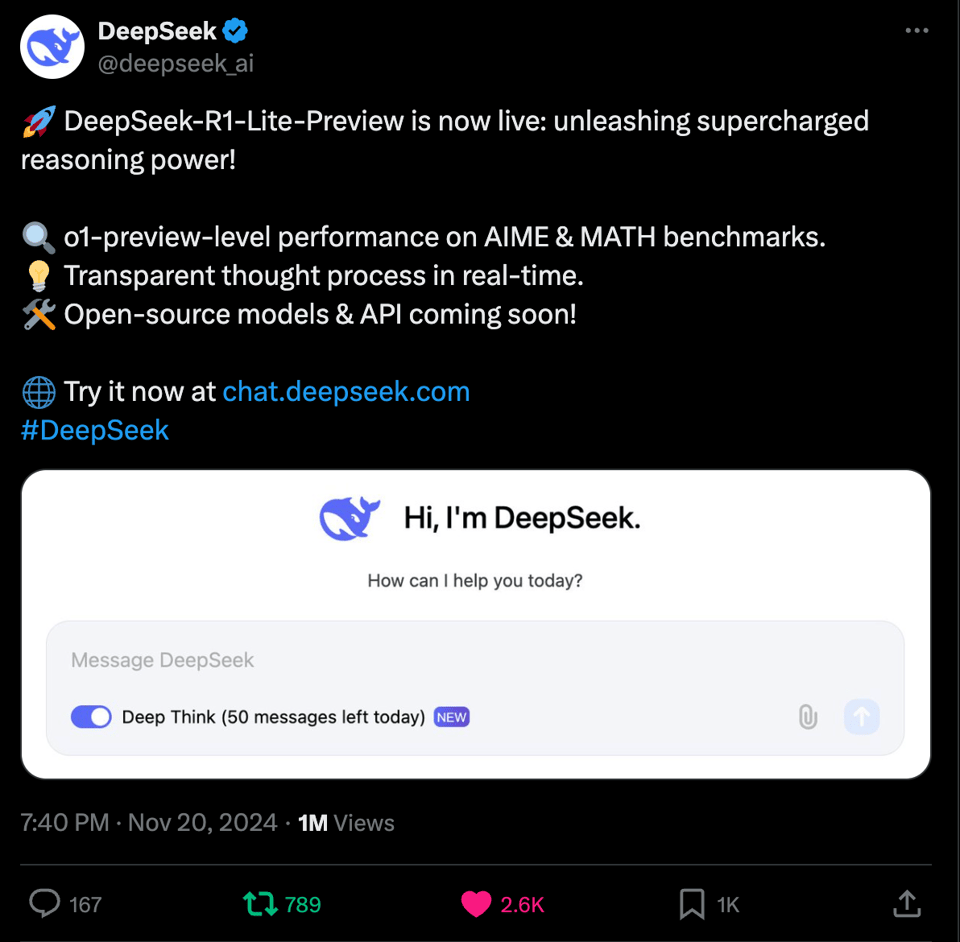
DeepSeek-R1-Lite-Preview è pensato per essere molto bravo a risolvere problemi complessi di ragionamento in matematica, coding e logica. Mostra passo dopo passo come ragiona, così puoi capire come arriva alle risposte, il che aiuta a fidarsi di più del modello.
Puoi provarlo gratuitamente sul loro sito, chat.deepseek.com, ma sei limitato a 50 messaggi al giorno nella modalità avanzata chiamata “Deep Think”. DeepSeek inoltre prevede di condividere parti di questo strumento con il pubblico, così che altri possano usarlo o costruirci sopra.
Puoi iniziare a usare DeepSeek-R1-Lite-Preview seguendo questi due passaggi:
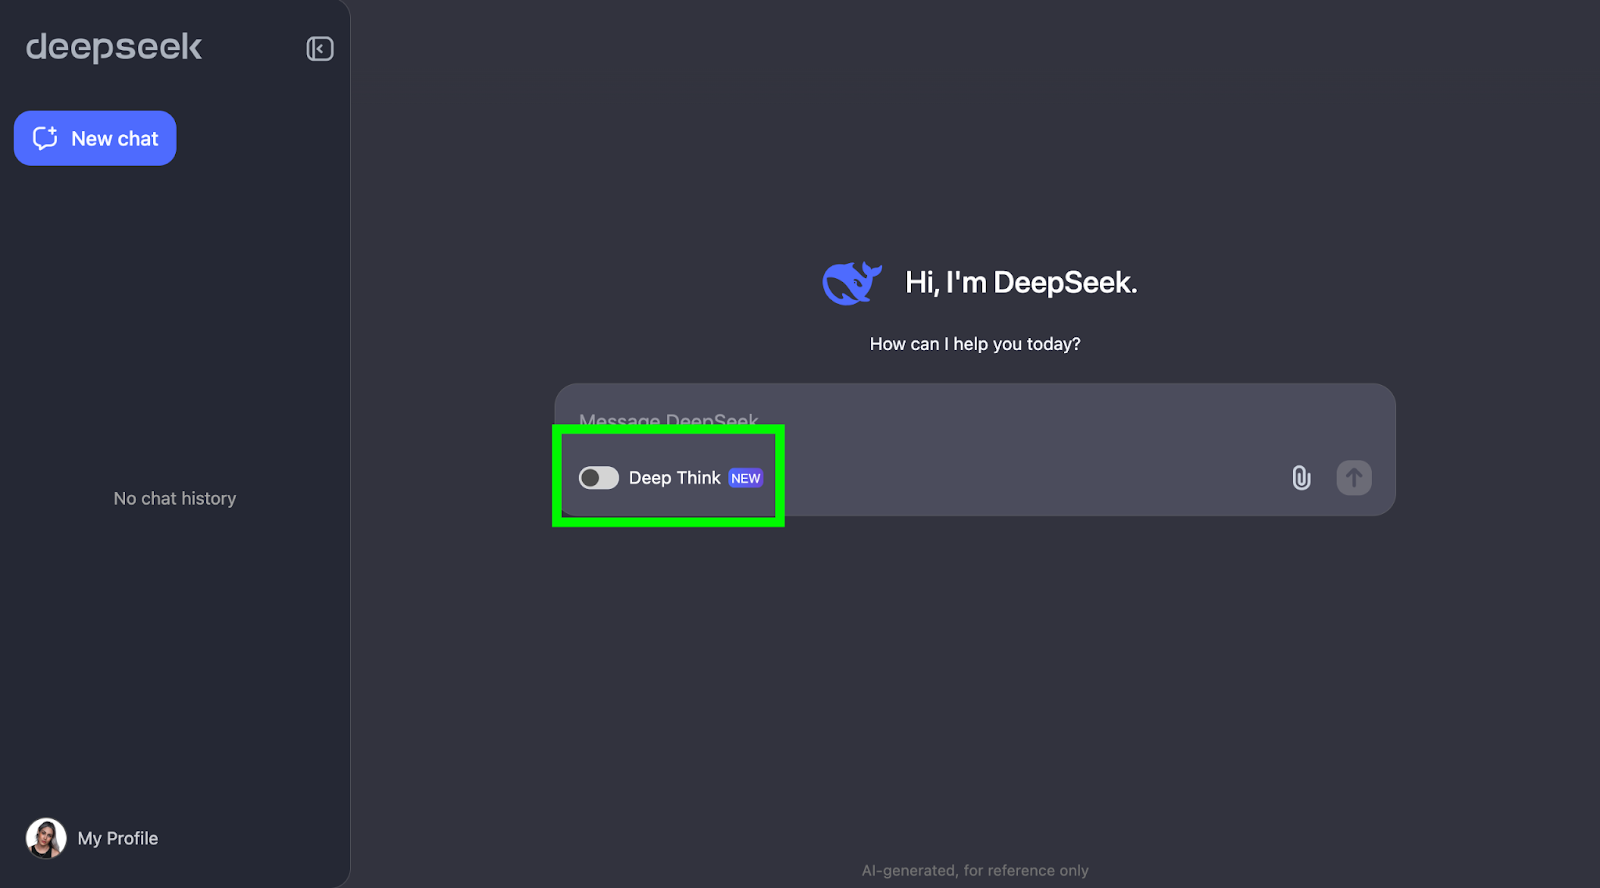
Per vedere cosa sa fare DeepSeek-R1-Lite-Preview, mettiamolo alla prova! Passerò attraverso una serie di sfide che mostrano le sue capacità di ragionamento, iniziando con la semplice ma famosa domanda della fragola: Quante volte compare la lettera “r” in 'strawberry'?
Questa domanda può sembrare banale, ma gli LLM (anche GPT-4o) storicamente faticano a rispondere correttamente—tipicamente dicono che ci sono solo due occorrenze della lettera “r”.
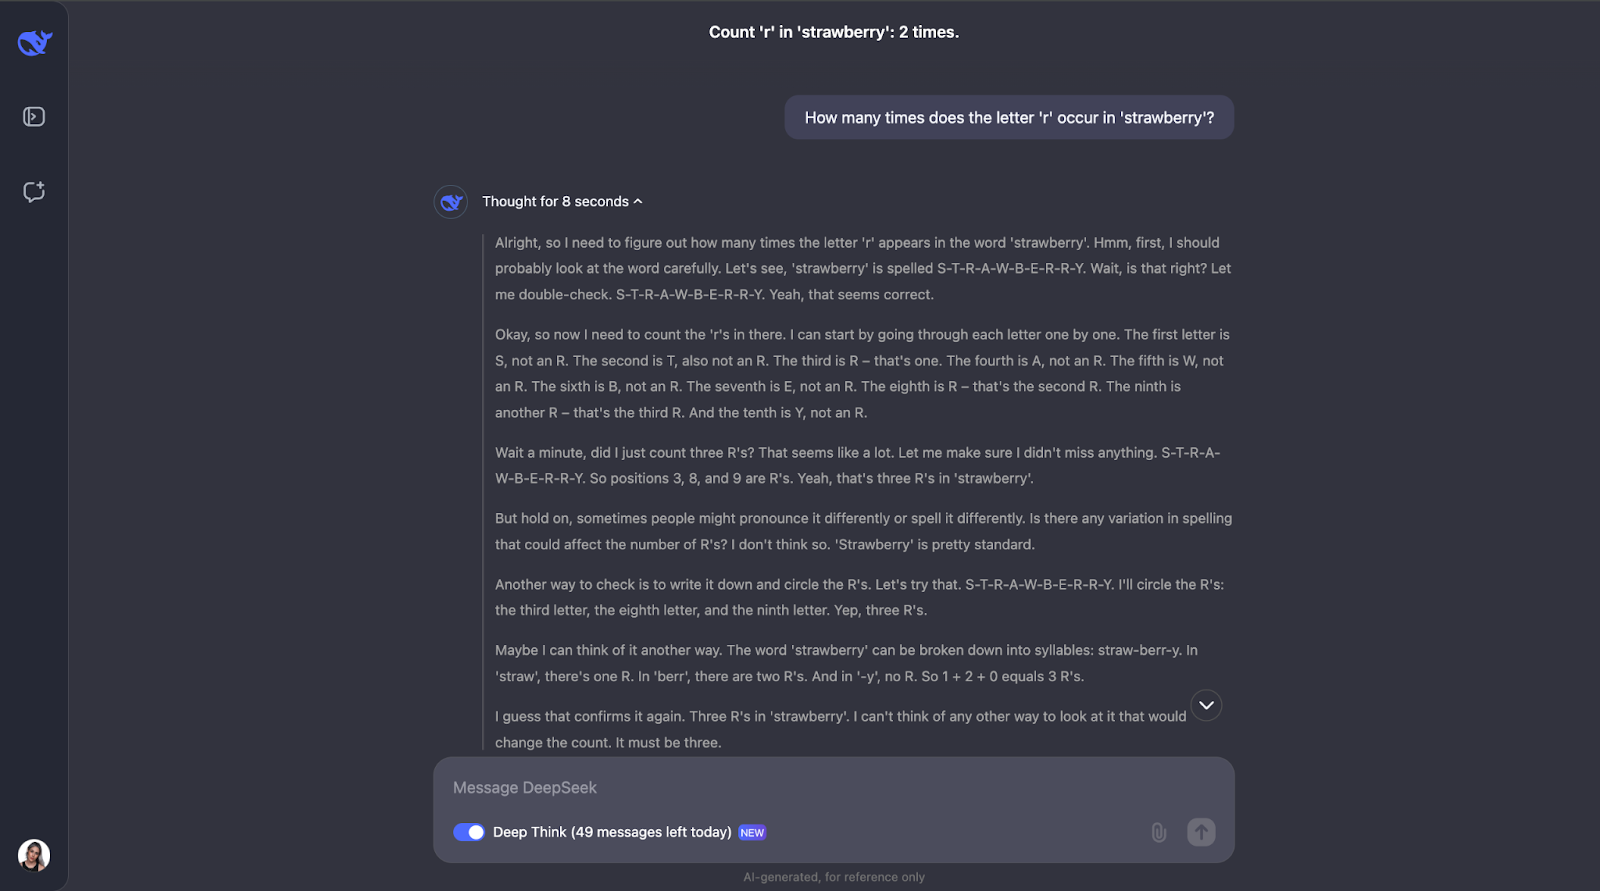
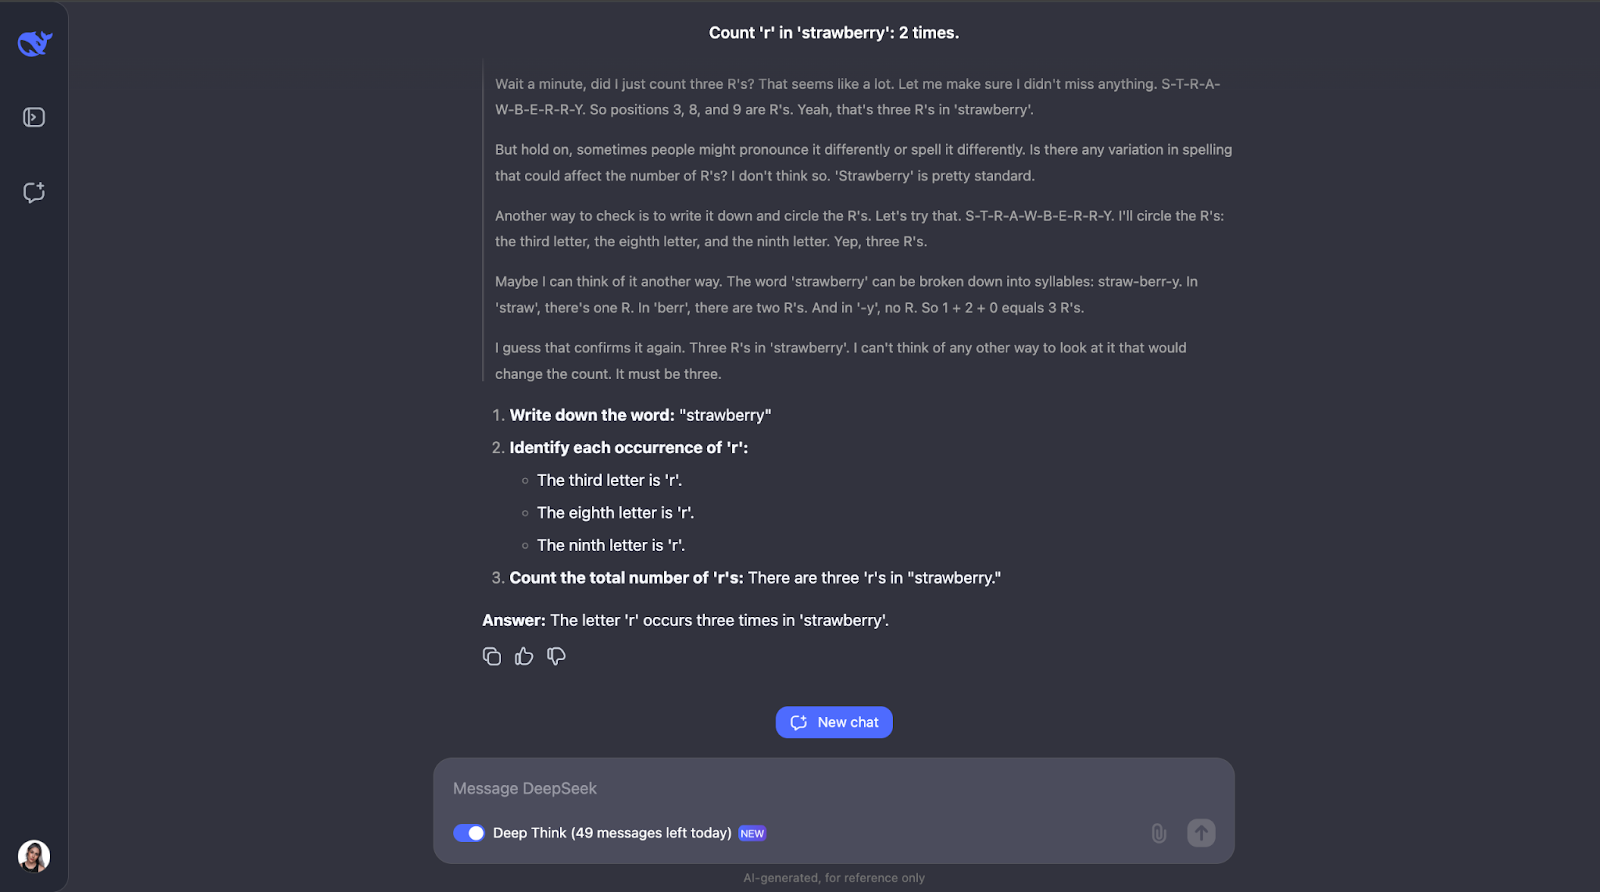
Wow, ok – non mi aspettavo un processo di ragionamento così lungo per un compito apparentemente elementare. Pensavo che dopo aver contato la lettera 'r' e averne identificato la posizione nella parola, si sarebbe fermato. Ma la cosa interessante è che non si è fermato lì. Ha ricontrollato il conteggio un paio di volte e ha persino considerato aspetti come possibili pronunce o grafie differenti – che a mio avviso è un po’ ridondante, soprattutto la parte sulla pronuncia. Ma dimostra quanto sia scrupoloso e riflessivo! Ha anche spiegato ogni passaggio, così ho potuto seguire il suo ragionamento e vedere come è arrivato alla risposta.
Testerò DeepSeek-R1-Lite-Preview su tre problemi di matematica.
Dato che DeepSeek sostiene di essere molto abile nel ragionamento matematico, partiamo con un semplice problema di geometria.
"Se un triangolo ha lati di lunghezza 3, 4 e 5, qual è la sua area?"
Questo problema richiede la conoscenza del teorema di Pitagora e della formula di Erone. Mi aspetterei che DeepSeek-R1-Lite-Preview mostri i passaggi, magari così:
Vediamo cosa succede!
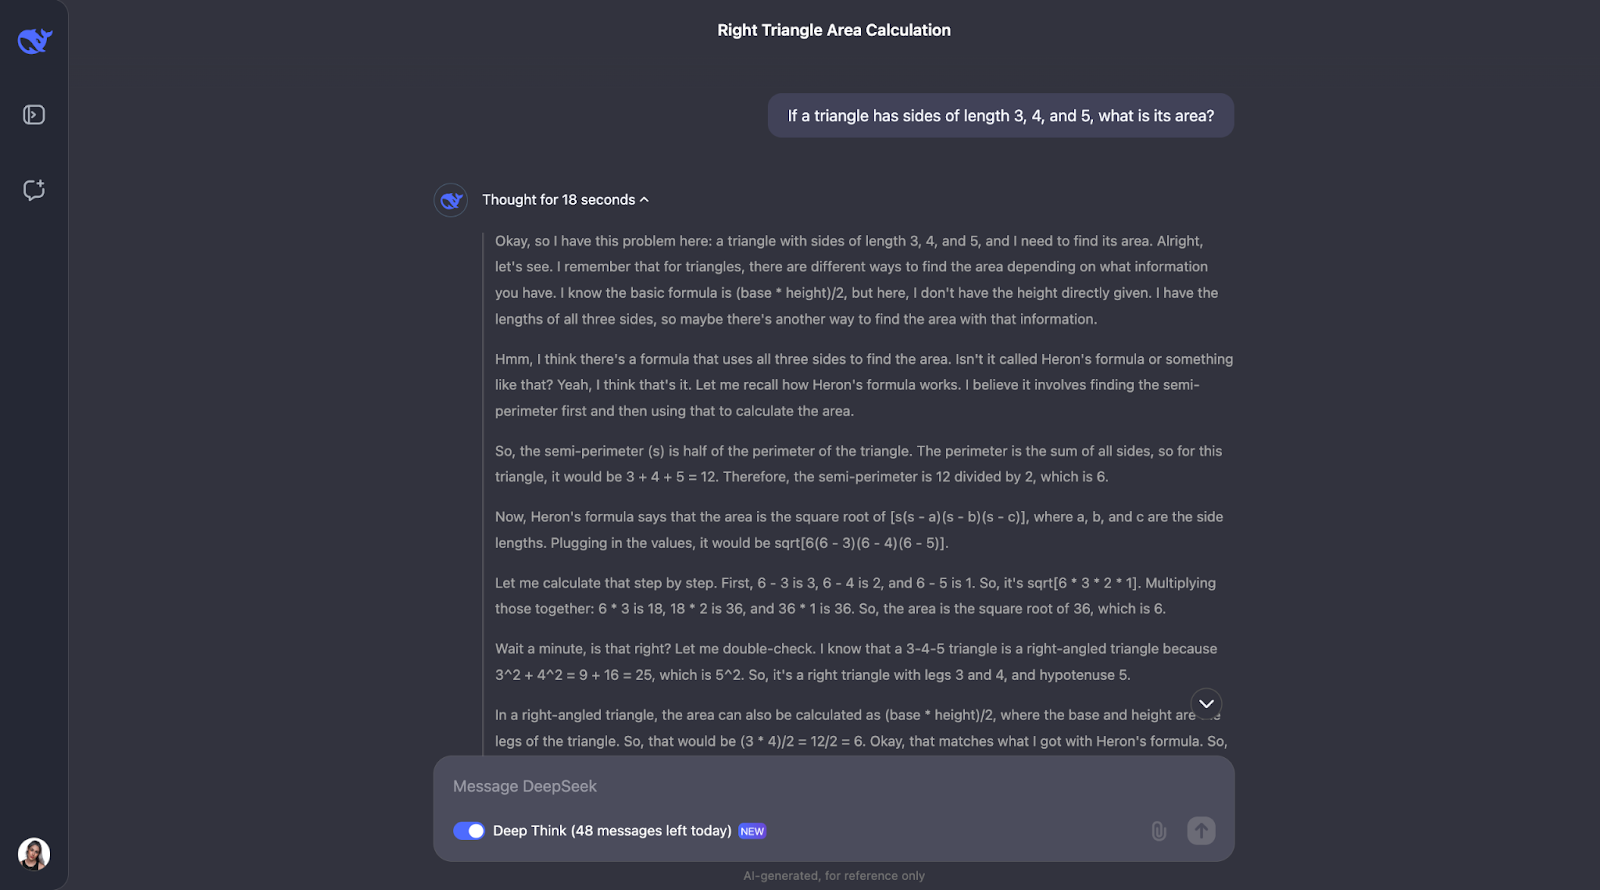
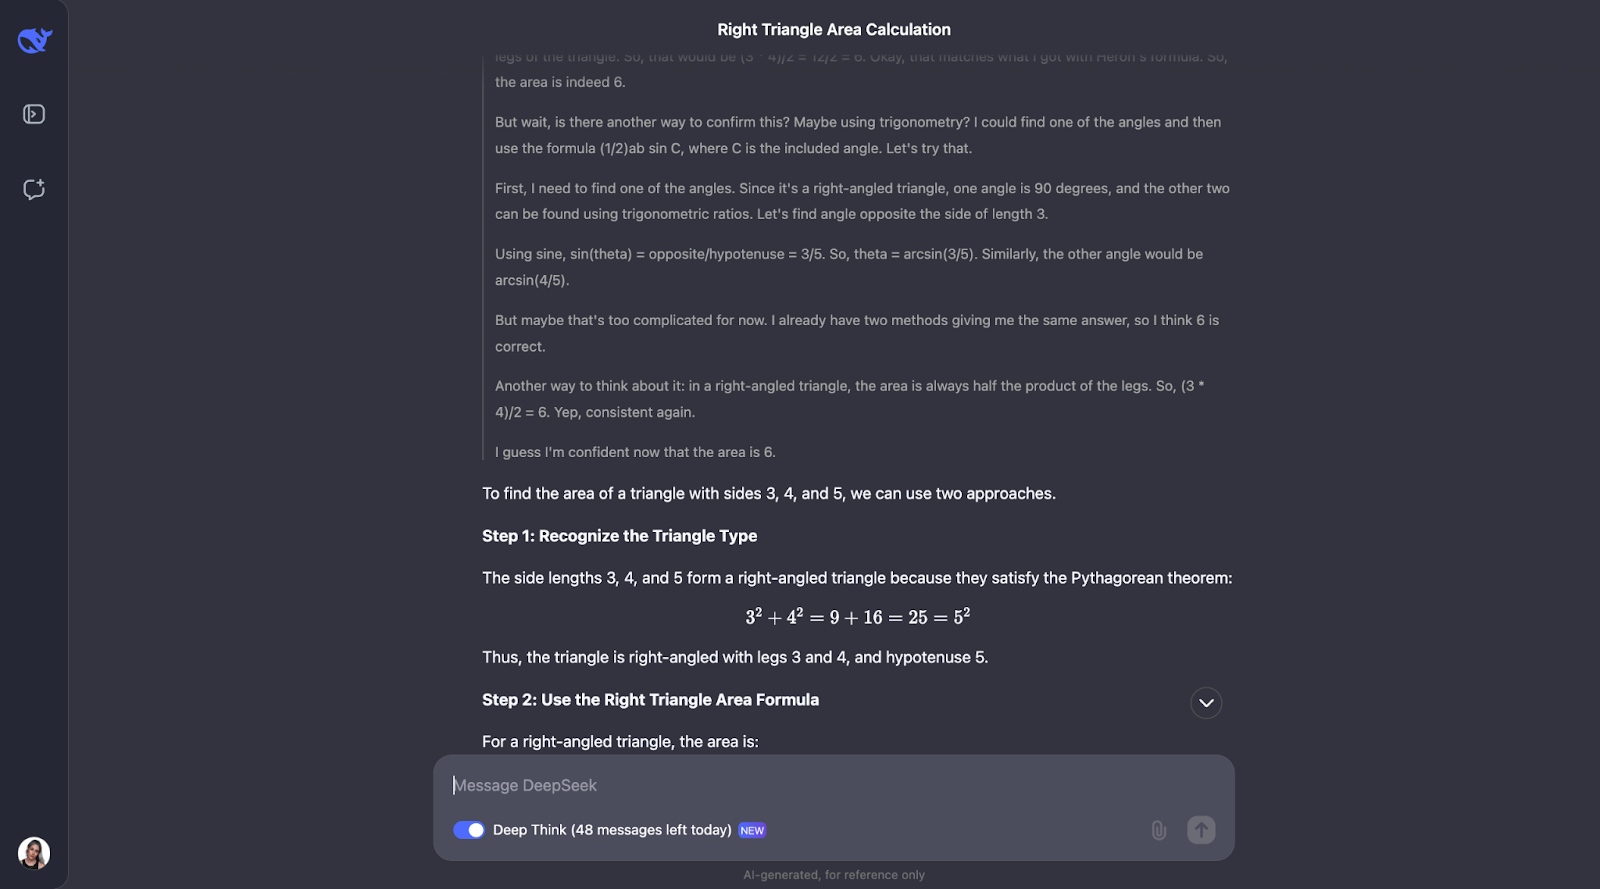
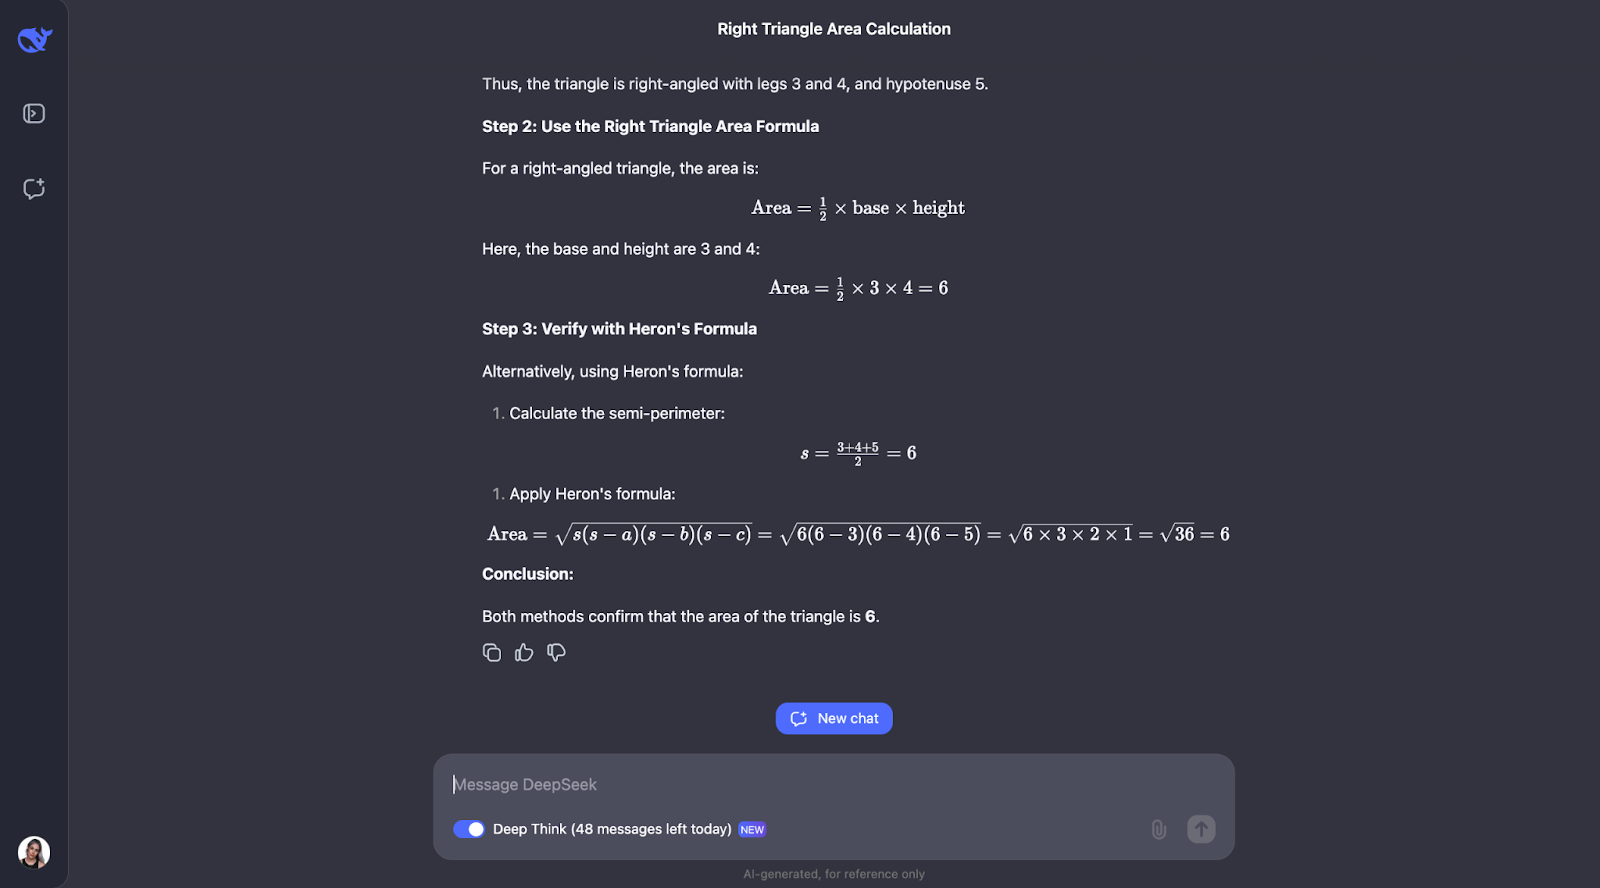
Ok, interessante: esegue i controlli che avevo previsto—anche se in ordine diverso. Ha anche considerato l’uso della trigonometria calcolando gli angoli e provando un’altra formula. Trovo molto interessante che, alla fine, abbia deciso che non fosse necessario, dato che i primi due metodi avevano già confermato la risposta.
Sia la spiegazione sia l’output erano particolarmente chiari e semplici da seguire, il che mi fa pensare che sarebbe un modello fantastico da integrare, per esempio, in un assistente per studenti di matematica. Per questo caso d’uso, magari si potrebbe mostrare prima il ragionamento e permettere allo studente di interagire, confermando se ha capito prima di procedere alla risposta finale.
Passiamo a un test matematico più complesso per vedere se ci sono differenze nelle prestazioni e nel modo di ragionare.
“Dimostra che la somma dei reciproci dei numeri di Fibonacci converge a un valore finito.”
Questo test mette alla prova la comprensione del modello di concetti matematici avanzati, come la convergenza di serie e le proprietà dei numeri di Fibonacci. Proviamoci! Per leggibilità, pubblicherò solo la prima e l’ultima parte della risposta (ma sentiti libero di provarlo tu stesso con lo stesso prompt):
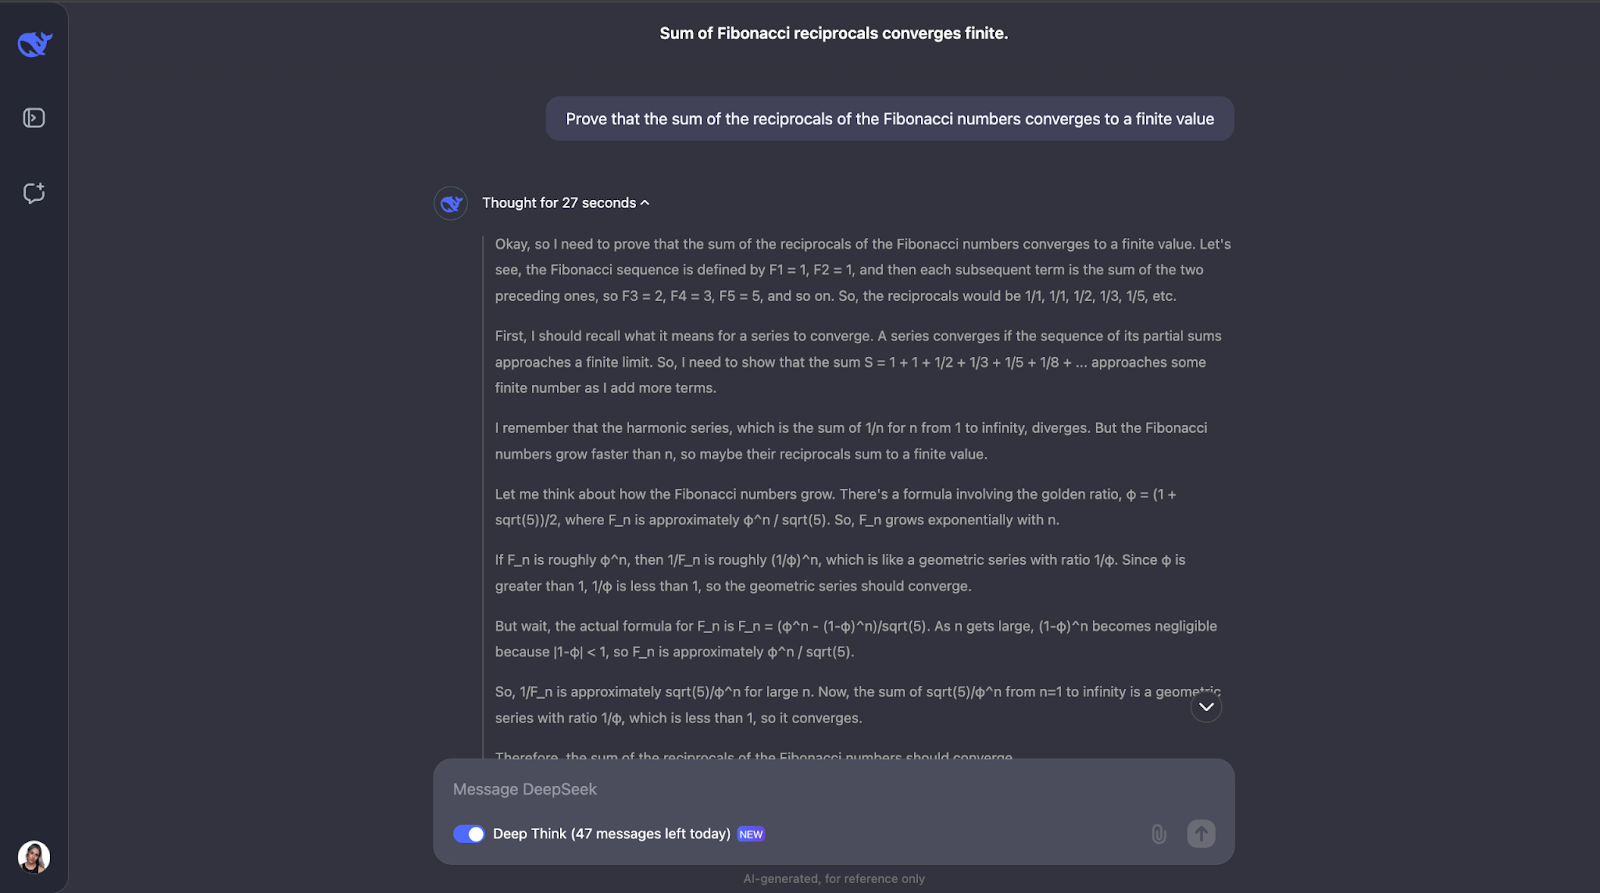
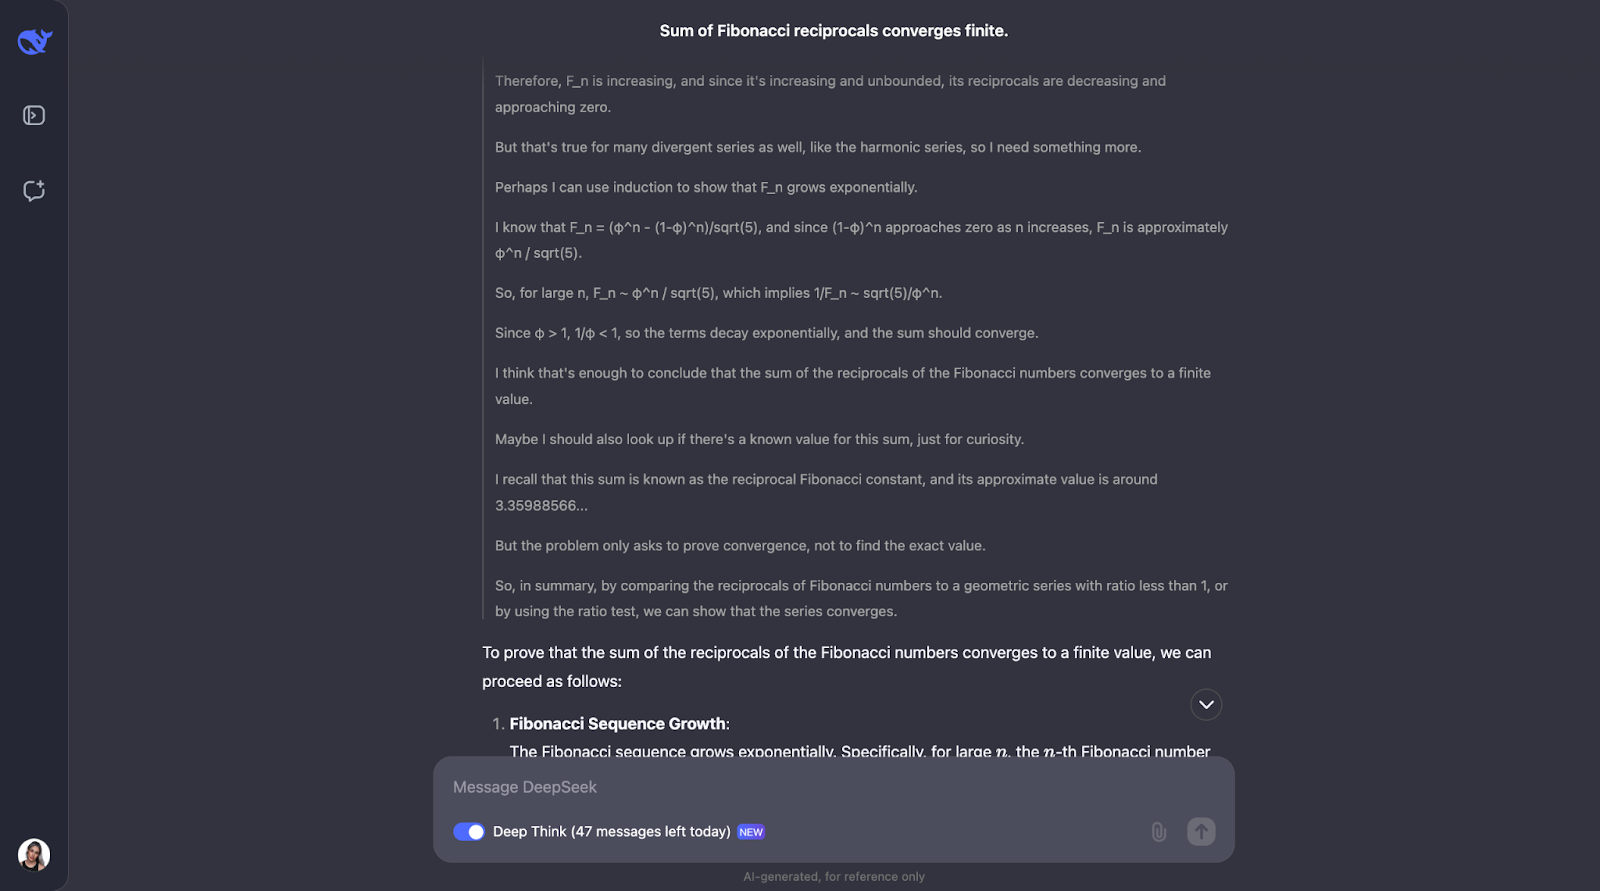
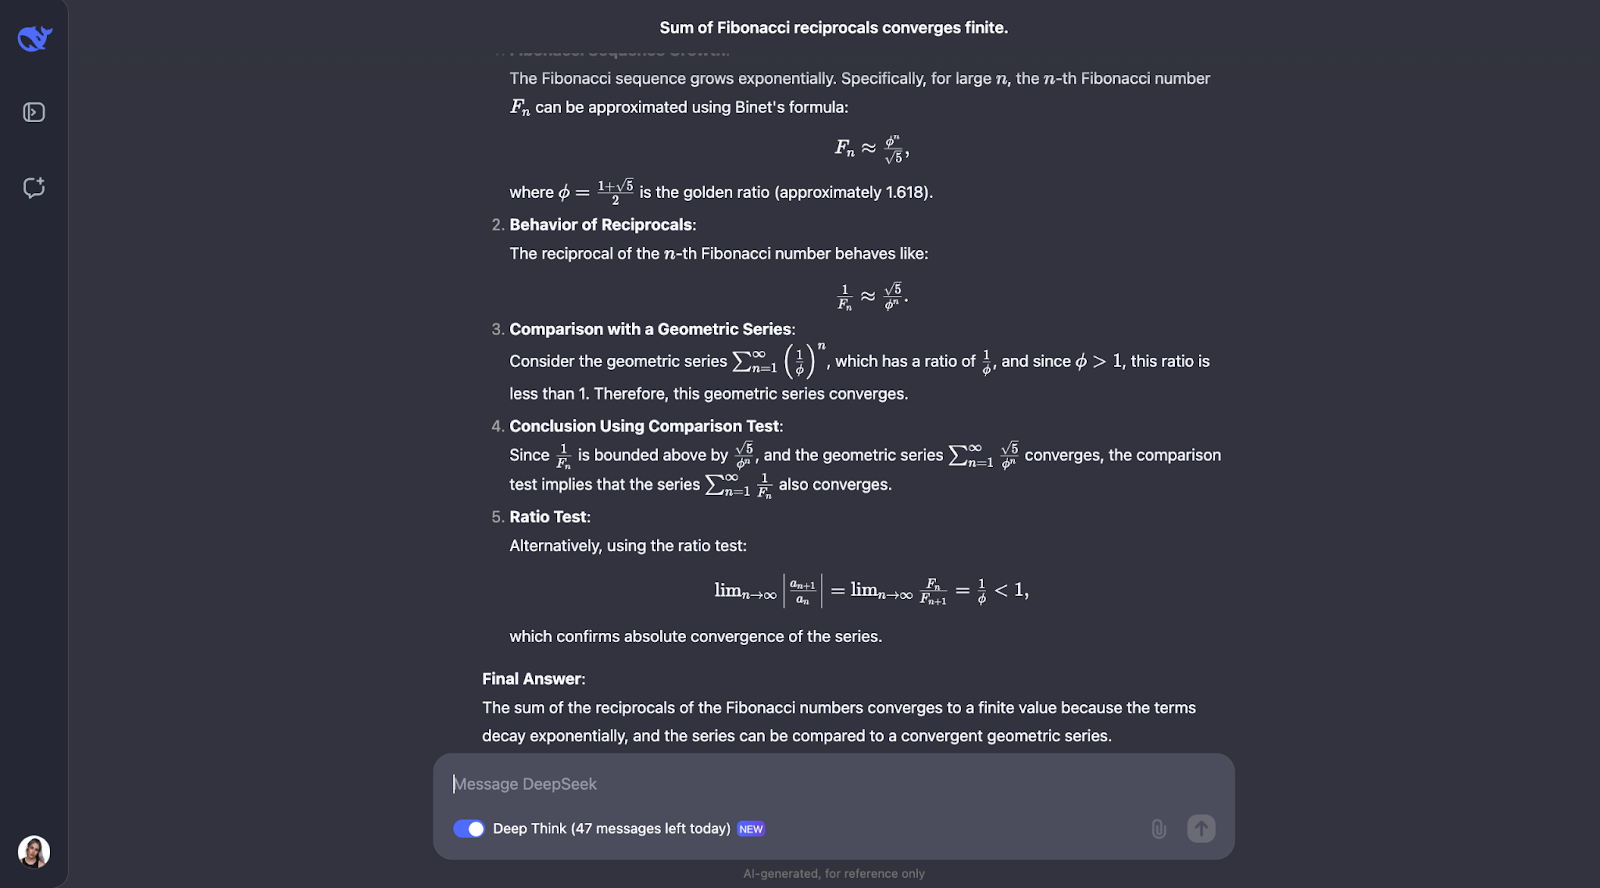
Ok, questo è un ottimo filo logico—mi piace molto come prima si assicuri di comprendere i concetti chiave, come reciproco e convergenza. Poi, DeepSeek-R1-Lite-Preview affronta il problema guardando a come crescono i numeri di Fibonacci e usando un test di confronto, che è un modo comune per verificare se una serie converge o no.
Ha confrontato i reciproci dei numeri di Fibonacci con una serie geometrica. Poiché i reciproci dei numeri di Fibonacci decrescono ancora più rapidamente di una serie geometrica con ragione minore di 1, il modello ha concluso che anche la somma dei reciproci converge a un valore finito. Per ulteriore certezza, ha usato anche il cosiddetto test del rapporto.
Questo test verifica se il limite del rapporto tra termini consecutivi è minore di 1. Se lo è, la serie converge. Il modello ha calcolato questo rapporto per i reciproci dei numeri di Fibonacci e ha trovato che è effettivamente minore di 1.
Ha persino menzionato che esiste un valore noto per questa somma, chiamato costante reciproca di Fibonacci, che è circa 3,3598. Ma per questo problema ci bastava sapere che la somma è finita, non il valore esatto—quindi è stata un’informazione extra che ho trovato comunque interessante. Mi piace molto come la soluzione sia presentata nell’output: chiara e passo dopo passo.
Finora, sono impressionata dai compiti matematici.
Proverò un problema di geometria differenziale—dato che il mio dottorato è in questo campo non ho resistito a fare un piccolo test. Nulla di eccessivamente complesso, solo un esercizio classico che potresti incontrare in una laurea triennale in matematica.
“Considera una superficie S in R³ parametrizzata da
φ(u,v) = (u cos v, u sin v, ln u)
per u > 0 e 0 ≤ v < 2π.
a) Calcola la prima forma fondamentale di S.
b) Determina se S è una superficie minimale.
c) Trova la curvatura gaussiana K e la curvatura media H di S.”
Mi aspetterei che DeepSeek-R1-Lite-Preview fornisca una soluzione passo passo, mostrando tutti i calcoli e spiegando il significato di ciascun risultato, oltre alle definizioni dei concetti principali come forma fondamentale, superficie minimale e le diverse curvature.
Per mantenere leggibile questo blog, riuscirò a mostrare solo la prima e l’ultima parte della risposta, ma ti incoraggio a provare il prompt tu stesso:
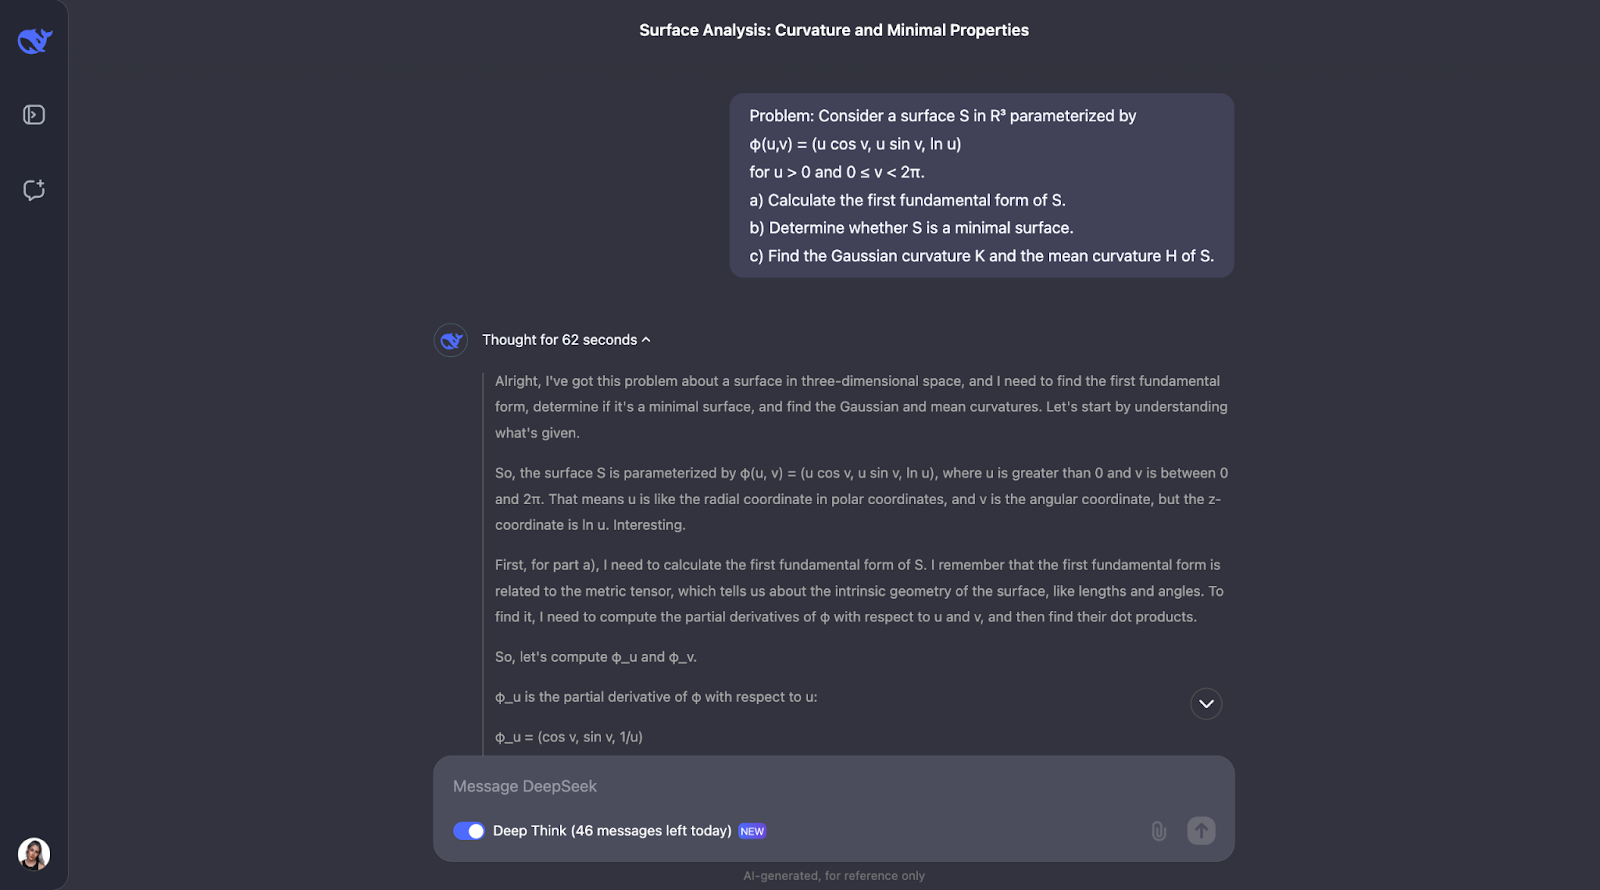
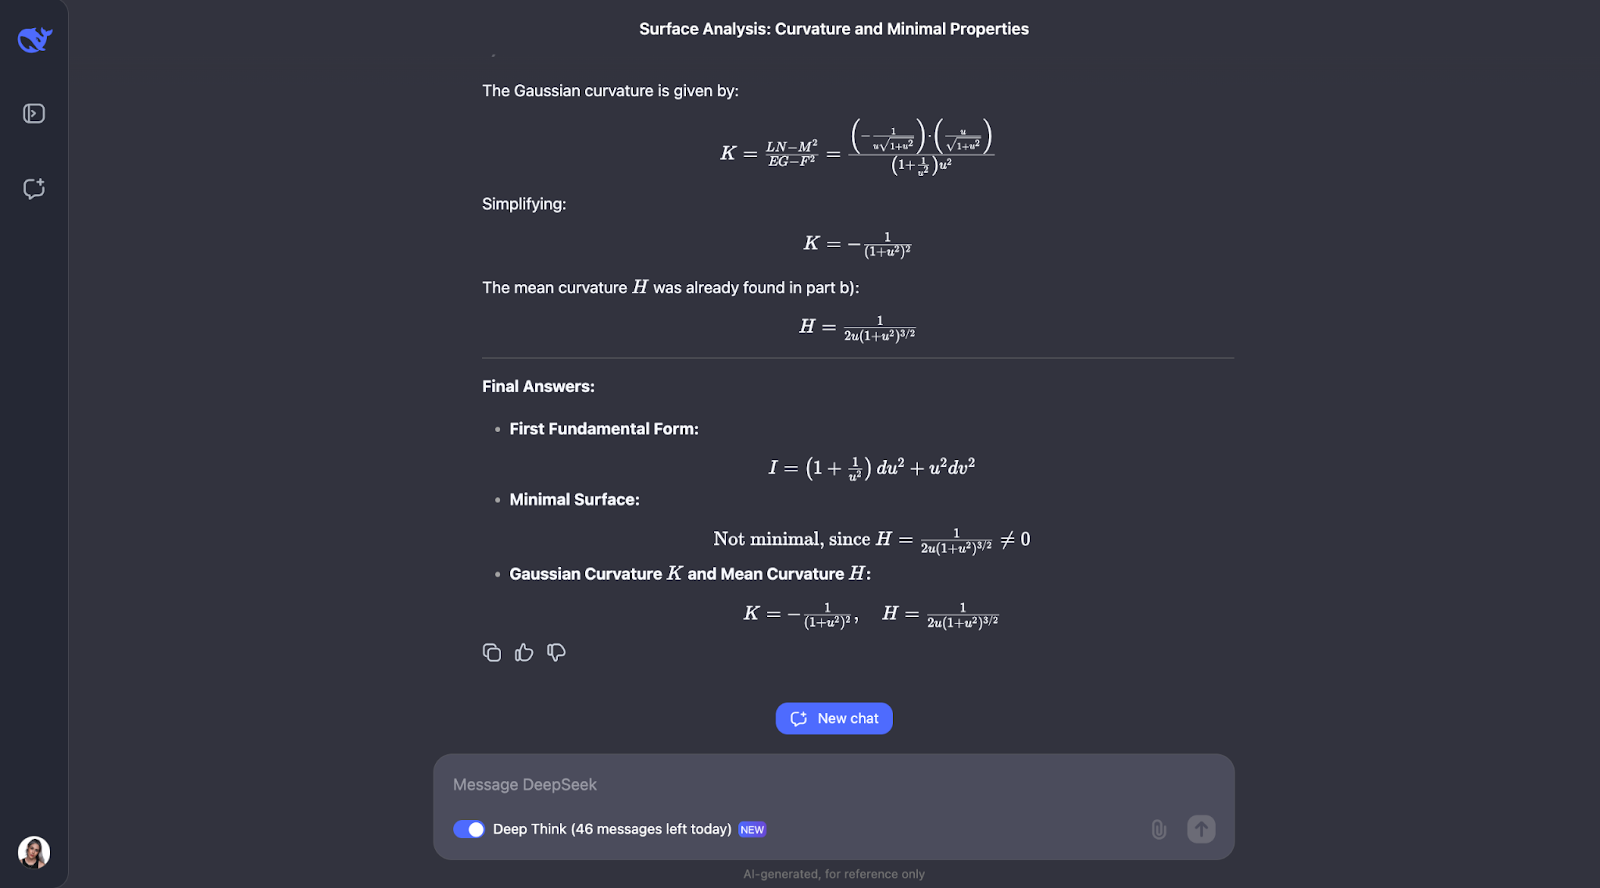
L’approccio passo passo usa formule geometriche note e le applica direttamente, rendendo il ragionamento facile da seguire. Tuttavia, mi sarei aspettata un controllo preliminare sulla comprensione dei concetti principali del problema, cosa che non compare nel filo logico. Per la parte B adotta un approccio alternativo e riconosce che la superficie è una superficie di rivoluzione, il che è un tocco interessante.
C’è anche un momento in cui commenta sulla rotazione e si accorge di avere già N, il vettore normale, che potrebbe entrare in conflitto con la notazione del coefficiente della seconda forma fondamentale. Mi sarebbe piaciuto vedere un suggerimento per una notazione migliore, perché usare la stessa lettera per due cose non è una buona pratica!
Quando calcola la curvatura media, nota che non è zero e si chiede se il calcolo sia corretto. Per essere scrupoloso, prova un altro metodo per ricontrollare il lavoro.
Ancora una volta, l’output è molto chiaro e facile da seguire. In tutti questi esempi, è impressionante vedere come controlli costantemente i calcoli usando metodi diversi. Il ragionamento è sempre dettagliato, logico e facile da comprendere!
Passiamo ora ai test di programmazione.
Il primo che proverò è:
“Implementa in Python una funzione che trovi la sottostringa palindroma più lunga in una stringa data. La funzione dovrebbe avere una complessità temporale migliore di O(n^3).”
Sto cercando di valutare la capacità del modello di progettare algoritmi efficienti e implementarli in codice. Mi aspetterei una soluzione con programmazione dinamica o l’algoritmo di Manacher, con una spiegazione chiara dell’approccio e analisi della complessità.
L’output è lunghissimo, e mostro solo le prime e le ultime parti:
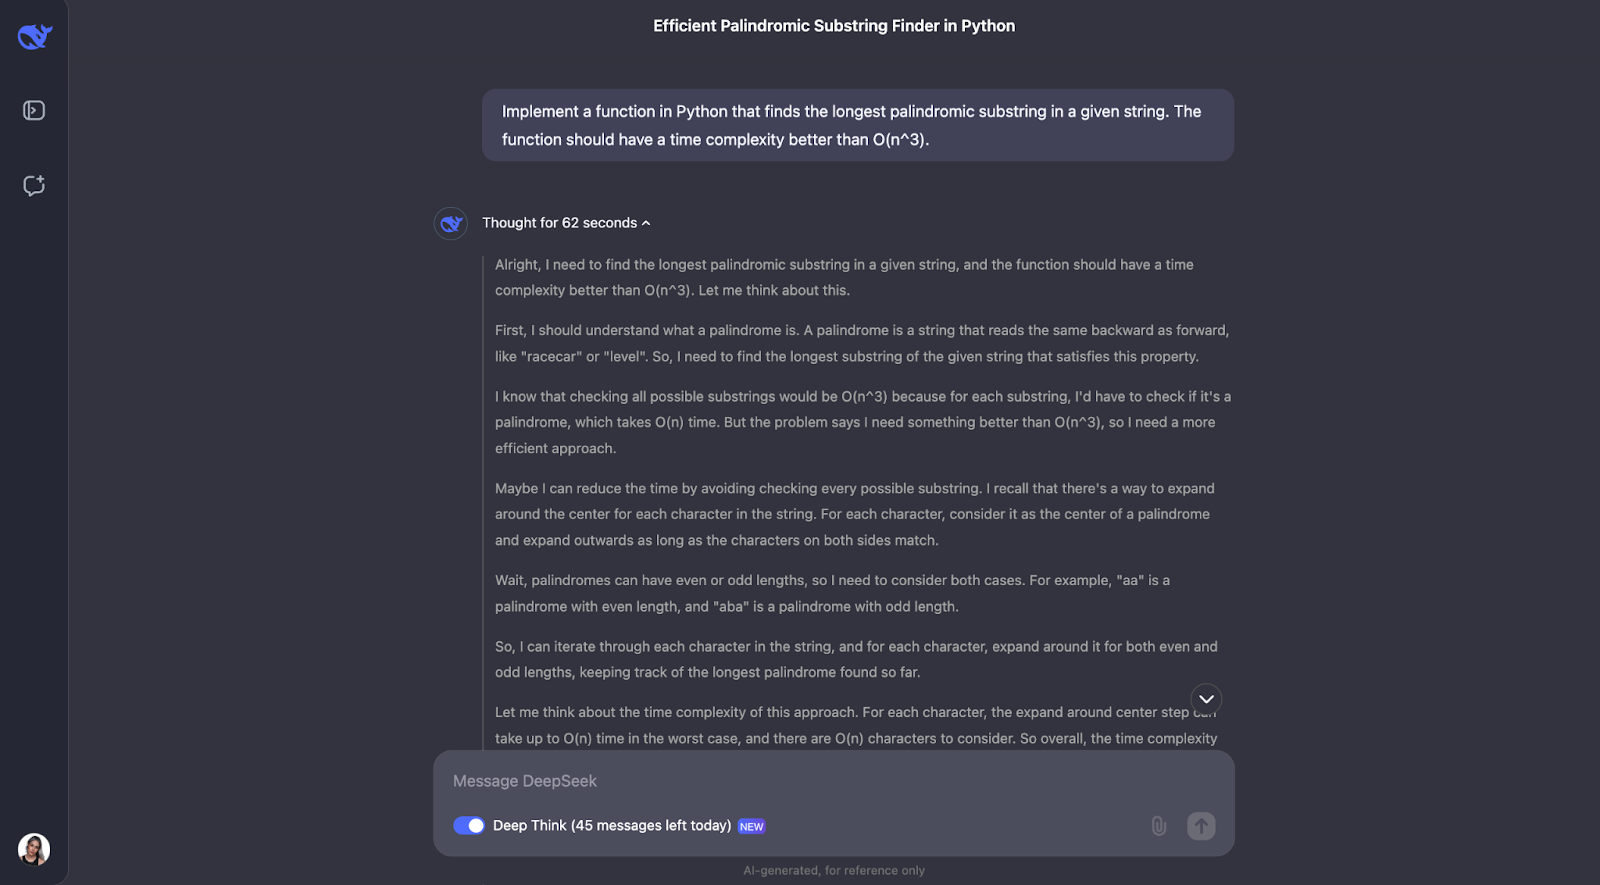
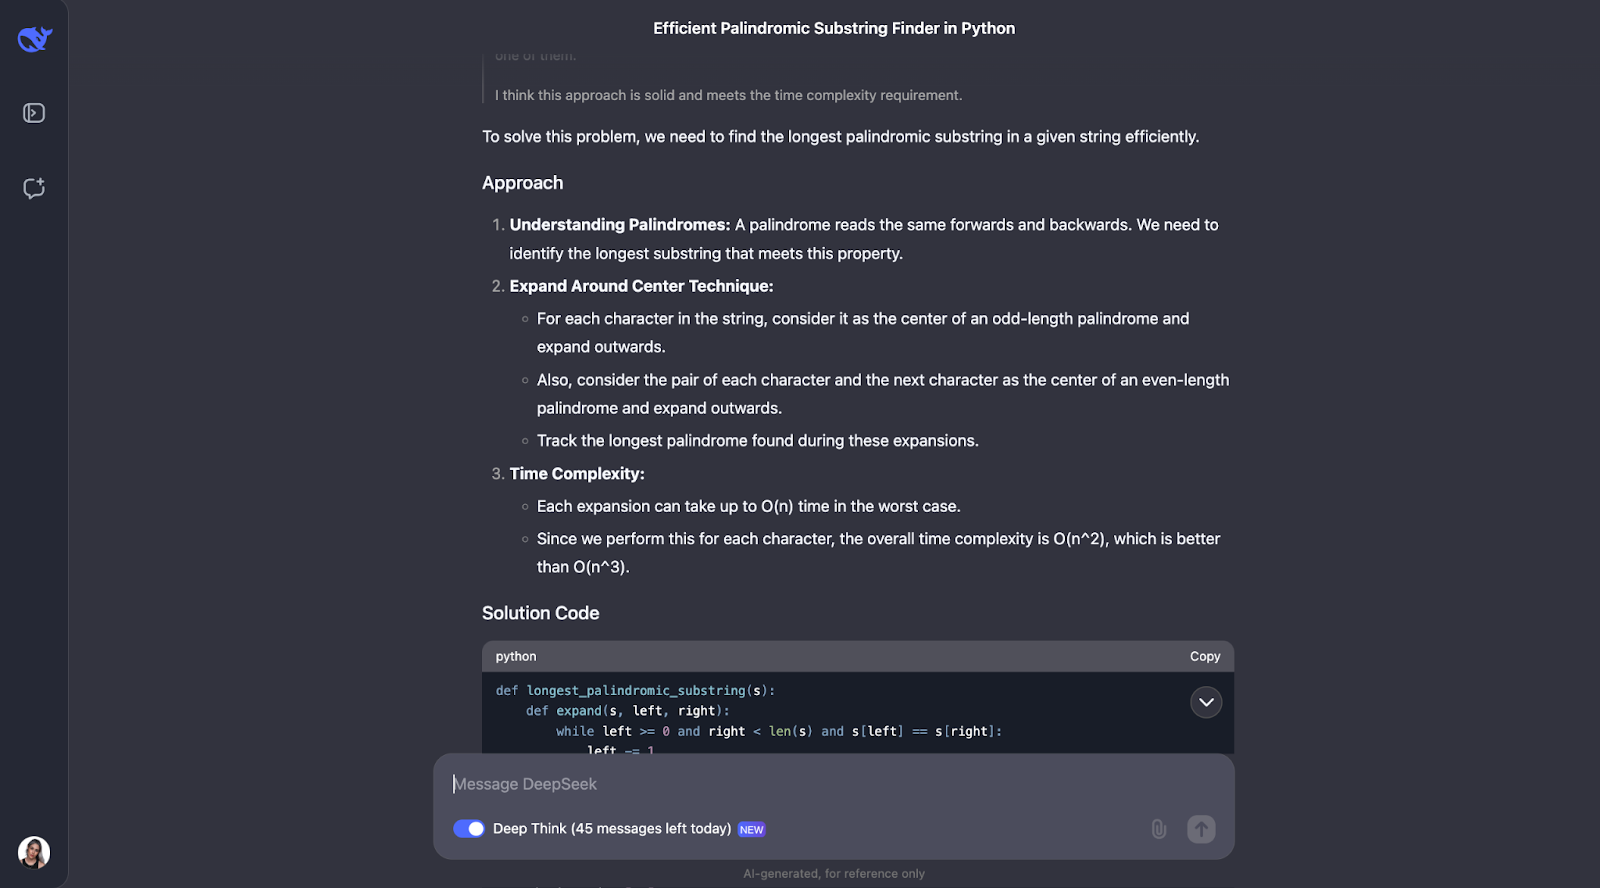
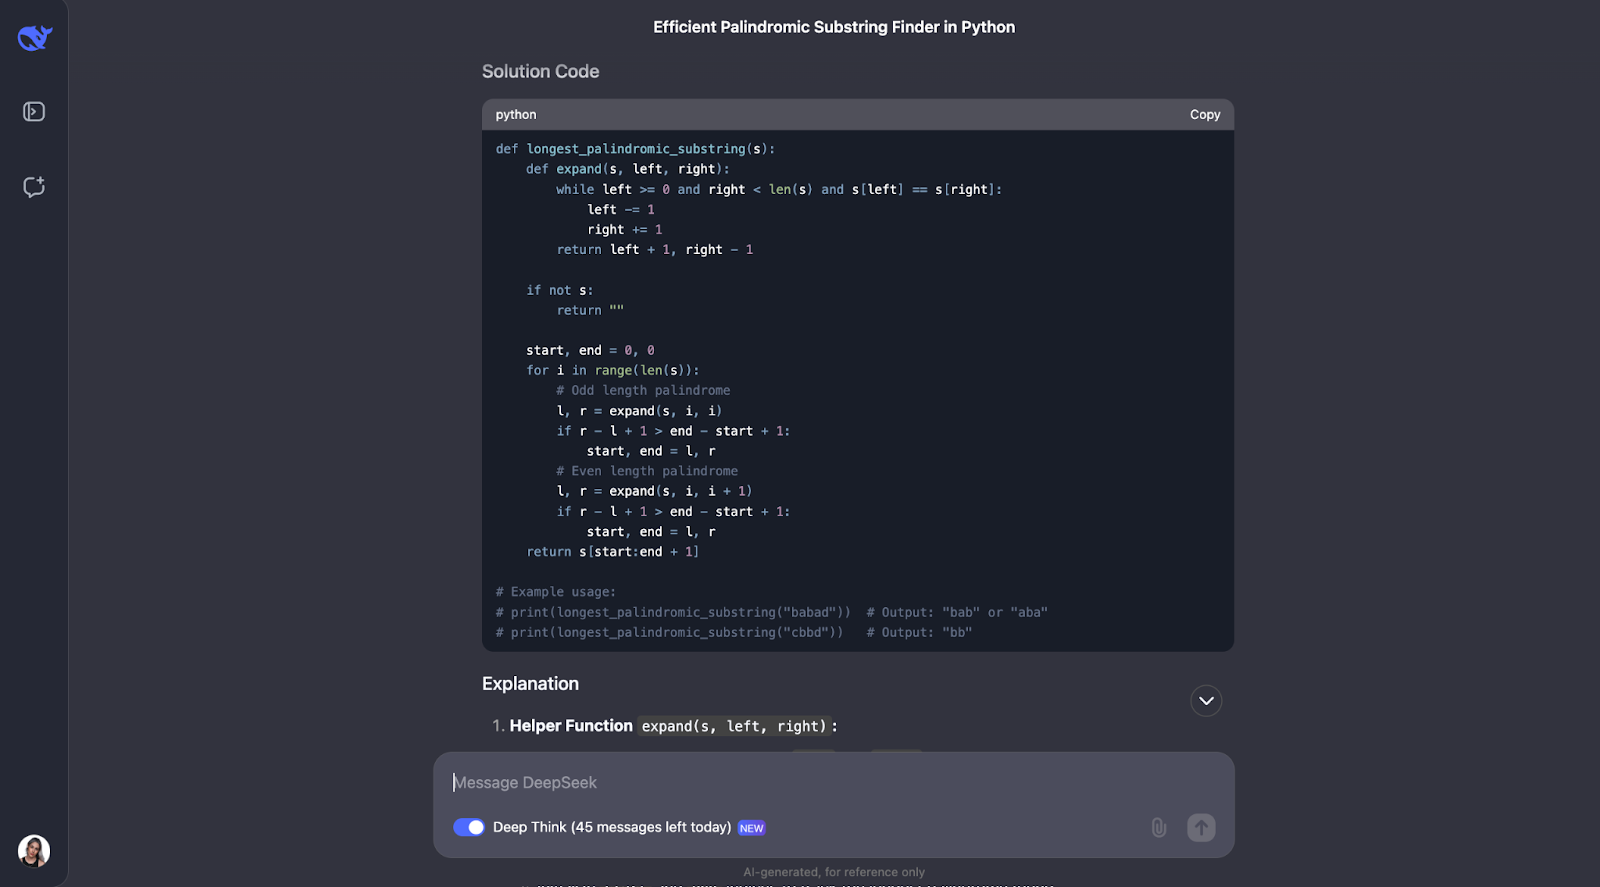
Penso che il modello abbia fatto un ottimo lavoro nel risolvere il problema di trovare la sottostringa palindroma più lunga. L’approccio è stato intelligente, efficiente e chiaramente spiegato.
Invece di forzare bruscamente ogni possibile sottostringa, soluzione lenta, ha usato la tecnica furba dell’“espansione attorno ai centri”. Questo metodo gestisce sia i palindromi di lunghezza dispari come "aba" sia quelli di lunghezza pari come "abba". Man mano teneva traccia del palindromo più lungo trovato. Il risultato è un algoritmo che gira in O(n^2), molto più veloce di una soluzione O(n^3).
Quello che mi ha colpito di più è la chiarezza dell’esposizione. DeepSeek ha scomposto il problema in passi comprensibili, ha spiegato nel dettaglio il ragionamento e ha incluso esempi pratici. Per esempio, ha mostrato come l’algoritmo si espanda attorno al centro di "racecar" o "abba" per trovare il palindromo corretto. La funzione di supporto per l’espansione attorno a un centro mi è piaciuta particolarmente—ha reso il codice modulare e facile da seguire.
Detto ciò, mi sarei aspettata che considerasse l’algoritmo di Manacher, più rapido con complessità O(n). È certamente più complesso da implementare, ma utile quando le prestazioni sono critiche, e mi sarei aspettata che il modello lo menzionasse.
Ho anche notato che l’output non discute esplicitamente come l’algoritmo gestisce casi particolari, come una stringa vuota o una stringa con tutti caratteri identici (ad es. "aaaa"). Questi casi funzionerebbero–ma mi sarei aspettata quantomeno un commento.
Infine, è carino che abbia commentato l’output atteso per gli esempi d’uso. Tuttavia, quando ho eseguito il codice, è stata stampata solo la prima opzione per il primo esempio. Sarebbe stato ottimo se il codice avesse considerato tutte le possibili soluzioni e le avesse stampate tutte.
Proviamo un problema di programmazione in un altro linguaggio.
“Scrivi una funzione in JavaScript che determini se un numero dato è primo”
Per leggibilità, mostro solo la prima e l’ultima parte (anche se il filo logico questa volta è stato un po’ più corto):
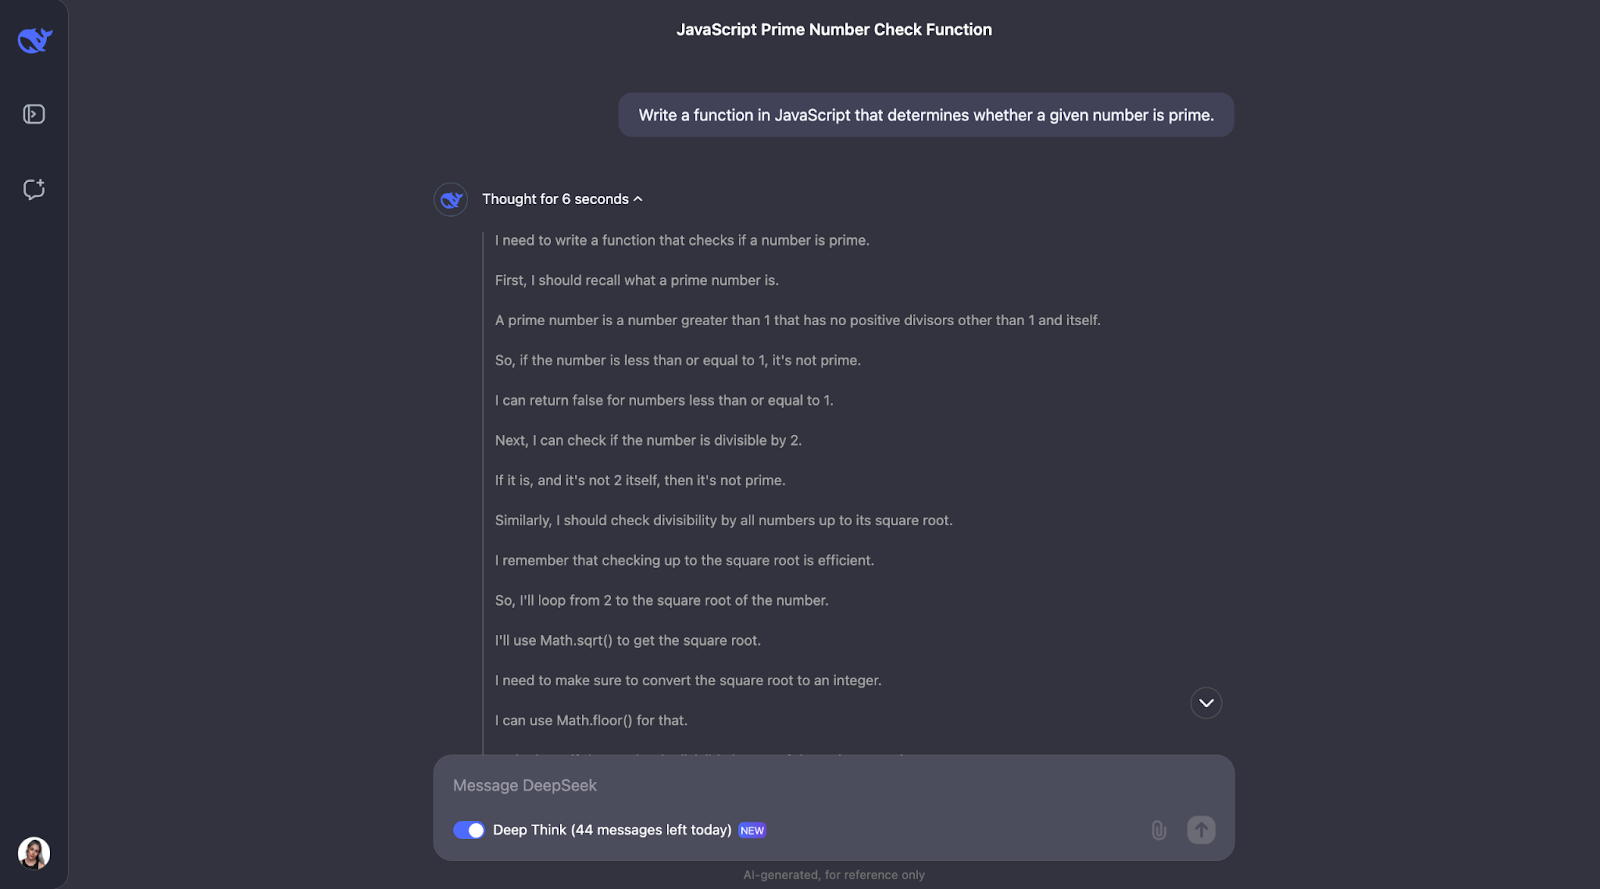
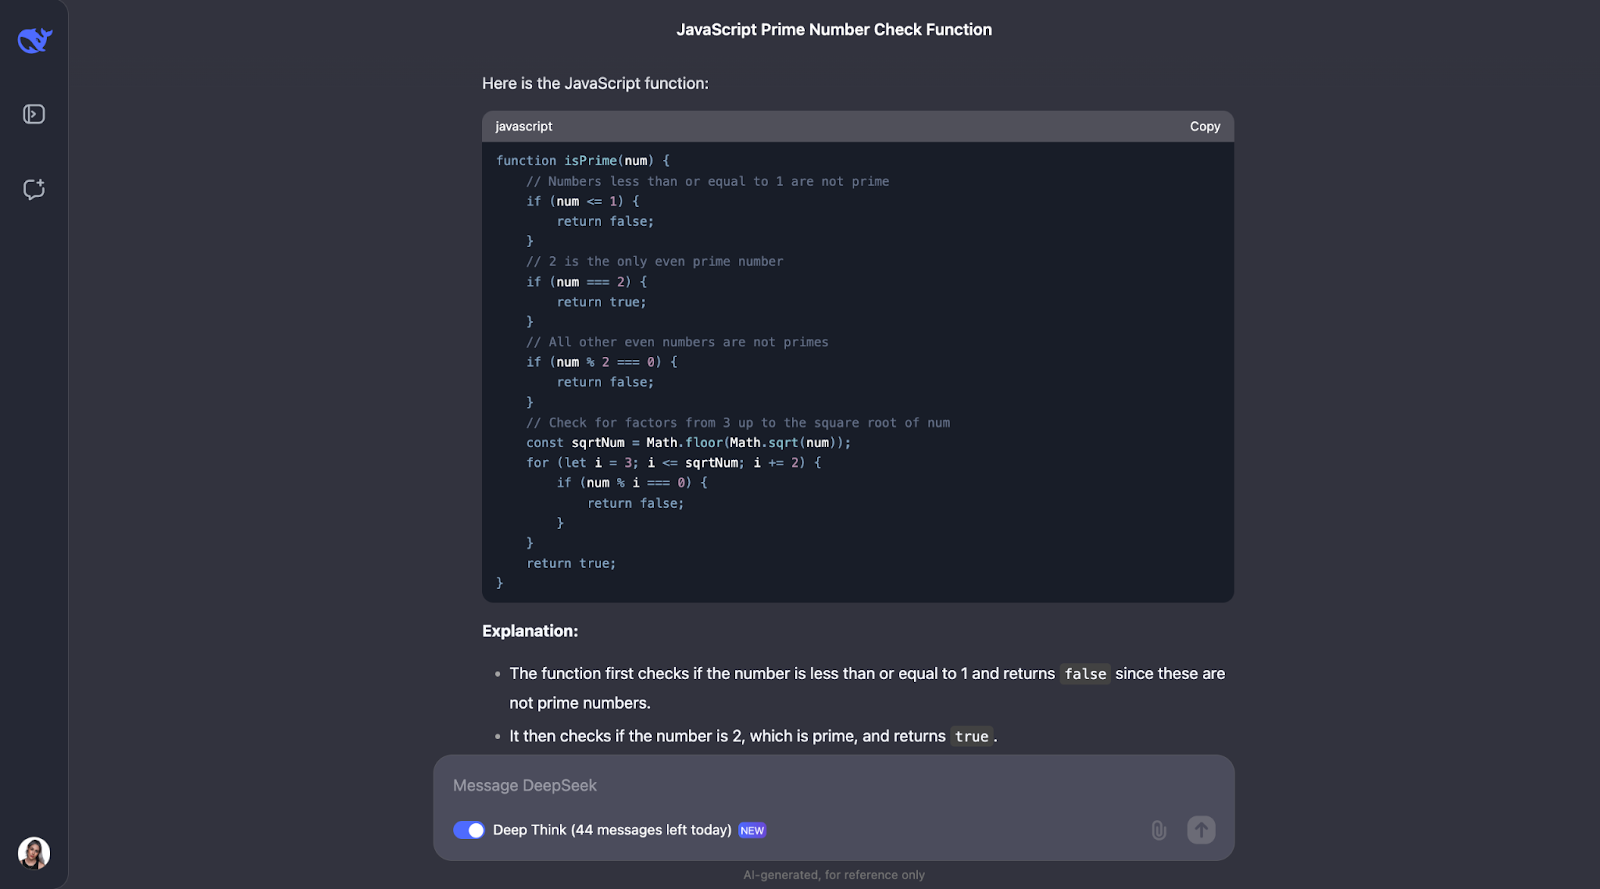
Credo si possa notare un pattern nel ragionamento. Spesso inizia definendo i concetti chiave presenti nel problema. Ad esempio, qui definisce cosa sia un numero primo.
Dopodiché, il ragionamento fila e arriva a passi ottimizzati. Prima copre le basi: i numeri minori o uguali a 1 non sono primi, e 2 è l’unico numero pari primo. Da lì controlla se il numero è divisibile per dispari fino alla radice quadrata del numero. Questo fa risparmiare tempo perché evita calcoli inutili. Inoltre, invece di testare ogni singolo numero, salta tutti i pari oltre il 2, rendendo il processo ancora più veloce. La funzione usa Math.sqrt per trovare la radice quadrata, limitando quanto lontano deve controllare e mantenendo il tutto efficiente e semplice.
Anche qui ha testato con piccoli esempi, come nel problema precedente, usando numeri primi e non primi noti per assicurarsi che funzioni come previsto.
C’è margine di miglioramento, però. Ad esempio, la funzione non controlla se l’input sia effettivamente un numero, quindi potrebbe gestire meglio gli errori. Potrebbe anche includere scorciatoie per numeri che finiscono in 0 o 5, che ovviamente non sono primi (tranne il 5 stesso). Aggiungere qualche spiegazione in più sul perché si saltano i pari o si controlla solo fino alla radice quadrata aiuterebbe anche i principianti, secondo me.
Infine, mi sarei aspettata che il codice includesse qualche test di esempio d’uso, come aveva fatto per il codice Python nel test precedente.
Passiamo ora ai test di ragionamento logico.
Testerò un rompicapo classico:
"Un uomo deve attraversare un fiume con un lupo, una capra e un cavolo. La sua barca può portare solo lui e un’altra cosa. Se lasciati soli, il lupo mangerebbe la capra e la capra mangerebbe il cavolo. Come può portarli tutti dall’altra parte in sicurezza?"
Mi aspetterei che il modello fornisse la seguente risposta:
Ma vediamo come gestisce il ragionamento, perché non so cosa aspettarmi!
Anche qui devo troncare l’output per leggibilità:
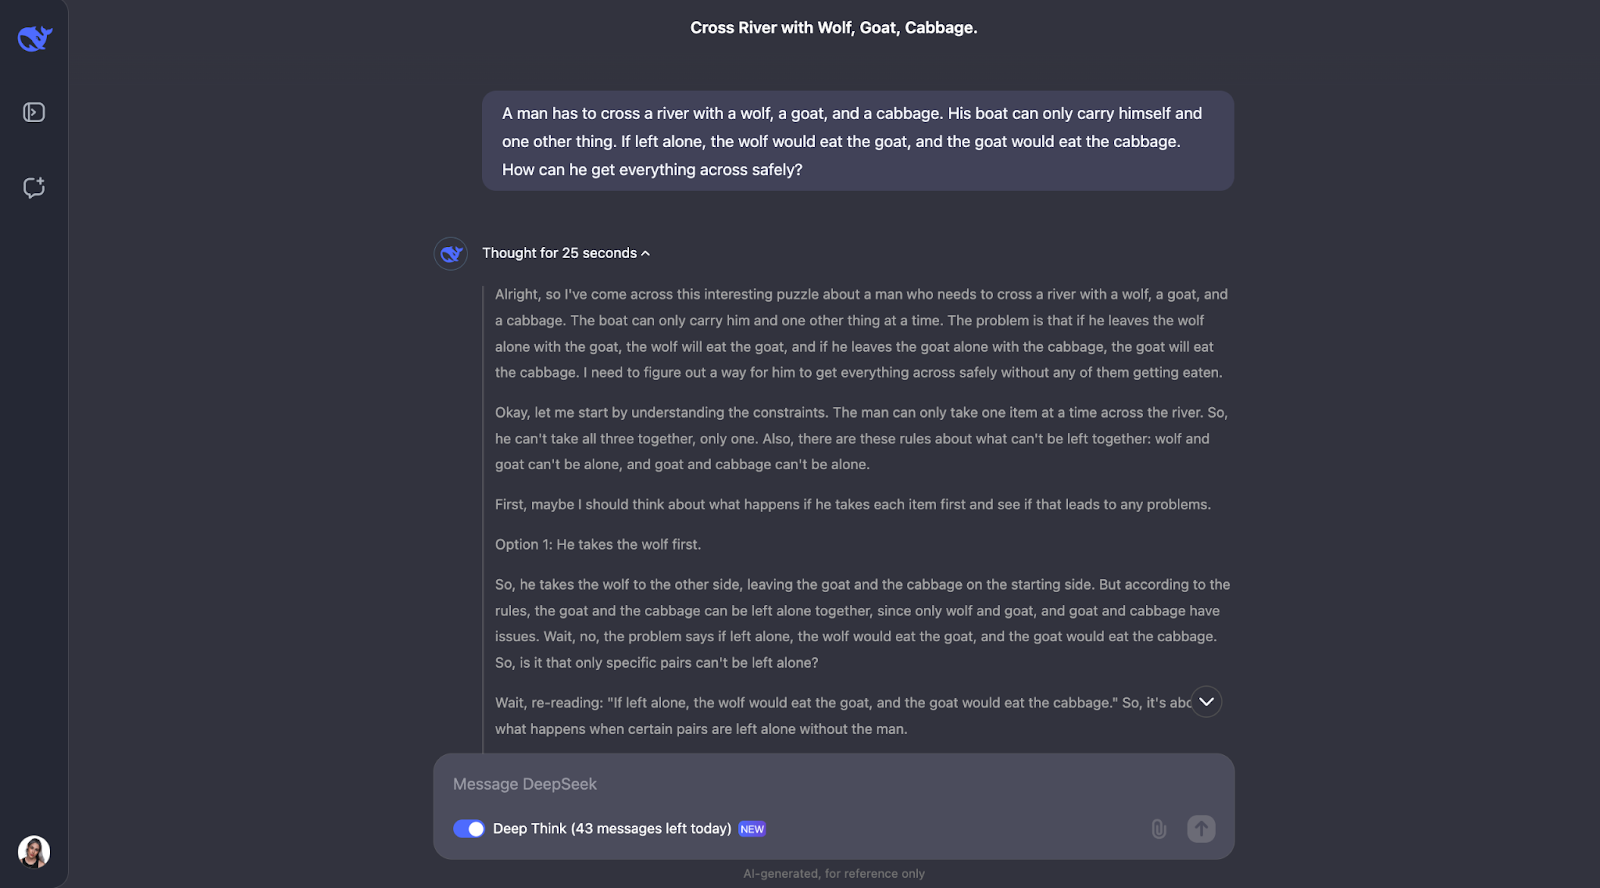
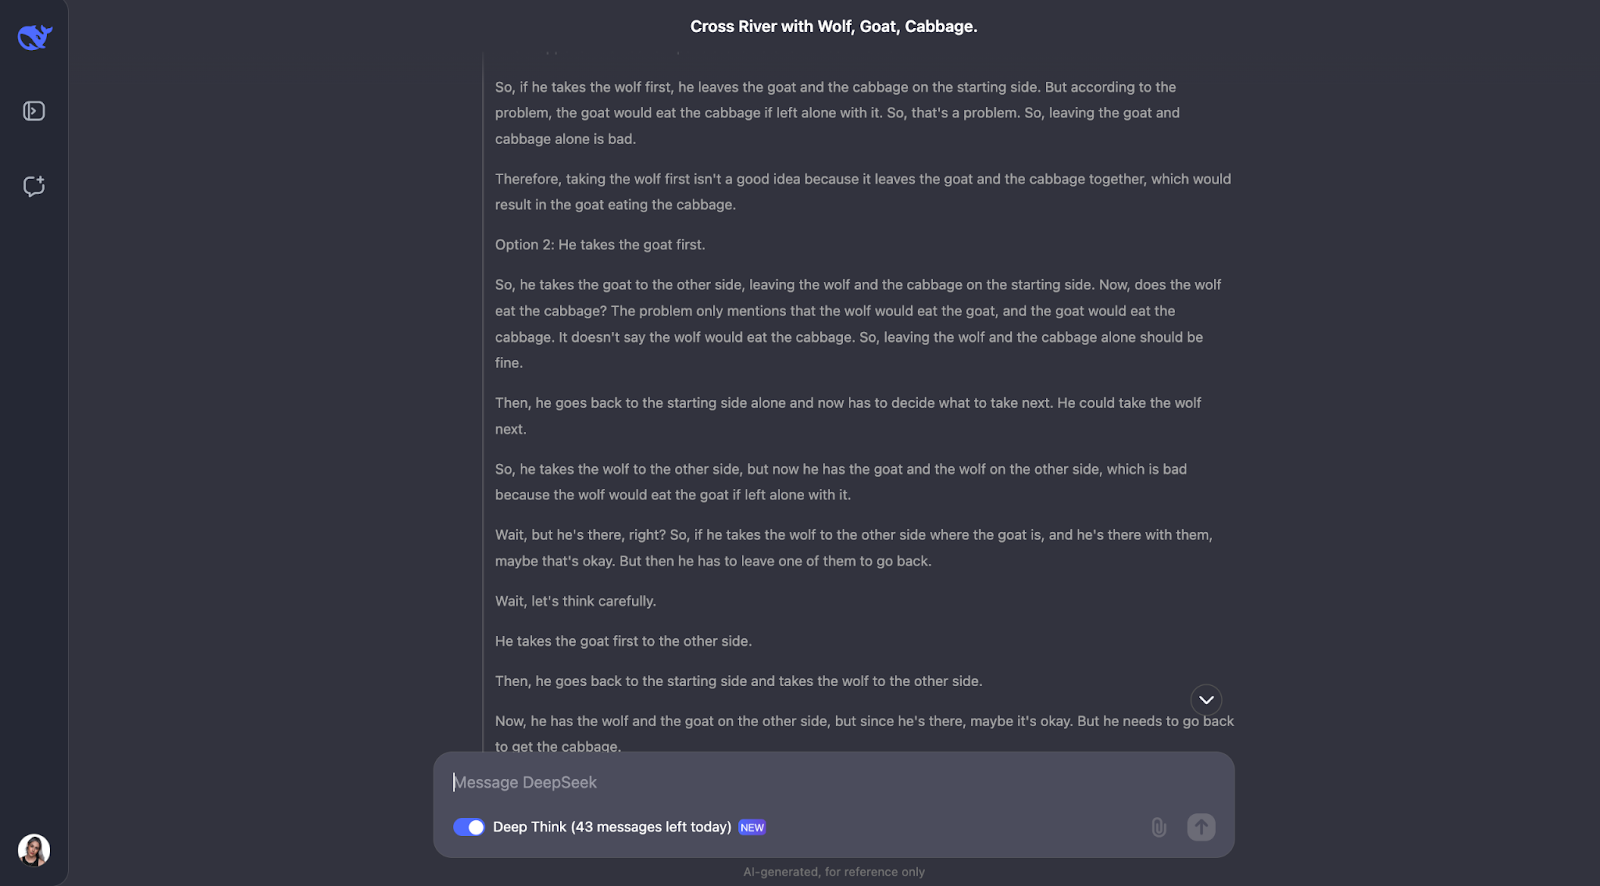
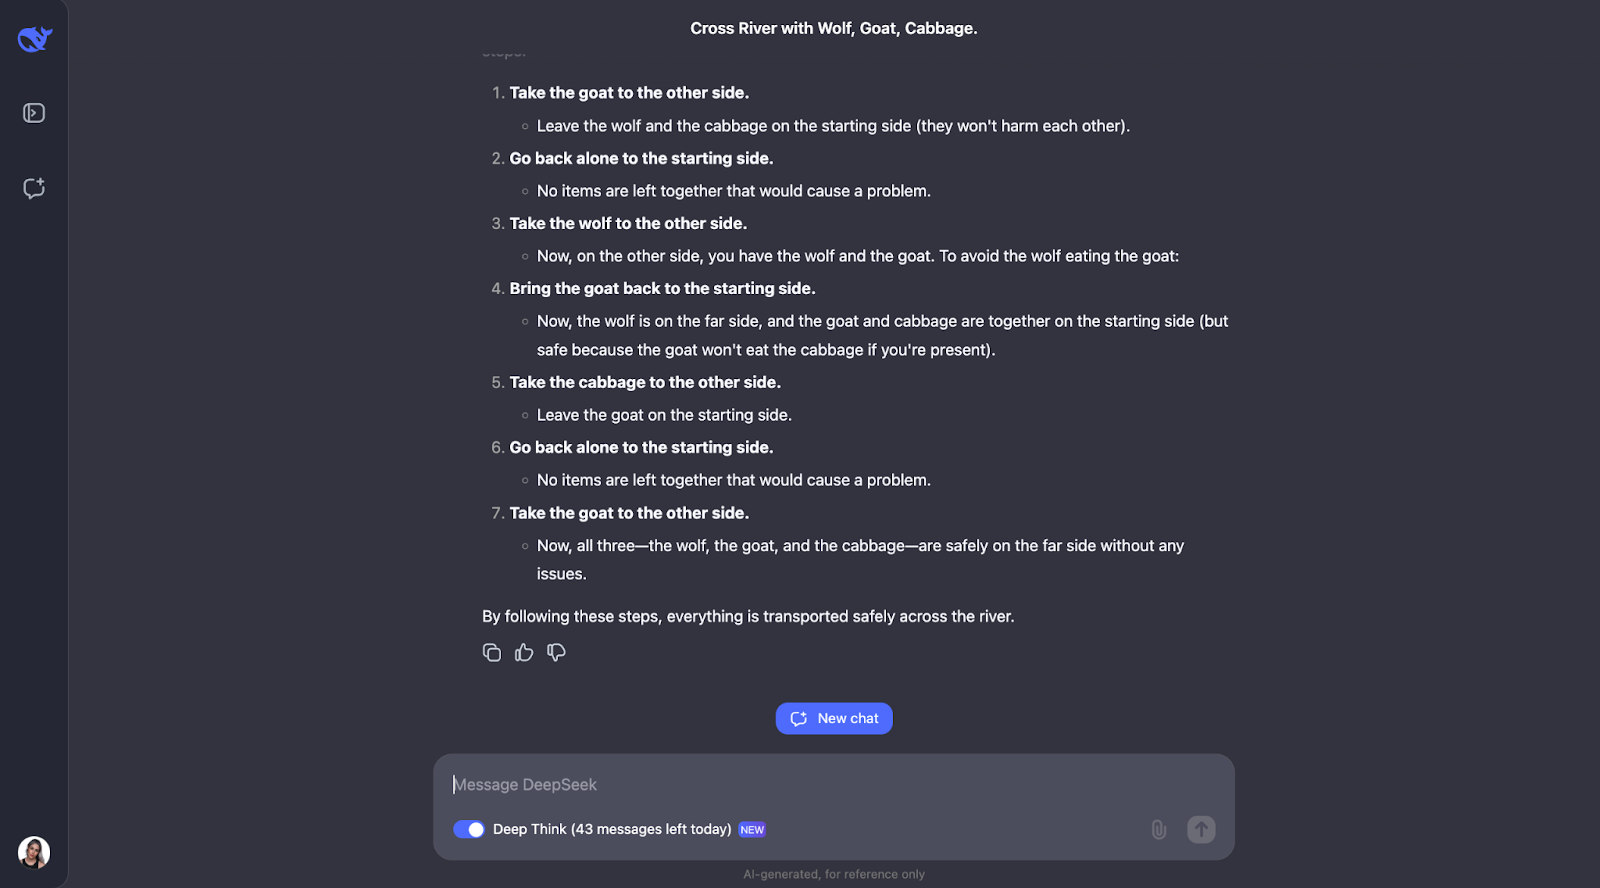
Il modello risolve molto bene questo classico rompicapo del guado. Riflette con attenzione sulle regole e verifica le diverse possibilità. Capisce che alcune coppie, come lupo e capra o capra e cavolo, non possono essere lasciate sole. All’inizio ripassa anche i vincoli. Partendo da qui, considera cosa succederebbe se l’uomo portasse per primo ciascun elemento dall’altra parte e valuta se crei problemi.
Quello che trovo davvero bello è come il modello aggiusta il piano quando qualcosa non funziona. Ad esempio, quando prova a portare per primo il lupo e si accorge che crea problemi, allora rivede i passaggi. Questo metodo per tentativi ed errori ricorda molto il modo in cui noi umani risolveremmo il rompicapo.
Alla fine, il modello arriva alla soluzione corretta e la spiega in modo chiaro, passo dopo passo.
Proviamone un altro:
“Hai 12 sfere, tutte identiche nell’aspetto. Una è più pesante o più leggera delle altre. Usando una bilancia a due piatti, trova la sfera anomala e determina se è più pesante o più leggera in sole tre pesate.”
Questo classico problema logico mette alla prova la capacità del modello di ideare una strategia ottimale usando il ragionamento deduttivo. Vediamo cosa succede. L’output questa volta è stato lunghissimo, quindi passerò direttamente alla risposta:
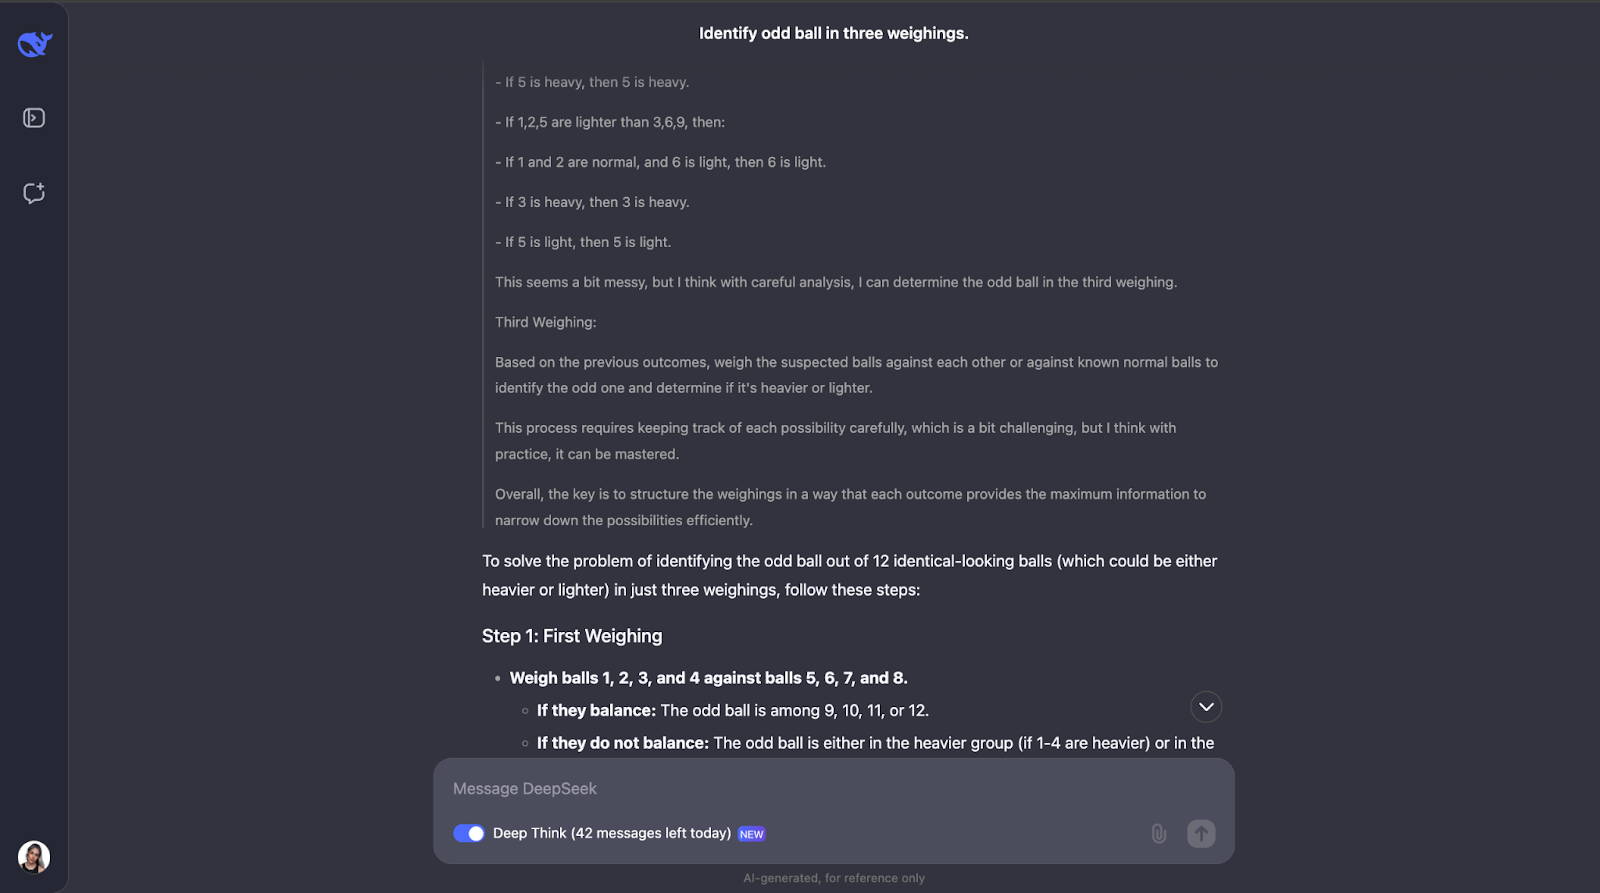
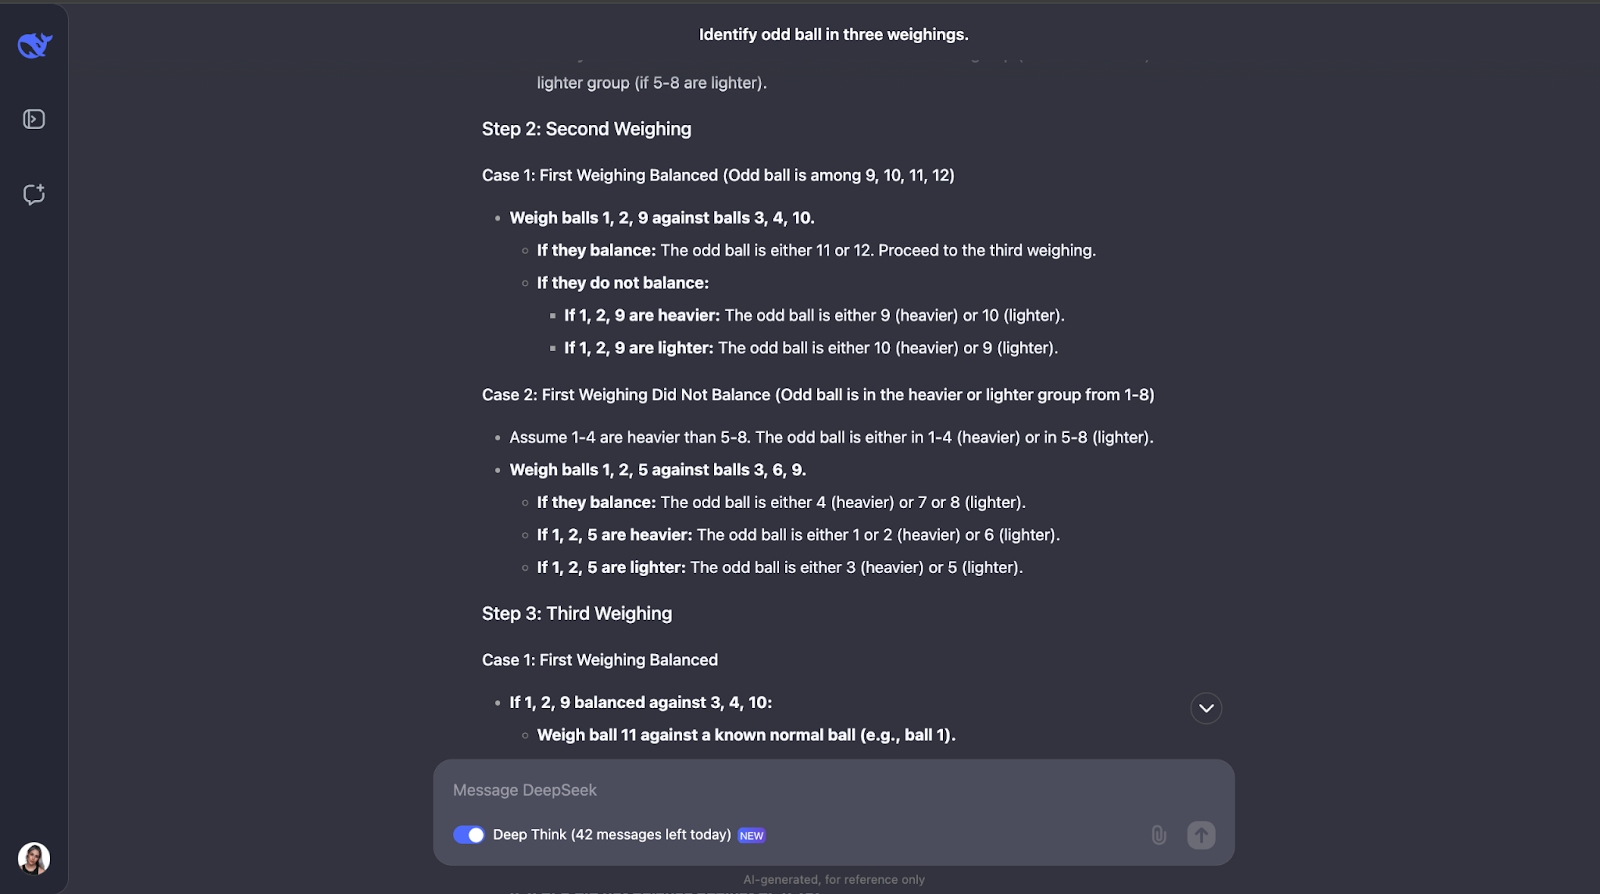
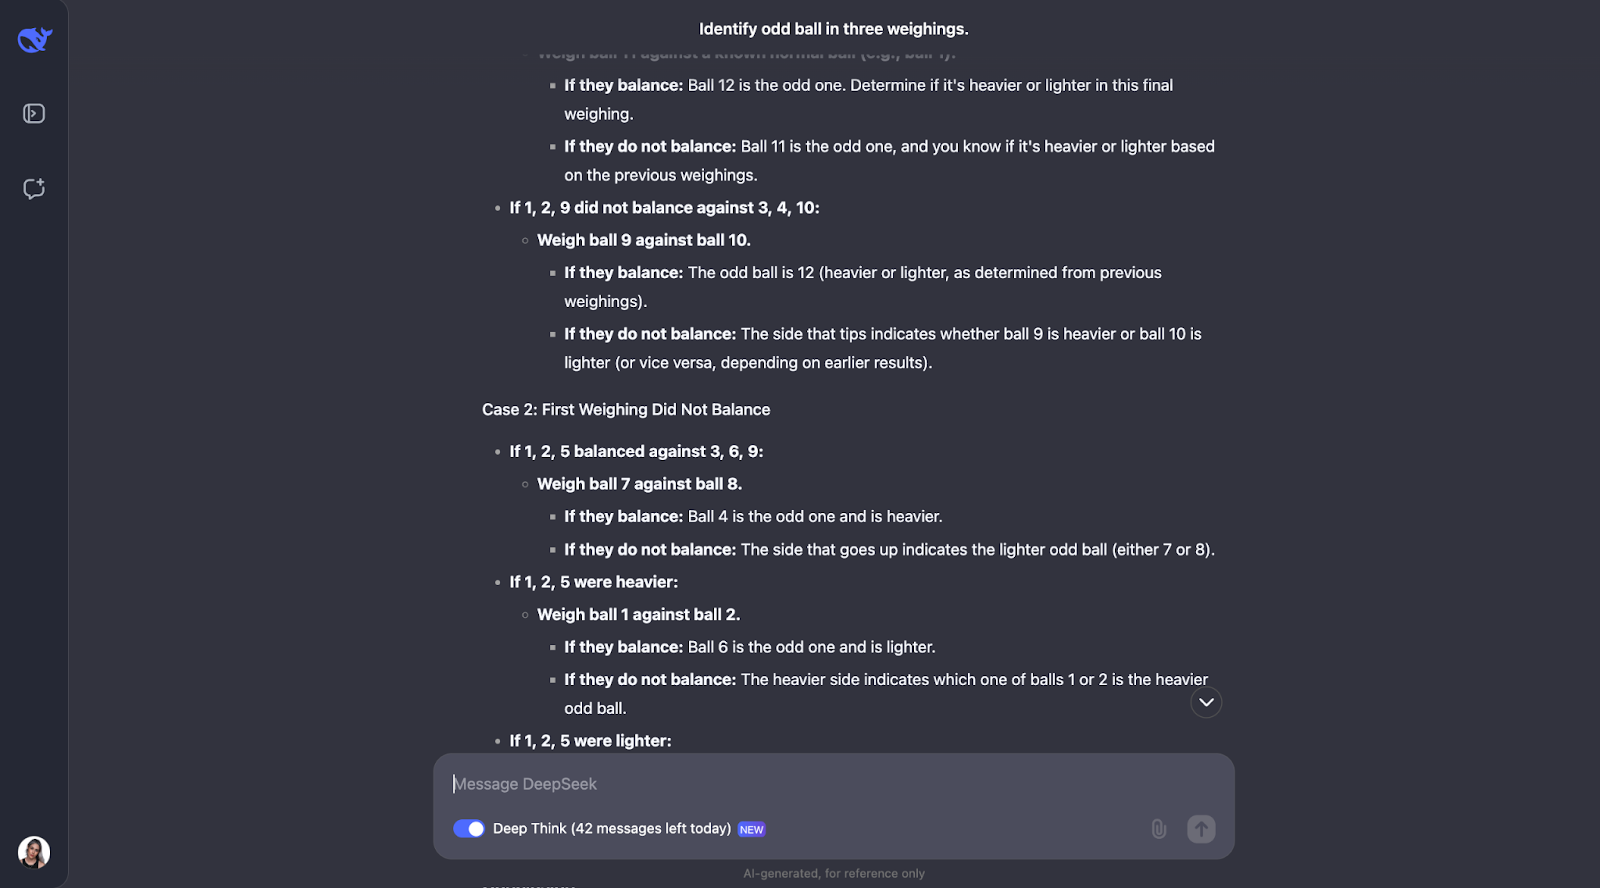
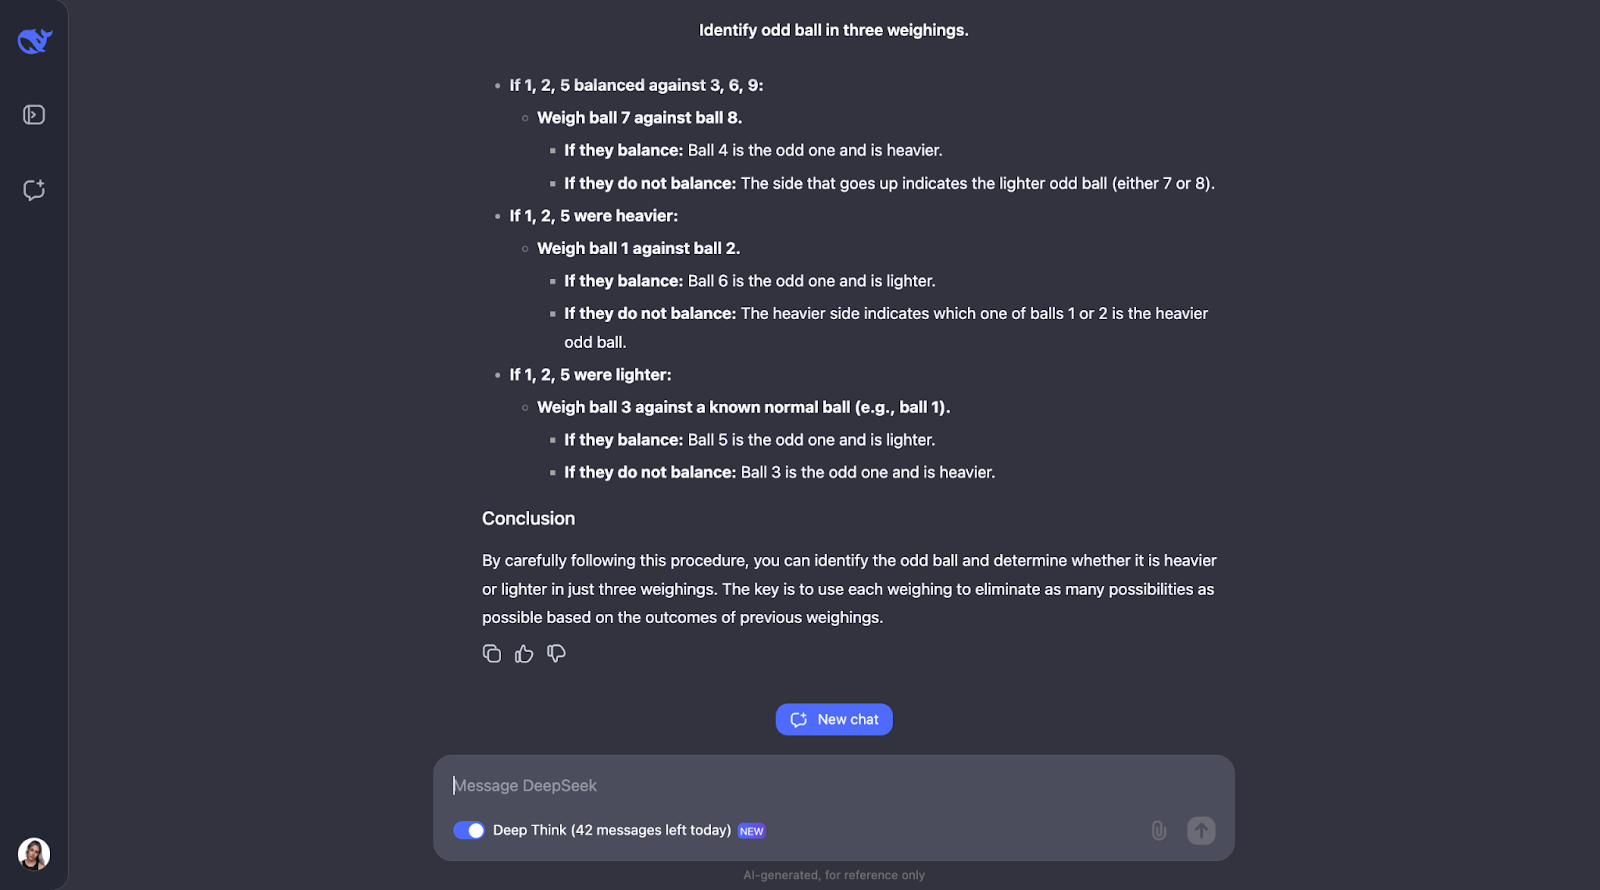
Un’altra volta ho sottovalutato totalmente la lunghezza dell’output! Il modello capisce che per risolvere questo problema serve pianificazione attenta perché hai solo tre tentativi. Calcola anche il numero di esiti e possibilità.
L’approccio è intelligente perché ogni pesata elimina quante più possibilità possibile. Pianifica per tutti gli esiti—che la bilancia resti in equilibrio o penda—e adatta il passo successivo in base a ciò che accade. È molto dettagliato ma i passaggi sono chiari e logici, per cui è facilissimo da seguire, anche se è prolisso,
Una cosa che mi è piaciuta molto è che quando l’approccio inizia a diventare troppo complesso, applica un metodo più sistematico o semplice. Tuttavia, per problemi come questo, in cui devi tenere traccia di vari casi, esiti e possibilità, aggiungere un diagramma o una tabella potrebbe aiutare a visualizzare il ragionamento e capire meglio l’output.
In questa sezione confronterò DeepSeek con altri modelli come o1-preview e GPT-4o in termini di performance su diversi benchmark. Ognuno si concentra su una diversa abilità, così possiamo vedere quali modelli eccellono in cosa. Vediamo i benchmark misurati da DeepSeek:
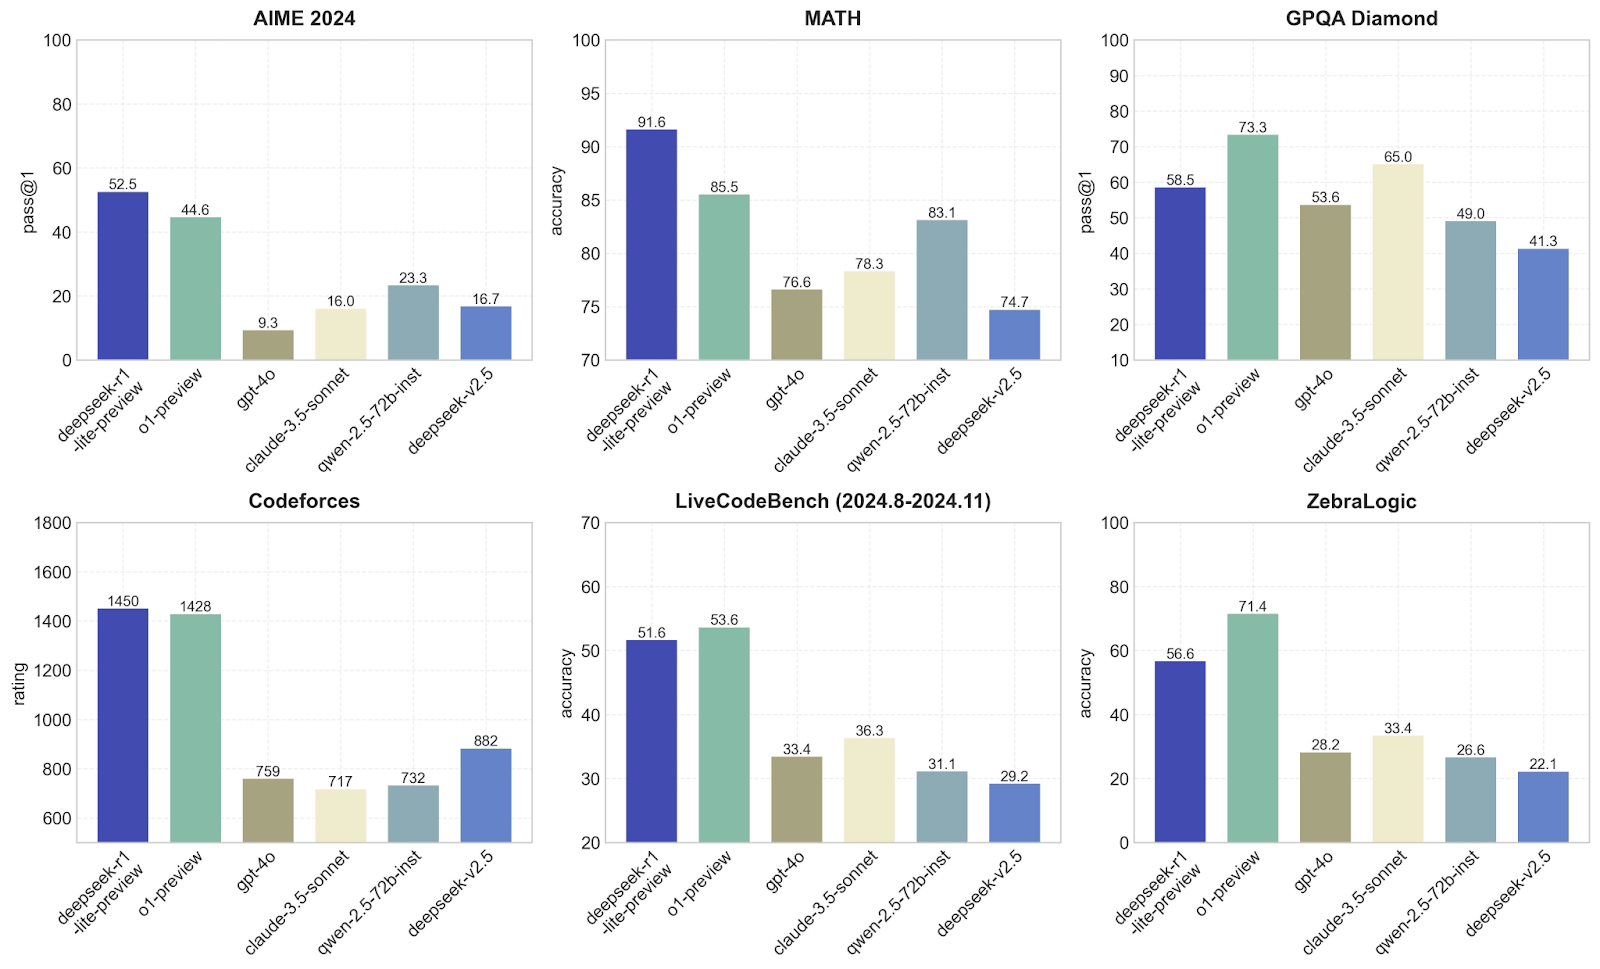
DeepSeek-r1-lite-preview qui è chiaramente il migliore, con un pass@1 di 52,5, seguito da o1-preview a 44,6. Altri modelli, come GPT-4o e claude-3.5-sonnet, vanno molto peggio, con punteggi sotto 23. Questo suggerisce che il modello DeepSeek-r1-lite-preview è piuttosto bravo a gestire il tipo di problemi avanzati di matematica o logica specifici dei benchmark AIME, cosa che non mi sorprende dopo i test che ho effettuato.
DeepSeek-v1 domina di nuovo con un’impressionante accuratezza di 91,6, ben avanti rispetto a o1-preview (85,5) e molto meglio di altri modelli come GPT-4o, che fatica ad arrivare a 76,6. Questo dimostra che DeepSeek è ottimo nel risolvere problemi matematici, confermando l’ipotesi basata sulle evidenze empiriche dei test precedenti–finora nessuna sorpresa!
Qui o1-preview fa meglio di DeepSeek-v1, con un pass@1 di 73,3 rispetto a 58,5. Altri modelli, come GPT-4o, restano indietro a 53,6. Questo suggerisce che o1-preview è più adatto a compiti che prevedono di rispondere a domande o risolvere problemi basati sul ragionamento logico. DeepSeek si comporta comunque bene ma non è al livello di o1-preview.
Per il competitive programming, DeepSeek-v1 (1450) e 01-preview (1428) sono quasi alla pari in cima, mentre altri modelli come GPT-4o totalizzano solo circa 759. Come previsto, questo mostra che questi due modelli sono eccellenti nel comprendere e generare codice per sfide di programmazione.
Questo test valuta le abilità di coding nel tempo, e o1-preview supera di poco DeepSeek-v1 (53,6 vs 51,6). Altri modelli, come GPT-4o, rimangono molto indietro a 33,4. Ancora una volta, si vede che sia DeepSeek sia 01-preview sono adatti al coding, ma 01-preview è leggermente migliore in questi compiti.
o1-preview è in testa qui con un’accuratezza di 71,4, rispetto a 56,6 per DeepSeek-v1. Gli altri modelli fanno molto peggio. Questo mostra che o1-preview è migliore nella gestione di compiti di logica astratta come ZebraLogic, che richiedono pensiero più creativo o fuori dagli schemi, in linea con i risultati dei miei test, dato che la creatività non era di certo il punto di forza di DeepSeek-v1.
Questi grafici confermano che DeepSeek-v1 è straordinario in matematica e nelle sfide di programmazione. Direi che o1-preview è più equilibrato e si comporta bene in una gamma più ampia di compiti, il che lo rende più versatile.
Guardiamo ora questo grafico:
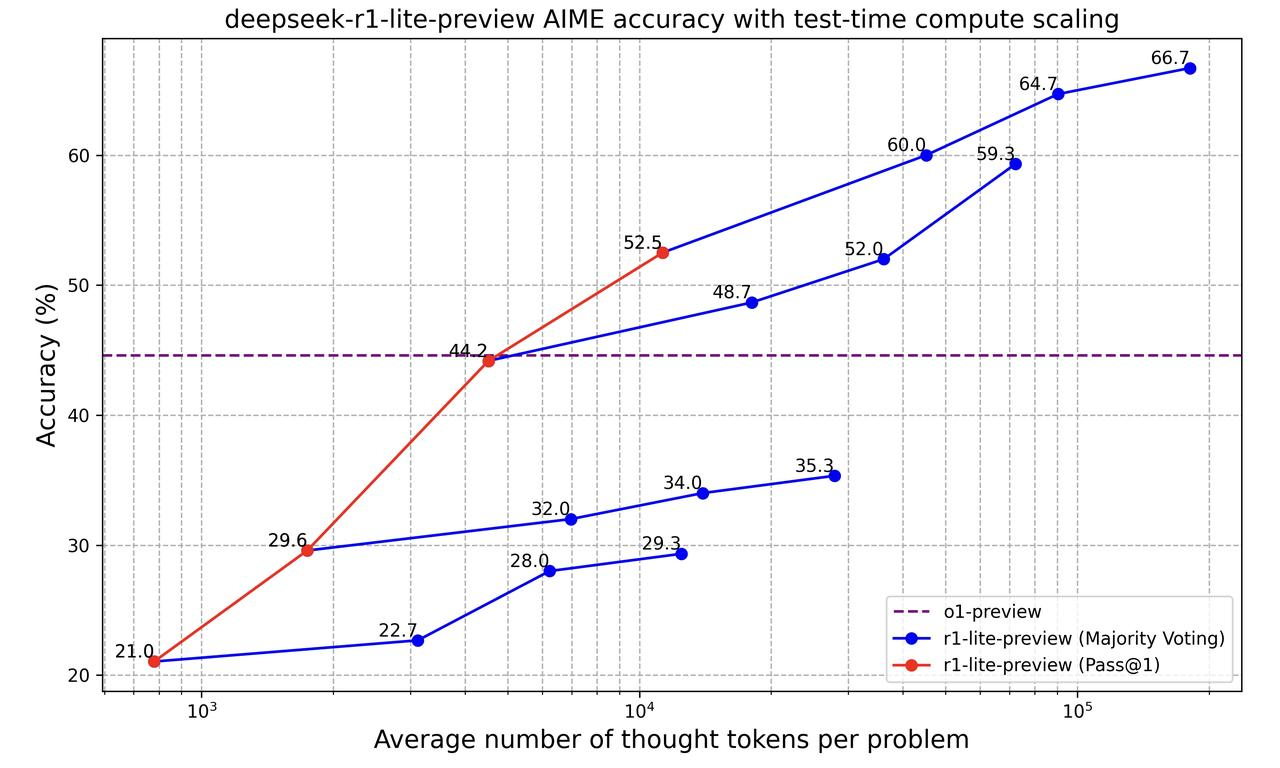
Questo grafico mostra come il modello "deepseek-r1-lite-preview" migliori nel risolvere i problemi man mano che elabora più informazioni (misurate dal numero di "thought token" utilizzati). Confronta due modi in cui viene misurata l’accuratezza del modello:
La linea viola tratteggiata rappresenta il modello o1-preview con un’accuratezza stabile. All’inizio o1-preview è migliore, ma man mano che a DeepSeek r1-lite-preview si consentono più thought token, supera o1-preview e diventa molto più accurato.
In sostanza, questo grafico mostra che lasciare a DeepSeek r1-lite-preview più margine di “pensiero” e più tentativi migliora la sua accuratezza.
DeepSeek-r1-lite-preview è migliore dell’o1-preview di OpenAI? Dipende dal compito. Direi di sì per matematica e programmazione. Per il ragionamento logico, dipende dal tipo di esercizio.
Quello che mi ha davvero sorpresa è stato il modo in cui ha ragionato in alcuni test. Mi ha fatto riflettere su cosa significhi davvero per un modello “pensare” e su come elabori gli approcci di ragionamento.
Se questo modello ti incuriosisce, perché non lo provi tu? Testalo sui compiti che ti interessano e guarda come si comporta—potresti trovarlo sorprendente quanto l’ho trovato io!
Impara l’IA con questi corsi!
Corso
Programma
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min




