
Cursus
Retrieval Augmented Generation (RAG) met LangChain
3 uur
20.9K
DeepSeek-R1-Lite-Preview is een AI-tool, vergelijkbaar met ChatGPT, ontwikkeld door het Chinese bedrijf DeepSeek. Het bedrijf kondigde dit nieuwe model aan op X op 20 november (link naar tweet) en deelde enkele details op een documentatiepagina.
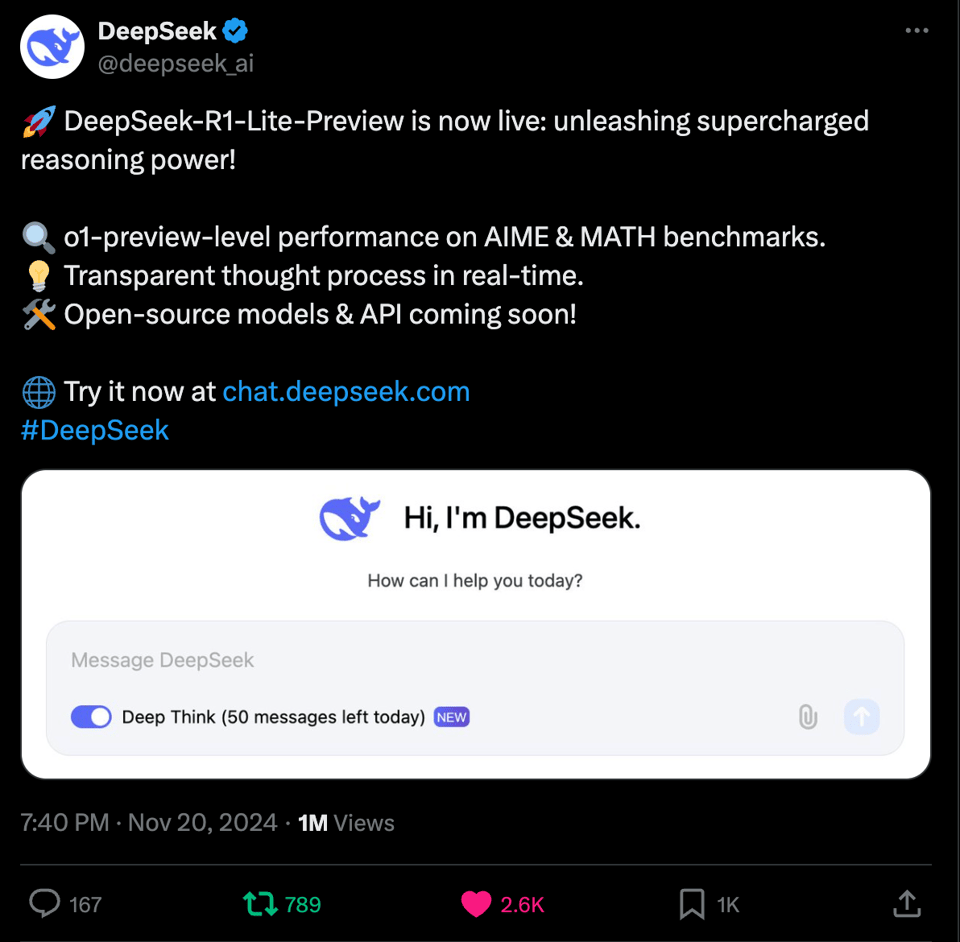
DeepSeek-R1-Lite-Preview is bedoeld om heel goed te zijn in het oplossen van complexe redeneerproblemen in wiskunde, programmeren en logica. Het laat stap voor stap zien hoe het denkt, zodat je kunt begrijpen hoe het tot antwoorden komt, wat helpt om het vertrouwen te vergroten.
Je kunt het gratis uitproberen op hun website, chat.deepseek.com, maar je bent beperkt tot 50 berichten per dag in de geavanceerde modus genaamd “Deep Think”. DeepSeek is ook van plan onderdelen van deze tool te delen met het publiek, zodat anderen het kunnen gebruiken of erop kunnen voortbouwen.
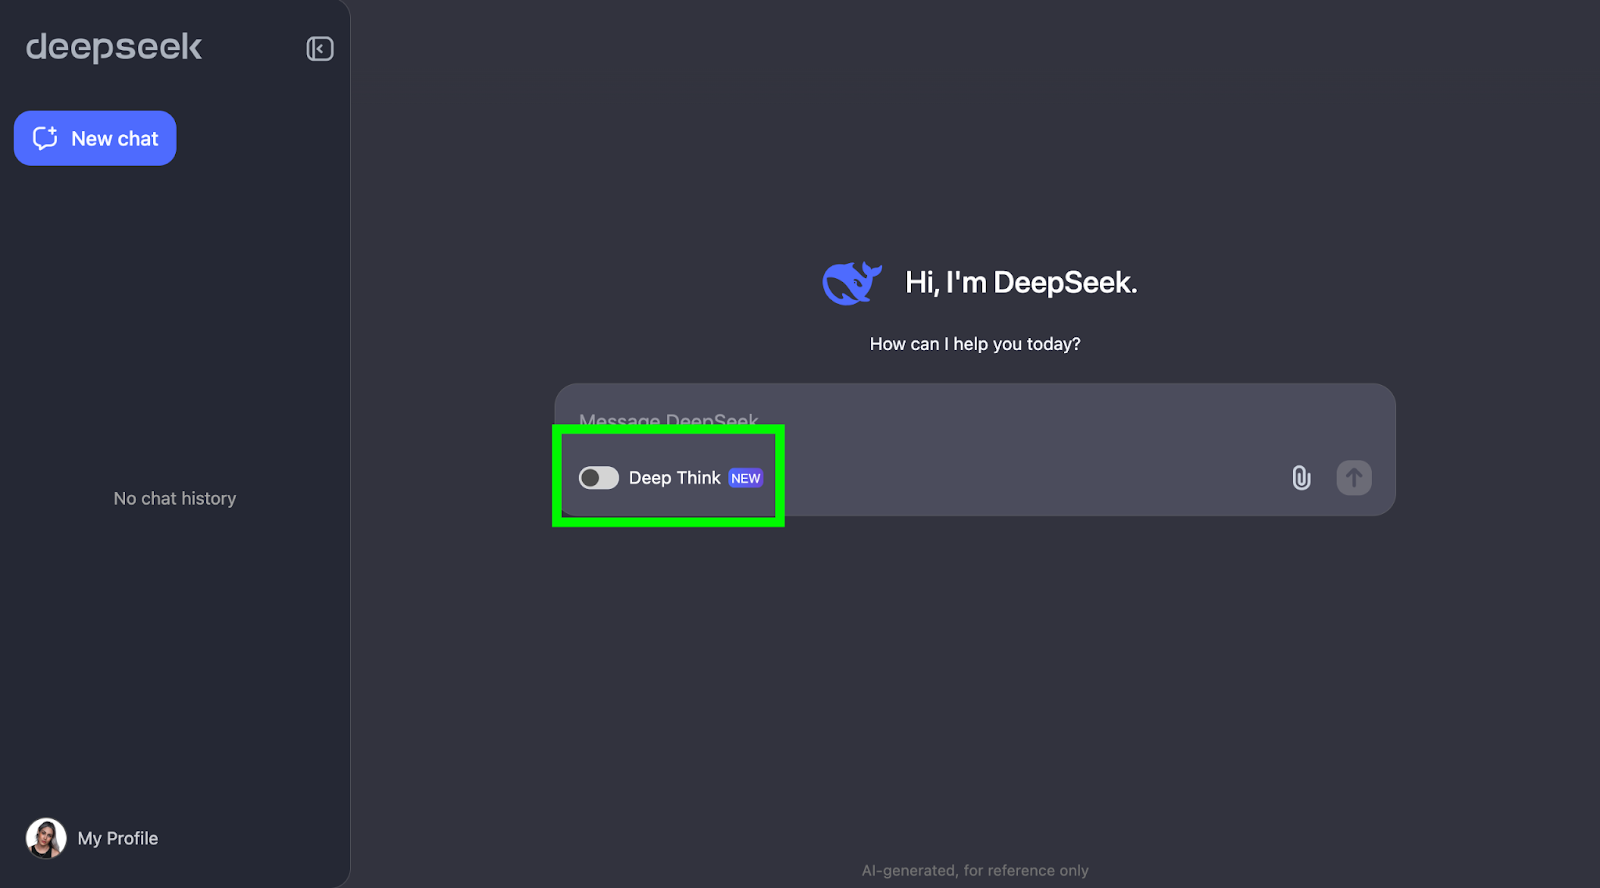
Je kunt DeepSeek-R1-Lite-Preview gebruiken door deze twee stappen te volgen:
Om te zien wat DeepSeek-R1-Lite-Preview kan, gaan we het op de proef stellen! Ik doorloop een reeks uitdagingen die de redeneervaardigheden laten zien, te beginnen met de simpele maar bekende aardbeienvraag: Hoe vaak komt de letter “r” voor in 'strawberry'?
Deze vraag lijkt simpel, maar LLM’s (zelfs GPT-4o) hebben er traditioneel moeite mee om dit correct te beantwoorden—ze antwoorden meestal dat er maar twee keer de letter “r” voorkomt.
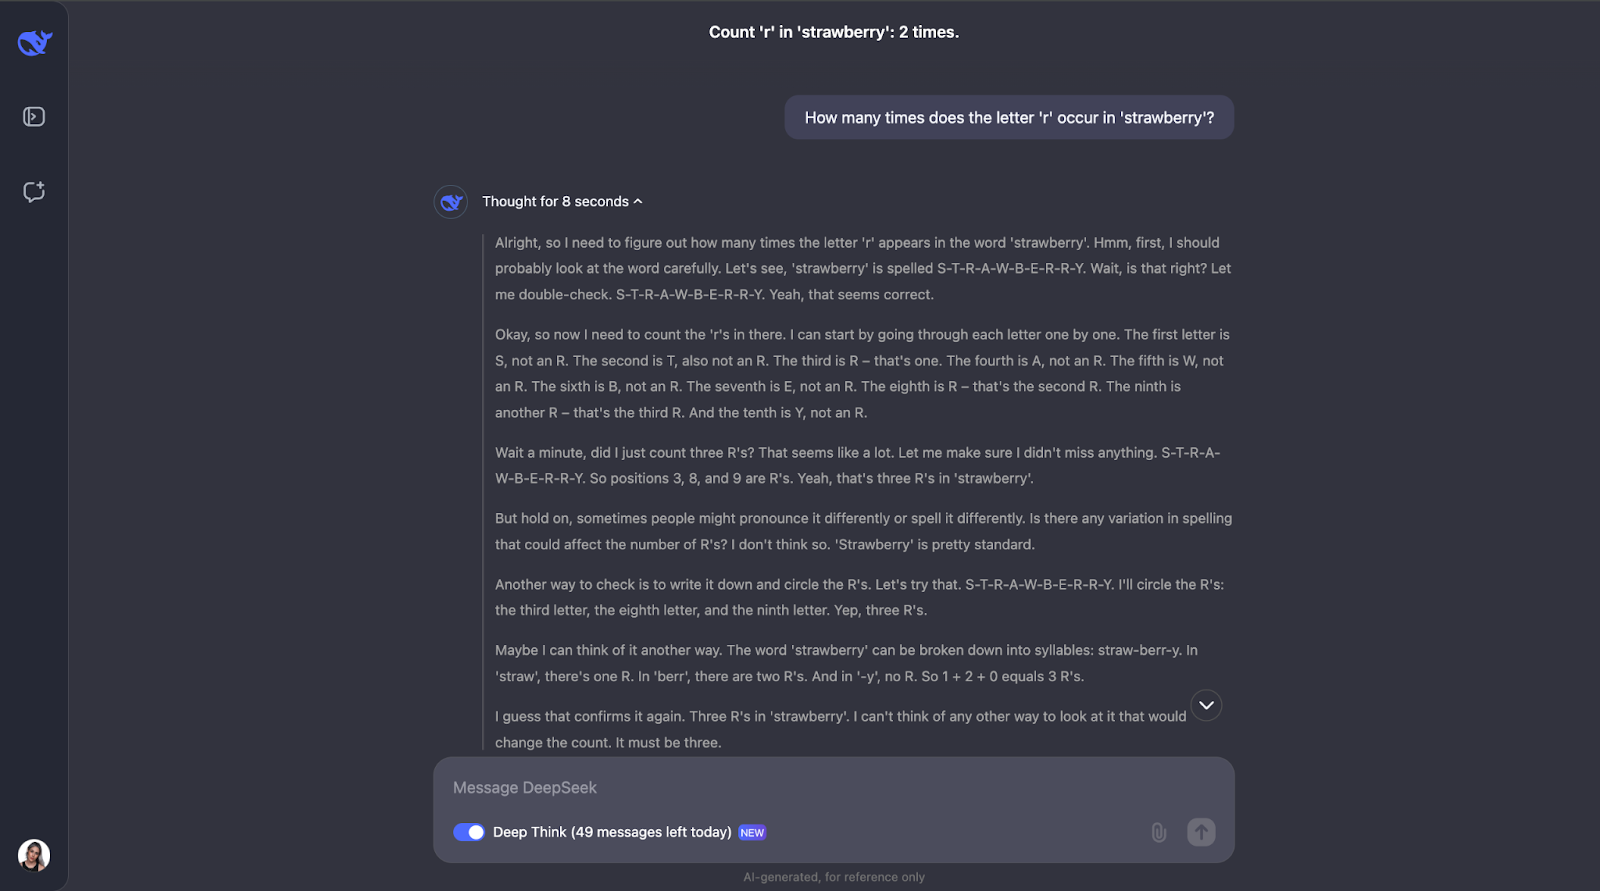
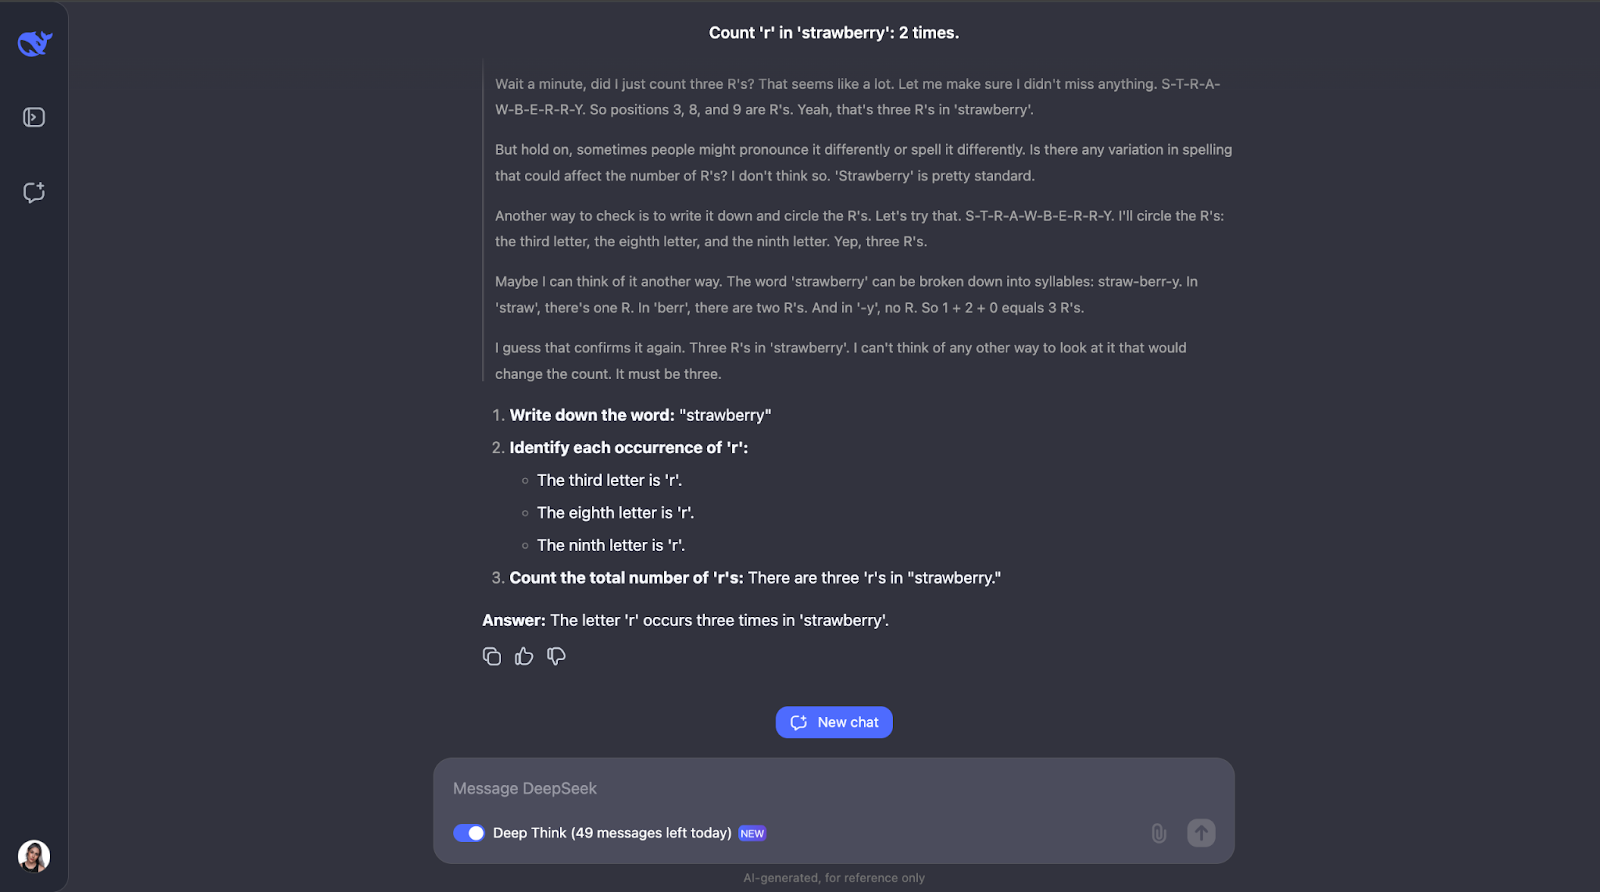
Wauw, oké – ik had niet zo’n lange redeneerlijn verwacht voor wat een eenvoudige taak lijkt. Ik dacht dat het na het tellen van de letter 'r' en het bepalen van de posities zou stoppen. Maar wat ik interessant vind, is dat het daar niet stopte. Het controleerde het tellen een paar keer en hield zelfs rekening met zaken als hoe mensen het woord anders zouden kunnen uitspreken of spellen – wat ik wat overbodig vind, zeker het uitspraakgedeelte. Maar het laat wel zien hoe zorgvuldig en bedachtzaam het is! Het legde ook elke stap uit, zodat ik het denkproces kon volgen en kon zien hoe het tot het antwoord kwam.
Ik test DeepSeek-R1-Lite-Preview op drie wiskundeproblemen.
Gezien DeepSeeks claim om erg goed te zijn in wiskundig redeneren, beginnen we met een eenvoudig meetkundig probleem.
"Als een driehoek zijden heeft van lengte 3, 4 en 5, wat is dan de oppervlakte?"
Dit probleem vereist kennis van de stelling van Pythagoras en de formule van Heron. Ik verwachtte dat DeepSeek-R1-Lite-Preview zijn werkwijze zou laten zien, bijvoorbeeld zo:
Laten we zien wat er gebeurt!
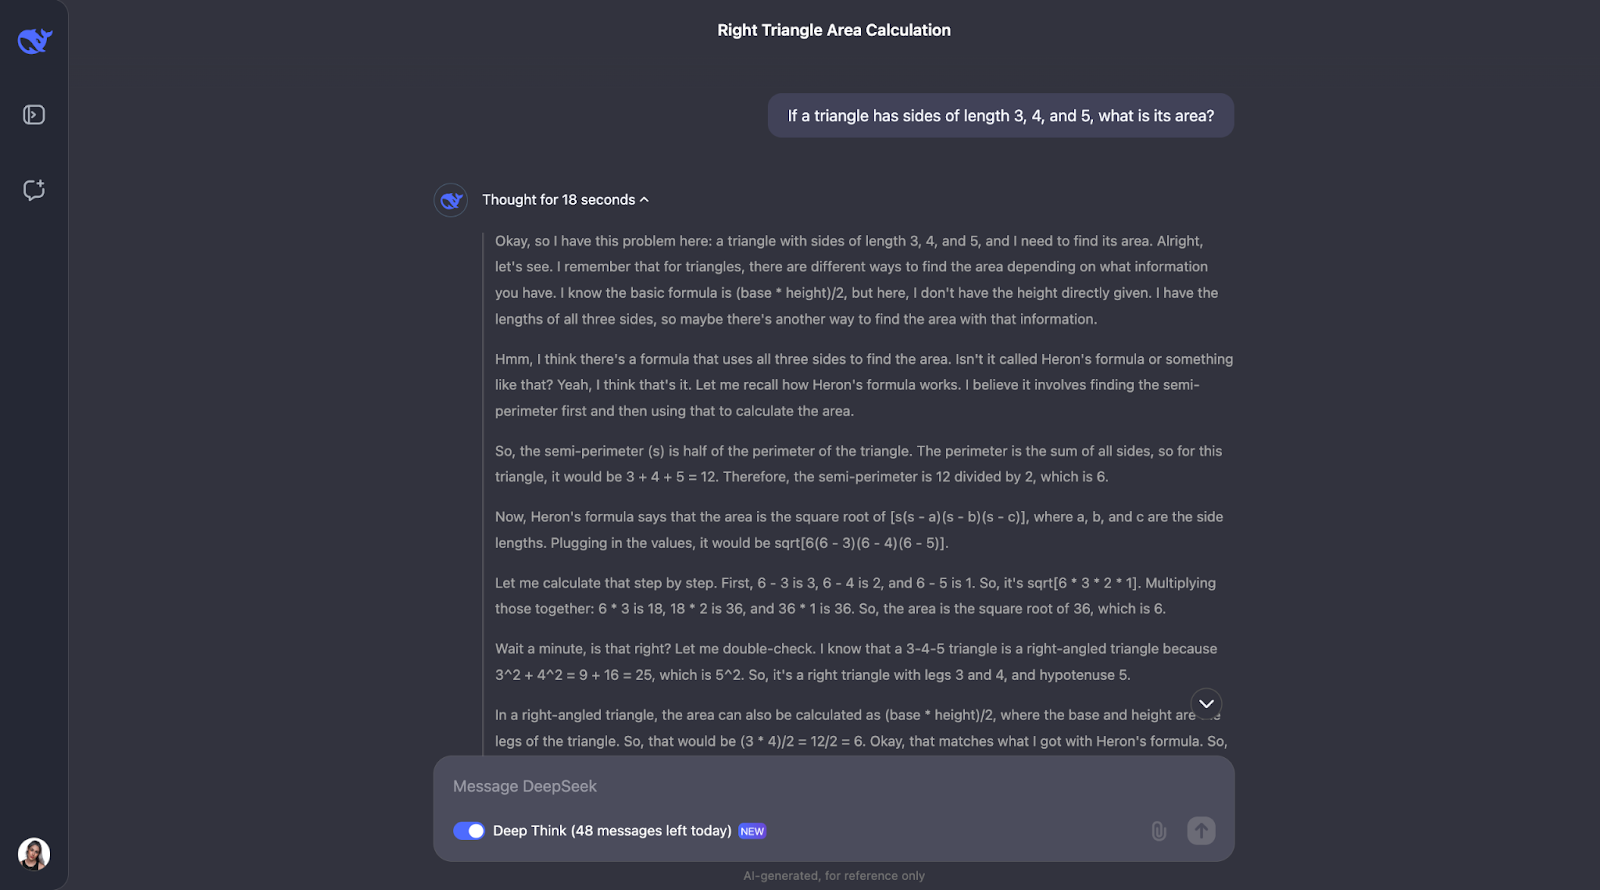
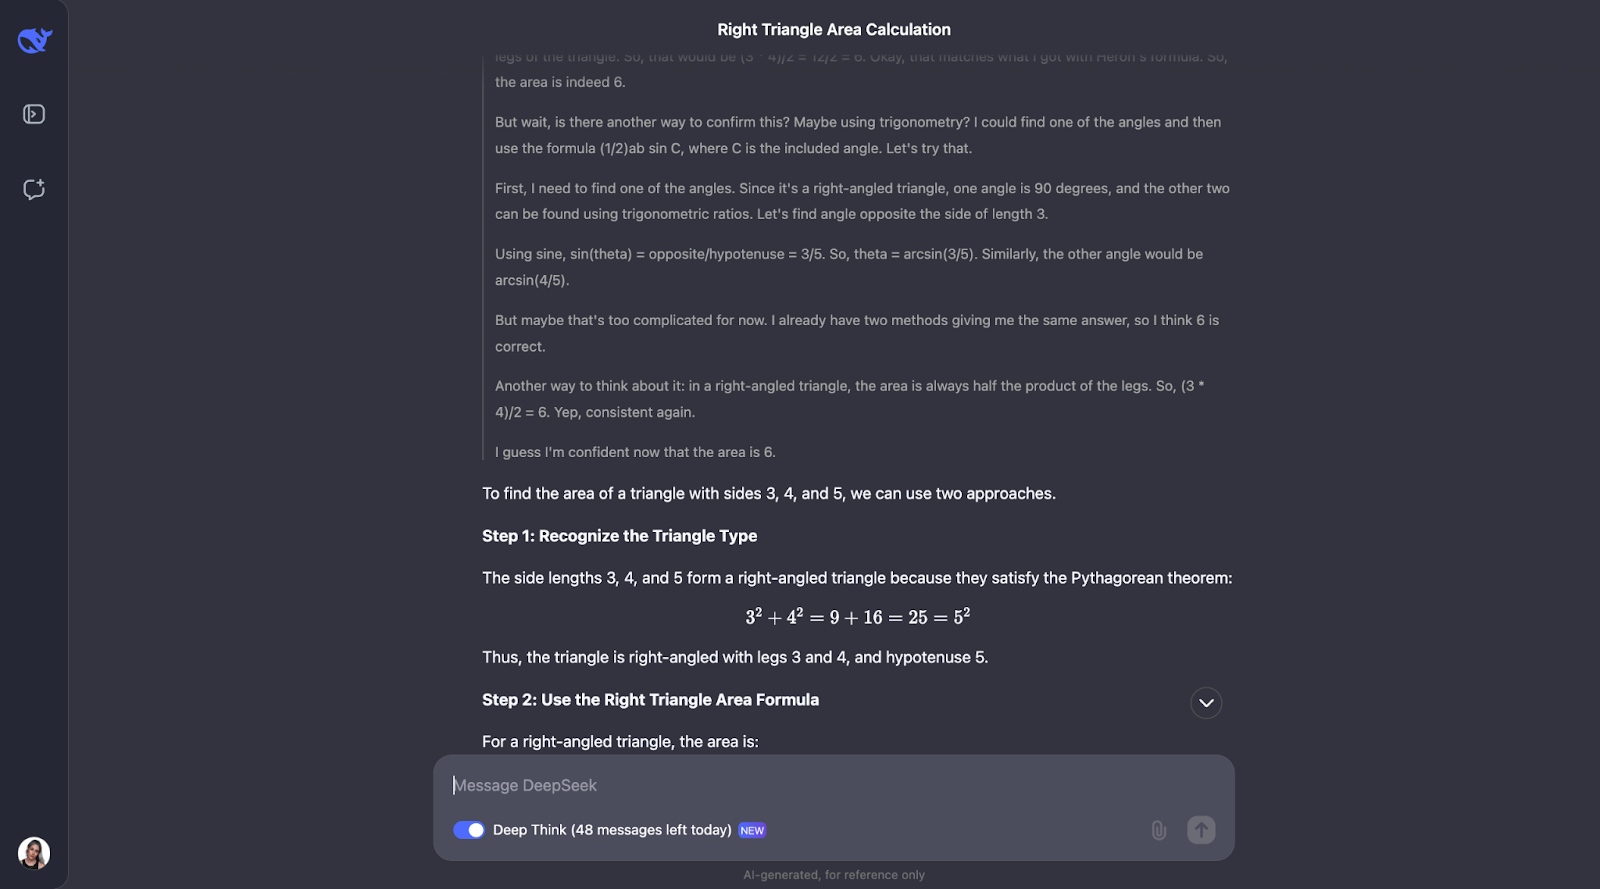
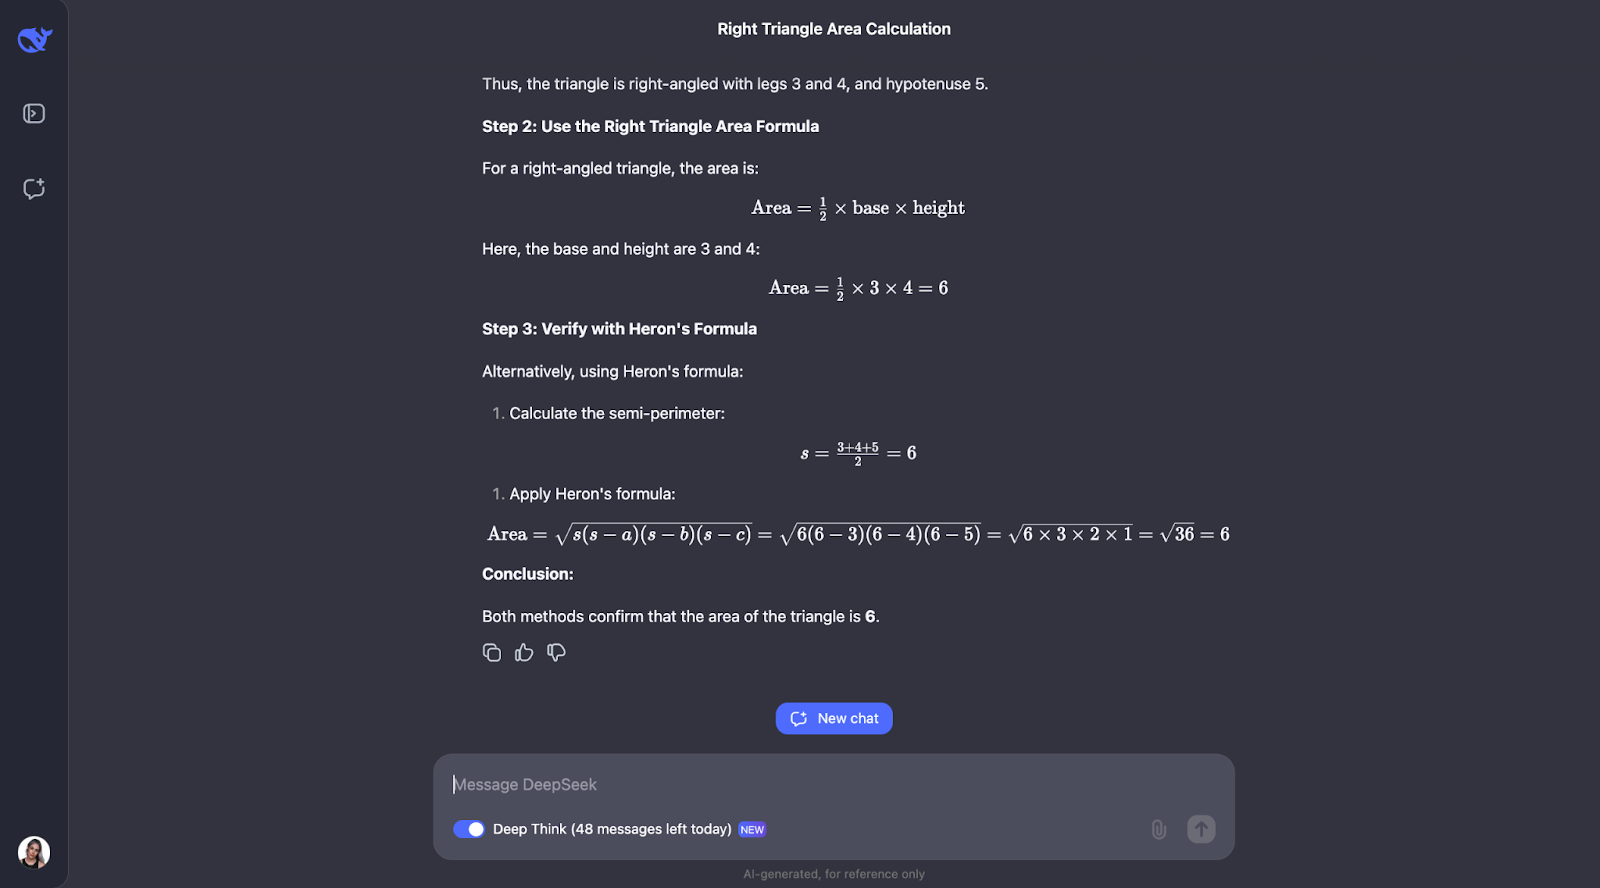
Oké, interessant genoeg voert het de controles uit die ik voorspelde—zij het in een andere volgorde. Het overwoog ook trigonometrie door hoeken te berekenen en een andere formule te proberen. Ik vind het boeiend dat het uiteindelijk besloot dat dit niet nodig was, omdat de eerste twee methoden het antwoord al bevestigden.
Zowel de uitleg als de output waren bijzonder duidelijk en goed te volgen, wat me doet denken dat dit een fantastisch model zou zijn voor bijvoorbeeld een hulpje voor wiskundestudenten. Voor dit gebruik zou je misschien eerst het denkproces kunnen tonen en de student laten aangeven of die het begrepen heeft voordat je het eindantwoord geeft.
Laten we doorgaan naar een complexere wiskundetest om te zien of er verschil is in prestaties en denkproces.
“Bewijs dat de som van de reciprocals van de Fibonacci-getallen convergeert naar een eindige waarde.”
Deze test daagt het begrip van het model uit op het gebied van geavanceerde wiskundige concepten, zoals reeksenconvergentie en de eigenschappen van Fibonacci-getallen. Laten we het proberen! Voor de leesbaarheid laat ik alleen het eerste en laatste deel van het antwoord zien (maar probeer gerust zelf dezelfde prompt):
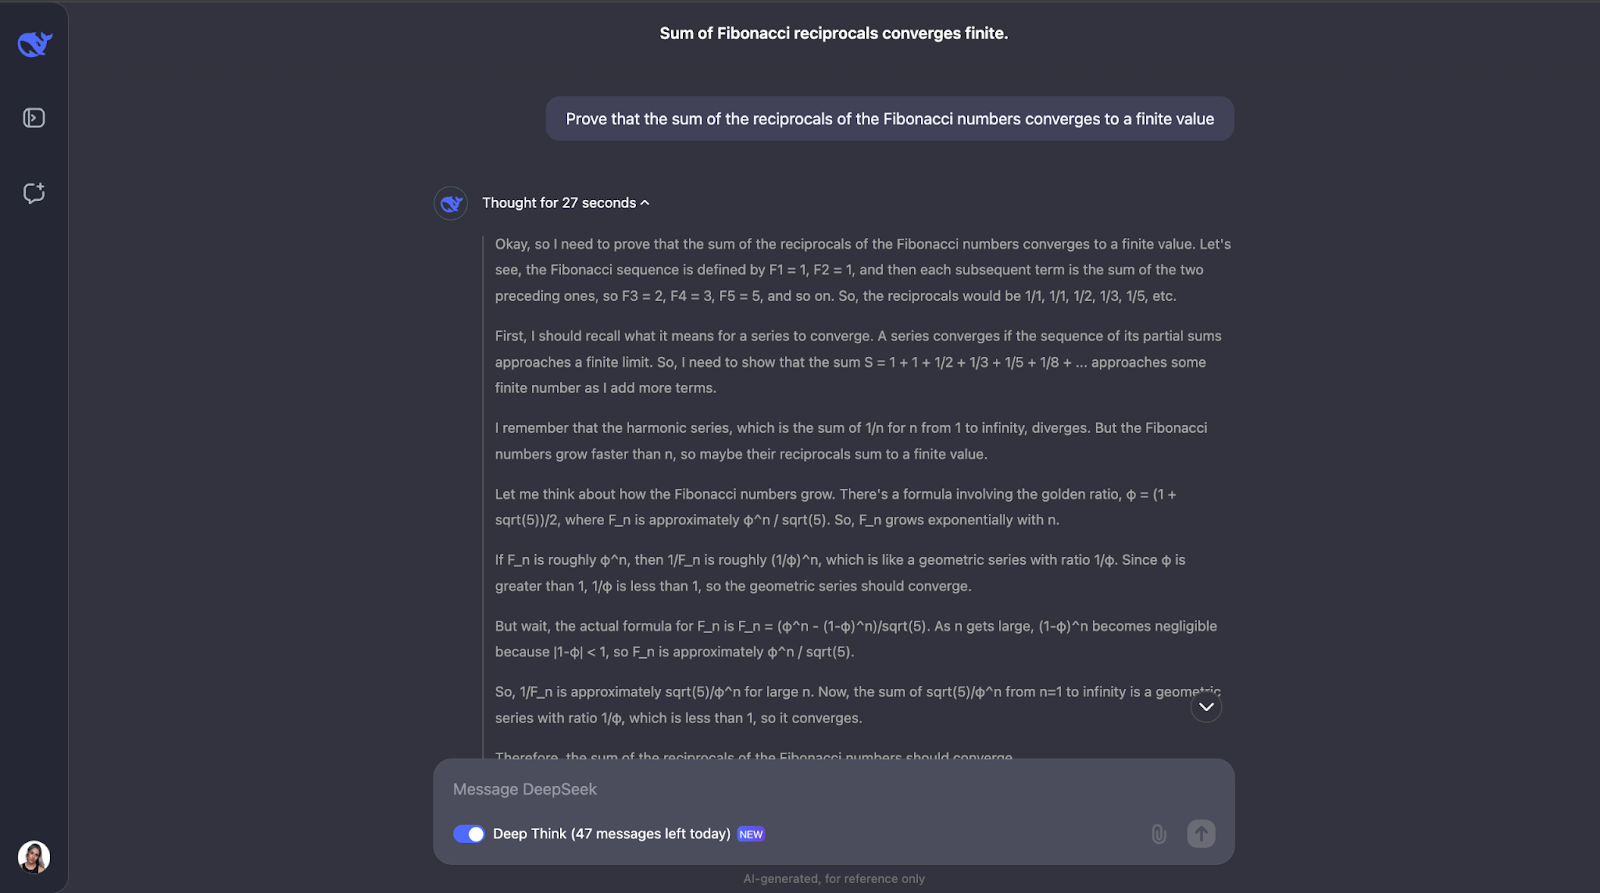
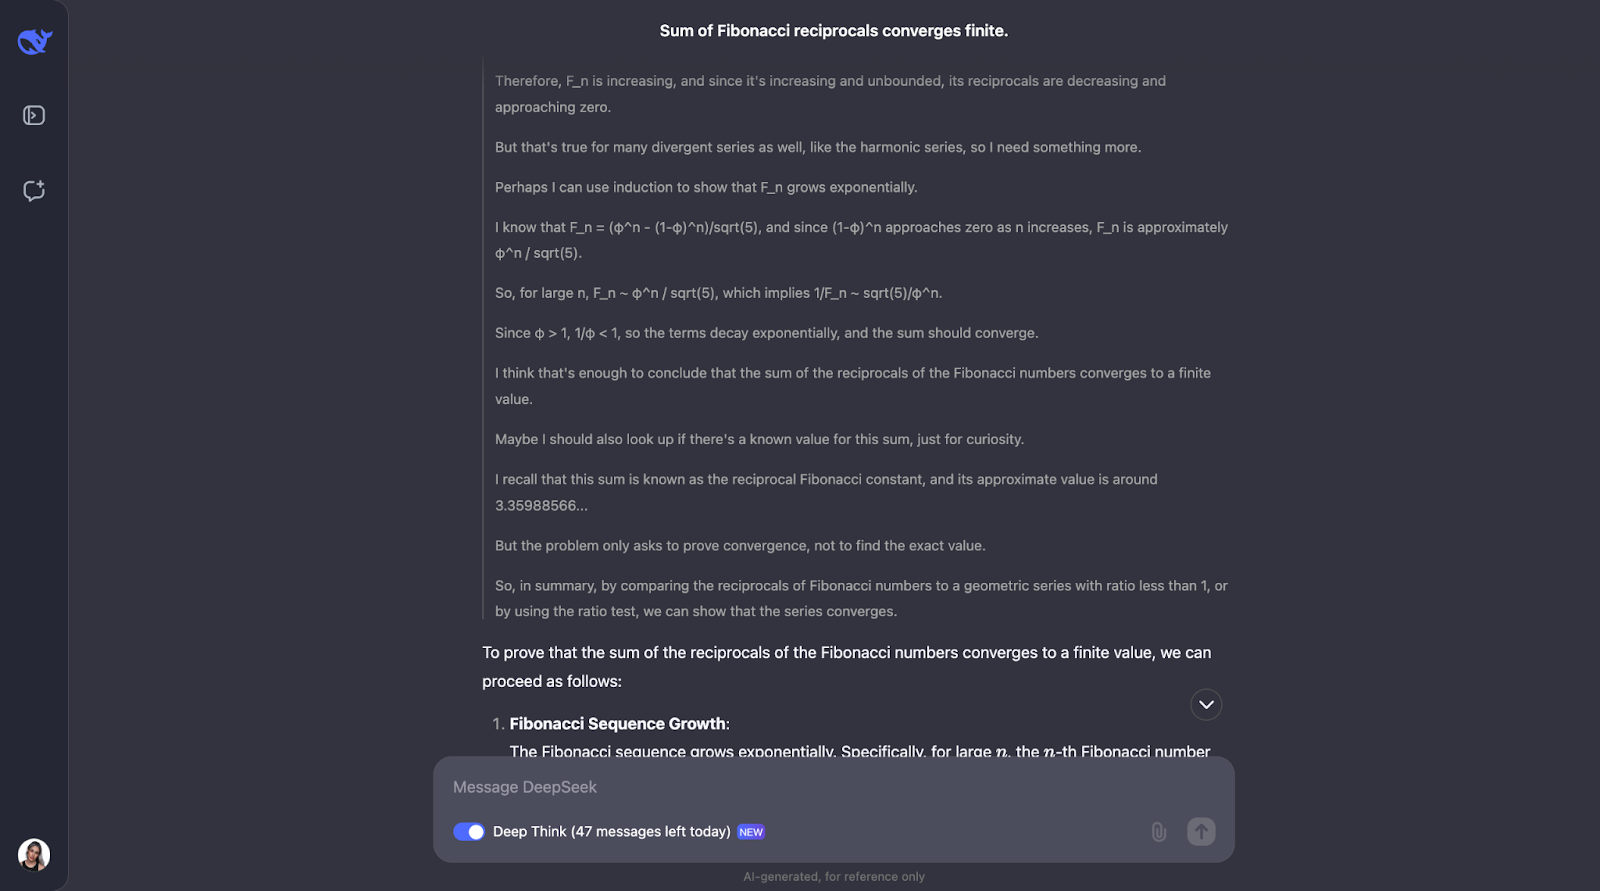
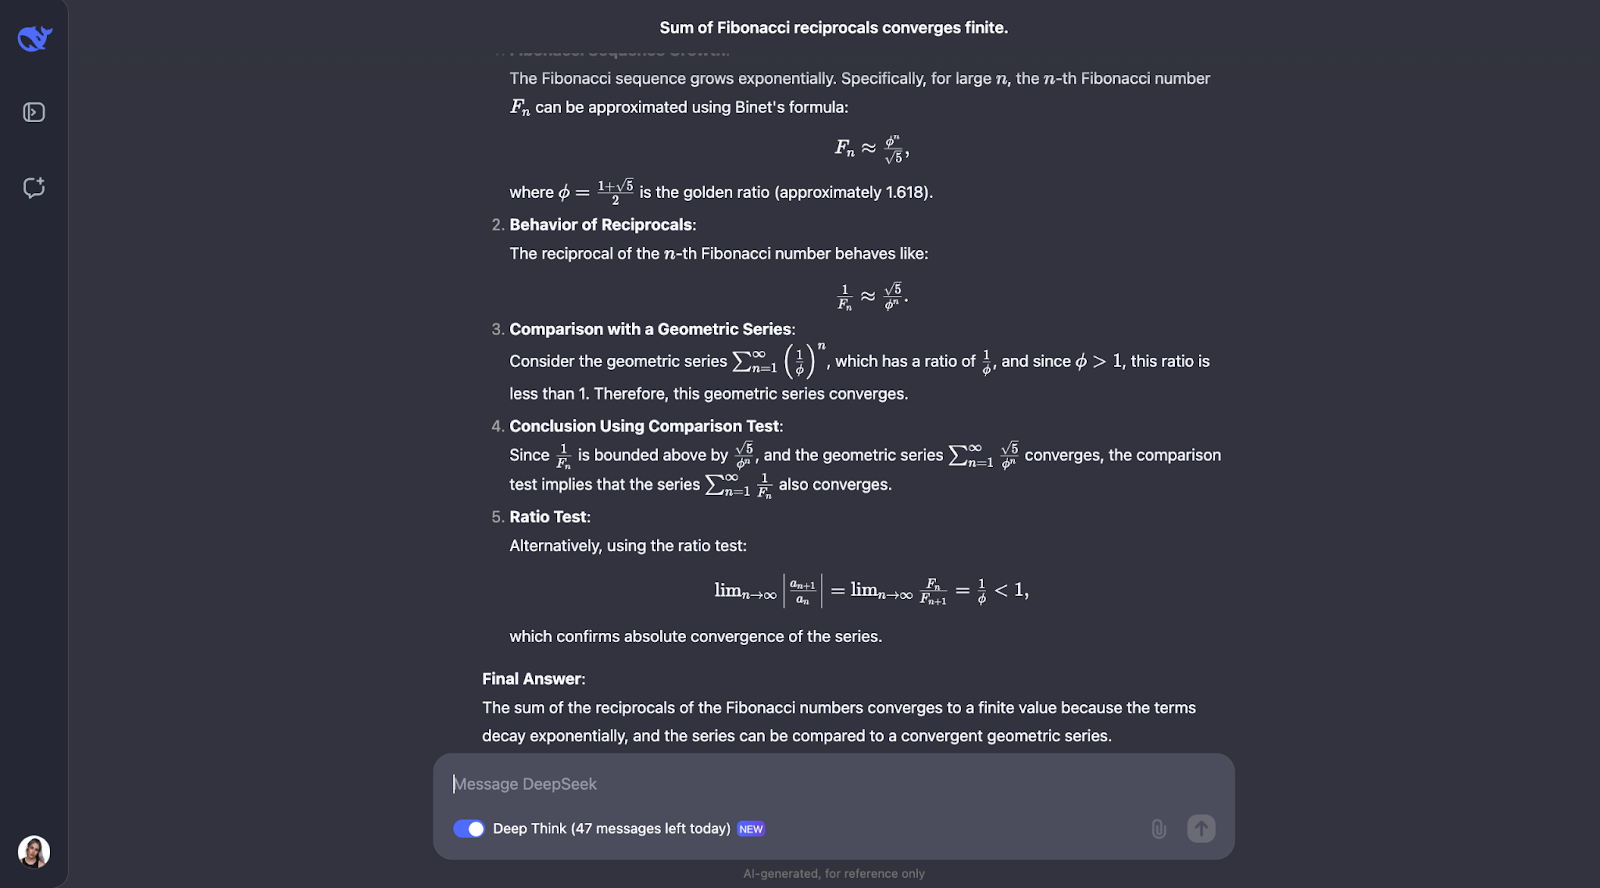
Oké, dit is een mooie denklijn—ik vind het erg fijn hoe het eerst zeker weet dat het de kernbegrippen begrijpt, zoals reciprocals en convergentie. Daarna pakt DeepSeek-R1-Lite-Preview dit probleem aan door te kijken naar de groei van de Fibonacci-getallen en een vergelijkingstest te gebruiken, wat een gebruikelijke manier is om te testen of een reeks convergeert.
Het vergeleek de reciprocals van de Fibonacci-getallen met een meetkundige reeks. Omdat de reciprocals sneller afnemen dan een meetkundige reeks met een reden kleiner dan 1, concludeerde het model dat de som van de reciprocals ook convergeert naar een eindige waarde. Om extra zeker te zijn, gebruikte het de zogenoemde quotiënttest.
Deze test controleert of de limiet van de verhouding van opeenvolgende termen kleiner is dan 1. Als dat zo is, convergeert de reeks. Het model berekende deze verhouding voor de reciprocals van de Fibonacci-getallen en stelde vast dat die inderdaad kleiner is dan 1.
Het noemde zelfs dat er een bekende waarde is voor deze som, de reciprocal Fibonacci constant, die ongeveer 3,3598 is. Maar voor dit probleem hoefden we alleen te weten dat de som eindig is, niet exact wat die is—dus dit was extra informatie die ik ook interessant vond. Ik vind vooral prettig hoe de oplossing in de output wordt gepresenteerd. Het is duidelijk en stap voor stap.
Tot nu toe ben ik onder de indruk van de wiskundetaken.
Ik ga een probleem in de differentiaalmeetkunde proberen—gewoon omdat mijn PhD in dit vakgebied is en ik de verleiding niet kon weerstaan om een kleine test te doen. Niets al te complex, gewoon een klassiek oefenstuk dat je in de bachelorwiskunde kunt tegenkomen.
“Beschouw een oppervlak S in R³ geparametriseerd door
φ(u,v) = (u cos v, u sin v, ln u)
voor u > 0 en 0 ≤ v < 2π.
a) Bereken de eerste fundamentele vorm van S.
b) Bepaal of S een minimaal oppervlak is.
c) Vind de Gaussiaanse kromming K en de gemiddelde kromming H van S.”
Wat ik van DeepSeek-R1-Lite-Preview zou verwachten, is een stap-voor-stapoplossing, met alle berekeningen en uitleg van de betekenis van elk resultaat, evenals de definities van de hoofdconcepten zoals fundamentele vorm, minimaal oppervlak en de verschillende krommingen.
Om deze blog leesbaar te houden kan ik alleen het eerste en laatste deel van het antwoord laten zien, maar ik moedig je aan om de prompt zelf te proberen:
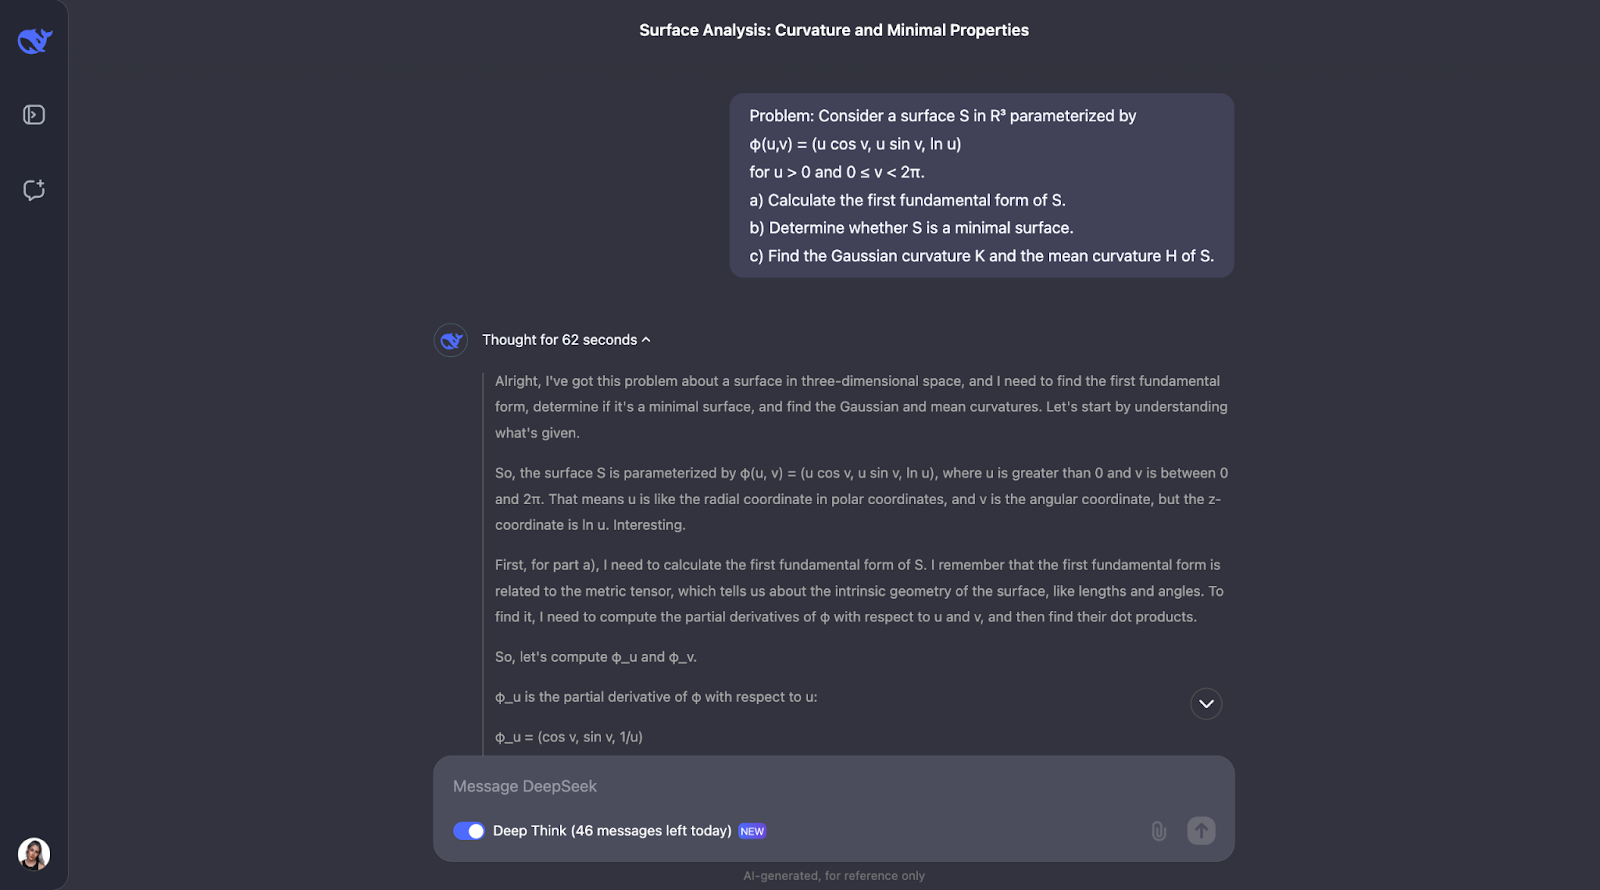
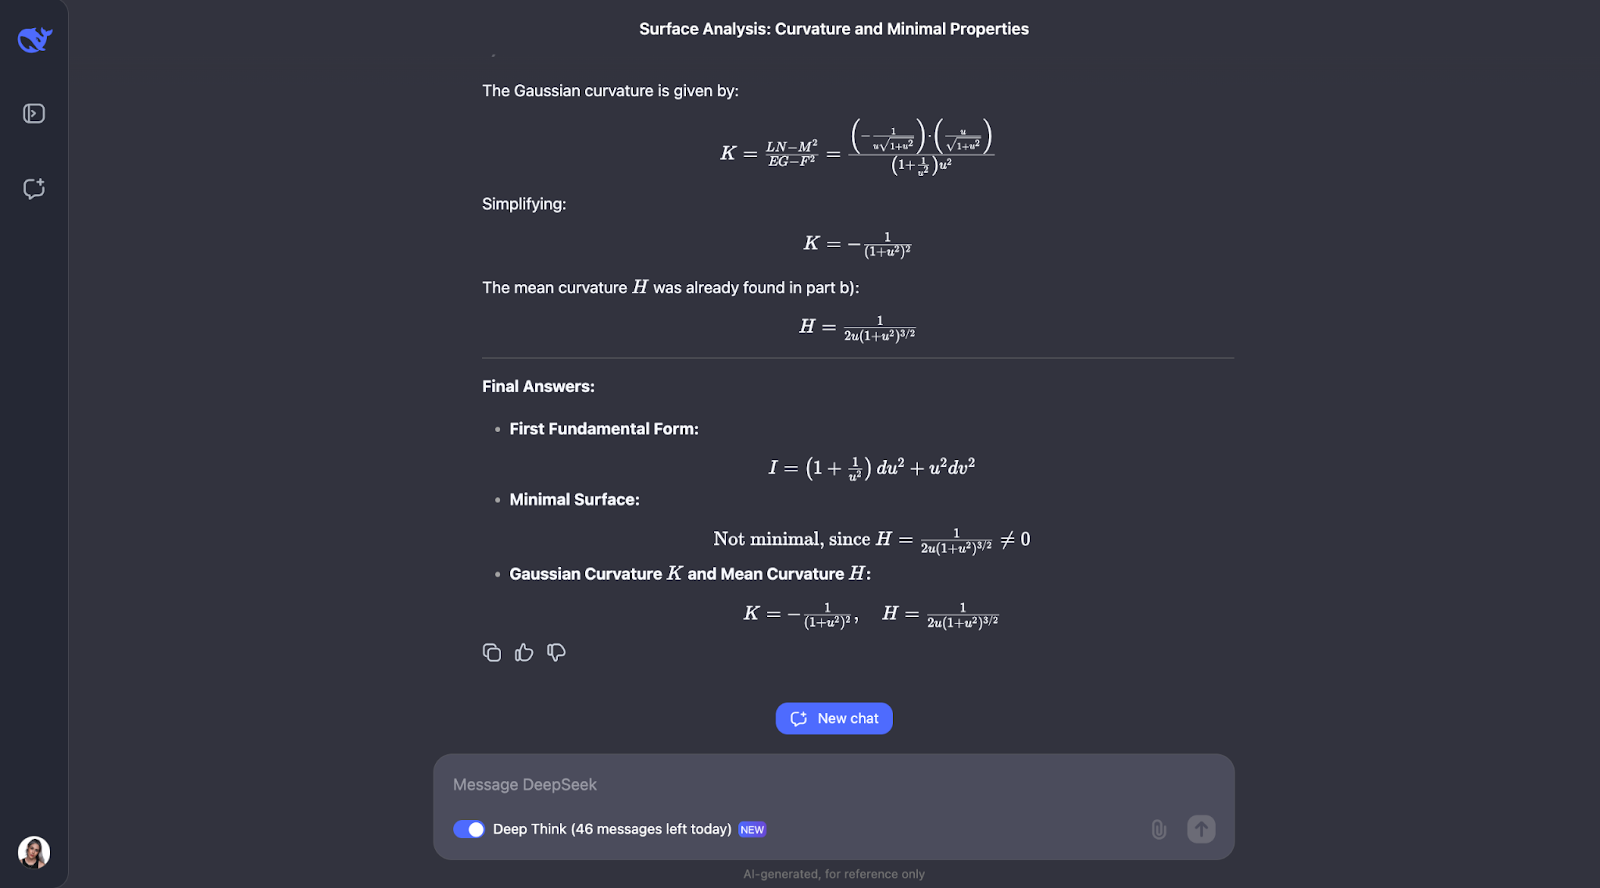
De stap-voor-stapaanpak gebruikt bekende meetkundige formules en past die direct toe, wat het redeneren goed te volgen maakt. Ik had echter verwacht dat het zijn begrip van de hoofdconcepten in het probleem zou checken, wat niet in de denklijn voorkomt. Voor deel B kiest het een alternatieve aanpak en herkent het dat het oppervlak een omwentelingsoppervlak is, wat een leuke vondst is.
Er is ook een moment waarop het commentaar geeft op rotatie en beseft dat het N, de normaalvector, al heeft, wat in conflict kan komen met de notatie van de coëfficiënt voor de tweede fundamentele vorm. Ik had graag een suggestie gezien voor betere notatie, want dezelfde letter voor twee dingen gebruiken is geen goede gewoonte!
Bij het berekenen van de gemiddelde kromming merkt het op dat die niet nul is en vraagt het zich af of de berekening klopt. Om grondig te zijn probeert het een andere methode om het werk te dubbelchecken.
Opnieuw is de output heel duidelijk en goed te volgen. In al deze voorbeelden is het indrukwekkend om te zien hoe het consequent berekeningen dubbelcheckt met verschillende methoden. Het denkproces is steeds gedetailleerd, logisch en goed te begrijpen!
Laten we nu doorgaan naar codetests.
De eerste die ik ga testen is:
“Implementeer een functie in Python die de langste palindromische substring in een gegeven string vindt. De functie moet een tijdscomplexiteit hebben beter dan O(n^3).”
Ik probeer het vermogen van het model te beoordelen om efficiënte algoritmen te ontwerpen en ze in code te implementeren. Ik zou een oplossing verwachten met dynamic programming of Manacher’s algoritme, met een duidelijke uitleg van de aanpak en analyse van de tijdscomplexiteit.
De output is erg, erg lang, en ik laat alleen het eerste en laatste deel zien:
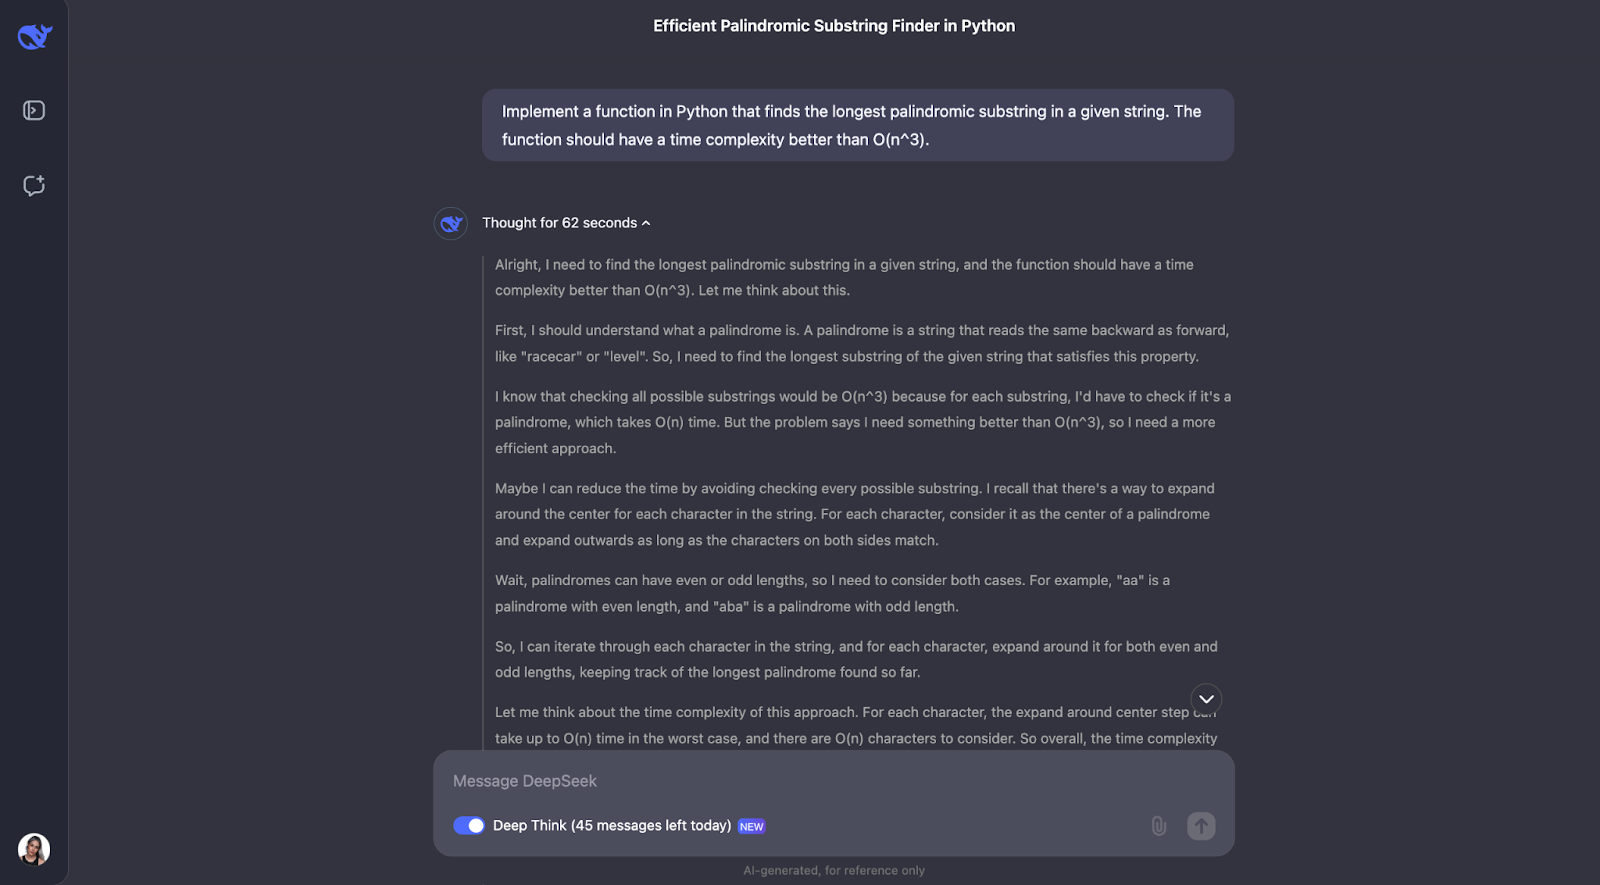
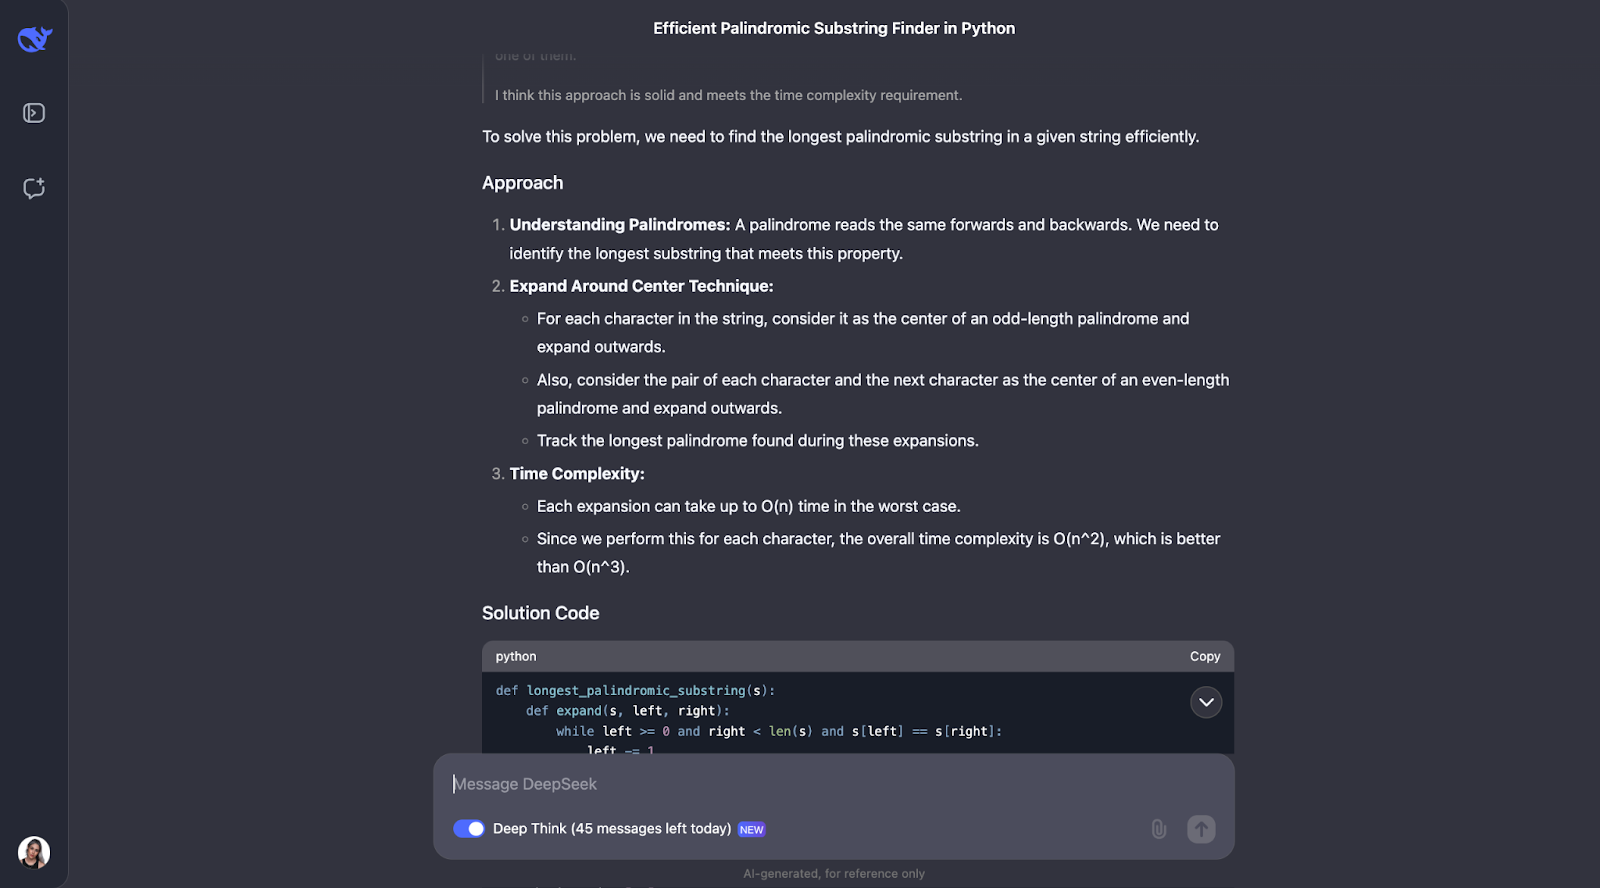
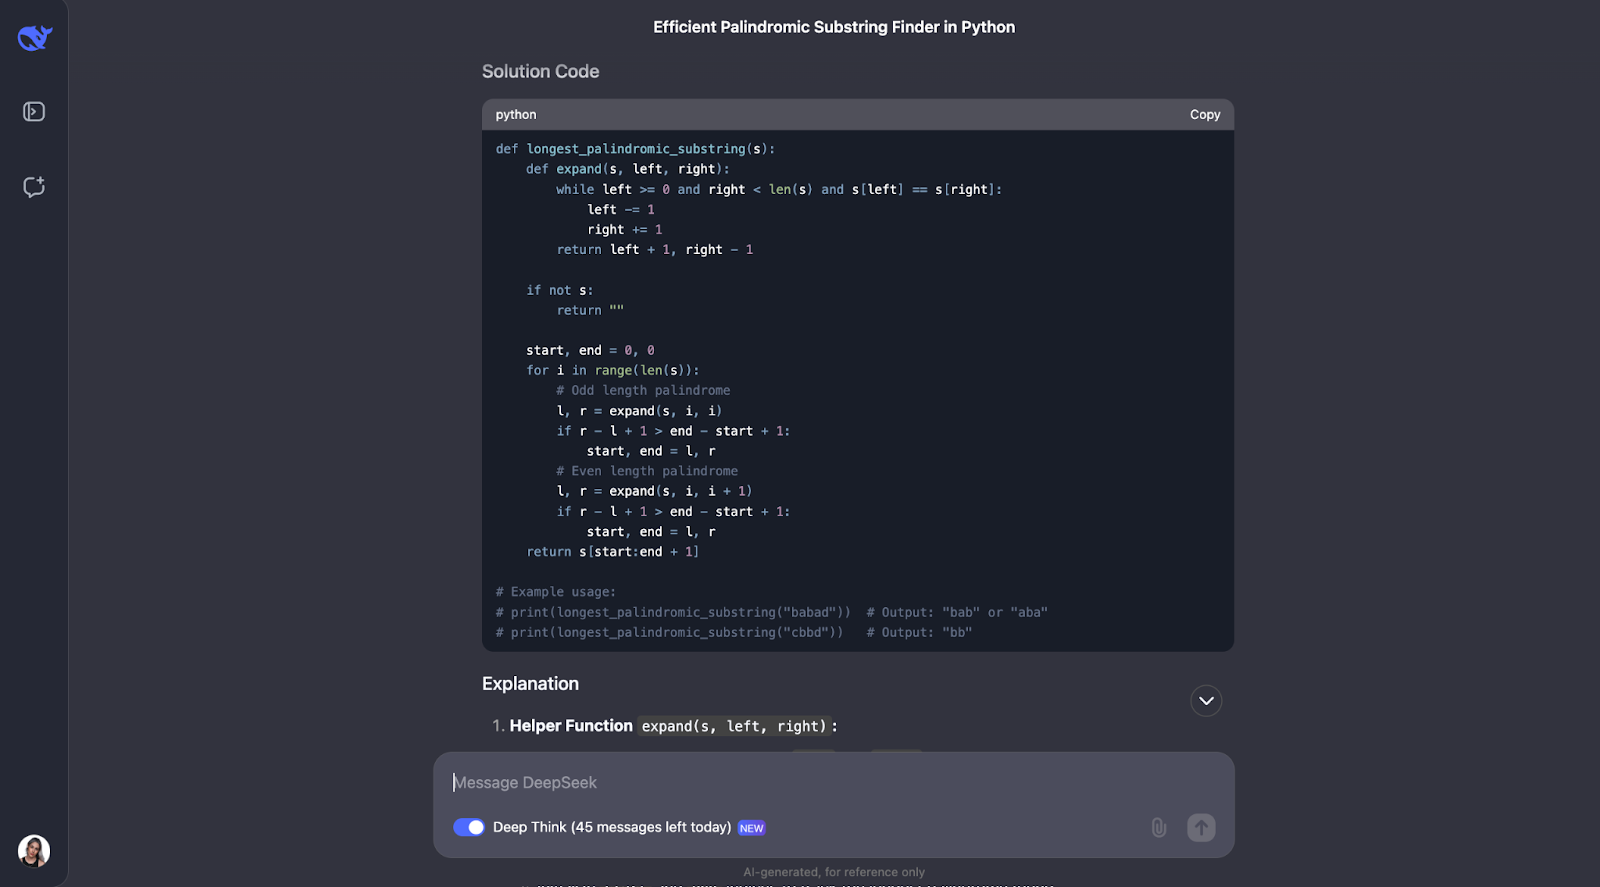
Ik vind dat het model uitstekend werk heeft geleverd bij het oplossen van het probleem om de langste palindromische substring te vinden. De aanpak was slim, efficiënt en duidelijk uitgelegd.
In plaats van elke mogelijke substring brute-forcen, wat traag zou zijn, gebruikte het een slimme "expand around centers"-techniek. Deze methode behandelde zowel palindromen met oneven lengte zoals "aba" als die met even lengte zoals "abba". Het hield de langste gevonden palindrome bij. Het resultaat was een algoritme dat in O(n^2) tijd draait, veel sneller dan een O(n^3)-oplossing.
Wat mij het meest indrukte aan dit antwoord is hoe helder het gepresenteerd werd. DeepSeek brak het probleem op in begrijpelijke stappen, legde het denkproces gedetailleerd uit en voegde zelfs praktische voorbeelden toe. Zo liet het bijvoorbeeld zien hoe het algoritme rond het midden van "racecar" of "abba" uitbreidt om de juiste palindrome te vinden. De helperfunctie om rond een centrum uit te breiden vond ik bijzonder mooi—die maakte de code modulair en goed te volgen.
Dat gezegd hebbende, ik had verwacht dat het Manacher’s algoritme zou overwegen, dat sneller is met O(n). Dat is beslist complexer om te implementeren, maar nuttig in situaties waar performance cruciaal is, en ik had verwacht dat het model dit zou aanstippen.
Ook viel me op dat de output niet expliciet besprak hoe het algoritme omgaat met speciale gevallen, zoals een lege string of een string met allemaal gelijke karakters (bijv. "aaaa"). Deze gevallen zouden werken–maar ik had verwacht dat het dat ten minste zou bespreken.
Tot slot vind ik het fijn dat het commentaar gaf op de verwachte output voor de voorbeeldaanroepen. Toen ik de code draaide, werd echter alleen de eerste optie voor de eerste voorbeeldaanroep geprint. Het was mooi geweest als de code met alle mogelijke oplossingen rekening hield en die allemaal werden geprint.
Laten we een ander programmeerprobleem proberen in een andere programmeertaal.
“Schrijf een functie in JavaScript die bepaalt of een gegeven getal een priemgetal is”
Voor de leesbaarheid laat ik alleen het eerste en het laatste deel zien (al was de denklijn dit keer wat korter):
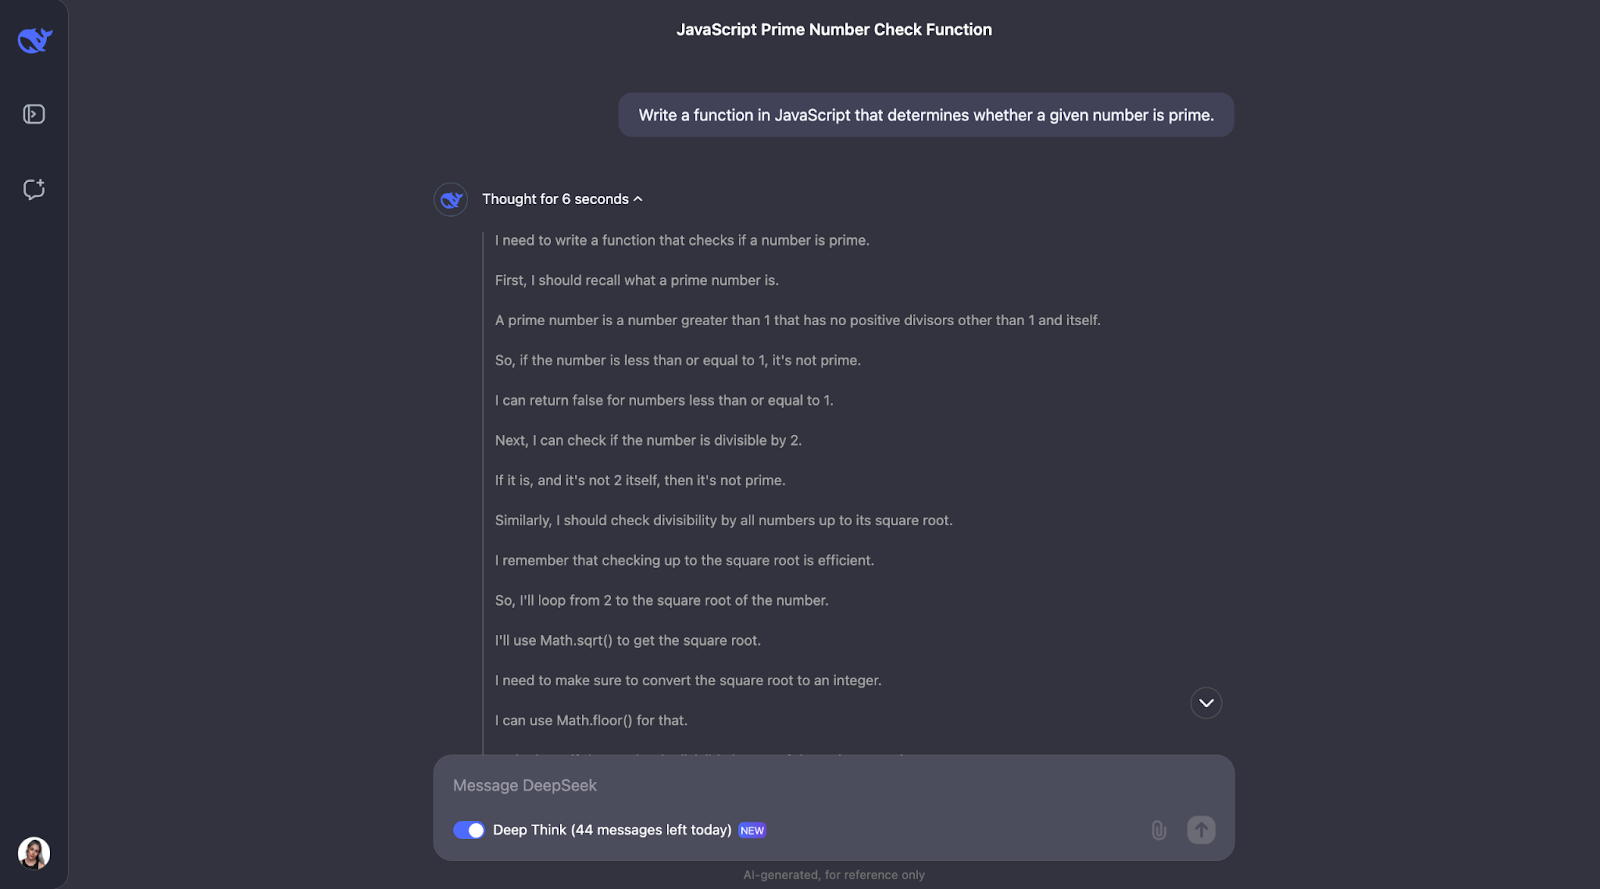
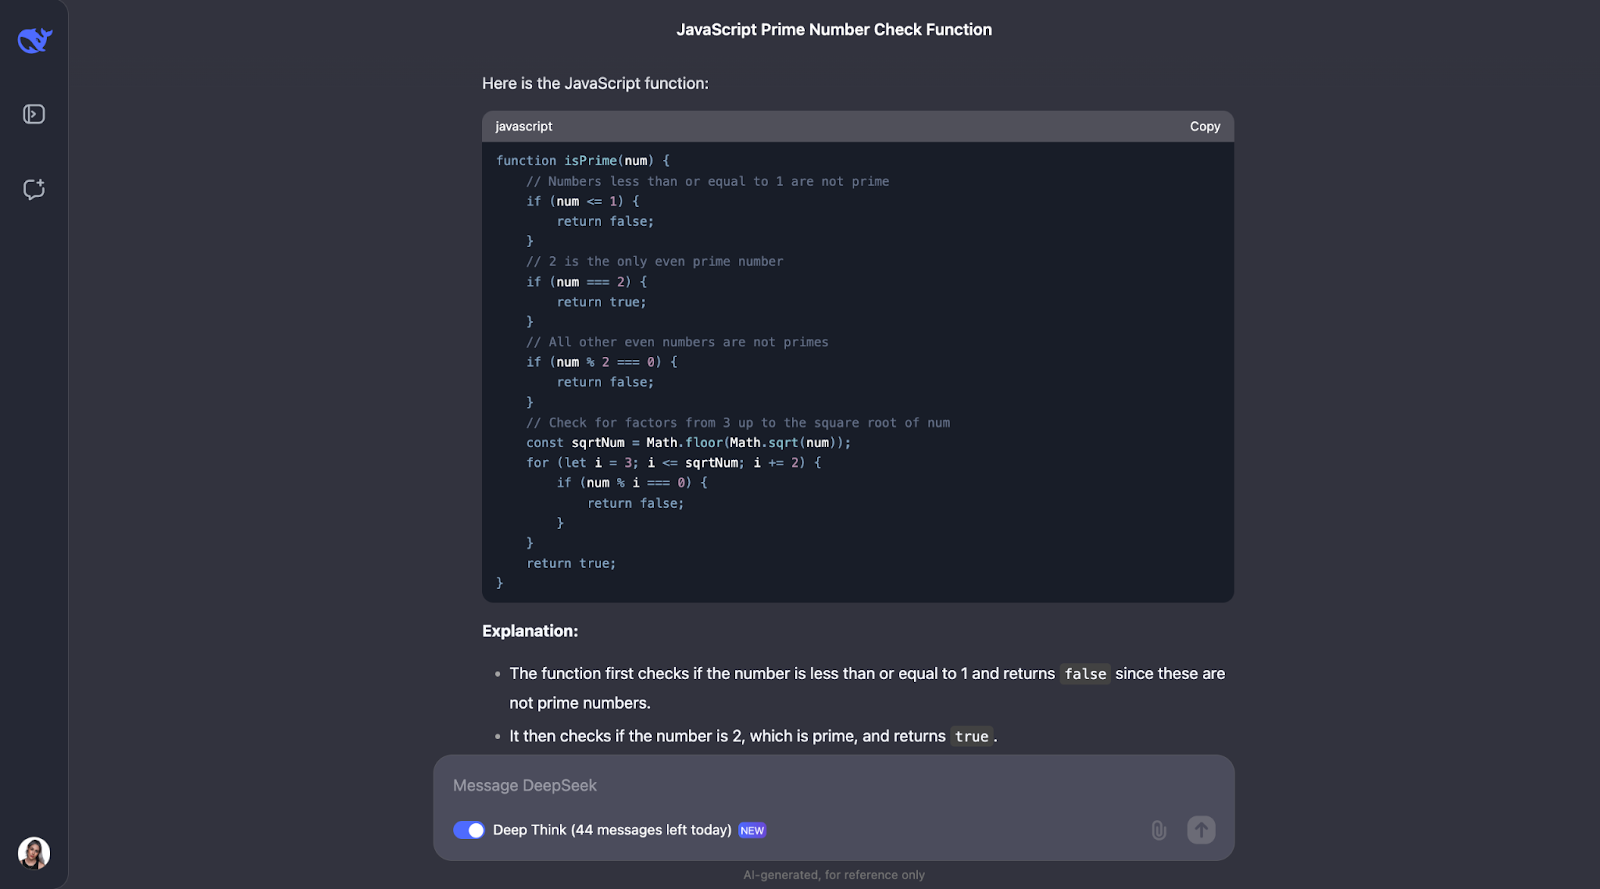
Ik denk dat we hier een patroon zien in het denkproces. Meestal begint het met het definiëren van de kernbegrippen die in het probleem voorkomen. Voor dit probleem definieert het bijvoorbeeld wat een priemgetal is.
Daarna is het denkproces logisch en komt het tot geoptimaliseerde stappen. Eerst de basis: getallen kleiner dan of gelijk aan 1 zijn geen priemgetal, en 2 is het enige even priemgetal. Vervolgens controleert het of het getal deelbaar is door oneven getallen tot aan de wortel uit het getal. Dat bespaart tijd omdat onnodige berekeningen worden vermeden. En in plaats van elk getal te testen, slaat het alle even getallen boven 2 over, wat het proces nog sneller maakt. De functie gebruikt Math.sqrt om de wortel te vinden, wat begrenst hoe ver het hoeft te controleren en het efficiënt en simpel houdt.
Opnieuw testte het ook met kleine voorbeelden, net als bij het vorige probleem, zoals bekende priem- en niet-priemgetallen, om zeker te weten dat het werkt zoals verwacht.
Er is wel ruimte voor verbetering. Zo controleert de functie niet of de input daadwerkelijk een getal is, dus de foutafhandeling kan beter. Ook zouden er shortcuts kunnen worden toegevoegd voor getallen die eindigen op 0 of 5, die overduidelijk geen priem zijn (behalve 5 zelf). Iets meer uitleg over waarom het even getallen overslaat of alleen tot de wortel controleert, zou beginners ook helpen, denk ik.
Tot slot had ik verwacht dat de code, net als bij de Python-code in de vorige test, enkele voorbeeldaanroepen zou bevatten.
Laten we nu doorgaan naar testen van logisch redeneren.
Ik ga een klassieke puzzel testen:
"Een man moet een rivier oversteken met een wolf, een geit en een kool. Zijn boot kan alleen hemzelf en nog één ding dragen. Als ze alleen worden gelaten, eet de wolf de geit op en de geit de kool. Hoe krijgt hij alles veilig naar de overkant?"
Ik zou verwachten dat het model het volgende antwoord geeft:
Maar laten we zien hoe het het denkproces aanpakt, want ik weet niet precies wat ik moet verwachten!
Ik moet ook deze output inkorten voor de leesbaarheid:
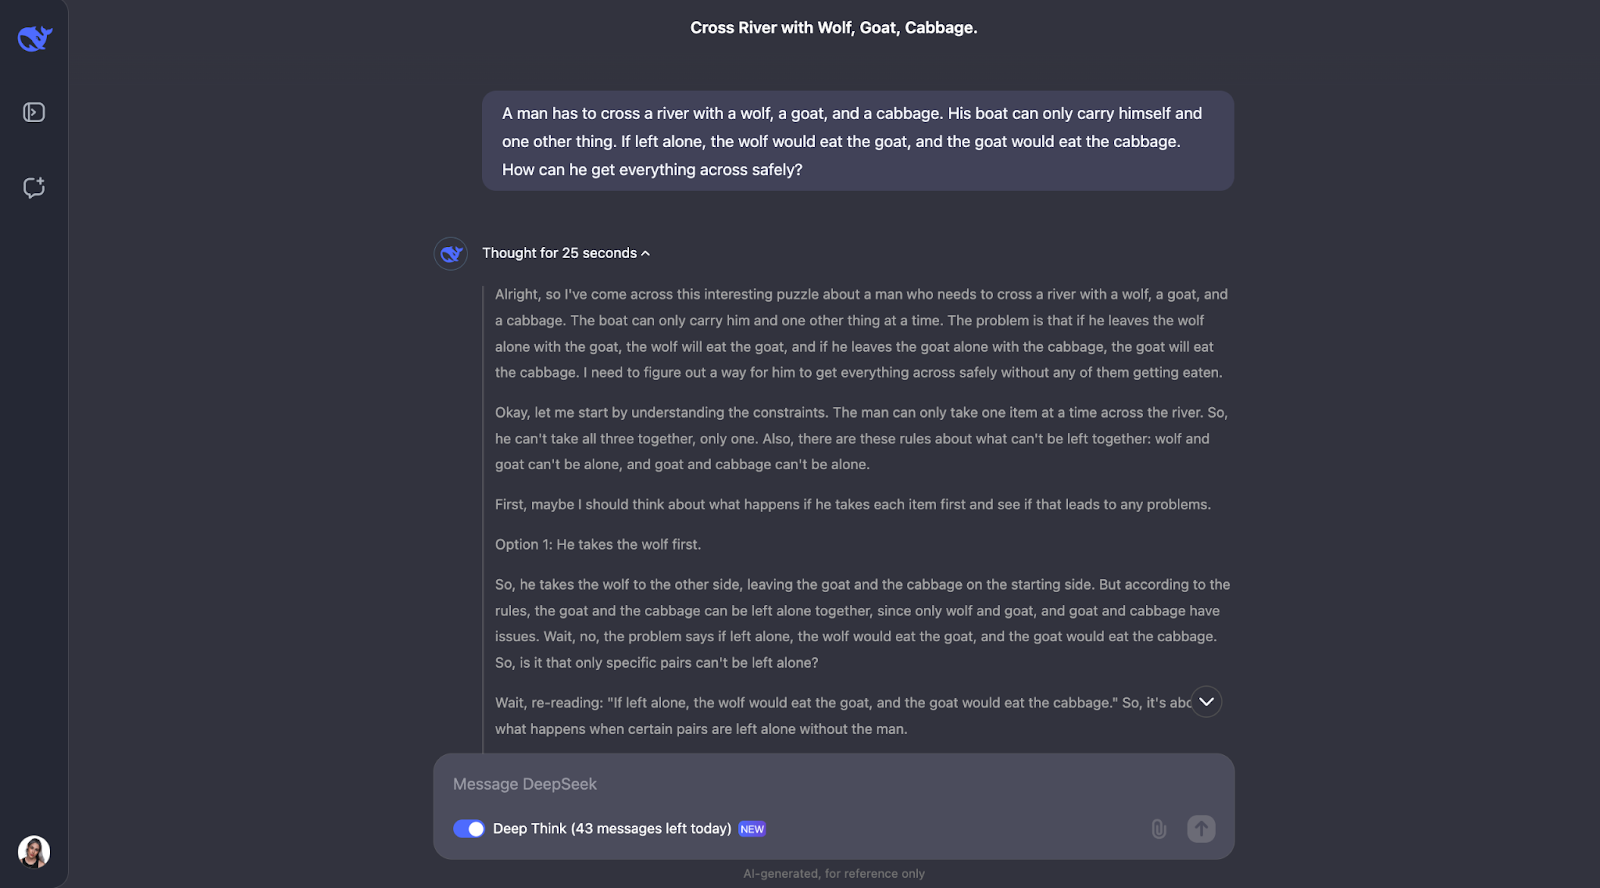
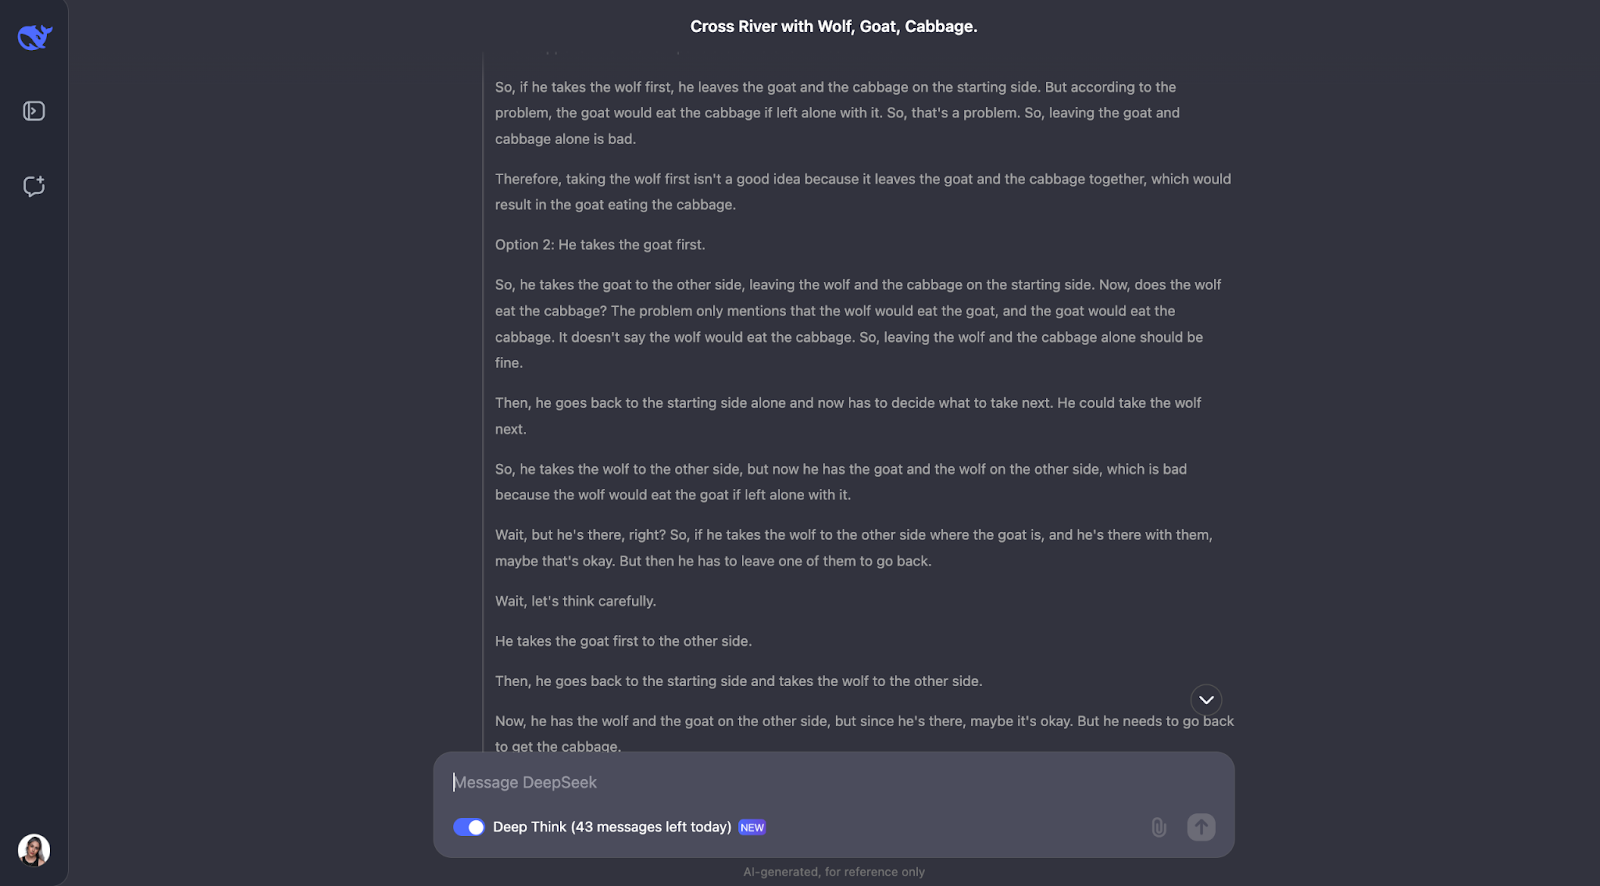
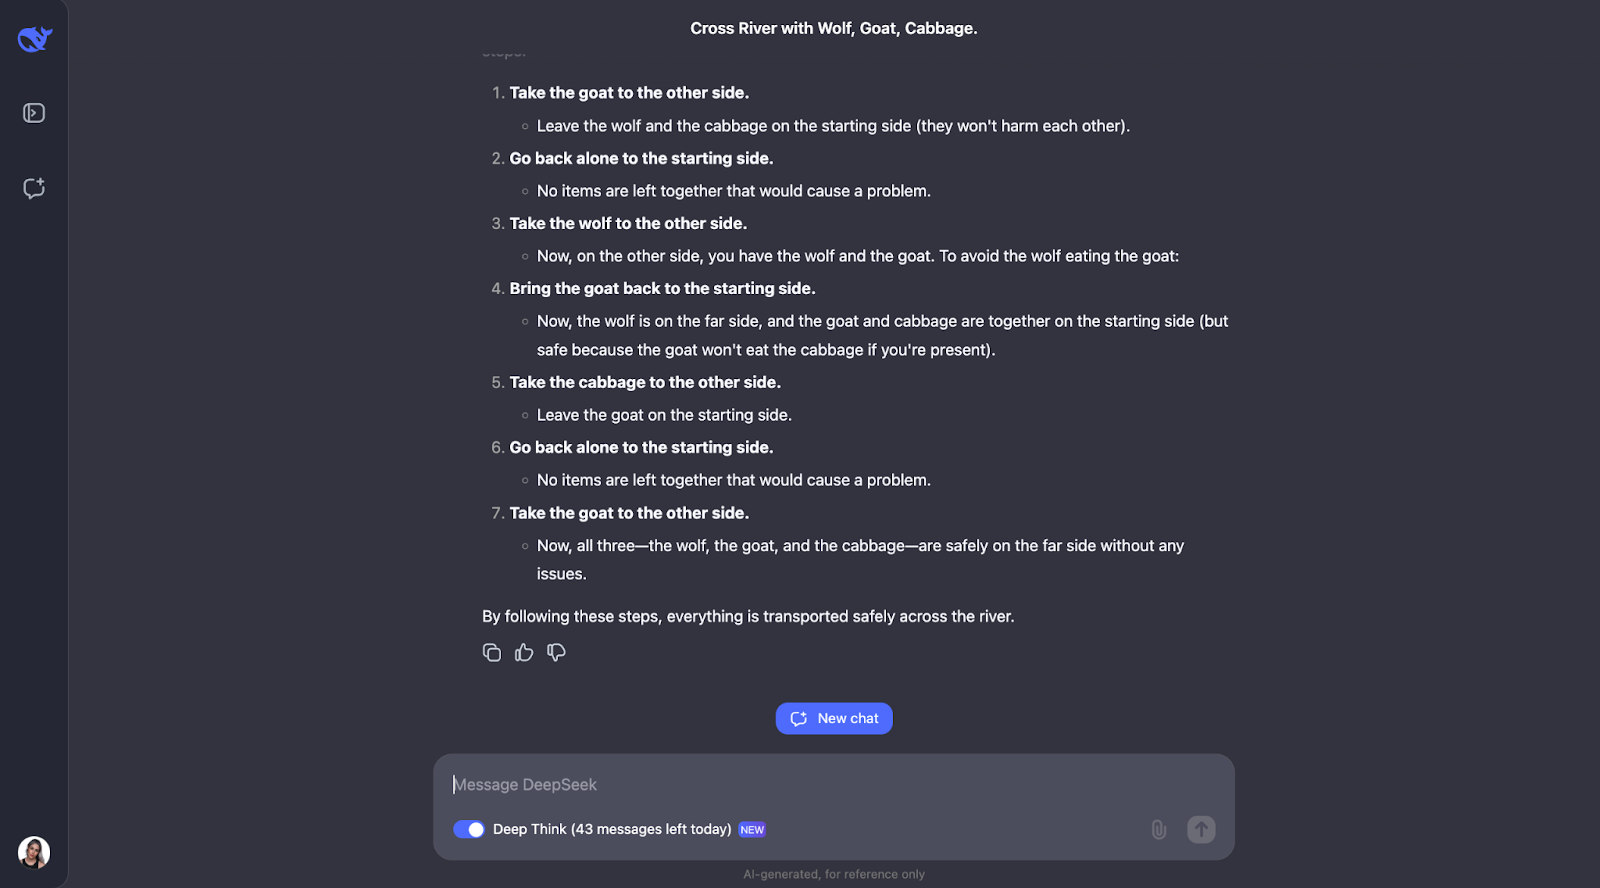
Het model levert uitstekend werk bij het oplossen van deze klassieke rivieroversteekpuzzel. Het denkt zorgvuldig na over de regels en bekijkt verschillende mogelijkheden. Het begrijpt dat sommige paren, zoals de wolf en de geit of de geit en de kool, niet alleen kunnen worden achtergelaten. Het bekijkt de beperkingen ook aan het begin. Vanuit daar bekijkt het wat er gebeurt als de man elk item als eerste naar de overkant brengt en werkt het uit of dat problemen oplevert.
Wat ik heel fijn vind, is hoe het model zijn plan aanpast als iets niet werkt. Bijvoorbeeld wanneer het eerst de wolf probeert mee te nemen, maar inziet dat dit problemen veroorzaakt, en dan de stappen heroverweegt. Deze trial-and-error-methode voelt erg vergelijkbaar met hoe wij, als mensen, de puzzel zelf zouden oplossen.
Uiteindelijk komt het model met de juiste oplossing en legt die duidelijk stap voor stap uit.
Laten we nog een proberen:
“Je hebt 12 ballen, die er allemaal identiek uitzien. Eén bal is ofwel zwaarder of lichter dan de rest. Gebruik een balansweegschaal om de afwijkende bal te vinden en bepaal of hij zwaarder of lichter is in slechts drie wegingen.”
Deze klassieke logische puzzel test het vermogen van het model om met een optimale strategie te komen via deductief redeneren. Laten we zien wat er gebeurt. De output was dit keer erg, erg lang, dus ik ga meteen naar het antwoord:
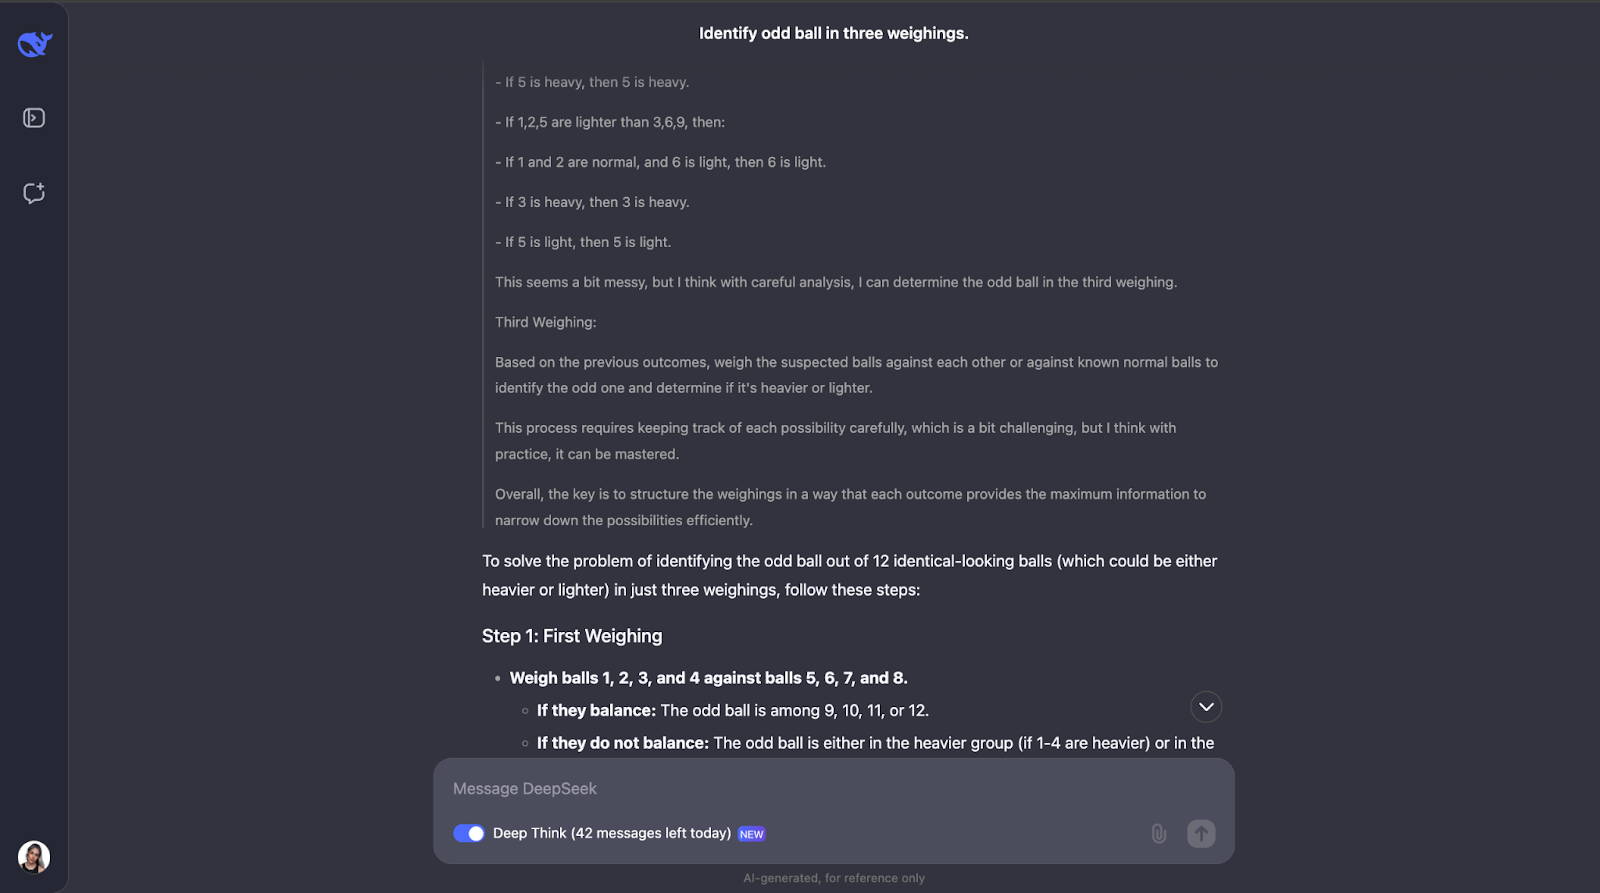
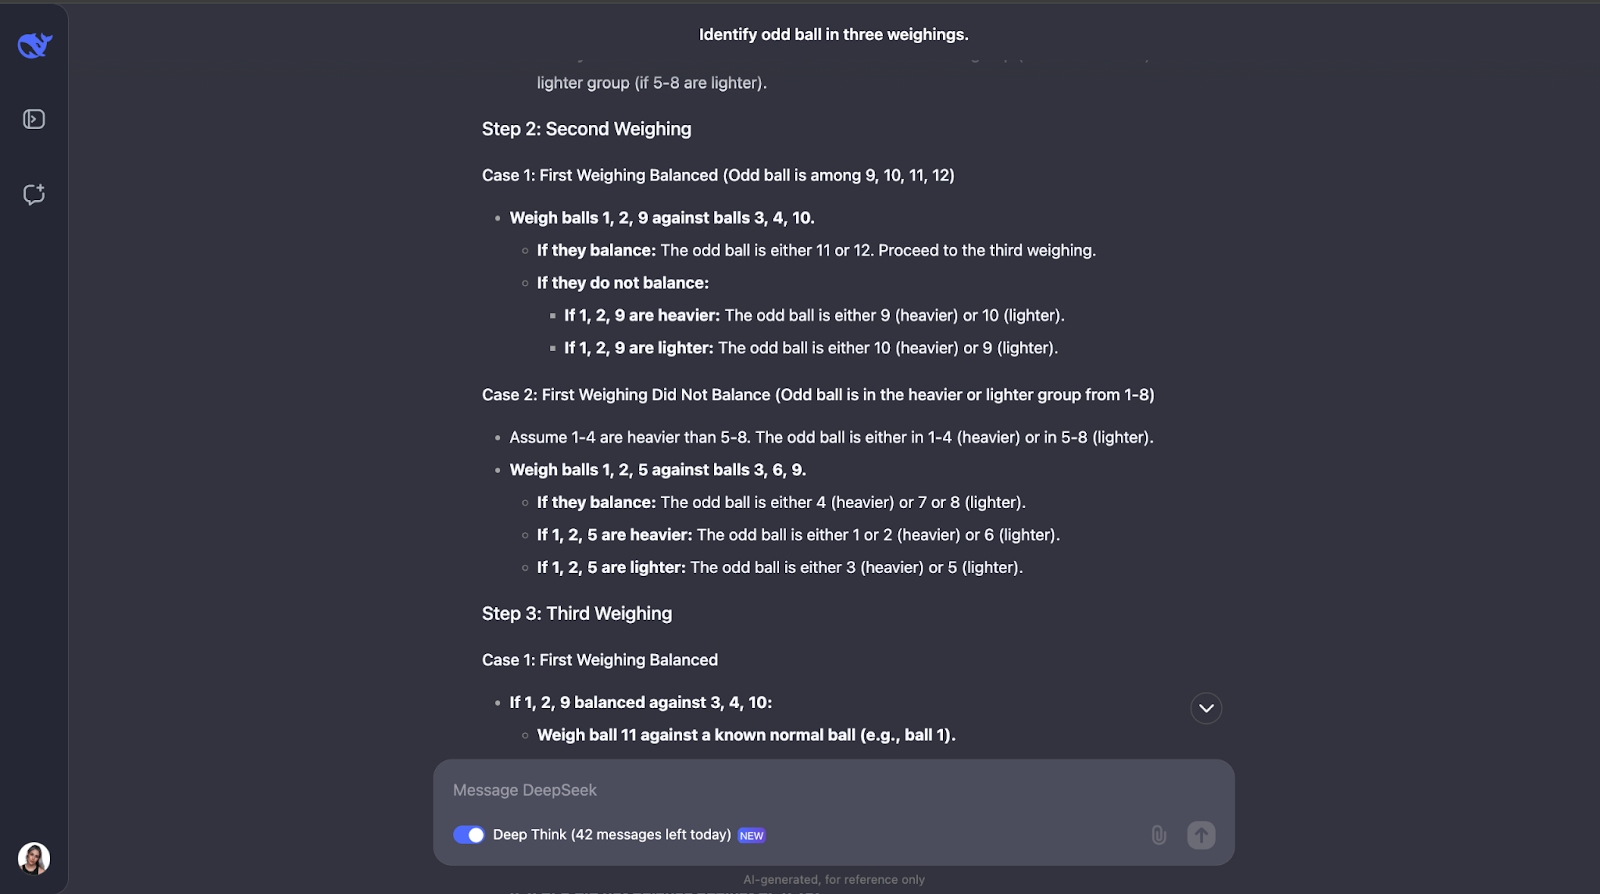
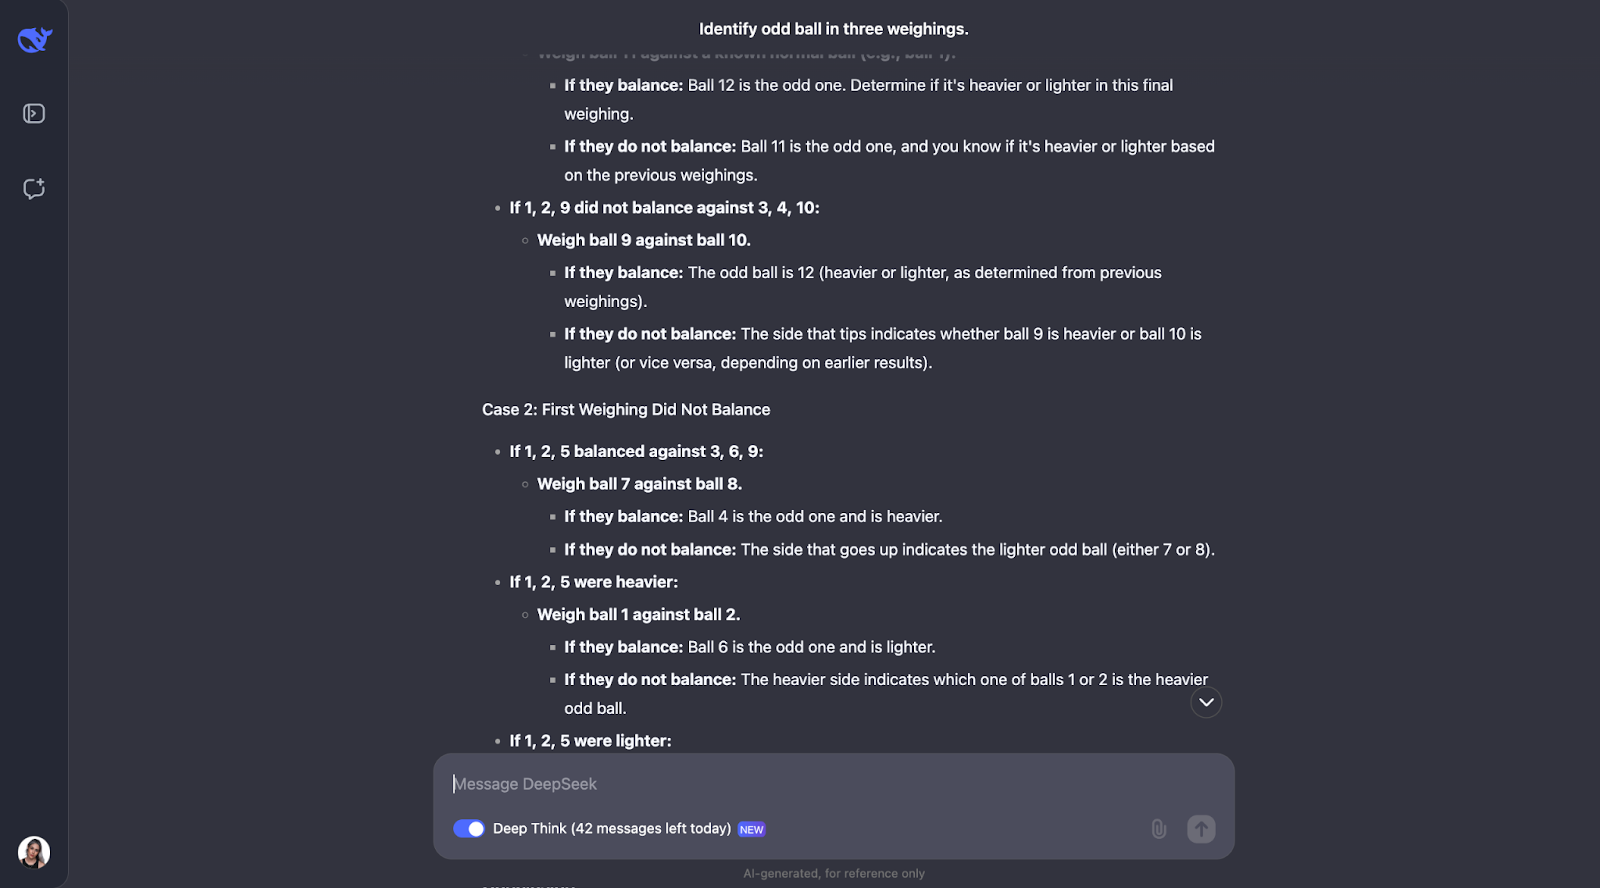
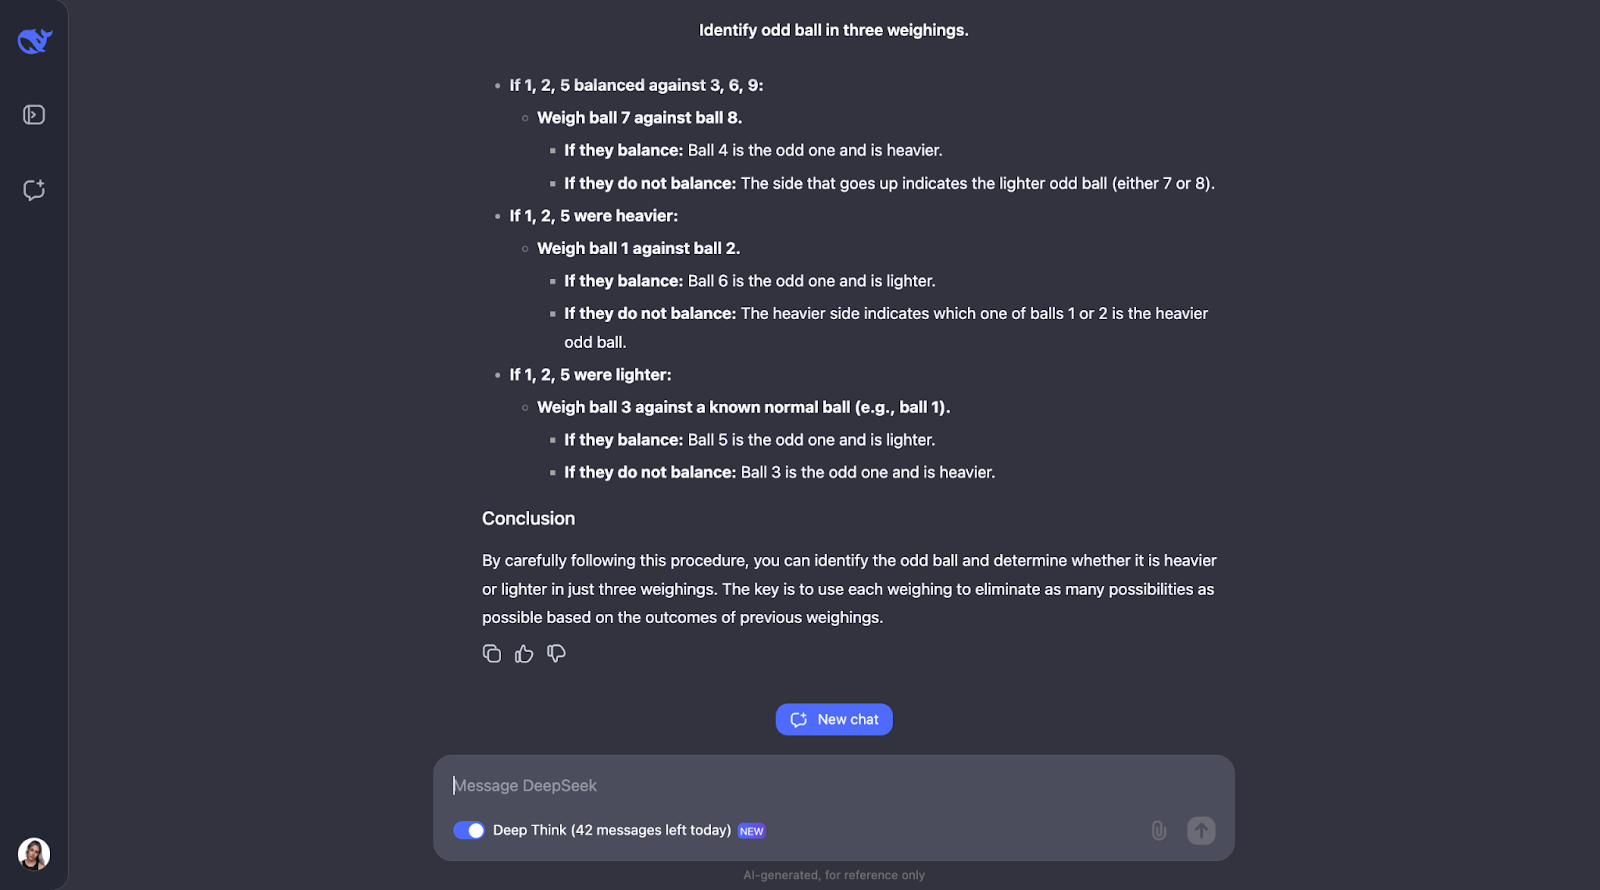
Weer een geval waarin ik de lengte van de output totaal had onderschat! Het model beseft dat deze puzzel zorgvuldige planning vereist omdat je maar drie pogingen krijgt. Het berekent ook het aantal uitkomsten en mogelijkheden.
De aanpak van het model is slim, omdat elke weging zoveel mogelijk mogelijkheden uitsluit. Het plant voor alle uitkomsten—of de weegschaal nu in evenwicht is of overhelt—en past de volgende stap aan op basis van wat er gebeurt. Het is zeer gedetailleerd, maar de stappen zijn duidelijk en logisch, waardoor het heel goed te volgen is, ook al is het langdradig,
Wat ik erg prettig vond, is dat het, wanneer de aanpak wat te complex begint te worden, een meer systematische of eenvoudigere aanpak toepast. Voor dit soort problemen, waarbij je verschillende gevallen, uitkomsten en mogelijkheden moet bijhouden, zou het toevoegen van een diagram of schema mensen kunnen helpen om de denklijn te visualiseren en de output beter te begrijpen.
In deze sectie vergelijk ik DeepSeek met andere modellen zoals o1-preview en GPT-4o qua prestaties op verschillende benchmarks. Elke benchmark richt zich op een andere vaardigheid, zodat we kunnen zien welke modellen waar het beste in zijn. Laten we de benchmarks bekijken die door DeepSeek zijn gemeten:
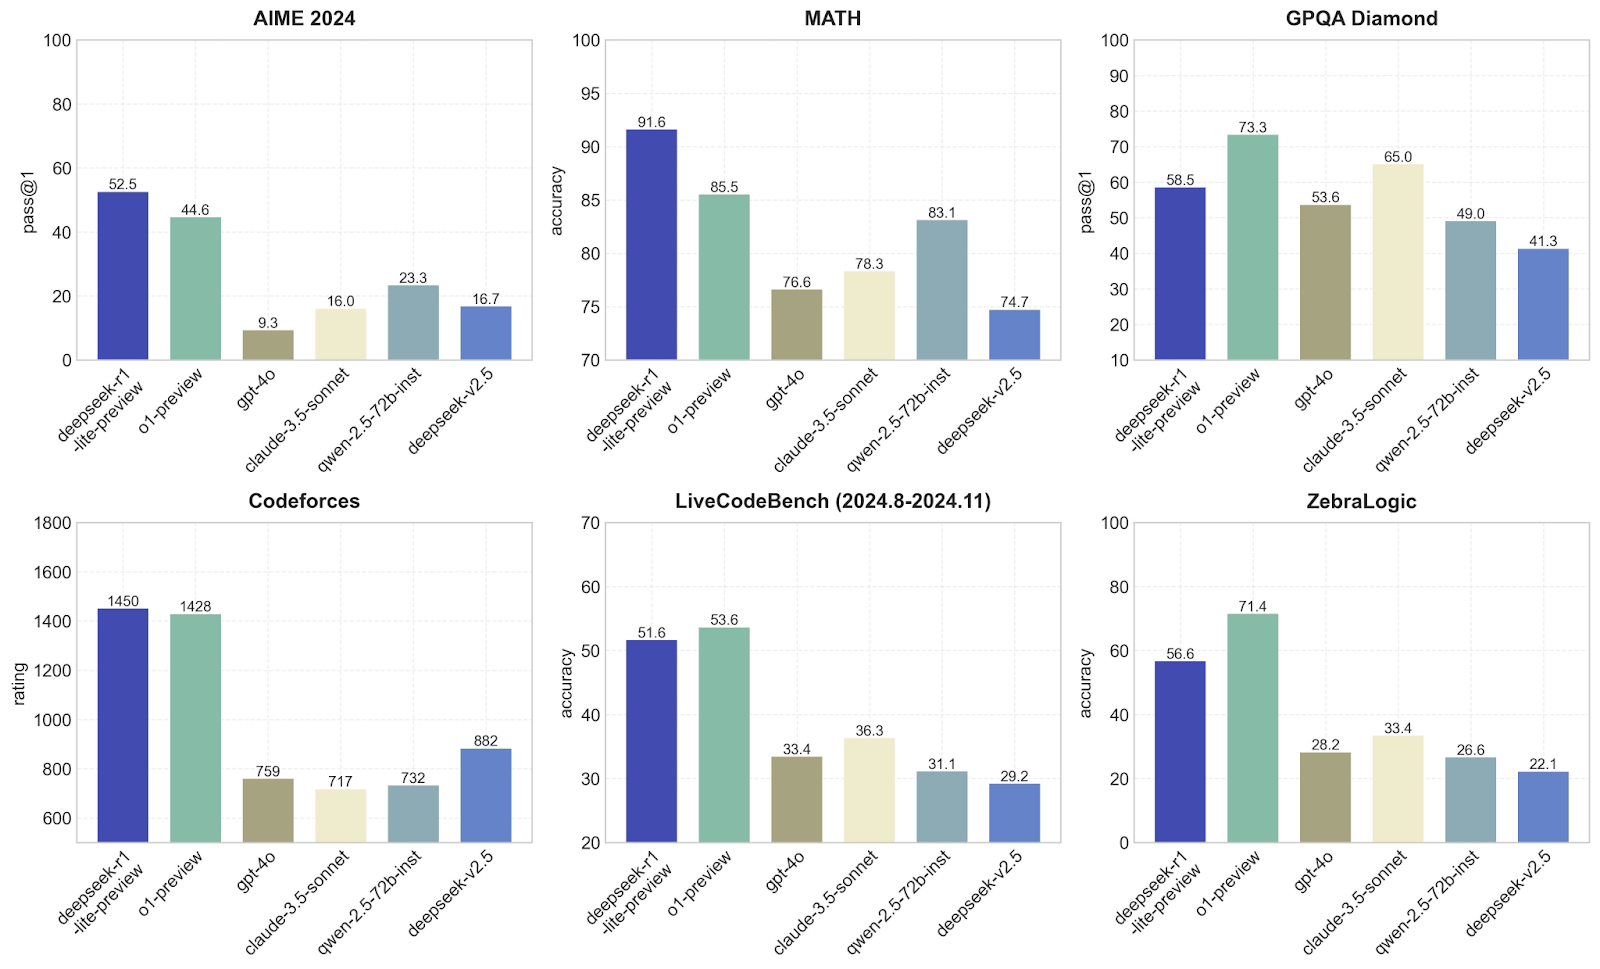
DeepSeek-r1-lite-preview is hier duidelijk de beste, met een pass@1 van 52,5, gevolgd door o1-preview met 44,6. Andere modellen, zoals GPT-4o en claude-3.5-sonnet, doen het veel slechter, met scores onder 23. Dit suggereert dat het DeepSeek-r1-lite-preview-model behoorlijk goed is in het aanpakken van de soort geavanceerde wiskunde- of logische problemen die specifiek zijn voor de AIME-benchmarks, wat me niet verbaast na de tests die ik heb uitgevoerd.
DeepSeek-v1 domineert opnieuw met een indrukwekkende nauwkeurigheid van 91,6, ver voor o1-preview (85,5) en veel beter dan andere modellen zoals GPT-4o, die moeite hebben om 76,6 te halen. Dit laat zien dat DeepSeek geweldig is in het oplossen van wiskundeproblemen, wat mijn hypothese bevestigt op basis van het empirisch bewijs uit de eerdere tests–geen verrassingen tot nu toe!
Hier doet o1-preview het beter dan DeepSeek-v1, met een pass@1 van 73,3 tegenover 58,5. Andere modellen, zoals GPT-4o, blijven achter met 53,6. Dit suggereert dat o1-preview beter geschikt is voor taken die het beantwoorden van vragen of het oplossen van problemen met logisch redeneren vereisen. DeepSeek presteert nog steeds solide, maar is niet zo goed als o1-preview.
Voor competitive programming staan DeepSeek-v1 (1450) en 01-preview (1428) bijna gelijk bovenaan, terwijl andere modellen zoals GPT-4o rond de 759 scoren. Zoals verwacht laat dit zien dat deze twee modellen uitstekend zijn in het begrijpen en genereren van code voor programmeeruitdagingen.
Dit test codeervaardigheden in de tijd, en o1-preview is net iets beter dan DeepSeek-v1 (53,6 vs. 51,6). Andere modellen, zoals GPT-4o, blijven ver achter met 33,4. Opnieuw laat dit zien dat zowel DeepSeek als 01-preview geschikt zijn voor coderen, maar dat 01-preview hierin net iets beter is.
o1-preview neemt hier de leiding met een nauwkeurigheid van 71,4, vergeleken met 56,6 voor DeepSeek-v1. Andere modellen doen het veel slechter. Dit laat zien dat o1-preview beter is in het aanpakken van abstracte logische taken zoals ZebraLogic, die meer creatief of out-of-the-box denken vereisen, wat aansluit bij de resultaten die ik kreeg uit de tests, aangezien creativiteit zeker niet DeepSeek-v1’s sterkste kant was.
Deze grafieken bevestigen dat DeepSeek-v1 geweldig is in wiskunde- en programmeeruitdagingen. Ik zou zeggen dat o1-preview meer in balans is en goed presteert over een breder scala aan taken, wat het veelzijdiger maakt.
Laten we nu naar deze grafiek kijken:
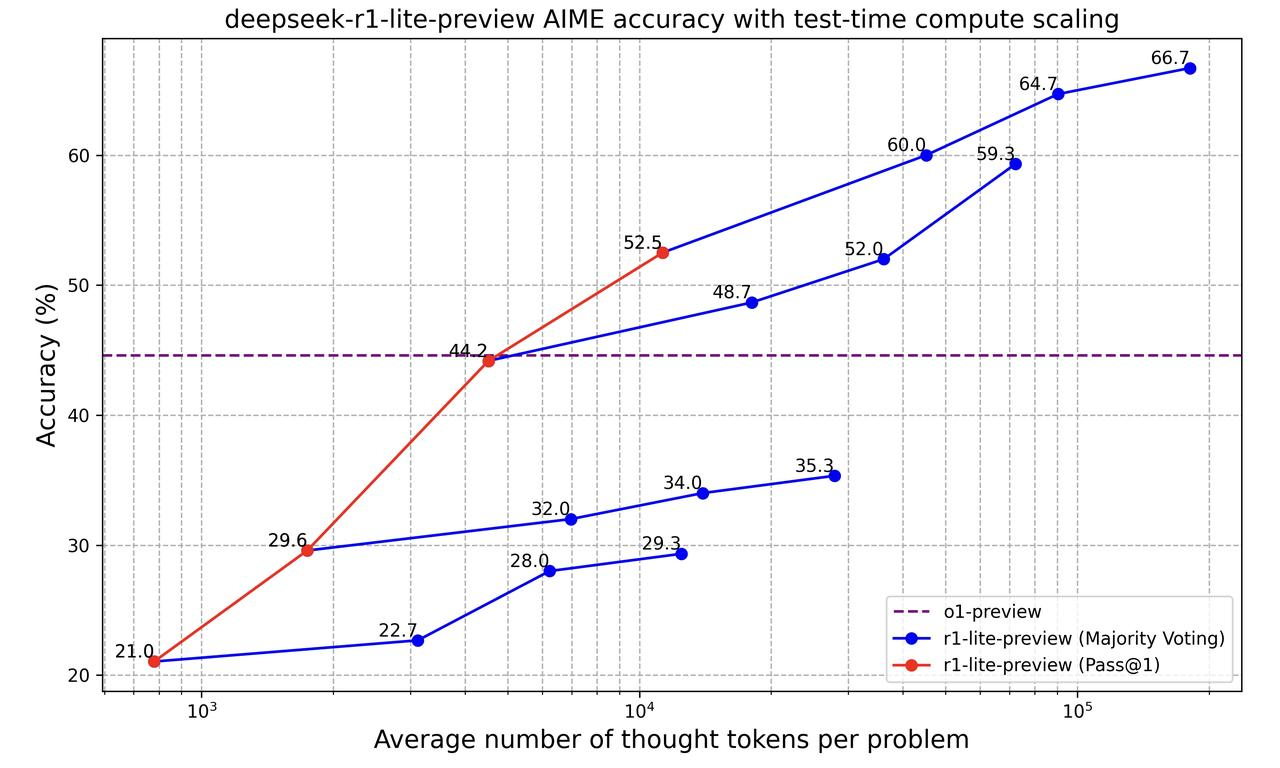
Deze grafiek laat zien hoe het model "deepseek-r1-lite-preview" beter wordt in het oplossen van problemen naarmate het meer informatie verwerkt (gemeten aan het aantal gebruikte "thought tokens"). Er worden twee manieren vergeleken waarop de nauwkeurigheid van het model wordt gemeten:
De gestreepte paarse lijn vertegenwoordigt het o1-preview-model dat een stabiele nauwkeurigheid heeft. In het begin is o1-preview beter, maar naarmate DeepSeek r1-lite-preview meer thought tokens mag gebruiken, haalt het o1-preview in en wordt het veel nauwkeuriger.
Kortom, deze grafiek laat zien dat DeepSeek r1-lite-preview beter presteert als je het meer laat nadenken en meerdere keren laat proberen.
Is DeepSeek-r1-lite-preview beter dan OpenAI’s o1-preview? Nou, dat hangt af van de taak. Voor wiskunde- en programmeerproblemen zeg ik ja. Voor logisch redeneren hangt het van de specifieke taak af.
Wat me echt verraste, was hoe het door sommige tests heen redeneerde. Het zette me aan het denken over wat het eigenlijk betekent dat een model “denkt” en hoe het met redeneerstrategieën komt.
Als je nieuwsgierig bent naar dit model, waarom test je het dan niet zelf? Probeer het op de taken die jou interesseren en kijk hoe het presteert—misschien vind je het net zo verrassend als ik!
Leer AI met deze cursussen!
Cursus
Leerpad
Cursus
blog
Adel Nehme
15 min

