
Apa Itu Komputasi Terdistribusi?
Dalam komputasi terdistribusi, kita menggunakan banyak komputer untuk bekerja sama pada satu masalah. Alih-alih mengandalkan satu mesin, kita membagi tugas menjadi potongan-potongan lebih kecil dan menugaskannya ke jaringan komputer yang kita sebut “node.” Node-node ini berbagi beban pemrosesan dan penyimpanan data, bekerja secara kolaboratif untuk menyelesaikan tugas.
Pendekatan ini berguna saat menangani masalah skala besar atau dataset yang terlalu besar atau kompleks untuk ditangani oleh satu komputer. Misalnya, sistem komputasi terdistribusi dapat memproses petabyte data untuk mesin pencari, menjalankan simulasi untuk riset ilmiah, atau mendukung model keuangan untuk analisis pasar.
Komputasi Terdistribusi vs Komputasi Paralel
Komputasi terdistribusi dan komputasi paralel sering kali membingungkan dan tampak dapat dipertukarkan. Keduanya melibatkan banyak proses yang bekerja menuju satu tujuan, namun keduanya adalah pendekatan berbeda yang dirancang untuk skenario berbeda.
Komputasi terdistribusi berfokus pada penggunaan jaringan mesin terpisah, sering kali tersebar secara geografis, untuk menyelesaikan masalah secara kolaboratif. Setiap mesin beroperasi sebagai node independen dengan memori dan daya pemrosesannya sendiri. Komunikasi antar node terjadi melalui jaringan, dan tugas dibagi agar dapat dijalankan pada mesin yang berbeda.
Komputasi paralel, di sisi lain, biasanya berlangsung dalam satu sistem. Pendekatan ini menggunakan beberapa prosesor atau inti dalam satu komputer untuk mengeksekusi tugas secara bersamaan. Prosesor-prosesor ini berbagi memori yang sama dan sering bekerja erat untuk membagi komputasi.
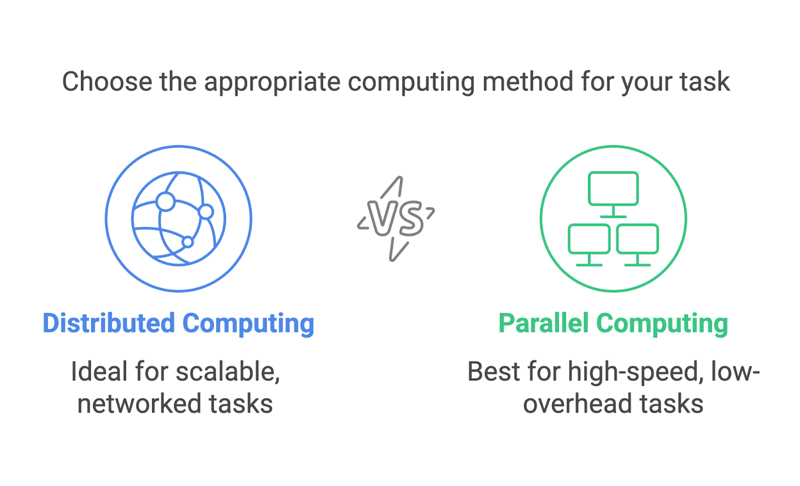
Mari ambil contoh praktis: kita sedang mengurutkan dataset yang sangat besar. Dalam komputasi paralel, kita akan membagi dataset menjadi beberapa bagian, dan setiap prosesor dalam mesin yang sama akan menangani satu bagian. Dalam komputasi terdistribusi, dataset akan dibagi dan dikirim ke mesin yang berbeda, yang masing-masing kemudian mengurutkan bagiannya secara mandiri. Potongan yang sudah diurutkan kemudian digabungkan.
Kedua metode sangat berguna, tetapi cocok untuk tugas yang berbeda. Komputasi paralel ideal untuk tugas yang membutuhkan komputasi berkecepatan tinggi dengan overhead komunikasi minimal, seperti menjalankan simulasi pada superkomputer. Komputasi terdistribusi lebih cocok saat perlu melakukan scale-out, seperti saat memproses data di sistem berbasis cloud atau di seluruh jaringan global.
Use Case Komputasi Terdistribusi
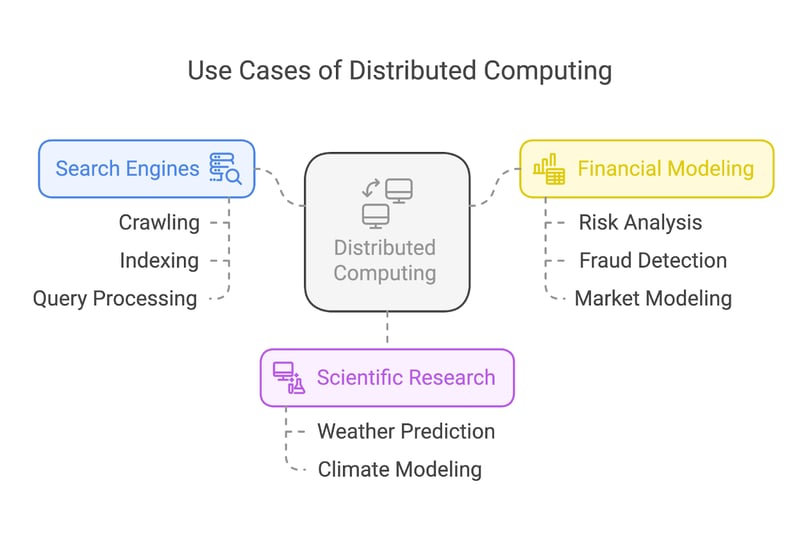
Komputasi terdistribusi mendukung beberapa aplikasi paling berpengaruh di dunia kita saat ini. Mari kita lihat tiga use case umum: mesin pencari, riset ilmiah, dan pemodelan keuangan.
Mesin pencari
Mesin pencari seperti Google sangat bergantung pada komputasi terdistribusi untuk merayapi dan mengindeks miliaran halaman web. Alih-alih menugaskan pekerjaan ke satu mesin, sistem ini membagi beban kerja di antara banyak, banyak node.
Sebagian node fokus pada perayapan halaman web, yang lain menangani pengindeksan, dan kelompok lainnya memproses kueri pengguna secara real-time. Pembagian kerja ini memastikan hasil pencarian yang cepat dan efisien, apa pun skala tugasnya.
Riset ilmiah
Dalam riset ilmiah, komputasi terdistribusi memungkinkan terobosan dengan menjalankan simulasi kompleks dan menganalisis dataset yang sangat besar. Misalnya, ilmuwan iklim menggunakan sistem terdistribusi untuk memodelkan dan memprediksi pola cuaca atau mensimulasikan dampak pemanasan global.
Pemodelan keuangan
Industri keuangan mengandalkan komputasi terdistribusi untuk tugas seperti analisis risiko, deteksi penipuan, dan pemodelan pasar.
Memproses dataset besar yang dihasilkan oleh pasar keuangan global menuntut sistem yang mampu bekerja tanpa henti dan sangat cepat. Komputasi terdistribusi memungkinkan perusahaan keuangan menganalisis data, menguji model, dan menghasilkan wawasan pada kecepatan yang membuat mereka tetap kompetitif di pasar real-time.
Komponen Utama Komputasi Terdistribusi
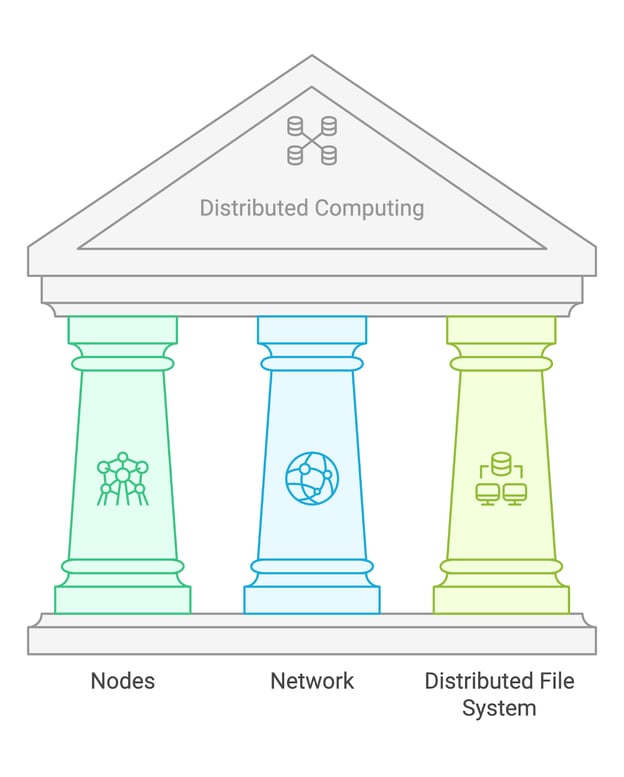
Komputasi terdistribusi bergantung pada beberapa blok bangunan fundamental: node, jaringan, dan sistem berkas terdistribusi (DFS).
Node
Node adalah mesin-mesin individual yang melakukan komputasi dalam sistem terdistribusi. Setiap node dapat bertindak secara independen, memproses tugas yang ditugaskan dan berkomunikasi dengan node lain untuk berbagi hasil. Dalam beberapa kasus, node mungkin memiliki peran khusus, seperti mengelola tugas atau menyimpan data.
Jaringan
Jaringan adalah infrastruktur komunikasi yang menghubungkan berbagai node. Jaringan memungkinkan pertukaran data dan koordinasi tugas. Bergantung pada ukuran sistem, ini dapat melibatkan jaringan area lokal (LAN) atau jaringan area luas (WAN) untuk node yang tersebar secara geografis.
Sistem berkas terdistribusi (DFS)
Sistem berkas terdistribusi adalah solusi penyimpanan yang memungkinkan data diakses di berbagai node. Salah satu contohnya yang populer adalah Hadoop Distributed File System (HDFS), yang dirancang untuk menangani dataset besar dan menyediakan toleransi kesalahan dengan mereplikasi data di beberapa node.
Arsitektur Umum Komputasi Terdistribusi
Baik, kita punya beban kerja yang didistribusikan ke berbagai node melalui jaringan, dan semua node memiliki akses ke data melalui DFS. Namun siapa yang memutuskan node mana mengerjakan apa?
Tidak ada satu jawaban untuk pertanyaan ini karena sistem komputasi terdistribusi dapat diatur dengan berbagai cara. Meski begitu, ada tiga arsitektur umum: master-slave, peer-to-peer, dan client-server.
Master-slave
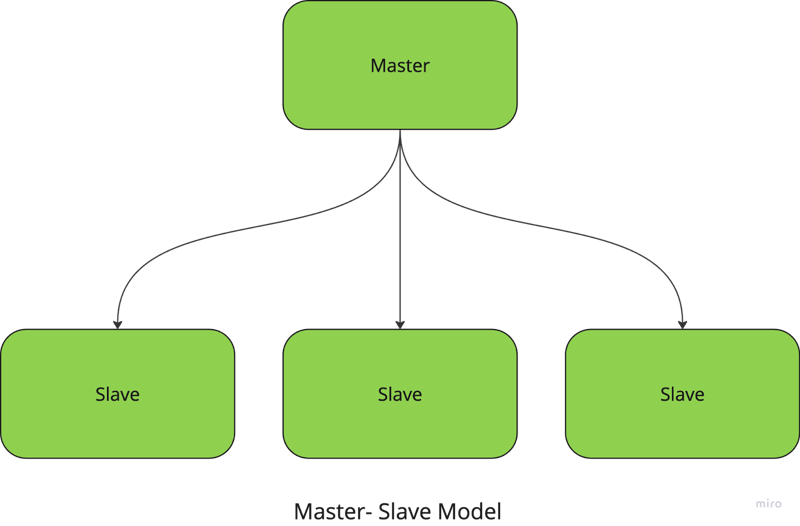
Dalam model master-slave, satu node pusat (master) mengelola dan mengoordinasikan tugas sementara node slave mengeksekusi komputasi aktual. Master bertanggung jawab membagi tugas menjadi potongan-potongan kecil, mendistribusikannya ke slave, dan mengumpulkan hasilnya.
Misalnya, jika Anda menjalankan tugas pemrosesan gambar skala besar, node master menugaskan setiap node slave bagian spesifik dari gambar untuk diproses. Setelah tugas selesai, master mengumpulkan hasil dan menggabungkannya menjadi keluaran akhir.
Pendekatan ini menyederhanakan manajemen dan koordinasi tugas tetapi memiliki kelemahan kuat: sistem memiliki satu titik kegagalan karena sepenuhnya bergantung pada node master.
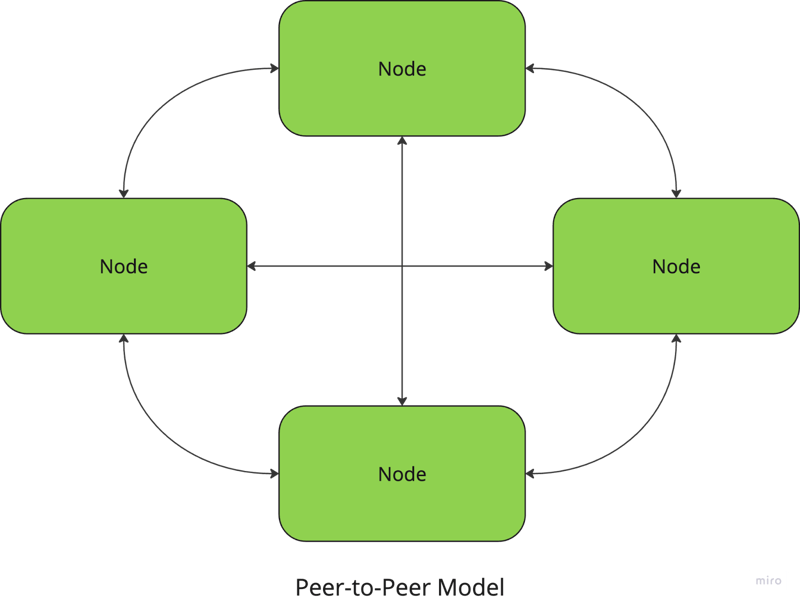
Peer-to-peer
Dalam arsitektur peer-to-peer, semua node setara, dan tidak ada koordinator pusat. Setiap node dapat bertindak sebagai klien dan server, berbagi sumber daya dan berkomunikasi langsung dengan node lain.
Sebagai contoh, jaringan berbagi berkas seperti BitTorrent menggunakan pendekatan P2P, di mana pengguna mengunduh dan mengunggah potongan berkas secara langsung dari dan ke peer lainnya.
Keuntungannya, sistem ini tidak memiliki titik kegagalan pusat, sehingga tangguh dan dapat diskalakan, namun koordinasi antar node (untuk memastikan konsistensi data, misalnya) bisa lebih kompleks.
Client-server
Dalam model client-server, satu atau lebih server menyediakan sumber daya atau layanan kepada banyak node klien. Klien mengirim permintaan ke server, yang memprosesnya dan mengembalikan hasil. Arsitektur ini umum digunakan pada aplikasi web dan basis data.
Ini mungkin terdengar mirip dengan model master-slave, dengan server berperan sebagai master, tetapi ada perbedaan: server biasanya lebih pasif dan tidak membagi atau mendelegasikan tugas—server hanya merespons permintaan klien.
Dengan model ini, pengelolaan dan kontrol terpusat memudahkan pemeliharaan dan pembaruan sistem, namun server menjadi bottleneck yang dapat membatasi skalabilitas. Waktu henti server juga dapat mengganggu seluruh sistem.
Ketiga arsitektur ini adalah yang paling umum dalam sistem terdistribusi, tetapi ada model lain yang mungkin pernah Anda temui (saya yakin Anda pernah mendengar arsitektur berbasis cloud!).
Setiap model melayani kebutuhan yang berbeda, dan pilihan arsitektur dapat berdampak besar pada kinerja sistem, toleransi kesalahan, dan skalabilitas, sehingga penting untuk memetakan masalah yang Anda selesaikan sebelum menentukan pendekatan. Kabar baiknya, Anda tidak harus memilih hanya satu! Sebagian besar sistem modern, terutama dalam komputasi cloud, menggunakan versi hibrida dari arsitektur ini untuk menggabungkan keunggulan masing-masing.
Menyiapkan Sistem Komputasi Terdistribusi
Sekarang kita telah membahas teori di balik komputasi terdistribusi, mari lihat cara sebenarnya menyiapkan sistem komputasi terdistribusi.
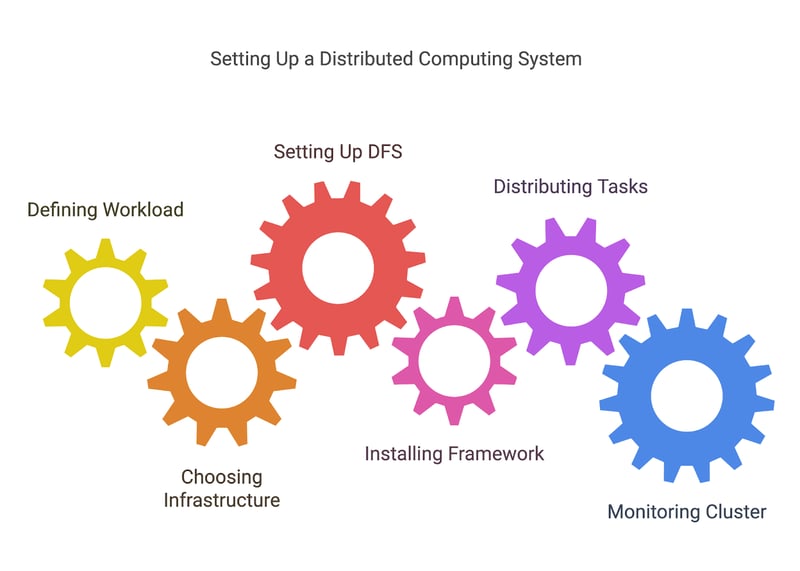
1. Mendefinisikan beban kerja Anda
Sebelum Anda dapat mendistribusikan tugas, Anda perlu mendefinisikan tugas apa yang akan didistribusikan. Ini sering melibatkan pemecahan masalah yang lebih besar menjadi unit kerja yang lebih kecil dan independen yang dapat diproses secara paralel atau didistribusikan ke berbagai node.
Misalnya, jika Anda memproses dataset besar, Anda dapat membagi data menjadi beberapa bagian yang dapat ditangani oleh mesin atau prosesor yang berbeda.
2. Memilih infrastruktur Anda
Komputasi terdistribusi memerlukan jaringan mesin, baik itu server on-premises, instance cloud (seperti AWS, Azure, atau Google Cloud), atau bahkan kombinasi keduanya. Anda perlu memutuskan bagaimana menyiapkan dan mengonfigurasi mesin-mesin ini, memastikan mesin-mesin tersebut terhubung dan dapat saling berkomunikasi.
- Infrastruktur berbasis cloud: Platform seperti AWS, Google Cloud, dan Azure memudahkan untuk menyiapkan klaster komputasi terdistribusi tanpa perlu mengelola perangkat keras fisik. Platform ini sering menyediakan layanan terkelola seperti AWS EC2 (untuk daya komputasi) dan S3 (untuk penyimpanan terdistribusi), sehingga lebih mudah menyiapkan sistem yang dapat diskalakan.
- On-premises atau hibrida: Jika Anda menggunakan server sendiri atau kombinasi sumber daya on-premises dan cloud, Anda perlu menyiapkan jaringan, mengonfigurasi node, dan memastikan komunikasi antar node yang andal.
3. Menyiapkan sistem berkas terdistribusi (DFS)
Seperti yang telah kita bahas sebelumnya, salah satu elemen terpenting dalam komputasi terdistribusi adalah memastikan semua node memiliki akses ke data yang mereka butuhkan. HDFS milik Hadoop atau solusi DFS lainnya memungkinkan Anda menyimpan dataset besar di berbagai node, dengan redundansi untuk memastikan data tidak hilang jika sebuah node gagal.
4. Menyiapkan kerangka kerja atau alat
Setelah infrastruktur siap, Anda perlu menyiapkan alat yang Anda pilih untuk komputasi terdistribusi. Setiap kerangka kerja memiliki proses instalasi dan konfigurasi sendiri, tetapi ini mungkin melibatkan:
- Menginstal perangkat lunak yang diperlukan pada setiap node atau menggunakan solusi berbasis cloud yang secara otomatis menginstal dan mengonfigurasi alat untuk Anda.
- Mengonfigurasi pengaturan klaster, seperti berapa banyak node pekerja yang Anda inginkan, bagaimana sumber daya dialokasikan, dan bagaimana toleransi kesalahan ditangani.
5. Mendistribusikan tugas
Setelah lingkungan siap, Anda dapat mulai mendistribusikan tugas ke seluruh node. Sebagian besar alat akan membantu Anda mengelola proses ini dengan membagi beban kerja dan menugaskan tugas ke node yang berbeda.
Biasanya Anda perlu menulis kode yang menentukan bagaimana tugas harus dibagi (pekerjaan MapReduce untuk Hadoop, transformasi dan aksi untuk Spark, dll.) atau menggunakan API kerangka kerja untuk menangani distribusi dan komunikasi antar node.
6. Memantau dan mengelola klaster Anda
Sistem terdistribusi bisa menjadi kompleks, dan melacak kinerja, kegagalan, serta penggunaan sumber daya sangat penting untuk memastikan semuanya berjalan lancar. Banyak alat menyediakan dasbor bawaan untuk pemantauan, tetapi Anda mungkin juga memerlukan solusi pemantauan tambahan (seperti Prometheus atau Grafana) untuk memantau kesehatan node, kinerja, dan progres pekerjaan.
Alat dan Kerangka Kerja untuk Komputasi Terdistribusi
Seperti yang baru saja kita lihat, alat yang tepat dapat membantu Anda memulai komputasi terdistribusi dan menangani banyak pekerjaan berat saat mengelola lingkungan terdistribusi Anda. Mari lihat lebih dekat beberapa yang paling populer.
Apache Hadoop
Apache Hadoop adalah kerangka kerja open-source yang dirancang untuk memproses sejumlah besar data di seluruh klaster komputer terdistribusi. Hadoop menggunakan model pemrograman MapReduce, yang memecah tugas besar menjadi potongan-potongan kecil yang dapat diparalelkan.
Hadoop sangat berguna untuk menangani petabyte data, unggul dalam skalabilitas, toleransi kesalahan, dan fleksibilitas penyimpanan. Ekosistemnya mencakup berbagai komponen seperti Hadoop Distributed File System (HDFS) untuk penyimpanan terdistribusi dan alat untuk pemrosesan batch, itulah sebabnya Hadoop menjadi salah satu solusi andalan untuk banyak aplikasi big data.
Penyiapan infrastruktur itu sendiri bisa kompleks, karena tetap memerlukan konfigurasi node, pengelolaan sumber daya klaster, dan memastikan toleransi kesalahan.
Untuk mempelajari lebih lanjut tentang Hadoop, baca artikel tentang Pertanyaan Wawancara Hadoop. Ini berguna saat mempersiapkan wawancara dan juga penuh dengan fakta menarik tentang alat tersebut dan use case-nya.
Apache Spark
Apache Spark adalah mesin serbaguna dan cepat untuk pemrosesan data skala besar.
Karena berbasis pada Hadoop, Spark dapat berjalan di atas klaster Hadoop yang ada atau pada pengelola klasternya sendiri. Namun berbeda dengan Hadoop yang menggunakan penyimpanan berbasis disk, Spark menawarkan komputasi in-memory, dan dapat memproses data jauh lebih cepat.
Spark dapat digunakan untuk berbagai tugas pemrosesan, termasuk pemrosesan batch, streaming real-time, pembelajaran mesin, dan pemrosesan graf. Spark mendukung bahasa seperti Python, Scala, dan Java dan terintegrasi dengan platform cloud seperti AWS dan Azure.
Dask
Ingat saat kita membahas komputasi paralel? Nah, Dask adalah pustaka komputasi paralel di Python yang dirancang untuk menskalakan dari satu mesin hingga klaster terdistribusi besar.
Ini adalah pilihan ideal untuk menangani dataset besar dan tugas komputasi kompleks karena terintegrasi dengan pustaka Python lainnya seperti NumPy, Pandas, dan Scikit-learn serta menawarkan lingkungan yang familier bagi pengguna Python.
Kemampuannya untuk bekerja pada lingkungan terdistribusi maupun lokal berarti Anda dapat menggunakannya saat mengerjakan proyek kecil atau pipeline data yang sangat besar. Tetap diperlukan tingkat konfigurasi tertentu untuk komputasi terdistribusi, meskipun banyak yang diotomatisasi dibandingkan Hadoop dan Spark.
Kesimpulan
Semoga Anda menikmati mempelajari dasar-dasar komputasi terdistribusi! Namun, artikel ini hanyalah titik awal. Bidang komputasi terdistribusi memiliki banyak sekali alat, kerangka kerja, dan teknik yang bermunculan setiap tahun.
Jika Anda ingin mencoba membuat sistem terdistribusi, saya sarankan mendaftar ke penyedia cloud seperti AWS atau GCP. Keduanya memberikan kredit saat pendaftaran, sehingga Anda dapat mencoba infrastrukturnya dan menyiapkan proyek kecil secara gratis!
Jika Anda sudah nyaman dengan dasar-dasarnya dan ingin meningkatkan karier data Anda, Anda dapat mengambil salah satu dari banyak sertifikasi Apache Spark yang tersedia secara online.
Selamat ngoding!
FAQs
Apakah saya memerlukan perangkat keras khusus untuk komputasi terdistribusi?
Tidak selalu—Anda dapat menggunakan mesin biasa, tetapi tugas berkinerja tinggi mungkin mendapat manfaat dari perangkat keras yang dioptimalkan.
Apakah komputasi terdistribusi selalu lebih cepat?
Tidak selalu. Overhead dari koordinasi dan komunikasi terkadang dapat melebihi manfaatnya untuk tugas yang lebih kecil.
Seberapa banyak pengetahuan pemrograman yang dibutuhkan untuk menyiapkan sistem terdistribusi?
Meski alat dapat menyederhanakan proses, Anda tetap memerlukan pemahaman yang baik tentang dasar-dasar pemrograman, jaringan, dan desain sistem.

Penulis
Marie Fayard
Saya adalah tech lead berorientasi produk yang berspesialisasi dalam mengembangkan startup tahap awal dari prototipe pertama hingga mencapai product-market fit dan seterusnya. Saya sangat penasaran dengan cara orang menggunakan teknologi, dan saya senang bekerja erat dengan para founder serta tim lintas fungsi untuk mewujudkan ide-ide berani. Saat tidak membangun produk, saya mencari inspirasi di berbagai penjuru dunia atau melepas penat di studio yoga.




Jika Anda pernah bekerja pada sistem dengan komputasi kompleks atau kebutuhan analisis data yang tinggi, Anda mungkin melihat betapa mesin tunggal kesulitan untuk mengimbangi. Bahkan komputer yang kuat pun dapat mencapai batasnya saat memproses dataset yang sangat besar, terutama dalam area seperti analisis data real-time atau pembelajaran mesin.
Di sinilah komputasi terdistribusi berperan. Dengan membagi tugas ke banyak mesin, pendekatan ini memanfaatkan kekuatan gabungan untuk mengatasi tantangan yang terlalu berat bagi satu sistem. Ini memungkinkan kita, para engineer, untuk membuat beragam aplikasi, mulai dari mesin pencari yang mengindeks miliaran halaman web hingga simulasi perubahan iklim.
Dalam artikel ini, saya akan memperkenalkan Anda pada komputasi terdistribusi, menguraikan komponen dan arsitektur utamanya, menjelaskan cara menyiapkan sistem terdistribusi, serta meninjau beberapa alat yang tersedia untuk membantu.