
Điện toán phân tán là gì?
Trong điện toán phân tán, chúng ta sử dụng nhiều máy tính cùng phối hợp để giải quyết một vấn đề. Thay vì dựa vào một máy duy nhất, ta chia nhỏ công việc thành các phần nhỏ và giao cho một mạng lưới máy tính—gọi là “nút” (nodes). Các nút này cùng chia sẻ khối lượng xử lý và lưu trữ dữ liệu, phối hợp để hoàn thành nhiệm vụ.
Cách tiếp cận này hữu ích khi xử lý các bài toán hoặc bộ dữ liệu ở quy mô lớn, quá lớn hoặc quá phức tạp để một máy tính đơn lẻ đảm đương. Ví dụ, một hệ thống điện toán phân tán có thể xử lý petabyte dữ liệu cho công cụ tìm kiếm, chạy mô phỏng phục vụ nghiên cứu khoa học, hoặc vận hành các mô hình tài chính để phân tích thị trường.
Điện toán phân tán vs. Điện toán song song
Điện toán phân tán và điện toán song song thường bị nhầm lẫn và có vẻ có thể thay thế cho nhau. Cả hai đều gồm nhiều tiến trình làm việc hướng tới một mục tiêu chung, nhưng là những cách tiếp cận khác nhau, phục vụ các kịch bản khác nhau.
Điện toán phân tán tập trung vào việc dùng một mạng lưới các máy riêng biệt, thường phân tán theo địa lý, để giải quyết vấn đề một cách hợp tác. Mỗi máy hoạt động như một nút độc lập với bộ nhớ và năng lực xử lý riêng. Các nút giao tiếp qua mạng, và nhiệm vụ được chia nhỏ để chạy trên các máy khác nhau.
Điện toán song song, ngược lại, thường diễn ra trong một hệ thống đơn lẻ. Nó sử dụng nhiều bộ xử lý hoặc lõi trong cùng một máy tính để thực thi tác vụ đồng thời. Các bộ xử lý này dùng chung bộ nhớ và phối hợp chặt chẽ để phân chia phép tính.
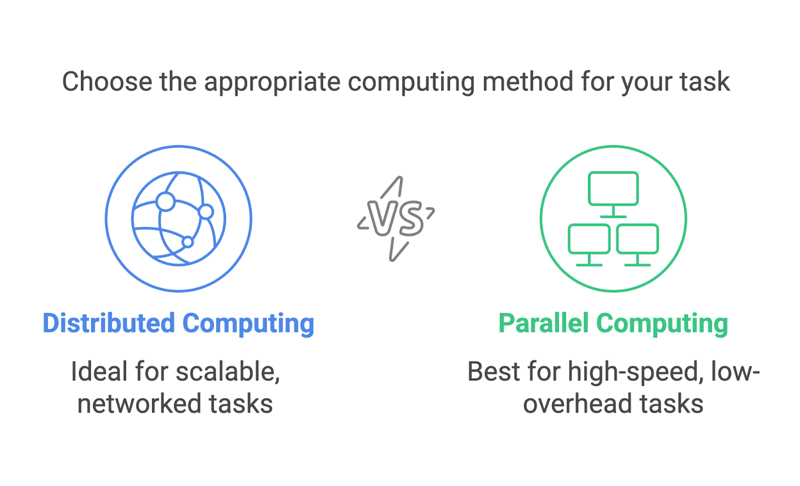
Hãy lấy ví dụ thực tế: ta cần sắp xếp một bộ dữ liệu khổng lồ. Trong điện toán song song, ta sẽ chia bộ dữ liệu thành các phần, và mỗi bộ xử lý trong cùng một máy sẽ xử lý một phần. Trong điện toán phân tán, bộ dữ liệu sẽ được chia và gửi tới các máy khác nhau, mỗi máy tự sắp xếp phần của mình. Sau đó ghép các phần đã sắp xếp lại với nhau.
Cả hai phương pháp đều rất hữu ích nhưng phù hợp với các tác vụ khác nhau. Điện toán song song lý tưởng cho những công việc cần tốc độ tính toán cao với chi phí giao tiếp tối thiểu, như chạy mô phỏng trên siêu máy tính. Điện toán phân tán phù hợp hơn khi cần mở rộng theo chiều ngang, như xử lý dữ liệu trong các hệ thống đám mây hoặc trên các mạng toàn cầu.
Các trường hợp sử dụng của điện toán phân tán
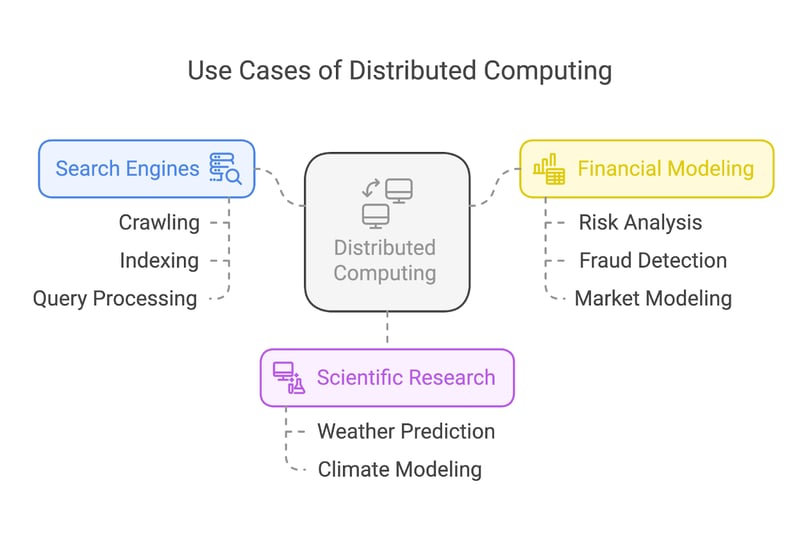
Điện toán phân tán là nền tảng cho nhiều ứng dụng có tác động lớn hiện nay. Hãy cùng xem ba trường hợp phổ biến: công cụ tìm kiếm, nghiên cứu khoa học và mô hình hóa tài chính.
Công cụ tìm kiếm
Các công cụ tìm kiếm như Google phụ thuộc rất nhiều vào điện toán phân tán để thu thập và lập chỉ mục hàng tỷ trang web. Thay vì giao việc cho một máy, các hệ thống này chia tải cho rất nhiều nút.
Một số nút tập trung thu thập trang web, số khác xử lý lập chỉ mục, và một nhóm nữa xử lý truy vấn người dùng theo thời gian thực. Sự phân công này giúp kết quả tìm kiếm nhanh và hiệu quả, bất kể quy mô công việc.
Nghiên cứu khoa học
Trong nghiên cứu khoa học, điện toán phân tán tạo điều kiện cho những đột phá nhờ chạy các mô phỏng phức tạp và phân tích bộ dữ liệu khổng lồ. Ví dụ, các nhà khoa học khí hậu dùng hệ thống phân tán để mô hình và dự đoán thời tiết hoặc mô phỏng tác động của hiện tượng ấm lên toàn cầu.
Mô hình hóa tài chính
Ngành tài chính dựa vào điện toán phân tán cho các tác vụ như phân tích rủi ro, phát hiện gian lận và mô hình hóa thị trường.
Việc xử lý khối dữ liệu khổng lồ do các thị trường tài chính toàn cầu tạo ra đòi hỏi những hệ thống có khả năng hoạt động liên tục và cực nhanh. Điện toán phân tán giúp các công ty tài chính phân tích dữ liệu, kiểm thử mô hình và rút ra thông tin chi tiết với tốc độ đủ để cạnh tranh trên thị trường thời gian thực.
Các thành phần chính của điện toán phân tán
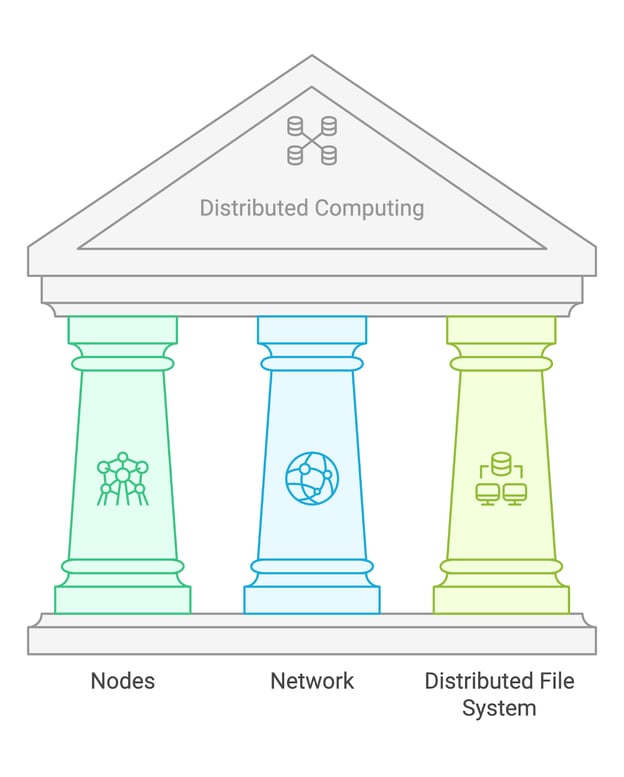
Điện toán phân tán dựa trên một số khối xây dựng cơ bản: các nút, mạng và hệ thống tệp phân tán (DFS).
Nút (Node)
Nút là các máy riêng lẻ thực hiện tính toán trong một hệ thống phân tán. Mỗi nút có thể hoạt động độc lập, xử lý nhiệm vụ được giao và giao tiếp với các nút khác để chia sẻ kết quả. Ở một số trường hợp, các nút có thể có vai trò chuyên biệt, như quản lý nhiệm vụ hoặc lưu trữ dữ liệu.
Mạng
Mạng là hạ tầng truyền thông kết nối các nút. Nó cho phép trao đổi dữ liệu và phối hợp công việc. Tùy quy mô hệ thống, có thể là mạng cục bộ (LAN) hoặc mạng diện rộng (WAN) cho các nút phân tán theo địa lý.
Hệ thống tệp phân tán (DFS)
Hệ thống tệp phân tán là giải pháp lưu trữ cho phép truy cập dữ liệu trên nhiều nút. Một ví dụ phổ biến là Hadoop Distributed File System (HDFS), được thiết kế để xử lý bộ dữ liệu lớn và cung cấp khả năng chịu lỗi bằng cách sao chép dữ liệu trên nhiều nút.
Các kiến trúc phổ biến của điện toán phân tán
Giả sử ta có khối công việc được phân phối tới các nút qua mạng, và tất cả các nút đều truy cập dữ liệu qua DFS. Nhưng ai quyết định nút nào làm việc gì?
Không có câu trả lời duy nhất, vì các hệ thống điện toán phân tán có thể được tổ chức theo nhiều cách. Tuy vậy, có ba kiến trúc phổ biến: master-slave, ngang hàng (peer-to-peer) và khách-chủ (client-server).
Master-slave
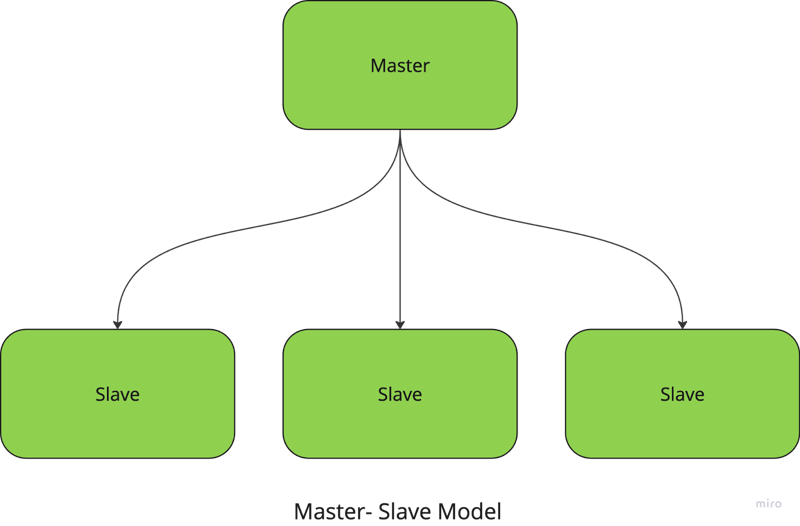
Trong mô hình master-slave, một nút trung tâm (nút chủ) quản lý và điều phối nhiệm vụ, còn các nút phụ thực hiện tính toán. Nút chủ chịu trách nhiệm chia nhỏ công việc, phân phối cho các nút phụ và thu thập kết quả.
Ví dụ, nếu bạn chạy một tác vụ xử lý ảnh quy mô lớn, nút chủ sẽ giao cho mỗi nút phụ một phần ảnh cụ thể để xử lý. Khi hoàn tất, nút chủ gom kết quả và kết hợp thành đầu ra cuối cùng.
Cách tiếp cận này đơn giản hóa việc quản lý và điều phối, nhưng có nhược điểm lớn: hệ thống có điểm lỗi đơn (single point of failure) vì phụ thuộc hoàn toàn vào nút chủ.
Ngang hàng (Peer-to-peer)
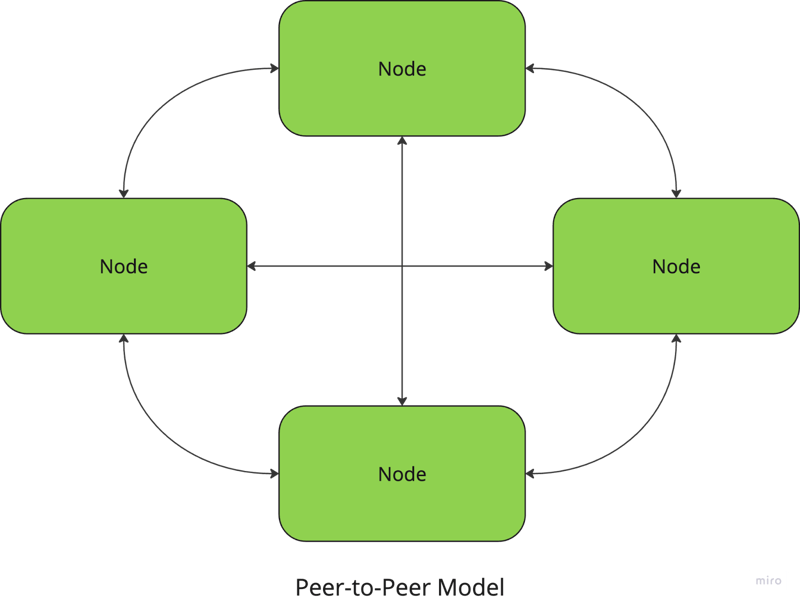
Trong kiến trúc ngang hàng, tất cả các nút bình đẳng và không có bộ điều phối trung tâm. Mỗi nút có thể vừa là khách vừa là chủ, chia sẻ tài nguyên và giao tiếp trực tiếp với các nút khác.
Ví dụ, các mạng chia sẻ tệp như BitTorrent sử dụng cách tiếp cận P2P, nơi người dùng tải xuống và tải lên các mảnh tệp trực tiếp từ và tới các máy ngang hàng khác.
Điểm cộng là hệ thống không có điểm lỗi trung tâm, giúp bền bỉ và có khả năng mở rộng, nhưng việc phối hợp giữa các nút (chẳng hạn để đảm bảo tính nhất quán dữ liệu) có thể phức tạp hơn.
Khách-chủ (Client-server)
Trong mô hình khách-chủ, một hoặc nhiều máy chủ cung cấp tài nguyên hay dịch vụ cho nhiều nút khách. Khách gửi yêu cầu tới máy chủ, máy chủ xử lý và trả về kết quả. Kiến trúc này thường dùng trong ứng dụng web và cơ sở dữ liệu.
Nghe có vẻ giống mô hình master-slave, với máy chủ đóng vai trò nút chủ, nhưng có khác biệt: máy chủ thường thụ động hơn và không chia tách hay ủy quyền nhiệm vụ—chỉ phản hồi yêu cầu của khách.
Với mô hình này, quản lý và kiểm soát tập trung giúp việc bảo trì và cập nhật hệ thống dễ dàng hơn, nhưng máy chủ cũng là nút thắt cổ chai có thể hạn chế khả năng mở rộng. Thời gian chết của máy chủ cũng có thể làm gián đoạn toàn bộ hệ thống.
Ba kiến trúc trên là những kiến trúc thường gặp trong hệ thống phân tán, nhưng còn nhiều mô hình khác mà bạn có thể đã biết (chắc chắn bạn đã nghe về kiến trúc dựa trên đám mây!).
Mỗi mô hình đáp ứng các nhu cầu khác nhau, và lựa chọn kiến trúc có thể tác động lớn tới hiệu năng, khả năng chịu lỗi và khả năng mở rộng của hệ thống, nên điều quan trọng là bạn phải xác định rõ bài toán trước khi quyết định cách tiếp cận. Tin tốt là bạn không nhất thiết phải chọn chỉ một! Hầu hết các hệ thống hiện đại, đặc biệt trong điện toán đám mây, dùng phiên bản lai của các kiến trúc này để kết hợp ưu điểm của chúng.
Thiết lập hệ thống điện toán phân tán
Sau khi đã nắm lý thuyết, hãy xem cách thiết lập một hệ thống điện toán phân tán trong thực tế.
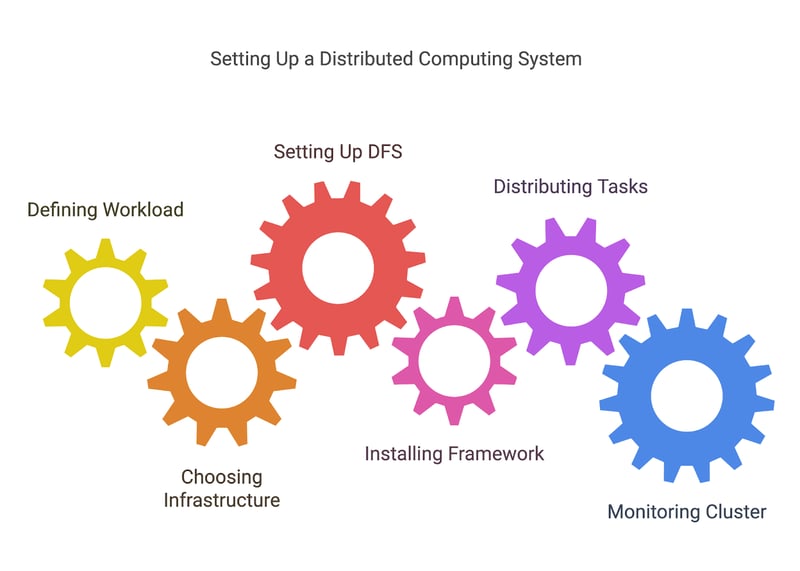
1. Xác định khối công việc
Trước khi có thể phân phối nhiệm vụ, bạn cần xác định chính xác mình sẽ phân phối những gì. Thường là chia nhỏ một vấn đề lớn thành các đơn vị công việc độc lập có thể xử lý song song hoặc phân tán qua các nút.
Ví dụ, nếu bạn xử lý một bộ dữ liệu lớn, bạn có thể chia dữ liệu thành các phần để các máy hoặc bộ xử lý khác nhau đảm nhận.
2. Lựa chọn hạ tầng
Điện toán phân tán cần một mạng lưới máy tính, dù là máy chủ tại chỗ (on-premises), máy trên đám mây (như AWS, Azure hoặc Google Cloud), hay kết hợp cả hai. Bạn sẽ cần quyết định cách thiết lập và cấu hình các máy, đảm bảo chúng được kết nối và có thể giao tiếp với nhau.
- Hạ tầng dựa trên đám mây: Các nền tảng như AWS, Google Cloud và Azure giúp bạn dễ dàng khởi tạo các cụm điện toán phân tán mà không cần quản lý phần cứng vật lý. Chúng thường cung cấp các dịch vụ được quản lý như AWS EC2 (cho năng lực tính toán) và S3 (cho lưu trữ phân tán), giúp thiết lập hệ thống có khả năng mở rộng dễ dàng hơn.
- Tại chỗ hoặc lai (hybrid): Nếu bạn dùng máy chủ riêng hoặc kết hợp tài nguyên tại chỗ và đám mây, bạn cần thiết lập mạng, cấu hình các nút và đảm bảo giao tiếp đáng tin cậy giữa chúng.
3. Thiết lập hệ thống tệp phân tán (DFS)
Như đã đề cập, một trong những yếu tố quan trọng nhất của điện toán phân tán là đảm bảo mọi nút đều truy cập được dữ liệu cần thiết. HDFS của Hadoop hoặc các giải pháp DFS khác cho phép lưu trữ bộ dữ liệu lớn trên nhiều nút, với tính dư thừa để tránh mất dữ liệu nếu một nút gặp sự cố.
4. Thiết lập khung công cụ
Khi hạ tầng đã sẵn sàng, bạn cần thiết lập công cụ được chọn cho điện toán phân tán. Mỗi framework có quy trình cài đặt và cấu hình riêng, thường bao gồm:
- Cài đặt phần mềm cần thiết trên mỗi nút hoặc dùng giải pháp đám mây tự động cài đặt và cấu hình giúp bạn.
- Cấu hình các thiết lập cụm, như số lượng nút công nhân (worker), cách phân bổ tài nguyên và cơ chế chịu lỗi.
5. Phân phối nhiệm vụ
Khi môi trường đã sẵn sàng, bạn có thể bắt đầu phân phối nhiệm vụ cho các nút. Phần lớn công cụ sẽ hỗ trợ quản lý quá trình này bằng cách chia khối công việc và gán nhiệm vụ cho các nút khác nhau.
Thường bạn sẽ cần viết mã xác định cách chia nhiệm vụ (công việc MapReduce cho Hadoop, transformations và actions cho Spark, v.v.) hoặc dùng API của framework để xử lý việc phân phối và giao tiếp giữa các nút.
6. Giám sát và quản lý cụm
Hệ thống phân tán có thể trở nên phức tạp, nên việc theo dõi hiệu năng, lỗi và sử dụng tài nguyên là tối quan trọng để mọi thứ vận hành trơn tru. Nhiều công cụ cung cấp bảng điều khiển tích hợp để giám sát, nhưng bạn cũng có thể cần các giải pháp bổ sung (như Prometheus hoặc Grafana) để theo dõi tình trạng nút, hiệu năng và tiến độ công việc.
Công cụ và framework cho điện toán phân tán
Như vừa thấy, công cụ phù hợp có thể giúp bạn bắt đầu với điện toán phân tán và gánh vác phần lớn việc quản lý môi trường phân tán. Hãy cùng xem kỹ hơn một số công cụ phổ biến nhất.
Apache Hadoop
Apache Hadoop là một framework mã nguồn mở được thiết kế để xử lý lượng dữ liệu khổng lồ trên một cụm máy tính phân tán. Nó sử dụng mô hình lập trình MapReduce, chia các tác vụ lớn thành những phần nhỏ có thể xử lý song song.
Hadoop đặc biệt hữu ích khi xử lý dữ liệu ở quy mô petabyte, nổi bật về khả năng mở rộng, chịu lỗi và linh hoạt trong lưu trữ. Hệ sinh thái của nó gồm nhiều thành phần như Hadoop Distributed File System (HDFS) cho lưu trữ phân tán và các công cụ xử lý theo lô, nên được xem là lựa chọn hàng đầu cho nhiều ứng dụng dữ liệu lớn.
Việc thiết lập hạ tầng tự thân có thể phức tạp, vì vẫn cần cấu hình các nút, quản lý tài nguyên cụm và đảm bảo khả năng chịu lỗi.
Để tìm hiểu thêm về Hadoop, hãy đọc bài viết về Các câu hỏi phỏng vấn Hadoop. Bài này hữu ích khi chuẩn bị phỏng vấn và cũng chứa nhiều thông tin thú vị về công cụ và các trường hợp sử dụng.
Apache Spark
Apache Spark là một động cơ xử lý dữ liệu quy mô lớn nhanh và đa năng.
Vì dựa trên Hadoop, Spark có thể chạy trên các cụm Hadoop hiện có hoặc trên bộ quản lý cụm riêng. Nhưng khác với Hadoop dùng lưu trữ trên đĩa, Spark cung cấp tính toán trong bộ nhớ, nên có thể xử lý dữ liệu nhanh hơn đáng kể.
Spark dùng được cho nhiều tác vụ xử lý, gồm xử lý theo lô, streaming thời gian thực, học máy và xử lý đồ thị. Nó hỗ trợ các ngôn ngữ như Python, Scala và Java và tích hợp với các nền tảng đám mây như AWS và Azure.
Dask
Bạn còn nhớ khi chúng ta nói về điện toán song song chứ? Dask là một thư viện điện toán song song trong Python được thiết kế để mở rộng từ một máy đơn tới các cụm phân tán lớn.
Đây là lựa chọn lý tưởng để xử lý bộ dữ liệu lớn và các tác vụ tính toán phức tạp vì nó tích hợp với những thư viện Python khác như NumPy, Pandas và Scikit-learn, đồng thời mang lại môi trường quen thuộc cho người dùng Python.
Khả năng hoạt động cả ở môi trường phân tán lẫn cục bộ giúp bạn dùng nó cho dự án nhỏ hoặc pipeline dữ liệu khổng lồ. Tuy vẫn cần một mức cấu hình nhất định cho điện toán phân tán, nhưng nhiều phần đã tự động hóa hơn so với Hadoop và Spark.
Kết luận
Hy vọng bạn thích phần giới thiệu cơ bản về điện toán phân tán! Tuy nhiên, đây chỉ là điểm khởi đầu. Lĩnh vực này có vô số công cụ, framework và kỹ thuật mới ra đời mỗi năm.
Nếu bạn muốn tự thử xây dựng hệ thống phân tán, tôi khuyên bạn đăng ký một nhà cung cấp đám mây như AWS hoặc GCP. Cả hai đều tặng tín dụng khi đăng ký, nên bạn có thể thử hạ tầng của họ và thiết lập các dự án nhỏ miễn phí!
Nếu bạn đã nắm vững kiến thức cơ bản và muốn thúc đẩy sự nghiệp dữ liệu, bạn có thể tham gia một trong nhiều chứng chỉ Apache Spark có sẵn trực tuyến.
Chúc bạn mã hóa vui vẻ!
FAQs
Tôi có cần phần cứng chuyên dụng cho điện toán phân tán không?
Không nhất thiết—bạn có thể dùng các máy thông thường, nhưng các tác vụ hiệu năng cao có thể hưởng lợi từ phần cứng tối ưu hóa.
Điện toán phân tán có luôn nhanh hơn không?
Không phải lúc nào cũng vậy. Chi phí do phối hợp và giao tiếp đôi khi có thể lớn hơn lợi ích đối với các tác vụ nhỏ.
Cần kiến thức lập trình ở mức nào để thiết lập hệ thống phân tán?
Dù các công cụ giúp đơn giản hóa, bạn vẫn cần hiểu tốt về lập trình, mạng và các nguyên lý thiết kế hệ thống cơ bản.

Tác giả
Marie Fayard
Tôi là một trưởng nhóm kỹ thuật định hướng sản phẩm, chuyên giúp các startup giai đoạn đầu phát triển từ nguyên mẫu đầu tiên đến khi đạt được sự phù hợp sản phẩm - thị trường và xa hơn nữa. Tôi luôn tò mò về cách con người sử dụng công nghệ, và tôi thích làm việc sát sao với nhà sáng lập và các nhóm liên chức năng để biến những ý tưởng táo bạo thành hiện thực. Khi không xây dựng sản phẩm, tôi tìm cảm hứng ở những miền đất mới hoặc xả căng thẳng tại phòng tập yoga.


Nếu bạn từng làm việc với những hệ thống có tính toán phức tạp hoặc nhu cầu phân tích dữ liệu cao, hẳn bạn đã thấy các máy đơn lẻ khó lòng theo kịp. Ngay cả những máy tính mạnh cũng có thể chạm ngưỡng khi xử lý các bộ dữ liệu khổng lồ, đặc biệt trong các lĩnh vực như phân tích dữ liệu thời gian thực hoặc học máy.
Đó là lúc điện toán phân tán phát huy tác dụng. Bằng cách chia nhỏ công việc cho nhiều máy, nó tận dụng sức mạnh tổng hợp để vượt qua những thách thức mà một hệ thống đơn lẻ khó xử lý. Nhờ đó, chúng ta—các kỹ sư—có thể tạo ra nhiều ứng dụng đa dạng, từ công cụ tìm kiếm lập chỉ mục hàng tỷ trang web đến mô phỏng biến đổi khí hậu.
Trong bài viết này, tôi sẽ giới thiệu về điện toán phân tán, phân tích các thành phần và kiến trúc chính, giải thích cách thiết lập một hệ thống phân tán, và điểm qua một số công cụ hỗ trợ hữu ích.