
Wat is distributed computing?
Bij distributed computing gebruiken we meerdere computers die samenwerken aan één probleem. In plaats van te vertrouwen op één machine verdelen we taken in kleinere brokken en wijzen die toe aan een netwerk van computers, de zogeheten “nodes”. Deze nodes delen de verwerkingslast en dataopslag en werken samen om taken te voltooien.
Deze aanpak is nuttig bij grootschalige problemen of datasets die te groot of te complex zijn voor één computer. Zo kan een distributed computing-systeem petabytes aan data verwerken voor zoekmachines, simulaties draaien voor wetenschappelijk onderzoek of financiële modellen aansturen voor marktanalyses.
Distributed computing vs. parallel computing
Distributed computing en parallel computing worden vaak verward en lijken soms inwisselbaar. Beide omvatten meerdere processen die naar één doel toewerken, maar het zijn verschillende benaderingen voor verschillende situaties.
Distributed computing gebruikt een netwerk van afzonderlijke machines, vaak geografisch verspreid, om samen problemen op te lossen. Elke machine werkt als een zelfstandige node met eigen geheugen en rekenkracht. De communicatie tussen nodes verloopt via een netwerk, en taken worden zo verdeeld dat ze op verschillende machines kunnen draaien.
Parallel computing daarentegen vindt doorgaans plaats binnen één systeem. Het gebruikt meerdere processors of cores in één computer om taken gelijktijdig uit te voeren. Deze processors delen hetzelfde geheugen en werken vaak nauw samen om berekeningen op te splitsen.
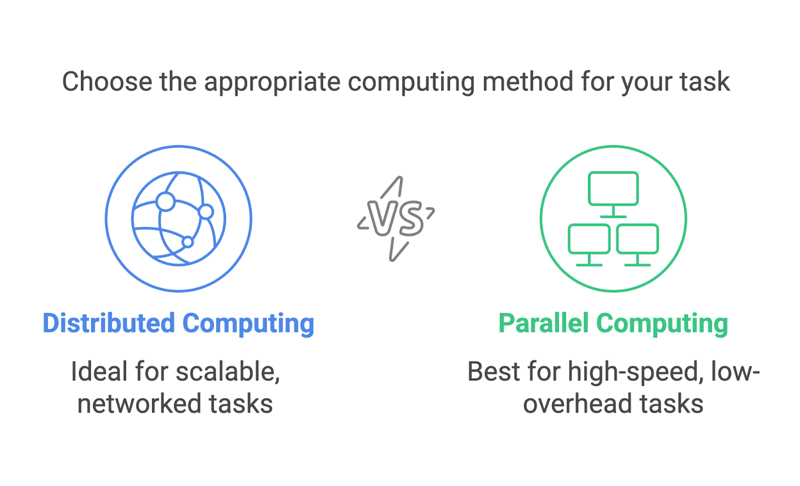
Neem een praktisch voorbeeld: we sorteren een enorme dataset. Bij parallel computing splitsen we de dataset in stukken en elke processor in dezelfde machine verwerkt een stuk. Bij distributed computing wordt de dataset opgesplitst en naar verschillende machines gestuurd, die elk hun deel onafhankelijk sorteren. De gesorteerde delen worden daarna samengevoegd.
Beide methoden zijn ontzettend nuttig, maar voor andere taken geschikt. Parallel computing is ideaal voor taken die hoge rekensnelheid met minimale communicatie-overhead vereisen, zoals simulaties op een supercomputer. Distributed computing is beter wanneer je wilt opschalen, zoals bij dataverwerking in cloudsystemen of over wereldwijde netwerken.
Use-cases van distributed computing
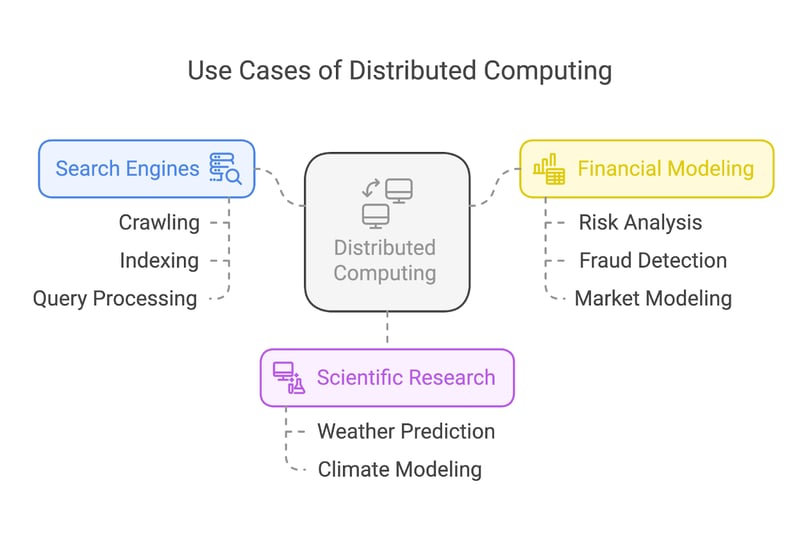
Distributed computing drijft enkele van de meest impactvolle toepassingen van vandaag. Laten we drie veelvoorkomende use-cases bekijken: zoekmachines, wetenschappelijk onderzoek en financiële modellering.
Zoekmachines
Zoekmachines zoals Google leunen zwaar op distributed computing om miljarden webpagina’s te crawlen en te indexeren. In plaats van de taak aan één machine toe te wijzen, verdelen deze systemen de werklast over heel veel nodes.
Sommige nodes richten zich op het crawlen van webpagina’s, andere op indexeren, en weer andere verwerken gebruikersvragen in realtime. Deze taakverdeling zorgt voor snelle en efficiënte zoekresultaten, ongeacht de schaal.
Wetenschappelijk onderzoek
In wetenschappelijk onderzoek maakt distributed computing doorbraken mogelijk door complexe simulaties te draaien en enorme datasets te analyseren. Klimaatwetenschappers gebruiken bijvoorbeeld distributed systemen om weerpatronen te modelleren en de effecten van opwarming van de aarde te simuleren.
Financiële modellering
De financiële sector vertrouwt op distributed computing voor taken als risicoanalyse, fraudedetectie en marktmodellering.
Het verwerken van de enorme datasets die door mondiale financiële markten worden gegenereerd, vraagt systemen die continu en razendsnel kunnen werken. Distributed computing stelt financiële instellingen in staat data te analyseren, modellen te testen en inzichten te genereren met snelheden die ze concurrerend houden in realtime markten.
Belangrijkste componenten van distributed computing
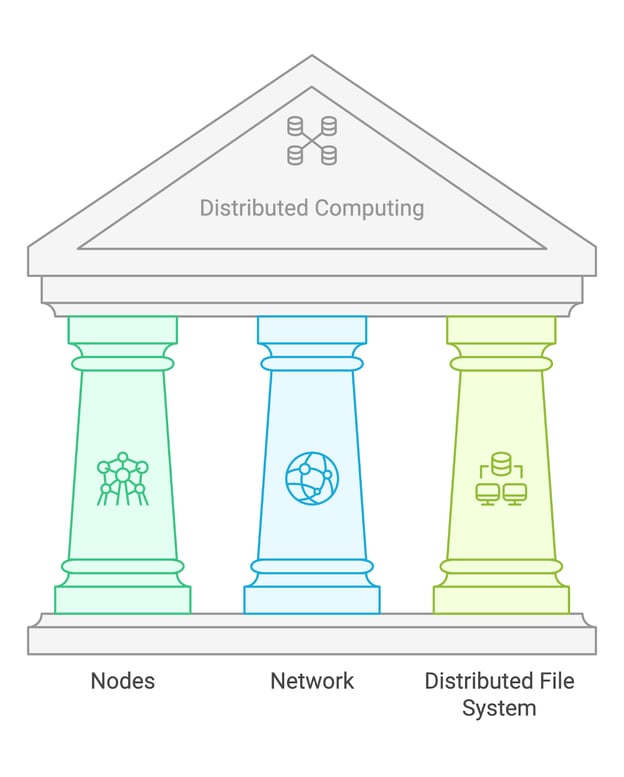
Distributed computing steunt op enkele fundamentele bouwstenen: nodes, een netwerk en een distributed file system (DFS).
Nodes
Nodes zijn de individuele machines die berekeningen uitvoeren binnen een distributed systeem. Elke node kan zelfstandig opereren, toegewezen taken verwerken en met andere nodes communiceren om resultaten te delen. In sommige gevallen hebben nodes gespecialiseerde rollen, zoals taakbeheer of dataopslag.
Netwerk
Het netwerk is de communicatie-infrastructuur die de verschillende nodes verbindt. Het maakt gegevensuitwisseling en taakcoördinatie mogelijk. Afhankelijk van de systeemgrootte kan dit gaan om lokale netwerken (LAN’s) of wide area networks (WAN’s) voor geografisch verspreide nodes.
Distributed file system (DFS)
Een distributed file system is een opslagoplossing waarmee data over meerdere nodes toegankelijk is. Een bekend voorbeeld is het Hadoop Distributed File System (HDFS), ontworpen voor grote datasets en met fouttolerantie door data te repliceren over meerdere nodes.
Veelvoorkomende architecturen van distributed computing
Oké, we hebben een werklast die via een netwerk over verschillende nodes is verdeeld, en alle nodes hebben toegang tot de data via een DFS. Maar wie bepaalt welke node wat doet?
Daar is geen eenduidig antwoord op, want distributed computing-systemen kunnen op verschillende manieren worden georganiseerd. Toch zijn er drie gangbare architecturen: master-slave, peer-to-peer en client-server.
Master-slave
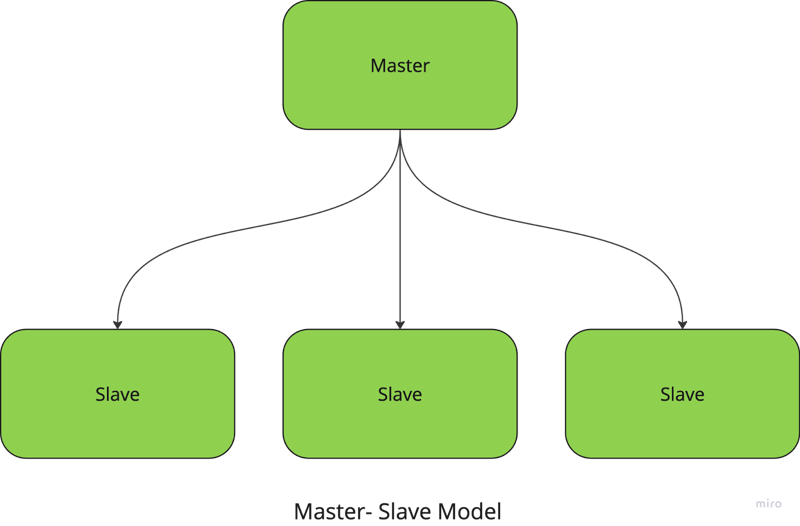
In het master-slave-model beheert en coördineert één centrale node (de masternode) de taken, terwijl de slavenodes de daadwerkelijke berekeningen uitvoeren. De master is verantwoordelijk voor het opdelen van taken in kleinere brokken, het verdelen onder de slaves en het verzamelen van de resultaten.
Voer je bijvoorbeeld een grootschalige beeldverwerkingstaak uit, dan wijst de masternode elke slavenode een specifiek deel van de afbeeldingen toe. Zodra de taken klaar zijn, verzamelt de master de resultaten en voegt ze samen tot de einduitvoer.
Deze aanpak vereenvoudigt taakbeheer en coördinatie, maar heeft een groot nadeel: het systeem kent één enkel storingspunt, omdat het volledig afhankelijk is van de masternode.
Peer-to-peer
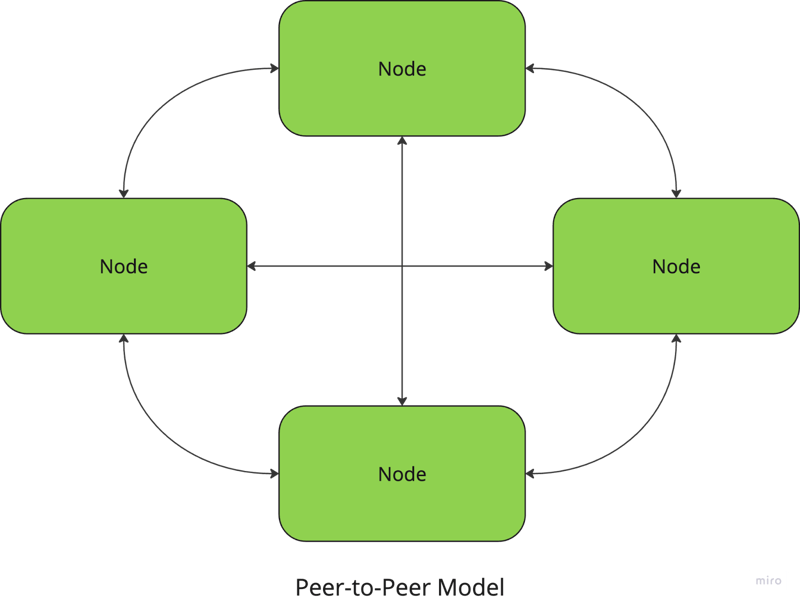
In een peer-to-peer-architectuur zijn alle nodes gelijk en is er geen centrale coördinator. Elke node kan zowel als client als server fungeren, resources delen en direct met andere nodes communiceren.
Bestandendeelnetwerken zoals BitTorrent gebruiken bijvoorbeeld een P2P-aanpak, waarbij gebruikers stukjes bestanden direct bij en naar andere peers downloaden en uploaden.
Voordeel is dat er geen centraal storingspunt is, waardoor deze systemen veerkrachtig en schaalbaar zijn, maar de coördinatie tussen nodes (bijvoorbeeld om dataconsistentie te waarborgen) kan complexer zijn.
Client-server
In het client-servermodel leveren één of meer servers resources of diensten aan meerdere clientnodes. Clients sturen verzoeken naar de server, die ze verwerkt en de resultaten terugstuurt. Deze architectuur wordt veel gebruikt in webapplicaties en databases.
Dat klinkt misschien vergelijkbaar met het master-slave-model, waarbij de server de rol van master speelt, maar er is een verschil: de server is doorgaans passiever en splitst of delegeert geen taken—hij reageert alleen op clientverzoeken.
Met dit model maken gecentraliseerd beheer en controle het eenvoudiger om het systeem te onderhouden en te updaten, maar de server is een knelpunt dat de schaalbaarheid kan beperken. Serveruitval kan ook het hele systeem verstoren.
Deze drie architecturen zijn veelvoorkomend in distributed systemen, maar er zijn ook andere modellen die je wellicht kent (ik durf te wedden dat je weleens van cloudgebaseerde architectuur hebt gehoord!).
Elk model dient andere behoeften, en de keuze van architectuur heeft grote impact op prestaties, fouttolerantie en schaalbaarheid. Het is dus belangrijk om het probleem dat je oplost goed in kaart te brengen voordat je een aanpak kiest. Het goede nieuws: je hoeft niet één model te kiezen! De meeste moderne systemen, zeker in de cloud, gebruiken een hybride van deze architecturen om hun sterke punten te combineren.
Distributed computing-systemen opzetten
Nu we de theorie achter distributed computing hebben behandeld, kijken we hoe je zo’n systeem in de praktijk opzet.
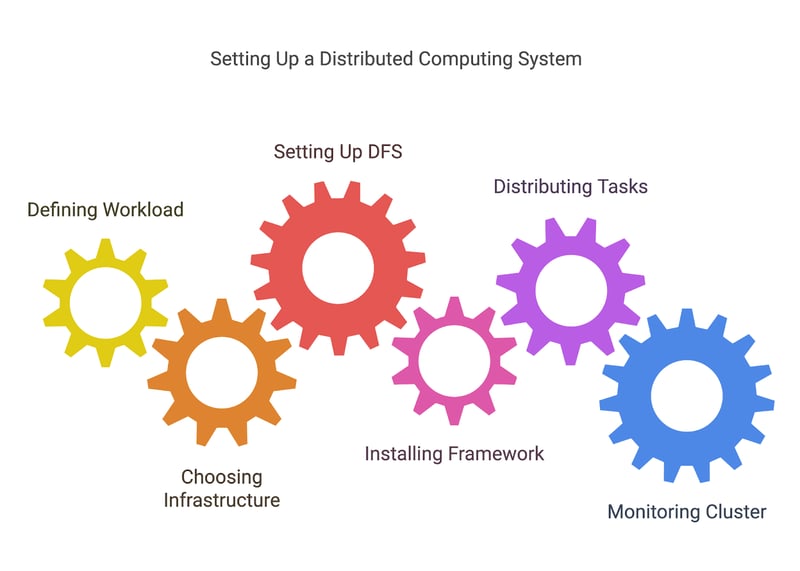
1. Je werklast definiëren
Voor je taken kunt verdelen, moet je bepalen welke taken je verdeelt. Vaak betekent dit dat je een groter probleem opbreekt in kleinere, onafhankelijke werkeenheden die parallel of over nodes verdeeld verwerkt kunnen worden.
Verwerk je bijvoorbeeld een grote dataset, dan kun je de data opdelen in stukken die door verschillende machines of processors verwerkt kunnen worden.
2. Je infrastructuur kiezen
Distributed computing vereist een netwerk van machines, of dat nu on-premises servers zijn, cloud-instanties (zoals AWS, Azure of Google Cloud) of een mix van beide. Je moet bepalen hoe je deze machines inricht en configureert en zorgen dat ze verbonden zijn en met elkaar kunnen communiceren.
- Cloudgebaseerde infrastructuur: platforms als AWS, Google Cloud en Azure maken het eenvoudiger om distributed computing-clusters te starten zonder fysiek hardwarebeheer. Deze platforms bieden vaak managed services zoals AWS EC2 (voor rekenkracht) en S3 (voor distributed opslag), wat het opzetten van schaalbare systemen vereenvoudigt.
- On-premises of hybride: gebruik je eigen servers of een mix van on-premises en cloudresources, dan moet je je netwerk inrichten, de nodes configureren en zorgen voor betrouwbare communicatie.
3. Een distributed file system (DFS) inrichten
Zoals eerder besproken is het cruciaal dat alle nodes toegang hebben tot de data die ze nodig hebben. Hadoop’s HDFS of andere DFS-oplossingen laten je grote datasets over meerdere nodes opslaan, met redundantie zodat data niet verloren gaat als een node uitvalt.
4. Het framework of de tool instellen
Als je infrastructuur staat, moet je de tool voor distributed computing inrichten. Elk framework heeft zijn eigen installatie- en configuratieproces, maar dit kan inhouden:
- De vereiste software op elke node installeren of een cloudoplossing gebruiken die de tool automatisch installeert en configureert.
- Je clusterinstellingen configureren, zoals het aantal workernodes, hoe resources worden toegewezen en hoe fouttolerantie wordt afgehandeld.
5. Taken verdelen
Zodra je omgeving klaar is, kun je taken over je nodes verdelen. De meeste tools helpen hierbij door je werklast op te splitsen en taken aan verschillende nodes toe te wijzen.
Meestal schrijf je code die definieert hoe taken gesplitst moeten worden (MapReduce-jobs voor Hadoop, transformaties en acties voor Spark, enz.) of gebruik je de API’s van het framework om distributie en communicatie tussen nodes te regelen.
6. Je cluster monitoren en beheren
Distributed systemen kunnen complex worden, en inzicht in performance, storingen en resourcegebruik is cruciaal om alles soepel te laten draaien. Veel tools bieden ingebouwde dashboards voor monitoring, maar je kunt ook extra oplossingen nodig hebben (zoals Prometheus of Grafana) om de gezondheid van nodes, prestaties en voortgang van jobs bij te houden.
Tools en frameworks voor distributed computing
Zoals we net zagen, kan de juiste tool je helpen om met distributed computing aan de slag te gaan en veel van het zware werk in het beheer van je distributed omgevingen uit handen nemen. Laten we enkele van de populairste opties bekijken.
Apache Hadoop
Apache Hadoop is een open-sourceframework dat is ontworpen om enorme hoeveelheden data te verwerken over een distributed cluster van computers. Het gebruikt het MapReduce-programmeermodel, dat grote taken opdeelt in kleinere, parallelle brokken.
Hadoop is vooral handig voor het verwerken van petabytes aan data en blinkt uit in schaalbaarheid, fouttolerantie en flexibiliteit in opslag. Het ecosysteem omvat verschillende componenten zoals het Hadoop Distributed File System (HDFS) voor distributed opslag en tools voor batchverwerking, waardoor het een van de favoriete oplossingen is voor veel bigdata-toepassingen.
Het inrichten van de infrastructuur kan complex zijn, omdat je nog steeds nodes moet configureren, clusterresources beheren en fouttolerantie borgen.
Wil je meer leren over Hadoop, lees dan dit artikel met Hadoop-vragen voor sollicitaties. Handig ter voorbereiding op een gesprek en boordevol interessante feiten over de tool en de use-cases.
Apache Spark
Apache Spark is een snelle, algemene engine voor grootschalige dataverwerking.
Omdat het op Hadoop is gebaseerd, kan Spark boven op bestaande Hadoop-clusters draaien of op zijn eigen clustermanager. In tegenstelling tot Hadoop, dat schijfgebaseerde opslag gebruikt, biedt Spark in-memory verwerking en kan het data aanzienlijk sneller verwerken.
Het is inzetbaar voor uiteenlopende verwerkingstaken, waaronder batchverwerking, realtime streaming, machine learning en graafverwerking. Het ondersteunt talen zoals Python, Scala en Java en integreert met cloudplatforms zoals AWS en Azure.
Dask
Weet je nog dat we het over parallel computing hadden? Dask is een parallel computing-bibliotheek in Python die is ontworpen om te schalen van één machine naar grote distributed clusters.
Het is een ideale keuze voor het verwerken van grote datasets en complexe rekentaken, omdat het integreert met andere Python-bibliotheken zoals NumPy, Pandas en Scikit-learn en een vertrouwde omgeving biedt voor Python-gebruikers.
Doordat het zowel met distributed als lokale omgevingen kan werken, kun je het inzetten voor kleine projecten of enorme datapijplijnen. Voor distributed computing is nog wel enige configuratie nodig, al is veel hiervan geautomatiseerd vergeleken met Hadoop en Spark.
Conclusie
Ik hoop dat je het leuk vond om de basis van distributed computing te leren kennen! Dit artikel is echter slechts een begin. Het veld van distributed computing kent elk jaar talloze nieuwe tools, frameworks en technieken.
Wil je zelf distributed systemen bouwen, dan raad ik aan je aan te melden bij een cloudprovider zoals AWS of GCP. Beide geven tegoed bij aanmelding, zodat je hun infrastructuur kunt uitproberen en gratis kleine projecten kunt opzetten!
Ben je al vertrouwd met de basis en wil je je datacarrière een boost geven, bekijk dan een van de vele Apache Spark-certificeringen die online beschikbaar zijn.
Happy coding!
FAQs
Heb ik speciale hardware nodig voor distributed computing?
Niet per se—je kunt gewone machines gebruiken, maar voor high-performance taken kan geoptimaliseerde hardware voordeel bieden.
Is distributed computing altijd sneller?
Niet altijd. De overhead van coördinatie en communicatie kan bij kleinere taken zwaarder wegen dan de voordelen.
Hoeveel programmeerkennis heb je nodig om een distributed systeem op te zetten?
Tools maken het eenvoudiger, maar je hebt wel een goede basis nodig in programmeren, netwerken en systeemontwerp.

Auteur
Marie Fayard
Ik ben een productgerichte tech lead die gespecialiseerd is in het laten groeien van startups in een vroeg stadium, van het eerste prototype tot product‑market fit en verder. Ik ben eindeloos nieuwsgierig naar hoe mensen technologie gebruiken, en ik werk graag nauw samen met oprichters en multidisciplinaire teams om gedurfde ideeën tot leven te brengen. Als ik geen producten bouw, zoek ik inspiratie in nieuwe uithoeken van de wereld of ontspan ik me in de yogastudio.


Als je ooit hebt gewerkt met systemen die complexe berekeningen of hoge eisen aan data-analyse stellen, heb je vast gezien hoe moeilijk losse machines het kunnen krijgen om bij te blijven. Zelfs krachtige computers lopen tegen hun grenzen aan bij het verwerken van enorme datasets, vooral bij zaken als realtime data-analyse of machine learning.
Daar komt distributed computing om de hoek kijken. Door taken over meerdere machines te verdelen, benut je hun gecombineerde kracht om uitdagingen aan te gaan die voor één systeem te zwaar zouden zijn. Zo kunnen wij, als engineers, een breed scala aan applicaties bouwen, van zoekmachines die miljarden webpagina’s indexeren tot simulaties van klimaatverandering.
In dit artikel maak ik je wegwijs in distributed computing, bespreek ik de belangrijkste componenten en architecturen, leg ik uit hoe je een distributed systeem opzet en verken ik enkele hulpmiddelen die je daarbij kunnen helpen.