
डिस्ट्रीब्यूटेड कम्प्यूटिंग क्या है?
डिस्ट्रीब्यूटेड कम्प्यूटिंग में हम किसी एक समस्या पर साथ मिलकर काम करने के लिए कई कंप्यूटरों का उपयोग करते हैं। एक ही मशीन पर निर्भर होने के बजाय, हम कार्यों को छोटे भागों में बाँटते हैं और उन्हें कंप्यूटरों के नेटवर्क—जिन्हें हम “नोड्स” कहते हैं—को सौंपते हैं। ये नोड्स प्रोसेसिंग वर्कलोड और डेटा स्टोरेज साझा करते हुए सहयोगात्मक रूप से कार्य पूरे करते हैं।
यह तरीका तब उपयोगी होता है जब बहुत बड़े या जटिल समस्याओं/डेटासेट्स से निपटना हो, जिन्हें एकल कंप्यूटर संभाल नहीं सकता। उदाहरण के लिए, डिस्ट्रीब्यूटेड कम्प्यूटिंग सिस्टम सर्च इंजनों के लिए पेटाबाइट्स डेटा प्रोसेस कर सकता है, वैज्ञानिक अनुसंधान के लिए सिमुलेशन चला सकता है, या बाज़ार विश्लेषण के लिए वित्तीय मॉडल्स को शक्ति दे सकता है।
डिस्ट्रीब्यूटेड कम्प्यूटिंग बनाम पैरेलल कम्प्यूटिंग
डिस्ट्रीब्यूटेड और पैरेलल कम्प्यूटिंग को अक्सर एक जैसा समझ लिया जाता है। दोनों में कई प्रॉसेसेज़ एक लक्ष्य की ओर काम करते हैं, लेकिन ये अलग-अलग परिदृश्यों के लिए बनाए गए भिन्न दृष्टिकोण हैं।
डिस्ट्रीब्यूटेड कम्प्यूटिंग में अलग-अलग मशीनों का नेटवर्क—अक्सर भौगोलिक रूप से बिखरा हुआ—साझा रूप से समस्याएँ हल करता है। प्रत्येक मशीन अपने स्वयं के मेमोरी और प्रोसेसिंग पावर के साथ एक स्वतंत्र नोड की तरह काम करती है। नोड्स के बीच संचार नेटवर्क पर होता है, और कार्य इस तरह विभाजित किए जाते हैं कि वे अलग-अलग मशीनों पर चल सकें।
दूसरी ओर, पैरेलल कम्प्यूटिंग आमतौर पर एक ही सिस्टम के भीतर होती है। इसमें एक कंप्यूटर के कई प्रोसेसर या कोर एक साथ कार्यों को निष्पादित करते हैं। ये प्रोसेसर एक ही मेमोरी साझा करते हैं और गणनाओं को बाँटकर नज़दीकी समन्वय में काम करते हैं।
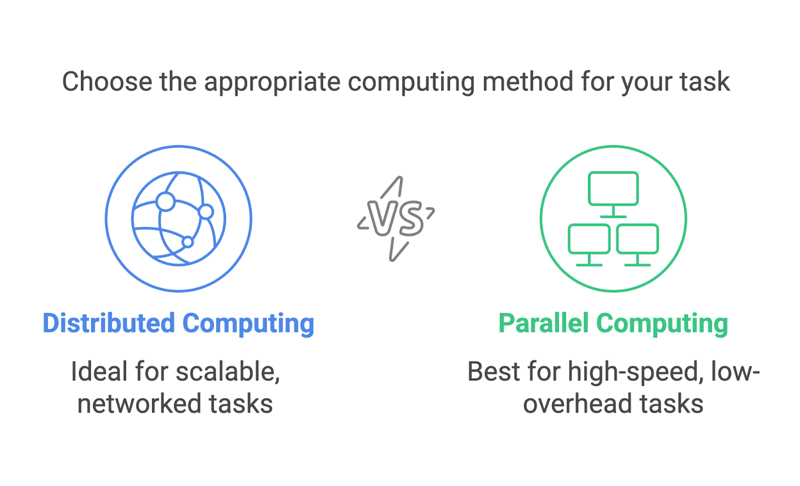
एक व्यावहारिक उदाहरण लें—मान लें हमें एक विशाल डेटासेट को सॉर्ट करना है। पैरेलल कम्प्यूटिंग में हम डेटासेट को हिस्सों में बाँटेंगे और उसी मशीन के प्रत्येक प्रोसेसर एक-एक हिस्सा संभालेंगे। डिस्ट्रीब्यूटेड कम्प्यूटिंग में डेटासेट को बाँटकर अलग-अलग मशीनों को भेजा जाएगा, और हर मशीन अपना हिस्सा स्वतंत्र रूप से सॉर्ट करेगी। फिर सॉर्ट किए गए हिस्सों को जोड़ दिया जाएगा।
दोनों तरीके बेहद उपयोगी हैं, लेकिन अलग कार्यों के लिए उपयुक्त हैं। पैरेलल कम्प्यूटिंग उन कार्यों के लिए आदर्श है जिन्हें उच्च-गति गणना चाहिए और जहाँ संचार ओवरहेड कम हो—जैसे सुपरकंप्यूटर पर सिमुलेशन चलाना। डिस्ट्रीब्यूटेड कम्प्यूटिंग तब बेहतर है जब स्केल-आउट करना हो—जैसे क्लाउड-आधारित सिस्टम या वैश्विक नेटवर्क्स पर डेटा प्रोसेस करना।
डिस्ट्रीब्यूटेड कम्प्यूटिंग के उपयोग
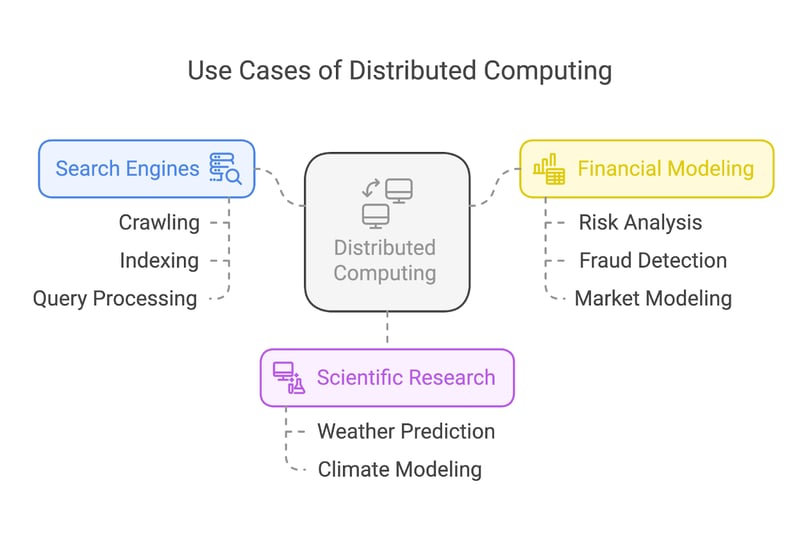
डिस्ट्रीब्यूटेड कम्प्यूटिंग आज हमारी दुनिया के कुछ सबसे प्रभावशाली अनुप्रयोगों को शक्ति देती है। आइए तीन आम उपयोग देखें: सर्च इंजन, वैज्ञानिक अनुसंधान, और वित्तीय मॉडलिंग।
सर्च इंजन
Google जैसे सर्च इंजन अरबों वेब पेज क्रॉल और इंडेक्स करने के लिए डिस्ट्रीब्यूटेड कम्प्यूटिंग पर बहुत अधिक निर्भर रहते हैं। एक मशीन को यह कार्य सौंपने के बजाय, ये सिस्टम वर्कलोड को असंख्य नोड्स में बाँटते हैं।
कुछ नोड्स वेब पेज क्रॉल करते हैं, अन्य इंडेक्सिंग संभालते हैं, और एक और समूह रियल-टाइम में उपयोगकर्ता क्वेरी प्रोसेस करता है। इस श्रम-विभाजन से कार्य के पैमाने चाहे जो हों, सर्च परिणाम तेज़ और कुशल मिलते हैं।
वैज्ञानिक अनुसंधान
वैज्ञानिक अनुसंधान में डिस्ट्रीब्यूटेड कम्प्यूटिंग जटिल सिमुलेशन चलाकर और विशाल डेटासेट्स का विश्लेषण करके सफलता दिलाती है। उदाहरण के लिए, जलवायु वैज्ञानिक मौसम पैटर्न का मॉडल बनाने और ग्लोबल वार्मिंग के प्रभावों का सिमुलेशन करने के लिए डिस्ट्रीब्यूटेड सिस्टम का उपयोग करते हैं।
वित्तीय मॉडलिंग
वित्तीय उद्योग जोखिम विश्लेषण, धोखाधड़ी का पता लगाने, और बाज़ार मॉडलिंग जैसे कार्यों के लिए डिस्ट्रीब्यूटेड कम्प्यूटिंग पर निर्भर रहता है।
वैश्विक वित्तीय बाज़ारों से उत्पन्न विशाल डेटासेट्स को प्रोसेस करने के लिए ऐसी प्रणालियाँ चाहिए जो चौबीसों घंटे और बहुत तेज़ी से काम कर सकें। डिस्ट्रीब्यूटेड कम्प्यूटिंग से वित्तीय फर्म्स डेटा का विश्लेषण, मॉडल्स का परीक्षण, और इनसाइट्स उत्पन्न उस गति से कर पाती हैं जो रियल-टाइम बाज़ारों में उन्हें प्रतिस्पर्धी बनाए रखे।
डिस्ट्रीब्यूटेड कम्प्यूटिंग के प्रमुख घटक
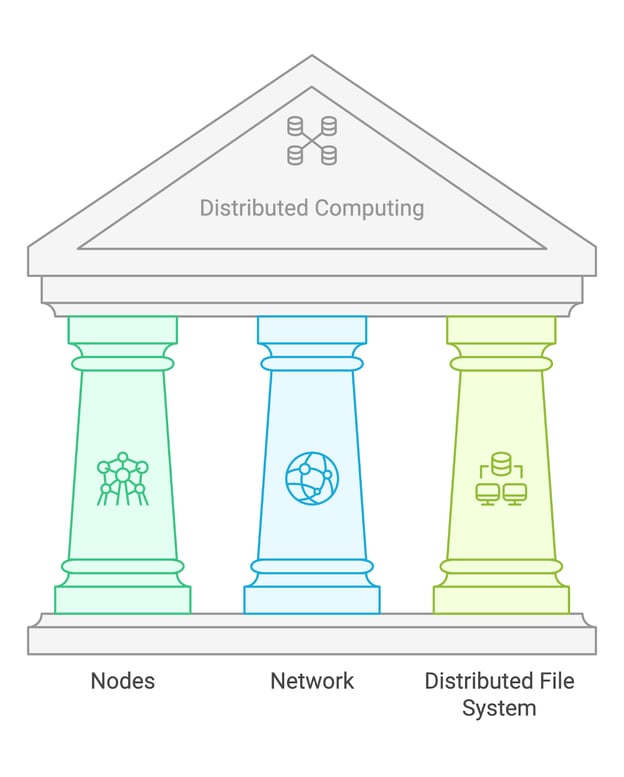
डिस्ट्रीब्यूटेड कम्प्यूटिंग कुछ बुनियादी ईंटों पर टिकी है: नोड्स, एक नेटवर्क, और एक डिस्ट्रीब्यूटेड फाइल सिस्टम (DFS)।
नोड्स
नोड्स वे व्यक्तिगत मशीनें हैं जो डिस्ट्रीब्यूटेड सिस्टम के भीतर गणनाएँ करती हैं। प्रत्येक नोड स्वतंत्र रूप से काम कर सकता है—अपने सौंपे गए कार्यों को प्रोसेस करता है और परिणाम साझा करने के लिए अन्य नोड्स से संचार करता है। कुछ मामलों में नोड्स के विशेष रोल भी हो सकते हैं, जैसे कार्यों का प्रबंधन करना या डेटा संग्रहीत करना।
नेटवर्क
नेटवर्क वह संचार अवसंरचना है जो विभिन्न नोड्स को जोड़ती है। यह उन्हें डेटा का आदान-प्रदान और कार्यों का समन्वय करने देती है। सिस्टम के आकार के आधार पर, इसमें स्थानीय क्षेत्र नेटवर्क (LANs) या व्यापक क्षेत्र नेटवर्क (WANs) शामिल हो सकते हैं, जो भौगोलिक रूप से बिखरे नोड्स को जोड़ते हैं।
डिस्ट्रीब्यूटेड फाइल सिस्टम (DFS)
डिस्ट्रीब्यूटेड फाइल सिस्टम एक स्टोरेज समाधान है जो कई नोड्स के बीच डेटा तक पहुँच देता है। एक लोकप्रिय उदाहरण Hadoop Distributed File System (HDFS) है, जिसे बड़े डेटासेट्स को संभालने और कई नोड्स पर डेटा की प्रतिलिपि बनाकर फॉल्ट टॉलरेंस प्रदान करने के लिए डिज़ाइन किया गया है।
डिस्ट्रीब्यूटेड कम्प्यूटिंग की सामान्य आर्किटेक्चर
ठीक है, तो हमारे पास वर्कलोड नेटवर्क के ज़रिए विभिन्न नोड्स में वितरित है, और सभी नोड्स DFS के माध्यम से डेटा तक पहुँच सकते हैं। लेकिन यह तय कौन करता है कि कौन-सा नोड क्या करेगा?
इनका एक ही उत्तर नहीं है, क्योंकि डिस्ट्रीब्यूटेड कम्प्यूटिंग सिस्टम कई तरीकों से संगठित किए जा सकते हैं। फिर भी, तीन सामान्य आर्किटेक्चर हैं: मास्टर-स्लेव, पीयर-टू-पीयर, और क्लाइंट-सर्वर।
मास्टर–स्लेव
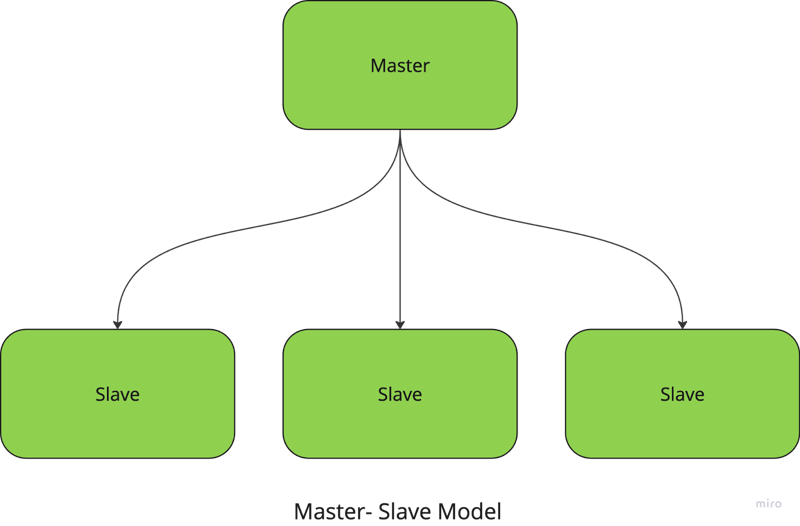
मास्टर–स्लेव मॉडल में एक केंद्रीय नोड (मास्टर नोड) कार्यों का प्रबंधन और समन्वय करता है, जबकि स्लेव नोड्स वास्तविक गणनाएँ करते हैं। मास्टर बड़े कार्यों को छोटे हिस्सों में बाँटता है, उन्हें स्लेव्स में वितरित करता है, और परिणाम एकत्र करता है।
उदाहरण के लिए, यदि आप बड़े पैमाने पर इमेज प्रोसेसिंग कार्य चला रहे हैं, तो मास्टर नोड प्रत्येक स्लेव नोड को इमेजेज़ का एक विशिष्ट भाग प्रोसेस करने के लिए सौंपेगा। कार्य पूर्ण होने पर, मास्टर परिणाम एकत्र कर अंतिम आउटपुट में संयोजित कर देगा।
यह तरीका कार्य-प्रबंधन और समन्वय को सरल बनाता है, पर एक बड़ी कमी है: सिस्टम एकल बिंदु विफलता से ग्रस्त है क्योंकि यह पूरी तरह मास्टर नोड पर निर्भर करता है।
पीयर-टू-पीयर
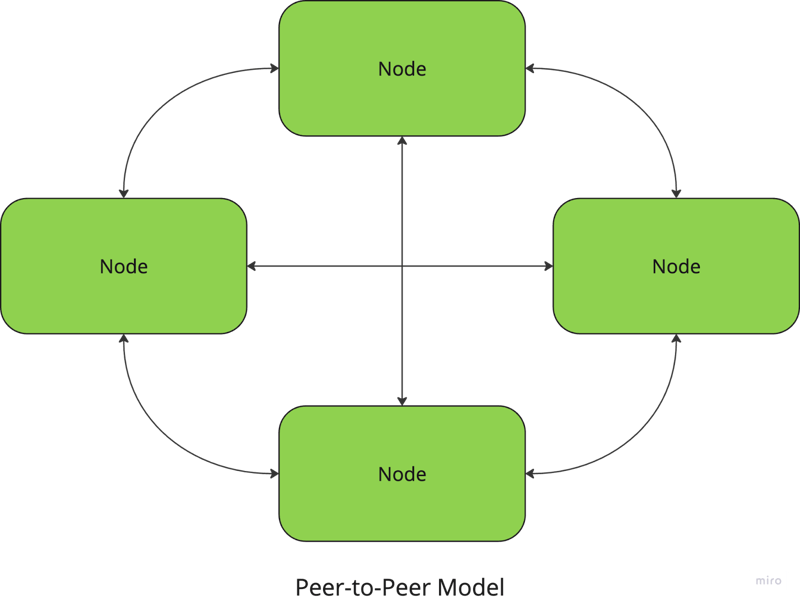
पीयर-टू-पीयर आर्किटेक्चर में सभी नोड्स समान होते हैं और कोई केंद्रीय समन्वयक नहीं होता। हर नोड क्लाइंट और सर्वर—दोनों की तरह कार्य कर सकता है, संसाधनों को साझा करता है और सीधे अन्य नोड्स से संवाद करता है।
उदाहरण के लिए, BitTorrent जैसी फाइल-शेयरिंग नेटवर्क्स P2P तरीका अपनाती हैं, जहाँ उपयोगकर्ता फाइलों के हिस्से सीधे अन्य साथियों से डाउनलोड और उनके लिए अपलोड करते हैं।
सकारात्मक पक्ष यह है कि ऐसे सिस्टम में कोई केंद्रीय विफलता-बिंदु नहीं होता, जिससे वे लचीले और स्केलेबल बनते हैं; लेकिन नोड्स के बीच समन्वय (जैसे डेटा स्थिरता सुनिश्चित करना) अधिक जटिल हो सकता है।
क्लाइंट–सर्वर
क्लाइंट–सर्वर मॉडल में एक या अधिक सर्वर अनेक क्लाइंट नोड्स को संसाधन या सेवाएँ प्रदान करते हैं। क्लाइंट सर्वर को अनुरोध भेजते हैं, सर्वर उन्हें प्रोसेस करता है और परिणाम लौटाता है। यह आर्किटेक्चर वेब अनुप्रयोगों और डेटाबेस में सामान्य है।
यह मास्टर–स्लेव मॉडल जैसा लग सकता है, मानो सर्वर मास्टर की भूमिका निभा रहा हो, लेकिन अंतर यह है: सर्वर आम तौर पर अधिक निष्क्रिय होता है और कार्यों को न तो बाँटता है न सौंपता—वह केवल क्लाइंट अनुरोधों का प्रत्युत्तर देता है।
इस मॉडल में केंद्रीकृत प्रबंधन और नियंत्रण से सिस्टम का रखरखाव और अपडेट आसान हो जाता है, पर सर्वर एक बाधा (बॉटलनेक) बन सकता है जो स्केलेबिलिटी सीमित करता है। सर्वर का डाउनटाइम पूरे सिस्टम को बाधित कर सकता है।
ये तीन आर्किटेक्चर डिस्ट्रीब्यूटेड सिस्टम्स में सबसे सामान्य हैं, लेकिन अन्य मॉडल भी हैं जिनसे आप परिचित होंगे (मुझे यक़ीन है आपने क्लाउड-आधारित आर्किटेक्चर का नाम सुना होगा!).
हर मॉडल अलग ज़रूरतें पूरी करता है, और आर्किटेक्चर का चुनाव सिस्टम के प्रदर्शन, फॉल्ट टॉलरेंस, और स्केलेबिलिटी पर बड़ा असर डाल सकता है, इसलिए तरीका चुनने से पहले जिस समस्या को आप सुलझा रहे हैं उसका मानचित्र बनाना ज़रूरी है। अच्छी बात यह है कि आपको केवल एक ही चुनना नहीं पड़ता! अधिकांश आधुनिक सिस्टम, खासकर क्लाउड कम्प्यूटिंग में, इन आर्किटेक्चर्स के हाइब्रिड रूप का उपयोग करते हैं ताकि उनकी सबसे अच्छी खूबियों को जोड़ा जा सके।
डिस्ट्रीब्यूटेड कम्प्यूटिंग सिस्टम्स सेटअप करना
अब जबकि हमने डिस्ट्रीब्यूटेड कम्प्यूटिंग के सिद्धांत देख लिए हैं, आइए देखें कि वास्तव में डिस्ट्रीब्यूटेड कम्प्यूटिंग सिस्टम कैसे सेटअप किया जाए।
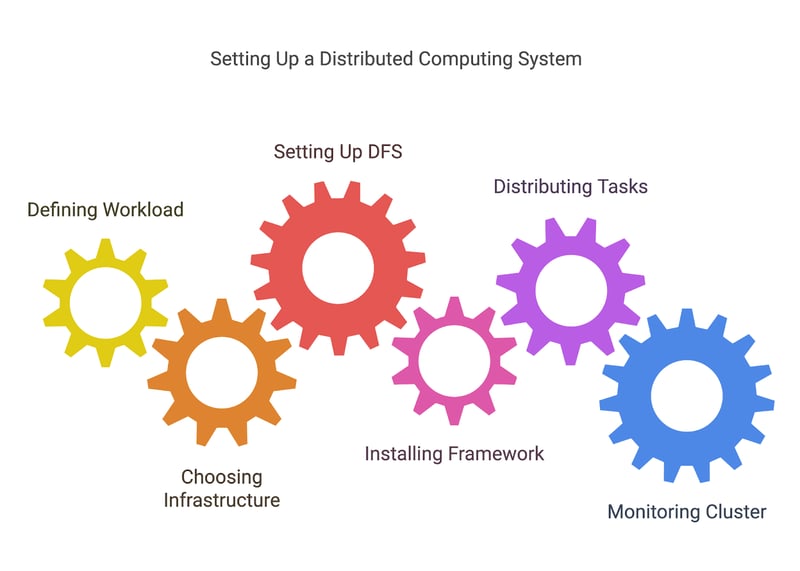
1. अपना वर्कलोड परिभाषित करना
कार्य वितरित करने से पहले, आपको परिभाषित करना होगा कि आप कौन-से कार्य बाँट रहे हैं। अक्सर इसका अर्थ है किसी बड़े समस्या को छोटे, स्वतंत्र इकाइयों में तोड़ना जिन्हें समानांतर रूप से या नोड्स में बाँटकर प्रोसेस किया जा सके।
उदाहरण के लिए, यदि आप बड़ा डेटासेट प्रोसेस कर रहे हैं, तो आप डेटा को हिस्सों में बाँट सकते हैं जिन्हें अलग-अलग मशीनें या प्रोसेसर संभाल सकें।
2. अपना इन्फ्रास्ट्रक्चर चुनना
डिस्ट्रीब्यूटेड कम्प्यूटिंग के लिए मशीनों का एक नेटवर्क चाहिए—चाहे वे ऑन-प्रिमाइसेस सर्वर हों, क्लाउड इंस्टैंसेज़ (जैसे AWS, Azure, या Google Cloud), या दोनों का मिश्रण। आपको तय करना होगा कि इन मशीनों को कैसे सेटअप और कॉन्फ़िगर करें, यह सुनिश्चित करते हुए कि वे जुड़ी हों और एक-दूसरे से संवाद कर सकें।
- क्लाउड-आधारित इन्फ्रास्ट्रक्चर: AWS, Google Cloud, और Azure जैसे प्लेटफ़ॉर्म बिना भौतिक हार्डवेयर संभाले डिस्ट्रीब्यूटेड कम्प्यूटिंग क्लस्टर खड़ा करना आसान बनाते हैं। ये प्लेटफ़ॉर्म अक्सर AWS EC2 (कम्प्यूट पावर के लिए) और S3 (डिस्ट्रीब्यूटेड स्टोरेज के लिए) जैसी प्रबंधित सेवाएँ देते हैं, जिससे स्केलेबल सिस्टम सेटअप करना आसान हो जाता है।
- ऑन-प्रिमाइसेस या हाइब्रिड: यदि आप अपने सर्वर उपयोग कर रहे हैं या ऑन-प्रिमाइसेस और क्लाउड संसाधनों का मिश्रण है, तो आपको अपना नेटवर्क सेटअप करना होगा, नोड्स कॉन्फ़िगर करने होंगे, और उनके बीच विश्वसनीय संचार सुनिश्चित करना होगा।
3. डिस्ट्रीब्यूटेड फाइल सिस्टम (DFS) सेटअप करना
जैसा कि हमने पहले चर्चा की, डिस्ट्रीब्यूटेड कम्प्यूटिंग में सबसे महत्वपूर्ण तत्वों में से एक है यह सुनिश्चित करना कि सभी नोड्स को आवश्यक डेटा तक पहुँच मिले। Hadoop का HDFS या अन्य DFS समाधान बड़े डेटासेट्स को कई नोड्स में संग्रहीत करने देते हैं, और रिडंडेंसी से यह सुनिश्चित करते हैं कि किसी नोड के फेल होने पर डेटा न खोए।
4. फ्रेमवर्क या टूल सेटअप करना
एक बार इन्फ्रास्ट्रक्चर तैयार हो जाए, तो आपको वह टूल सेटअप करना होगा जिसे आपने डिस्ट्रीब्यूटेड कम्प्यूटिंग के लिए चुना है। प्रत्येक फ्रेमवर्क की अपनी इंस्टॉलेशन और कॉन्फ़िगरेशन प्रक्रिया होगी, जिसमें शामिल हो सकता है:
- हर नोड पर आवश्यक सॉफ़्टवेयर इंस्टॉल करना, या क्लाउड-आधारित समाधान उपयोग करना जो आपके लिए स्वतः टूल इंस्टॉल और कॉन्फ़िगर कर दे।
- क्लस्टर सेटिंग्स कॉन्फ़िगर करना—जैसे कितने वर्कर नोड्स चाहिए, संसाधन कैसे आबंटित होंगे, और फॉल्ट टॉलरेंस कैसे संभाला जाएगा।
5. कार्य वितरित करना
पर्यावरण तैयार होने के बाद, आप अपने नोड्स में कार्य वितरित करना शुरू कर सकते हैं। अधिकांश टूल्स आपके वर्कलोड को बाँटने और अलग-अलग नोड्स को कार्य सौंपने की प्रक्रिया में मदद करते हैं।
आमतौर पर आपको ऐसा कोड लिखना होगा जो बताए कि कार्य कैसे बाँटे जाएँ (Hadoop के लिए MapReduce जॉब्स, Spark के लिए ट्रांसफॉर्मेशन और एक्शन्स, आदि), या फ़्रेमवर्क के APIs का उपयोग करके नोड्स के बीच वितरण और संचार संभालना होगा।
6. अपने क्लस्टर की मॉनिटरिंग और प्रबंधन
डिस्ट्रीब्यूटेड सिस्टम जटिल हो सकते हैं, और प्रदर्शन, विफलताओं, तथा संसाधन उपयोग पर नज़र रखना सबकुछ सुचारु रखने के लिए महत्वपूर्ण है। कई टूल्स बिल्ट-इन मॉनिटरिंग डैशबोर्ड देते हैं, लेकिन आपको अतिरिक्त मॉनिटरिंग समाधान (जैसे Prometheus या Grafana) भी चाहिए हो सकते हैं ताकि नोड स्वास्थ्य, प्रदर्शन, और जॉब प्रोग्रेस पर नज़र रखी जा सके।
डिस्ट्रीब्यूटेड कम्प्यूटिंग के टूल्स और फ्रेमवर्क
जैसा कि हमने देखा, सही टूल डिस्ट्रीब्यूटेड कम्प्यूटिंग सेटअप करने में और आपके डिस्ट्रीब्यूटेड वातावरण के प्रबंधन में काफी मदद कर सकता है। आइए कुछ सबसे लोकप्रिय टूल्स को क़रीब से देखें।
Apache Hadoop
Apache Hadoop एक ओपन-सोर्स फ्रेमवर्क है जिसे कंप्यूटरों के डिस्ट्रीब्यूटेड क्लस्टर में अपार मात्रा में डेटा प्रोसेस करने के लिए डिज़ाइन किया गया है। यह MapReduce प्रोग्रामिंग मॉडल का उपयोग करता है, जो बड़े कार्यों को छोटे, समानांतर किए जा सकने वाले हिस्सों में बाँट देता है।
Hadoop पेटाबाइट्स डेटा संभालने में विशेष रूप से उपयोगी है, और स्केलेबिलिटी, फॉल्ट टॉलरेंस, तथा स्टोरेज की लचीलापन में बेहतरीन है। इसका इकोसिस्टम HDFS (डिस्ट्रीब्यूटेड स्टोरेज के लिए) और बैच प्रोसेसिंग के टूल्स जैसे विभिन्न घटक शामिल करता है, इसी कारण कई बिग डेटा अनुप्रयोगों के लिए यह प्रमुख समाधानों में से एक है।
इन्फ्रास्ट्रक्चर सेटअप स्वयं जटिल हो सकता है, क्योंकि फिर भी नोड्स कॉन्फ़िगर करने, क्लस्टर संसाधन प्रबंधित करने, और फॉल्ट टॉलरेंस सुनिश्चित करने की आवश्यकता होती है।
Hadoop के बारे में और जानने के लिए यह लेख पढ़ें: Hadoop Interview Questions। इंटरव्यू की तैयारी में यह उपयोगी है और इस टूल व इसके उपयोग मामलों के दिलचस्प तथ्यों से भरा है।
Apache Spark
Apache Spark बड़े पैमाने पर डेटा प्रोसेसिंग के लिए एक तेज़ और जनरल-पर्पस इंजन है।
Hadoop पर आधारित होने के कारण, Spark मौजूदा Hadoop क्लस्टर पर या अपने स्वयं के क्लस्टर मैनेजर पर चल सकता है। पर Hadoop के विपरीत, जो डिस्क-आधारित स्टोरेज उपयोग करता है, Spark इन-मेमोरी कम्प्यूटेशन देता है और डेटा को काफ़ी तेज़ी से प्रोसेस कर सकता है।
इसे बैच प्रोसेसिंग, रियल-टाइम स्ट्रीमिंग, मशीन लर्निंग, और ग्राफ़ प्रोसेसिंग सहित व्यापक कार्यों के लिए इस्तेमाल किया जा सकता है। यह Python, Scala, और Java जैसी भाषाओं को सपोर्ट करता है और AWS तथा Azure जैसे क्लाउड प्लेटफ़ॉर्म्स से एकीकृत होता है।
Dask
याद है जब हमने पैरेलल कम्प्यूटिंग की बात की थी? तो Dask Python में एक पैरेलल कम्प्यूटिंग लाइब्रेरी है जिसे एकल मशीन से लेकर बड़े डिस्ट्रीब्यूटेड क्लस्टर्स तक स्केल करने के लिए बनाया गया है।
यह बड़े डेटासेट्स और जटिल कम्प्यूटेशनल कार्यों को संभालने के लिए आदर्श है, क्योंकि यह NumPy, Pandas, और Scikit-learn जैसी अन्य Python लाइब्रेरीज़ से एकीकृत है और Python उपयोगकर्ताओं के लिए परिचित परिवेश प्रदान करती है।
इसकी वितरित और स्थानीय—दोनों वातावरणों में काम करने की क्षमता का मतलब है कि आप इसे छोटे प्रोजेक्ट से लेकर विशाल डेटा पाइपलाइन तक में उपयोग कर सकते हैं। डिस्ट्रीब्यूटेड कम्प्यूटिंग के लिए कुछ हद तक कॉन्फ़िगरेशन की आवश्यकता रहती है, हालांकि Hadoop और Spark की तुलना में इसका बहुत-सा हिस्सा स्वचालित है।
निष्कर्ष
आशा है आपको डिस्ट्रीब्यूटेड कम्प्यूटिंग की मूल बातें जानकर अच्छा लगा! यह लेख बस शुरुआत है। डिस्ट्रीब्यूटेड कम्प्यूटिंग के क्षेत्र में हर साल असंख्य टूल्स, फ्रेमवर्क्स, और तकनीकें उभरती रहती हैं।
यदि आप डिस्ट्रीब्यूटेड सिस्टम बनाकर देखना चाहते हैं, तो AWS या GCP जैसे क्लाउड प्रदाता पर साइन अप करने की मैं सिफारिश करूँगा। दोनों साइन अप पर क्रेडिट देते हैं, जिससे आप उनकी इन्फ्रास्ट्रक्चर आज़मा सकते हैं और छोटे प्रोजेक्ट्स मुफ़्त में सेटअप कर सकते हैं!
यदि आप मूल बातों में सहज हैं और अपना डेटा करियर आगे बढ़ाना चाहते हैं, तो ऑनलाइन उपलब्ध कई Apache Spark प्रमाणपत्रों में से एक कर सकते हैं।
हैप्पी कोडिंग!
FAQs
क्या डिस्ट्रीब्यूटेड कम्प्यूटिंग के लिए विशेष हार्डवेयर चाहिए?
ज़रूरी नहीं—आप सामान्य मशीनें इस्तेमाल कर सकते हैं, लेकिन उच्च-प्रदर्शन वाले कार्यों में अनुकूलित हार्डवेयर से लाभ हो सकता है।
क्या डिस्ट्रीब्यूटेड कम्प्यूटिंग हमेशा तेज़ होती है?
हमेशा नहीं। छोटे कार्यों में समन्वय और संचार का ओवरहेड कभी-कभी फायदों से अधिक हो सकता है।
डिस्ट्रीब्यूटेड सिस्टम सेटअप करने के लिए कितनी प्रोग्रामिंग जानकारी चाहिए?
टूल्स प्रक्रिया सरल बनाते हैं, लेकिन आपको प्रोग्रामिंग, नेटवर्किंग, और सिस्टम डिज़ाइन की मूलभूत समझ होना ज़रूरी है।

लेखक
Marie Fayard
मैं एक प्रोडक्ट-उन्मुख टेक लीड हूं, जो शुरुआती चरण के स्टार्टअप्स को पहले प्रोटोटाइप से लेकर प्रोडक्ट–मार्केट फिट और उससे आगे तक बढ़ाने में विशेषज्ञता रखता/रखती हूं। मुझे यह जानने में गहरी दिलचस्पी है कि लोग तकनीक का उपयोग कैसे करते हैं, और मुझे संस्थापकों व क्रॉस-फ़ंक्शनल टीमों के साथ मिलकर साहसिक विचारों को साकार करना पसंद है। जब मैं प्रोडक्ट नहीं बना रहा/रही होता/होती, तब मैं दुनिया के नए कोनों में प्रेरणा की तलाश में रहता/रहती हूं या योग स्टूडियो में जाकर मन हल्का करता/करती हूं।
यदि आपने कभी जटिल गणनाओं या उच्च डेटा विश्लेषण आवश्यकताओं वाले सिस्टम पर काम किया है, तो आपने देखा होगा कि अकेली मशीनें अक्सर कदम से कदम मिलाने में जूझती हैं। शक्तिशाली कंप्यूटर भी बेहद बड़े डेटासेट्स को प्रोसेस करते समय अपनी सीमाओं से टकरा जाते हैं—खासकर रियल-टाइम डेटा विश्लेषण या मशीन लर्निंग जैसे क्षेत्रों में।
यहीं डिस्ट्रीब्यूटेड कम्प्यूटिंग काम आती है। कार्यों को कई मशीनों में बाँटकर, यह उनकी संयुक्त शक्ति का उपयोग करती है ताकि वे चुनौतियाँ पार की जा सकें जो एकल सिस्टम के लिए बहुत कठिन होतीं। इससे हम इंजीनियर ऐसे अनेक अनुप्रयोग बना पाते हैं—सर्च इंजन जो अरबों वेब पेज इंडेक्स करते हैं से लेकर जलवायु परिवर्तन सिमुलेशन तक।
इस लेख में, मैं आपको डिस्ट्रीब्यूटेड कम्प्यूटिंग से परिचित कराऊँगा, इसके प्रमुख घटकों और आर्किटेक्चर को समझाऊँगा, डिस्ट्रीब्यूटेड सिस्टम कैसे सेटअप करें यह बताऊँगा, और कुछ सहायक टूल्स की झलक दूँगा।