
Dağıtık Hesaplama Nedir?
Dağıtık hesaplamada, tek bir problemi birlikte çözmek için birden fazla bilgisayar kullanırız. Tek bir makineye güvenmek yerine, görevleri daha küçük parçalara ayırır ve bunları “düğümler” olarak adlandırdığımız bilgisayar ağındaki makinelere atarız. Bu düğümler, işlem yükünü ve veri depolamayı paylaşarak işbirliği içinde çalışır ve görevleri tamamlar.
Bu yaklaşım, tek bir bilgisayarın işleyemeyeceği kadar büyük veya karmaşık olan geniş ölçekli problemler veya veri kümeleriyle uğraşırken kullanışlıdır. Örneğin, dağıtık bir hesaplama sistemi arama motorları için petabaytlarca veriyi işleyebilir, bilimsel araştırmalar için simülasyonlar çalıştırabilir veya piyasa analizi için finansal modelleri güçlendirebilir.
Dağıtık Hesaplama ve Paralel Hesaplama
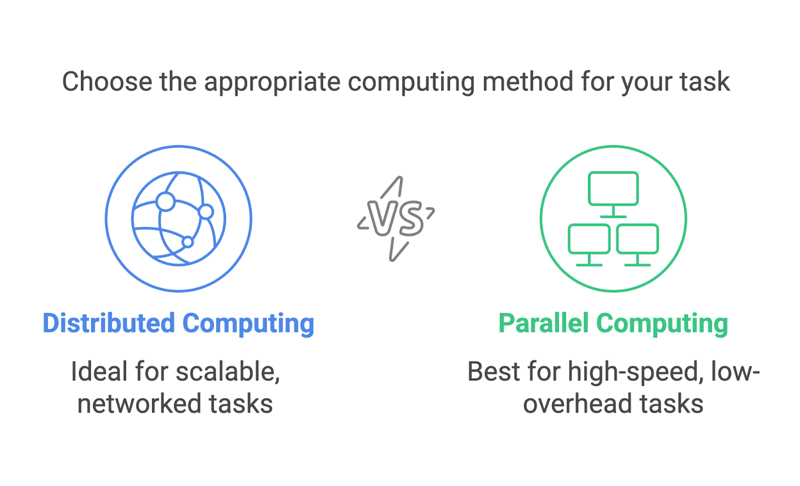
Dağıtık hesaplama ile paralel hesaplama sıklıkla karıştırılır ve birbirinin yerine kullanılabilir gibi görünebilir. Her ikisi de tek bir hedefe yönelik olarak birden çok süreci içerir, ancak farklı senaryolar için tasarlanmış ayrı yaklaşımlardır.
Dağıtık hesaplama, genellikle coğrafi olarak dağıtılmış, ayrı makinelerden oluşan bir ağı işbirliği içinde problem çözmek için kullanmaya odaklanır. Her makine, kendi belleği ve işlem gücüyle bağımsız bir düğüm olarak çalışır. Düğümler arasındaki iletişim ağ üzerinden gerçekleşir ve görevler farklı makinelerde çalışacak şekilde bölünür.
Paralel hesaplama ise genellikle tek bir sistem içinde gerçekleşir. Bir bilgisayarın içindeki birden çok işlemciyi veya çekirdeği, görevleri eşzamanlı olarak yürütmek için kullanır. Bu işlemciler aynı belleği paylaşır ve hesaplamaları bölmek için çoğunlukla yakın işbirliği içinde çalışır.
Pratik bir örnek verelim: Devasa bir veri kümesini sıraladığımızı düşünelim. Paralel hesaplamada, veri kümesini parçalara bölerdik ve aynı makinedeki her işlemci bir parçayı işlerdi. Dağıtık hesaplamada ise veri kümesi bölünür ve farklı makinelere gönderilir; her makine kendi bölümünü bağımsız olarak sıralar. Ardından sıralanan parçalar birleştirilir.
Her iki yöntem de son derece kullanışlıdır ancak farklı görevlere uygundur. Paralel hesaplama, ağ iletişimi yükünün düşük olduğu, süper bilgisayarda simülasyon çalıştırma gibi yüksek hızlı hesaplama gerektiren işler için idealdir. Dağıtık hesaplama ise bulut tabanlı sistemlerde veya küresel ağlar genelinde veri işleme gibi yatay ölçekleme gerektiren durumlara daha uygundur.
Dağıtık Hesaplamanın Kullanım Alanları
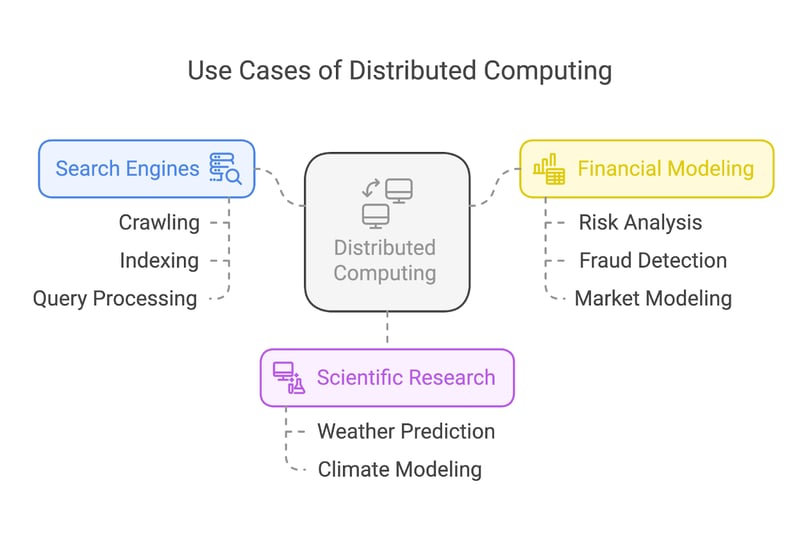
Dağıtık hesaplama, bugün dünyamızdaki en etkili uygulamalardan bazılarına güç verir. Üç yaygın kullanım alanına bakalım: arama motorları, bilimsel araştırmalar ve finansal modelleme.
Arama motorları
Google gibi arama motorları, milyarlarca web sayfasını taramak ve dizine eklemek için yoğun şekilde dağıtık hesaplamaya dayanır. Görevi tek bir makineye vermek yerine, bu sistemler iş yükünü çok sayıda düğüm arasında paylaştırır.
Bazı düğümler web sayfalarını taramaya odaklanırken, diğerleri indekslemeyi yapar ve başka bir grup da kullanıcı sorgularını gerçek zamanlı işler. Bu işbölümü, görevin ölçeği ne olursa olsun, hızlı ve verimli arama sonuçları sağlar.
Bilimsel araştırmalar
Bilimsel araştırmalarda, dağıtık hesaplama karmaşık simülasyonları çalıştırarak ve çok büyük veri kümelerini analiz ederek atılımlar sağlar. Örneğin, iklim bilimciler hava durumu modellerini oluşturmak ve tahmin etmek ya da küresel ısınmanın etkilerini simüle etmek için dağıtık sistemler kullanır.
Finansal modelleme
Finans sektörü, risk analizi, sahtekarlık tespiti ve piyasa modellemesi gibi görevler için dağıtık hesaplamaya güvenir.
Küresel finansal piyasaların ürettiği devasa veri kümelerini işlemek, 7/24 ve çok hızlı çalışabilen sistemler gerektirir. Dağıtık hesaplama, finansal kurumların verileri analiz etmesine, modelleri test etmesine ve gerçek zamanlı piyasalarda rekabetçi kalmalarını sağlayan içgörüler üretmesine olanak tanır.
Dağıtık Hesaplamanın Temel Bileşenleri
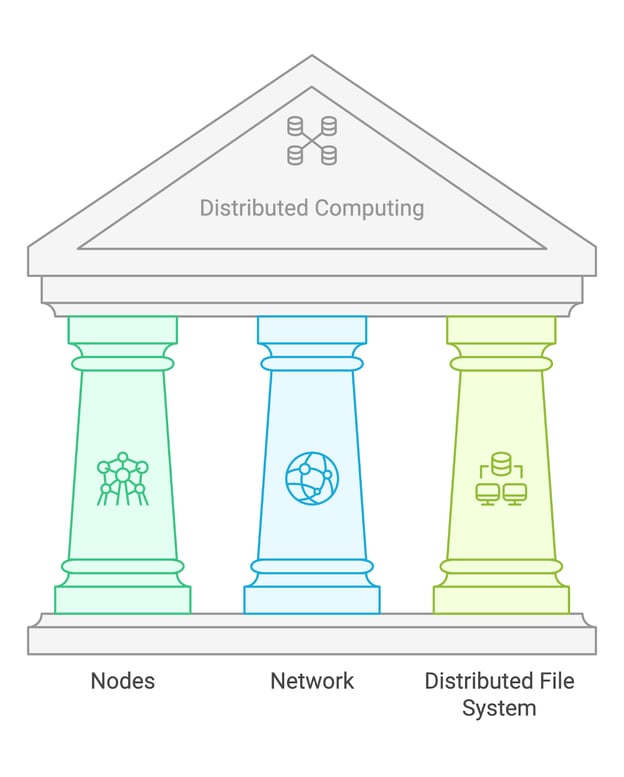
Dağıtık hesaplama, şu temel yapı taşlarına dayanır: düğümler, bir ağ ve dağıtık dosya sistemi (DFS).
Düğümler
Düğümler, bir dağıtık sistem içinde hesaplamaları gerçekleştiren bireysel makinelerdir. Her düğüm, kendisine atanan görevleri bağımsız olarak işleyebilir ve sonuçları paylaşmak için diğer düğümlerle iletişim kurabilir. Bazı durumlarda, düğümler görev yönetimi veya veri depolama gibi uzmanlaşmış rollere sahip olabilir.
Ağ
Ağ, farklı düğümleri birbirine bağlayan iletişim altyapısıdır. Dataları değiştirmelerine ve görevleri koordine etmelerine olanak tanır. Sistem boyutuna bağlı olarak, bu yerel alan ağlarını (LAN) veya coğrafi olarak dağınık düğümler için geniş alan ağlarını (WAN) içerebilir.
Dağıtık dosya sistemi (DFS)
Dağıtık dosya sistemi, verilerin birden fazla düğüm üzerinden erişilebilir olmasını sağlayan bir depolama çözümüdür. Popüler bir örnek, büyük veri kümelerini işlemek ve veriyi birden fazla düğüme çoğaltarak hata toleransı sağlamak üzere tasarlanmış Hadoop Dağıtık Dosya Sistemi’dir (HDFS).
Dağıtık Hesaplamanın Yaygın Mimarileri
Tamam, bir iş yükünü bir ağ üzerinden farklı düğümlere dağıttık ve tüm düğümler DFS aracılığıyla veriye erişebiliyor. Peki hangi düğümün ne yapacağına kim karar veriyor?
Bu soruların tek bir yanıtı yok, çünkü dağıtık hesaplama sistemleri çeşitli şekillerde düzenlenebilir. Bununla birlikte, üç yaygın mimari vardır: ana-köle, eşten eşe ve istemci-sunucu.
Ana-köle
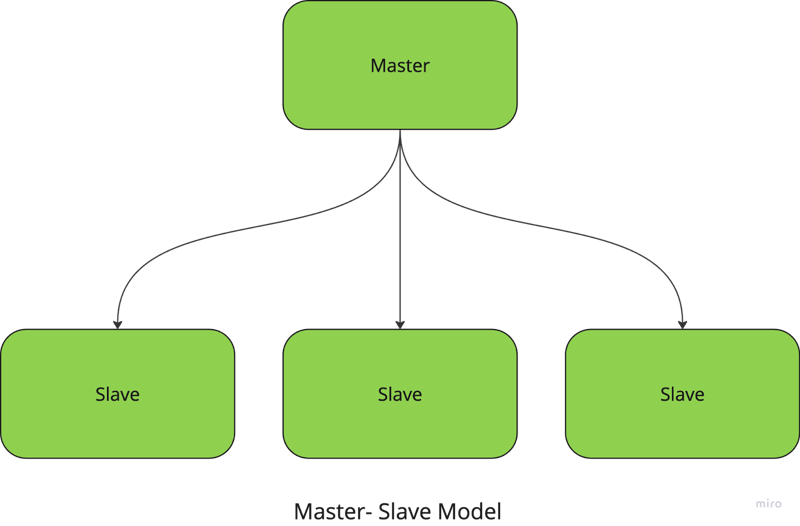
Ana-köle modelinde, merkezi bir düğüm (ana düğüm) görevleri yönetir ve koordine ederken köle düğümler gerçek hesaplamaları yürütür. Ana düğüm, görevleri daha küçük parçalara bölmek, bunları kölelere dağıtmak ve sonuçları toplamakla sorumludur.
Örneğin, büyük ölçekli bir görüntü işleme görevi çalıştırıyorsanız, ana düğüm her köle düğüme işlemeleri için belirli bir görüntü kısmını atar. Görevler tamamlandığında, ana düğüm sonuçları toplayıp nihai çıktıda birleştirir.
Bu yaklaşım görev yönetimini ve koordinasyonu basitleştirir, ancak önemli bir dezavantajı vardır: Sistem, tamamen ana düğüme bağlı olduğu için tekil bir arıza noktasına sahiptir.
Eşten eşe
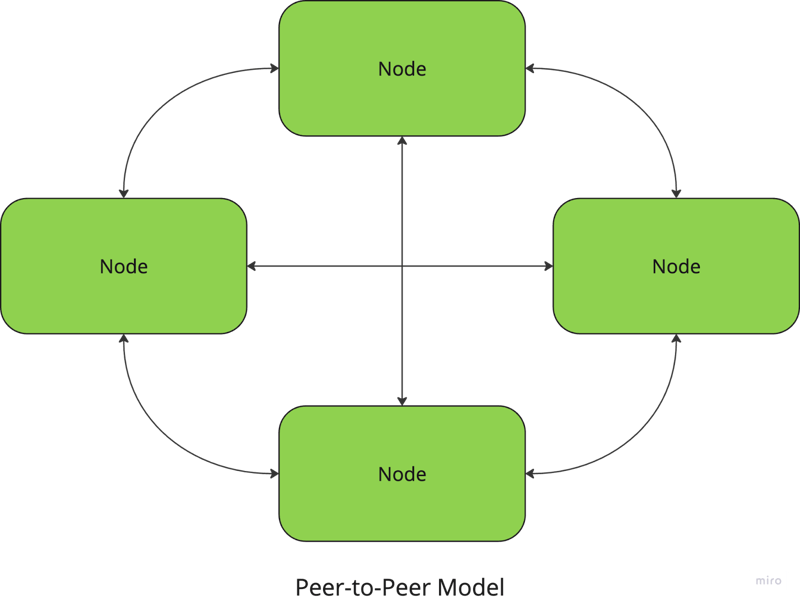
Eşten eşe mimaride, tüm düğümler eşittir ve merkezi bir koordinatör yoktur. Her düğüm hem istemci hem de sunucu gibi davranabilir, kaynakları paylaşır ve diğer düğümlerle doğrudan iletişim kurar.
Örneğin, BitTorrent gibi dosya paylaşım ağları P2P yaklaşımı kullanır; kullanıcılar dosyaların parçalarını doğrudan diğer eşlerden indirir ve onlara yükler.
Artı olarak, bu sistemlerde merkezi bir arıza noktası yoktur; bu da onları dayanıklı ve ölçeklenebilir kılar. Ancak düğümler arasındaki koordinasyon (örneğin veri tutarlılığını sağlamak için) daha karmaşık olabilir.
İstemci-sunucu
İstemci-sunucu modelinde, bir veya daha fazla sunucu, birden çok istemci düğümüne kaynak veya hizmet sağlar. İstemciler sunucuya istek gönderir; sunucu bu istekleri işler ve sonuçları döndürür. Bu mimari, web uygulamaları ve veritabanlarında yaygın olarak kullanılır.
Sunucunun ana düğüm rolünü oynadığı ana-köle modeline benziyor gibi gelebilir, ancak bir fark vardır: Sunucu genellikle daha pasiftir ve görevleri bölmez veya devretmez—yalnızca istemci isteklerine yanıt verir.
Bu modelde, merkezi yönetim ve kontrol sistemi sürdürmeyi ve güncellemeyi kolaylaştırır; ancak sunucu, ölçeklenebilirliği sınırlayabilen bir darboğazdır. Sunucu kesintisi ayrıca tüm sistemi aksatabilir.
Bu üç mimari, dağıtık sistemlerde en yaygın olanlardır, ancak karşılaşmış olabileceğiniz başka modeller de vardır (bulut tabanlı mimariyi duymuş olduğunuza eminim!).
Her model farklı ihtiyaçlara hizmet eder ve mimari seçimi sistem performansı, hata toleransı ve ölçeklenebilirlik üzerinde büyük etki yaratabilir; bu nedenle bir yaklaşıma karar vermeden önce çözdüğünüz problemi netleştirmeniz önemlidir. Güzel olan şu ki yalnızca birini seçmek zorunda değilsiniz! Özellikle bulut bilişimde modern sistemlerin çoğu, bu mimarilerin en iyi özelliklerini birleştiren hibrit sürümler kullanır.
Dağıtık Hesaplama Sistemlerinin Kurulumu
Artık dağıtık hesaplamanın arkasındaki teoriyi ele aldığımıza göre, bir dağıtık hesaplama sisteminin pratikte nasıl kurulacağına bakalım.
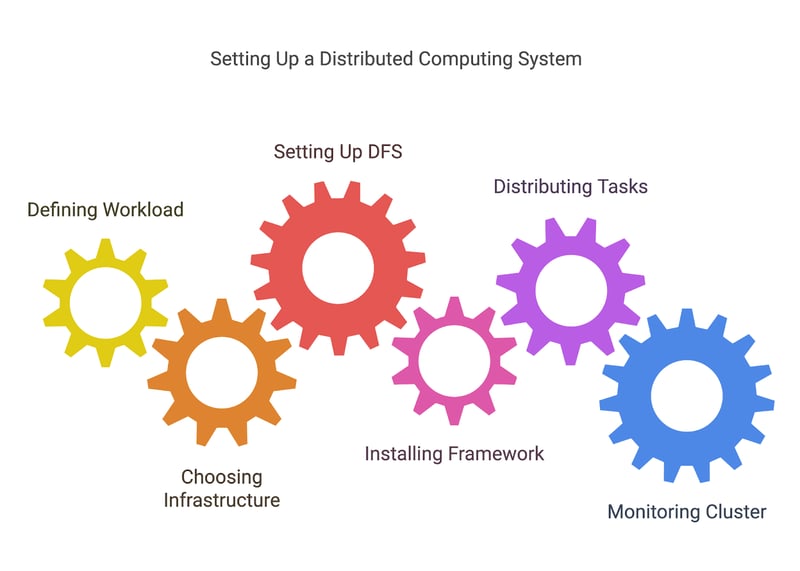
1. İş yükünüzü tanımlamak
Görevleri dağıtmadan önce, hangi görevleri dağıttığınızı tanımlamanız gerekir. Bu genellikle daha büyük bir problemi, paralel olarak veya düğümler arasında dağıtılabilecek daha küçük, bağımsız iş birimlerine ayırmayı içerir.
Örneğin, büyük bir veri kümesini işliyorsanız, veriyi farklı makineler veya işlemciler tarafından işlenebilecek parçalara ayırabilirsiniz.
2. Altyapınızı seçmek
Dağıtık hesaplama, ister kurum içi sunucular, ister bulut örnekleri (AWS, Azure veya Google Cloud gibi) ya da her ikisinin karışımı olsun, bir makine ağı gerektirir. Bu makineleri nasıl kurup yapılandıracağınıza karar vermeniz, bağlantıda olduklarından ve birbirleriyle iletişim kurabildiklerinden emin olmanız gerekir.
- Bulut tabanlı altyapı: AWS, Google Cloud ve Azure gibi platformlar, fiziksel donanımı yönetmeye gerek kalmadan dağıtık hesaplama kümeleri oluşturmayı kolaylaştırır. Bu platformlar sıklıkla AWS EC2 (işlem gücü için) ve S3 (dağıtık depolama için) gibi yönetilen hizmetler sunar; ölçeklenebilir sistemler kurmayı kolaylaştırır.
- Kurum içi veya hibrit: Kendi sunucularınızı veya kurum içi ve bulut kaynaklarının bir karışımını kullanıyorsanız, ağınızı kurmanız, düğümleri yapılandırmanız ve aralarında güvenilir iletişim sağlamanız gerekir.
3. Dağıtık dosya sistemini (DFS) kurmak
Daha önce tartıştığımız gibi, dağıtık hesaplamadaki en önemli unsurlardan biri tüm düğümlerin ihtiyaç duydukları verilere erişimini sağlamaktır. Hadoop’un HDFS’i veya diğer DFS çözümleri, büyük veri kümelerini birden fazla düğüm boyunca depolamanıza ve bir düğüm arızalanırsa veri kaybını önlemek için yedeklilik sağlamanıza olanak tanır.
4. Çerçeveyi veya aracı kurmak
Altyapınız hazır olduğunda, dağıtık hesaplama için seçtiğiniz aracı kurmanız gerekir. Her çerçevenin kendi kurulum ve yapılandırma süreci vardır; ancak şu adımları içerebilir:
- Gerekli yazılımları her düğüme kurmak veya aracı sizin için otomatik olarak kurup yapılandıran bulut tabanlı bir çözüm kullanmak.
- Kaç işçi (worker) düğüm istediğiniz, kaynakların nasıl tahsis edileceği ve hata toleransının nasıl ele alınacağı gibi küme ayarlarınızı yapılandırmak.
5. Görevleri dağıtmak
Ortamınız hazır olduğunda, görevleri düğümleriniz arasında dağıtmaya başlayabilirsiniz. Çoğu araç, iş yükünüzü bölerek ve görevleri farklı düğümlere atayarak bu süreci yönetmenize yardımcı olur.
Genellikle, görevlerin nasıl bölüneceğini tanımlayan kod yazmanız (Hadoop için MapReduce işleri, Spark için dönüşümler ve eylemler gibi) veya düğümler arasında dağıtım ve iletişimi ele almak için çerçevenin API’lerini kullanmanız gerekir.
6. Kümenizi izlemek ve yönetmek
Dağıtık sistemler karmaşık hale gelebilir ve performansı, arızaları ve kaynak kullanımını takip etmek her şeyin sorunsuz ilerlediğinden emin olmak için kritiktir. Birçok araç izleme için yerleşik paneller sağlar, ancak düğüm sağlığını, performansı ve iş ilerlemesini takip etmek için ek izleme çözümlerine (Prometheus veya Grafana gibi) de ihtiyaç duyabilirsiniz.
Dağıtık Hesaplama için Araçlar ve Çerçeveler
Az önce gördüğümüz gibi, doğru araç dağıtık hesaplamaya başlamanıza ve dağıtık ortamlarınızı yönetirken işin büyük kısmını üstlenmenize yardımcı olabilir. En popüler olanlardan bazılarına daha yakından bakalım.
Apache Hadoop
Apache Hadoop, dağıtık bir bilgisayar kümesi genelinde çok büyük miktarda veriyi işlemek için tasarlanmış bir açık kaynak çerçevedir. Büyük görevleri daha küçük, paralelleştirilebilir parçalara bölen MapReduce programlama modelini kullanır.
Hadoop, özellikle petabaytlarca veriyi işlemek için kullanışlıdır ve depolamada esneklik, ölçeklenebilirlik ve hata toleransı konusunda güçlüdür. Ekosistemi, dağıtık depolama için Hadoop Dağıtık Dosya Sistemi (HDFS) ve toplu işleme araçları gibi çeşitli bileşenler içerir; bu nedenle birçok büyük veri uygulaması için başvurulan çözümlerden biridir.
Altyapı kurulumu kendi başına karmaşık olabilir; çünkü düğümlerin yapılandırılmasını, küme kaynaklarının yönetilmesini ve hata toleransının sağlanmasını gerektirir.
Hadoop hakkında daha fazla bilgi edinmek için Hadoop Mülakat Soruları başlıklı bu makaleyi okuyun. Mülakata hazırlanırken faydalıdır ve araç ile kullanım alanlarına dair ilginç bilgilerle doludur.
Apache Spark
Apache Spark, büyük ölçekli veri işleme için hızlı ve genel amaçlı bir motordur.
Hadoop üzerine inşa edildiğinden, Spark mevcut Hadoop kümelerinin üzerinde veya kendi küme yöneticisiyle çalışabilir. Ancak disk tabanlı depolama kullanan Hadoop’dan farklı olarak Spark, bellek içi hesaplama sunar ve veriyi belirgin ölçüde daha hızlı işleyebilir.
Toplu işleme, gerçek zamanlı akış, makine öğrenimi ve grafik işlemenin de dahil olduğu geniş bir yelpazede işleme görevleri için kullanılabilir. Python, Scala ve Java gibi dilleri destekler ve AWS ile Azure gibi bulut platformlarıyla entegre olur.
Dask
Paralel hesaplamadan bahsettiğimizi hatırlıyor musunuz? Dask, tek bir makineden büyük dağıtık kümelere ölçeklenecek şekilde tasarlanmış, Python’da bir paralel hesaplama kütüphanesidir.
NumPy, Pandas ve Scikit-learn gibi diğer Python kütüphaneleriyle entegre olduğu ve Python kullanıcıları için tanıdık bir ortam sunduğu için büyük veri kümelerini ve karmaşık hesaplama görevlerini ele almak için ideal bir seçimdir.
Hem dağıtık hem de yerel ortamlarda çalışabilmesi, onu küçük projelerden dev veri hatlarına kadar kullanabileceğiniz anlamına gelir. Yine de dağıtık hesaplama için belli bir düzeyde yapılandırma gerektirir; ancak bunun önemli bir kısmı Hadoop ve Spark’a kıyasla otomatikleştirilmiştir.
Sonuç
Dağıtık hesaplamanın temellerini öğrenmekten keyif aldığınızı umuyorum! Ancak bu yazı sadece bir başlangıç. Dağıtık hesaplama alanında her yıl sayısız araç, çerçeve ve teknik ortaya çıkıyor.
Eğer dağıtık sistemler oluşturmayı denemek istiyorsanız, AWS veya GCP gibi bir bulut sağlayıcısına kaydolmanızı öneririm. Her ikisi de kayıt sırasında kredi verir; böylece altyapılarını deneyebilir ve küçük projeleri ücretsiz kurabilirsiniz!
Zaten temellerde rahatsanız ve veri kariyerinizi ilerletmek istiyorsanız, çevrimiçi olarak sunulan birçok Apache Spark sertifikasından birini alabilirsiniz.
Mutlu kodlamalar!
SSS
Dağıtık hesaplama için özel donanıma ihtiyacım var mı?
Gerekli değil—standart makineler kullanabilirsiniz, ancak yüksek performanslı görevler optimize donanımdan fayda görebilir.
Dağıtık hesaplama her zaman daha hızlı mı?
Her zaman değil. Koordinasyon ve iletişimden kaynaklanan ek yük, küçük görevlerde bazen faydaların önüne geçebilir.
Bir dağıtık sistem kurmak için ne kadar programlama bilgisi gerekir?
Araçlar süreci basitleştirse de programlama, ağ ve sistem tasarımı temellerini iyi bilmeniz gerekir.

Yazar
Marie Fayard
İlk prototipten ürün-pazar uyumuna ve ötesine kadar erken aşama girişimleri büyütme konusunda uzmanlaşmış, ürün odaklı bir teknik liderim. İnsanların teknolojiyi nasıl kullandığına dair bitmeyen bir merakım var ve kurucularla ile disiplinler arası ekiplerle yakın çalışarak cesur fikirleri hayata geçirmeyi seviyorum. Ürün inşa etmediğim zamanlarda ya dünyanın yeni köşelerinde ilham peşinde koşuyor ya da yoga stüdyosunda stres atıyorum.



Eğer karmaşık hesaplamalara veya yüksek veri analizi gereksinimlerine sahip sistemlerle çalıştıysanız, tekil makinelerin yetişmekte ne kadar zorlandığına muhtemelen tanık olmuşsunuzdur. Güçlü bilgisayarlar bile, özellikle gerçek zamanlı veri analizi veya makine öğrenimi gibi alanlarda, devasa veri kümelerini işlerken sınırlarına ulaşabilir.
İşte dağıtık hesaplama bu noktada devreye girer. Görevleri birden fazla makineye bölerek, tek bir sistem için fazla zorlu olabilecek sorunların üstesinden gelmek için bu makinelerin birleşik gücünü kullanır. Bu sayede biz mühendisler, milyarlarca web sayfasını dizine ekleyen arama motorlarından iklim değişikliği simülasyonlarına kadar çok geniş yelpazede uygulamalar geliştirebiliriz.
Bu yazıda sizi dağıtık hesaplamayla tanıştıracak, temel bileşenlerini ve mimarilerini açıklayacak, bir dağıtık sistemin nasıl kurulacağını anlatacak ve yardımcı olabilecek bazı araçları inceleyeceğim.