
Che cos’è il calcolo distribuito?
Nel calcolo distribuito utilizziamo più computer che lavorano insieme su un unico problema. Invece di affidarci a una singola macchina, dividiamo i compiti in parti più piccole e li assegniamo a una rete di computer, che chiamiamo “nodi”. Questi nodi condividono il carico di elaborazione e l’archiviazione dei dati, collaborando per portare a termine i task.
Questo approccio è utile quando si affrontano problemi o dataset su larga scala, troppo grandi o complessi per essere gestiti da un singolo computer. Ad esempio, un sistema di calcolo distribuito può elaborare petabyte di dati per i motori di ricerca, eseguire simulazioni per la ricerca scientifica o alimentare modelli finanziari per l’analisi dei mercati.
Calcolo distribuito vs calcolo parallelo
Il calcolo distribuito e il calcolo parallelo vengono spesso confusi e possono sembrare intercambiabili. Entrambi implicano processi multipli che lavorano verso un unico obiettivo, ma sono approcci distinti pensati per scenari diversi.
Il calcolo distribuito si concentra sull’uso di una rete di macchine separate, spesso geograficamente disperse, per risolvere i problemi in modo collaborativo. Ogni macchina opera come un nodo indipendente con la propria memoria e potenza di elaborazione. La comunicazione tra i nodi avviene tramite rete e i compiti vengono suddivisi per essere eseguiti su macchine diverse.
Il calcolo parallelo, invece, avviene in genere all’interno di un singolo sistema. Utilizza più processori o core all’interno di un computer per eseguire i compiti simultaneamente. Questi processori condividono la stessa memoria e collaborano strettamente per suddividere i calcoli.
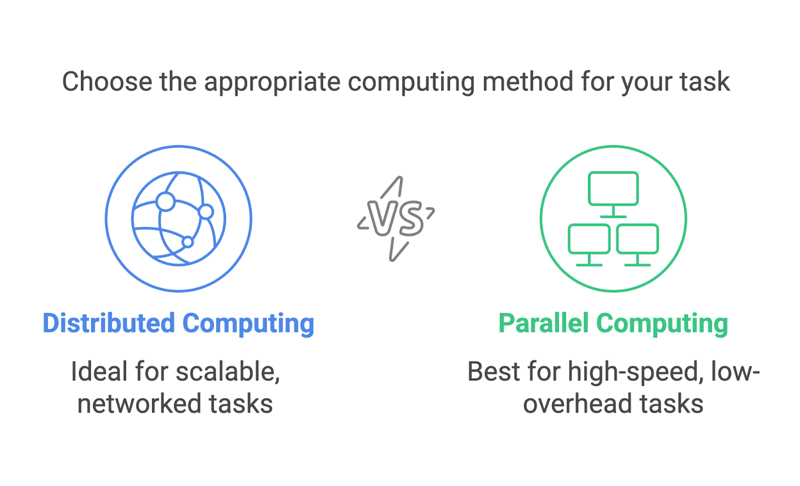
Prendiamo un esempio pratico: stiamo ordinando un dataset enorme. Nel calcolo parallelo, suddivideremmo il dataset in blocchi e ogni processore della stessa macchina gestirebbe un blocco. Nel calcolo distribuito, il dataset verrebbe suddiviso e inviato a macchine diverse, ognuna delle quali ordinerebbe in modo indipendente la propria porzione. Le parti ordinate verrebbero poi unite.
Entrambi i metodi sono estremamente utili, ma adatti a compiti diversi. Il calcolo parallelo è ideale per attività che richiedono calcolo ad alta velocità con minimo overhead di comunicazione, come le simulazioni su un supercomputer. Il calcolo distribuito è più adatto quando serve scalare orizzontalmente, ad esempio per elaborare dati in sistemi basati sul cloud o su reti globali.
Casi d’uso del calcolo distribuito
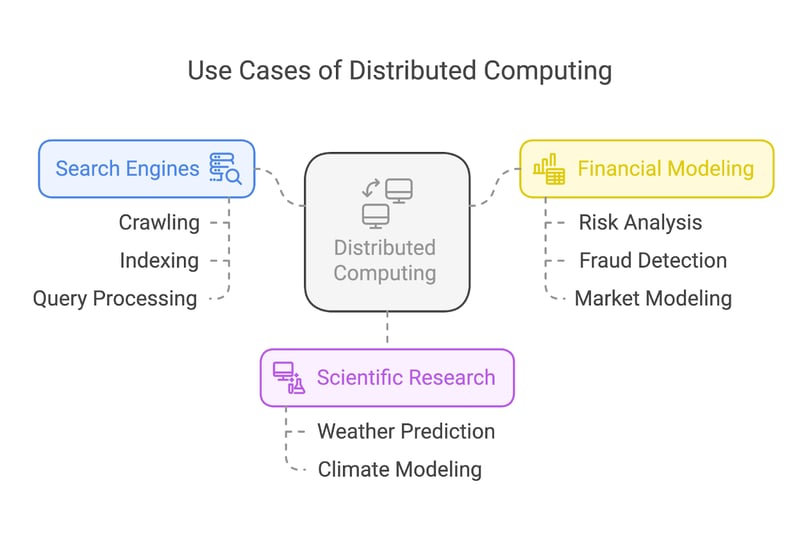
Il calcolo distribuito alimenta alcune delle applicazioni più impattanti del nostro mondo. Vediamo tre casi d’uso comuni: motori di ricerca, ricerca scientifica e modellazione finanziaria.
Motori di ricerca
Motori di ricerca come Google si affidano in modo massiccio al calcolo distribuito per eseguire il crawling e indicizzare miliardi di pagine web. Invece di assegnare il compito a una singola macchina, questi sistemi dividono il carico di lavoro tra tantissimi nodi.
Alcuni nodi si concentrano sul crawling delle pagine web, altri gestiscono l’indicizzazione e un altro gruppo elabora le query degli utenti in tempo reale. Questa divisione del lavoro garantisce risultati di ricerca rapidi ed efficienti, a prescindere dalla scala del compito.
Ricerca scientifica
Nella ricerca scientifica, il calcolo distribuito consente di raggiungere nuove scoperte eseguendo simulazioni complesse e analizzando enormi dataset. Per esempio, i climatologi usano sistemi distribuiti per modellare e prevedere gli schemi meteorologici o simulare gli effetti del riscaldamento globale.
Modellazione finanziaria
Il settore finanziario si affida al calcolo distribuito per attività come analisi del rischio, rilevamento delle frodi e modellazione dei mercati.
L’elaborazione degli enormi dataset generati dai mercati finanziari globali richiede sistemi in grado di lavorare senza sosta e con grande rapidità. Il calcolo distribuito consente alle aziende finanziarie di analizzare dati, testare modelli e generare insight a velocità tali da mantenerle competitive nei mercati in tempo reale.
Componenti chiave del calcolo distribuito
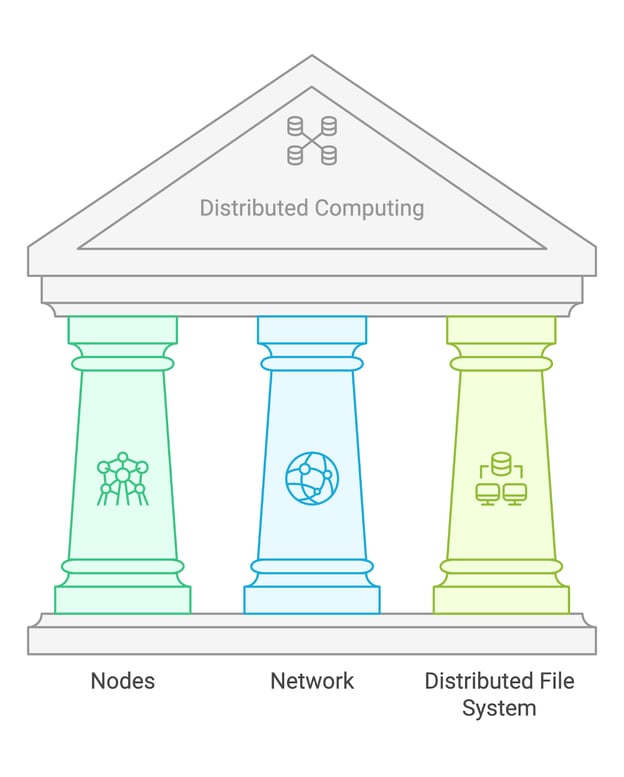
Il calcolo distribuito si basa su tre elementi fondamentali: nodi, rete e file system distribuito (DFS).
Nodi
I nodi sono le singole macchine che eseguono i calcoli all’interno di un sistema distribuito. Ogni nodo può agire in modo indipendente, elaborando i task assegnati e comunicando con gli altri nodi per condividere i risultati. In alcuni casi, i nodi possono avere ruoli specializzati, come la gestione dei task o l’archiviazione dei dati.
Rete
La rete è l’infrastruttura di comunicazione che collega i diversi nodi. Consente lo scambio di dati e il coordinamento dei compiti. A seconda delle dimensioni del sistema, può trattarsi di reti locali (LAN) o reti geografiche (WAN) per nodi dispersi geograficamente.
File system distribuito (DFS)
Un file system distribuito è una soluzione di archiviazione che consente di accedere ai dati su più nodi. Un esempio diffuso è l’Hadoop Distributed File System (HDFS), progettato per gestire grandi dataset e garantire la tolleranza ai guasti replicando i dati su più nodi.
Architetture comuni del calcolo distribuito
D’accordo, abbiamo un carico di lavoro distribuito su diversi nodi tramite una rete, e tutti i nodi hanno accesso ai dati tramite un DFS. Ma chi decide quale nodo fa cosa?
Non esiste una sola risposta, perché i sistemi di calcolo distribuito possono essere organizzati in vari modi. Detto ciò, esistono tre architetture comuni: master-slave, peer-to-peer e client-server.
Master-slave
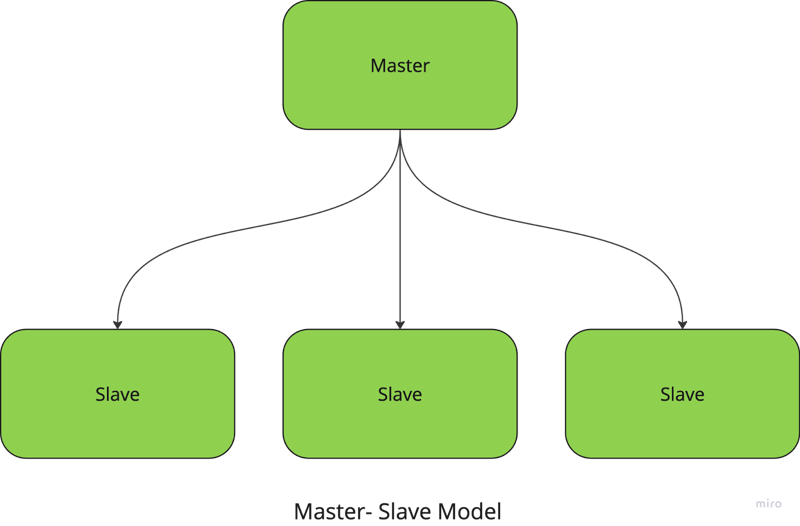
Nel modello master-slave, un nodo centrale (il nodo master) gestisce e coordina i task mentre i nodi slave eseguono i calcoli effettivi. Il master si occupa di suddividere i compiti in parti più piccole, distribuirli agli slave e raccogliere i risultati.
Per esempio, se stai eseguendo un’attività di elaborazione di immagini su larga scala, il nodo master assegna a ciascun nodo slave una porzione specifica di immagini da elaborare. Una volta completati i compiti, il master raccoglie i risultati e li combina nell’output finale.
Questo approccio semplifica la gestione e il coordinamento dei task, ma ha un forte svantaggio: il sistema presenta un singolo punto di guasto, poiché dipende interamente dal nodo master.
Peer-to-peer
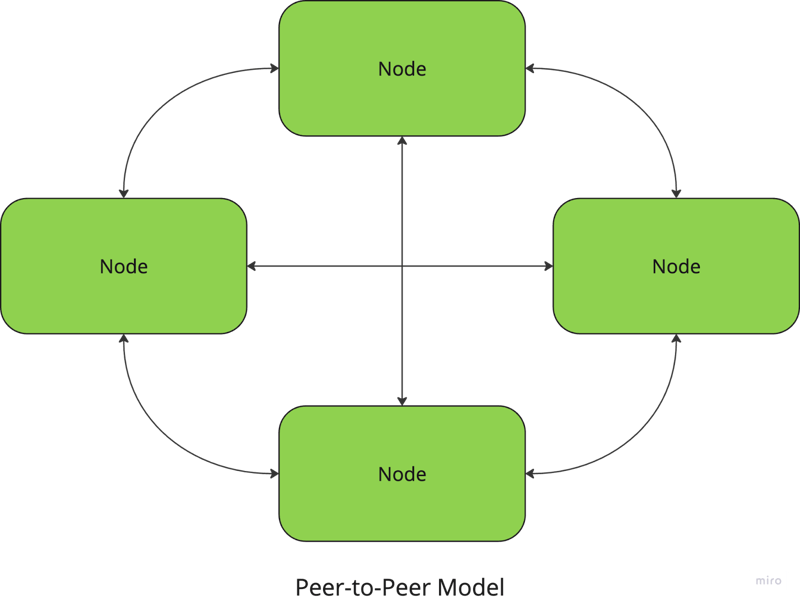
Nell’architettura peer-to-peer, tutti i nodi sono uguali e non esiste un coordinatore centrale. Ogni nodo può agire sia da client sia da server, condividendo risorse e comunicando direttamente con gli altri nodi.
Ad esempio, le reti di condivisione file come BitTorrent usano un approccio P2P, in cui gli utenti scaricano e caricano porzioni di file direttamente da e verso altri peer.
Il lato positivo è che questi sistemi non hanno un punto centrale di guasto, risultando resilienti e scalabili, ma il coordinamento tra nodi (per garantire, ad esempio, la coerenza dei dati) può essere più complesso.
Client-server
Nel modello client-server, uno o più server forniscono risorse o servizi a più nodi client. I client inviano richieste al server, che le elabora e restituisce i risultati. Questa architettura è comunemente usata nelle applicazioni web e nei database.
Potrebbe sembrare simile al modello master-slave, con il server nel ruolo di master, ma c’è una differenza: il server è di solito più passivo e non suddivide o delega i compiti—si limita a rispondere alle richieste dei client.
Con questo modello, la gestione e il controllo centralizzati rendono più semplice mantenere e aggiornare il sistema, ma il server rappresenta un collo di bottiglia che può limitare la scalabilità. Un’interruzione del server può inoltre bloccare l’intero sistema.
Queste tre architetture sono tra le più comuni nei sistemi distribuiti, ma esistono altri modelli che potresti aver incontrato (sono sicuro che hai sentito parlare dell’architettura basata sul cloud!).
Ogni modello risponde a esigenze diverse e la scelta dell’architettura può avere un forte impatto su prestazioni, tolleranza ai guasti e scalabilità, quindi è importante definire bene il problema prima di scegliere un approccio. La buona notizia è che non devi sceglierne solo uno! La maggior parte dei sistemi moderni, soprattutto nel cloud computing, utilizza versioni ibride di queste architetture per combinarne i punti di forza.
Configurare sistemi di calcolo distribuito
Ora che abbiamo visto la teoria alla base del calcolo distribuito, vediamo come configurare concretamente un sistema di questo tipo.
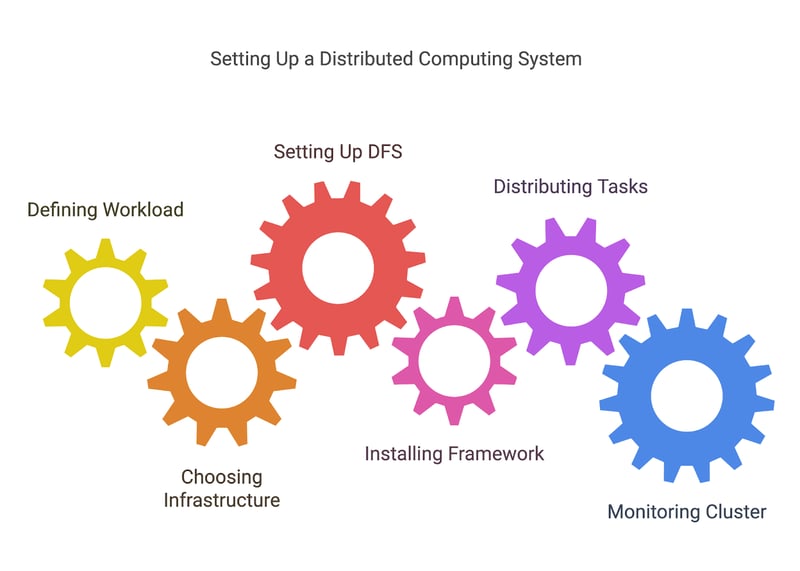
1. Definire il carico di lavoro
Prima di poter distribuire i compiti, devi definire quali compiti stai distribuendo. Spesso questo comporta scomporre un problema più grande in unità di lavoro più piccole e indipendenti che possano essere elaborate in parallelo o distribuite tra i nodi.
Per esempio, se stai elaborando un grande dataset, potresti dividere i dati in blocchi gestibili da macchine o processori diversi.
2. Scegliere l’infrastruttura
Il calcolo distribuito richiede una rete di macchine, che si tratti di server on-premise, istanze cloud (come AWS, Azure o Google Cloud) o di un mix di entrambi. Dovrai decidere come configurare queste macchine, assicurandoti che siano connesse e possano comunicare tra loro.
- Infrastruttura basata sul cloud: piattaforme come AWS, Google Cloud e Azure semplificano l’avvio di cluster di calcolo distribuito senza dover gestire l’hardware fisico. Queste piattaforme offrono spesso servizi gestiti come AWS EC2 (per la potenza di calcolo) e S3 (per lo storage distribuito), rendendo più semplice impostare sistemi scalabili.
- On-premise o ibrida: se utilizzi server propri o un mix di risorse on-premise e cloud, dovrai configurare la tua rete, impostare i nodi e assicurare una comunicazione affidabile tra di essi.
3. Configurare un file system distribuito (DFS)
Come abbiamo detto, uno degli elementi più importanti nel calcolo distribuito è garantire che tutti i nodi abbiano accesso ai dati di cui hanno bisogno. HDFS di Hadoop o altre soluzioni DFS consentono di archiviare grandi dataset su più nodi, con ridondanza per evitare la perdita di dati se un nodo si guasta.
4. Configurare il framework o lo strumento
Una volta predisposta l’infrastruttura, devi configurare lo strumento scelto per il calcolo distribuito. Ogni framework ha il proprio processo di installazione e configurazione, che può includere:
- Installare il software richiesto su ciascun nodo oppure utilizzare una soluzione cloud che installi e configuri automaticamente lo strumento per te.
- Configurare le impostazioni del cluster, come il numero di nodi worker, l’allocazione delle risorse e la gestione della tolleranza ai guasti.
5. Distribuire i task
Una volta pronto l’ambiente, puoi iniziare a distribuire i task tra i nodi. La maggior parte degli strumenti ti aiuta in questo processo, suddividendo il carico di lavoro e assegnando i compiti ai nodi diversi.
Di solito dovrai scrivere codice che definisca come suddividere i task (job MapReduce per Hadoop, trasformazioni e azioni per Spark, ecc.) o usare le API del framework per gestire la distribuzione e la comunicazione tra i nodi.
6. Monitorare e gestire il cluster
I sistemi distribuiti possono diventare complessi e tenere traccia di prestazioni, guasti e uso delle risorse è fondamentale per assicurarsi che tutto funzioni senza intoppi. Molti strumenti offrono dashboard integrate per il monitoraggio, ma potresti aver bisogno anche di soluzioni aggiuntive (come Prometheus o Grafana) per monitorare lo stato dei nodi, le prestazioni e l’avanzamento dei job.
Strumenti e framework per il calcolo distribuito
Come abbiamo appena visto, lo strumento giusto può aiutarti ad avviare il calcolo distribuito e a gestire gran parte del lavoro pesante nella gestione degli ambienti distribuiti. Diamo un’occhiata più da vicino ad alcuni tra i più popolari.
Apache Hadoop
Apache Hadoop è un framework open-source progettato per elaborare enormi quantità di dati su un cluster distribuito di computer. Utilizza il modello di programmazione MapReduce, che scompone grandi compiti in porzioni più piccole e parallelizzabili.
Hadoop è particolarmente utile per gestire petabyte di dati ed è ottimo per scalabilità, tolleranza ai guasti e flessibilità nello storage. Il suo ecosistema include vari componenti, come l’Hadoop Distributed File System (HDFS) per lo storage distribuito e strumenti per l’elaborazione batch, motivo per cui è una delle soluzioni di riferimento per molte applicazioni di big data.
La configurazione dell’infrastruttura può essere complessa, poiché richiede comunque l’impostazione dei nodi, la gestione delle risorse del cluster e l’assicurazione della tolleranza ai guasti.
Per saperne di più su Hadoop, leggi questo articolo sulle domande di colloquio su Hadoop. È utile per prepararti a un colloquio ed è anche ricco di curiosità sullo strumento e sui suoi casi d’uso.
Apache Spark
Apache Spark è un motore veloce e generico per l’elaborazione di dati su larga scala.
Poiché si basa su Hadoop, Spark può essere eseguito sopra cluster Hadoop esistenti o con un proprio gestore di cluster. A differenza di Hadoop, che utilizza storage su disco, Spark offre computazione in memoria e può elaborare i dati molto più rapidamente.
Può essere utilizzato per un’ampia gamma di elaborazioni, tra cui batch processing, streaming in tempo reale, machine learning e graph processing. Supporta linguaggi come Python, Scala e Java e si integra con piattaforme cloud come AWS e Azure.
Dask
Ti ricordi quando abbiamo parlato di calcolo parallelo? Ecco, Dask è una libreria di calcolo parallelo in Python progettata per scalare da una singola macchina a grandi cluster distribuiti.
È una scelta ideale per gestire grandi dataset e compiti computazionali complessi, poiché si integra con altre librerie Python come NumPy, Pandas e Scikit-learn e offre un ambiente familiare agli utenti Python.
La sua capacità di lavorare sia in ambienti distribuiti sia locali significa che puoi usarlo tanto per un progetto piccolo quanto per una pipeline dati enorme. Richiede comunque un certo livello di configurazione per il calcolo distribuito, anche se molto è automatizzato rispetto a Hadoop e Spark.
Conclusione
Spero che ti sia piaciuto scoprire le basi del calcolo distribuito! Questo articolo, però, è solo un punto di partenza. Il campo del calcolo distribuito vede emergere ogni anno innumerevoli strumenti, framework e tecniche.
Se vuoi provare a creare sistemi distribuiti, ti consiglio di iscriverti a un provider cloud come AWS o GCP. Entrambi offrono crediti all’iscrizione, così puoi testare la loro infrastruttura e configurare piccoli progetti gratuitamente!
Se hai già dimestichezza con le basi e vuoi far crescere la tua carriera nei dati, puoi seguire una delle tante certificazioni Apache Spark disponibili online.
Buon coding!
FAQ
Ho bisogno di hardware specializzato per il calcolo distribuito?
Non necessariamente: puoi usare macchine normali, ma per task ad alte prestazioni potresti beneficiare di hardware ottimizzato.
Il calcolo distribuito è sempre più veloce?
Non sempre. L’overhead di coordinamento e comunicazione può a volte superare i benefici per i compiti più piccoli.
Quanta programmazione serve per configurare un sistema distribuito?
Gli strumenti semplificano il processo, ma serve una buona comprensione di programmazione, networking e basi di progettazione dei sistemi.

Autore
Marie Fayard
Sono una tech lead orientata al prodotto, specializzata nel far crescere startup nelle fasi iniziali, dal primo prototipo al product-market fit e oltre. Sono instancabilmente curiosa di come le persone usano la tecnologia e adoro lavorare a stretto contatto con founder e team cross‑funzionali per dare vita a idee ambiziose. Quando non costruisco prodotti, inseguo l’ispirazione in angoli nuovi del mondo o scarico le tensioni in una sala yoga.





Se hai lavorato su sistemi con calcoli complessi o elevati requisiti di analisi dei dati, probabilmente hai visto quanto fatichino le singole macchine a stare al passo. Anche i computer potenti possono raggiungere i propri limiti quando elaborano dataset enormi, soprattutto in aree come l’analisi dei dati in tempo reale o il machine learning.
È qui che entra in gioco il calcolo distribuito. Suddividendo i compiti tra più macchine, sfrutta la loro potenza combinata per superare sfide troppo impegnative per un singolo sistema. Questo ci permette, in quanto ingegneri, di creare un’ampia gamma di applicazioni, dai motori di ricerca che indicizzano miliardi di pagine web alle simulazioni sul cambiamento climatico.
In questo articolo ti presenterò il calcolo distribuito, ne analizzerò i componenti e le architetture principali, spiegherò come configurare un sistema distribuito e passerò in rassegna alcuni degli strumenti disponibili.