Last chance! 50% off DataCamp Premium
Sale ends in
Jika Anda membangun aplikasi modern, Anda tahu betapa pentingnya menangani data berukuran besar secara efisien. Platform event streaming adalah solusi andalan untuk pemrosesan dan analisis data real time.
Dalam artikel ini, kita akan membahas dua platform paling populer di ranah ini: Apache Kafka dan Amazon Simple Queue Service (SQS). Kita akan membandingkan kelebihan dan kekurangan masing-masing platform serta memberikan wawasan praktis untuk membantu Anda membuat keputusan tepat bagi proyek berbasis data Anda.
Bagi Anda yang sudah tahu persis apa yang dicari dan hanya membutuhkan perbandingan cepat antara Apache Kafka dan Amazon SQS, tabel di bawah ini dapat menjadi panduan ringkas. Namun, jika Anda membutuhkan pembahasan lebih detail, lanjutkan membaca untuk perbandingan yang komprehensif.
|
Kategori |
Kafka |
SQS |
Pemenang |
|
Arsitektur |
Terdistribusi, pub-sub |
Tersentralisasi, berbasis pull |
Kafka |
|
Skalabilitas |
Sangat skalabel untuk volume besar |
Sangat skalabel untuk volume lebih kecil |
Kafka untuk besar, SQS untuk kecil |
|
Persistensi Pesan |
Periode retensi dapat dikonfigurasi |
Periode retensi terbatas |
Kafka |
|
Pengiriman Pesan |
At-least-once, exactly-once dengan transaksi |
At-least-once, exactly-once dengan deduplikasi |
Seri |
|
Kelompok Konsumen |
Didukung |
Tidak didukung |
Kafka |
|
Integrasi |
Ekosistem luas, konektor |
Integrasi AWS yang erat |
Kafka untuk non-AWS, SQS untuk AWS |
|
Kemudahan Penggunaan |
Kurva belajar lebih terjal |
Dikelola penuh, mudah memulai |
SQS |
|
Biaya |
Sumber terbuka, biaya infrastruktur |
Bayar sesuai pemakaian |
SQS untuk beban kerja kecil, Kafka untuk besar |
|
Retensi Pesan |
Lebih lama |
14 hari |
Kafka |
|
Dukungan Protokol |
Banyak |
Terbatas |
Kafka |
|
Tingkat Kesulitan Sintaks |
Lebih kompleks |
Sederhana dan lugas |
SQS |
Platform event streaming seperti Apache Kafka dan Amazon SQS menjadi pilihan utama di lingkungan modern yang digerakkan data. Platform ini memungkinkan Anda mengumpulkan, memproses, dan menganalisis data saat data tersebut dihasilkan, sehingga pengambilan keputusan lebih cepat dan responsivitas meningkat.
Berikut beberapa alasan mengapa platform streaming seperti Kafka dan SQS itu penting:
Platform event streaming memungkinkan pengumpulan data berkelanjutan dan pemrosesan data secara real time. Kemampuan ini relevan untuk aplikasi yang membutuhkan wawasan dan tindakan segera, seperti sistem perdagangan finansial, deteksi penipuan, dan pemantauan media sosial. Dengan memproses data saat tiba, Anda dapat mengambil keputusan tepat waktu dan merespons dengan cepat terhadap peristiwa yang muncul.
Platform ini mendukung komunikasi asinkron, memisahkan produsen dan konsumen data. Pemisahan ini memungkinkan komponen sistem yang berbeda beroperasi secara independen, meningkatkan ketahanan dan fleksibilitas. Komunikasi asinkron juga memungkinkan layanan diskalakan secara independen dan berevolusi tanpa mengganggu komponen lain.
Baik Kafka maupun SQS dirancang untuk skalabilitas dan keandalan tinggi. Kafka dapat menangani jutaan peristiwa per detik dengan penskalaan horizontal melalui penambahan broker. SQS melakukan penskalaan otomatis untuk menangani peningkatan volume pesan, sehingga cocok untuk beban kerja yang bervariasi. Kapabilitas ini memastikan platform mampu memenuhi tuntutan tugas pemrosesan data skala besar.
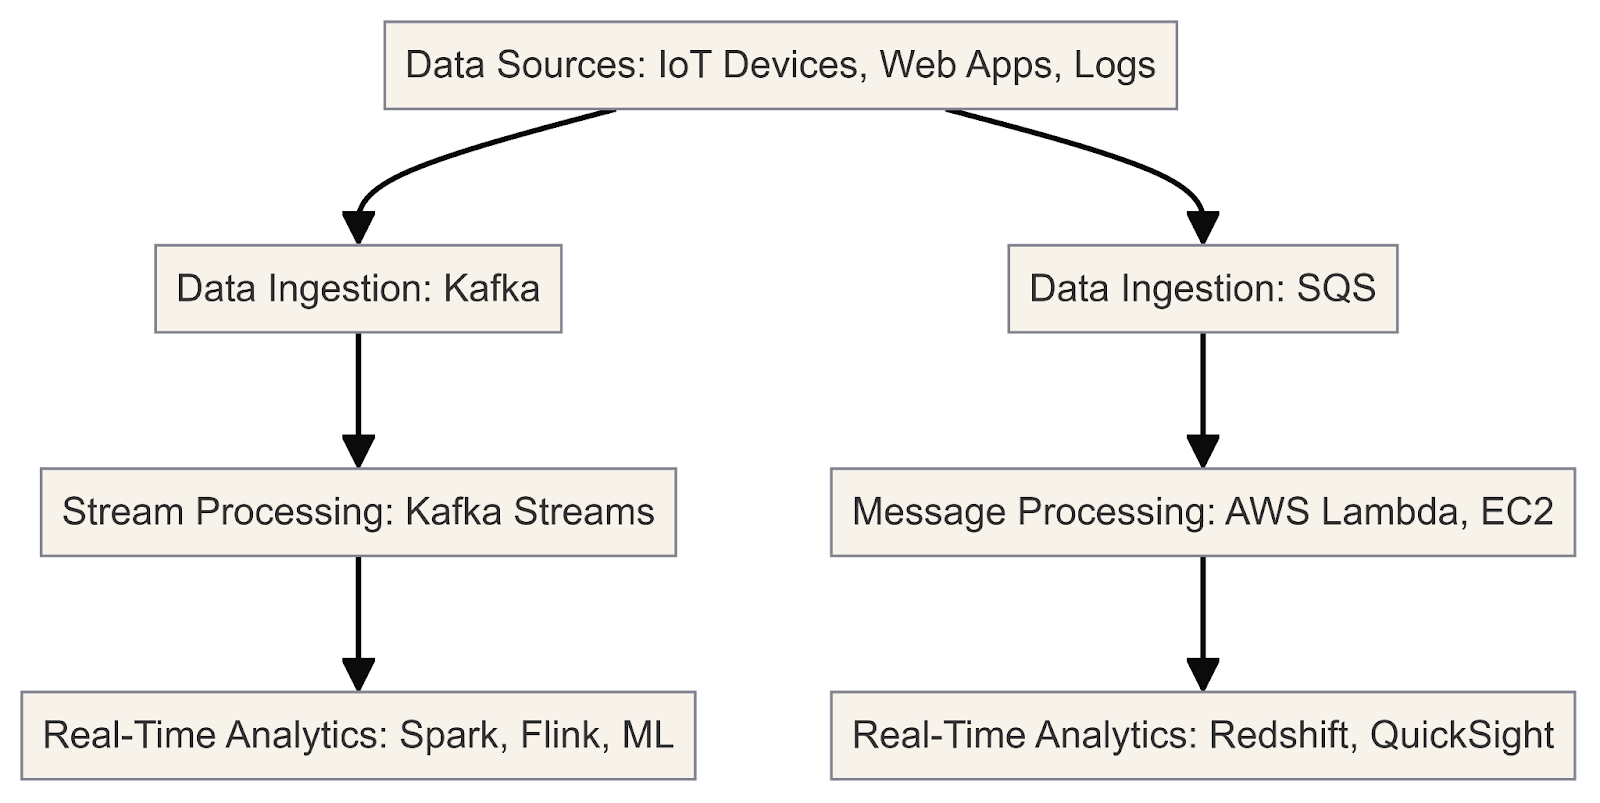
Diagram ini menggambarkan alur kerja pemrosesan dan analisis data real time menggunakan Kafka dan SQS
Setelah kita memahami pentingnya platform streaming, mari kita ulas Kafka dan SQS secara rinci.
Apache Kafka adalah platform event streaming terdistribusi sumber terbuka yang dirancang untuk menangani aliran data real time berukuran besar. Kafka sering digunakan untuk tugas seperti messaging, agregasi log, pemrosesan stream, dan commit log.
Arsitektur Kafka dibangun untuk skalabilitas tinggi dan toleransi kesalahan, menjadikannya solusi andalan untuk aplikasi berbasis data. Anggap Kafka sebagai pipeline data berperforma tinggi yang memudahkan Anda membangun pipeline data dan aplikasi real time dengan mudah.
Sebagai pengembang, Anda dapat memanfaatkan komponen inti Kafka untuk menangani stream data real time secara efisien. Berikut contoh praktis cara kerja Kafka dengan Python:
Kunjungi situs Apache Kafka dan unduh versi terbaru. Pilih unduhan biner yang sesuai dengan sistem operasi Anda.
Ekstrak arsip yang diunduh ke direktori pilihan Anda. Direktori ini akan menjadi direktori instalasi Kafka.
Di Terminal, arahkan ke direktori Kafka yang diekstrak dan jalankan layanan Zookeeper dan broker Kafka menggunakan skrip yang disediakan:
# Start Zookeeper
bin/zookeeper-server-start.sh config/zookeeper.properties
# Start Kafka broker
bin/kafka-server-start.sh config/server.properties
Perhatikan bahwa Zookeeper saat ini ditandai sebagai deprecated dan direncanakan akan dihapus pada Apache Kafka 4.0. Untuk detail lebih lanjut, lihat dokumentasinya.
Broker adalah server Kafka yang menangani penyimpanan dan replikasi stream data. Anda dapat berinteraksi dengan broker melalui alat baris perintah atau secara terprogram menggunakan pustaka klien.
Berikut contoh penggunaan alat baris perintah untuk mengelola dan berinteraksi dengan topik Kafka:
bin/kafka-topics.sh --create --topic my_topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1bin/kafka-topics.sh --list --bootstrap-server localhost:9092bin/kafka-console-producer.sh --topic my_topic --bootstrap-server localhost:9092bin/kafka-console-consumer.sh --topic my_topic --bootstrap-server localhost:9092 --from-beginningPastikan Anda telah menginstal Python pada sistem Anda. Pustaka klien Python untuk Kafka mendukung Python 3.7 dan versi yang lebih baru.
Buat virtual environment untuk mengisolasi dependensi proyek Anda. Anda dapat menggunakan venv.
Ini adalah pustaka klien Python resmi untuk Apache Kafka:
pip install kafka-pythonBergantung pada kebutuhan proyek Anda, Anda mungkin perlu memasang pustaka tambahan, seperti json, untuk serialisasi/deserialisasi JSON.
Kemudian, gunakan skrip berikut untuk membuat daftar broker secara terprogram:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# List the available brokers
brokers = admin_client.describe_cluster()
print("Brokers:", brokers['brokers'])Partisi adalah cara Kafka mencapai paralelisme dan skalabilitas. Setiap partisi merupakan urutan rekaman yang terurut dan tidak dapat diubah, yang terus ditambahkan. Anda dapat mengonfigurasi jumlah partisi untuk sebuah topik saat membuatnya:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# Create a new topic with 3 partitions
topic = NewTopic(name="social-media-posts", num_partitions=3, replication_factor=1)
admin_client.create_topics([topic])
Memahami partisi membantu Anda mengoptimalkan aplikasi untuk performa dan toleransi kesalahan yang lebih baik.
Dengan Kafka dan pustaka Python yang diperlukan terpasang, Anda kini dapat mulai menulis aplikasi producer dan consumer Kafka di Python.
Berikut contoh cara membuat producer Kafka untuk menerbitkan postingan media sosial dan consumer untuk memprosesnya:
Producer adalah klien yang menerbitkan stream data ke topik Kafka. Producer dapat diintegrasikan ke dalam aplikasi, layanan, atau sumber data Anda untuk mendorong data ke Kafka secara real time.
from kafka import KafkaProducer
import json

# Create a Kafka producer
producer = KafkaProducer(bootstrap_servers='localhost:9092',
                         value_serializer=lambda m: json.dumps(m).encode('utf-8'))

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Publish the social media post to the 'social-media-posts' topic
producer.send('social-media-posts', social_media_post)Consumer adalah klien yang berlangganan satu atau beberapa topik dan mengonsumsi stream data dari Kafka. Consumer dapat menerapkan berbagai pola konsumsi sesuai kebutuhan aplikasi Anda.
from kafka import KafkaConsumer
import json

# Create a Kafka consumer
consumer = KafkaConsumer('social-media-posts',
                         bootstrap_servers='localhost:9092',
                         value_deserializer=lambda m: json.loads(m.decode('utf-8')))

# Consume and process social media posts
for message in consumer:
    social_media_post = message.value
    print(f"Received post: {social_media_post}")
    # Process the social media post...
Contoh kode ini memberikan gambaran menyeluruh tentang pemasangan Kafka, penyiapan lingkungan Python, dan penerapan producer serta consumer Kafka untuk pemrosesan data real time.
SQS adalah layanan antrian pesan yang dikelola sepenuhnya oleh AWS. Layanan ini memungkinkan Anda memisahkan dan menskalakan microservices, sistem terdistribusi, dan aplikasi serverless.
Intinya, SQS adalah sistem antrian terdistribusi yang memungkinkan Anda mengirim, menyimpan, dan menerima pesan antar komponen perangkat lunak secara asinkron. Pesan ini bisa berupa data teks apa pun, notifikasi sistem, atau bahkan pointer ke data yang lebih besar yang disimpan di layanan AWS lain seperti S3 atau DynamoDB.
Salah satu manfaat utama SQS adalah Anda tidak perlu mengelola infrastruktur antrian pesan. AWS menangani manajemen antrian, penskalaan, dan toleransi kesalahan di balik layar, sehingga Anda dapat fokus pada logika aplikasi.
SQS menawarkan dua jenis antrian:
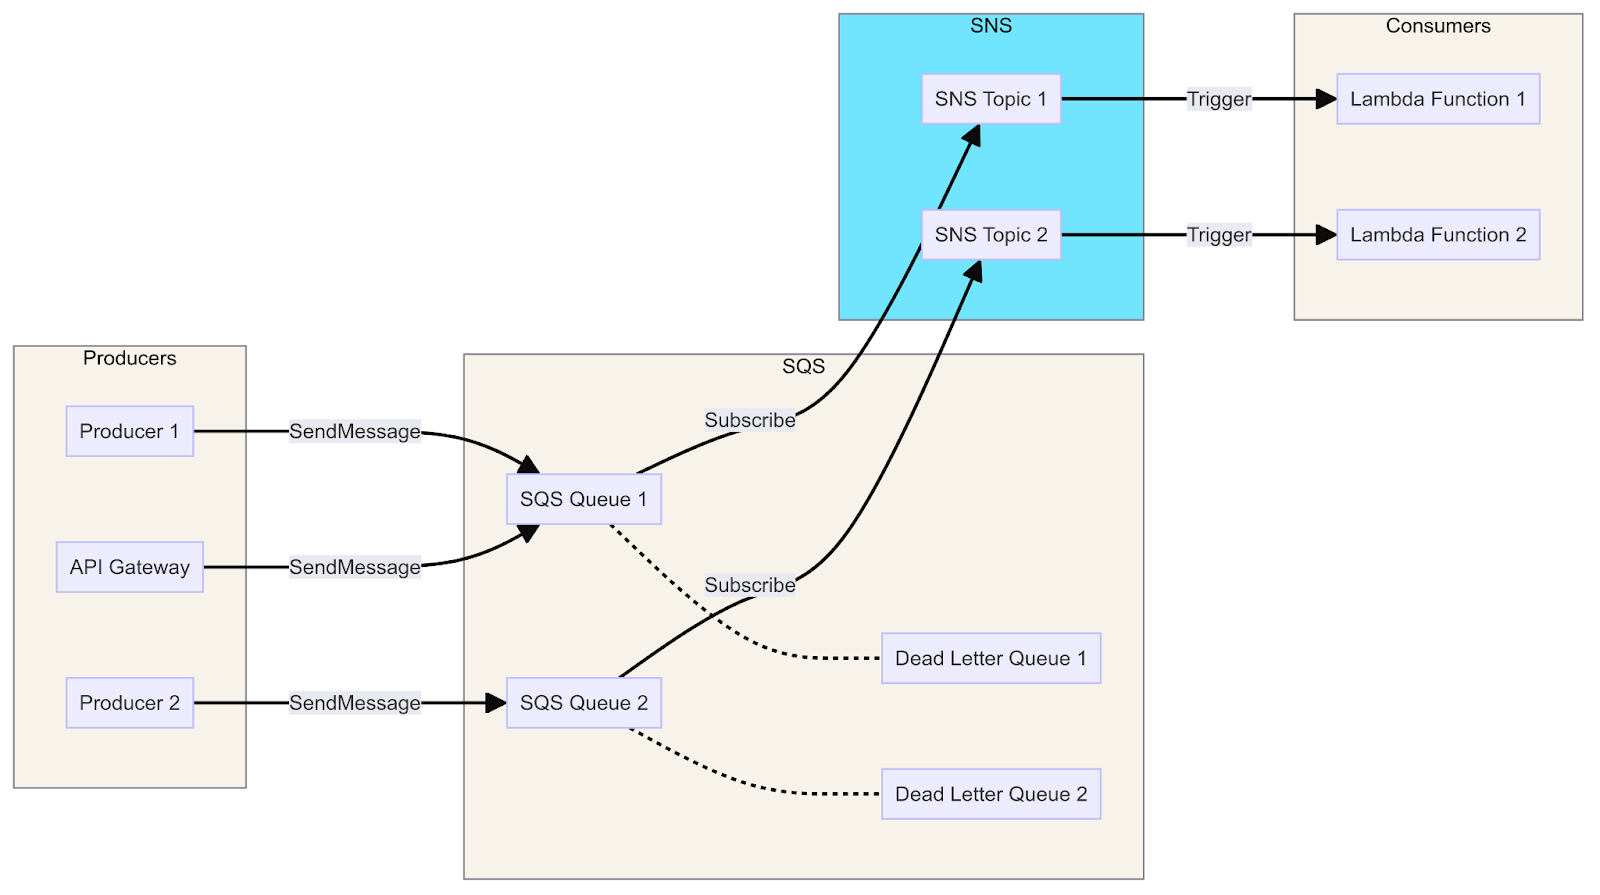
Salah satu keunggulan SQS adalah menjadi bagian dari ekosistem AWS, sehingga mudah diintegrasikan dengan layanan AWS lainnya. Cara integrasi bergantung pada apakah sebuah layanan bertindak sebagai produsen atau konsumen:
Diagram yang menunjukkan integrasi SQS dengan Lambda, SNS, dan API Gateway, menggambarkan aliran pesan dari produsen ke konsumen melalui antrian, topik, dan fungsi.
Sekarang mari kita lihat produsen dan konsumen dalam aksi. Berikut panduan menyiapkan dan menggunakan AWS SQS dengan Python, termasuk langkah dasar instalasi serta contoh producer dan consumer untuk SQS:
Jika Anda belum memiliki, buat akun AWS di AWS Free Tier.
Instal dan konfigurasikan AWS Command Line Interface (CLI) untuk mengelola sumber daya AWS Anda.
# Install AWS CLI
pip install awscli

# Configure AWS CLI with your credentials
aws configure
Berikan access key, secret key, region, dan format output AWS Anda saat diminta.
Kita akan menggunakan pustaka boto3, SDK resmi AWS untuk Python, untuk berinteraksi dengan SQS menggunakan Python.
boto3pip install boto3Buat antrian SQS menggunakan AWS Management Console atau secara terprogram menggunakan boto3.
import boto3

# Create SQS client
sqs = boto3.client('sqs')

# Create a new queue
response = sqs.create_queue(
    QueueName='social-media-posts',
    Attributes={
        'DelaySeconds': '0',
        'MessageRetentionPeriod': '86400'  # 1 day
    }
)
print(response['QueueUrl'])Producer mengirim pesan ke antrian SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Send message to SQS queue
response = sqs.send_message(
    QueueUrl=queue_url,
    MessageBody=json.dumps(social_media_post)
)
print(response['MessageId'])Consumer menerima dan memproses pesan dari antrian SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Receive messages from SQS queue
response = sqs.receive_message(
    QueueUrl=queue_url,
    MaxNumberOfMessages=10,
    WaitTimeSeconds=10
)

if 'Messages' in response:
    for message in response['Messages']:
        social_media_post = json.loads(message['Body'])
        print(f"Received post: {social_media_post}")

        # Process the social media post...

        # Delete received message from queue
        sqs.delete_message(
            QueueUrl=queue_url,
            ReceiptHandle=message['ReceiptHandle']
        )

else:
    print('No messages received')
Begitulah cara Anda membuat antrian SQS, mengirim pesan sebagai producer, dan menerima pesan sebagai consumer dengan mudah. Contoh sebelumnya mencakup langkah dasar untuk memulai.
Untuk langkah penyiapan yang lebih detail, pastikan Anda membaca dokumentasi AWS SQS.
Sekarang, mari kita bandingkan Kafka dan SQS secara berdampingan dan lihat persamaannya.
Kafka dan SQS sama-sama merupakan sistem antrian pesan yang dirancang untuk memfasilitasi komunikasi asinkron antara komponen berbeda dalam sistem terdistribusi. Keduanya bertindak sebagai perantara, memungkinkan produsen mengirim pesan dan konsumen menerima serta memproses pesan tersebut.
Kafka dan SQS memisahkan produsen dan konsumen, sehingga mereka dapat beroperasi dan diskalakan secara independen. Pemisahan ini mendorong loose coupling, toleransi kesalahan, dan skalabilitas pada sistem terdistribusi.
Baik Kafka maupun SQS menyediakan mekanisme untuk menyimpan pesan secara persisten, memastikan pesan tidak hilang jika terjadi kegagalan atau restart sistem. Kafka menyimpan pesan dalam commit log terdistribusi, sedangkan SQS menyimpan pesan dalam antrian yang sangat tahan lama dan tersedia.
Kafka dan SQS dirancang sebagai sistem yang sangat skalabel. Kafka dapat melakukan penskalaan horizontal dengan menambahkan lebih banyak broker ke kluster, sedangkan SQS dapat melakukan penskalaan otomatis untuk menangani peningkatan volume pesan.
Kafka dan SQS menawarkan kemampuan integrasi dengan sistem dan layanan lain. Kafka memiliki ekosistem konektor dan integrasi yang luas, sedangkan SQS terintegrasi mulus dengan layanan AWS lainnya.
Meski Kafka dan SQS memiliki jaminan pengurutan yang berbeda secara default, keduanya menyediakan mekanisme untuk mempertahankan pengurutan pesan saat diperlukan. Kafka menawarkan pengiriman berurutan dalam partisi, sementara SQS menyediakan antrian FIFO untuk pemrosesan pesan yang benar-benar berurutan.
Kafka dan SQS menyediakan kemampuan pemantauan dan metrik, memungkinkan pengguna melacak dan memantau performa serta kesehatan sistem messaging mereka.
Baik Kafka maupun SQS menawarkan fitur keamanan, seperti enkripsi, kontrol akses, dan mekanisme autentikasi, untuk melindungi data saat transit maupun saat tersimpan.
Sekarang, mari kita bandingkan Kafka dan SQS secara berdampingan dan catat perbedaan terpentingnya.
Kafka adalah platform streaming terdistribusi yang mengikuti model publish-subscribe. Kafka terdiri dari kluster broker yang menyimpan dan mengelola stream data dalam topik. Produsen menerbitkan pesan ke topik, dan konsumen berlangganan topik untuk menerima pesan.
SQS adalah layanan messaging yang dikelola penuh oleh AWS. SQS mengikuti model berbasis antrian di mana pesan dikirim ke antrian, dan konsumen melakukan polling antrian untuk menerima pesan.
Kafka menyediakan semantik pengiriman “at-least-once”, artinya pesan dapat dikirim satu kali atau lebih. Kafka juga mendukung “exactly-once” melalui penggunaan producer idempoten dan penulisan transaksional.
SQS menjamin pengiriman “at-least-once”. Untuk protokol lain seperti HTTP/HTTPS, email, dan SMS, Amazon SNS harus digunakan bersama SQS.
Kafka mempertahankan pengurutan pesan dalam partisi, memastikan pesan dikirim sesuai urutan saat diproduksi.
SQS tidak menjamin pengurutan pesan secara default. Namun, SQS mendukung topik FIFO yang mempertahankan urutan pesan secara persis.
Kafka menyimpan pesan di disk dalam commit log terdistribusi, memberikan daya tahan dan toleransi kesalahan. Pesan dapat dipertahankan untuk periode yang dapat dikonfigurasi, memungkinkan konsumen memundurkan dan memutar ulang pesan.
SQS tidak menyediakan persistensi pesan jangka panjang. Pesan disimpan sementara hingga dikirimkan ke semua pelanggan atau hingga kedaluwarsa (berdasarkan periode retensi yang dikonfigurasi).
Kafka dirancang untuk penskalaan horizontal dengan menambah broker ke kluster. Kafka juga mendukung pemartisian topik untuk paralelisme dan penyeimbangan beban.
SQS adalah layanan yang sepenuhnya dikelola dan melakukan penskalaan otomatis untuk menangani peningkatan volume pesan tanpa intervensi manual.
Kafka memiliki ekosistem konektor dan integrasi yang kaya dengan berbagai sumber data, tujuan, dan kerangka pemrosesan, seperti Apache Spark, Apache Flink, dan Apache Kafka Streams.
SQS terintegrasi mulus dengan layanan AWS lainnya, memungkinkan Anda mengirim notifikasi ke berbagai endpoint, termasuk fungsi AWS Lambda, antrian SQS, dan endpoint HTTP/HTTPS.
Kafka terutama menggunakan alat antarmuka baris perintah seperti kafka-topics untuk mengelola topik dan tugas administratif lainnya. Kafka tidak memiliki antarmuka pengguna bawaan khusus, tetapi alat pihak ketiga seperti Kafka Manager, Kafka Tool, dan Confluent Control Center menawarkan antarmuka web untuk mengelola kluster Kafka.
SQS, sebagai layanan yang sepenuhnya dikelola, terintegrasi mulus dengan AWS Management Console. Antarmuka web ini memungkinkan pengguna dengan mudah membuat, mengonfigurasi, dan memantau antrian SQS tanpa memerlukan alat tambahan.
Kafka menawarkan pustaka klien untuk berbagai bahasa, seperti Java, Python, dan Go. Sintaksnya bisa kompleks karena konsep seperti topik, partisi, offset, dan kelompok konsumen.
SQS menyediakan SDK untuk banyak bahasa, termasuk Java, Python, dan Node.js. Sintaksnya lebih sederhana dan berfokus pada pengiriman dan penerimaan pesan ke dan dari antrian. Sintaks SQS lebih lugas, sementara sintaks Kafka lebih kompleks karena sifatnya yang terdistribusi dan fitur canggihnya.
Harga Kafka bervariasi tergantung pada model penerapan (dikelola sendiri atau layanan terkelola seperti Confluent Cloud atau Amazon MSK).
SQS mengikuti model bayar sesuai pemakaian berdasarkan jumlah permintaan dan transfer data.
Setelah meninjau persamaan dan perbedaan, berikut perbandingan terperinci antara Apache Kafka dan Amazon SQS, dengan fokus pada pemenang tiap kategori, tergantung kasusnya.
Kafka adalah sistem messaging terdistribusi berbasis pub-sub yang beroperasi pada arsitektur log terdistribusi, di mana pesan dipertahankan dalam commit log terdistribusi.
Di sisi lain, SQS adalah sistem messaging berbasis pull yang dikelola penuh dan mengandalkan arsitektur message broker, dengan layanan pusat yang mengorkestrasi manajemen antrian.
Arsitektur terdistribusi Kafka membuatnya lebih skalabel dan tahan terhadap kegagalan, sedangkan arsitektur terpusat SQS menyederhanakan manajemen tetapi dapat menjadi bottleneck.
Kafka dan Amazon SQS sama-sama menawarkan skalabilitas tinggi. Kafka dikenal dengan kemampuan streaming yang ber-throughput tinggi, toleran terhadap kesalahan, dan skalabel secara horizontal. Kafka dapat menangani volume data besar dan memiliki periode retensi data yang panjang.
Amazon SQS dikenal mampu menangani jutaan pesan per detik dan penskalaan otomatis sebagai respons terhadap lalu lintas yang bervariasi.
Kafka lebih skalabel untuk menangani volume data besar dan menyediakan periode retensi lebih lama, sementara SQS lebih mudah diskalakan secara otomatis untuk beban kerja lebih kecil.
Kafka dirancang untuk memastikan persistensi data melalui sistem log yang direplikasi. Kafka menawarkan fleksibilitas dengan memungkinkan konfigurasi periode retensi dan ruang disk yang digunakan untuk penyimpanan data.
Di sisi lain, SQS memastikan persistensi pesan dengan menyimpan pesan di beberapa pusat data, meningkatkan daya tahan sistem. SQS memiliki periode retensi default 4 hari, yang dapat disesuaikan hingga maksimum 14 hari sesuai kebutuhan pengguna.
Kedua platform menawarkan persistensi pesan, tetapi Kafka memberikan fleksibilitas lebih dalam mengonfigurasi periode retensi dan penyimpanan.
Apache Kafka dan Amazon SQS sama-sama menawarkan kapabilitas messaging yang andal dengan jaminan pengiriman. Kafka memastikan pengiriman pesan “at-least-once” dan dapat mencapai semantik “exactly-once” melalui mekanisme seperti penulisan pesan idempoten dan dukungan transaksional.
Di sisi lain, SQS juga memastikan pengiriman pesan "at-least-once” dan menyediakan semantik pengiriman “exactly-once” melalui mekanisme deduplikasi.
Kedua platform menawarkan jaminan pengiriman pesan yang serupa, dengan Kafka menyediakan fitur lebih lanjut seperti penulisan idempoten dan transaksi.
Salah satu perbedaan utama antara Kafka dan SQS adalah cara menangani konsumsi pesan.
Kafka menggunakan kelompok konsumen untuk pembacaan independen dari partisi yang berbeda, memungkinkan penyeimbangan beban dan toleransi kesalahan. SQS tidak memiliki dukungan bawaan untuk kelompok konsumen, sehingga diperlukan antrian terpisah untuk setiap konsumen guna mencapai fungsionalitas serupa.
Ini menunjukkan pendekatan berbeda yang diambil Kafka dan SQS dalam mengelola interaksi konsumen dengan pesan.
Dukungan Kafka terhadap kelompok konsumen membuatnya lebih cocok untuk skenario yang melibatkan banyak konsumen dan penyeimbangan beban.
Kafka memiliki ekosistem integrasi yang lebih luas dan menawarkan konektor untuk berbagai sistem data dan kerangka kerja. Di sisi lain, SQS terintegrasi erat dengan layanan AWS lainnya, sehingga mudah dimasukkan ke arsitektur berbasis AWS.
SQS menjadi pemenang untuk arsitektur berbasis AWS, sementara Kafka menawarkan fleksibilitas lebih untuk integrasi dengan sistem dan kerangka kerja non-AWS.
Saat membandingkan Kafka dan SQS, jelas bahwa keduanya memenuhi kebutuhan yang berbeda. Kafka menuntut lebih banyak dalam hal penyiapan dan konfigurasi, dengan kurva belajar yang lebih terjal, terutama saat mendalami konsep sistem terdistribusi.
Di sisi lain, SQS menonjol karena kesederhanaannya. Sebagai layanan yang dikelola penuh, SQS memerlukan penyiapan dan konfigurasi minimal, sehingga lebih mudah diakses untuk kasus penggunaan yang sederhana.
SQS lebih mudah digunakan dan dimulai, sementara Kafka membutuhkan lebih banyak keahlian dalam sistem terdistribusi dan konfigurasi.
Kafka, sebagai platform sumber terbuka, membutuhkan investasi pada infrastruktur dan pengelolaan, namun bisa lebih hemat biaya untuk menangani beban kerja skala besar. Di sisi lain, SQS menawarkan layanan yang sepenuhnya dikelola dengan model bayar sesuai pemakaian, sehingga berpotensi lebih ekonomis untuk beban kerja yang lebih kecil.
SQS umumnya lebih hemat biaya untuk beban kerja kecil, sementara Kafka bisa lebih hemat untuk beban kerja skala besar, bergantung pada biaya infrastruktur dan pengelolaan.
Untuk memahami Kafka, perlu mendalami sistem terdistribusi dan pemrosesan stream. Kafka kaya akan konsep seperti topik, partisi, offset, dan kelompok konsumen. Di sisi lain, SQS memiliki API yang ramah pengguna, sehingga sederhana untuk mengirim dan menerima pesan dari antrian dengan SDK di berbagai bahasa pemrograman.
SQS menjadi pemenang dalam hal tingkat kesulitan sintaks. SQS menawarkan API yang lebih lugas dan ramah pengguna, sehingga lebih mudah diintegrasikan ke aplikasi. Sintaks Kafka bisa lebih kompleks karena sifatnya yang terdistribusi dan fitur streaming yang canggih.
|
Kafka |
SQS |
|
Terdistribusi, pub-sub |
Tersentralisasi, berbasis pull |
|
Sangat skalabel untuk volume besar |
Sangat skalabel untuk volume lebih kecil |
|
Periode retensi dapat dikonfigurasi |
Periode retensi terbatas |
|
At-least-once, exactly-once dengan transaksi |
At-least-once, exactly-once dengan deduplikasi |
|
Didukung |
Tidak didukung |
|
Ekosistem luas, konektor |
Integrasi AWS yang erat |
|
Kurva belajar lebih terjal |
Dikelola penuh, mudah memulai |
|
Sumber terbuka, biaya infrastruktur |
Bayar sesuai pemakaian |
|
Lebih lama |
14 hari |
|
Banyak |
Terbatas |
|
Lebih kompleks |
Sederhana dan lugas |
Sebagai kesimpulan, jika Anda membutuhkan layanan terkelola yang cepat diterapkan dan terintegrasi baik dalam ekosistem AWS, AWS SQS adalah pilihan terbaik. SQS menyederhanakan pengelolaan antrian dan melakukan penskalaan tanpa hambatan, menjadikannya ideal untuk banyak aplikasi standar.
Sebaliknya, jika proyek Anda menuntut throughput tinggi, latensi rendah, dan kemampuan penyetelan sistem yang mendalam, Apache Kafka menawarkan fleksibilitas untuk streaming dan pemrosesan data real time.
Pemilihan alat yang tepat akan bergantung pada kebutuhan spesifik proyek Anda, termasuk faktor seperti kemudahan penggunaan, performa, skalabilitas, dan integrasi. Baik Kafka maupun SQS memiliki keunggulannya masing-masing, dan memahami ini akan membantu Anda memanfaatkan platform terbaik untuk proyek berbasis data berikutnya!
Untuk terus mempelajari topik-topik ini, lihat sumber berikut:
Pelajari lebih lanjut tentang infrastruktur dan pengelolaan data stream melalui kursus berikut!
Kursus
Kursus
Kursus
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt
blogs
David Woods
13 mnt