Kurs
Datenstreaming mit AWS Kinesis und Lambda
4 Std.
9.4K
Wenn du moderne Anwendungen baust, weißt du, wie wichtig ein effizienter Umgang mit großen Datenmengen ist. Event-Streaming-Plattformen sind die erste Wahl für die Echtzeitverarbeitung und -analyse von Daten.
In diesem Artikel schauen wir uns zwei der beliebtesten Plattformen in diesem Bereich an: Apache Kafka und Amazon Simple Queue Service (SQS). Wir vergleichen Stärken und Schwächen und geben dir praxisnahe Einblicke, damit du fundierte Entscheidungen für datengetriebene Projekte treffen kannst.
Für alle, die genau wissen, wonach sie suchen, und nur einen schnellen Überblick über Apache Kafka und Amazon SQS brauchen, bietet die folgende Tabelle eine kompakte Orientierung. Wenn du es ausführlicher möchtest, lies weiter für den detaillierten Vergleich.
|
Kategorie |
Kafka |
SQS |
Vorteil |
|
Architektur |
Verteilt, Pub/Sub |
Zentralisiert, Pull-basiert |
Kafka |
|
Skalierbarkeit |
Sehr gut für große Datenmengen |
Sehr gut für kleinere Volumina |
Kafka für groß, SQS für klein |
|
Nachrichtenpersistenz |
Konfigurierbare Aufbewahrungsdauer |
Begrenzte Aufbewahrungsdauer |
Kafka |
|
Zustellung |
Mindestens einmal, exakt einmal mit Transaktionen |
Mindestens einmal, exakt einmal mit Deduplizierung |
Unentschieden |
|
Consumer-Gruppen |
Unterstützt |
Nicht unterstützt |
Kafka |
|
Integration |
Breites Ökosystem, Connectoren |
Enge AWS-Integration |
Kafka außerhalb von AWS, SQS in AWS |
|
Benutzerfreundlichkeit |
Höhere Einstiegshürde |
Voll gemanagt, schneller Start |
SQS |
|
Kosten |
Open Source, Infrastrukturkosten |
Nutzenbasiertes Preismodell |
SQS bei kleinen, Kafka bei großen Workloads |
|
Aufbewahrung |
Länger |
14 Tage |
Kafka |
|
Protokollunterstützung |
Vielfältig |
Begrenzt |
Kafka |
|
Syntax-Komplexität |
Komplexer |
Einfach und geradlinig |
SQS |
Event-Streaming-Plattformen wie Apache Kafka und Amazon SQS sind in modernen, datengetriebenen Umgebungen erste Wahl. Sie ermöglichen es, Daten beim Entstehen zu sammeln, zu verarbeiten und zu analysieren – für schnellere Entscheidungen und mehr Reaktionsfähigkeit.
Das sind einige Gründe, warum Streaming-Plattformen wie Kafka und SQS wichtig sind:
Event-Streaming-Plattformen ermöglichen kontinuierliche Datenerfassung und Echtzeitverarbeitung. Das ist relevant für Anwendungen, die sofortige Einblicke und Aktionen erfordern, etwa Finanzhandel, Betrugserkennung und Social-Media-Monitoring. Indem du Daten beim Eintreffen verarbeitest, triffst du rechtzeitig Entscheidungen und reagierst schnell auf Ereignisse.
Diese Plattformen unterstützen asynchrone Kommunikation und entkoppeln Produzenten und Konsumenten. Dadurch können Systemkomponenten unabhängig arbeiten – das erhöht Resilienz und Flexibilität. Außerdem lassen sich Services so getrennt skalieren und weiterentwickeln, ohne andere Komponenten zu stören.
Sowohl Kafka als auch SQS sind auf hohe Skalierbarkeit und Zuverlässigkeit ausgelegt. Kafka verarbeitet durch horizontale Skalierung mit zusätzlichen Brokern Millionen von Events pro Sekunde. SQS skaliert automatisch mit dem Nachrichtenvolumen und eignet sich damit für wechselnde Lasten. Diese Fähigkeiten stellen sicher, dass beide Plattformen große Datenverarbeitungsaufgaben stemmen.
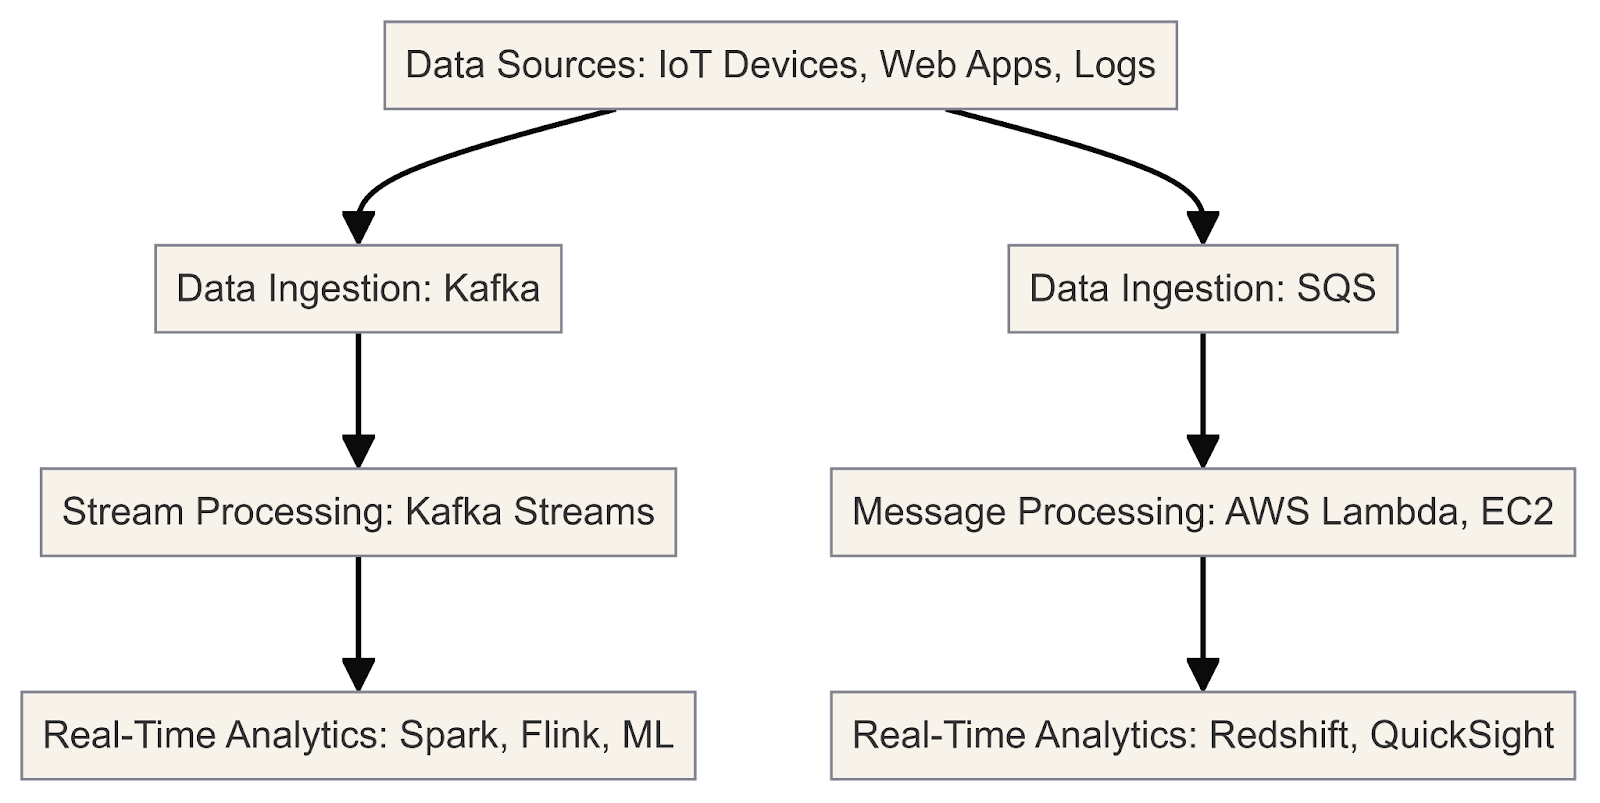
Dieses Diagramm zeigt den Workflow zur Echtzeitdatenverarbeitung und -analyse mit Kafka und SQS.
Nachdem wir die Bedeutung von Streaming-Plattformen geklärt haben, schauen wir uns Kafka und SQS im Detail an.
Apache Kafka ist eine Open-Source-Event-Streaming-Plattform für verteilte Umgebungen, die große Mengen an Echtzeitdatenströmen verarbeitet. Sie wird häufig für Messaging, Log-Aggregation, Stream Processing und Commit-Logs eingesetzt.
Die Architektur von Kafka ist auf hohe Skalierbarkeit und Fehlertoleranz ausgelegt und damit eine bevorzugte Lösung für datengetriebene Anwendungen. Stell dir Kafka als leistungsstarke Datenpipeline vor, mit der du ganz einfach Echtzeit-Datenpipelines und Anwendungen erstellst.
Als Entwickler:in kannst du Kafkas Kernkomponenten nutzen, um Echtzeitdatenströme effizient zu handhaben. Hier ein praktisches Beispiel, wie Kafka mit Python funktioniert:
Besuche die Apache Kafka Website und lade die aktuelle Version herunter. Wähle das passende Binary für dein Betriebssystem.
Entpacke das heruntergeladene Archiv in ein Verzeichnis deiner Wahl. Dieses Verzeichnis ist deine Kafka-Installation.
Wechsle im Terminal in das entpackte Kafka-Verzeichnis und starte Zookeeper und den Kafka-Broker mit den bereitgestellten Skripten:
# Start Zookeeper
bin/zookeeper-server-start.sh config/zookeeper.properties
# Start Kafka broker
bin/kafka-server-start.sh config/server.properties
Beachte: Zookeeper ist als veraltet markiert und soll mit Apache Kafka 4.0 entfernt werden. Weitere Details findest du in der Dokumentation.
Broker sind die Kafka-Server, die Speicherung und Replikation der Datenströme übernehmen. Du kannst über die Kommandozeile oder programmgesteuert über Client-Bibliotheken mit ihnen arbeiten.
Hier ein Beispiel, wie du über die Kommandozeile Kafka-Themen verwaltest und nutzt:
bin/kafka-topics.sh --create --topic my_topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1bin/kafka-topics.sh --list --bootstrap-server localhost:9092bin/kafka-console-producer.sh --topic my_topic --bootstrap-server localhost:9092bin/kafka-console-consumer.sh --topic my_topic --bootstrap-server localhost:9092 --from-beginningStelle sicher, dass Python installiert ist. Die Kafka-Python-Clients unterstützen Python 3.7 und höher.
Erstelle eine virtuelle Umgebung, um Abhängigkeiten zu isolieren. Du kannst mit venv arbeiten.
Das ist die offizielle Apache Kafka Python-Client-Bibliothek:
pip install kafka-pythonJe nach Projekt brauchst du ggf. weitere Bibliotheken wie json für JSON-(De)Serialisierung.
Nutze dann folgendes Skript, um Broker programmgesteuert aufzulisten:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# List the available brokers
brokers = admin_client.describe_cluster()
print("Brokers:", brokers['brokers'])Partitionen sind Kafkas Hebel für Parallelität und Skalierung. Jede Partition ist eine geordnete, unveränderliche Sequenz von Records, die fortlaufend ergänzt wird. Die Anzahl der Partitionen legst du beim Erstellen eines Topics fest:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# Create a new topic with 3 partitions
topic = NewTopic(name="social-media-posts", num_partitions=3, replication_factor=1)
admin_client.create_topics([topic])
Wer Partitionen versteht, kann Anwendungen gezielt auf Leistung und Fehlertoleranz trimmen.
Mit Kafka und den nötigen Python-Bibliotheken kannst du jetzt Producer- und Consumer-Anwendungen in Python schreiben.
So erstellst du einen Kafka-Producer zum Veröffentlichen von Social-Media-Posts und einen Consumer zu deren Verarbeitung:
Producer publizieren Datenströme in Kafka-Themen. Sie lassen sich in Anwendungen, Services oder Datenquellen integrieren, um Daten in Echtzeit nach Kafka zu pushen.
from kafka import KafkaProducer
import json

# Create a Kafka producer
producer = KafkaProducer(bootstrap_servers='localhost:9092',
                         value_serializer=lambda m: json.dumps(m).encode('utf-8'))

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Publish the social media post to the 'social-media-posts' topic
producer.send('social-media-posts', social_media_post)Consumer abonnieren ein oder mehrere Topics und konsumieren Datenströme aus Kafka. Je nach Anforderung kannst du unterschiedliche Konsummuster umsetzen.
from kafka import KafkaConsumer
import json

# Create a Kafka consumer
consumer = KafkaConsumer('social-media-posts',
                         bootstrap_servers='localhost:9092',
                         value_deserializer=lambda m: json.loads(m.decode('utf-8')))

# Consume and process social media posts
for message in consumer:
    social_media_post = message.value
    print(f"Received post: {social_media_post}")
    # Process the social media post...
Dieses Beispiel deckt Installation von Kafka, Python-Setup und die Implementierung von Producer/Consumer für Echtzeitverarbeitung ab.
SQS ist ein vollständig gemanagter Message-Queuing-Service von AWS. Er ermöglicht die Entkopplung und Skalierung von Microservices, verteilten Systemen und serverlosen Anwendungen.
Im Kern ist SQS ein verteiltes Warteschlangensystem, mit dem du Nachrichten zwischen Softwarekomponenten asynchron senden, speichern und empfangen kannst. Diese Nachrichten können Textdaten, Systembenachrichtigungen oder Verweise auf größere Daten sein, die in anderen AWS-Services wie S3 oder DynamoDB liegen.
Ein großer Vorteil von SQS: Du musst keine eigene Queuing-Infrastruktur betreiben. AWS übernimmt Verwaltung, Skalierung und Fehlertoleranz im Hintergrund – du konzentrierst dich auf die Anwendungslogik.
SQS bietet zwei Warteschlangentypen:
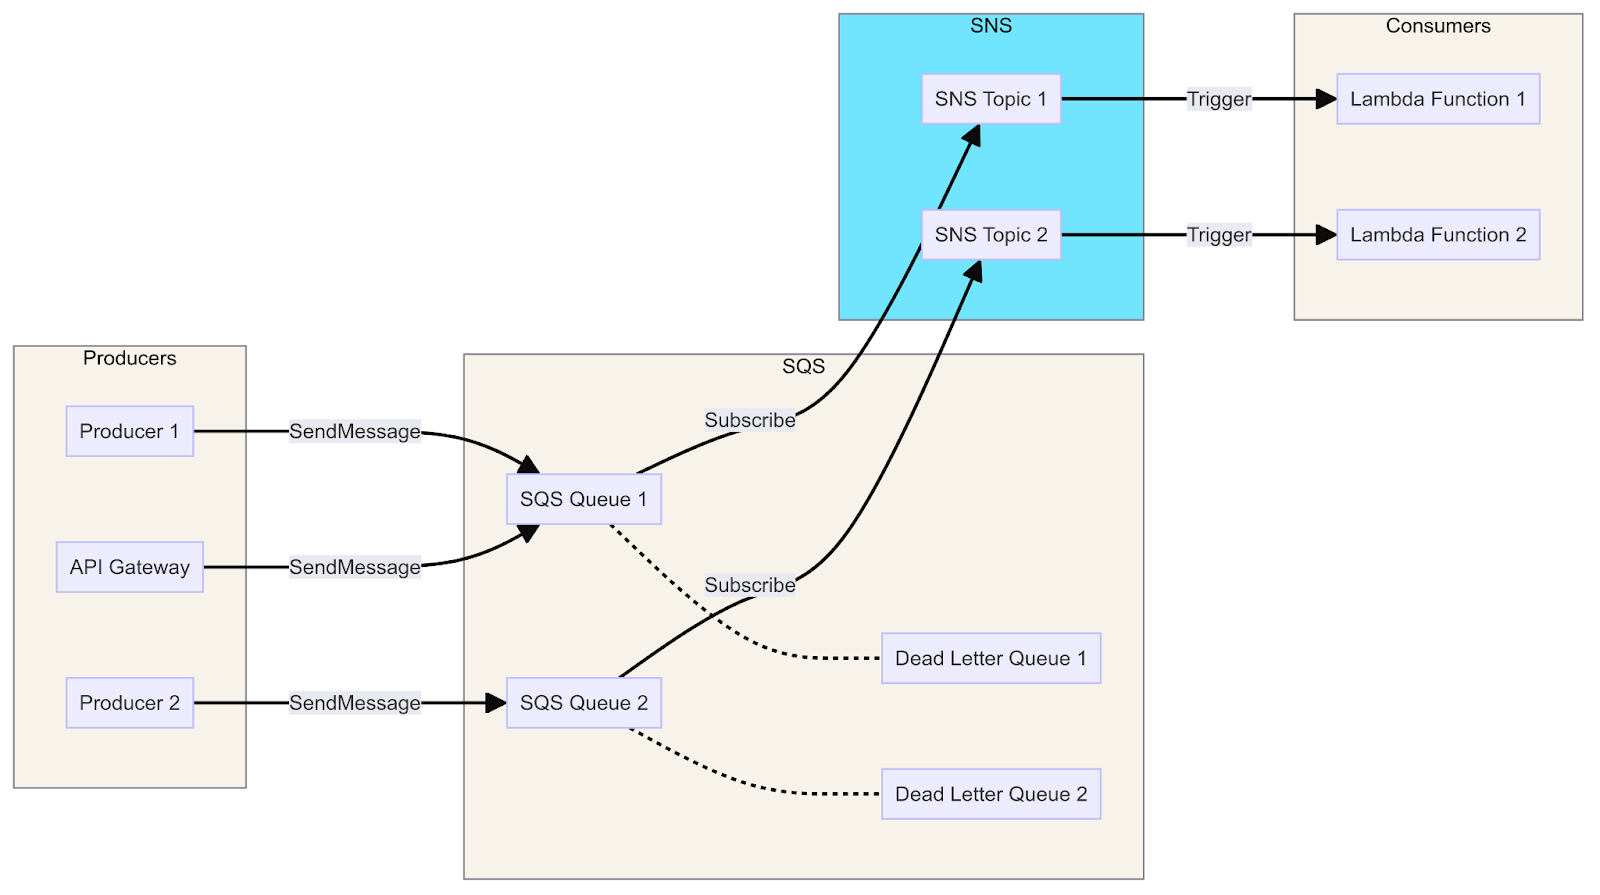
Ein Vorteil von SQS ist die Zugehörigkeit zum AWS-Ökosystem – dadurch lassen sich andere AWS-Services leicht anbinden. Die Art der Integration hängt davon ab, ob der Service Produzent oder Konsument ist:
Ein Diagramm zeigt die Integration von SQS mit Lambda, SNS und API Gateway und illustriert den Nachrichtenfluss von Producer zu Consumer über Queues, Topics und Functions.
Schauen wir uns Producer und Consumer in Aktion an. Hier ist eine Anleitung, wie du AWS SQS mit Python einrichtest und nutzt – inklusive grundlegender Installationsschritte sowie Producer- und Consumer-Beispiel:
Falls noch nicht vorhanden, erstelle ein AWS-Konto über den AWS Free Tier.
Installiere und konfiguriere die AWS Command Line Interface (CLI), um AWS-Ressourcen zu verwalten.
# Install AWS CLI
pip install awscli

# Configure AWS CLI with your credentials
aws configure
Gib bei der Einrichtung Access Key, Secret Key, Region und Ausgabeformat an.
Wir nutzen die boto3-Bibliothek, das offizielle AWS SDK für Python, um mit SQS zu interagieren.
boto3 installierenpip install boto3Erstelle eine SQS-Queue über die AWS Management Console oder programmgesteuert mit boto3.
import boto3

# Create SQS client
sqs = boto3.client('sqs')

# Create a new queue
response = sqs.create_queue(
    QueueName='social-media-posts',
    Attributes={
        'DelaySeconds': '0',
        'MessageRetentionPeriod': '86400'  # 1 day
    }
)
print(response['QueueUrl'])Ein Producer sendet Nachrichten an die SQS-Queue.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Send message to SQS queue
response = sqs.send_message(
    QueueUrl=queue_url,
    MessageBody=json.dumps(social_media_post)
)
print(response['MessageId'])Ein Consumer empfängt und verarbeitet Nachrichten aus der SQS-Queue.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Receive messages from SQS queue
response = sqs.receive_message(
    QueueUrl=queue_url,
    MaxNumberOfMessages=10,
    WaitTimeSeconds=10
)

if 'Messages' in response:
    for message in response['Messages']:
        social_media_post = json.loads(message['Body'])
        print(f"Received post: {social_media_post}")

        # Process the social media post...

        # Delete received message from queue
        sqs.delete_message(
            QueueUrl=queue_url,
            ReceiptHandle=message['ReceiptHandle']
        )

else:
    print('No messages received')
So erstellst du unkompliziert eine SQS-Queue, sendest Nachrichten als Producer und empfängst sie als Consumer. Das Beispiel deckt die wichtigsten Schritte für den Einstieg ab.
Ausführlichere Schritte zur Einrichtung findest du in der AWS SQS-Dokumentation.
Schauen wir uns nun Kafka und SQS im direkten Vergleich an und heben ihre Gemeinsamkeiten hervor.
Sowohl Kafka als auch SQS sind Message-Queuing-Systeme für asynchrone Kommunikation zwischen Komponenten verteilter Systeme. Sie agieren als Vermittler: Producer senden Nachrichten, Consumer empfangen und verarbeiten sie.
Kafka und SQS entkoppeln Producer und Consumer, sodass beide unabhängig arbeiten und skalieren können. Das fördert lose Kopplung, Fehlertoleranz und Skalierbarkeit.
Beide Systeme bieten Mechanismen zur Persistenz, damit Nachrichten bei Ausfällen oder Neustarts nicht verloren gehen. Kafka speichert in einem verteilten Commit-Log, SQS in hochverfügbaren, langlebigen Queues.
Kafka und SQS sind für hohe Skalierbarkeit gebaut. Kafka skaliert horizontal über zusätzliche Broker im Cluster, SQS skaliert automatisch mit dem Nachrichtenaufkommen.
Beide bieten Integrationsmöglichkeiten. Kafka verfügt über ein breites Ökosystem an Connectoren, SQS integriert nahtlos mit anderen AWS-Services.
Obwohl die Standardgarantien unterschiedlich sind, können beide Systeme Reihenfolge sichern: Kafka garantiert geordnete Zustellung innerhalb von Partitionen, SQS bietet FIFO-Queues für strikt geordnete Verarbeitung.
Kafka und SQS stellen Monitoring- und Metrikfunktionen bereit, um Leistung und Gesundheit der Messaging-Systeme zu überwachen.
Beide bieten Sicherheitsfunktionen wie Verschlüsselung, Zugriffskontrolle und Authentifizierung – für Daten in Bewegung und im Ruhezustand.
Nun zu den wichtigsten Unterschieden zwischen Kafka und SQS.
Kafka ist eine verteilte Streaming-Plattform im Publish-Subscribe-Modell. Ein Cluster aus Brokern speichert und verwaltet Datenströme in Topics. Producer veröffentlichen Nachrichten, Consumer abonnieren Topics und empfangen Nachrichten.
SQS ist ein vollständig gemanagter Messaging-Service von AWS. Er folgt einem Queue-basierten Modell: Nachrichten werden in eine Queue gesendet, Consumer pollen diese, um Nachrichten zu erhalten.
Kafka bietet „mindestens einmal“-Semantik, d. h. Nachrichten können einmal oder mehrfach zugestellt werden. Über idempotente Producer und transaktionale Schreibvorgänge sind auch „exakt einmal“-Semantiken möglich.
SQS garantiert „mindestens einmal“-Zustellung. Für weitere Protokolle wie HTTP/HTTPS, E-Mail und SMS wird Amazon SNS zusammen mit SQS eingesetzt.
Kafka erhält die Reihenfolge innerhalb von Partitionen und stellt so zu, wie produziert wurde.
SQS garantiert standardmäßig keine Reihenfolge, unterstützt aber FIFO-Topics, die die exakte Reihenfolge erhalten.
Kafka speichert Nachrichten dauerhaft auf Datenträgern in einem verteilten Commit-Log. Die Aufbewahrung ist konfigurierbar, Consumer können Nachrichten zurückspulen und erneut abspielen.
SQS bietet keine langfristige Aufbewahrung. Nachrichten werden temporär gespeichert, bis sie zugestellt oder gemäß Aufbewahrungsfrist gelöscht werden.
Kafka skaliert horizontal durch zusätzliche Broker und unterstützt Topic-Partitionierung für Parallelität und Lastverteilung.
SQS skaliert als Managed Service automatisch mit wachsender Last – ohne manuelles Eingreifen.
Kafka bietet ein breites Integrationsökosystem mit Connectoren zu vielen Datenquellen, -senken und Frameworks wie Apache Spark, Apache Flink und Kafka Streams.
SQS integriert nahtlos mit AWS-Services und kann Benachrichtigungen an Ziele wie AWS Lambda, SQS-Queues und HTTP/HTTPS-Endpunkte senden.
Kafka setzt primär auf CLI-Tools wie kafka-topics zur Verwaltung. Eine eingebaute UI fehlt, aber Dritttools wie Kafka Manager, Kafka Tool und Confluent Control Center bieten Web-UIs für das Cluster-Management.
SQS ist in die AWS Management Console integriert. Darüber lassen sich Queues einfach anlegen, konfigurieren und überwachen – ohne Zusatztools.
Kafka bietet Client-Bibliotheken für Java, Python, Go u. a. Die Syntax ist durch Konzepte wie Topics, Partitionen, Offsets und Consumer-Gruppen komplexer.
SQS stellt SDKs für mehrere Sprachen bereit, darunter Java, Python und Node.js. Die Syntax ist einfacher und fokussiert auf das Senden und Empfangen von Nachrichten in/aus Queues. Insgesamt ist SQS geradliniger, während Kafka durch seine verteilte Natur komplexer ist.
Die Kosten für Kafka hängen vom Deployment ab (self-managed oder Managed Services wie Confluent Cloud oder Amazon MSK).
SQS folgt einem nutzungsabhängigen Preismodell basierend auf Requests und Datentransfer.
Nach Gemeinsamkeiten und Unterschieden folgt nun der Detailvergleich – inklusive Empfehlung je Kategorie, je nach Anwendungsfall.
Kafka ist ein verteiltes Pub/Sub-Messagingsystem auf Basis einer Distributed-Log-Architektur, in der Nachrichten im Commit-Log erhalten bleiben.
SQS ist dagegen ein vollständig gemanagtes, Pull-basiertes Messagingsystem mit Broker-Architektur, in dem ein zentraler Service die Queue-Verwaltung orchestriert.
Kafkas verteilte Architektur ist skalierbarer und fehlertoleranter; die zentralisierte Architektur von SQS vereinfacht das Management, kann aber zum Engpass werden.
Beide – Kafka und Amazon SQS – sind hoch skalierbar. Kafka ist bekannt für hohen Durchsatz, Fehlertoleranz und horizontale Skalierung und bewältigt große Datenmengen mit längerer Aufbewahrung.
Amazon SQS kann Millionen Nachrichten pro Sekunde verarbeiten und skaliert automatisch bei schwankender Last.
Kafka skaliert besser für sehr große Datenvolumina und längere Aufbewahrung, SQS lässt sich für kleinere Workloads einfacher automatisch skalieren.
Kafka stellt Persistenz über ein repliziertes Log sicher. Du kannst Aufbewahrungsdauer und Speicherplatz flexibel konfigurieren.
SQS speichert Nachrichten über mehrere Rechenzentren hinweg, was die Haltbarkeit erhöht. Standardmäßig 4 Tage Aufbewahrung, konfigurierbar bis maximal 14 Tage.
Beide bieten Persistenz, Kafka ist jedoch flexibler bei Aufbewahrungsfristen und Speicher.
Apache Kafka und Amazon SQS bieten robuste Messaging-Funktionen mit garantierter Zustellung. Kafka stellt „mindestens einmal“ sicher und erreicht „exakt einmal“ über idempotente Writes und Transaktionen.
SQS stellt ebenfalls „mindestens einmal“ sicher und ermöglicht „exakt einmal“ über Deduplizierung.
Beide liefern ähnliche Garantien; Kafka bietet zusätzliche Features wie idempotente Writes und Transaktionen.
Ein zentraler Unterschied liegt in der Konsumierung von Nachrichten.
Kafka nutzt Consumer-Gruppen für unabhängiges Lesen aus Partitionen – für Lastverteilung und Fehlertoleranz. SQS unterstützt Consumer-Gruppen nicht nativ; vergleichbare Muster erfordern separate Queues je Consumer.
Das zeigt die unterschiedlichen Ansätze bei der Steuerung der Consumer-Interaktion.
Kafka ist mit Consumer-Gruppen besser für mehrere Konsumenten und Lastverteilung geeignet.
Kafka bietet das breitere Integrationsökosystem und Connectoren zu vielen Systemen und Frameworks. SQS ist dafür eng mit AWS verzahnt und in AWS-Architekturen besonders einfach einzubinden.
SQS gewinnt in AWS-Umgebungen, Kafka ist flexibler für Integrationen außerhalb von AWS.
Kafka verlangt mehr Setup und Konfiguration und hat eine steilere Lernkurve – insbesondere bei verteilten Systemen.
SQS punktet mit Einfachheit. Als Managed Service ist der Einstieg schnell und mit wenig Aufwand möglich – ideal für klar umrissene Anwendungsfälle.
SQS ist leichter zu nutzen und schneller startklar; Kafka erfordert mehr Know-how in verteilten Systemen und Konfiguration.
Kafka ist Open Source und benötigt Infrastruktur und Betrieb – kann bei sehr großen Workloads aber kosteneffizienter sein. SQS ist voll gemanagt und nutzungsbasiert bepreist – oft günstiger bei kleineren Workloads.
SQS ist meist günstiger für kleinere Workloads, Kafka kann bei großem Maßstab wirtschaftlicher sein – abhängig von Infrastruktur- und Betriebskosten.
Um Kafka zu meistern, brauchst du Wissen zu verteilten Systemen und Stream Processing. Es gibt viele Konzepte (Topics, Partitionen, Offsets, Consumer-Gruppen). SQS bietet eine benutzerfreundliche API – Nachrichten senden/empfangen per SDK in vielen Sprachen ist simpel.
SQS ist hier im Vorteil: Eine einfache, nutzerfreundliche API erleichtert die Integration. Kafka ist komplexer aufgrund seiner verteilten Natur und Advanced-Streaming-Features.
|
Kafka |
SQS |
|
Verteilt, Pub/Sub |
Zentralisiert, Pull-basiert |
|
Sehr gut für große Datenmengen |
Sehr gut für kleinere Volumina |
|
Konfigurierbare Aufbewahrung |
Begrenzte Aufbewahrung |
|
Mindestens einmal, exakt einmal mit Transaktionen |
Mindestens einmal, exakt einmal mit Deduplizierung |
|
Unterstützt |
Nicht unterstützt |
|
Breites Ökosystem, Connectoren |
Enge AWS-Integration |
|
Höhere Einstiegshürde |
Voll gemanagt, schneller Start |
|
Open Source, Infrastrukturkosten |
Nutzenbasiert |
|
Länger |
14 Tage |
|
Vielfältig |
Begrenzt |
|
Komplexer |
Einfach und geradlinig |
Wenn du einen schnell einsetzbaren Managed Service willst, der sich nahtlos ins AWS-Ökosystem einfügt, ist AWS SQS die beste Wahl. Es vereinfacht das Queue-Management und skaliert mühelos – ideal für viele Standardanwendungen.
Benötigst du hingegen hohen Durchsatz, geringe Latenz und feine Stellschrauben, bietet Apache Kafka maximale Flexibilität für Echtzeit-Streaming und -Verarbeitung.
Die richtige Wahl hängt von den Anforderungen deines Projekts ab – Benutzerfreundlichkeit, Performance, Skalierbarkeit und Integration. Beide haben ihre Stärken. Wenn du sie kennst, nutzt du die jeweils beste Plattform für dein nächstes datengetriebenes Projekt!
Wenn du tiefer einsteigen willst, schau dir diese Ressourcen an:
Erweitere dein Wissen über Stream-Dateninfrastruktur und -Management mit diesen Kursen!
Kurs
Kurs
Kurs