Corso
Dati in streaming con AWS Kinesis e Lambda
4 ore
9.5K
Pratica and corso your progress.
Continua Con GoogleSe stai creando applicazioni moderne, sai quanto sia importante gestire grandi volumi di dati in modo efficiente. Le piattaforme di event streaming sono la soluzione di riferimento per l’elaborazione e l’analisi dei dati in tempo reale.
In questo articolo esploreremo due delle piattaforme più popolari in questo ambito: Apache Kafka e Amazon Simple Queue Service (SQS). Confronteremo punti di forza e debolezze di ciascuna piattaforma e forniremo spunti pratici per aiutarti a prendere decisioni consapevoli per i tuoi progetti data-driven.
Per chi sa già cosa sta cercando e vuole solo un rapido confronto tra Apache Kafka e Amazon SQS, la tabella qui sotto offre una guida sintetica. Se invece vuoi una versione più dettagliata, continua a leggere per un confronto approfondito.
|
Categoria |
Kafka |
SQS |
Vincitore |
|
Architettura |
Distribuita, pub-sub |
Centralizzata, pull-based |
Kafka |
|
Scalabilità |
Altamente scalabile per grandi volumi |
Altamente scalabile per volumi minori |
Kafka per grandi, SQS per piccoli |
|
Persistenza dei messaggi |
Periodi di conservazione configurabili |
Periodi di conservazione limitati |
Kafka |
|
Consegna dei messaggi |
At-least-once, exactly-once con transazioni |
At-least-once, exactly-once con deduplicazione |
Parità |
|
Gruppi di consumer |
Supportati |
Non supportati |
Kafka |
|
Integrazione |
Ampio ecosistema, connettori |
Integrazione stretta con AWS |
Kafka fuori da AWS, SQS su AWS |
|
Facilità d’uso |
Curva di apprendimento più ripida |
Completamente gestito, facile da iniziare |
SQS |
|
Costo |
Open-source, costi d’infrastruttura |
Pay-as-you-go |
SQS per carichi piccoli, Kafka per grandi |
|
Conservazione dei messaggi |
Più lunga |
14 giorni |
Kafka |
|
Supporto dei protocolli |
Multipli |
Limitato |
Kafka |
|
Difficoltà della sintassi |
Più complessa |
Semplice e lineare |
SQS |
Piattaforme di event streaming come Apache Kafka e Amazon SQS sono tra le scelte migliori negli ambienti moderni data-driven. Ti permettono di raccogliere, elaborare e analizzare i dati mentre vengono generati, favorendo decisioni più rapide e una maggiore reattività.
Ecco alcuni motivi per cui le piattaforme di streaming come Kafka e SQS sono importanti:
Le piattaforme di event streaming abilitano la raccolta continua e l’elaborazione dei dati in tempo reale. Questa capacità è cruciale per applicazioni che richiedono insight e azioni immediate, come i sistemi di trading finanziario, rilevazione delle frodi e monitoraggio dei social media. Elaborando i dati man mano che arrivano, puoi prendere decisioni tempestive e rispondere rapidamente agli eventi emergenti.
Queste piattaforme supportano la comunicazione asincrona, disaccoppiando produttori e consumer dei dati. Questo disaccoppiamento consente ai diversi componenti del sistema di operare in modo indipendente, migliorando resilienza e flessibilità. La comunicazione asincrona consente inoltre ai servizi di scalare ed evolversi indipendentemente, senza causare interruzioni agli altri componenti.
Sia Kafka che SQS sono progettati per un’elevata scalabilità e affidabilità. Kafka può gestire milioni di eventi al secondo scalando orizzontalmente con l’aggiunta di broker. SQS scala automaticamente per gestire volumi di messaggi crescenti, rendendolo adatto a carichi variabili. Queste capacità assicurano che le piattaforme possano soddisfare le esigenze di elaborazione dati su larga scala.
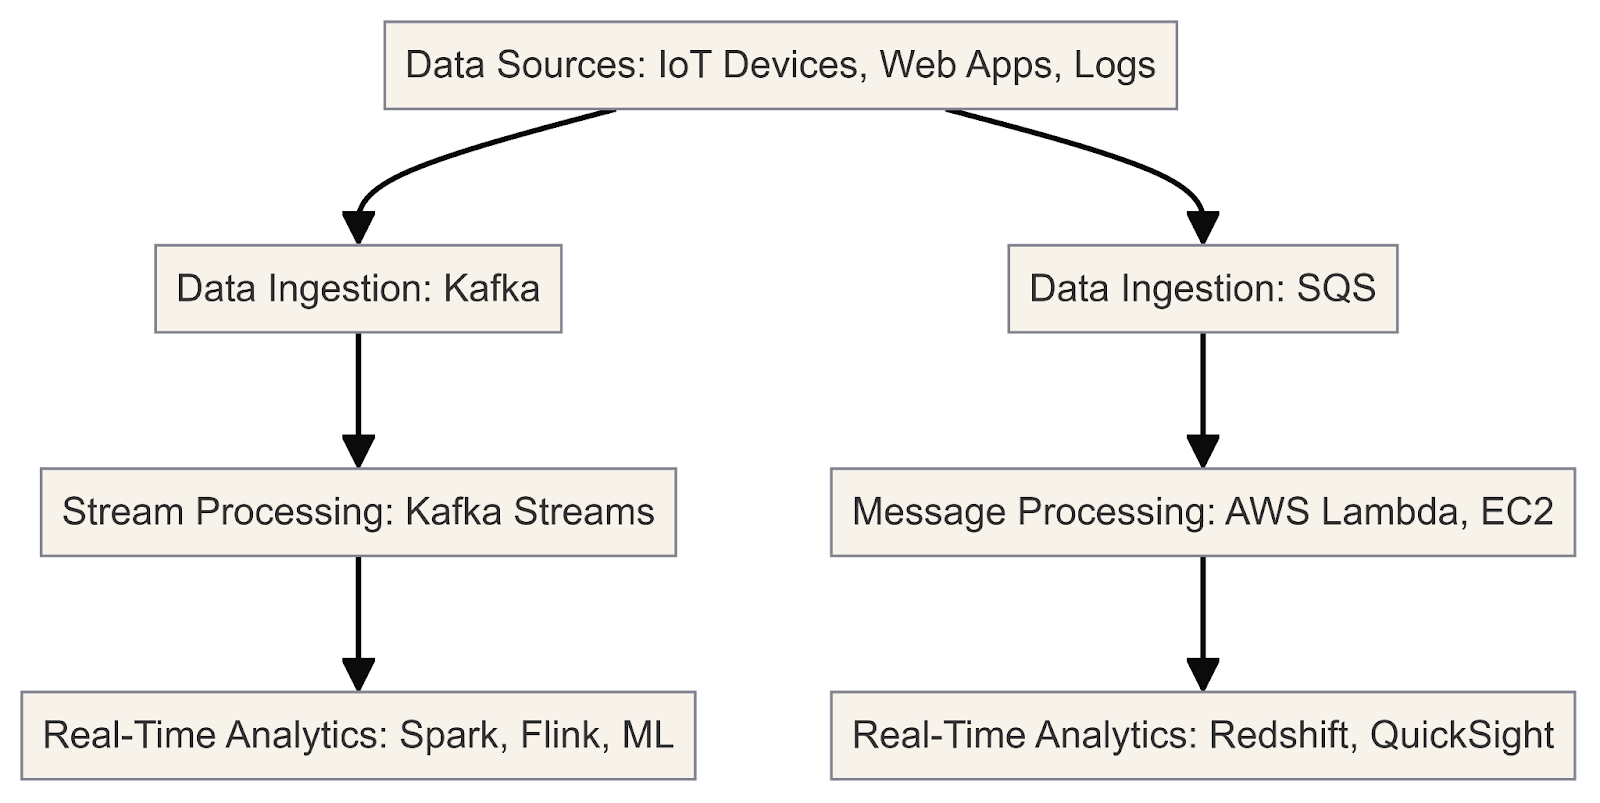
Questo diagramma illustra il flusso di elaborazione e analisi dei dati in tempo reale utilizzando Kafka e SQS
Chiarita l’importanza delle piattaforme di streaming, vediamo ora nel dettaglio Kafka e SQS.
Apache Kafka è una piattaforma open-source di event streaming distribuita, progettata per gestire grandi volumi di flussi di dati in tempo reale. È spesso impiegata per messaging, aggregazione di log, stream processing e commit log.
L’architettura di Kafka è pensata per un’elevata scalabilità e tolleranza ai guasti, rendendola una soluzione di riferimento per applicazioni data-driven. Pensa a Kafka come a una pipeline dati ad alte prestazioni che ti permette di creare facilmente pipeline dati e applicazioni in tempo reale.
Come sviluppatore, puoi sfruttare i componenti core di Kafka per gestire in modo efficiente i flussi di dati in tempo reale. Ecco un esempio pratico di come funziona Kafka con Python:
Visita il sito di Apache Kafka e scarica l’ultima versione. Scegli il pacchetto binario adatto al tuo sistema operativo.
Estrai l’archivio in una directory a tua scelta. Questa sarà la tua directory di installazione di Kafka.
Nel Terminale, vai nella directory di Kafka estratta e avvia i servizi Zookeeper e Kafka broker usando gli script forniti:
# Start Zookeeper
bin/zookeeper-server-start.sh config/zookeeper.properties
# Start Kafka broker
bin/kafka-server-start.sh config/server.properties
Nota: Zookeeper è attualmente deprecato e la sua rimozione è prevista in Apache Kafka 4.0. Per maggiori dettagli, vedi la documentazione.
I broker sono i server Kafka che gestiscono l’archiviazione e la replica dei flussi di dati. Puoi interagire con i broker tramite strumenti da riga di comando o in modo programmatico usando le librerie client.
Ecco un esempio di utilizzo degli strumenti da riga di comando per gestire e interagire con i topic Kafka:
bin/kafka-topics.sh --create --topic my_topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1bin/kafka-topics.sh --list --bootstrap-server localhost:9092bin/kafka-console-producer.sh --topic my_topic --bootstrap-server localhost:9092bin/kafka-console-consumer.sh --topic my_topic --bootstrap-server localhost:9092 --from-beginningAssicurati di avere Python installato sul tuo sistema. Le librerie client Python di Kafka supportano Python 3.7 e versioni successive.
Crea un ambiente virtuale per isolare le dipendenze del tuo progetto. Puoi usare venv.
Questa è la libreria client ufficiale di Apache Kafka per Python:
pip install kafka-pythonIn base ai requisiti del tuo progetto, potresti dover installare librerie aggiuntive, come json, per la serializzazione/deserializzazione JSON.
Poi, usa il seguente script per elencare i broker in modo programmatico:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# List the available brokers
brokers = admin_client.describe_cluster()
print("Brokers:", brokers['brokers'])Le partition sono il modo in cui Kafka ottiene parallelismo e scalabilità. Ogni partition è una sequenza ordinata e immutabile di record a cui si aggiunge continuamente. Puoi configurare il numero di partition per un topic al momento della creazione:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# Create a new topic with 3 partitions
topic = NewTopic(name="social-media-posts", num_partitions=3, replication_factor=1)
admin_client.create_topics([topic])
Capire le partition può aiutarti a ottimizzare le applicazioni per migliori prestazioni e tolleranza ai guasti.
Con Kafka e le librerie Python necessarie installate, puoi iniziare a scrivere le tue applicazioni producer e consumer in Python.
Ecco un esempio di come creare un producer Kafka per pubblicare post dai social media e un consumer per elaborarli:
I producer sono i client che pubblicano flussi di dati sui topic Kafka. Possono essere integrati nelle tue applicazioni, servizi o sorgenti dati per inviare dati a Kafka in tempo reale.
from kafka import KafkaProducer
import json

# Create a Kafka producer
producer = KafkaProducer(bootstrap_servers='localhost:9092',
                         value_serializer=lambda m: json.dumps(m).encode('utf-8'))

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Publish the social media post to the 'social-media-posts' topic
producer.send('social-media-posts', social_media_post)I consumer sono i client che si iscrivono a uno o più topic e consumano i flussi di dati da Kafka. Possono implementare vari pattern di consumo in base alle esigenze della tua applicazione.
from kafka import KafkaConsumer
import json

# Create a Kafka consumer
consumer = KafkaConsumer('social-media-posts',
                         bootstrap_servers='localhost:9092',
                         value_deserializer=lambda m: json.loads(m.decode('utf-8')))

# Consume and process social media posts
for message in consumer:
    social_media_post = message.value
    print(f"Received post: {social_media_post}")
    # Process the social media post...
Questo codice di esempio offre una panoramica completa dell’installazione di Kafka, della configurazione dell’ambiente Python e dell’implementazione di producer e consumer Kafka per l’elaborazione dei dati in tempo reale.
SQS è un servizio di accodamento dei messaggi completamente gestito da AWS. Ti consente di disaccoppiare e scalare microservizi, sistemi distribuiti e applicazioni serverless.
Alla base, SQS è un sistema di code distribuite che ti permette di inviare, archiviare e ricevere messaggi tra componenti software in modo asincrono. Questi messaggi possono essere dati testuali, notifiche di sistema o anche puntatori a dati più grandi archiviati in altri servizi AWS come S3 o DynamoDB.
Uno dei principali vantaggi di SQS è che elimina la necessità di gestire l’infrastruttura di accodamento dei messaggi. AWS si occupa della gestione delle code, della scalabilità e della tolleranza ai guasti, permettendoti di concentrarti sulla logica applicativa.
SQS offre due tipi di code:
Uno dei vantaggi di SQS è che fa parte dell’ecosistema AWS e quindi si integra facilmente con altri servizi AWS. La modalità di integrazione dipende dal fatto che il servizio sia produttore o consumer:
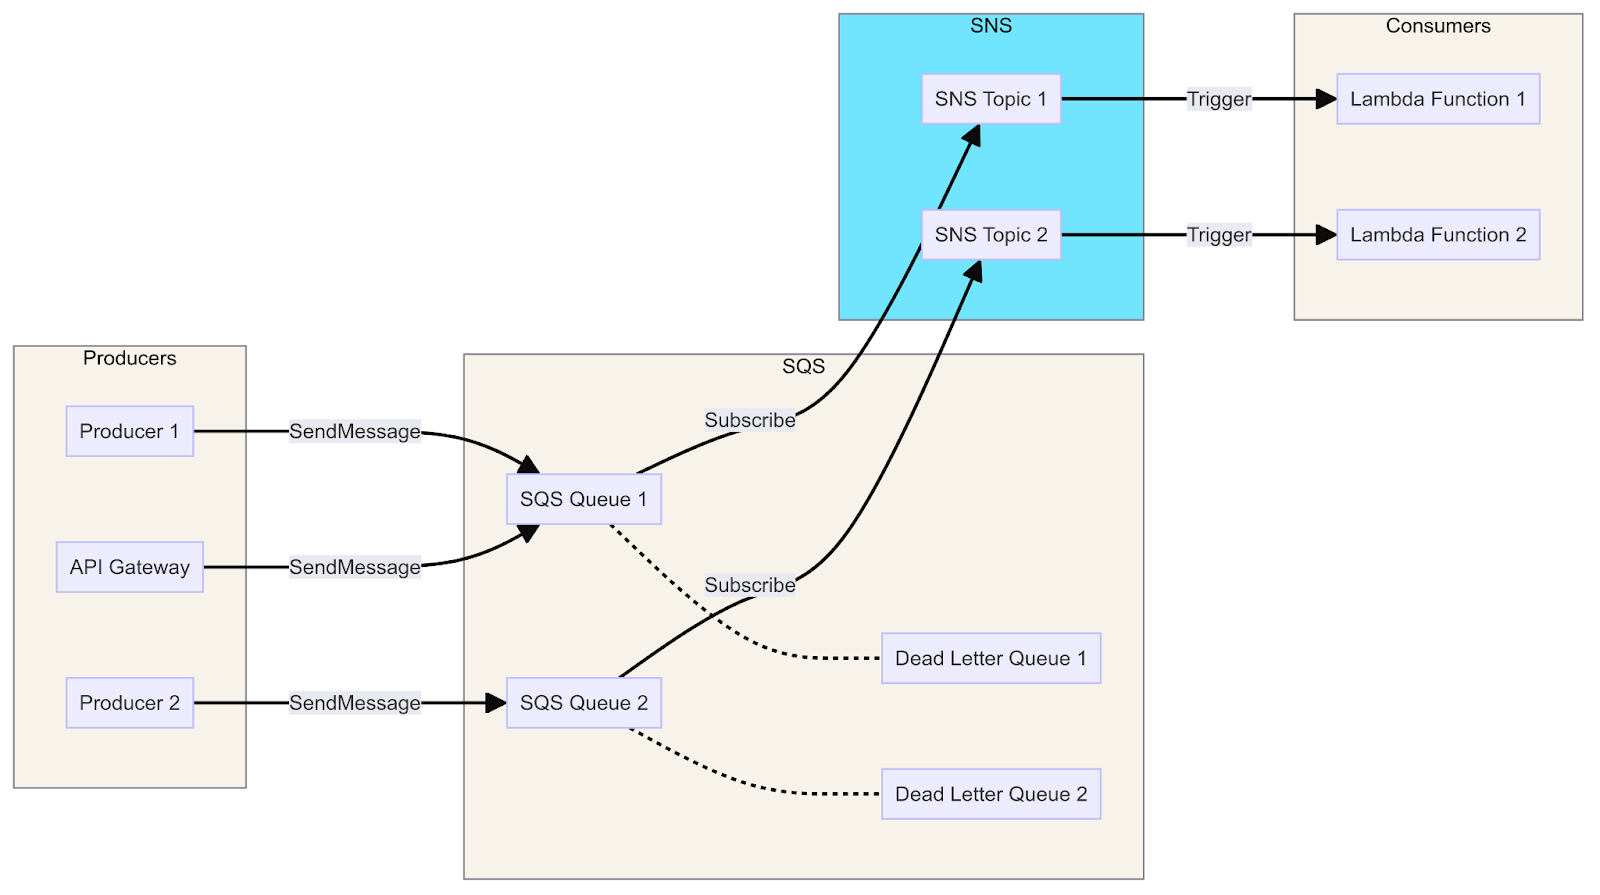
Un diagramma che mostra l’integrazione di SQS con Lambda, SNS e API Gateway, illustrando il flusso di messaggi dai producer ai consumer tramite code, topic e funzioni.
Vediamo ora producer e consumer in azione. Ecco una guida per configurare e usare AWS SQS con Python, con i passaggi di base per l’installazione e un esempio di producer e consumer per SQS:
Se non ne hai già uno, crea un account AWS al AWS Free Tier.
Installa e configura la Command Line Interface (CLI) di AWS per gestire le tue risorse AWS.
# Install AWS CLI
pip install awscli

# Configure AWS CLI with your credentials
aws configure
Quando richiesto, fornisci access key, secret key, regione e formato di output.
Useremo la libreria boto3, l’SDK ufficiale AWS per Python, per interagire con SQS tramite Python.
boto3pip install boto3Crea una coda SQS usando la Console di gestione AWS o in modo programmatico con boto3.
import boto3

# Create SQS client
sqs = boto3.client('sqs')

# Create a new queue
response = sqs.create_queue(
    QueueName='social-media-posts',
    Attributes={
        'DelaySeconds': '0',
        'MessageRetentionPeriod': '86400'  # 1 day
    }
)
print(response['QueueUrl'])Un producer invia messaggi alla coda SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Send message to SQS queue
response = sqs.send_message(
    QueueUrl=queue_url,
    MessageBody=json.dumps(social_media_post)
)
print(response['MessageId'])Un consumer riceve ed elabora messaggi dalla coda SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Receive messages from SQS queue
response = sqs.receive_message(
    QueueUrl=queue_url,
    MaxNumberOfMessages=10,
    WaitTimeSeconds=10
)

if 'Messages' in response:
    for message in response['Messages']:
        social_media_post = json.loads(message['Body'])
        print(f"Received post: {social_media_post}")

        # Process the social media post...

        # Delete received message from queue
        sqs.delete_message(
            QueueUrl=queue_url,
            ReceiptHandle=message['ReceiptHandle']
        )

else:
    print('No messages received')
Ecco come creare facilmente una coda SQS, inviare messaggi come producer e riceverli come consumer. L’esempio precedente copre i passaggi di base per iniziare.
Per passaggi più dettagliati di configurazione, consulta la documentazione di AWS SQS.
Ora mettiamo Kafka e SQS a confronto diretto e vediamo le loro somiglianze.
Sia Kafka che SQS sono sistemi di accodamento dei messaggi progettati per facilitare la comunicazione asincrona tra componenti di un sistema distribuito. Agiscono da intermediari, consentendo ai producer di inviare messaggi e ai consumer di riceverli ed elaborarli.
Kafka e SQS disaccoppiano producer e consumer, consentendo loro di operare e scalare in modo indipendente. Questo promuove loose coupling, tolleranza ai guasti e scalabilità nei sistemi distribuiti.
Entrambi offrono meccanismi di persistenza per evitare la perdita dei messaggi in caso di guasti o riavvii. Kafka archivia i messaggi in un commit log distribuito, mentre SQS li conserva in una coda altamente durevole e disponibile.
Kafka e SQS sono progettati per essere altamente scalabili. Kafka scala orizzontalmente aggiungendo broker al cluster, mentre SQS scala automaticamente per gestire volumi crescenti di messaggi.
Entrambi offrono capacità di integrazione con altri sistemi e servizi. Kafka ha un ampio ecosistema di connettori e integrazioni, mentre SQS si integra nativamente con gli altri servizi AWS.
Pur avendo garanzie di ordinamento diverse di default, entrambi offrono meccanismi per preservare l’ordine quando necessario. Kafka garantisce l’ordine all’interno delle partition, mentre SQS offre code FIFO per un’elaborazione rigorosamente ordinata.
Kafka e SQS offrono funzionalità di monitoraggio e metriche per tenere sotto controllo prestazioni e stato di salute dei sistemi di messaggistica.
Entrambi offrono funzionalità di sicurezza, come crittografia, controllo degli accessi e meccanismi di autenticazione, per proteggere i dati in transito e a riposo.
Ora confrontiamo affiancati Kafka e SQS e annotiamo le differenze più importanti.
Kafka è una piattaforma di streaming distribuita che segue il modello publish-subscribe. È composto da un cluster di broker che archiviano e gestiscono i flussi di dati in topic. I producer pubblicano messaggi sui topic e i consumer si iscrivono ai topic per riceverli.
SQS è un servizio di messaggistica completamente gestito da AWS. Segue un modello basato su code, in cui i messaggi vengono inviati a una coda e i consumer interrogano la coda per riceverli.
Kafka fornisce semantiche di consegna “almeno una volta”, il che significa che i messaggi possono essere consegnati una o più volte. Supporta anche l’“esattamente una volta” tramite producer idempotenti e scritture transazionali.
SQS garantisce la consegna “almeno una volta”. Per altri protocolli come HTTP/HTTPS, email e SMS, Amazon SNS dovrebbe essere usato insieme a SQS.
Kafka mantiene l’ordine dei messaggi all’interno delle partition, assicurando che siano consegnati nell’ordine in cui sono stati prodotti.
SQS non garantisce l’ordine dei messaggi di default. Tuttavia, supporta i topic FIFO, che preservano l’ordine esatto dei messaggi.
Kafka archivia i messaggi su disco in un commit log distribuito, offrendo durabilità e tolleranza ai guasti. I messaggi possono essere conservati per un periodo configurabile, consentendo ai consumer di tornare indietro e riprodurli.
SQS non fornisce una persistenza a lungo termine. I messaggi sono archiviati temporaneamente fino a quando non vengono consegnati a tutti i subscriber o finché non scadono (in base al periodo di conservazione configurato).
Kafka è progettato per scalare orizzontalmente aggiungendo broker al cluster. Supporta anche la partizionazione dei topic per parallelismo e bilanciamento del carico.
SQS è un servizio completamente gestito che scala automaticamente per gestire volumi crescenti di messaggi senza interventi manuali.
Kafka ha un ricco ecosistema di connettori e integrazioni con varie sorgenti, destinazioni e framework di elaborazione, come Apache Spark, Apache Flink e Apache Kafka Streams.
SQS si integra nativamente con i servizi AWS, consentendo l’invio di notifiche verso vari endpoint, incluse funzioni AWS Lambda, code SQS ed endpoint HTTP/HTTPS.
Kafka utilizza principalmente strumenti da riga di comando come kafka-topics per la gestione dei topic e altre attività amministrative. Non ha un’interfaccia utente integrata dedicata, ma strumenti di terze parti come Kafka Manager, Kafka Tool e Confluent Control Center offrono interfacce web per la gestione dei cluster Kafka.
SQS, in quanto servizio completamente gestito, si integra con l’AWS Management Console. Questa interfaccia web consente di creare, configurare e monitorare facilmente le code SQS senza strumenti aggiuntivi.
Kafka offre librerie client per vari linguaggi, come Java, Python e Go. La sua sintassi può risultare complessa a causa di concetti come topic, partition, offset e gruppi di consumer.
SQS fornisce SDK per più linguaggi, tra cui Java, Python e Node.js. La sua sintassi è più semplice e focalizzata sull’invio e la ricezione di messaggi da/verso le code. In generale, la sintassi di SQS è più lineare, mentre quella di Kafka è più complessa per via della natura distribuita e delle funzionalità avanzate.
Il prezzo di Kafka varia in base al modello di deployment (self-managed o servizi gestiti come Confluent Cloud o Amazon MSK).
SQS segue un modello pay-as-you-go basato sul numero di richieste e sui trasferimenti dati.
Dopo aver visto somiglianze e differenze, ecco un confronto dettagliato tra Apache Kafka e Amazon SQS, concentrandoci su chi vince per ciascuna categoria, a seconda dei casi.
Kafka è un sistema di messaggistica distribuito pub-sub che opera su un’architettura di log distribuito, in cui i messaggi sono conservati in un commit log distribuito.
SQS, invece, è un sistema di messaggistica pull-based completamente gestito che si basa su un’architettura con message broker, con un servizio centrale che orchestra la gestione delle code.
L’architettura distribuita di Kafka lo rende più scalabile e tollerante ai guasti, mentre l’architettura centralizzata di SQS semplifica la gestione ma può diventare un collo di bottiglia.
Sia Kafka che Amazon SQS offrono alta scalabilità. Kafka è noto per throughput elevato, tolleranza ai guasti e scalabilità orizzontale. Può gestire grandi volumi di dati e prevede periodi di conservazione estesi.
Amazon SQS è apprezzato per la capacità di gestire milioni di messaggi al secondo e la scalabilità automatica in risposta a traffico variabile.
Kafka è più scalabile per gestire grandi volumi di dati e fornire conservazione più lunga, mentre SQS è più semplice da scalare automaticamente per carichi minori.
Kafka è progettato per garantire la persistenza dei dati tramite il suo sistema di log replicato. Offre flessibilità consentendo di configurare sia il periodo di conservazione sia lo spazio su disco utilizzato.
SQS, d’altro canto, assicura la persistenza distribuendo i messaggi su più data center, migliorando la durabilità. Ha un periodo di conservazione predefinito di 4 giorni, regolabile fino a un massimo di 14 giorni in base alle esigenze.
Entrambe le piattaforme offrono persistenza, ma Kafka garantisce maggiore flessibilità nella configurazione di conservazione e storage.
Apache Kafka e Amazon SQS offrono solide capacità di messaggistica con consegna garantita. Kafka assicura la consegna “almeno una volta” e può raggiungere la semantica “esattamente una volta” tramite meccanismi come scritture idempotenti e supporto transazionale.
SQS, a sua volta, garantisce la consegna “almeno una volta” e offre semantiche “esattamente una volta” grazie ai meccanismi di deduplicazione.
Le garanzie di consegna sono simili, con Kafka che offre funzionalità avanzate come scritture idempotenti e transazioni.
Una differenza chiave tra Kafka e SQS riguarda la gestione del consumo dei messaggi.
Kafka utilizza i gruppi di consumer per letture indipendenti da partition diverse, abilitando bilanciamento del carico e tolleranza ai guasti. SQS non ha un supporto nativo per i gruppi di consumer, quindi per ottenere funzionalità simili servono code separate per ciascun consumer.
Questo evidenzia gli approcci differenti di Kafka e SQS nella gestione dell’interazione dei consumer con i messaggi.
Il supporto ai gruppi di consumer rende Kafka più adatto a scenari con consumer multipli e load balancing.
Kafka vanta un ecosistema di integrazioni più ampio e offre connettori per vari sistemi e framework. SQS, invece, è strettamente integrato con gli altri servizi AWS, risultando semplice da inserire in qualsiasi architettura basata su AWS.
SQS vince nelle architetture basate su AWS, mentre Kafka offre più flessibilità per l’integrazione con sistemi e framework non AWS.
Confrontando Kafka e SQS, è chiaro che rispondono a esigenze diverse. Kafka richiede più impegno in termini di setup e configurazione, con una curva di apprendimento più ripida, soprattutto per i concetti di sistemi distribuiti.
SQS, al contrario, si distingue per semplicità. Essendo un servizio completamente gestito, richiede una configurazione minima e risulta una scelta più accessibile per casi d’uso lineari.
SQS è più facile da usare e con cui iniziare, mentre Kafka richiede più competenze sui sistemi distribuiti e sulla configurazione.
Kafka, essendo open-source, richiede investimenti in infrastruttura e gestione, ma può risultare più conveniente per carichi su larga scala. SQS, invece, è un servizio completamente gestito con modello pay-as-you-go, potenzialmente più economico per carichi ridotti.
SQS è in genere più conveniente per carichi ridotti, mentre Kafka può esserlo per carichi su larga scala, a seconda dei costi di infrastruttura e gestione.
Per comprendere Kafka, è necessario approfondire i sistemi distribuiti e lo stream processing. Include concetti come topic, partition, offset e gruppi di consumer. SQS, invece, ha una API user-friendly che rende semplice inviare e ricevere messaggi dalle code con SDK per più linguaggi.
SQS vince in termini di difficoltà della sintassi. Offre una API più semplice e intuitiva, facilitandone l’integrazione nelle applicazioni. La sintassi di Kafka può risultare più complessa per la sua natura distribuita e le funzionalità avanzate di streaming.
|
Kafka |
SQS |
|
Distribuita, pub-sub |
Centralizzata, pull-based |
|
Altamente scalabile per grandi volumi |
Altamente scalabile per volumi minori |
|
Periodi di conservazione configurabili |
Periodi di conservazione limitati |
|
At-least-once, exactly-once con transazioni |
At-least-once, exactly-once con deduplicazione |
|
Supportati |
Non supportati |
|
Ampio ecosistema, connettori |
Integrazione stretta con AWS |
|
Curva di apprendimento più ripida |
Completamente gestito, facile da iniziare |
|
Open-source, costi d’infrastruttura |
Pay-as-you-go |
|
Più lunga |
14 giorni |
|
Multipli |
Limitato |
|
Più complessa |
Semplice e lineare |
In conclusione, se ti serve un servizio gestito, rapido da distribuire e ben integrato nell’ecosistema AWS, AWS SQS è la scelta migliore. Semplifica la gestione delle code e scala senza sforzo, rendendolo ideale per molte applicazioni standard.
Se invece il tuo progetto richiede throughput elevato, bassa latenza e la possibilità di calibrare finemente il sistema, Apache Kafka offre la flessibilità necessaria per lo streaming e l’elaborazione dei dati in tempo reale.
La scelta dello strumento giusto dipende dalle esigenze specifiche del progetto, inclusi facilità d’uso, prestazioni, scalabilità e integrazione. Sia Kafka che SQS hanno i loro punti di forza: comprenderli ti aiuterà a sfruttare al meglio la piattaforma più adatta al tuo prossimo progetto data-driven!
Per continuare ad approfondire questi temi, dai un’occhiata a queste risorse:
Approfondisci l’infrastruttura e la gestione dei dati in streaming con questi corsi!
Corso
Corso
Pratica and corso your progress.
Continua Con Googleblog
Tim Lu
12 min
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min



