
Kursus
Memahami Rekayasa Data
2 jam
375K
Partisi adalah komponen penting dalam arsitektur terdistribusi Kafka yang memungkinkan Kafka melakukan penskalaan horizontal, sehingga pemrosesan data paralel menjadi efisien. Partisi menjadi blok bangunan untuk mengatur dan mendistribusikan data di seluruh klaster Kafka.
Anggap saja partisi sebagai saluran individual di dalam sebuah topik tempat pesan disimpan. Setiap partisi dapat memiliki beberapa replika yang tersebar di berbagai broker, sehingga menjamin toleransi kesalahan dan redundansi data.
Selain itu, partisi memberikan jaminan pengurutan, memastikan bahwa pesan dalam satu partisi diproses sesuai urutan saat diproduksi. Ini menjadikan partisi Kafka sangat penting dalam menjaga integritas dan konsistensi data, yang krusial untuk skenario pemrosesan data waktu nyata.
Dalam artikel ini, kita akan membahas lebih dalam hal-hal berikut:
Anda dapat melihat perbandingan Kafka vs SQS kami untuk panduan rinci tentang bagaimana kedua alat tersebut dibandingkan.
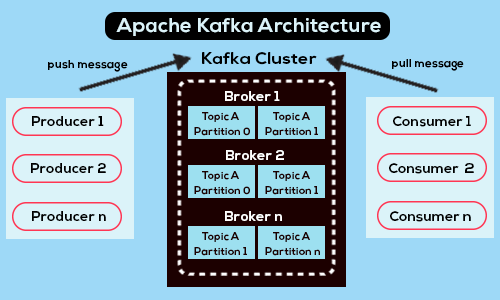
Gambaran arsitektur Kafka - Sumber
Apache Kafka adalah platform streaming terdistribusi sumber terbuka yang dirancang untuk throughput tinggi, toleransi kesalahan, dan skalabilitas, sehingga menjadi pilihan populer untuk membangun pipeline data dan aplikasi waktu nyata.
Pada intinya, Kafka terdiri dari banyak komponen. Komponen ini mencakup producer, consumer, broker, topik, dan partisi, dan masing-masing memainkan peran penting dalam sistem secara keseluruhan.
Partisi berperan kunci dalam membentuk efisiensi dan ketangguhan Kafka. Partisi memfasilitasi distribusi data di seluruh broker Kafka, memungkinkan penskalaan horizontal.
Dengan membagi topik menjadi partisi, Kafka dapat menyebarkan beban kerja pemrosesan data ke beberapa server, sehingga memungkinkan pemanfaatan sumber daya yang efisien dan mengakomodasi volume data yang meningkat tanpa membebani broker individual.
Selain itu, partisi juga memungkinkan paralelisme dalam pemrosesan data. Consumer dapat membaca dari beberapa partisi secara bersamaan, mendistribusikan beban komputasi dan meningkatkan throughput. Konsumsi data paralel ini memastikan pemanfaatan sumber daya consumer yang efisien dan mengurangi latensi dalam pipeline pemrosesan data.
Alasan lain mengapa partisi penting di Kafka adalah karena partisi membantu kemampuan toleransi kesalahan pada platform. Setiap partisi dapat memiliki beberapa replika yang didistribusikan di berbagai broker. Jika terjadi kegagalan broker, Kafka dapat terus menyajikan data dari replika yang dihosting pada broker lain, memastikan ketersediaan dan keandalan data.
Intinya, partisi penting karena banyak alasan. Partisi sangat krusial bagi arsitektur Kafka dan memainkan peran sentral dalam memungkinkan skalabilitas, toleransi kesalahan, paralelisme, dan konsistensi data.
Seperti disebutkan sebelumnya, setiap partisi bertindak sebagai urutan rekaman yang tersegmentasi, terurut, dan tidak dapat diubah. Saat producer mengirim data ke Kafka, ia menggunakan logika partisi untuk menentukan partisi mana dalam sebuah topik tempat data harus dituliskan.
Logika ini dapat didasarkan pada berbagai faktor, seperti key yang terkait dengan data atau partitioner kustom yang diimplementasikan oleh producer. Setelah partisi ditentukan, Kafka menambahkan data ke akhir partisi, mempertahankan urutan pesan berdasarkan offset-nya.
Secara internal, broker Kafka menangani penyimpanan dan replikasi data partisi. Setiap partisi dapat memiliki beberapa replika yang didistribusikan di berbagai broker untuk memastikan toleransi kesalahan.
Model leader-follower diterapkan, di mana satu broker berperan sebagai leader yang bertanggung jawab menangani permintaan baca dan tulis untuk partisi, sementara broker lain bertindak sebagai follower yang mereplikasi data dari leader. Pengaturan ini memastikan daya tahan dan ketersediaan data bahkan jika terjadi kegagalan broker.
Sebelum menyiapkan partisi Kafka, pastikan Apache Kafka dan Zookeeper telah diinstal, dikonfigurasi, dan berjalan di komputer lokal Anda. Ini direkomendasikan untuk kompatibilitas yang optimal. Selain itu, pastikan Java 8 atau versi yang lebih baru telah terpasang dan berfungsi.
Perlu dicatat bahwa Kafka dapat mengalami berbagai masalah saat diinstal di Windows karena kurangnya kompatibilitas asli dengan sistem operasi ini. Oleh karena itu, disarankan menggunakan metode berikut untuk menjalankan Apache Kafka di Windows:
Menggunakan JVM untuk menjalankan Kafka di Windows tidak dianjurkan karena tidak memiliki karakteristik POSIX tertentu yang melekat pada Linux. Mencoba menjalankan Kafka di Windows tanpa WSL2 dapat menimbulkan kesulitan pada akhirnya.
Anda dapat mempelajari lebih lanjut tentang menyiapkan Apache Kafka di Apache Kafka for Beginners: A Comprehensive Guide.
Berikut panduan langkah demi langkah untuk menyiapkan partisi:
Buka command prompt dan navigasikan ke direktori root Kafka. Setelah itu, jalankan perintah berikut untuk memulai Zookeeper:
bin/zookeeper-server-start.sh config/zookeeper.propertiesBuka command prompt lain dan jalankan perintah berikut dari root Apache Kafka untuk memulai Apache Kafka:
.\bin\windows\kafka-server-start.bat .\config\server.propertiesUntuk membuat topik dengan tiga partisi, mulai command prompt baru dari direktori root Kafka dan jalankan perintah berikut:
bin/kafka-topics.sh --create --zookeeper localhost:2181 --replication-factor 1 --partitions 3 --topic my_topicIni akan membuat topik Kafka baru bernama “my_topic.”
Catatan: untuk mengonfirmasi bahwa topik dibuat dengan benar, eksekusi perintah akan menampilkan “Create topic <name of topic>.”
Anda dapat memverifikasi bahwa topik dibuat dengan benar dengan menjalankan:
bin/kafka-topics.sh --list --zookeeper localhost:2181Yang seharusnya menghasilkan output:
my_topicRepartisi topik yang sudah ada di Kafka melibatkan modifikasi jumlah partisi, yang mungkin diperlukan untuk mengakomodasi perubahan volume data, meningkatkan paralelisme, atau mengoptimalkan pemanfaatan sumber daya.
Berikut beberapa teknik dan pertimbangan untuk merepartisi topik yang sudah ada:
kafka-topics.sh --alter untuk menambah jumlah partisi dari topik yang sudah ada. Ini akan mendistribusikan ulang data ke partisi baru.Mengoptimalkan penggunaan dan kinerja partisi di Kafka sangat penting untuk memastikan pemrosesan data yang efisien, pemanfaatan sumber daya yang optimal, dan skalabilitas sistem secara keseluruhan.
Berikut beberapa strategi untuk penyeimbangan dan optimasi partisi:
Kafka telah menjadi tulang punggung banyak aplikasi yang intensif data, tetapi meminjam kata-kata Paman Ben dari Spider-Man, dengan kekuatan besar datang pula potensi tantangan kompleks yang meningkat.
Cukup banyak masalah partisi umum yang dapat muncul saat menggunakan Kafka. Hal ini bisa disebabkan oleh salah konfigurasi, keterbatasan sumber daya, distribusi data yang tidak merata, atau hal lain.
Di bagian ini, kita akan membahas lebih dalam masalah partisi yang umum dan cara menyelesaikannya.
Ketika data didistribusikan secara tidak merata di seluruh partisi, beberapa partisi dapat menjadi hotspot, mengakibatkan pemanfaatan sumber daya yang tidak merata dan potensi hambatan kinerja. Cara mengatasinya adalah dengan terus memantau distribusi data, yang dapat dilakukan dengan alat pemantauan Kafka seperti Kafka Manager atau Confluent Control Center. Pertimbangkan juga penerapan strategi partisi kustom atau menambah jumlah partisi untuk mencapai distribusi data yang lebih seimbang.
Ketika sebuah partisi menumpuk sejumlah besar data seiring waktu, hal ini dapat menyebabkan penurunan kinerja dan peningkatan latensi saat pengambilan dan pemrosesan data.
Kunci untuk mengatasi masalah ini adalah secara rutin memantau ukuran partisi dan membagi partisi besar menjadi partisi yang lebih kecil untuk mendistribusikan data lebih merata. Selain itu, menyesuaikan kebijakan retensi membantu mengontrol jumlah data yang disimpan di partisi.
Partisi dengan replikasi kurang terjadi ketika jumlah in-sync replica (ISR) berada di bawah minimum yang dikonfigurasi akibat kegagalan broker atau masalah jaringan.
Untuk mencegah hal ini, pantau status replikasi partisi dan selidiki setiap partisi yang replikasinya kurang. Pastikan faktor replikasi dikonfigurasi dengan tepat untuk mempertahankan tingkat toleransi kesalahan yang diinginkan. Segera atasi masalah yang terkait dengan konektivitas jaringan atau kegagalan broker.
Leader partisi menangani permintaan baca dan tulis dalam klaster Kafka. Ketidakseimbangan leader partisi di seluruh broker dapat menyebabkan pemanfaatan sumber daya yang tidak merata dan potensi masalah kinerja.
Hal ini dapat dicegah dengan memantau distribusi leader partisi menggunakan Kafka Manager atau Confluent Control Center dan melakukan rebalancing leader jika diperlukan. Pertimbangkan juga penyesuaian konfigurasi broker untuk mendistribusikan leader partisi secara merata di seluruh broker.
Skew partisi terjadi ketika partisi tertentu menerima volume lalu lintas yang jauh lebih tinggi dibandingkan partisi lainnya, yang menyebabkan pemanfaatan sumber daya tidak merata dan potensi penurunan kinerja. Karena itu penting untuk menganalisis pola lalu lintas.
Pertimbangkan penerapan strategi partisi kustom untuk mendistribusikan data secara merata ke seluruh partisi dan mengoptimalkan konfigurasi consumer group untuk mendistribusikan beban kerja secara merata di antara consumer.
Apache Kafka adalah platform streaming terdistribusi yang tangguh dan menjadi tulang punggung bagi banyak aplikasi yang intensif data. Di intinya terdapat konsep partisi, yang merupakan unit esensial untuk mengatur dan mendistribusikan data dalam topik Kafka. Partisi sangat penting dalam ekosistem Kafka, memungkinkan skalabilitas, toleransi kesalahan, paralelisme, dan pemrosesan data yang efisien.
Dengan mendistribusikan data ke beberapa broker, partisi memungkinkan Kafka menangani volume data besar sambil mempertahankan throughput tinggi dan keandalan. Selain itu, partisi memfasilitasi pemrosesan data paralel, memastikan pemanfaatan sumber daya yang optimal dan pengurangan latensi.
Pada akhirnya, memahami dan mengelola partisi secara efektif sangat penting untuk memaksimalkan kinerja dan keandalan klaster Kafka, menjadikannya komponen yang tak tergantikan dalam membangun pipeline data dan aplikasi waktu nyata yang skalabel dan tangguh.
Berikut beberapa sumber untuk melanjutkan pembelajaran Anda:
Terus Belajar Bersama DataCamp
Kursus
Program
Program
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



