Khóa học
Xử lý dữ liệu streaming với AWS Kinesis và Lambda
4 giờ
9.5K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleNếu bạn đang xây dựng các ứng dụng hiện đại, hẳn bạn hiểu tầm quan trọng của việc xử lý hiệu quả khối lượng dữ liệu lớn. Các nền tảng truyền sự kiện là giải pháp hàng đầu cho xử lý và phân tích dữ liệu theo thời gian thực.
Trong bài viết này, chúng ta sẽ khám phá hai nền tảng phổ biến nhất trong lĩnh vực này: Apache Kafka và Amazon Simple Queue Service (SQS). Chúng tôi sẽ so sánh điểm mạnh, điểm yếu của mỗi nền tảng và đưa ra những góc nhìn thực tiễn để giúp bạn đưa ra quyết định sáng suốt cho các dự án hướng dữ liệu.
Với những ai đã xác định rõ nhu cầu và chỉ cần một so sánh nhanh giữa Apache Kafka và Amazon SQS, bảng dưới đây sẽ là hướng dẫn súc tích. Tuy nhiên, nếu bạn cần chi tiết hơn, hãy tiếp tục đọc để xem phần so sánh toàn diện.
|
Danh mục |
Kafka |
SQS |
Bên vượt trội |
|
Kiến trúc |
Phân tán, pub-sub |
Tập trung, dựa trên pull |
Kafka |
|
Khả năng mở rộng |
Mở rộng rất tốt cho khối lượng lớn |
Mở rộng rất tốt cho khối lượng nhỏ hơn |
Kafka cho lớn, SQS cho nhỏ |
|
Lưu trữ thông điệp |
Thời gian lưu trữ cấu hình được |
Thời gian lưu trữ giới hạn |
Kafka |
|
Giao nhận thông điệp |
Ít nhất một lần, đúng một lần với giao dịch |
Ít nhất một lần, đúng một lần với khử trùng lặp |
Hòa |
|
Nhóm consumer |
Hỗ trợ |
Không hỗ trợ |
Kafka |
|
Tích hợp |
Hệ sinh thái rộng, nhiều connector |
Tích hợp chặt với AWS |
Kafka cho ngoài AWS, SQS cho trong AWS |
|
Dễ sử dụng |
Đường cong học tập dốc hơn |
Dịch vụ quản lý hoàn toàn, dễ bắt đầu |
SQS |
|
Chi phí |
Mã nguồn mở, tốn chi phí hạ tầng |
Trả theo mức dùng |
SQS cho tải nhỏ, Kafka cho tải lớn |
|
Lưu giữ thông điệp |
Dài hơn |
14 ngày |
Kafka |
|
Hỗ trợ giao thức |
Nhiều |
Hạn chế |
Kafka |
|
Độ khó cú pháp |
Phức tạp hơn |
Đơn giản và trực quan |
SQS |
Các nền tảng truyền sự kiện như Apache Kafka và Amazon SQS được ưa chuộng trong môi trường hiện đại hướng dữ liệu. Chúng cho phép bạn thu thập, xử lý và phân tích dữ liệu ngay khi dữ liệu được tạo ra, từ đó đưa ra quyết định nhanh hơn và nâng cao khả năng phản hồi.
Dưới đây là một số lý do vì sao các nền tảng truyền sự kiện như Kafka và SQS lại quan trọng:
Các nền tảng truyền sự kiện cho phép thu thập dữ liệu liên tục và xử lý dữ liệu theo thời gian thực. Khả năng này đặc biệt phù hợp với các ứng dụng cần insight và hành động tức thì, như hệ thống giao dịch tài chính, phát hiện gian lận và giám sát mạng xã hội. Bằng cách xử lý dữ liệu ngay khi đến, bạn có thể ra quyết định kịp thời và phản ứng nhanh trước các sự kiện phát sinh.
Các nền tảng này hỗ trợ giao tiếp bất đồng bộ, tách rời nhà sản xuất (producer) và người tiêu thụ (consumer) dữ liệu. Sự tách rời này cho phép các thành phần hệ thống hoạt động độc lập, nâng cao khả năng chịu lỗi và linh hoạt. Giao tiếp bất đồng bộ cũng cho phép các dịch vụ mở rộng độc lập và phát triển mà không gây gián đoạn đến các thành phần khác.
Cả Kafka và SQS đều được thiết kế cho khả năng mở rộng cao và độ tin cậy lớn. Kafka có thể xử lý hàng triệu sự kiện mỗi giây bằng cách mở rộng ngang thông qua việc bổ sung nhiều broker. SQS tự động mở rộng để xử lý khối lượng thông điệp tăng, phù hợp với tải công việc biến thiên. Những khả năng này đảm bảo các nền tảng có thể đáp ứng yêu cầu của tác vụ xử lý dữ liệu quy mô lớn.
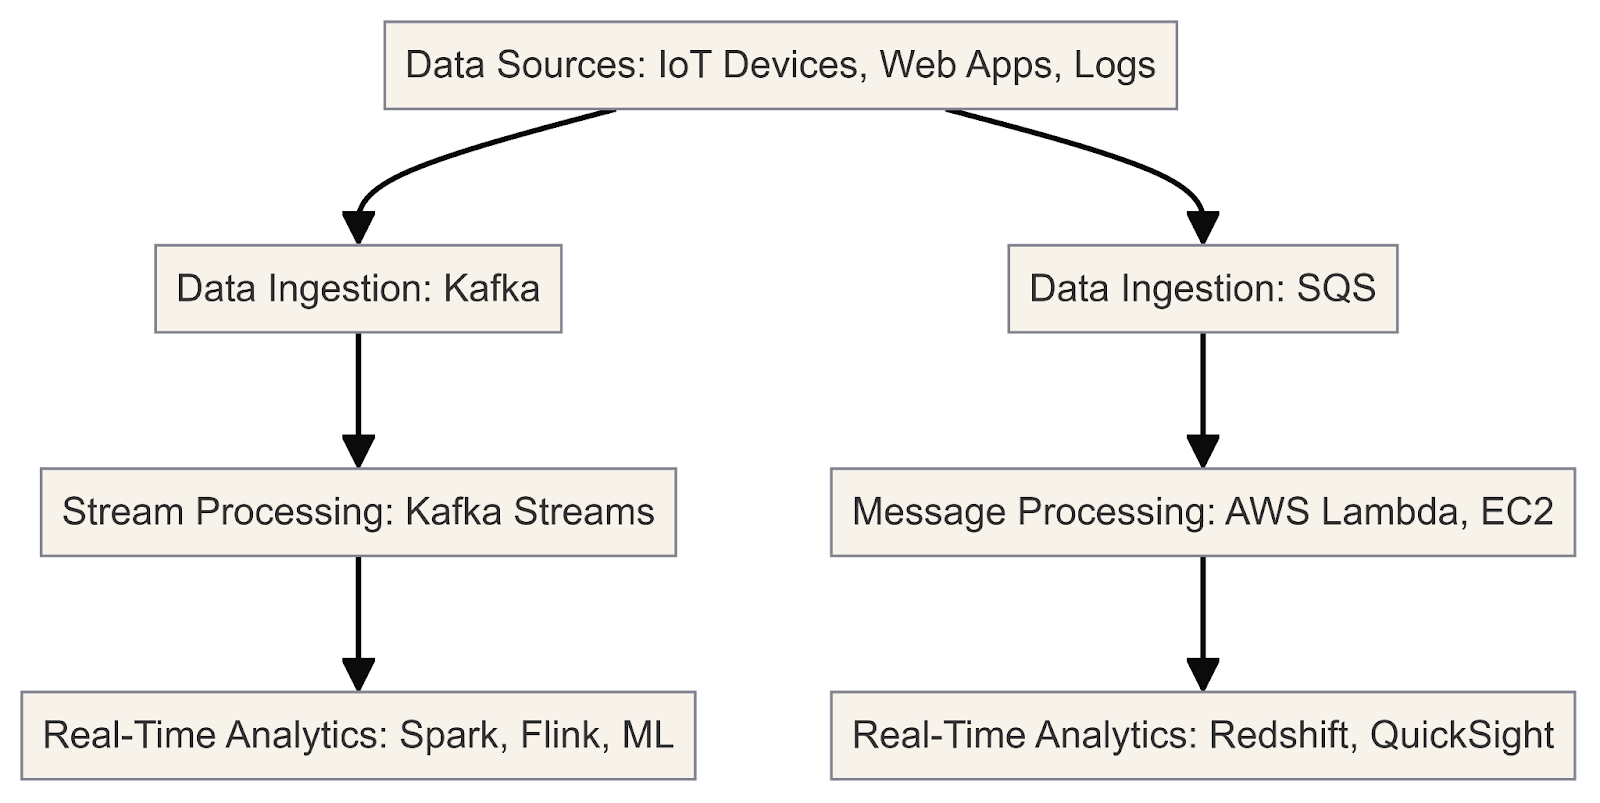
Sơ đồ này minh họa quy trình xử lý và phân tích dữ liệu theo thời gian thực với Kafka và SQS
Giờ khi đã làm rõ tầm quan trọng của các nền tảng streaming, hãy cùng xem chi tiết về Kafka và SQS.
Apache Kafka là một nền tảng truyền sự kiện phân tán mã nguồn mở, được thiết kế để xử lý các luồng dữ liệu theo thời gian thực với khối lượng lớn. Thường được dùng cho các tác vụ như nhắn tin, tổng hợp log, xử lý luồng và commit log.
Kiến trúc của Kafka được xây dựng cho khả năng mở rộng cao và chịu lỗi, khiến nó trở thành lựa chọn hàng đầu cho các ứng dụng hướng dữ liệu. Hãy hình dung Kafka như một đường ống dữ liệu hiệu năng cao cho phép bạn dễ dàng tạo các pipeline dữ liệu và ứng dụng theo thời gian thực.
Là một lập trình viên, bạn có thể tận dụng các thành phần lõi của Kafka để xử lý hiệu quả các luồng dữ liệu thời gian thực. Dưới đây là ví dụ thực tiễn về cách Kafka hoạt động với Python:
Truy cập trang Apache Kafka và tải về phiên bản mới nhất. Chọn gói nhị phân phù hợp với hệ điều hành của bạn.
Giải nén gói đã tải vào thư mục bạn chọn. Thư mục này sẽ là thư mục cài đặt Kafka của bạn.
Trong Terminal, điều hướng đến thư mục Kafka đã giải nén và khởi động các dịch vụ Zookeeper và Kafka broker bằng các script đi kèm:
# Start Zookeeper
bin/zookeeper-server-start.sh config/zookeeper.properties
# Start Kafka broker
bin/kafka-server-start.sh config/server.properties
Lưu ý Zookeeper hiện được đánh dấu là lỗi thời và dự kiến sẽ bị loại bỏ trong Apache Kafka 4.0. Để biết thêm chi tiết, xem tài liệu.
Broker là các máy chủ Kafka xử lý lưu trữ và sao chép luồng dữ liệu. Bạn có thể tương tác với broker qua công cụ dòng lệnh hoặc bằng lập trình thông qua thư viện client.
Dưới đây là ví dụ sử dụng công cụ dòng lệnh để quản lý và tương tác với các topic Kafka:
bin/kafka-topics.sh --create --topic my_topic --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1bin/kafka-topics.sh --list --bootstrap-server localhost:9092bin/kafka-console-producer.sh --topic my_topic --bootstrap-server localhost:9092bin/kafka-console-consumer.sh --topic my_topic --bootstrap-server localhost:9092 --from-beginningĐảm bảo bạn đã cài đặt Python trên hệ thống. Thư viện client Python của Kafka hỗ trợ Python 3.7 trở lên.
Tạo môi trường ảo để cô lập các phụ thuộc của dự án. Bạn có thể dùng venv.
Đây là thư viện client Python chính thức cho Apache Kafka:
pip install kafka-pythonTùy theo yêu cầu dự án, bạn có thể cần cài thêm thư viện, như json cho tuần tự hóa/giải tuần tự JSON.
Sau đó, dùng script sau để liệt kê broker bằng lập trình:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# List the available brokers
brokers = admin_client.describe_cluster()
print("Brokers:", brokers['brokers'])Partition là cách Kafka đạt được song song hóa và khả năng mở rộng. Mỗi partition là một chuỗi bản ghi bất biến, có thứ tự và được ghi nối tiếp liên tục. Bạn có thể cấu hình số lượng partition cho một topic khi tạo nó:
from kafka.admin import KafkaAdminClient, NewTopic

# Create an AdminClient
admin_client = KafkaAdminClient(bootstrap_servers='localhost:9092', client_id='test')

# Create a new topic with 3 partitions
topic = NewTopic(name="social-media-posts", num_partitions=3, replication_factor=1)
admin_client.create_topics([topic])
Hiểu về partition sẽ giúp bạn tối ưu ứng dụng để đạt hiệu năng và khả năng chịu lỗi tốt hơn.
Khi đã cài đặt Kafka và các thư viện Python cần thiết, bạn có thể bắt đầu viết ứng dụng producer và consumer Kafka bằng Python.
Dưới đây là ví dụ cách tạo một producer Kafka để xuất bản bài đăng mạng xã hội và một consumer để xử lý chúng:
Producer là các client xuất bản luồng dữ liệu vào các topic Kafka. Chúng có thể được tích hợp vào ứng dụng, dịch vụ hoặc nguồn dữ liệu của bạn để đẩy dữ liệu vào Kafka theo thời gian thực.
from kafka import KafkaProducer
import json

# Create a Kafka producer
producer = KafkaProducer(bootstrap_servers='localhost:9092',
                         value_serializer=lambda m: json.dumps(m).encode('utf-8'))

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Publish the social media post to the 'social-media-posts' topic
producer.send('social-media-posts', social_media_post)Consumer là các client đăng ký một hoặc nhiều topic và tiêu thụ luồng dữ liệu từ Kafka. Chúng có thể triển khai nhiều mẫu tiêu thụ khác nhau tùy nhu cầu ứng dụng của bạn.
from kafka import KafkaConsumer
import json

# Create a Kafka consumer
consumer = KafkaConsumer('social-media-posts',
                         bootstrap_servers='localhost:9092',
                         value_deserializer=lambda m: json.loads(m.decode('utf-8')))

# Consume and process social media posts
for message in consumer:
    social_media_post = message.value
    print(f"Received post: {social_media_post}")
    # Process the social media post...
Đoạn mã mẫu này cung cấp cái nhìn tổng quan về việc cài đặt Kafka, thiết lập môi trường Python và triển khai producer, consumer Kafka cho xử lý dữ liệu theo thời gian thực.
SQS là dịch vụ xếp hàng thông điệp được AWS quản lý hoàn toàn. Nó cho phép bạn tách rời và mở rộng microservice, hệ thống phân tán và ứng dụng serverless.
Về cốt lõi, SQS là một hệ thống hàng đợi phân tán cho phép bạn gửi, lưu trữ và nhận thông điệp giữa các thành phần phần mềm một cách bất đồng bộ. Các thông điệp này có thể là dữ liệu văn bản, thông báo hệ thống hoặc thậm chí là con trỏ đến dữ liệu lớn hơn được lưu ở các dịch vụ AWS khác như S3 hoặc DynamoDB.
Một lợi ích chính của SQS là loại bỏ nhu cầu quản lý hạ tầng hàng đợi thông điệp. AWS xử lý phần quản lý hàng đợi, mở rộng và chịu lỗi ở tầng nền, cho phép bạn tập trung vào logic ứng dụng.
SQS cung cấp hai loại hàng đợi:
Một ưu điểm của SQS là thuộc hệ sinh thái AWS nên dễ dàng tích hợp với các dịch vụ AWS khác. Cách tích hợp phụ thuộc vào việc dịch vụ là producer hay consumer:
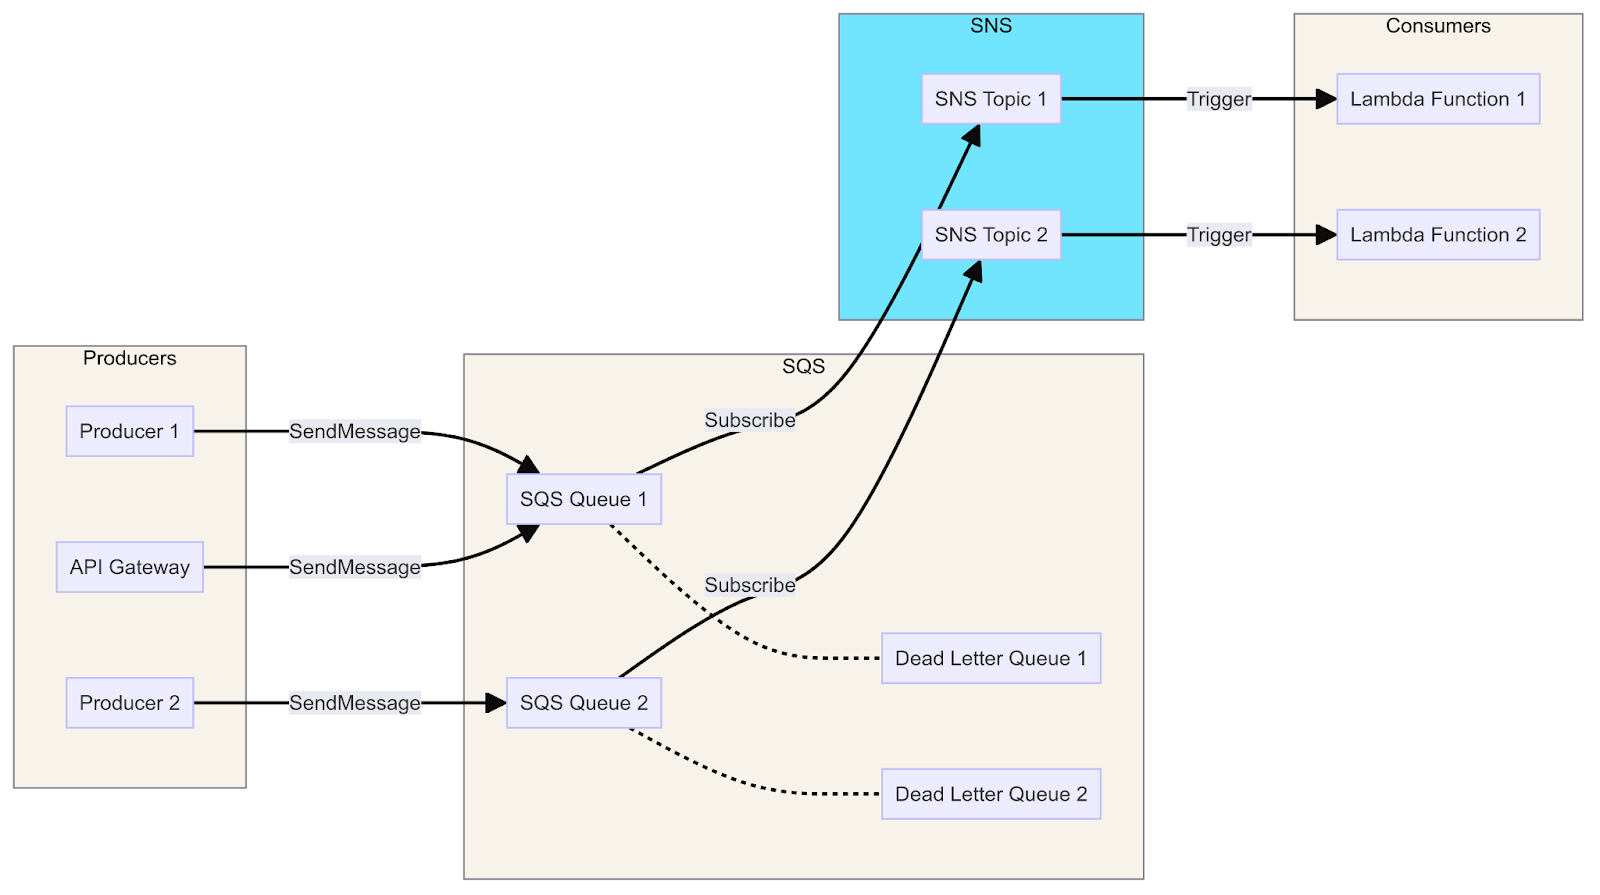
Sơ đồ cho thấy việc tích hợp SQS với Lambda, SNS và API Gateway, minh họa luồng thông điệp từ producer đến consumer thông qua hàng đợi, topic và hàm.
Giờ hãy xem producer và consumer trong thực tế. Dưới đây là hướng dẫn thiết lập và sử dụng AWS SQS với Python, bao gồm các bước cài đặt cơ bản và ví dụ producer, consumer cho SQS:
Nếu bạn chưa có, hãy tạo tài khoản AWS tại AWS Free Tier.
Cài đặt và cấu hình AWS Command Line Interface (CLI) để quản lý tài nguyên AWS của bạn.
# Install AWS CLI
pip install awscli

# Configure AWS CLI with your credentials
aws configure
Cung cấp access key, secret key, region và định dạng đầu ra của bạn khi được hỏi.
Chúng ta sẽ sử dụng thư viện boto3, SDK chính thức của AWS cho Python, để tương tác với SQS bằng Python.
boto3pip install boto3Tạo một hàng đợi SQS bằng AWS Management Console hoặc bằng lập trình với boto3.
import boto3

# Create SQS client
sqs = boto3.client('sqs')

# Create a new queue
response = sqs.create_queue(
    QueueName='social-media-posts',
    Attributes={
        'DelaySeconds': '0',
        'MessageRetentionPeriod': '86400'  # 1 day
    }
)
print(response['QueueUrl'])Producer gửi thông điệp vào hàng đợi SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Define a social media post
social_media_post = {
    'platform': 'Twitter',
    'user': 'john_doe',
    'text': 'Had a great time at the concert last night! #music #live'
}

# Send message to SQS queue
response = sqs.send_message(
    QueueUrl=queue_url,
    MessageBody=json.dumps(social_media_post)
)
print(response['MessageId'])Consumer nhận và xử lý thông điệp từ hàng đợi SQS.
import boto3
import json

# Create SQS client
sqs = boto3.client('sqs')
queue_url = 'https://sqs.us-east-1.amazonaws.com/123456789012/social-media-posts'  # Replace with your Queue URL

# Receive messages from SQS queue
response = sqs.receive_message(
    QueueUrl=queue_url,
    MaxNumberOfMessages=10,
    WaitTimeSeconds=10
)

if 'Messages' in response:
    for message in response['Messages']:
        social_media_post = json.loads(message['Body'])
        print(f"Received post: {social_media_post}")

        # Process the social media post...

        # Delete received message from queue
        sqs.delete_message(
            QueueUrl=queue_url,
            ReceiptHandle=message['ReceiptHandle']
        )

else:
    print('No messages received')
Đó là cách bạn có thể dễ dàng tạo hàng đợi SQS, gửi thông điệp như một producer và nhận thông điệp như một consumer. Ví dụ trên bao quát các bước cơ bản để bạn bắt đầu.
Để biết các bước thiết lập chi tiết hơn, hãy xem tài liệu AWS SQS.
Giờ hãy so sánh song song Kafka và SQS để xem những điểm giống nhau.
Cả Kafka và SQS đều là hệ thống xếp hàng thông điệp được thiết kế để hỗ trợ giao tiếp bất đồng bộ giữa các thành phần của hệ thống phân tán. Chúng đóng vai trò trung gian, cho phép producer gửi thông điệp và consumer nhận, xử lý các thông điệp đó.
Kafka và SQS tách rời producer và consumer, cho phép chúng vận hành và mở rộng độc lập. Sự tách rời này thúc đẩy liên kết lỏng lẻo, khả năng chịu lỗi và khả năng mở rộng trong hệ thống phân tán.
Cả Kafka và SQS đều có cơ chế lưu trữ thông điệp, đảm bảo không mất thông điệp khi có lỗi hoặc khởi động lại hệ thống. Kafka lưu thông điệp trong commit log phân tán, còn SQS lưu trong hàng đợi có độ bền và tính sẵn sàng cao.
Kafka và SQS được thiết kế để có khả năng mở rộng rất cao. Kafka có thể mở rộng ngang bằng cách thêm broker vào cụm, trong khi SQS tự động mở rộng để xử lý khối lượng thông điệp tăng.
Cả Kafka và SQS đều cung cấp khả năng tích hợp với các hệ thống và dịch vụ khác. Kafka có hệ sinh thái rộng với nhiều connector và tích hợp, trong khi SQS tích hợp liền mạch với các dịch vụ AWS khác.
Dù mặc định có khác nhau về đảm bảo thứ tự, cả hai hệ thống đều có cơ chế bảo toàn thứ tự khi cần. Kafka đảm bảo thứ tự trong phạm vi partition, còn SQS cung cấp hàng đợi FIFO để xử lý theo thứ tự nghiêm ngặt.
Kafka và SQS cung cấp khả năng giám sát và số liệu, cho phép người dùng theo dõi hiệu năng và tình trạng của hệ thống nhắn tin.
Cả Kafka và SQS đều có các tính năng bảo mật như mã hóa, kiểm soát truy cập và cơ chế xác thực để bảo vệ dữ liệu khi truyền và khi lưu trữ.
Giờ hãy so sánh song song Kafka và SQS và ghi nhận những khác biệt quan trọng nhất.
Kafka là nền tảng streaming phân tán theo mô hình xuất bản/đăng ký. Nó bao gồm một cụm broker lưu trữ và quản lý luồng dữ liệu trong các topic. Producer xuất bản thông điệp vào topic, còn consumer đăng ký topic để nhận thông điệp.
SQS là dịch vụ nhắn tin được AWS quản lý hoàn toàn. Nó theo mô hình hàng đợi, nơi thông điệp được gửi vào hàng đợi và consumer thăm dò (poll) hàng đợi để nhận thông điệp.
Kafka cung cấp ngữ nghĩa giao nhận “ít nhất một lần”, nghĩa là thông điệp có thể được chuyển phát một hoặc nhiều lần. Nó cũng hỗ trợ “đúng một lần” thông qua producer idempotent và ghi giao dịch.
SQS đảm bảo giao nhận “ít nhất một lần”. Với các giao thức khác như HTTP/HTTPS, email và SMS, cần dùng Amazon SNS kết hợp với SQS.
Kafka duy trì thứ tự thông điệp trong phạm vi partition, đảm bảo thông điệp được chuyển theo đúng thứ tự sản sinh.
SQS không đảm bảo thứ tự theo mặc định. Tuy nhiên, nó hỗ trợ topic FIFO, bảo toàn chính xác thứ tự thông điệp.
Kafka lưu thông điệp trên đĩa dưới dạng commit log phân tán, cung cấp độ bền và khả năng chịu lỗi. Thông điệp có thể được lưu giữ trong thời gian cấu hình, cho phép consumer tua lại và phát lại thông điệp.
SQS không cung cấp lưu trữ thông điệp dài hạn. Thông điệp được lưu tạm thời cho đến khi được chuyển đến tất cả subscriber hoặc đến khi hết hạn (dựa trên thời gian lưu giữ đã cấu hình).
Kafka được thiết kế để mở rộng ngang bằng cách thêm broker vào cụm. Nó cũng hỗ trợ phân vùng (partition) topic để song song hóa và cân bằng tải.
SQS là dịch vụ được quản lý hoàn toàn, tự động mở rộng để xử lý khối lượng thông điệp tăng mà không cần can thiệp thủ công.
Kafka có hệ sinh thái tích hợp phong phú và cung cấp connector cho nhiều nguồn, đích dữ liệu và khung xử lý như Apache Spark, Apache Flink và Apache Kafka Streams.
SQS tích hợp liền mạch với các dịch vụ AWS khác, cho phép bạn gửi thông báo đến nhiều đầu mút, bao gồm hàm AWS Lambda, hàng đợi SQS và endpoint HTTP/HTTPS.
Kafka chủ yếu sử dụng công cụ dòng lệnh như kafka-topics để quản lý topic và các tác vụ quản trị khác. Nó thiếu giao diện người dùng tích hợp chuyên biệt, nhưng các công cụ bên thứ ba như Kafka Manager, Kafka Tool và Confluent Control Center cung cấp giao diện web để quản lý cụm Kafka.
SQS, với vai trò là dịch vụ quản lý hoàn toàn, tích hợp liền mạch với AWS Management Console. Giao diện web này cho phép người dùng dễ dàng tạo, cấu hình và theo dõi hàng đợi SQS mà không cần công cụ bổ sung.
Kafka cung cấp thư viện client cho nhiều ngôn ngữ như Java, Python và Go. Cú pháp có thể phức tạp do các khái niệm như topic, partition, offset và nhóm consumer.
SQS cung cấp SDK cho nhiều ngôn ngữ, bao gồm Java, Python và Node.js. Cú pháp của SQS đơn giản hơn, tập trung vào việc gửi và nhận thông điệp tới/từ hàng đợi. Cú pháp SQS trực quan hơn, trong khi Kafka phức tạp hơn do tính phân tán và các tính năng nâng cao.
Chi phí Kafka phụ thuộc vào mô hình triển khai (tự quản lý hoặc dùng dịch vụ quản lý như Confluent Cloud hay Amazon MSK).
SQS theo mô hình trả theo mức dùng, dựa trên số yêu cầu và lượng dữ liệu truyền.
Sau khi xem xét điểm giống và khác, dưới đây là so sánh chi tiết giữa Apache Kafka và Amazon SQS, tập trung vào bên vượt trội cho từng hạng mục tùy trường hợp.
Kafka là hệ thống nhắn tin pub-sub phân tán vận hành trên kiến trúc log phân tán, nơi thông điệp được lưu trong commit log phân tán.
Trong khi đó, SQS là hệ thống nhắn tin dạng pull, được quản lý hoàn toàn, dựa trên kiến trúc message broker, với dịch vụ trung tâm điều phối quản lý hàng đợi.
Kiến trúc phân tán của Kafka giúp mở rộng và chịu lỗi tốt hơn, trong khi kiến trúc tập trung của SQS đơn giản hóa quản lý nhưng có thể trở thành nút thắt cổ chai.
Cả Kafka và Amazon SQS đều có khả năng mở rộng cao. Kafka nổi tiếng với thông lượng lớn, chịu lỗi và mở rộng ngang trong xử lý streaming. Nó xử lý được khối lượng dữ liệu lớn và có thời gian lưu trữ kéo dài.
Amazon SQS nổi bật ở khả năng xử lý hàng triệu thông điệp mỗi giây và tự động mở rộng theo lưu lượng biến động.
Kafka mở rộng tốt hơn cho khối lượng dữ liệu lớn và thời gian lưu trữ dài hơn, trong khi SQS dễ tự động mở rộng cho tải nhỏ hơn.
Kafka được thiết kế để đảm bảo lưu trữ dữ liệu thông qua hệ thống log sao chép. Nó linh hoạt cho phép cấu hình cả thời gian lưu giữ và dung lượng đĩa dùng để lưu trữ dữ liệu.
Trong khi đó, SQS đảm bảo lưu trữ thông điệp bằng cách phân tán thông điệp qua nhiều trung tâm dữ liệu, tăng độ bền. Mặc định thời gian lưu giữ là 4 ngày, có thể điều chỉnh tối đa đến 14 ngày theo nhu cầu.
Cả hai đều cung cấp lưu trữ thông điệp, nhưng Kafka linh hoạt hơn trong cấu hình thời gian lưu giữ và lưu trữ.
Apache Kafka và Amazon SQS đều cung cấp khả năng nhắn tin mạnh mẽ với đảm bảo giao nhận. Kafka đảm bảo giao nhận “ít nhất một lần” và có thể đạt “đúng một lần” thông qua cơ chế như ghi idempotent và hỗ trợ giao dịch.
SQS cũng đảm bảo giao nhận “ít nhất một lần” và cung cấp ngữ nghĩa “đúng một lần” nhờ cơ chế khử trùng lặp.
Cả hai cung cấp đảm bảo giao nhận tương tự, với Kafka có thêm tính năng nâng cao như ghi idempotent và giao dịch.
Một khác biệt quan trọng giữa Kafka và SQS là cách xử lý tiêu thụ thông điệp.
Kafka sử dụng nhóm consumer để đọc độc lập từ các partition khác nhau, cho phép cân bằng tải và chịu lỗi. SQS thiếu hỗ trợ tích hợp sẵn cho nhóm consumer, nên cần hàng đợi riêng cho mỗi consumer để đạt chức năng tương tự.
Điều này cho thấy cách tiếp cận khác nhau của Kafka và SQS trong quản lý tương tác của consumer với thông điệp.
Hỗ trợ nhóm consumer của Kafka khiến nó phù hợp hơn cho kịch bản có nhiều consumer và cần cân bằng tải.
Kafka có hệ sinh thái tích hợp rộng và cung cấp connector cho nhiều hệ thống dữ liệu và framework. Ngược lại, SQS tích hợp chặt với các dịch vụ AWS, dễ đưa vào bất kỳ kiến trúc dựa trên AWS nào.
SQS vượt trội trong kiến trúc dựa trên AWS, trong khi Kafka linh hoạt hơn khi tích hợp với hệ thống và framework ngoài AWS.
Khi so sánh Kafka và SQS, có thể thấy chúng phục vụ các nhu cầu khác nhau. Kafka đòi hỏi nhiều hơn về thiết lập và cấu hình, với đường cong học tập dốc, đặc biệt khi đi sâu vào khái niệm hệ thống phân tán.
Trong khi đó, SQS nổi bật bởi sự đơn giản. Là dịch vụ quản lý hoàn toàn, nó yêu cầu thiết lập và cấu hình tối thiểu, phù hợp hơn cho các trường hợp sử dụng đơn giản.
SQS dễ dùng và dễ bắt đầu hơn, còn Kafka cần nhiều chuyên môn về hệ thống phân tán và cấu hình.
Kafka là nền tảng mã nguồn mở, cần đầu tư hạ tầng và quản trị, nhưng có thể tiết kiệm chi phí hơn cho tải quy mô lớn. Ngược lại, SQS là dịch vụ quản lý hoàn toàn với mô hình trả theo mức dùng, có thể kinh tế hơn cho tải nhỏ.
SQS thường kinh tế hơn cho tải nhỏ, trong khi Kafka có thể kinh tế hơn cho tải lớn, tùy chi phí hạ tầng và quản trị.
Để hiểu Kafka, cần đào sâu về hệ thống phân tán và xử lý luồng. Nó có nhiều khái niệm như topic, partition, offset và nhóm consumer. Trong khi đó, SQS có API thân thiện, giúp gửi/nhận thông điệp từ hàng đợi một cách đơn giản với SDK trên nhiều ngôn ngữ lập trình.
SQS vượt trội về độ khó cú pháp. API đơn giản, thân thiện hơn, dễ tích hợp vào ứng dụng. Cú pháp Kafka phức tạp hơn do tính phân tán và các tính năng streaming nâng cao.
|
Kafka |
SQS |
|
Phân tán, pub-sub |
Tập trung, dựa trên pull |
|
Mở rộng rất tốt cho khối lượng lớn |
Mở rộng rất tốt cho khối lượng nhỏ hơn |
|
Thời gian lưu trữ cấu hình được |
Thời gian lưu trữ giới hạn |
|
Ít nhất một lần, đúng một lần với giao dịch |
Ít nhất một lần, đúng một lần với khử trùng lặp |
|
Hỗ trợ |
Không hỗ trợ |
|
Hệ sinh thái rộng, nhiều connector |
Tích hợp chặt với AWS |
|
Đường cong học tập dốc hơn |
Quản lý hoàn toàn, dễ bắt đầu |
|
Mã nguồn mở, chi phí hạ tầng |
Trả theo mức dùng |
|
Dài hơn |
14 ngày |
|
Nhiều |
Hạn chế |
|
Phức tạp hơn |
Đơn giản và trực quan |
Tóm lại, nếu bạn cần một dịch vụ được quản lý, triển khai nhanh và tích hợp tốt trong hệ sinh thái AWS, AWS SQS là lựa chọn phù hợp. Nó đơn giản hóa quản lý hàng đợi và mở rộng dễ dàng, lý tưởng cho nhiều ứng dụng tiêu chuẩn.
Ngược lại, nếu dự án của bạn yêu cầu thông lượng cao, độ trễ thấp và khả năng tinh chỉnh hệ thống, Apache Kafka mang đến sự linh hoạt cho truyền và xử lý dữ liệu theo thời gian thực.
Việc chọn công cụ phù hợp phụ thuộc vào nhu cầu cụ thể của dự án, bao gồm các yếu tố như dễ sử dụng, hiệu năng, khả năng mở rộng và tích hợp. Cả Kafka và SQS đều có điểm mạnh riêng; hiểu rõ những điều này sẽ giúp bạn tận dụng nền tảng tốt nhất cho dự án hướng dữ liệu tiếp theo!
Để tiếp tục học về các chủ đề này, hãy xem các tài nguyên sau:
Tìm hiểu thêm về hạ tầng và quản lý dữ liệu streaming với các khóa học này!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
