
Program
Dasar-Dasar Bisnis Kecerdasan Buatan
12 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleLarge language models (LLM) sangat kuat, tetapi sering kesulitan menjaga gambaran besar. Ini karena LLM bekerja dengan memprediksi teks satu token, atau kata, pada satu waktu.
Pendekatan per token ini, ditambah jendela konteks yang terbatas, dapat menghasilkan respons yang terputus-putus, konteks yang hilang, dan banyak pengulangan. Ibarat mencoba menulis esai dengan menebak kata berikutnya alih-alih menyusun kerangka gagasan terlebih dahulu.
Di sinilah large concept models (LCM) bisa berguna. Alih-alih bekerja kata demi kata, LCM memproses bahasa pada tingkat kalimat dan mengabstraksikan bahasa menjadi konsep. Abstraksi ini memungkinkan model memahami bahasa secara lebih matang dan bermakna.
Large concept model (LCM) adalah jenis model bahasa yang memproses bahasa pada tingkat konsep alih-alih menganalisis kata-kata secara individual. Tidak seperti model tradisional yang memecah teks kata demi kata, LCM menafsirkan representasi semantik, yang merepresentasikan seluruh kalimat atau gagasan yang padu. Pergeseran ini memungkinkan mereka memahami makna bahasa yang lebih luas, bukan sekadar mekaniknya.
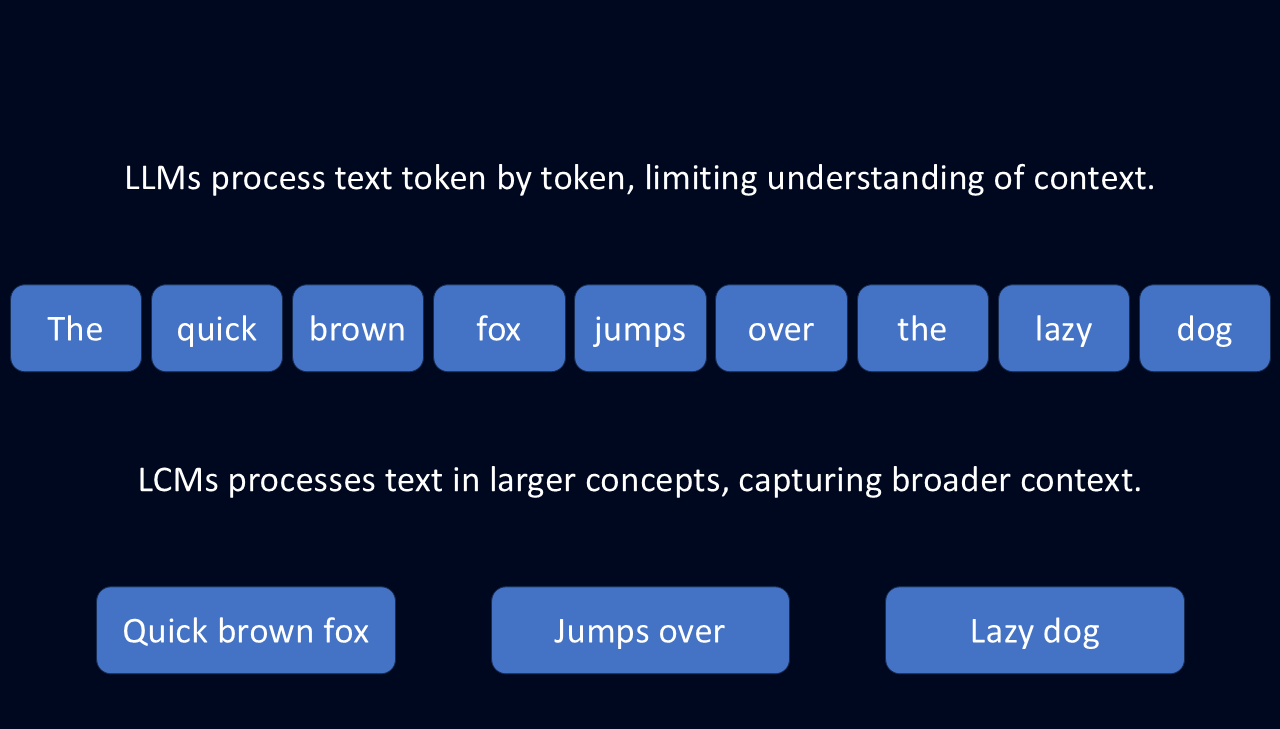
Bayangkan membaca sebuah novel. LLM akan memprosesnya token demi token, berfokus pada kata-kata individual dan tetangganya yang paling dekat. Dengan pendekatan ini, LLM bisa menghasilkan ringkasan dengan memprediksi kata berikutnya yang paling mungkin. Namun, ia mungkin melewatkan alur cerita yang lebih luas dan tema-tema mendasarnya.
LCM, sebaliknya, menganalisis bagian teks yang lebih besar untuk mengekstrak gagasan yang mendasarinya. Pendekatan ini membantu mereka memahami konsep yang lebih luas: alur cerita keseluruhan, pengembangan karakter, dan tema. Pendekatan ini tidak hanya membantu menghasilkan ringkasan yang lebih lengkap, tetapi juga membantu mengembangkan cerita dengan cara yang lebih bermakna.
Kemampuan untuk berpikir dalam konsep alih-alih kata membuat LCM sangat fleksibel. LCM dibangun di atas ruang embedding SONAR, yang memungkinkan mereka memproses teks dalam lebih dari 200 bahasa dan ucapan dalam 76 bahasa.
Alih-alih bergantung pada pola spesifik bahasa, LCM menyimpan makna pada tingkat konseptual. Abstraksi ini membuatnya mudah beradaptasi untuk tugas seperti ringkasan multibahasa, penerjemahan, dan pembuatan konten lintas format.
Karena LCM memproses bahasa pada tingkat konseptual, ia menghasilkan keluaran yang terstruktur dan sadar konteks. Berbeda dari LLM yang membangun teks kata demi kata, LCM menggunakan representasi numerik dari seluruh kalimat untuk menjaga alur logis. Ini membuatnya sangat efektif untuk tugas seperti menyusun laporan atau menerjemahkan dokumen panjang.
LCM juga memiliki desain modular, sehingga pengembang dapat mengintegrasikan bahasa atau modalitas baru tanpa melatih ulang seluruh sistem.
LLM dan LCM memiliki banyak tujuan yang sama: keduanya menghasilkan teks, merangkum informasi, dan menerjemahkan antarbahasa. Namun cara mereka mencapai tugas-tugas ini pada dasarnya berbeda.
LLM memprediksi teks satu token pada satu waktu, yang membuatnya hebat dalam menghasilkan kalimat yang fasih. Namun, ini sering menimbulkan inkonsistensi atau redundansi dalam keluaran yang lebih panjang. LCM, sebaliknya, memproses bahasa pada tingkat kalimat, sehingga dapat menjaga alur logis di bagian teks yang panjang.
Perbedaan lain adalah cara mereka menangani pemrosesan multibahasa. LLM sangat bergantung pada data pelatihan dari bahasa berdaya sumber tinggi, atau bahasa dengan banyak konten pelatihan, seperti bahasa Inggris. Akibatnya, LLM sering kesulitan dengan bahasa berdaya sumber rendah yang kekurangan dataset besar.
LCM, sebaliknya, beroperasi dalam ruang embedding SONAR. Ruang embedding ini memungkinkan mereka memproses teks dalam banyak bahasa tanpa pelatihan ulang. Bekerja dengan konsep abstrak membuatnya jauh lebih adapat beradaptasi.
|
Kapabilitas |
Cara kerja LLM |
Cara LCM meningkatkannya |
|
Fleksibilitas multibahasa dan multiformat |
Dilatih terutama pada bahasa berdaya sumber tinggi dan kesulitan dengan bahasa yang kurang umum. Membutuhkan pelatihan tambahan untuk format berbeda seperti ucapan. |
Bekerja dalam 200+ bahasa dan mendukung teks serta ucapan, tanpa pelatihan tambahan. |
|
Generalisasi ke tugas baru |
Membutuhkan fine-tuning untuk menangani bahasa atau topik baru. Kesulitan dengan data yang tidak dikenal. |
Menggunakan sistem yang independen dari bahasa, memungkinkan menangani bahasa dan tugas baru tanpa pelatihan tambahan. |
|
Koherensi dalam konten panjang |
Menulis kata demi kata, membuat respons panjang rentan terhadap inkonsistensi atau pengulangan. |
Memproses kalimat penuh sekaligus, menjaga respons tetap jelas dan lebih terstruktur pada teks panjang. |
|
Efisiensi dalam menangani konteks |
Kesulitan dengan masukan yang lebih panjang karena kebutuhan memori dan pemrosesan yang meningkat. |
Menggunakan representasi kalimat yang ringkas, sehingga lebih mudah memproses dokumen panjang secara efisien. |
Large concept models mencapai kemampuan uniknya melalui sistem tiga bagian:
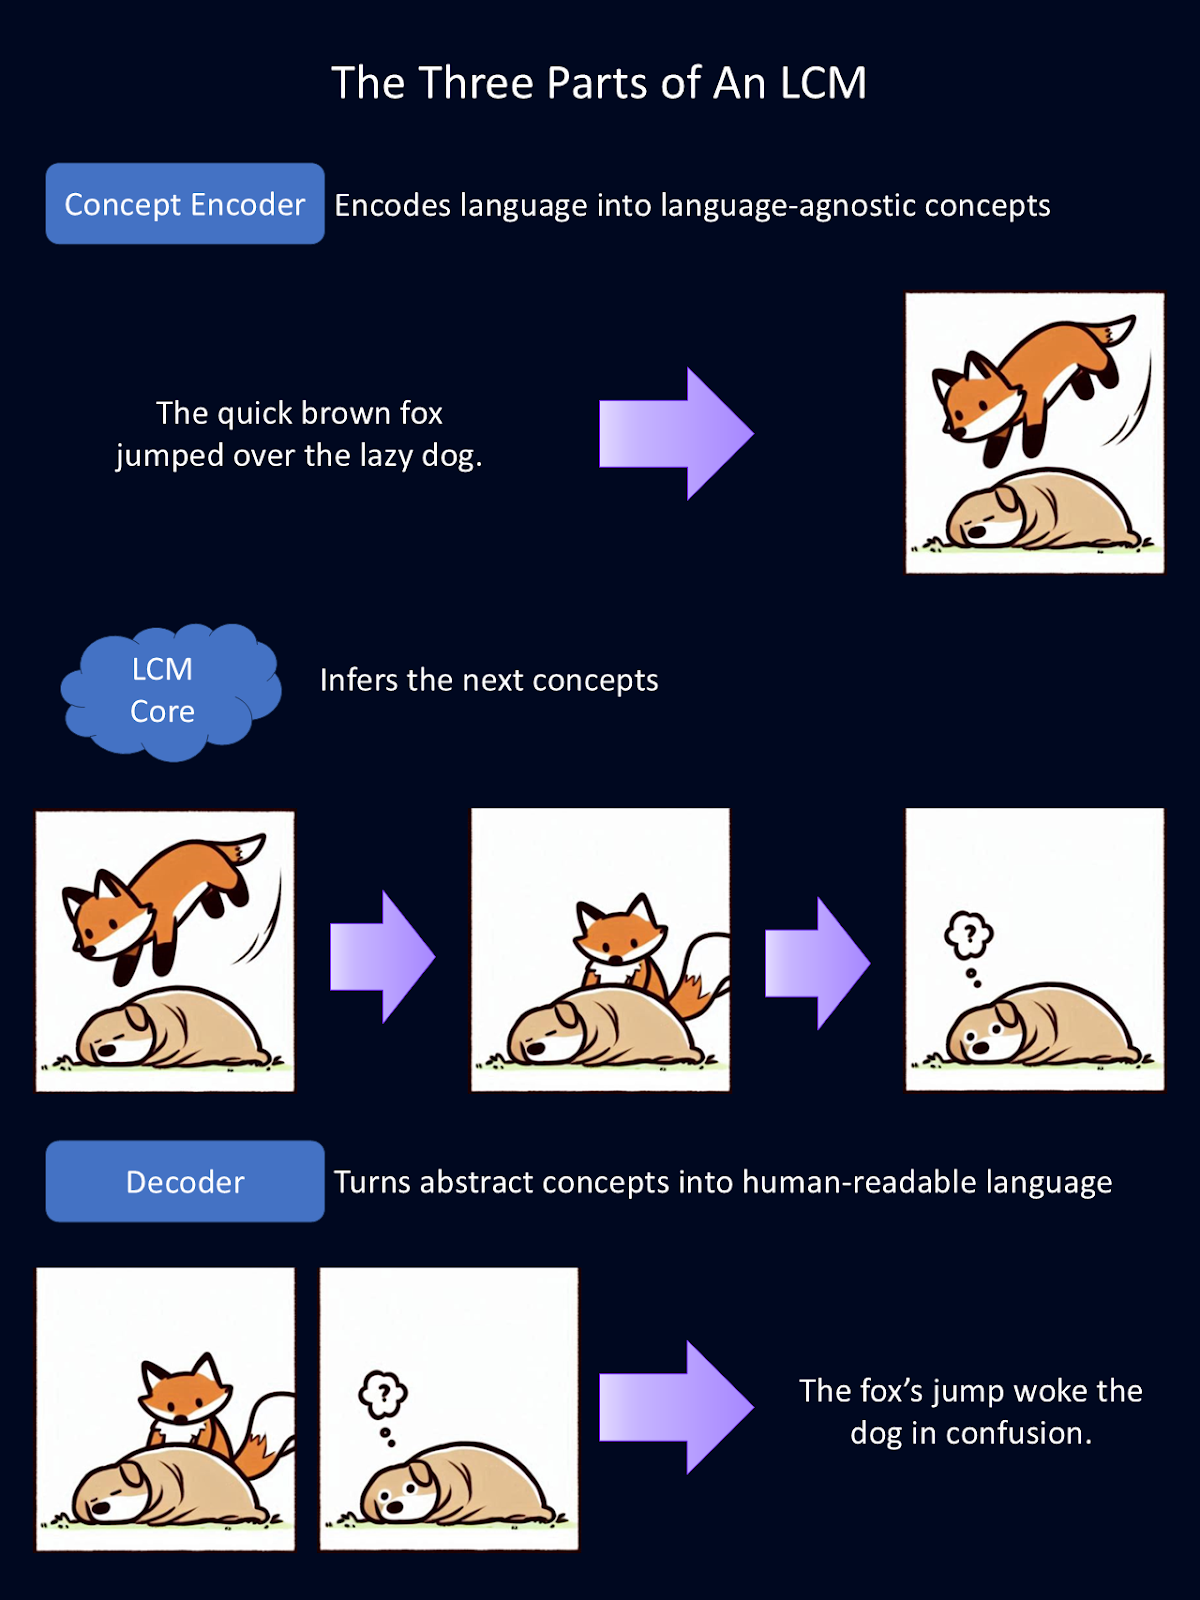
Diagram di atas adalah penjelasan sederhana tentang cara kerja masing-masing dari tiga komponen modular LCM. Encoder mengubah bahasa menjadi konsep abstrak. Di sini, konsep abstrak direpresentasikan sebagai gambar. Dalam model, konsep ini direpresentasikan secara matematis. Inti menjalankan inferensi pada konsep-konsep tersebut. Lalu decoder mengubah abstraksi itu menjadi bahasa yang dapat dibaca manusia. Untuk gambar ini, Copilot memberikan draf pertama gambar hewan.
Langkah pertama dalam pipeline pemrosesan LCM adalah mengenkode input ke representasi semantik berdimensi tinggi. Intinya, ini mengubah bahasa menjadi representasi matematis dari konsep. Concept encoder memetakan segmen teks besar, seperti seluruh kalimat.
LCM menggunakan SONAR, ruang embedding yang kuat untuk bahasa. Ruang embedding inilah yang mendukung berbagai bahasa untuk teks dan ucapan. SONAR memungkinkan encoder memproses bahasa tulis dan lisan, menyarikan konsep menjadi sesuatu yang dapat dipahami model.
Setelah konsep dienkode, inti LCM memprosesnya untuk menghasilkan konsep baru berdasarkan konteks. Di sinilah inferensi terjadi. Tidak seperti LLM, yang memprediksi teks token demi token, inti LCM memprediksi seluruh kalimat atau konsep.
Ada tiga jenis inti LCM, masing-masing dengan pendekatan berbeda untuk pemodelan konsep:
Di antara ketiganya, LCM berbasis difusi menunjukkan daya prediksi terbaik, menghasilkan keluaran yang paling akurat dan koheren secara kontekstual.
Setelah Inti LCM memproses dan memprediksi konsep baru, konsep tersebut harus diubah kembali ke bentuk yang dapat dibaca manusia. Inilah tugas concept decoder. Ia menerjemahkan representasi matematis dari konsep menjadi keluaran teks atau ucapan.
Karena konsep dasar disimpan dalam ruang embedding bersama, konsep tersebut dapat didekodekan ke bahasa apa pun yang didukung tanpa pemrosesan ulang. Ini sangat kuat karena berarti keluarannya agnostik bahasa. Semua “pemikiran” terjadi dengan matematika. Jadi, LCM yang dilatih terutama pada bahasa Inggris dan Spanyol dapat membaca input dalam bahasa Jerman, “berpikir” dalam matematika, dan menghasilkan konten dalam bahasa Jepang.
Ini juga berarti bahasa dan modalitas baru dapat ditambahkan tanpa melatih ulang seluruh model. Jika sistem speech-to-text baru dikembangkan, sistem itu dapat diintegrasikan dengan LCM yang ada tanpa memerlukan sumber daya komputasi besar.
Bayangkan jika seseorang membuat encoder dan decoder untuk bahasa isyarat. Mereka bisa menambahkannya ke inti LCM yang ada, tanpa pelatihan ulang, dan mengomunikasikan gagasan dalam format yang sepenuhnya berbeda. Fleksibilitas ini membuat LCM menjadi solusi yang skalabel dan mudah beradaptasi untuk aplikasi AI multibahasa dan multiformat.
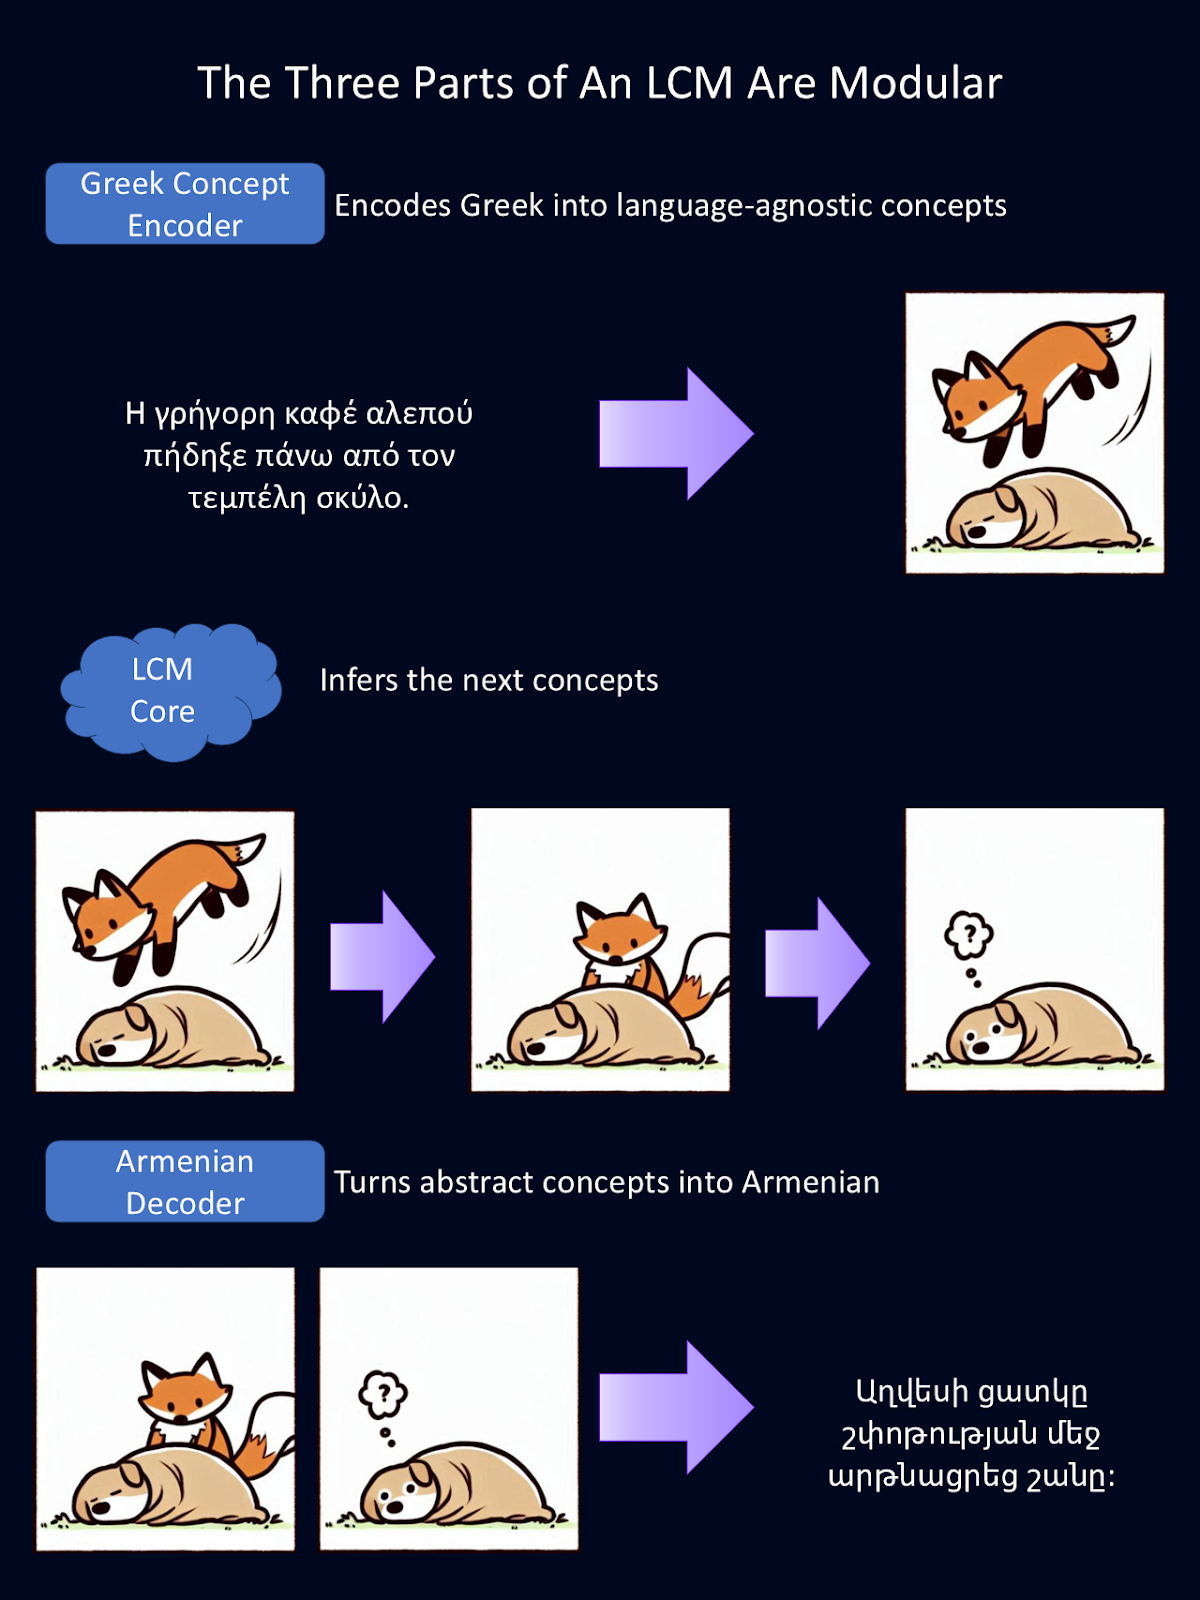
Karena setiap bagian LCM bersifat modular, masing-masing bagian dapat diganti secara independen. Pada diagram di atas, kami mengganti encoder dan decoder bahasa Inggris sebelumnya dengan encoder bahasa Yunani dan decoder bahasa Armenia.
Encoder dan decoder ini juga dapat diganti dengan yang menangani modalitas bahasa berbeda, seperti ucapan verbal alih-alih teks. Untuk gambar ini, Google Translate menyediakan terjemahan dari bahasa Inggris, dan Copilot memberikan draf pertama gambar hewan.
Aplikasi LCM tumpang tindih dengan LLM, tetapi karena fokusnya pada konsep dan pemahaman yang lebih dalam, LCM berpotensi memberikan dampak lebih besar pada industri yang memerlukan pemikiran mendalam.
LCM menyederhanakan penerjemahan dan meningkatkan pemahaman lintas bahasa dengan beroperasi dalam ruang embedding yang agnostik bahasa. Ini membuatnya sangat efektif untuk tugas seperti ringkasan multibahasa atau penerjemahan dokumen kompleks.
Sebagai contoh, LCM dapat memproses dokumen hukum yang kompleks dalam satu bahasa dan menghasilkan ringkasan yang koheren dalam bahasa lain. Kapabilitas ini sangat berharga bagi organisasi global, komunikasi internasional, dan penerjemahan yang melibatkan bahasa berdaya sumber rendah.
LCM unggul dalam menghasilkan keluaran yang koheren dan relevan secara kontekstual, sehingga ideal untuk tugas seperti menyusun laporan, menulis artikel, dan membuat ringkasan. Dengan menjaga konsistensi logis di seluruh konten panjang, LCM dapat menghasilkan keluaran yang membutuhkan jauh lebih sedikit penyuntingan dibanding LLM, menghemat waktu dan tenaga bagi profesional di bidang jurnalisme, pemasaran, dan riset.
Menurut saya, penerapan LCM untuk pendidikan adalah yang paling mengesankan. Bayangkan sistem tutor cerdas bertenaga LCM yang dapat menghasilkan konten penjelasan dan interaktif yang disesuaikan dengan masing-masing pembelajar.
Tutor LCM dapat merangkum topik kompleks menjadi segmen yang lebih sederhana dan mudah dicerna secara konseptual bagi siswa dengan tingkat keahlian yang beragam. Adaptabilitasnya lintas bahasa dapat memungkinkan satu guru mengajar siswa dalam ratusan bahasa sekaligus!
LCM juga sangat cocok untuk membantu riset dan penulisan kreatif. LCM dapat menyusun draf tulisan yang terstruktur dan koheren, seperti esai, makalah riset, atau narasi fiksi, menyediakan draf awal yang dapat disempurnakan penulis.
Peneliti juga dapat menggunakan LCM untuk mengorganisasi gagasan, mengembangkan ringkasan, atau bahkan menghasilkan hipotesis berdasarkan data yang ada. LCM memecahkan banyak masalah yang membuat peneliti frustrasi dengan LLM saat ini.
Saya yakin bukan hanya saya yang pernah mengalami frustrasi berinteraksi dengan bot dukungan pelanggan bertenaga LLM yang baru ini, tetapi tidak memahami masalah saya. Dengan LCM sebagai penggerak, chatbot dukungan pelanggan dapat menawarkan pemahaman yang lebih baik tentang situasi kompleks dan bahkan mungkin solusi yang lebih kreatif. Ini dapat meningkatkan kepuasan dan retensi pelanggan.
Saat ini, LLM digunakan dalam beberapa kapasitas tersebut, tetapi efektivitasnya terbatas. LCM berpotensi meningkatkan aplikasi-aplikasi ini. Segera, asisten AI kita mungkin lebih mirip asisten manusia nyata, mampu mengikuti gagasan dan percakapan yang lebih kompleks—hanya saja mereka dapat berkomunikasi jauh lebih cepat daripada kita.
Walau LCM menawarkan kemungkinan yang menarik, LCM juga memiliki tantangan dalam kebutuhan data, kompleksitas, dan biaya komputasi. Mari kita ulas beberapa tantangan terbesar saat ini.
Melatih model AI apa pun memerlukan data dalam jumlah besar, tetapi LCM memiliki langkah pemrosesan tambahan dibanding LLM. Alih-alih menggunakan teks mentah, LCM mengandalkan representasi tingkat kalimat, artinya teks harus terlebih dahulu dipecah menjadi kalimat lalu dikonversi menjadi embedding. Ini menambah lapisan prapemrosesan dan kebutuhan penyimpanan.
Selain itu, pelatihan pada ratusan miliar kalimat memerlukan daya komputasi yang sangat besar.
LCM memproses seluruh kalimat sebagai satuan tunggal, yang membantu menjaga alur logis, tetapi membuat penelusuran masalah menjadi lebih sulit.
LLM menghasilkan teks satu kata pada satu waktu, memungkinkan kita menelusuri kesalahan hingga token individual. Sebaliknya, LCM beroperasi dalam ruang embedding berdimensi tinggi, di mana keputusan didasarkan pada relasi abstrak.
LCM, terutama model berbasis difusi, memerlukan daya pemrosesan jauh lebih besar daripada LLM. Sementara LLM menghasilkan teks dalam satu forward pass, LCM berbasis difusi menyempurnakan keluarannya selangkah demi selangkah, yang meningkatkan waktu dan biaya komputasi. Walau LCM bisa lebih efisien untuk dokumen panjang, LCM sering kurang efisien untuk tugas bentuk pendek seperti respons cepat atau interaksi berbasis chat.
Mendefinisikan konsep pada tingkat kalimat menciptakan tantangannya sendiri. Kalimat yang lebih panjang dapat memuat banyak gagasan, sehingga sulit ditangkap sebagai satu kesatuan. Dan kalimat yang lebih pendek mungkin tidak memberikan cukup konteks untuk representasi yang bermakna.
LCM juga menghadapi masalah kelangkaan data. Karena kalimat individual jauh lebih unik daripada kata, model memiliki lebih sedikit pola berulang untuk dipelajari.
Teknologi ini berkembang pesat dan tantangan-tantangan ini sedang ditangani secara aktif. Karena teknologi ini bersifat open source, Anda dapat menambahkan solusi Anda sendiri untuk membantu mengatasi tantangan ini dan memajukan teknologi ini.
Tertarik mencoba bekerja dengan LCM? Banyak kodenya bersifat open source, jadi Anda bisa mencobanya!
Titik awal yang bagus adalah kode pelatihan LCM yang tersedia gratis dan ruang embedding SONAR. Alat open source ini memungkinkan pengembang bereksperimen dengan teknologi baru ini dan membuat peningkatan mereka sendiri.
Untuk mempelajari lebih lanjut teori di balik LCM, lihat paper ini dari Meta.
Kemampuan LCM untuk beroperasi pada tingkat konseptual berpotensi menyempurnakan interaksi AI dengan bahasa. Dengan melampaui keterbatasan analisis berbasis token, LCM membuka jalan bagi aplikasi yang lebih bernuansa, sadar konteks, dan multibahasa.
Saya mendorong Anda untuk melihat langsung kodenya dan menambahkan sentuhan Anda sendiri. Peningkatan apa yang dapat Anda buat untuk teknologi ini? Produk apa yang bisa Anda ciptakan dengannya?
Pelajari AI dengan kursus-kursus ini!
Program
Program
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
David Woods
13 mnt
blogs
Javier Canales Luna
14 mnt



