
Leerpad
Basisprincipes van AI-business
12 uur
Oefen en volg je voortgang.
Ga Verder Met GoogleGrote taalmodellen (LLM’s) zijn erg krachtig, maar ze hebben vaak moeite om het overzicht te bewaren. Dat komt omdat LLM’s werken door tekst woord voor woord, of token voor token, te voorspellen.
Deze token-voor-token aanpak, gecombineerd met een beperkte contextvenster, kan leiden tot onsamenhangende reacties, verlies van context en veel herhaling. Het is alsof je een essay probeert te schrijven door telkens het volgende woord te raden in plaats van eerst je gedachten te ordenen.
Hier kunnen large concept models (LCM’s) uitkomst bieden. In plaats van woord voor woord te werken, verwerken LCM’s taal op zinsniveau en abstraheren ze taal tot concepten. Door deze abstractie kan het model taal bedachtzamer en betekenisvoller begrijpen.
Een large concept model (LCM) is een type taalmodel dat taal op conceptniveau verwerkt in plaats van individuele woorden te analyseren. In tegenstelling tot traditionele modellen die tekst woord voor woord opdelen, interpreteren LCM’s semantische representaties die overeenkomen met volledige zinnen of samenhangende ideeën. Deze verschuiving stelt ze in staat de bredere betekenis van taal te vatten en niet alleen de mechanica.
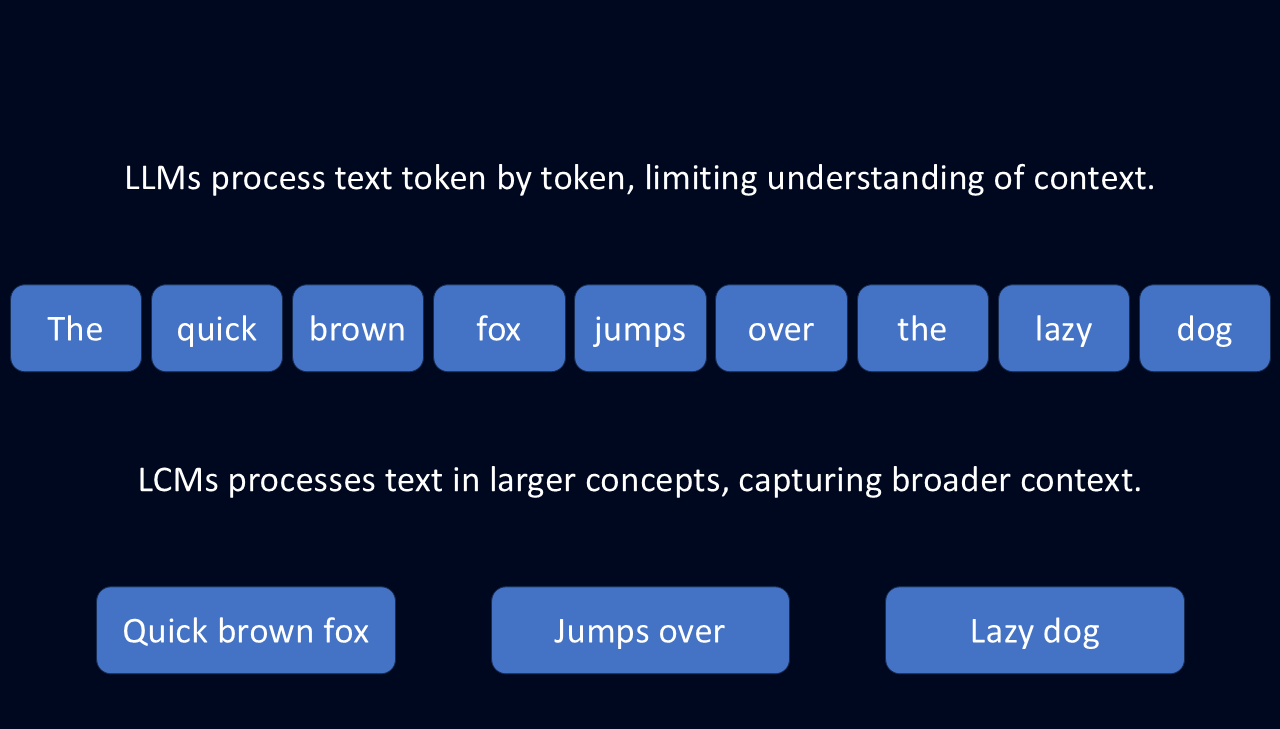
Stel je voor dat je een roman leest. Een LLM zou deze token voor token verwerken, met focus op individuele woorden en hun directe buren. Met deze aanpak kan het een samenvatting genereren door het meest waarschijnlijke volgende woord te voorspellen. Maar het kan de bredere verhaallijn en onderliggende thema’s missen.
LCM’s analyseren daarentegen grotere tekstgedeelten om de onderliggende ideeën te extraheren. Deze aanpak helpt ze de bredere concepten te begrijpen: de algemene verhaallijn, karakterontwikkeling en thema’s. Dit kan ze niet alleen helpen een vollediger samenvatting te genereren, maar ook het verhaal op een betekenisvollere manier uit te werken.
Dit vermogen om in concepten in plaats van woorden te denken, maakt LCM’s enorm flexibel. Ze zijn gebouwd op de SONAR-embeddingruimte, waardoor ze tekst in meer dan 200 talen en spraak in 76 talen kunnen verwerken.
In plaats van te vertrouwen op taalspecifieke patronen, slaan LCM’s betekenis op conceptueel niveau op. Deze abstractie maakt ze inzetbaar voor taken als meertalige samenvatting, vertaling en contentgeneratie over verschillende formaten heen.
Omdat LCM’s taal op conceptueel niveau verwerken, genereren ze gestructureerde, contextbewuste outputs. In tegenstelling tot LLM’s, die tekst woord voor woord opbouwen, gebruiken LCM’s numerieke representaties van volledige zinnen om de logische lijn vast te houden. Dit maakt ze bijzonder effectief voor taken als het opstellen van rapporten of het vertalen van lange documenten.
Ze hebben ook een modulaire opzet, waardoor ontwikkelaars nieuwe talen of modaliteiten kunnen integreren zonder het hele systeem te hertrainen.
LLM’s en LCM’s hebben veel dezelfde doelen: beide genereren tekst, vatten informatie samen en vertalen tussen talen. Maar de manier waarop ze deze taken uitvoeren, verschilt fundamenteel.
LLM’s voorspellen tekst één token per keer, waardoor ze uitstekend vloeiende zinnen produceren. Dit leidt echter vaak tot inconsistenties of herhalingen in langere outputs. LCM’s daarentegen verwerken taal op zinsniveau, waardoor ze de logische lijn over langere passages kunnen bewaren.
Een ander verschil is hoe ze meertalige verwerking aanpakken. LLM’s leunen sterk op trainingsdata uit high-resource-talen, oftewel talen met veel trainingsmateriaal, zoals Engels. Daardoor hebben ze vaak moeite met low-resource-talen waarvoor weinig datasets bestaan.
LCM’s werken daarentegen in de SONAR-embeddingruimte. Deze embeddingruimte stelt ze in staat tekst in veel talen te verwerken zonder hertraining. Werken met abstracte concepten maakt ze veel adaptiever.
|
Capaciteit |
Hoe LLM’s werken |
Hoe LCM’s dit verbeteren |
|
Meertalige en multiformat flexibiliteit |
Voornamelijk getraind op high-resource-talen en worstelen met minder voorkomende talen. Heeft extra training nodig voor andere formaten zoals spraak. |
Werkt in 200+ talen en ondersteunt tekst en spraak, zonder extra training. |
|
Generaliseerbaarheid naar nieuwe taken |
Heeft fine-tuning nodig voor nieuwe talen of onderwerpen. Heeft moeite met onbekende data. |
Gebruikt een taalonafhankelijk systeem, waardoor het nieuwe talen en taken aankan zonder extra training. |
|
Samenhang in longform content |
Schrijft woord voor woord, waardoor lange antwoorden vatbaar zijn voor inconsistentie of herhaling. |
Verwerkt volledige zinnen in één keer, waardoor antwoorden over lange tekst duidelijker en gestructureerder blijven. |
|
Efficiënt omgaan met context |
Heeft moeite met langere input door toenemende geheugen- en verwerkingsbehoefte. |
Gebruikt compacte zinsrepresentaties, waardoor lange documenten efficiënter te verwerken zijn. |
Large concept models bereiken hun unieke mogelijkheden via een drieschalig systeem:
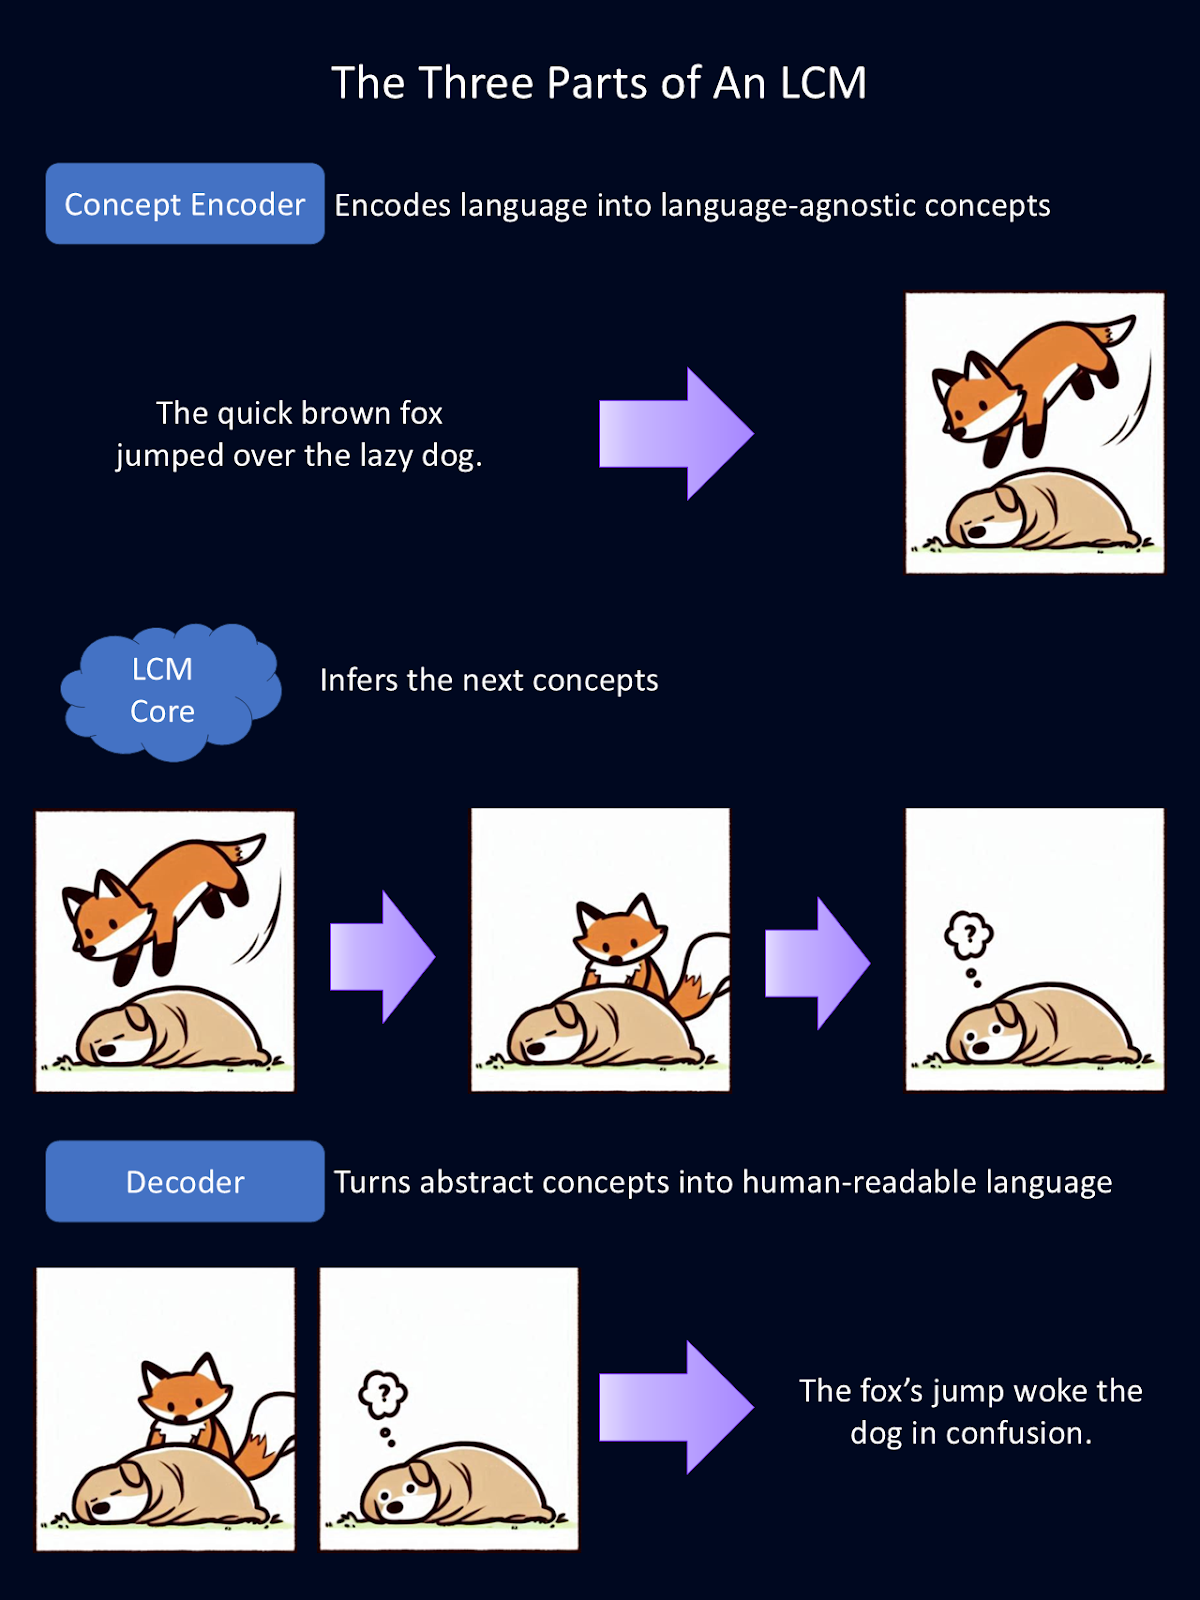
Het bovenstaande diagram is een vereenvoudigde uitleg van hoe elk van de drie modulaire onderdelen van een LCM werkt. De encoder zet taal om in abstracte concepten. Hier worden deze abstracte concepten weergegeven als afbeeldingen. In het model worden deze concepten wiskundig gerepresenteerd. De core voert daarop inferentie uit. Vervolgens zet de decoder die abstracties om in menselijk leesbare taal. Voor deze figuur verzorgde Copilot de eerste schets van de dierentekeningen.
De eerste stap in de verwerkingspijplijn van een LCM is het encoderen van input naar een hoog-dimensionale semantische representatie. In wezen zet dit taal om in wiskundige representaties van concepten. Deze conceptencoder projecteert grote tekstsegmenten, zoals volledige zinnen.
LCM’s gebruiken SONAR, een krachtige embeddingruimte voor taal. Het is deze embeddingruimte die verschillende talen voor tekst en spraak ondersteunt. SONAR stelt de encoder in staat zowel geschreven als gesproken taal te verwerken en de concepten te destilleren tot iets wat het model kan begrijpen.
Zodra concepten zijn gecodeerd, verwerkt de LCM-core ze om op basis van context nieuwe concepten te genereren. Dit is waar inferentie plaatsvindt. In tegenstelling tot LLM’s, die tekst token voor token voorspellen, voorspelt de LCM-core volledige zinnen of concepten.
Er zijn drie typen LCM-cores, elk met een eigen benadering voor het modelleren van concepten:
Van deze varianten hebben diffusiegebaseerde LCM’s de beste voorspellende kracht laten zien, met de meest accurate en contextueel samenhangende outputs.
Zodra de LCM-core nieuwe concepten heeft verwerkt en voorspeld, moeten die worden terugvertaald naar menselijk leesbare vorm. Dat is de taak van de conceptdecoder. Deze vertaalt de wiskundige representaties van concepten naar tekst- of spraakoutput.
Omdat de onderliggende concepten in een gedeelde embeddingruimte zijn opgeslagen, kunnen ze zonder herverwerking in elke ondersteunde taal worden gedecodeerd. Dit is bijzonder krachtig, omdat het betekent dat de outputs taalagnostisch zijn. Al het “denken” gebeurt met wiskunde. Dus een LCM dat voornamelijk op Engels en Spaans is getraind, kan input in het Duits lezen, “denken” in wiskunde en content genereren in het Japans.
Dit betekent ook dat nieuwe talen en modaliteiten kunnen worden toegevoegd zonder het hele model te hertrainen. Als er een nieuw spraak-naar-tekst-systeem wordt ontwikkeld, kan dit met een bestaand LCM worden geïntegreerd zonder enorme rekenkosten.
Stel dat iemand een encoder en decoder voor gebarentaal maakt. Die kunnen aan een bestaande LCM-core worden toegevoegd, zonder hertraining, en ideeën in een volledig ander formaat overbrengen. Deze flexibiliteit maakt LCM’s een schaalbare en aanpasbare oplossing voor meertalige en multiformat AI-toepassingen.
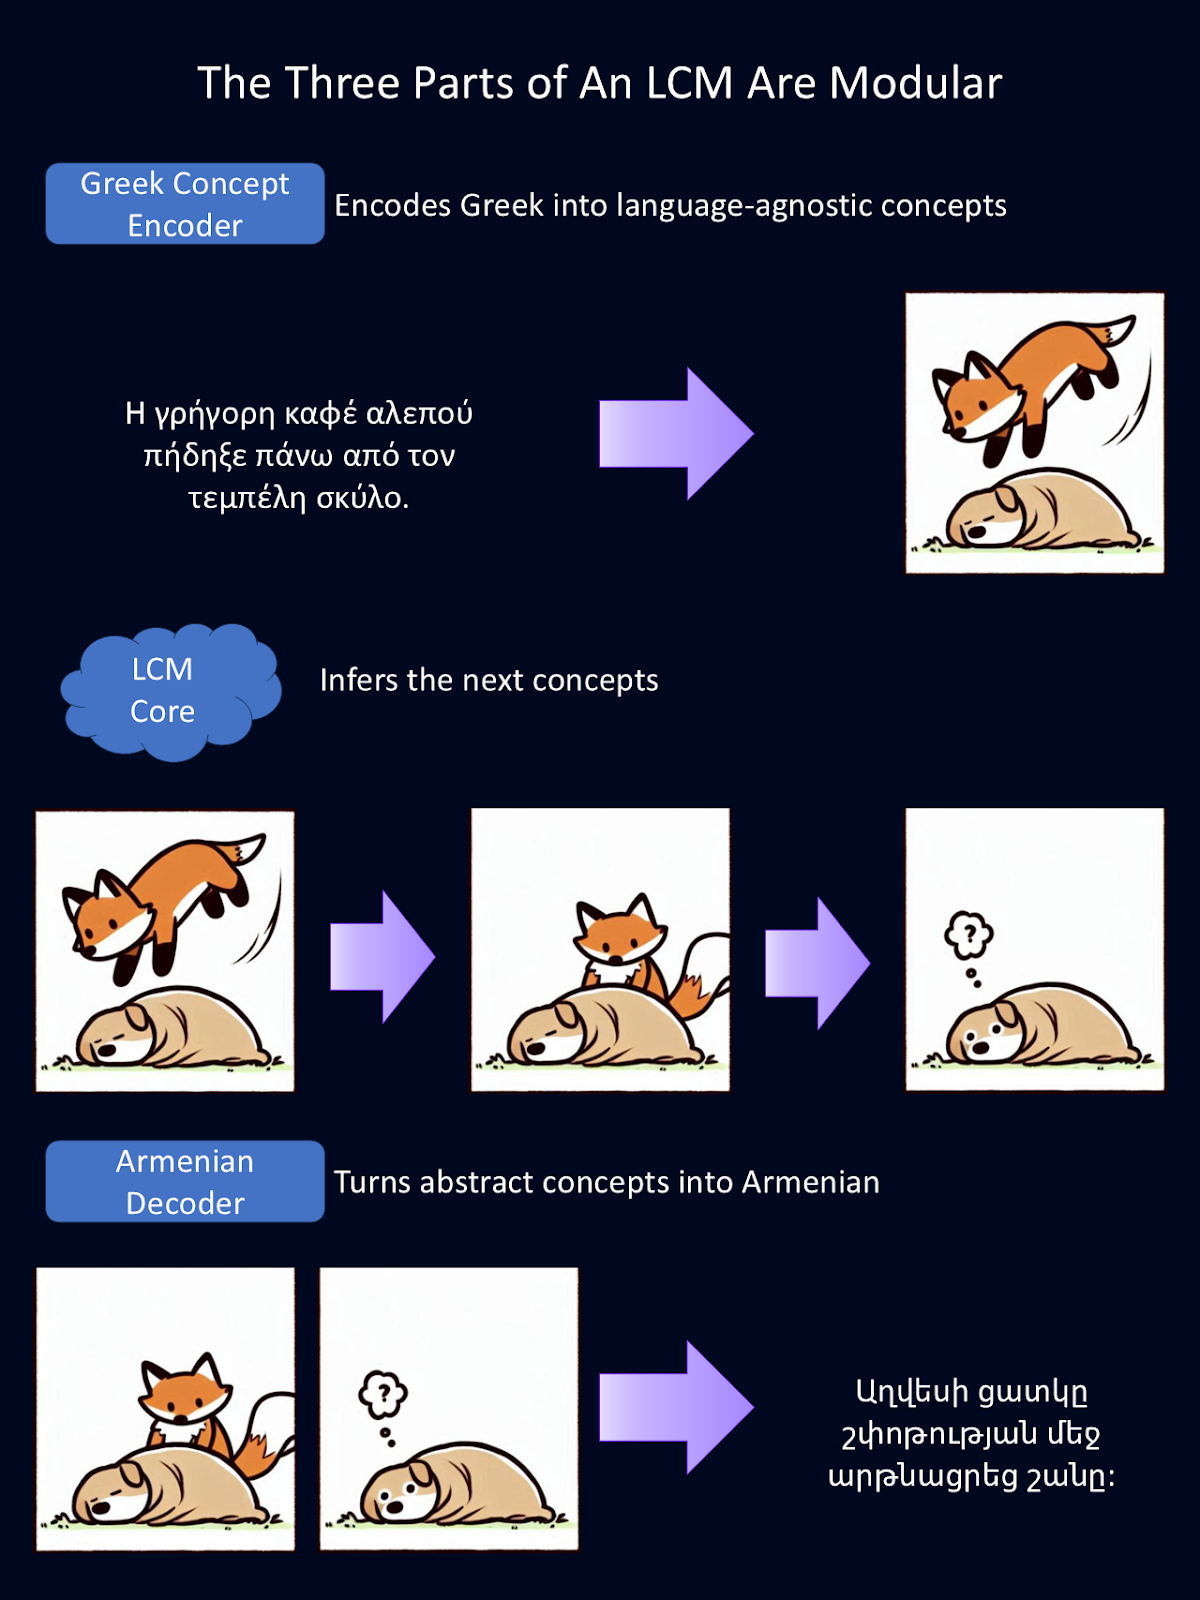
Omdat elk deel van het LCM modulair is, kan elk deel onafhankelijk worden verwisseld. In het bovenstaande diagram hebben we de eerdere Engelstalige encoder en decoder vervangen door een Griekse encoder en een Armeense decoder.
Deze encoders en decoders kunnen ook worden vervangen door varianten die andere modaliteiten van taal verwerken, zoals gesproken taal in plaats van tekst. Voor deze figuur leverde Google Translate de vertalingen uit het Engels, en Copilot de eerste schets van de dierentekeningen.
De toepassingen van LCM’s overlappen met die van LLM’s, maar door hun focus op concepten en dieper begrip kunnen ze een grotere impact hebben in sectoren die meer denkwerk vereisen.
LCM’s vereenvoudigen vertaling en verbeteren kruislinguïstisch begrip door te werken in een taalagnostische embeddingruimte. Dit maakt ze bijzonder effectief voor taken als meertalige samenvatting of vertaling van complexe documenten.
Zo kan een LCM een complex juridisch document in de ene taal verwerken en een samenhangende samenvatting in een andere taal genereren. Deze mogelijkheid is van onschatbare waarde voor wereldwijde organisaties, internationale communicatie en vertalingen waarbij low-resource-talen betrokken zijn.
LCM’s blinken uit in het produceren van coherente en contextueel relevante outputs, waardoor ze ideaal zijn voor taken als het opstellen van rapporten, schrijven van artikelen en maken van samenvattingen. Door de logische consistentie in longform content te behouden, kunnen LCM’s outputs leveren die aanzienlijk minder redactie vergen dan die van LLM’s, wat tijd en moeite bespaart voor professionals in journalistiek, marketing en onderzoek.
Ik vind de toepasbaarheid van LCM’s op onderwijs het meest indrukwekkend. Stel je een intelligent tutoringsysteem voor, aangedreven door een LCM, dat verklarende en interactieve content kan genereren die is afgestemd op individuele leerlingen.
Een LCM-tutor kan een complex onderwerp samenvatten in eenvoudigere, conceptueel behapbare segmenten voor studenten met uiteenlopende expertiseniveaus. De aanpasbaarheid over talen heen zou één docent in staat kunnen stellen om tegelijk in honderden talen les te geven!
LCM’s zijn ook zeer geschikt om te assisteren bij onderzoek en creatief schrijven. Ze kunnen gestructureerde, coherente teksten opzetten, zoals essays, onderzoeksartikelen of fictieve verhalen, en zo eerste versies bieden die schrijvers verder kunnen verfijnen.
Onderzoekers kunnen LCM’s ook gebruiken om ideeën te ordenen, samenvattingen uit te breiden of zelfs hypothesen te genereren op basis van bestaande data. Ze lossen veel van de problemen op die onderzoekers nu frustrerend vinden aan huidige LLM’s.
Ik ben vast niet de enige die de frustrerende ervaring heeft gehad met zo’n nieuwe, door LLM’s aangedreven klantenservicebot te praten die mijn probleem niet begreep. Met LCM’s onder de motorkap kunnen chatbots voor klantenservice complexere situaties beter doorgronden en misschien zelfs creatievere oplossingen bieden. Dit kan leiden tot hogere klanttevredenheid en -binding.
Op dit moment worden LLM’s voor meerdere van deze taken ingezet, maar met beperkte effectiviteit. LCM’s hebben het potentieel om deze toepassingen naar een hoger niveau te tillen. Binnenkort lijken onze AI-assistenten misschien meer op echte menselijke assistenten, die complexere ideeën en gesprekken kunnen volgen—alleen communiceren ze veel sneller dan wij.
Hoewel LCM’s spannende mogelijkheden bieden, brengen ze ook uitdagingen mee op het gebied van databehoefte, complexiteit en rekenkosten. Laten we enkele van de grootste huidige uitdagingen doornemen.
Het trainen van elk AI-model vereist enorme hoeveelheden data, maar LCM’s hebben extra verwerkingsstappen vergeleken met LLM’s. In plaats van ruwe tekst te gebruiken, vertrouwen ze op representaties op zinsniveau, wat betekent dat tekst eerst in zinnen moet worden opgesplitst en vervolgens in embeddings moet worden omgezet. Dit voegt een laag preprocessing en opslagbehoefte toe.
Bovendien vergt trainen op honderden miljarden zinnen enorme rekenkracht.
LCM’s verwerken volledige zinnen als éénheden, wat helpt om de logische flow te behouden, maar het opsporen van fouten lastiger maakt.
LLM’s genereren tekst woord voor woord, waardoor we fouten kunnen herleiden tot individuele tokens. LCM’s daarentegen opereren in een hoog-dimensionale embeddingruimte, waar beslissingen zijn gebaseerd op abstracte relaties.
LCM’s, vooral diffusiegebaseerde modellen, vereisen veel meer rekenkracht dan LLM’s. Waar LLM’s tekst in één forward pass genereren, verfijnen diffusiegebaseerde LCM’s hun output stap voor stap, wat zowel rekentijd als kosten verhoogt. Hoewel LCM’s efficiënter kunnen zijn voor lange documenten, zijn ze vaak minder efficiënt voor kortere taken zoals snelle antwoorden of chatinteracties.
Concepten definiëren op zinsniveau brengt eigen uitdagingen met zich mee. Langere zinnen kunnen meerdere ideeën bevatten, waardoor ze lastig als één eenheid te vangen zijn. En kortere zinnen bieden mogelijk niet genoeg context voor een betekenisvolle representatie.
LCM’s kampen ook met dataschaarste. Omdat afzonderlijke zinnen veel unieker zijn dan woorden, heeft het model minder herhaalde patronen om van te leren.
Deze technologie ontwikkelt zich razendsnel en aan deze uitdagingen wordt actief gewerkt. Omdat deze technologie open source is, kun je je eigen oplossingen toevoegen om deze uitdagingen aan te pakken en de technologie vooruit te helpen.
Wil je zelf aan de slag met een LCM? Veel van de code is open source, dus dat kan!
Een goed startpunt is de vrij beschikbare LCM-trainingscode en de SONAR-embeddingruimte. Met deze open-sourcetools kunnen ontwikkelaars met deze nieuwe technologie experimenteren en eigen verbeteringen aanbrengen.
Om meer te leren over de theorie achter LCM’s, bekijk dit paper van Meta.
Het vermogen van LCM’s om op conceptueel niveau te werken, kan AI-interacties met taal verfijnen. Door voorbij de beperkingen van token-gebaseerde analyse te gaan, banen LCM’s de weg voor meer genuanceerde, contextbewuste en meertalige toepassingen.
Ik raad je aan de code zelf te bekijken en je eigen draai eraan te geven. Welke verbeteringen kun jij aanbrengen aan deze technologie? Welke producten kun je ermee creëren?
Leer AI met deze cursussen!
Leerpad
Leerpad
Oefen en volg je voortgang.
Ga Verder Met Googleblog
Adel Nehme
15 min

