
Programma
Nozioni di base sull'intelligenza artificiale nel mondo degli affari
12 ore
Pratica and corso your progress.
Continua Con GoogleI large language model (LLM) sono molto potenti, ma spesso faticano a tenere traccia delle idee di insieme. Questo perché gli LLM funzionano prevedendo il testo un token, o una parola, alla volta.
Questo approccio token per token, combinato con una finestra di contesto limitata, può portare a risposte sconnesse, perdita di contesto e molta ripetizione. È come cercare di scrivere un tema indovinando ogni parola successiva invece di delineare prima le tue idee.
Qui entrano in gioco i large concept model (LCM). Invece di lavorare parola per parola, gli LCM elaborano il linguaggio a livello di frase e lo astraggono in concetti. Questa astrazione consente al modello di comprendere il linguaggio in modo più riflessivo e significativo.
Un large concept model (LCM) è un tipo di modello linguistico che elabora il linguaggio a livello di concetto, invece di analizzare le singole parole. A differenza dei modelli tradizionali che scompongono il testo parola per parola, gli LCM interpretano rappresentazioni semantiche che corrispondono a intere frasi o idee coerenti. Questo cambio di prospettiva consente loro di cogliere il significato più ampio del linguaggio, non solo la meccanica.
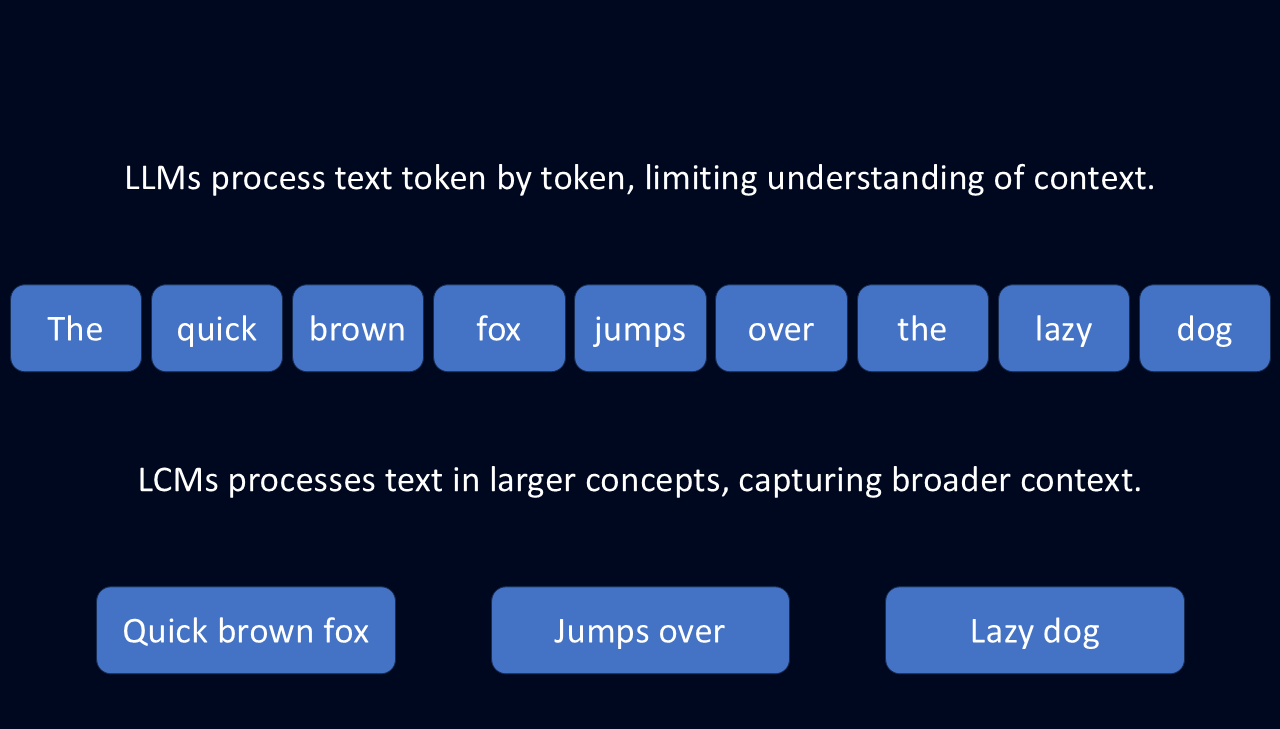
Immagina di leggere un romanzo. Un LLM lo elaborerebbe token per token, concentrandosi sulle singole parole e sui loro vicini immediati. Con questo approccio potrebbe generare un riassunto prevedendo la parola più probabile successiva, ma rischierebbe di perdere la narrazione generale e i temi sottostanti.
Gli LCM, invece, analizzano sezioni più ampie di testo per estrarne le idee sottostanti. Questo approccio li aiuta a comprendere i concetti di più alto livello: l'arco narrativo complessivo, l'evoluzione dei personaggi e i temi. Non solo possono generare un riassunto più completo, ma possono anche espandere la storia in modo più significativo.
Questa capacità di ragionare in concetti anziché in parole rende gli LCM incredibilmente flessibili. Si basano sul SONAR embedding space, che consente loro di elaborare testo in oltre 200 lingue e parlato in 76.
Invece di fare affidamento su schemi specifici di ciascuna lingua, gli LCM memorizzano il significato a livello concettuale. Questa astrazione li rende adattabili per attività come la sintesi multilingue, la traduzione e la generazione di contenuti tra formati diversi.
Poiché gli LCM elaborano il linguaggio a livello concettuale, generano output strutturati e consapevoli del contesto. A differenza degli LLM, che costruiscono il testo parola per parola, gli LCM usano rappresentazioni numeriche di intere frasi per mantenere il filo logico. Questo li rende particolarmente efficaci per attività come redigere report o tradurre documenti lunghi.
Hanno anche un design modulare, che consente agli sviluppatori di integrare nuove lingue o modalità senza riaddestrare l'intero sistema.
LLM e LCM condividono molti degli stessi obiettivi: entrambi generano testo, riassumono informazioni e traducono tra lingue. Ma il modo in cui raggiungono questi compiti è fondamentalmente diverso.
Gli LLM prevedono il testo un token alla volta, il che li rende ottimi nel produrre frasi fluide. Tuttavia, questo spesso porta a incoerenze o ridondanze negli output più lunghi. Gli LCM, invece, elaborano il linguaggio a livello di frase, consentendo di mantenere il flusso logico su passaggi estesi.
Un'altra differenza è il modo in cui gestiscono l'elaborazione multilingue. Gli LLM si basano fortemente su dati di addestramento provenienti da lingue ad alta disponibilità di risorse, cioè lingue con molti contenuti di training, come l'inglese. Di conseguenza, spesso faticano con lingue a bassa disponibilità di risorse che non dispongono di grandi dataset.
Gli LCM, invece, operano nello spazio di embedding SONAR. Questo spazio di embedding consente loro di elaborare testo in molte lingue senza riaddestramento. Lavorare con concetti astratti li rende molto più adattabili.
|
Capacità |
Come funzionano gli LLM |
Come gli LCM la migliorano |
|
Flessibilità multilingue e multiformato |
Addestrati soprattutto su lingue ad alta disponibilità di risorse e in difficoltà con quelle meno comuni. Necessitano di training extra per formati diversi come il parlato. |
Funzionano in 200+ lingue e supportano testo e parlato, senza training aggiuntivo. |
|
Generalizzazione a nuovi compiti |
Necessitano di fine-tuning per gestire nuove lingue o argomenti. Faticano con dati non familiari. |
Usano un sistema indipendente dalla lingua, che consente di gestire nuove lingue e compiti senza training extra. |
|
Coerenza nei contenuti lunghi |
Scrivono parola per parola, rendendo le risposte lunghe soggette a incoerenze o ripetizioni. |
Elaborano intere frasi alla volta, mantenendo le risposte più chiare e strutturate nei testi lunghi. |
|
Efficienza nella gestione del contesto |
Faticano con input più lunghi a causa dell'aumento delle esigenze di memoria ed elaborazione. |
Usano rappresentazioni compatte delle frasi, facilitando l'elaborazione efficiente di documenti lunghi. |
I large concept model raggiungono le loro capacità uniche tramite un sistema in tre parti:
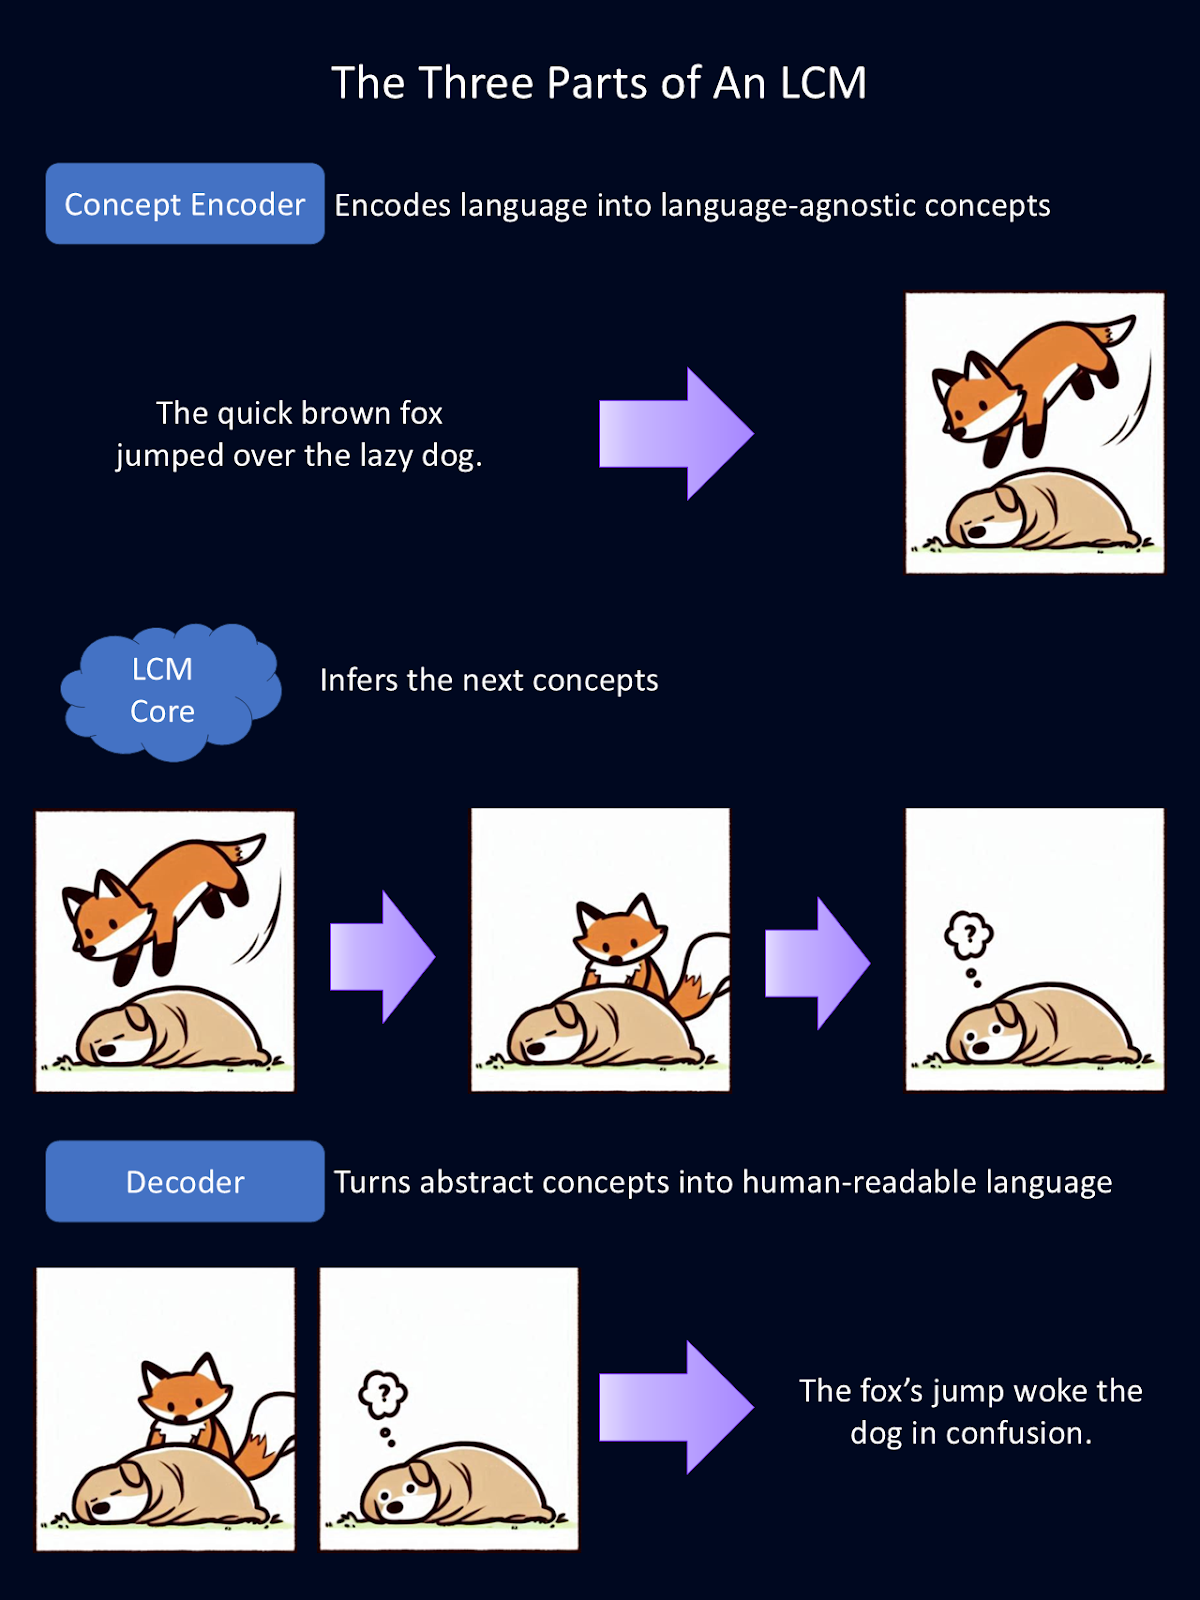
Lo schema sopra è una spiegazione semplificata di come funziona ciascuno dei tre componenti modulari di un LCM. L'encoder trasforma il linguaggio in concetti astratti. Qui questi concetti astratti sono rappresentati come immagini. Nel modello, questi concetti sono rappresentati matematicamente. Il core esegue l'inferenza su tali concetti. Poi il decoder trasforma queste astrazioni in linguaggio comprensibile. Per questa figura, Copilot ha fornito la prima bozza dei disegni degli animali.
Il primo passo nella pipeline di elaborazione di un LCM è codificare l'input in una rappresentazione semantica ad alta dimensione. In sostanza, questo trasforma il linguaggio in rappresentazioni matematiche di concetti. Questo encoder di concetti mappa ampi segmenti di testo, come intere frasi.
Gli LCM usano SONAR, un potente spazio di embedding per il linguaggio. È questo spazio di embedding che supporta lingue diverse per testo e parlato. SONAR consente all'encoder di elaborare sia il linguaggio scritto che quello parlato, distillando i concetti in qualcosa che il modello può capire.
Una volta codificati i concetti, il core LCM li elabora per generarne di nuovi in base al contesto. Qui avviene l'inferenza. A differenza degli LLM, che prevedono il testo token per token, il core LCM predice intere frasi o concetti.
Esistono tre tipi di core LCM, ciascuno con un approccio distinto alla modellazione dei concetti:
Tra questi, gli LCM basati su diffusione hanno dimostrato la migliore capacità predittiva, generando output più accurati e coerenti con il contesto.
Una volta che il Core LCM ha elaborato e previsto nuovi concetti, questi devono essere convertiti in forma comprensibile. È il compito del decoder di concetti. Traduce le rappresentazioni matematiche dei concetti in output testuali o vocali.
Poiché i concetti sottostanti sono memorizzati in uno spazio di embedding condiviso, possono essere decodificati in qualsiasi lingua supportata senza rielaborazione. Questo è estremamente potente perché significa che gli output sono indipendenti dalla lingua. Tutto il "pensiero" avviene tramite la matematica. Così, un LCM addestrato principalmente su inglese e spagnolo potrebbe leggere un input in tedesco, "pensare" in matematica e generare contenuti in giapponese.
Questo significa anche che si possono aggiungere nuove lingue e modalità senza riaddestrare l'intero modello. Se viene sviluppato un nuovo sistema speech-to-text, può essere integrato con un LCM esistente senza richiedere enormi risorse computazionali.
Immagina se qualcuno realizzasse un encoder e un decoder per la lingua dei segni. Potrebbero aggiungerli a un core LCM esistente, senza riaddestramento, e comunicare idee in un formato completamente diverso. Questa flessibilità rende gli LCM una soluzione scalabile e adattabile per applicazioni di AI multilingue e multiformato.
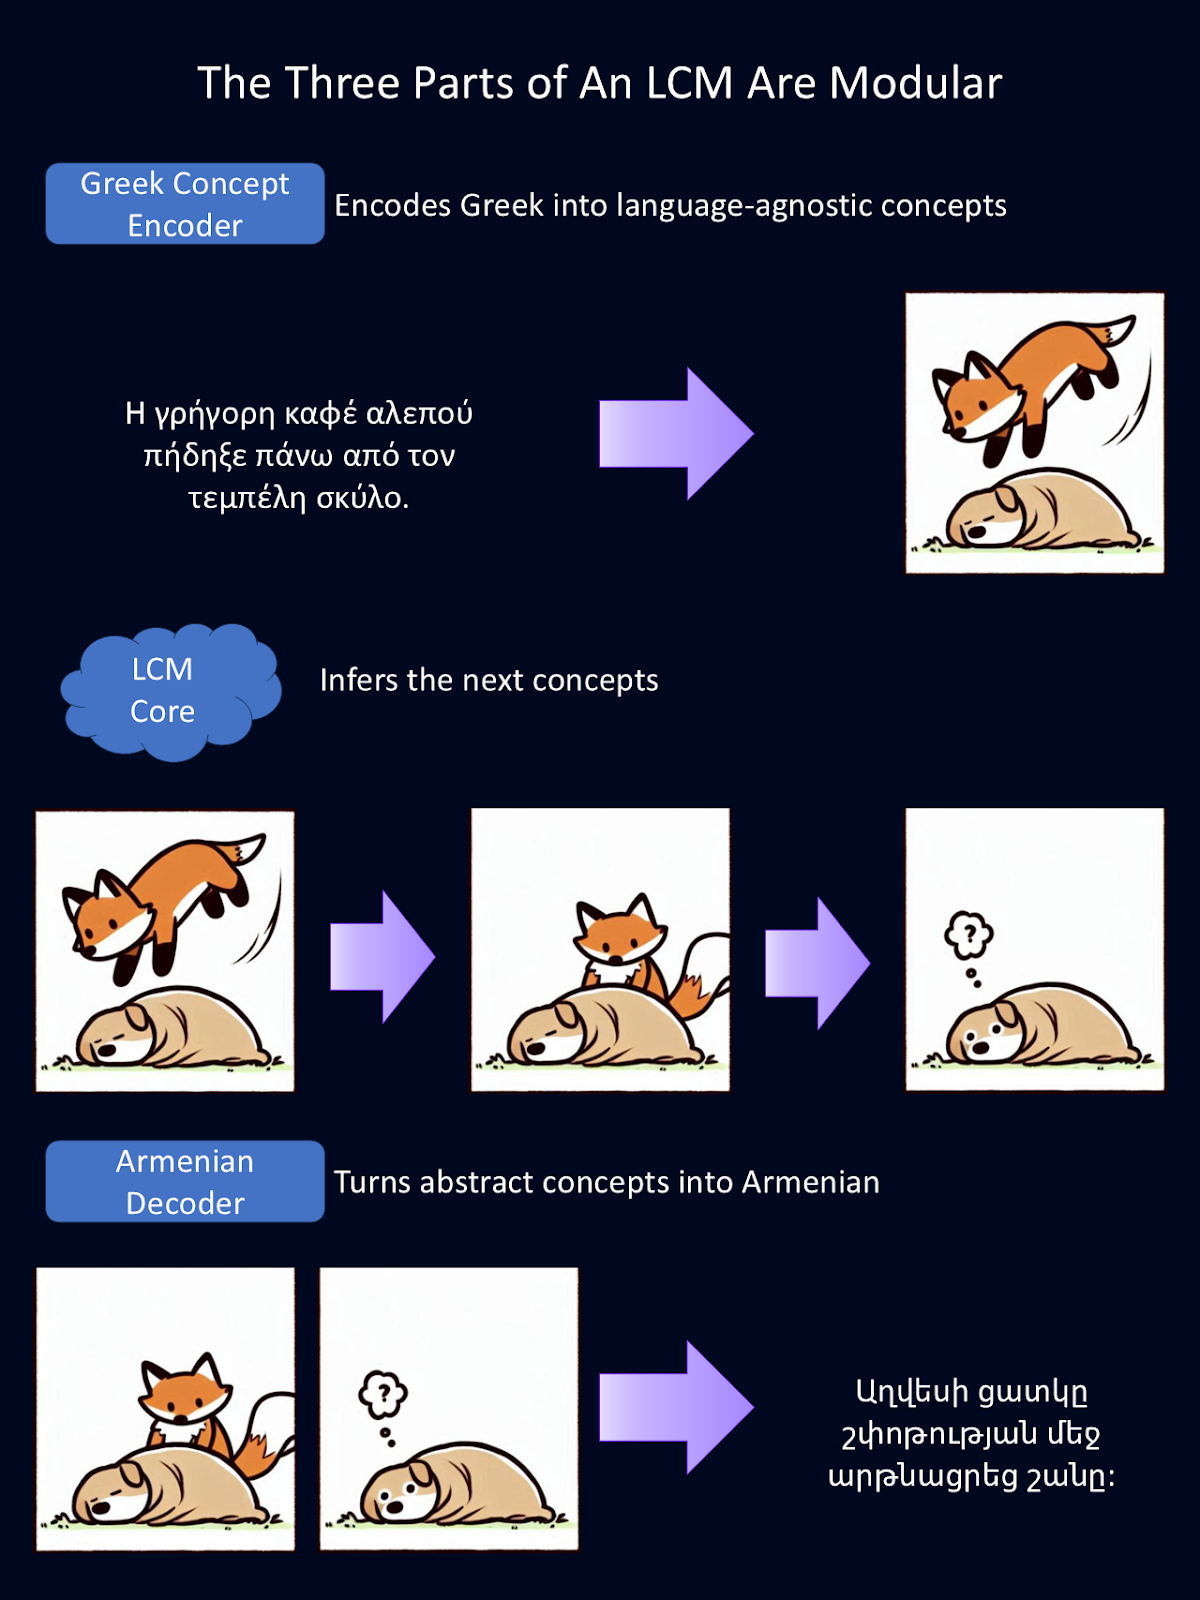
Poiché ogni parte dell'LCM è modulare, ciascun componente può essere sostituito in modo indipendente. Nel diagramma sopra, abbiamo sostituito il precedente encoder e decoder per la lingua inglese con un encoder in greco e un decoder in armeno.
Questi encoder e decoder possono anche essere sostituiti con altri che gestiscono modalità diverse del linguaggio, come il parlato verbale al posto del testo. Per questa figura, Google Traduttore ha fornito le traduzioni dall'inglese e Copilot ha fornito la prima bozza dei disegni degli animali.
Le applicazioni degli LCM si sovrappongono a quelle degli LLM, ma grazie all'attenzione ai concetti e a una comprensione più profonda, hanno il potenziale per creare un impatto più rilevante nei settori che richiedono maggiore riflessione.
Gli LCM semplificano la traduzione e migliorano la comprensione interlinguistica operando in uno spazio di embedding indipendente dalla lingua. Ciò li rende particolarmente efficaci per attività come la sintesi multilingue o la traduzione di documenti complessi.
Per esempio, un LCM può elaborare un complesso documento legale in una lingua e generare un riassunto coerente in un'altra. Questa capacità è preziosa per organizzazioni globali, comunicazioni internazionali e traduzioni che coinvolgono lingue a bassa disponibilità di risorse.
Gli LCM eccellono nel produrre output coerenti e contestualmente pertinenti, rendendoli una scelta ideale per compiti come redigere report, scrivere articoli e creare riassunti. Mantenendo la coerenza logica nei contenuti lunghi, gli LCM possono produrre risultati che richiedono molte meno modifiche rispetto agli LLM, facendo risparmiare tempo e fatica a professionisti in giornalismo, marketing e ricerca.
Penso che l'applicabilità degli LCM all'educazione sia la più impressionante. Immagina un sistema di tutoraggio intelligente basato su un LCM in grado di generare contenuti esplicativi e interattivi su misura per i singoli studenti.
Un tutor LCM potrebbe riassumere un argomento complesso in segmenti più semplici e digeribili dal punto di vista concettuale per studenti con livelli di competenza diversi. La sua adattabilità tra le lingue potrebbe permettere a un insegnante di insegnare contemporaneamente a studenti in centinaia di lingue!
Gli LCM sono anche adatti ad assistere nella ricerca e nella scrittura creativa. Possono redigere testi strutturati e coerenti, come saggi, articoli di ricerca o narrative di finzione, fornendo bozze iniziali che gli autori possono poi rifinire.
I ricercatori possono anche usare gli LCM per organizzare idee, ampliare i riassunti o persino generare ipotesi basate su dati esistenti. Risolvono molti dei problemi che i ricercatori trovano frustranti con gli attuali LLM.
Non credo di essere l'unico ad aver avuto l'esperienza frustrante di interagire con uno di questi nuovi bot di assistenza clienti basati su LLM, solo per scoprire che non capisce il mio problema. Con gli LCM a alimentarli, i chatbot di assistenza clienti possono offrire una comprensione migliore di situazioni complesse e magari anche soluzioni più creative. Questo può portare a una maggiore soddisfazione e fidelizzazione dei clienti.
Al momento, gli LLM sono usati in molte di queste modalità, ma con efficacia limitata. Gli LCM hanno il potenziale per far fare un salto di qualità a queste applicazioni. Presto, i nostri assistenti AI potrebbero assomigliare di più ad assistenti umani reali, capaci di seguire idee e conversazioni più complesse—solo che possono comunicare molto più velocemente di noi.
Sebbene gli LCM offrano possibilità entusiasmanti, presentano anche sfide in termini di requisiti di dati, complessità e costi computazionali. Vediamo alcune delle sfide più grandi attuali.
Addestrare qualsiasi modello di AI richiede enormi quantità di dati, ma gli LCM hanno passaggi di elaborazione extra rispetto agli LLM. Invece di usare testo grezzo, si basano su rappresentazioni a livello di frase, il che significa che il testo deve prima essere suddiviso in frasi e poi convertito in embeddings. Questo aggiunge un livello di pre-elaborazione e richieste di archiviazione.
Inoltre, addestrare su centinaia di miliardi di frasi richiede una potenza computazionale immensa.
Gli LCM elaborano intere frasi come unità singole, il che aiuta a mantenere il filo logico, ma rende la risoluzione dei problemi più difficile.
Gli LLM generano testo una parola alla volta, permettendoci di ricondurre gli errori a token specifici. Al contrario, gli LCM operano in uno spazio di embedding ad alta dimensione, in cui le decisioni si basano su relazioni astratte.
Gli LCM, in particolare i modelli basati su diffusione, richiedono molta più potenza di calcolo rispetto agli LLM. Mentre gli LLM generano testo in un singolo forward pass, gli LCM basati su diffusione affinano i loro output passo dopo passo, aumentando sia il tempo di calcolo sia il costo. Sebbene gli LCM possano essere più efficienti per documenti lunghi, spesso sono meno efficienti per compiti brevi come risposte rapide o interazioni in chat.
Definire i concetti a livello di frase crea sfide proprie. Le frasi più lunghe possono contenere più idee, rendendo difficile catturarle come un'unica unità. E le frasi più brevi potrebbero non fornire contesto sufficiente per una rappresentazione significativa.
Gli LCM affrontano anche problemi di scarsità dei dati. Poiché le singole frasi sono molto più uniche delle parole, il modello ha meno schemi ripetuti da cui apprendere.
Questa tecnologia si sta sviluppando rapidamente e tali sfide sono affrontate attivamente. Poiché questa tecnologia è open source, puoi aggiungere le tue soluzioni per contribuire ad affrontare queste sfide e far progredire la tecnologia.
Ti interessa provare a lavorare con un LCM? Molto del codice è open source, quindi puoi farlo davvero!
Un ottimo punto di partenza è il codice di training LCM liberamente disponibile e lo spazio di embedding SONAR. Questi strumenti open source consentono agli sviluppatori di sperimentare con questa nuova tecnologia e apportare i propri miglioramenti.
Per saperne di più sulla teoria alla base degli LCM, dai un'occhiata a questo paper di Meta.
La capacità degli LCM di operare a livello concettuale ha il potenziale per affinare le interazioni dell'AI con il linguaggio. Andando oltre i vincoli dell'analisi basata sui token, gli LCM aprono la strada ad applicazioni più sfumate, consapevoli del contesto e multilingue.
Ti invito a esaminare tu stesso il codice e a metterci del tuo. Quali miglioramenti puoi apportare a questa tecnologia? Quali prodotti puoi crearci?
Impara l'AI con questi corsi!
Programma
Programma
Pratica and corso your progress.
Continua Con Googleblog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



