
Lộ trình
Cơ bản về Kinh doanh Trí tuệ Nhân tạo
12 giờ
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleCác mô hình ngôn ngữ lớn (LLM) rất mạnh mẽ, nhưng thường gặp khó khăn khi theo dõi các ý tưởng mang tính tổng thể. Lý do là LLM hoạt động bằng cách dự đoán từng token, hay từng từ, một cách tuần tự.
Cách tiếp cận từng token này, cộng với cửa sổ ngữ cảnh hạn chế, có thể dẫn đến phản hồi rời rạc, mất ngữ cảnh và lặp lại nhiều. Giống như bạn cố viết một bài luận bằng cách đoán từ tiếp theo thay vì phác thảo ý trước.
Đây là lúc large concept models (LCM) có thể phát huy tác dụng. Thay vì xử lý từng từ, LCM xử lý ngôn ngữ ở cấp độ câu và trừu tượng hóa ngôn ngữ thành các khái niệm. Sự trừu tượng này giúp mô hình hiểu ngôn ngữ một cách sâu sắc và có ý nghĩa hơn.
Large concept model (LCM) là một dạng mô hình ngôn ngữ xử lý ở cấp độ khái niệm thay vì phân tích từng từ riêng lẻ. Khác với các mô hình truyền thống phân tách văn bản từng từ, LCM diễn giải các biểu diễn ngữ nghĩa, tương ứng với cả câu hoặc các ý liền mạch. Sự chuyển dịch này giúp chúng nắm bắt ý nghĩa rộng hơn của ngôn ngữ thay vì chỉ cơ chế bề mặt.
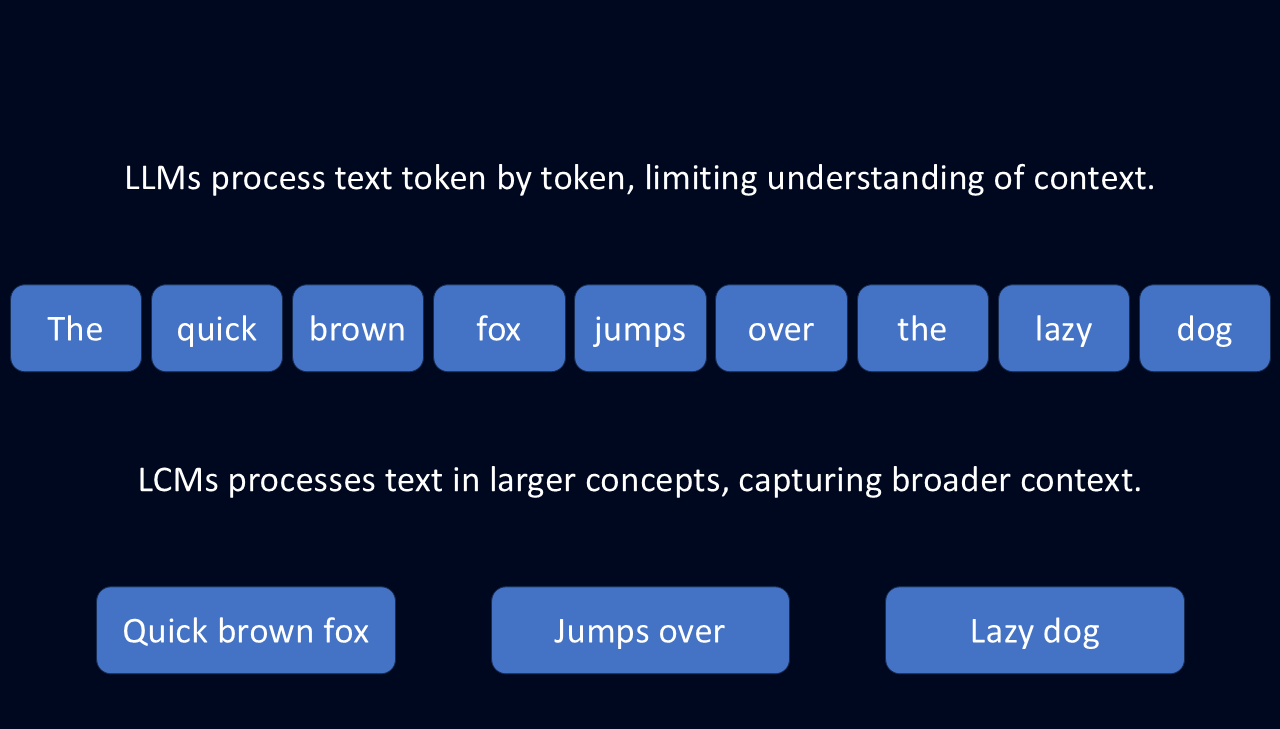
Hãy tưởng tượng bạn đang đọc một cuốn tiểu thuyết. LLM sẽ xử lý nó theo từng token, tập trung vào từng từ và các từ lân cận. Với cách này, nó có thể tạo bản tóm tắt bằng cách dự đoán từ có khả năng xuất hiện tiếp theo. Nhưng có thể bỏ lỡ mạch truyện và các chủ đề ẩn phía sau.
Trong khi đó, LCM phân tích các đoạn văn bản lớn hơn để trích xuất các ý cơ bản. Cách tiếp cận này giúp chúng hiểu các khái niệm rộng hơn: mạch truyện tổng thể, phát triển nhân vật và chủ đề. Không chỉ giúp tạo bản tóm tắt đầy đủ hơn, chúng còn có thể mở rộng câu chuyện một cách ý nghĩa hơn.
Khả năng suy nghĩ bằng khái niệm thay vì từ ngữ khiến LCM cực kỳ linh hoạt. Chúng được xây dựng trên không gian nhúng SONAR, cho phép xử lý văn bản bằng hơn 200 ngôn ngữ và giọng nói bằng 76 ngôn ngữ.
Thay vì dựa vào các mẫu đặc thù ngôn ngữ, LCM lưu trữ ý nghĩa ở cấp độ khái niệm. Sự trừu tượng này giúp chúng thích ứng tốt với các tác vụ như tóm tắt đa ngôn ngữ, dịch thuật và tạo nội dung đa định dạng.
Vì LCM xử lý ở cấp độ khái niệm, chúng tạo ra đầu ra có cấu trúc và nhận thức ngữ cảnh. Khác với LLM xây dựng văn bản từng từ, LCM dùng các biểu diễn số của toàn bộ câu để duy trì mạch logic. Điều này đặc biệt hiệu quả cho các tác vụ như soạn thảo báo cáo hoặc dịch tài liệu dài.
Chúng cũng có thiết kế dạng mô-đun, cho phép nhà phát triển tích hợp ngôn ngữ hoặc phương thức mới mà không cần huấn luyện lại toàn bộ hệ thống.
LLM và LCM có nhiều mục tiêu chung: cả hai đều tạo văn bản, tóm tắt thông tin và dịch giữa các ngôn ngữ. Nhưng cách chúng thực hiện các tác vụ này lại khác biệt căn bản.
LLM dự đoán văn bản từng token, giúp tạo câu trôi chảy. Tuy nhiên, điều này thường dẫn đến thiếu nhất quán hoặc dư thừa trong các đầu ra dài. Ngược lại, LCM xử lý ở cấp độ câu, cho phép duy trì mạch logic xuyên suốt những đoạn văn dài.
Một khác biệt nữa là cách chúng xử lý đa ngôn ngữ. LLM phụ thuộc nhiều vào dữ liệu huấn luyện từ các ngôn ngữ có tài nguyên dồi dào, như tiếng Anh. Hệ quả là chúng thường chật vật với các ngôn ngữ ít tài nguyên do thiếu tập dữ liệu lớn.
Trong khi đó, LCM hoạt động trong không gian nhúng SONAR. Không gian này cho phép xử lý văn bản bằng nhiều ngôn ngữ mà không cần huấn luyện lại. Làm việc với các khái niệm trừu tượng khiến chúng thíchdụng hơn rất nhiều.
|
Năng lực |
Cách LLM hoạt động |
Cách LCM cải thiện |
|
Linh hoạt đa ngôn ngữ và đa định dạng |
Chủ yếu được huấn luyện trên các ngôn ngữ giàu tài nguyên và gặp khó với ngôn ngữ ít phổ biến. Cần huấn luyện thêm cho các định dạng khác như giọng nói. |
Hoạt động với hơn 200 ngôn ngữ và hỗ trợ văn bản lẫn giọng nói, không cần huấn luyện bổ sung. |
|
Khái quát hóa sang tác vụ mới |
Cần fine-tuning để xử lý ngôn ngữ hoặc chủ đề mới. Gặp khó với dữ liệu lạ. |
Dùng hệ thống phi phụ thuộc ngôn ngữ, cho phép xử lý ngôn ngữ và tác vụ mới mà không cần huấn luyện thêm. |
|
Tính mạch lạc trong nội dung dài |
Viết từng từ, khiến phản hồi dài dễ thiếu nhất quán hoặc lặp lại. |
Xử lý trọn câu cùng lúc, giữ cho phản hồi rõ ràng và có cấu trúc trên văn bản dài. |
|
Hiệu quả khi xử lý ngữ cảnh |
Gặp khó với đầu vào dài do nhu cầu bộ nhớ và xử lý tăng. |
Dùng biểu diễn câu gọn, giúp xử lý tài liệu dài hiệu quả hơn. |
LCM đạt được các khả năng độc đáo thông qua hệ thống ba phần:
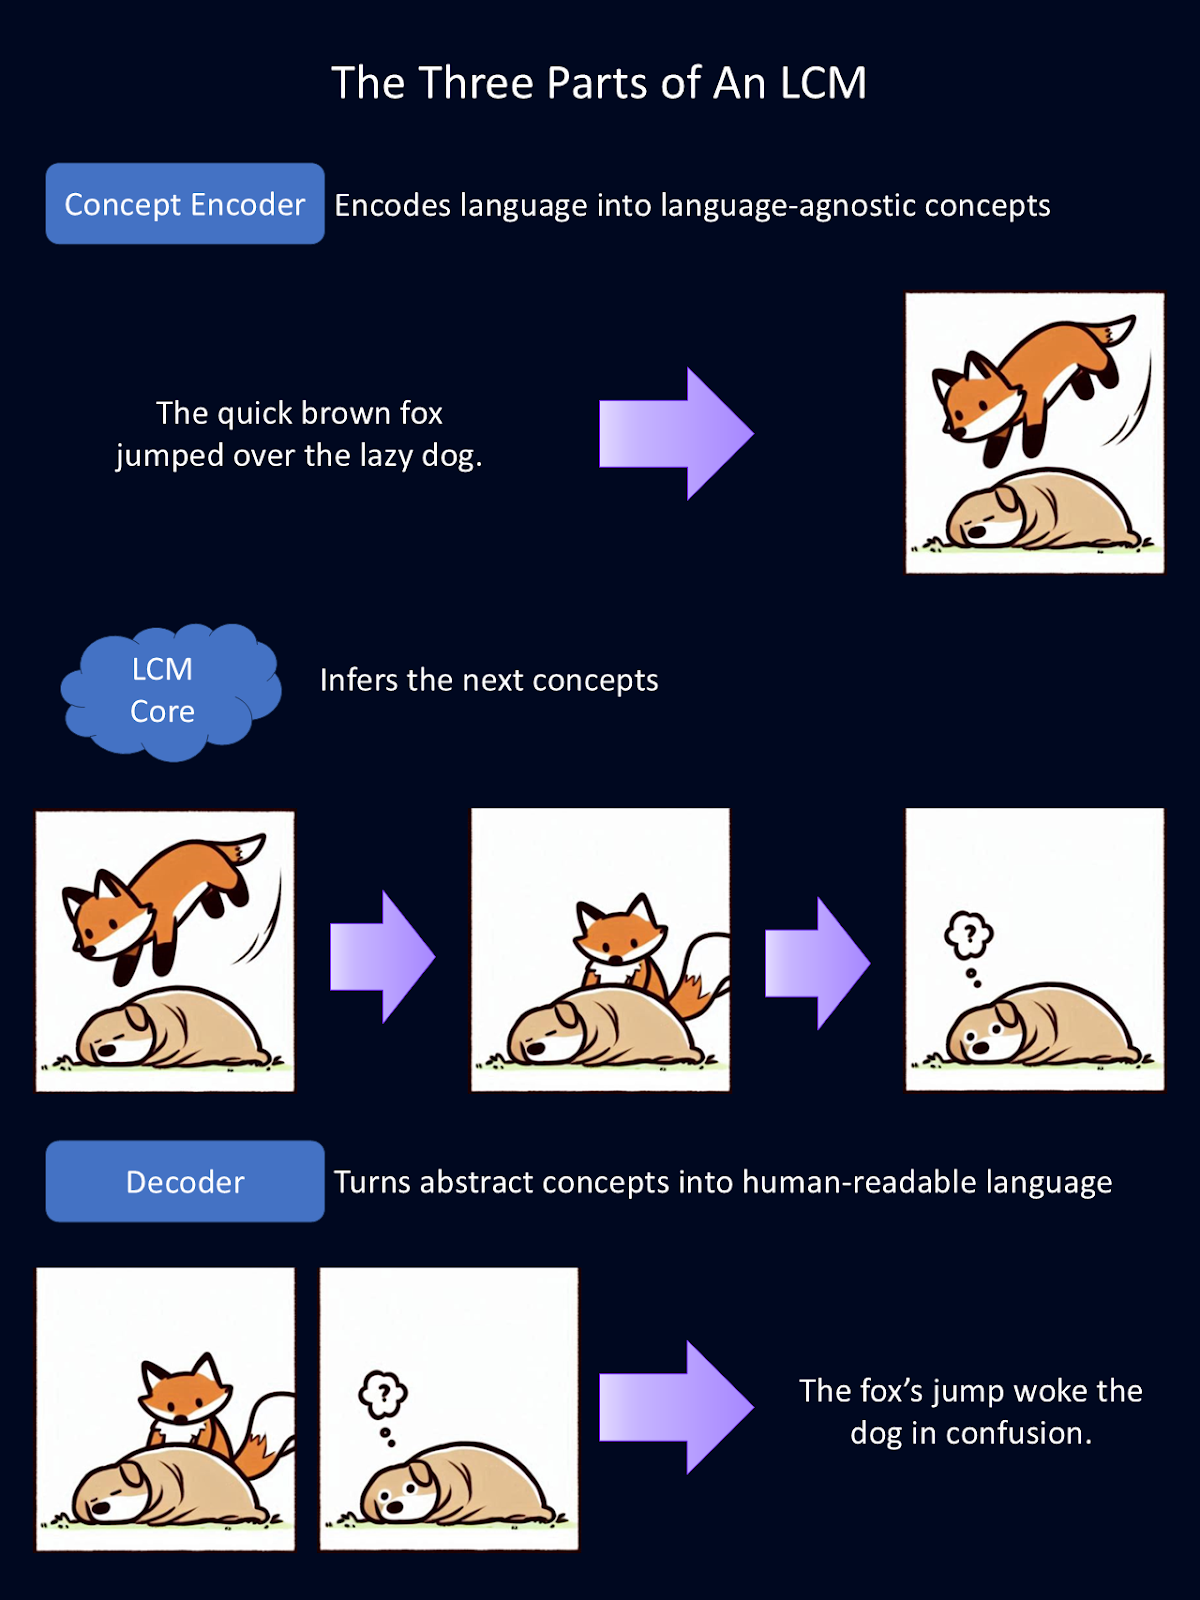
Sơ đồ trên giải thích đơn giản cách ba thành phần mô-đun của LCM hoạt động. Bộ mã hóa biến ngôn ngữ thành các khái niệm trừu tượng. Ở đây, các khái niệm trừu tượng được minh họa như hình ảnh. Trong mô hình, các khái niệm này được biểu diễn bằng toán học. Phần lõi chạy suy luận trên các khái niệm đó. Sau đó, bộ giải mã chuyển các trừu tượng thành ngôn ngữ có thể đọc được. Với hình này, Copilot đã phác thảo lần đầu các bản vẽ con vật.
Bước đầu trong quy trình của LCM là mã hóa đầu vào thành biểu diễn ngữ nghĩa nhiều chiều. Về bản chất, điều này biến ngôn ngữ thành các biểu diễn toán học của khái niệm. Bộ mã hóa khái niệm ánh xạ các đoạn văn bản lớn, như cả câu.
LCM dùng SONAR, một không gian nhúng mạnh cho ngôn ngữ. Chính không gian nhúng này hỗ trợ các ngôn ngữ khác nhau cho văn bản và giọng nói. SONAR cho phép bộ mã hóa xử lý cả ngôn ngữ viết và nói, chắt lọc khái niệm thành thứ mà mô hình có thể hiểu.
Khi các khái niệm đã được mã hóa, phần lõi LCM xử lý chúng để tạo ra khái niệm mới dựa trên ngữ cảnh. Đây là nơi diễn ra suy luận. Khác với LLM dự đoán từng token, lõi LCM dự đoán cả câu hoặc khái niệm.
Có ba loại lõi LCM, mỗi loại có cách tiếp cận riêng trong mô hình hóa khái niệm:
Trong số này, LCM dựa trên khuếch tán cho thấy khả năng dự đoán tốt nhất, tạo ra đầu ra chính xác và mạch lạc theo ngữ cảnh.
Khi lõi LCM đã xử lý và dự đoán các khái niệm mới, chúng phải được chuyển về dạng con người đọc được. Đó là nhiệm vụ của bộ giải mã khái niệm. Nó dịch các biểu diễn toán học của khái niệm thành đầu ra văn bản hoặc giọng nói.
Vì các khái niệm nền tảng được lưu trong một không gian nhúng dùng chung, chúng có thể được giải mã sang bất kỳ ngôn ngữ được hỗ trợ nào mà không cần xử lý lại. Điều này cực kỳ mạnh vì nghĩa là đầu ra không phụ thuộc ngôn ngữ. Toàn bộ phần “suy nghĩ” diễn ra bằng toán học. Vậy nên, một LCM được huấn luyện chủ yếu bằng tiếng Anh và Tây Ban Nha có thể đọc đầu vào bằng tiếng Đức, “suy nghĩ” bằng toán, và tạo nội dung bằng tiếng Nhật.
Điều này cũng có nghĩa là có thể thêm ngôn ngữ và phương thức mới mà không cần huấn luyện lại toàn bộ mô hình. Nếu một hệ thống chuyển giọng nói thành văn bản mới được phát triển, nó có thể tích hợp với LCM hiện có mà không đòi hỏi tài nguyên tính toán khổng lồ.
Hãy hình dung nếu có người tạo bộ mã hóa và giải mã cho ngôn ngữ ký hiệu. Họ có thể thêm vào lõi LCM hiện hữu, không cần huấn luyện lại, và truyền đạt ý tưởng ở một định dạng hoàn toàn khác. Tính linh hoạt này khiến LCM trở thành giải pháp có khả năng mở rộng và thích ứng cho các ứng dụng AI đa ngôn ngữ, đa định dạng.
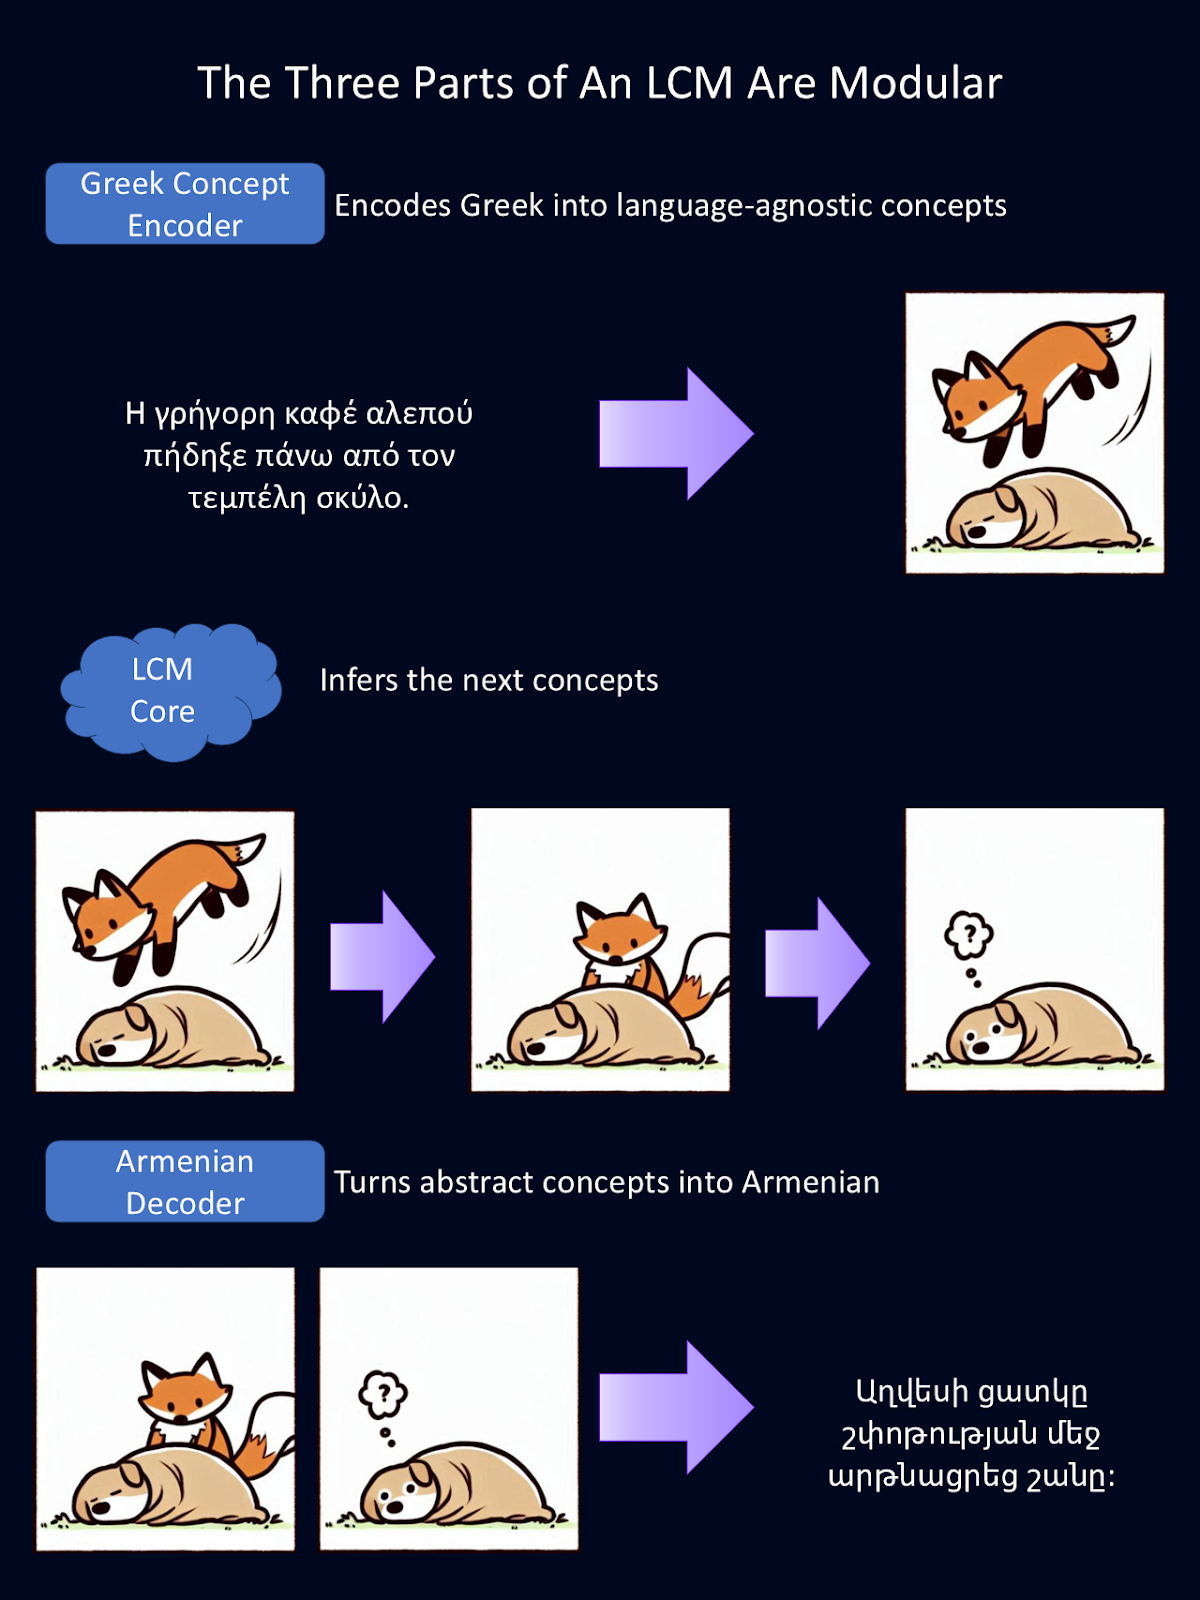
Vì mỗi phần của LCM là mô-đun, từng phần có thể được hoán đổi độc lập. Trong sơ đồ trên, chúng tôi đã thay bộ mã hóa và giải mã tiếng Anh trước đó bằng bộ mã hóa tiếng Hy Lạp và bộ giải mã tiếng Armenia.
Các bộ mã hóa và giải mã này cũng có thể được thay thế bằng những bộ xử lý các phương thức ngôn ngữ khác, như lời nói thay vì văn bản. Với hình này, Google Dịch cung cấp bản dịch từ tiếng Anh, và Copilot phác thảo lần đầu các bản vẽ con vật.
Ứng dụng của LCM trùng lặp với LLM, nhưng do tập trung vào khái niệm và mức độ hiểu sâu, chúng có tiềm năng tạo tác động mạnh mẽ hơn ở các lĩnh vực đòi hỏi tư duy sâu.
LCM đơn giản hóa dịch thuật và tăng cường hiểu biết liên ngôn ngữ bằng cách hoạt động trong không gian nhúng phi phụ thuộc ngôn ngữ. Điều này đặc biệt hiệu quả cho các tác vụ như tóm tắt đa ngôn ngữ hoặc dịch tài liệu phức tạp.
Ví dụ, một LCM có thể xử lý tài liệu pháp lý phức tạp bằng một ngôn ngữ và tạo bản tóm tắt mạch lạc bằng ngôn ngữ khác. Khả năng này vô giá cho tổ chức toàn cầu, truyền thông quốc tế và dịch thuật liên quan đến các ngôn ngữ ít tài nguyên.
LCM xuất sắc trong việc tạo đầu ra mạch lạc và phù hợp ngữ cảnh, khiến chúng lý tưởng cho các tác vụ như soạn thảo báo cáo, viết bài và tạo tóm tắt. Bằng cách duy trì tính nhất quán logic xuyên suốt nội dung dài, LCM có thể tạo đầu ra cần chỉnh sửa ít hơn đáng kể so với LLM, tiết kiệm thời gian và công sức cho các chuyên gia báo chí, tiếp thị và nghiên cứu.
Tôi cho rằng khả năng ứng dụng LCM trong giáo dục là ấn tượng nhất. Hãy tưởng tượng một hệ thống gia sư thông minh được vận hành bởi LCM có thể tạo nội dung giải thích và tương tác phù hợp cho từng người học.
Một gia sư LCM có thể tóm lược chủ đề phức tạp thành các phần dễ hiểu về mặt khái niệm cho học viên ở nhiều trình độ. Tính thích ứng đa ngôn ngữ có thể cho phép một giáo viên dạy học sinh bằng hàng trăm ngôn ngữ cùng lúc!
LCM cũng rất phù hợp để hỗ trợ nghiên cứu và sáng tác. Chúng có thể phác thảo các bài viết có cấu trúc, mạch lạc, như bài luận, bài nghiên cứu hoặc truyện hư cấu, cung cấp bản nháp ban đầu để tác giả tinh chỉnh.
Các nhà nghiên cứu cũng có thể dùng LCM để tổ chức ý tưởng, mở rộng tóm tắt hoặc thậm chí tạo giả thuyết dựa trên dữ liệu hiện có. Chúng giải quyết nhiều vấn đề mà các nhà nghiên cứu thấy khó chịu với LLM hiện nay.
Chắc hẳn tôi không phải người duy nhất từng bực mình khi tương tác với các bot hỗ trợ khách hàng dùng LLM mới, chỉ để rồi chúng không hiểu vấn đề của mình. Khi được vận hành bởi LCM, chatbot hỗ trợ khách hàng có thể hiểu tốt hơn các tình huống phức tạp và thậm chí đưa ra giải pháp sáng tạo hơn. Điều này có thể nâng cao sự hài lòng và gắn bó của khách hàng.
Hiện tại, LLM được dùng cho một số vai trò này nhưng hiệu quả còn hạn chế. LCM có tiềm năng nâng tầm các ứng dụng đó. Sớm thôi, trợ lý AI của chúng ta có thể giống như có trợ lý con người thực thụ, theo kịp các ý tưởng và cuộc trò chuyện phức tạp—chỉ là họ có thể giao tiếp nhanh hơn chúng ta nhiều.
Dù LCM mở ra nhiều khả năng thú vị, chúng cũng đi kèm thách thức về yêu cầu dữ liệu, độ phức tạp và chi phí tính toán. Hãy điểm qua một vài thách thức lớn hiện nay.
Huấn luyện bất kỳ mô hình AI nào cũng cần lượng dữ liệu lớn, nhưng LCM có thêm các bước xử lý so với LLM. Thay vì dùng văn bản thô, chúng dựa vào biểu diễn ở cấp câu, nghĩa là văn bản phải được tách thành câu rồi chuyển thành embedding. Điều này tăng lớp tiền xử lý và nhu cầu lưu trữ.
Thêm vào đó, huấn luyện trên hàng trăm tỷ câu đòi hỏi sức mạnh tính toán khổng lồ.
LCM xử lý cả câu như đơn vị đơn lẻ, giúp duy trì mạch logic nhưng khiến việc khắc phục sự cố khó hơn.
LLM tạo văn bản từng từ, cho phép truy vết lỗi đến từng token. Ngược lại, LCM hoạt động trong không gian nhúng nhiều chiều, nơi quyết định dựa trên các quan hệ trừu tượng.
LCM, đặc biệt các mô hình dựa trên khuếch tán, đòi hỏi nhiều sức mạnh xử lý hơn nhiều so với LLM. Trong khi LLM tạo văn bản qua một lượt truyền xuôi, LCM khuếch tán tinh chỉnh đầu ra theo từng bước, làm tăng cả thời gian lẫn chi phí tính toán. Dù LCM có thể hiệu quả hơn cho tài liệu dài, chúng thường kém hiệu quả cho các tác vụ ngắn như phản hồi nhanh hoặc tương tác chat.
Định nghĩa khái niệm ở cấp câu tự thân đã tạo ra thách thức. Câu dài có thể chứa nhiều ý, khó gói gọn thành một đơn vị. Còn câu ngắn có thể không cung cấp đủ ngữ cảnh để biểu diễn có ý nghĩa.
LCM cũng đối mặt với vấn đề thưa dữ liệu. Vì từng câu riêng lẻ độc nhất hơn rất nhiều so với từ, mô hình có ít mẫu lặp lại để học hơn.
Công nghệ này đang phát triển nhanh chóng và các thách thức đang được giải quyết tích cực. Vì công nghệ này mã nguồn mở, bạn có thể bổ sung giải pháp của riêng mình để góp phần khắc phục và thúc đẩy công nghệ.
Bạn muốn thử làm việc với LCM? Nhiều mã nguồn đã được mở, nên bạn hoàn toàn có thể bắt tay ngay!
Điểm khởi đầu tuyệt vời là mã huấn luyện LCM và không gian nhúng SONAR được cung cấp miễn phí. Các công cụ mã nguồn mở này cho phép nhà phát triển thử nghiệm công nghệ mới và tự cải tiến.
Để tìm hiểu thêm về lý thuyết đằng sau LCM, hãy xem bài báo này của Meta.
Khả năng vận hành ở cấp độ khái niệm của LCM có tiềm năng tinh chỉnh cách AI tương tác với ngôn ngữ. Bằng cách vượt qua giới hạn của phân tích dựa trên token, LCM mở đường cho các ứng dụng tinh tế hơn, nhận thức ngữ cảnh tốt hơn và đa ngôn ngữ.
Tôi khuyến khích bạn tự xem mã và thêm dấu ấn riêng. Bạn có thể cải thiện công nghệ này thế nào? Bạn có thể tạo ra sản phẩm gì với nó?
Học AI với những khóa học này!
Lộ trình
Lộ trình
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
