
LLMs बनाम LCMs
LLMs और LCMs के कई लक्ष्य समान हैं: दोनों पाठ उत्पन्न करते हैं, जानकारी का सारांश बनाते हैं, और भाषाओं के बीच अनुवाद करते हैं। लेकिन वे इन कार्यों को करने का तरीका बुनियादी रूप से भिन्न है।
LLMs एक समय में एक टोकन का अनुमान लगाते हैं, जिससे वे प्रवाहपूर्ण वाक्य बनाने में श्रेष्ठ होते हैं। हालांकि, लंबे आउटपुट में यह अक्सर असंगतियों या अनावश्यक दोहराव का कारण बनता है। दूसरी ओर, LCMs वाक्य स्तर पर भाषा को संसाधित करते हैं, जिससे वे विस्तृत अनुच्छेदों में तार्किक प्रवाह बनाए रख पाते हैं।
एक और अंतर यह है कि वे बहुभाषी प्रसंस्करण को कैसे संभालते हैं। LLMs उच्च-संसाधन भाषाओं—जैसे अंग्रेज़ी—के प्रशिक्षण डेटा पर अत्यधिक निर्भर होते हैं। नतीजतन, वे कम-संसाधन भाषाओं में, जहाँ बड़े डेटासेट नहीं होते, अक्सर संघर्ष करते हैं।
वहीं LCMs SONAR एंबेडिंग स्पेस में काम करते हैं। यह एंबेडिंग स्पेस उन्हें बिना पुनः प्रशिक्षण के कई भाषाओं में पाठ संसाधित करने देता है। अमूर्त अवधारणाओं के साथ काम करने से वे कहीं अधिक अdaptable.
|
क्षमता |
LLMs कैसे काम करते हैं |
LCMs इसे कैसे सुधारते हैं |
|
बहुभाषी और बहु-फॉर्मेट लचीलापन |
मुख्यतः उच्च-संसाधन भाषाओं पर प्रशिक्षित और कम सामान्य भाषाओं में संघर्ष। वाक् जैसे अन्य फॉर्मेट के लिए अतिरिक्त प्रशिक्षण चाहिए। |
200+ भाषाओं में काम करता है और बिना अतिरिक्त प्रशिक्षण के पाठ व वाक् दोनों का समर्थन करता है। |
|
नई कार्यों पर सामान्यीकरण |
नई भाषाओं या विषयों के लिए फाइन-ट्यूनिंग की आवश्यकता। अपरिचित डेटा में कठिनाई। |
भाषा-स्वतंत्र प्रणाली का उपयोग करता है, जिससे नई भाषाओं और कार्यों को बिना अतिरिक्त प्रशिक्षण के संभाल सकता है। |
|
दीर्घ-रूप सामग्री में सुसंगति |
शब्द-दर-शब्द लिखता है, जिससे लंबे उत्तरों में असंगति या दोहराव की संभावना। |
पूरे वाक्यों को एक साथ संसाधित करता है, लंबे पाठ में उत्तरों को अधिक स्पष्ट और संरचित रखता है। |
|
संदर्भ संभालने में दक्षता |
लंबे इनपुट पर मेमोरी और प्रोसेसिंग जरूरतें बढ़ने से संघर्ष। |
संक्षिप्त वाक्य निरूपणों का उपयोग करता है, जिससे लंबे दस्तावेजों को कुशलतापूर्वक संसाधित करना आसान होता है। |
LCMs के मुख्य घटक
लार्ज कॉन्सेप्ट मॉडल्स अपनी विशिष्ट क्षमताएँ तीन-भाग वाली प्रणाली के माध्यम से प्राप्त करते हैं:
- कॉन्सेप्ट एनकोडर: इनपुट को एक सिमैंटिक एंबेडिंग स्पेस में बदलता है
- LCM कोर: विचार-निर्णयन और भविष्यवाणी करता है
- कॉन्सेप्ट डिकोडर: मॉडल के आउटपुट को मानव-पठनीय भाषा में अनुवाद करता है
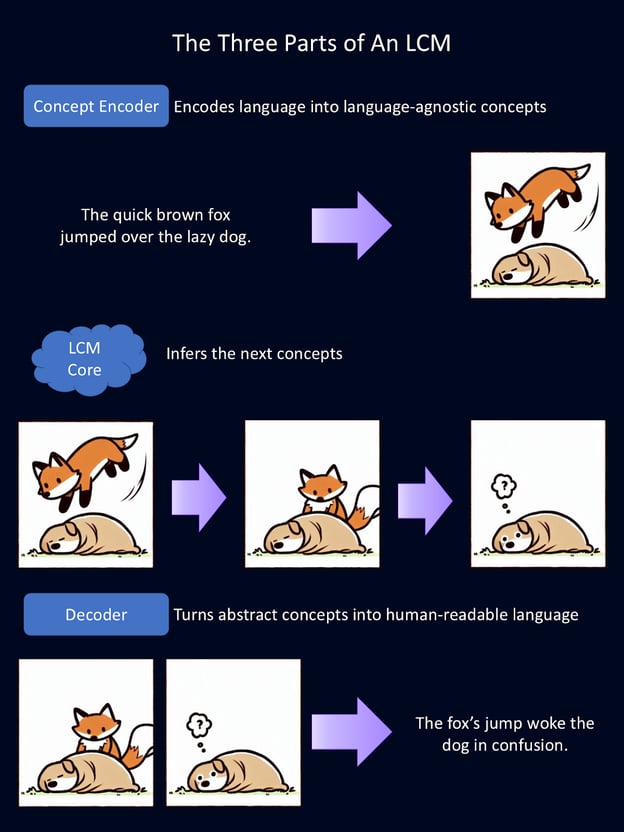
ऊपर का आरेख यह सरलता से समझाता है कि LCM के तीनों मॉड्यूलर घटक कैसे काम करते हैं। एनकोडर भाषा को अमूर्त अवधारणाओं में बदलता है। यहाँ ये अमूर्त अवधारणाएँ चित्रों के रूप में दर्शाई गई हैं। मॉडल में ये अवधारणाएँ गणितीय रूप में निरूपित होती हैं। कोर उन्हीं अवधारणाओं पर इन्फरेंस चलाता है। फिर डिकोडर उन अमूर्तनों को मानव-पठनीय भाषा में बदल देता है। इस चित्र के लिए, Copilot ने पशुओं के चित्रों का पहला प्रारूप प्रदान किया।
कॉन्सेप्ट एनकोडर: इनपुट को अवधारणा में बदलना
LCM की प्रोसेसिंग पाइपलाइन का पहला चरण इनपुट को उच्च-आयामी सिमैंटिक निरूपण में एन्कोड करना है। मूलतः, यह भाषा को अवधारणाओं के गणितीय निरूपणों में बदल देता है। यह कॉन्सेप्ट एनकोडर बड़े पाठ खंडों, जैसे पूरे वाक्यों, का मानचित्रण करता है।
LCMs SONAR का उपयोग करते हैं, जो भाषा के लिए एक शक्तिशाली एंबेडिंग स्पेस है। यही एंबेडिंग स्पेस पाठ और वाक् हेतु विभिन्न भाषाओं का समर्थन करता है। SONAR एनकोडर को लिखित और मौखिक भाषा दोनों को संसाधित करने देता है, अवधारणाओं को उस रूप में संक्षिप्त करता है जिसे मॉडल समझ सके।
LCM कोर: विचार-निर्णयन और भविष्यवाणी
एक बार अवधारणाएँ एन्कोड हो जाने पर, LCM कोर संदर्भ के आधार पर नए कॉन्सेप्ट उत्पन्न करने के लिए उन्हें संसाधित करता है। यहीं इन्फरेंस होता है। LLMs के विपरीत, जो टोकन-दर-टोकन पाठ का अनुमान लगाते हैं, LCM कोर पूरे वाक्यों या अवधारणाओं का अनुमान लगाता है।
LCM कोर के तीन प्रकार हैं, जिनमें से प्रत्येक अवधारणाओं का मॉडलिंग अलग तरीके से करता है:
- बेस-LCM: एक मानक ट्रांसफॉर्मर जो पूर्ववर्ती अवधारणाओं से भविष्य की अवधारणाओं का अनुमान Mean Squared Error लॉस का उपयोग करके लगाता है।
- डिफ्यूजन-आधारित LCM: एक जनरेटिव मॉडल जो स्व-प्रागामी डिफ्यूजन के माध्यम से शोरयुक्त वाक्य एंबेडिंग्स को परिष्कृत करता है, ठीक वैसे ही जैसे AI इमेज जनरेटर्स अपने आउटपुट को क्रमिक रूप से निखारते हैं।
- क्वांटाइज़्ड LCM: सतत वाक्य एंबेडिंग्स को मॉडलिंग से पहले असतत इकाइयों में बदलता है, जिससे यह LLMs के समान हो जाता है, पर बहुत बड़े टोकन आकारों के साथ।
इनमें, डिफ्यूजन-आधारित LCMs ने सर्वश्रेष्ठ भविष्यवाणी शक्ति दिखाई है, सबसे सटीक और संदर्भ के अनुरूप आउटपुट उत्पन्न करते हुए।
कॉन्सेप्ट डिकोडर: फिर से मानव-पठनीय भाषा
जब LCM कोर ने नई अवधारणाओं को संसाधित और अनुमानित कर लिया, तो उन्हें फिर से मानव-पठनीय रूप में बदला जाना चाहिए। यही काम कॉन्सेप्ट डिकोडर करता है। यह अवधारणाओं के गणितीय निरूपणों को पाठ या वाक् आउटपुट में अनुवादित करता है।
क्योंकि अंतर्निहित अवधारणाएँ एक साझा एंबेडिंग स्पेस में संग्रहीत होती हैं, उन्हें बिना पुनःप्रसंस्करण के किसी भी समर्थित भाषा में डिकोड किया जा सकता है। यह अत्यंत शक्तिशाली है क्योंकि इसका अर्थ है कि आउटपुट भाषा-निरपेक्ष हैं। सारा “सोचना” गणित में होता है। इसलिए, मुख्यतः अंग्रेज़ी और स्पैनिश पर प्रशिक्षित एक LCM जर्मन में इनपुट पढ़ सकता है, गणित में “सोच” सकता है, और जापानी में सामग्री उत्पन्न कर सकता है।
इसका यह भी अर्थ है कि नई भाषाएँ और मोडैलिटीज़ पूरे मॉडल को पुनः प्रशिक्षित किए बिना जोड़ी जा सकती हैं। यदि कोई नया स्पीच-टू-टेक्स्ट सिस्टम विकसित होता है, तो उसे मौजूदा LCM के साथ बड़े कंप्यूटेशनल संसाधनों की आवश्यकता के बिना एकीकृत किया जा सकता है।
कल्पना कीजिए यदि कोई सांकेतिक भाषा के लिए एनकोडर और डिकोडर बना दे। वे उसे मौजूदा LCM कोर में, बिना पुनः प्रशिक्षण, जोड़ सकते हैं और बिल्कुल अलग स्वरूप में विचारों का संप्रेषण कर सकते हैं। यह लचीलेपन LCMs को बहुभाषी और बहु-फॉर्मेट AI अनुप्रयोगों के लिए मापनीय और अनुकूलनीय समाधान बनाता है।
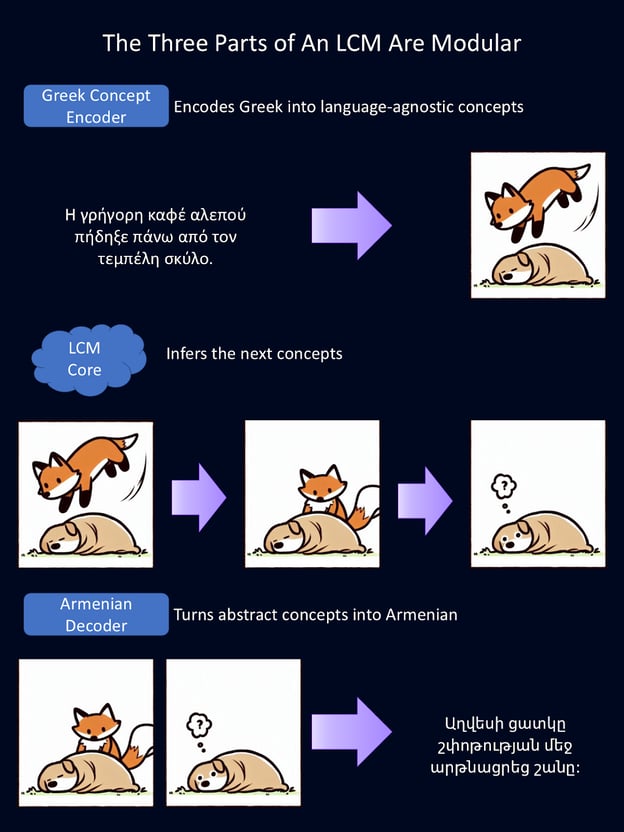
क्योंकि LCM का हर भाग मॉड्यूलर है, हर भाग को स्वतंत्र रूप से बदला जा सकता है। ऊपर के आरेख में, हमने पिछले अंग्रेज़ी भाषा के एनकोडर और डिकोडर को ग्रीक भाषा के एनकोडर और आर्मेनियाई भाषा के डिकोडर से बदल दिया है।
इन एनकोडर्स और डिकोडर्स को ऐसे मॉड्यूल्स से भी बदला जा सकता है जो भाषा की अलग मोडैलिटीज़, जैसे पाठ के बजाय मौखिक वाक्, को संभालते हों। इस चित्र के लिए, Google Translate ने अंग्रेज़ी से अनुवाद प्रदान किए, और Copilot ने पशु चित्रों का पहला प्रारूप दिया।
LCM के अनुप्रयोग
LCMs के अनुप्रयोग LLMs के साथ ओवरलैप करते हैं, लेकिन अवधारणाओं और गहन समझ पर उनके फोकस के कारण, उनमें उन उद्योगों पर और भी गहरा प्रभाव डालने की क्षमता है जहाँ गहन विचार की आवश्यकता होती है।
बहुभाषी संचार
LCMs भाषा-निरपेक्ष एंबेडिंग स्पेस में काम करके अनुवाद को सरल और अंतर्भाषिक समझ को बेहतर बनाते हैं। यह उन्हें बहुभाषी सारांशण या जटिल दस्तावेजों के अनुवाद जैसे कार्यों के लिए विशेष रूप से प्रभावी बनाता है।
उदाहरण के लिए, एक LCM किसी एक भाषा में जटिल कानूनी दस्तावेज़ को संसाधित कर दूसरी भाषा में सुसंगत सारांश बना सकता है। यह क्षमता वैश्विक संगठनों, अंतरराष्ट्रीय संचार, और कम-संसाधन भाषाओं से जुड़े अनुवादों के लिए अमूल्य है।
कंटेंट जेनरेशन
LCMs सुसंगत और संदर्भानुकूल आउटपुट बनाने में उत्कृष्ट हैं, जिससे वे रिपोर्ट का मसौदा, लेखन, और सारांश तैयार करने जैसे कार्यों के लिए आदर्श विकल्प बनते हैं। दीर्घ-रूप सामग्री में तार्किक सुसंगति बनाए रखते हुए, LCMs ऐसे आउटपुट तैयार कर सकते हैं जिन्हें LLMs की तुलना में काफी कम संपादन की आवश्यकता होती है, जिससे पत्रकारिता, मार्केटिंग, और शोध के पेशेवरों का समय और प्रयास बचता है।
शैक्षिक उपकरण
मुझे लगता है कि शिक्षा में LCMs की उपयोगिता सबसे प्रभावशाली है। कल्पना कीजिए, LCM द्वारा संचालित एक इंटेलिजेंट ट्यूटरिंग सिस्टम जो व्यक्तिगत शिक्षार्थियों के अनुरूप व्याख्यात्मक और इंटरैक्टिव सामग्री बना सके।
एक LCM ट्यूटर जटिल विषय को सरल, वैचारिक रूप से पचने योग्य खंडों में संक्षेपित कर सकता है, विभिन्न विशेषज्ञता स्तरों के छात्रों के लिए। इसकी बहुभाषी अनुकूलता एक शिक्षक को एक साथ सैकड़ों भाषाओं में छात्रों को पढ़ाने में सक्षम बना सकती है!
रचनात्मक लेखन और शोध सहयोग
LCMs शोध और रचनात्मक लेखन में सहयोग के लिए भी उपयुक्त हैं। वे निबंध, शोध-पत्र, या काल्पनिक कथाएँ जैसे संरचित और सुसंगत लेख तैयार कर सकते हैं, जिनका लेखक आगे परिष्करण कर सकते हैं।
शोधकर्ता LCMs का उपयोग विचारों को व्यवस्थित करने, सारांशों का विस्तार करने, या मौजूदा डेटा के आधार पर परिकल्पनाएँ उत्पन्न करने के लिए भी कर सकते हैं। वे उन कई समस्याओं का समाधान करते हैं जो शोधकर्ताओं को वर्तमान LLMs के साथ खटकती हैं।
बेहतर ग्राहक सहायता चैटबॉट्स
मुझे यकीन है कि मैं अकेला नहीं हूँ जिसे इन नए LLM-संचालित कस्टमर सपोर्ट बॉट्स के साथ बातचीत का निराशाजनक अनुभव हुआ हो, जहाँ वे मेरी समस्या समझ ही नहीं पाए। LCMs से संचालित होने पर, ग्राहक सहायता चैटबॉट्स जटिल परिस्थितियों को बेहतर समझ सकते हैं और शायद अधिक रचनात्मक समाधान भी दे सकते हैं। इससे ग्राहक संतुष्टि और बनाए रखने में सुधार हो सकता है।
अभी, LLMs इन कई भूमिकाओं में प्रयुक्त होते हैं, पर उनकी प्रभावशीलता सीमित है। LCMs इन अनुप्रयोगों को एक नया स्तर दे सकते हैं। जल्द ही, हमारे AI सहायक वास्तविक मानव सहायकों जैसे हो सकते हैं, जो अधिक जटिल विचारों और वार्ताओं के साथ चल सकें—बस वे हमसे कहीं तेज़ी से संवाद कर पाएँगे।
लार्ज कॉन्सेप्ट मॉडल्स की चुनौतियाँ
जहाँ LCMs रोमांचक संभावनाएँ प्रदान करते हैं, वहीं वे डेटा आवश्यकताओं, जटिलता, और कंप्यूटेशनल लागत में चुनौतियाँ भी लाते हैं। आइए कुछ प्रमुख मौजूदा चुनौतियों पर नज़र डालें।
उच्चतर डेटा और संसाधन जरूरतें
किसी भी AI मॉडल को प्रशिक्षित करने के लिए विशाल मात्रा में डेटा चाहिए, लेकिन LCMs में LLMs की तुलना में अतिरिक्त प्रोसेसिंग चरण होते हैं। कच्चे पाठ का उपयोग करने के बजाय, वे वाक्य-स्तरीय निरूपणों पर निर्भर करते हैं, यानी पाठ को पहले वाक्यों में तोड़ना और फिर एंबेडिंग्स में बदलना होता है। यह प्री-प्रोसेसिंग और स्टोरेज की माँगें बढ़ा देता है।
साथ ही, सैकड़ों अरब वाक्यों पर प्रशिक्षण के लिए अत्यधिक कंप्यूटेशनल शक्ति चाहिए।
बढ़ी हुई जटिलता और डिबगिंग
LCMs पूरे वाक्यों को एकक (यूनिट) के रूप में संसाधित करते हैं, जो तार्किक प्रवाह बनाए रखने में मदद करता है, लेकिन समस्या निवारण को और कठिन बना देता है।
LLMs एक समय में एक शब्द उत्पन्न करते हैं, जिससे हम त्रुटियों को व्यक्तिगत टोकनों तक ट्रेस कर सकते हैं। इसके विपरीत, LCMs उच्च-आयामी एंबेडिंग स्पेस में कार्य करते हैं, जहाँ निर्णय अमूर्त संबंधों पर आधारित होते हैं।
अधिक कंप्यूटेशनल लागत
LCMs, विशेषकर डिफ्यूजन-आधारित मॉडल, LLMs की तुलना में कहीं अधिक प्रोसेसिंग पावर माँगते हैं। जहाँ LLMs एक फॉरवर्ड पास में पाठ उत्पन्न कर देते हैं, वहीं डिफ्यूजन-आधारित LCMs अपने आउटपुट को चरण-दर-चरण परिष्कृत करते हैं, जिससे समय और लागत दोनों बढ़ते हैं। यद्यपि LCMs लंबे दस्तावेज़ों के लिए अधिक कुशल हो सकते हैं, वे त्वरित उत्तरों या चैट-आधारित संवाद जैसे लघु-रूप कार्यों के लिए अक्सर कम कुशल होते हैं।
संरचनात्मक सीमाएँ
वाक्य-स्तर पर अवधारणाएँ परिभाषित करना अपनी ही तरह की चुनौतियाँ लाता है। लंबे वाक्यों में अनेक विचार हो सकते हैं, जिन्हें एक इकाई के रूप में कैप्चर करना कठिन होता है। और छोटे वाक्य सार्थक निरूपण के लिए पर्याप्त संदर्भ नहीं देते।
LCMs डेटा विरलता की समस्या का भी सामना करते हैं। क्योंकि व्यक्तिगत वाक्य शब्दों की तुलना में कहीं अधिक अद्वितीय होते हैं, मॉडल के पास सीखने के लिए दोहराए जाने वाले पैटर्न कम होते हैं।
यह तकनीक तेज़ी से विकसित हो रही है और इन चुनौतियों पर सक्रिय रूप से काम हो रहा है। चूँकि यह तकनीक ओपन सोर्स है, आप अपने समाधान जोड़कर इन चुनौतियों को संबोधित करने और इस तकनीक को आगे बढ़ाने में मदद कर सकते हैं।
LCMs के साथ शुरुआत कैसे करें
क्या आप किसी LCM के साथ काम करने की कोशिश करना चाहते हैं? बहुत सा कोड ओपन सोर्स है, तो आप ऐसा कर सकते हैं!
एक बेहतरीन शुरुआती बिंदु है निःशुल्क उपलब्ध LCM प्रशिक्षण कोड और SONAR एंबेडिंग स्पेस। ये ओपन-सोर्स टूल डेवलपर्स को इस नई तकनीक के साथ प्रयोग करने और अपने सुधार जोड़ने की अनुमति देते हैं।
LCMs के पीछे के सिद्धांत के बारे में अधिक जानने के लिए, Meta का यह पेपर देखें।
निष्कर्ष
अवधारणा स्तर पर काम करने की LCMs की क्षमता में भाषा के साथ AI की अंतःक्रियाओं को परिष्कृत करने की संभावना है। टोकन-आधारित विश्लेषण की सीमाओं से आगे बढ़कर, LCMs अधिक सूक्ष्म, संदर्भ-जागरूक, और बहुभाषी अनुप्रयोगों के लिए मार्ग खोलते हैं।
मैं आपको स्वयं कोड देखने और अपना योगदान जोड़ने के लिए प्रोत्साहित करता/करती हूँ। आप इस तकनीक में क्या सुधार कर सकते हैं? आप इससे कौन-से उत्पाद बना सकते हैं?
FAQs
मैं LCM कहाँ आज़मा सकता/सकती हूँ?
LCMs अभी भी प्रायोगिक हैं, लेकिन वे ओपन सोर्स भी हैं। आप कोड Github पर पा सकते हैं।
क्या नई भाषा जोड़ने के लिए मुझे LCM को पुनः प्रशिक्षित करना होगा?
नहीं। नई भाषा जोड़ने के लिए LCM कोर को पुनः प्रशिक्षित करने की आवश्यकता नहीं होती। इसके बजाय, नया एनकोडर और डिकोडर लिखे जा सकते हैं जो गणितीय अवधारणाओं का उस नई भाषा में अनुवाद करें।
LCMs LLMs से कैसे भिन्न हैं?
LLMs भाषा को एक समय में एक टोकन “पढ़ते” हैं और वाक्य में अगले शब्द का अनुमान लगाने के लिए आँकड़ों का उपयोग करते हैं। दूसरी ओर, LCMs भाषा को एक समय में एक वाक्य “पढ़ते” हैं और अगली होने वाली अवधारणा का अनुमान लगाने की कोशिश करते हैं।

मैं एक पीएचडी हूँ, जिसके पास जैविक अनुसंधान परिवेश में डेटा के साथ काम करने का 13 वर्षों का अनुभव है। मैं Python, MATLAB और R सहित कई प्रोग्रामिंग भाषाओं में सॉफ्टवेयर बनाती/बनाता हूँ। मुझे सीखने के प्रति अपने प्रेम को दुनिया के साथ साझा करने का जुनून है।
लार्ज लैंग्वेज मॉडल्स (LLMs) बहुत शक्तिशाली हैं, लेकिन वे अक्सर व्यापक विचारों का ट्रैक रखने में संघर्ष करते हैं। इसका कारण यह है कि LLMs एक समय में एक टोकन, या शब्द, का अनुमान लगाकर काम करते हैं।
यह टोकन-दर-टोकन दृष्टिकोण, सीमित संदर्भ विंडो के साथ मिलकर, असंगत प्रतिक्रियाओं, संदर्भ खोने और बहुत अधिक दोहराव की ओर ले जा सकता है। यह ऐसा है मानो आप पहले विचारों का रूपरेखा बनाने के बजाय हर अगला शब्द अनुमान लगाकर निबंध लिखने की कोशिश कर रहे हों।
यहीं पर लार्ज कॉन्सेप्ट मॉडल्स (LCMs) उपयोगी साबित हो सकते हैं। शब्द दर शब्द काम करने के बजाय, LCMs वाक्य स्तर पर भाषा को संसाधित करते हैं और भाषा को अवधारणाओं में अमूर्त करते हैं। यह अमूर्तन मॉडल को भाषा को अधिक विचारशील और सार्थक तरीके से समझने देता है।
लार्ज कॉन्सेप्ट मॉडल क्या है?
लार्ज कॉन्सेप्ट मॉडल (LCM) भाषा का विश्लेषण व्यक्तिगत शब्दों की बजाय अवधारणा स्तर पर करने वाला एक प्रकार का भाषा मॉडल है। पारंपरिक मॉडल जो पाठ को शब्द-दर-शब्द तोड़ते हैं, उनसे अलग, LCMs वैचारिक निरूपणों की व्याख्या करते हैं, जो पूरे वाक्यों या सुसंगत विचारों से मेल खाते हैं। यह बदलाव उन्हें केवल यांत्रिकी से आगे बढ़कर भाषा के व्यापक अर्थ को समझने देता है।
कल्पना कीजिए कि आप एक उपन्यास पढ़ रहे हैं। एक LLM इसे टोकन-दर-टोकन संसाधित करेगा, व्यक्तिगत शब्दों और उनके आस-पास के शब्दों पर ध्यान केंद्रित करेगा। इस दृष्टिकोण से, यह सबसे संभावित अगले शब्द का अनुमान लगाकर एक सारांश उत्पन्न कर सकता है। परंतु यह व्यापक कथा और अंतर्निहित थीम्स को चूक सकता है।
इसके विपरीत, LCMs बड़े पाठ खंडों का विश्लेषण करके अंतर्निहित विचार निकालते हैं। यह दृष्टिकोण उन्हें व्यापक अवधारणाओं—समग्र कहानी चाप, चरित्र विकास, और थीम्स—को समझने में मदद करता है। इससे वे न केवल अधिक पूर्ण सारांश बना पाते हैं, बल्कि कहानी को अधिक अर्थपूर्ण तरीके से आगे भी बढ़ा सकते हैं।
भाषा-निरपेक्ष दृष्टिकोण
शब्दों की बजाय अवधारणाओं में सोचने की यह क्षमता LCMs को अत्यंत लचीला बनाती है। वे SONAR एंबेडिंग स्पेस पर आधारित हैं, जो उन्हें 200+ भाषाओं में पाठ और 76 भाषाओं में वाक् को संसाधित करने देता है।
भाषा-विशिष्ट पैटर्न पर निर्भर होने के बजाय, LCMs अर्थ को वैचारिक स्तर पर संग्रहीत करते हैं। यह अमूर्तन उन्हें बहुभाषी सारांशण, अनुवाद, और क्रॉस-फॉर्मेट कंटेंट जेनरेशन जैसे कार्यों के लिए अनुकूल बनाता है।
दीर्घ-रूप सामग्री में सुसंगति बनाए रखना
क्योंकि LCMs भाषा को वैचारिक स्तर पर संसाधित करते हैं, वे संरचित और संदर्भ-जागरूक आउटपुट उत्पन्न करते हैं। LLMs के विपरीत, जो शब्द-दर-शब्द पाठ बनाते हैं, LCMs तार्किक प्रवाह बनाए रखने के लिए पूरे वाक्यों के संख्यात्मक निरूपण का इस्तेमाल करते हैं। यह उन्हें रिपोर्ट का मसौदा तैयार करने या लंबे दस्तावेजों का अनुवाद करने जैसे कार्यों के लिए विशेष रूप से प्रभावी बनाता है।
उनमें एक मॉड्यूलर डिज़ाइन भी होता है, जो डेवलपर्स को पूरे सिस्टम को पुनः प्रशिक्षित किए बिना नई भाषाएँ या तौर-तरीके (modalities) जोड़ने देता है।