
Program
AI İşletme Temelleri
12 sa
Alıştırma and program your progress.
Google Ile Devam EdinBüyük dil modelleri (LLM’ler) çok güçlüdür, ancak çoğu zaman büyük resmi takip etmekte zorlanırlar. Bunun nedeni, LLM’lerin metni bir seferde bir token ya da kelime tahmin ederek üretmesidir.
Bu token token ilerleyen yaklaşım, sınırlı bağlam penceresiyle birleştiğinde, kopuk yanıtlar, kaybolan bağlam ve çokça tekrar üretilmesine yol açabilir. Düşüncelerinizi önce taslaklamak yerine, her bir sonraki kelimeyi tahmin ederek bir deneme yazmaya çalışmak gibidir.
İşte bu noktada büyük kavram modelleri (LCM’ler) faydalı olabilir. Kelime kelime çalışmak yerine, LCM’ler dili cümle düzeyinde işler ve dili kavramlara soyutlar. Bu soyutlama, modelin dili daha düşünceli ve anlamlı bir şekilde kavramasını sağlar.
Büyük kavram modeli (LCM), dili tek tek kelimeleri analiz etmek yerine kavram düzeyinde işleyen bir dil modeli türüdür. Metni kelime kelime parçalayan geleneksel modellerin aksine, LCM’ler tüm cümlelere veya tutarlı fikirlere karşılık gelen anlamsal temsilleri yorumlar. Bu dönüşüm, yalnızca mekaniklere değil, dilin daha geniş anlamına hâkim olmalarını sağlar.
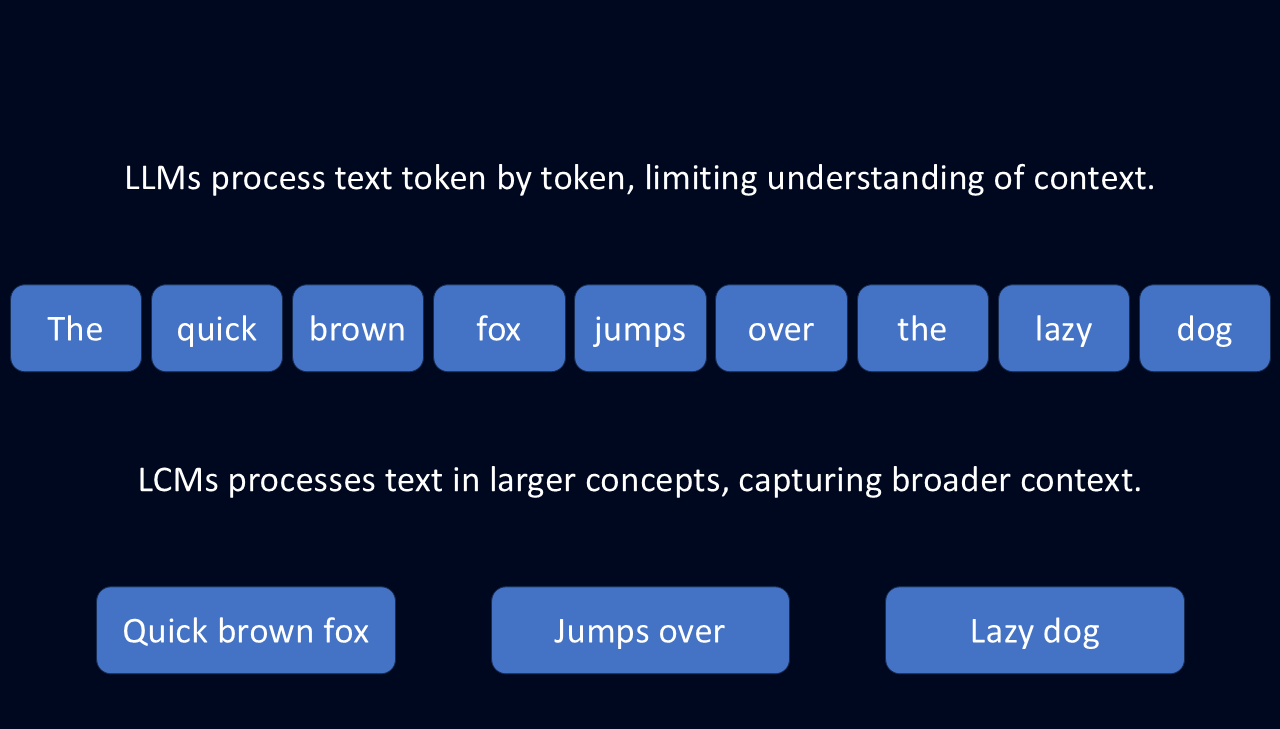
Bir roman okuduğunuzu hayal edin. Bir LLM, onu token token işler; tek tek kelimelere ve onların en yakın komşularına odaklanır. Bu yaklaşımla, en olası bir sonraki kelimeyi tahmin ederek bir özet üretebilir. Ancak daha geniş anlatıyı ve alttaki temaları kaçırabilir.
LCM’ler ise metnin daha büyük bölümlerini analiz ederek alttaki fikirleri çıkarır. Bu yaklaşım, genel hikâye akışı, karakter gelişimi ve temalar gibi daha geniş kavramları anlamalarına yardımcı olur. Bu sayede yalnızca daha eksiksiz bir özet üretmekle kalmaz, hikâyeyi daha anlamlı bir şekilde genişletebilirler.
Kelimeler yerine kavramlarla düşünebilme yetisi, LCM’leri son derece esnek kılar. SONAR gömme uzayı üzerine inşa edilirler; bu da onların 200’ün üzerinde dilde metni ve 76 dilde konuşmayı işlemesine imkân tanır.
LCM’ler, dil-özgü kalıplara dayanmak yerine anlamı kavramsal düzeyde depolar. Bu soyutlama, çok dilli özetleme, çeviri ve çok biçimli içerik üretimi gibi görevler için onları uyarlanabilir kılar.
LCM’ler dili kavramsal düzeyde işledikleri için, yapılandırılmış ve bağlama duyarlı çıktılar üretirler. Metni kelime kelime inşa eden LLM’lerden farklı olarak, LCM’ler mantıksal akışı korumak için tüm cümlelerin sayısal temsillerini kullanır. Bu da onları rapor taslağı hazırlama veya uzun belgeleri çevirme gibi görevlerde özellikle etkili kılar.
Ayrıca modüler bir tasarıma sahiptirler; bu da geliştiricilerin tüm sistemi yeniden eğitmeden yeni dilleri veya kipleri entegre etmesine olanak tanır.
LLM’ler ve LCM’ler birçok ortak hedefi paylaşır: her ikisi de metin üretir, bilgileri özetler ve diller arasında çeviri yapar. Ancak bu görevleri yerine getirme biçimleri temelden farklıdır.
LLM’ler metni bir seferde bir token tahmin ederek üretir; bu da onları akıcı cümleler kurmada başarılı kılar. Ne var ki bu, uzun çıktılarda tutarsızlıklara veya tekrar fazlalığına yol açabilir. LCM’ler ise dili cümle düzeyinde işleyerek uzun pasajlarda mantıksal akışı korumalarına imkân tanır.
Bir başka fark ise çok dilli işlemenin ele alınış biçimidir. LLM’ler, İngilizce gibi çok fazla eğitim içeriğine sahip yüksek kaynaklı dillere ait veriye büyük ölçüde dayanır. Sonuç olarak, büyük veri kümelerinden yoksun düşük kaynaklı dillerde sıklıkla zorlanırlar.
LCM’ler ise SONAR gömme uzayında çalışır. Bu gömme uzayı, yeniden eğitim gerektirmeden birçok dilde metni işlemelerine olanak verir. Soyut kavramlarla çalışmak onları çok daha uyarlanabilir hale getirir.
|
Yetenek |
LLM’ler nasıl çalışır |
LCM’ler nasıl iyileştirir |
|
Çok dilli ve çok biçimli esneklik |
Çoğunlukla yüksek kaynaklı dillerde eğitilir ve daha az yaygın dillerde zorlanır. Konuşma gibi farklı biçimler için ekstra eğitim gerekir. |
200’den fazla dilde çalışır ve ek eğitime gerek olmadan metin ve konuşmayı destekler. |
|
Yeni görevlere genelleme |
Yeni diller veya konular için ince ayar gerekir. Tanıdık olmayan verilerde zorlanır. |
Dilden bağımsız bir sistem kullanır; ekstra eğitim olmadan yeni dilleri ve görevleri ele alabilir. |
|
Uzun biçimli içerikte tutarlılık |
Kelime kelime yazar; bu da uzun yanıtlarda tutarsızlığa veya tekrara yatkınlık yaratır. |
Tam cümleleri bir seferde işler; uzun metinlerde yanıtları daha net ve yapılandırılmış tutar. |
|
Bağlamı verimli yönetme |
Artan bellek ve işlem gereksinimleri nedeniyle daha uzun girdilerde zorlanır. |
Kompakt cümle temsilleri kullanır; uzun belgeleri verimli biçimde işlemeyi kolaylaştırır. |
Büyük kavram modelleri, üç parçalı bir sistem sayesinde benzersiz yeteneklerine ulaşır:
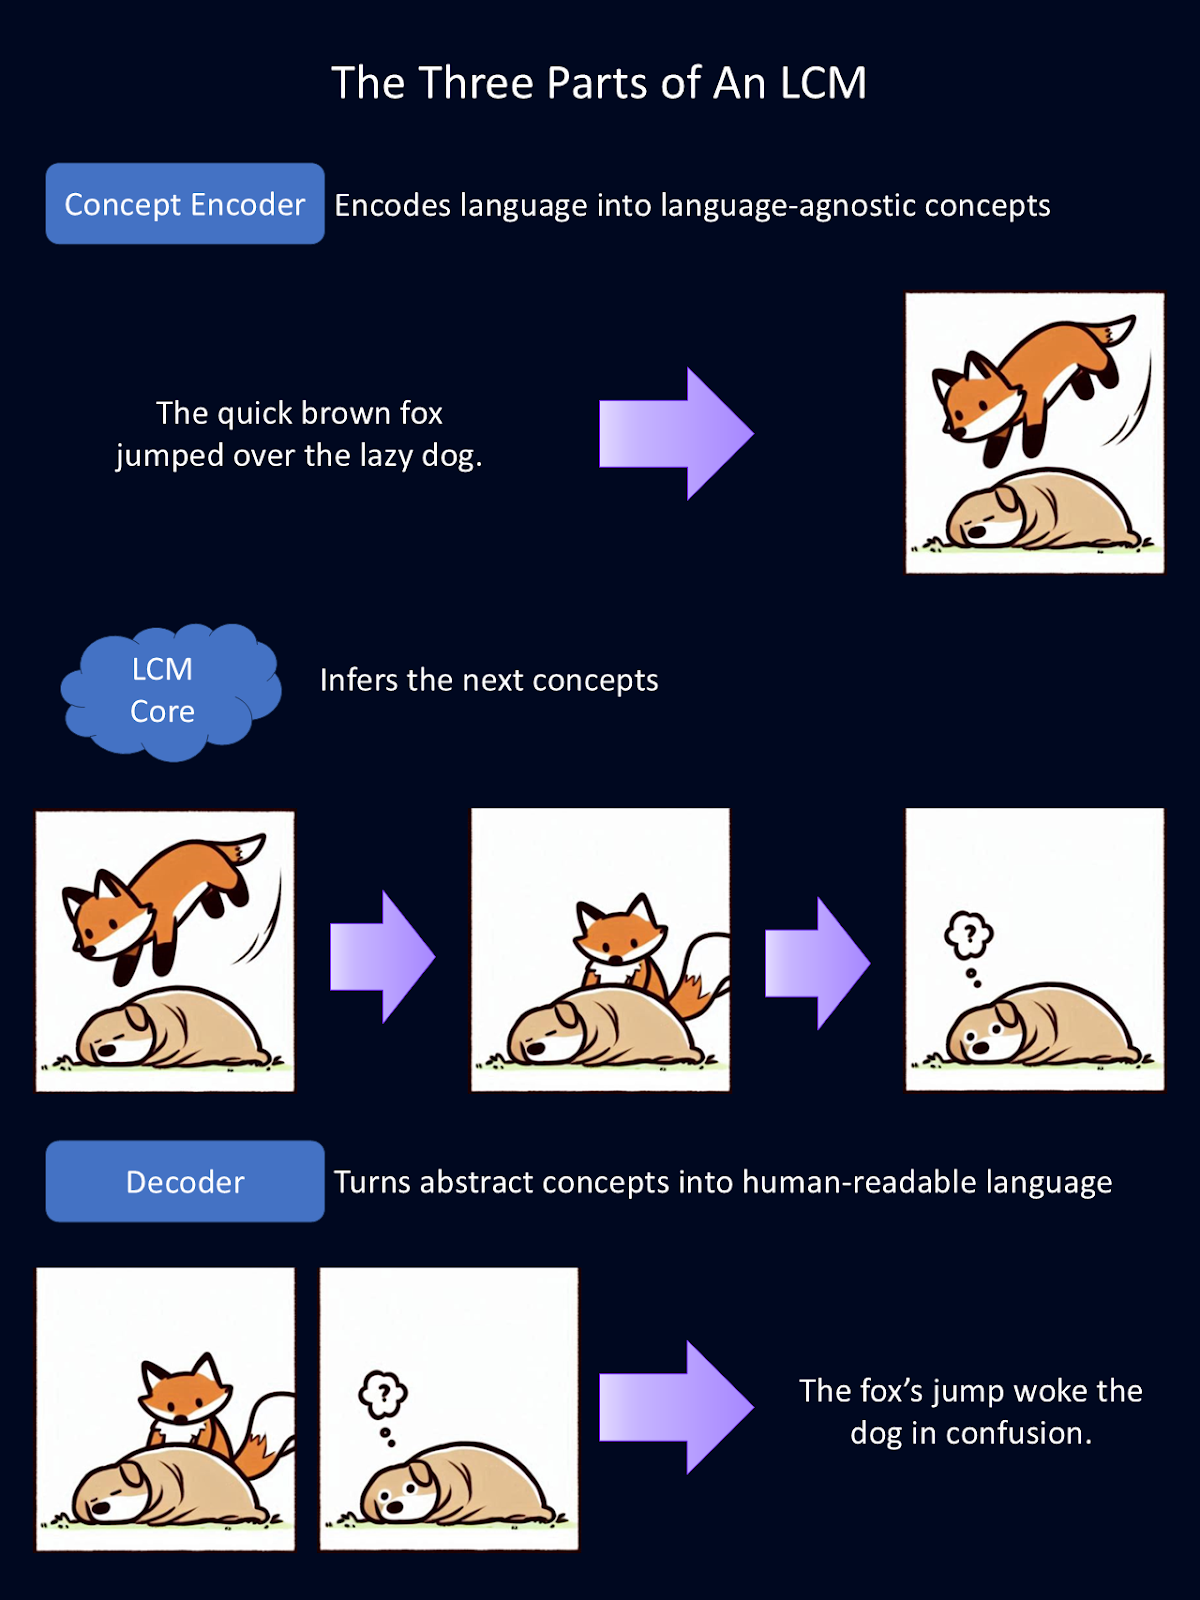
Yukarıdaki diyagram, bir LCM’in üç modüler bileşeninin her birinin nasıl çalıştığını basitleştirilmiş şekilde açıklar. Kodlayıcı, dili soyut kavramlara dönüştürür. Burada bu soyut kavramlar görsellerle temsil edilmiştir. Modelde ise bu kavramlar matematiksel olarak temsil edilir. Çekirdek bu kavramlar üzerinde çıkarım yürütür. Ardından çözücü, bu soyutlamaları insan tarafından okunabilir dile çevirir. Bu çizim için, hayvan resimlerinin ilk taslağını Copilot sağlamıştır.
Bir LCM’in işlem hattındaki ilk adım, girdiyi yüksek boyutlu bir anlamsal temsile kodlamaktır. Özünde bu, dili kavramların matematiksel temsillerine dönüştürür. Bu kavram kodlayıcı, bir bütün olarak cümleler gibi büyük metin bölümlerini eşler.
LCM’ler, dil için güçlü bir gömme uzayı olan SONAR’ı kullanır. Metin ve konuşma için farklı dilleri destekleyen bu gömme uzayıdır. SONAR, kodlayıcının hem yazılı hem de sözlü dili işlemesine ve kavramları modelin anlayabileceği bir şeye damıtmasına olanak tanır.
Kavramlar kodlandıktan sonra, LCM çekirdeği bunları bağlama göre yeni kavramlar üretmek üzere işler. Çıkarımın gerçekleştiği yer burasıdır. Metni token token tahmin eden LLM’lerin aksine, LCM çekirdeği tüm cümleleri veya kavramları tahmin eder.
Üç tür LCM çekirdeği vardır ve her biri kavramları modellemede farklı bir yaklaşım benimser:
Bunlar arasında, difüzyon tabanlı LCM’ler en iyi öngörü gücünü sergileyerek en doğru ve bağlamsal olarak tutarlı çıktıları üretmiştir.
LCM Çekirdeği yeni kavramları işleyip tahmin ettikten sonra, bunların insan tarafından okunabilir biçime dönüştürülmesi gerekir. Bu iş, kavram çözücünün görevidir. Kavramların matematiksel temsillerini metin ya da konuşma çıktısına çevirir.
Alttaki kavramlar ortak bir gömme uzayında depolandığı için, yeniden işleme gerekmeden desteklenen herhangi bir dile çözülebilirler. Bu, çıktılar dilden bağımsız olduğu için son derece güçlüdür. Tüm “düşünme” matematikle gerçekleşir. Dolayısıyla, ağırlıklı olarak İngilizce ve İspanyolca üzerinde eğitilmiş bir LCM, girdiyi Almanca alıp matematikte “düşünebilir” ve çıktıyı Japonca üretebilir.
Bu aynı zamanda yeni dillerin ve kiplerin tüm modeli yeniden eğitmeye gerek kalmadan eklenebileceği anlamına gelir. Yeni bir konuşmadan-yazıya sistemi geliştirilirse, devasa hesaplama kaynakları gerektirmeden mevcut bir LCM ile entegre edilebilir.
Birinin işaret dili için bir kodlayıcı ve çözücü geliştirdiğini hayal edin. Bunu yeniden eğitim olmadan mevcut bir LCM çekirdeğine ekleyebilir ve fikirleri tamamen farklı bir formatta iletebilirler. Bu esneklik, LCM’leri çok dilli ve çok biçimli yapay zekâ uygulamaları için ölçeklenebilir ve uyarlanabilir bir çözüm haline getirir.
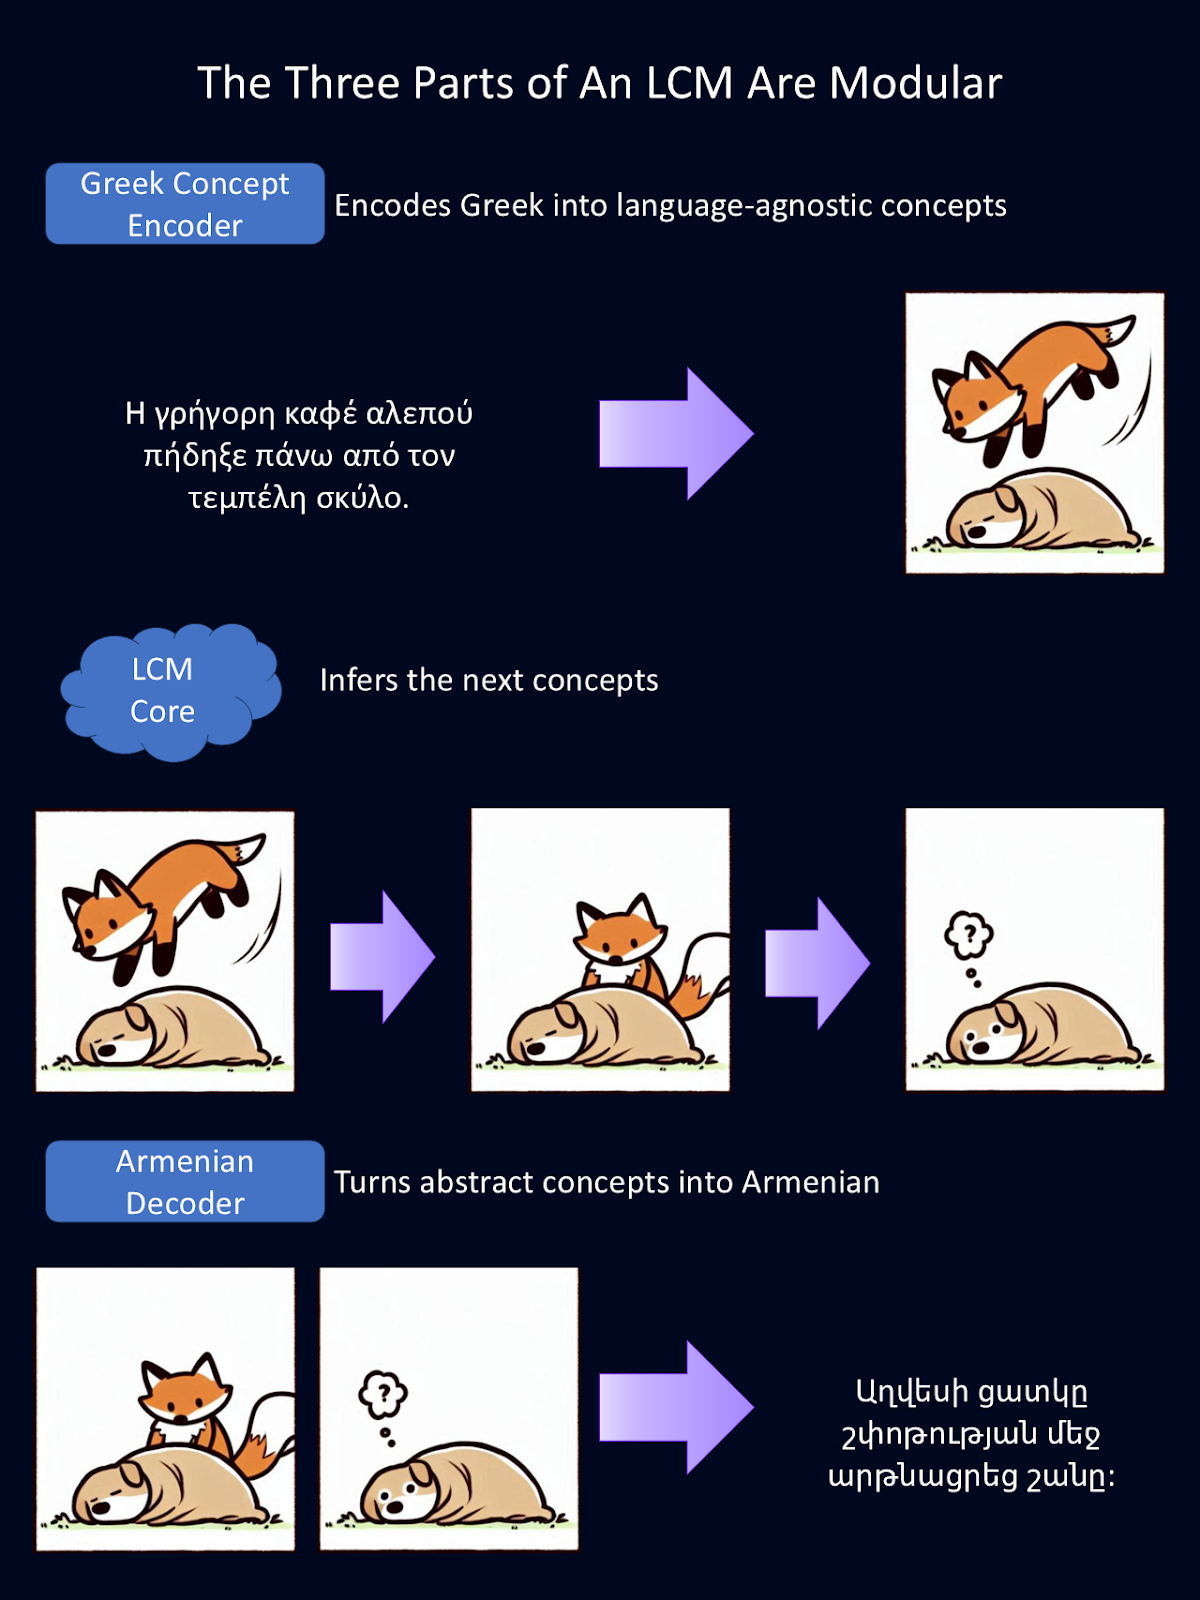
LCM’in her parçası modüler olduğundan, her bir parça bağımsız olarak değiştirilebilir. Yukarıdaki diyagramda, önceki İngilizce dil kodlayıcı ve çözücüyü bir Yunanca dil kodlayıcısı ve bir Ermenice dil çözücüsüyle değiştirdik.
Bu kodlayıcılar ve çözücüler, metin yerine sözlü konuşma gibi dilin farklı kiplerini ele alanlarla da değiştirilebilir. Bu çizim için, İngilizceden çevirileri Google Translate sağladı ve hayvan resimlerinin ilk taslağını Copilot hazırladı.
LCM’lerin uygulama alanları LLM’lerle örtüşür; ancak kavramlara ve daha derin anlama odaklanmaları nedeniyle, daha derin düşünme gerektiren sektörlerde daha güçlü bir etki yaratma potansiyeline sahiptirler.
LCM’ler, dilden bağımsız bir gömme uzayında çalışarak çeviriyi basitleştirir ve diller arası anlayışı güçlendirir. Bu da onları çok dilli özetleme veya karmaşık belgelerin çevirisi gibi görevlerde özellikle etkili kılar.
Örneğin bir LCM, bir dildeki karmaşık bir hukuk belgesini işleyip başka bir dilde tutarlı bir özet üretebilir. Bu yetenek, küresel kuruluşlar, uluslararası iletişim ve düşük kaynaklı dilleri içeren çeviriler için çok değerlidir.
LCM’ler, tutarlı ve bağlamsal olarak ilgili çıktılar üretmede mükemmeldir; bu da onları rapor taslakları, makale yazımı ve özet oluşturma gibi görevler için ideal kılar. Uzun biçimli içerikte mantıksal tutarlılığı koruyarak, LCM’ler LLM’lere kıyasla çok daha az düzenleme gerektiren çıktılar üretebilir; bu da gazetecilik, pazarlama ve araştırma alanlarındaki profesyonellerin zaman ve emek tasarrufu yapmasını sağlar.
LCM’lerin eğitime uygulanabilirliğinin en etkileyici olanı olduğunu düşünüyorum. LCM tarafından desteklenen, bireysel öğrenenlere göre uyarlanmış açıklayıcı ve etkileşimli içerik üretebilen akıllı bir öğretim sistemi hayal edin.
Bir LCM eğitmeni, karmaşık bir konuyu, farklı uzmanlık seviyelerindeki öğrenciler için kavramsal olarak sindirilebilir daha basit parçalara özetleyebilir. Diller arası uyarlanabilirliği, tek bir öğretmenin aynı anda yüzlerce dilde öğrencilere ders verebilmesini bile sağlayabilir!
LCM’ler, araştırma ve yaratıcı yazımda yardımcı olmak için de uygundur. Denemeler, araştırma makaleleri veya kurgu anlatıları gibi yapılandırılmış ve tutarlı yazılar taslaklayabilir; yazarların daha sonra üzerinde çalışabileceği ilk taslaklar sağlayabilirler.
Araştırmacılar ayrıca LCM’leri fikirleri düzenlemek, özetleri genişletmek veya mevcut verilere dayanarak hipotezler üretmek için kullanabilir. Mevcut LLM’lerle araştırmacıların sıkça yaşadığı pek çok sorunu çözerler.
Bunlardan biriyle etkileşime girip sorunumun anlaşılmadığı sinir bozucu deneyimi yaşayan tek kişinin ben olmadığımı biliyorum. LCM’ler tarafından desteklendiklerinde, müşteri destek sohbet botları karmaşık durumları daha iyi anlayabilir ve belki daha yaratıcı çözümler sunabilir. Bu da müşteri memnuniyeti ve elde tutmada artışa yol açabilir.
Şu anda LLM’ler bu rollerin bir kısmında kullanılıyor, ancak etkinlikleri sınırlı. LCM’lerin bu uygulamaları bir üst seviyeye taşıma potansiyeli var. Yakında, yapay zekâ asistanlarımız daha karmaşık fikirleri ve sohbetleri takip edebilen gerçek insan asistanlarına daha çok benzeyebilir—yalnız bizden çok daha hızlı iletişim kurabilirler.
LCM’ler heyecan verici olasılıklar sunsa da veri gereksinimleri, karmaşıklık ve hesaplama maliyetleri açısından zorluklar da barındırır. Mevcut en büyük zorluklardan birkaçını gözden geçirelim.
Herhangi bir yapay zekâ modelini eğitmek büyük miktarda veri gerektirir; ancak LCM’lerde LLM’lere kıyasla fazladan işlem adımları vardır. Ham metni kullanmak yerine, cümle düzeyindeki temsillere dayanırlar; yani metnin önce cümlelere bölünmesi ve ardından gömmelere dönüştürülmesi gerekir. Bu da bir ön işleme ve depolama katmanı ekler.
Üstelik yüz milyarlarca cümle üzerinde eğitim, muazzam hesaplama gücü gerektirir.
LCM’ler, mantıksal akışı korumaya yardımcı olan şekilde, tüm cümleleri tekil birimler olarak işler; ancak bu durum sorun gidermeyi zorlaştırır.
LLM’ler metni kelime kelime üretir; bu da hataları tekil token’lara kadar izlememize olanak tanır. Buna karşılık LCM’ler, kararların soyut ilişkiler temelinde verildiği yüksek boyutlu bir gömme uzayında çalışır.
Özellikle difüzyon tabanlı LCM’ler, LLM’lere kıyasla çok daha fazla işlem gücü gerektirir. LLM’ler metni tek bir ileri geçişte üretirken, difüzyon tabanlı LCM’ler çıktıları adım adım rafine eder; bu da hem hesaplama süresini hem de maliyeti artırır. LCM’ler uzun belgeler için daha verimli olabilse de, kısa yanıtlar veya sohbet tabanlı etkileşimler gibi kısa biçimli görevler için çoğu zaman daha az verimlidir.
Kavramları cümle düzeyinde tanımlamak, kendi başına bazı zorluklar yaratır. Daha uzun cümleler birden fazla fikir içerebilir; bu da onların tek bir birim olarak yakalanmasını zorlaştırır. Daha kısa cümleler ise anlamlı bir temsil için yeterli bağlam sağlamayabilir.
LCM’ler ayrıca veri seyrekliği sorunlarıyla karşı karşıyadır. Tek tek cümleler, kelimelere göre çok daha özgün olduğundan, modelin öğrenebileceği tekrarlayan kalıplar daha azdır.
Bu teknoloji hızla gelişiyor ve bu zorluklar aktif olarak ele alınıyor. Teknoloji açık kaynak olduğundan, siz de kendi çözümlerinizi ekleyerek bu zorlukların aşılmasına ve teknolojinin ilerlemesine katkıda bulunabilirsiniz.
Bir LCM ile çalışmayı denemek ister misiniz? Kodun büyük bir kısmı açık kaynak; yani bunu yapabilirsiniz!
Harika bir başlangıç noktası, ücretsiz olarak sunulan LCM eğitim kodu ve SONAR gömme uzayıdur. Bu açık kaynak araçlar, geliştiricilerin bu yeni teknolojiyle denemeler yapmasına ve kendi iyileştirmelerini sunmasına imkân tanır.
LCM’lerin arkasındaki kuram hakkında daha fazla bilgi edinmek için Meta’nın bu makalesine göz atın.
LCM’lerin kavramsal düzeyde çalışabilme yetisi, yapay zekânın dille etkileşimini rafine etme potansiyeline sahiptir. Token tabanlı analiz kısıtlarının ötesine geçerek, LCM’ler daha incelikli, bağlamı gözeten ve çok dilli uygulamaların önünü açar.
Kodu bizzat incelemenizi ve kendi dokunuşunuzu katmanızı öneririm. Bu teknolojiye hangi iyileştirmeleri getirebilirsiniz? Bununla hangi ürünleri oluşturabilirsiniz?
Bu kurslarla Yapay Zekâ öğrenin!
Program
Program
Alıştırma and program your progress.
Google Ile Devam Edinblog
Abid Ali Awan
14 dk.
blog
Dario Radečić
15 dk.
Eğitim
Kurtis Pykes
8 dk.
Eğitim
Adel Nehme



