{count, plural, one {Program} other {Program}}
Rekayasa Kecerdasan Buatan dengan LangChain
{hours} jam
Dua rilis model yang paling banyak diperbincangkan di awal 2026 datang dari arah yang sangat berbeda. Muse Spark dari Meta adalah model pertama dari Meta Superintelligence Labs dan merupakan pergeseran yang disengaja dari garis keturunan Llama. Claude Opus 4.6 dari Anthropic hadir lebih awal sebagai peningkatan untuk tier andalannya, dengan jendela konteks 1 juta token dan skor teratas di Terminal-Bench 2.0.
Memilih di antara keduanya tidaklah mudah. Muse Spark secara native bersifat multimodal dengan tiga mode penalaran yang berbeda dan berfokus pada efisiensi komputasi. Claude Opus 4.6 dibangun untuk pengkodean agentik, alur kerja jangka panjang, dan penalaran mendalam, dengan Agent Teams dan adaptive thinking yang tertanam. Keduanya bersifat proprietari dan hanya tersedia di cloud, yang sudah mempersempit pilihan dibandingkan alternatif berbobot terbuka.
Dalam artikel ini, saya akan membandingkan Muse Spark dan Claude Opus 4.6 dalam enam dimensi utama: arsitektur dan filosofi desain, penalaran dan benchmark, kemampuan multimodal, fitur agentik, akses dan ketersediaan, serta privasi dan lisensi.
Jika Anda tertarik mempelajari lebih lanjut tentang model bahasa besar (LLM) Anthropic, saya sarankan mengikuti kursus Introduction to Claude Models kami. Selain itu, jangan lupa melihat artikel perbandingan kami yang lain tentang GPT-5.4 vs Claude Opus 4.6.
Pembaruan: Tak lama setelah artikel ini diterbitkan, versi Opus baru dirilis. Pastikan membaca panduan Claude Opus 4.7 kami.
Muse Spark adalah model pertama yang dirilis dengan nama keluarga Muse, awalnya berkode nama "Avocado" selama pengembangan. Model ini dibangun oleh Meta Superintelligence Labs, sebuah divisi yang dibentuk Meta pada Juni 2025 setelah dorongan investasi sebesar $14,3 miliar yang termasuk merekrut Alexandr Wang dari Scale AI. Model ini diluncurkan pada 8 April 2026.
Keputusan desain kunci di balik Muse Spark adalah membangun ulang pipeline pelatihan dari nol. Alih-alih memperluas arsitektur Llama, tim Meta memulai dari awal dengan multimodalitas native meliputi teks, gambar, audio, dan penggunaan alat. Hasilnya adalah model yang menurut Meta menyamai kinerja Llama 4 Maverick dengan penggunaan komputasi satu ordo magnitudo lebih sedikit. Meta merilis Muse Spark 1.3 pada 2 September 2026.
Muse Spark menawarkan tiga mode penalaran:
Model ini hanya tersedia di cloud, dapat diakses melalui meta.ai atau aplikasi Meta AI, dengan API pratinjau privat untuk mitra perusahaan terpilih. Model ini juga mendukung Muse Agent yang baru.
Claude Opus 4.6 adalah model andalan terbaru Anthropic, dirilis pada awal 2026 sebagai peningkatan dari Opus 4.5. Anthropic menggambarkannya sebagai tier model tercerdas mereka, dengan fokus pada pengkodean agentik, penalaran mendalam, dan koreksi diri. Model ini memuncaki benchmark evaluasi pengkodean Terminal-Bench 2.0 dan setara dengan para pemimpin di beberapa benchmark lain, seperti BrowseComp untuk riset informasi.
Angka utama yang disorot adalah jendela konteks 1 juta token, saat ini dalam beta. Ini membuat Opus 4.6 sejalan dengan Gemini 3 dalam panjang konteks dan layak untuk basis kode besar serta tugas agentik jangka panjang. Bersamaan dengan modelnya, Anthropic meluncurkan Agent Teams di Claude Code, memungkinkan beberapa instance Claude yang independen bekerja paralel pada satu tugas.
Claude Opus 4.6 tersedia melalui Claude API (ID model: claude-opus-4-6), Claude Code, dan Claude in PowerPoint. Model ini bersifat proprietari dan hanya di cloud, tanpa versi berbobot terbuka.
Tanpa basa-basi, mari bandingkan kedua model dalam beberapa kategori relevan.
Jika Anda menginginkan jawaban cepat sebelum masuk ke detail, tabel ini memetakan skenario umum ke model yang lebih sesuai.
| Kasus penggunaan | Direkomendasikan | Alasan |
|---|---|---|
| Pengkodean agentik dengan agen paralel | Claude Opus 4.6 | Agent Teams di Claude Code, 80,8 pada SWE-Bench Verified |
| Analisis dokumen ber-konteks panjang | Claude Opus 4.6 | Jendela konteks 1M token (beta) |
| Penalaran multimodal (teks + gambar + audio) | Muse Spark | Multimodalitas native dari awal, visual chain-of-thought |
| Inferensi yang efisien secara komputasi | Muse Spark | Menyamai Llama 4 Maverick dengan komputasi 10x lebih sedikit |
| Matematika dan penalaran kompleks | Claude Opus 4.6 | Skor lebih baik di berbagai benchmark penalaran |
| Akses API untuk perusahaan | Claude Opus 4.6 | API publik tersedia; API Muse Spark hanya pratinjau privat |
| Penalaran multi-langkah ekstrem | Muse Spark (Contemplating) | Mode penalaran multiagen paralel; bersaing dengan Gemini Deep Think dan GPT Pro |
| Integrasi PowerPoint dan Excel | Claude Opus 4.6 | Claude in PowerPoint dan Claude in Excel adalah integrasi yang sudah tersedia |
| Kasus penggunaan terkait kesehatan | Muse Spark | Kekuatan utama Muse Spark: 42,8 vs. 14,8 di HealthBench Hard |
Cara sebuah model dibangun membentuk keunggulannya. Muse Spark dan Claude Opus 4.6 mencerminkan pertaruhan yang benar-benar berbeda tentang ke mana AI terdepan seharusnya menuju.
Meta membangun ulang pipeline pelatihannya dari nol untuk Muse Spark. Model ini secara native multimodal, artinya teks, gambar, audio, dan penggunaan alat dilatih bersama, bukan ditambahkan belakangan. Ini sangat kontras dengan seri Llama, yang oleh Meta sendiri digambarkan berbasis pencocokan pola.
Salah satu pilihan teknis yang menarik adalah Thought Compression, teknik reinforcement learning yang memberi penalti pada token berlebihan selama penalaran. Tujuannya adalah efisiensi: model didorong untuk bernalar dengan baik tanpa menghasilkan langkah perantara yang tidak perlu. Inilah sebagian alasan mengapa Muse Spark dapat menyamai kinerja Llama 4 Maverick dengan sebagian kecil biaya komputasi.
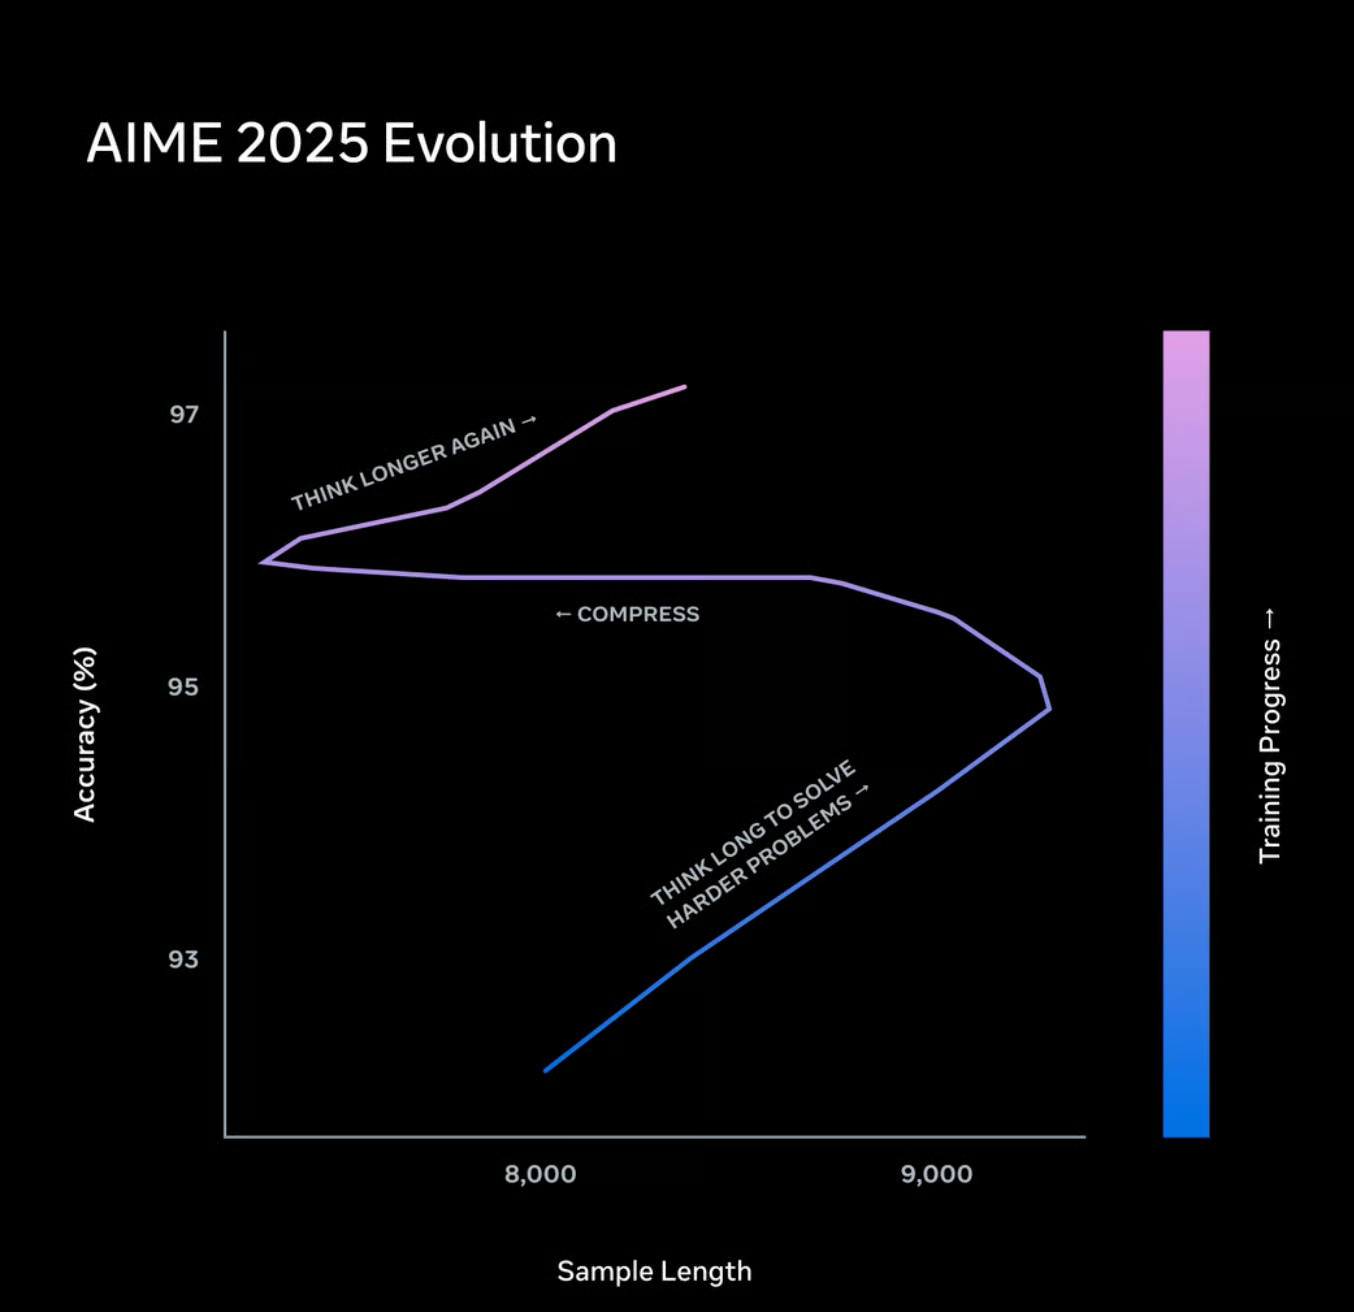
Fokus desain Anthropic untuk Opus 4.6 adalah aksi berkelanjutan, bukan performa satu giliran. Model ini dibangun untuk merencanakan dengan cermat, menjaga koherensi dalam jangka waktu lama, dan mengidentifikasi kesalahan pada penalarannya sendiri. Adaptive thinking memungkinkan model memutuskan apakah sebuah prompt memerlukan rantai pemikiran yang diperpanjang, dan parameter effort memberi pengembang kendali manual atas pertukaran tersebut.
Tingkat effort patut dipahami jika Anda menggunakan API:
Stack yang dibangun ulang Muse Spark merupakan penyimpangan arsitektural yang lebih radikal, dan cerita efisiensi komputasinya benar-benar impresif. Adaptive thinking dan kontrol effort pada Claude Opus 4.6 lebih langsung berguna bagi pengembang yang membutuhkan kontrol terperinci atas biaya versus kedalaman.
Angka benchmark adalah proksi yang tidak sempurna, tetapi itu sinyal paling jelas yang kita miliki untuk membandingkan model yang sebagian besar orang belum jalankan berdampingan.
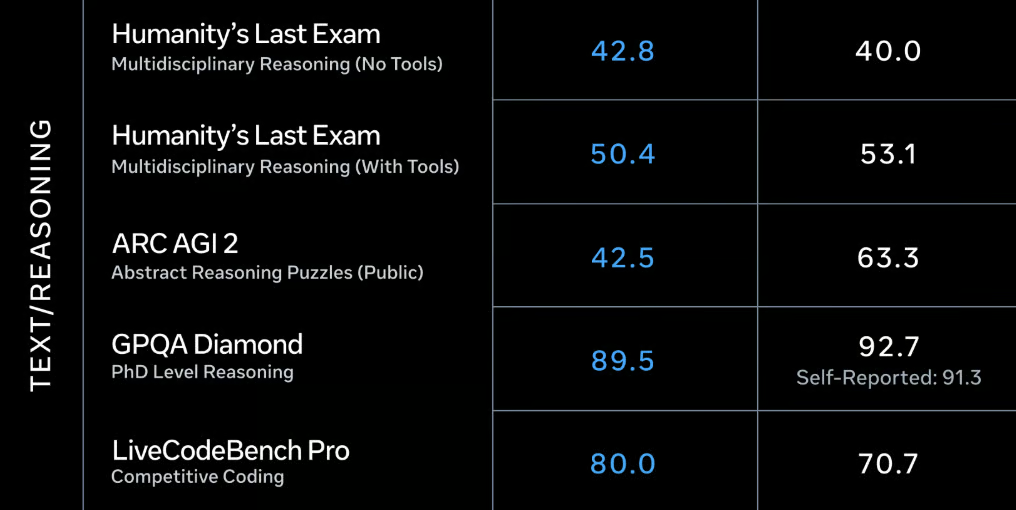
Benchmark teks/penalaran. Skor Muse Spark (Thinking) di kiri, Claude Opus 4.6 (Max) di kanan. Sumber: Meta
Saat membandingkan kedua model di domain teks/penalaran, kita melihat pola berikut:
Secara keseluruhan, Claude Opus 4.6 tampaknya pilihan yang lebih baik ketika diperlukan penalaran yang sangat abstrak, sementara Muse Spark setara dalam hal penalaran berbasis akal sehat dan terkait domain.
Kedua model menangani lebih dari sekadar teks, tetapi kedalaman dukungannya berbeda secara signifikan.
Multimodalitas adalah inti dari identitas Muse Spark, bukan tambahan. Model ini dilatih secara native pada teks, gambar, audio, dan data terstruktur secara bersamaan. Visual chain-of-thought adalah fitur spesifik: model dapat menalar melalui masalah berbasis gambar selangkah demi selangkah, bukan hanya mendeskripsikan apa yang dilihatnya. Penggunaan alat juga native, yang penting untuk alur kerja agentik yang melibatkan pemanggilan API eksternal atau pemrosesan data terstruktur bersamaan dengan masukan tak terstruktur.
Claude Opus 4.6 mendukung masukan multimodal, tetapi catatan risetnya tidak menggambarkannya sebagai native multimodal dalam pengertian arsitektural yang sama seperti Muse Spark. Integrasi multimodal andalan model ini ada pada sisi keluaran: Claude in PowerPoint menghasilkan objek slide yang dapat diedit alih-alih gambar slide, dan Claude in Excel melacak ketergantungan rumus lintas lembar.
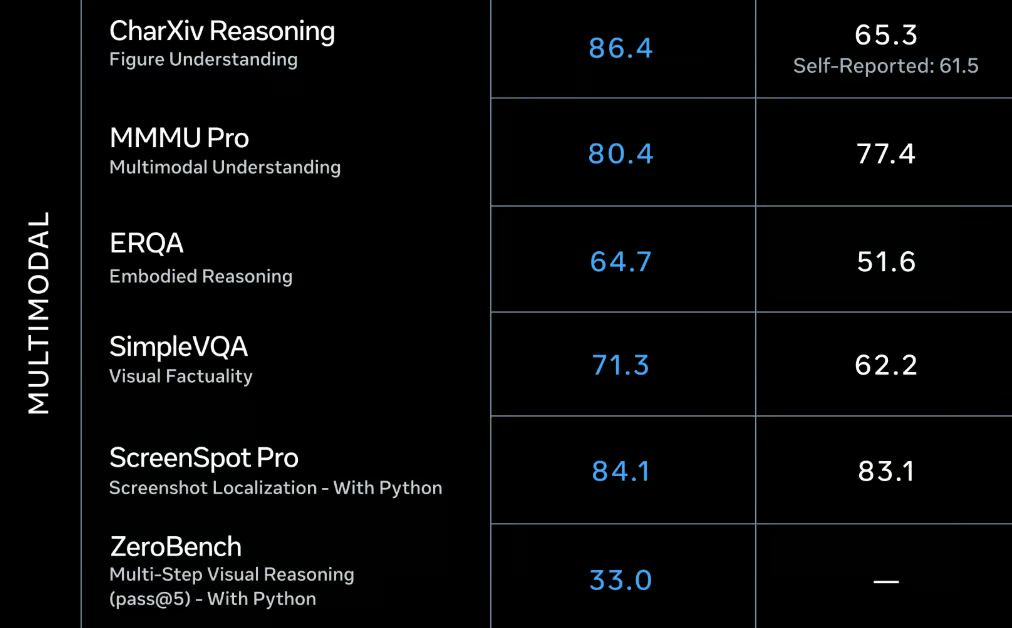
Benchmark multimodal. Skor Muse Spark (Thinking) di kiri, Claude Opus 4.6 (Max) di kanan. Sumber: Meta
Di domain multimodal, Muse Spark menunjukkan kekuatannya: Ia memimpin atas Claude Opus 4.6 di setiap benchmark yang dikutip. Hasil berikut sangat mengesankan:
Untuk tugas yang memadukan teks, gambar, dan audio di level model, Muse Spark memiliki dasar yang lebih kuat. Untuk alur kerja dokumen dan spreadsheet di perusahaan, integrasi Claude Opus 4.6 lebih langsung praktis.
Kedua model diposisikan untuk kasus penggunaan agentik, tetapi mereka mendekati masalahnya secara berbeda.
Mode Contemplating pada Muse Spark adalah andalan agentiknya. Alih-alih satu model yang menalar secara berurutan, Contemplating memutar beberapa agen secara paralel, masing-masing mengerjakan bagian dari suatu masalah, dengan hasil diverifikasi lintas agen. Ini mirip dalam semangat dengan Agent Teams milik Claude tetapi dibangun ke dalam mode penalaran itu sendiri, bukan diekspos sebagai fitur API terpisah.
Agent Teams di Claude Code adalah fitur agentik yang menonjol di Opus 4.6. Anda dapat memutar beberapa instance Claude yang independen, dengan satu bertindak sebagai koordinator utama dan lainnya menangani eksekusi, masing-masing dalam jendela konteksnya sendiri. Ini berarti alur kerja paralel tidak bersaing untuk anggaran token yang sama, tetapi biayanya dapat berlipat ganda dengan cepat. Anthropic merekomendasikan Agent Teams untuk skenario dengan kompleksitas tinggi di mana eksekusi paralel membenarkan biayanya.
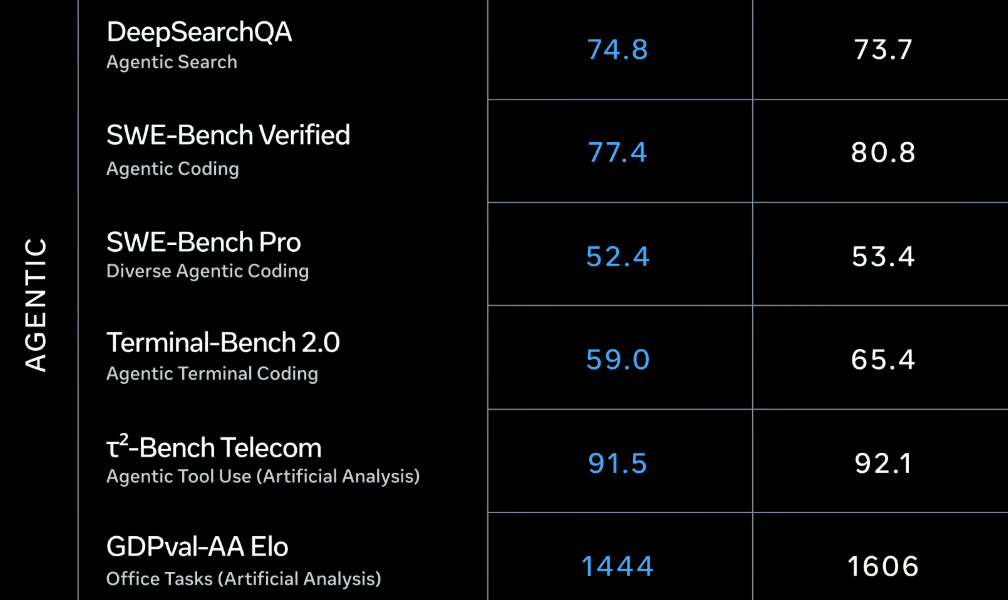
Benchmark agentik. Skor Muse Spark (Thinking) di kiri, Claude Opus 4.6 (Max) di kanan. Sumber: Meta
Secara keseluruhan, sebagian besar skor benchmark agentik cukup mirip antara kedua model, tetapi Opus 4.6 sedikit unggul atas Muse Spark. Beberapa pengamatan paling menonjol:
Kemampuan agentik Claude Opus 4.6 lebih matang dan lebih baik untuk sebagian besar tugas. Mode Contemplating Muse Spark menjanjikan tetapi masih diluncurkan secara bertahap, yang membatasi apa yang dapat benar-benar Anda bangun dengannya saat ini.
Walau ini bukan kategori klasik untuk membandingkan LLM, performa dalam skenario terkait kesehatan layak disebutkan, karena salah satu tujuan utama Muse Spark adalah to help people learn about and improve their health. Meta collaborated with over 1,000 physicians to curate medical training data on everyday health-related queries like the nutritional content of foods or muscles activated during exercise.
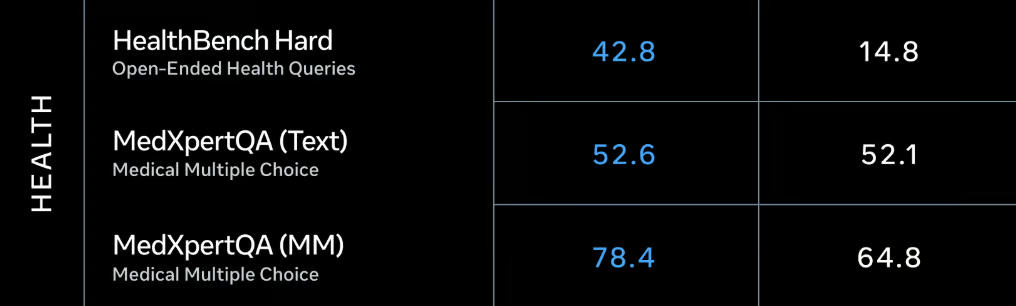
Benchmark kesehatan. Skor Muse Spark (Thinking) di kiri, Claude Opus 4.6 (Max) di kanan. Sumber: Meta
Fokus pada kesehatan tercermin pada skor masing-masing. Secara umum, tsemakin tidak terstandar pertanyaan kesehatannya, semakin terlihat perbedaan antara kedua model.
Terutama dipadukan dengan keterampilan multimodal Muse Spark, ini membuka beragam aplikasi yang sangat menarik untuk kehidupan sehari-hari. Bayangkan memotret isi kulkas Anda dan mendapatkan rencana makan yang dipersonalisasi sesuai target nutrisi mingguan Anda. Masih harus dilihat seberapa baik alat seperti ini bekerja dalam praktik, namun terdengar menjanjikan.
Kedua model bersifat proprietari dan hanya di cloud, tetapi cerita aksesnya cukup berbeda.
Muse Spark tersedia melalui meta.ai dan aplikasi Meta AI, yang keduanya memerlukan akun Meta. Ada API pratinjau privat untuk mitra perusahaan terpilih, tetapi belum ada API publik dan belum ada tanggal pasti untuk akses yang lebih luas. Meta menyatakan berharap dapat membuka sumber versi Muse di masa depan, tetapi Muse Spark sendiri bersifat tertutup tanpa opsi unduhan atau fine-tuning.
Tentang privasi: kebijakan Meta mengizinkan data percakapan digunakan untuk peningkatan model. Jika Anda bekerja dengan data sensitif, hal itu patut dipertimbangkan sebelum menyalurkannya melalui Muse Spark.
Claude Opus 4.6 tersedia melalui Claude API publik menggunakan ID model claude-opus-4-6. Model ini juga dapat diakses melalui antarmuka web Claude, Claude Code, Claude Cowork, dan aplikasi seluler Claude untuk iOS/Android. Di antarmuka web, akses dibatasi untuk pelanggan berbayar. Agent Teams bersifat eksperimental di Claude Code.
Bagi siapa pun yang membutuhkan akses API saat ini, Claude Opus 4.6 adalah satu-satunya pilihan. API pratinjau privat Muse Spark berarti sebagian besar pengembang belum dapat membangunnya, terlepas dari seberapa bagus modelnya.
Karena kekuatan dan kelemahan keduanya cukup berbeda, kita dapat dengan jelas menyarankan kasus penggunaan untuk masing-masing.
Muse Spark lebih cocok dalam serangkaian skenario spesifik, yang sebagian besar berpusat pada masukan multimodal dan efisiensi komputasi.
Satu catatan jujur: akses publik Muse Spark saat ini terbatas. Jika Anda tidak dapat masuk ke pratinjau perusahaan, Anda menggunakannya melalui meta.ai, yang baik untuk eksplorasi tetapi bukan untuk membangun alur kerja produksi.
Claude Opus 4.6 adalah pilihan yang lebih kuat bagi sebagian besar pengembang dan ilmuwan data saat ini, terutama karena model ini benar-benar dapat diakses.
Anda membutuhkan API publik dengan ID model terdokumentasi (claude-opus-4-6)
Pengkodean agentik adalah kasus penggunaan utama Anda, terutama dengan Claude Code dan Agent Teams
Anda bekerja dengan basis kode besar yang diuntungkan dari jendela konteks 1 juta token
Anda memerlukan performa kelas atas pada benchmark pengkodean
Anda menginginkan kontrol terperinci atas kedalaman penalaran melalui parameter effort
Tim Anda menggunakan PowerPoint atau Excel dan ingin AI terintegrasi langsung ke dalam alat tersebut
Fitur Agent Teams masih bersifat eksperimental, dan biaya token cepat berlipat ketika Anda menjalankan agen paralel. Namun untuk tugas pengembangan perangkat lunak yang kompleks, model eksekusi paralel benar-benar berguna, dan conversation compaction menjaga agen jangka panjang tetap pada jalurnya.
Jawaban jujurnya, kedua model ini tidak benar-benar bersaing untuk pengguna yang sama saat ini. Claude Opus 4.6 adalah model matang, dapat diakses, memimpin benchmark, dengan API publik, fitur terdokumentasi, dan integrasi nyata. Muse Spark adalah rilis pertama yang menarik secara teknis dari lab baru dengan akses publik terbatas dan lebih sedikit angka yang dipublikasikan. Kesenjangan itu bisa cepat tertutup, tetapi itulah realitas pada April 2026.
Jika Anda seorang pengembang atau ilmuwan data yang perlu membangun sesuatu hari ini, Claude Opus 4.6 adalah pilihan yang praktis. Skor benchmark pengkodean, jendela konteks 1M token, dan fitur Agent Teams di Claude Code adalah hal-hal yang benar-benar dapat Anda gunakan. Multimodalitas native dan Thought Compression milik Muse Spark benar-benar menarik, tetapi lebih sulit dievaluasi tanpa akses API yang lebih luas.
Hal yang patut diawasi dari Muse Spark adalah tugas penalaran multimodal setelah mode Contemplating sepenuhnya diluncurkan. Pendekatan multiagen paralel untuk masalah sulit adalah pertaruhan yang berbeda dari sekadar memperbesar token inferensi, dan jika klaim efisiensi Meta terbukti dalam pengujian independen, cerita biaya komputasi menjadi sangat menarik untuk beban kerja produksi.
Jika Anda tertarik mengembangkan aplikasi AI, saya sangat merekomendasikan mendaftar ke jalur keterampilan AI Engineering with LangChain. Konten pengajarannya bersifat AI-native, artinya Anda mendapatkan tutor pribadi yang mengajarkan keterampilan tepat yang Anda butuhkan untuk mulai dari level Anda hingga menjadi ahli sejati dalam merekayasa alur kerja AI.
Belajar AI bersama DataCamp
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt