{count, plural, one {Leerpad} other {Leerpaden}}
AI-engineering met LangChain
{hours} uur
Twee van de meest besproken modelreleases van begin 2026 komen uit heel verschillende hoeken. Meta’s Muse Spark is het eerste model van Meta Superintelligence Labs en een bewuste breuk met de Llama-lijn. Anthropic’s Claude Opus 4.6 verscheen eerder dit jaar als upgrade van de vlaggenschipcategorie, met een contextvenster van 1 miljoen tokens en een topscore op Terminal-Bench 2.0.
Kiezen tussen deze modellen is niet vanzelfsprekend. Muse Spark is van nature multimodaal met drie verschillende redeneermodi en een focus op reken-efficiëntie. Claude Opus 4.6 is gebouwd voor agentisch coderen, langlopende workflows en diep redeneren, met Agent Teams en adaptief denken ingebakken. Beide zijn proprietair en alleen in de cloud beschikbaar, wat het speelveld al verkleint vergeleken met open-weight-alternatieven.
In dit artikel vergelijk ik Muse Spark en Claude Opus 4.6 op zes kernpunten: architectuur en ontwerpfilosofie, redeneren en benchmarks, multimodale capaciteiten, agentische functies, toegang en beschikbaarheid, en privacy en licenties.
Wil je meer weten over de large language models (LLM’s) van Anthropic, dan raad ik onze cursus Introduction to Claude Models aan. Bekijk ook zeker onze andere vergelijking over GPT-5.4 vs Claude Opus 4.6.
Update: Kort na publicatie van dit artikel is er een nieuwe Opus-versie verschenen. Lees zeker onze gids over Claude Opus 4.7.
Muse Spark is het eerste model dat onder de Muse-familienaam is uitgebracht, oorspronkelijk met de codenaam “Avocado” tijdens de ontwikkeling. Het is gebouwd door Meta Superintelligence Labs, een divisie die Meta in juni 2025 oprichtte na een investering van naar verluidt $14,3 miljard, inclusief het aantrekken van Alexandr Wang van Scale AI. Het model lanceerde op 8 april 2026.
De belangrijkste ontwerpkeuze achter Muse Spark is een volledig opnieuw opgebouwde trainingspipeline. In plaats van de Llama-architectuur uit te breiden, begon Meta’s team opnieuw met native multimodaliteit over tekst, afbeeldingen, audio en toolgebruik. Het resultaat is een model waarvan Meta claimt dat het de prestaties van Llama 4 Maverick evenaart met een orde van grootte minder compute. Meta bracht op 2 september 2026 Muse Spark 1.3 uit.
Muse Spark biedt drie redeneermodi:
Het model is uitsluitend in de cloud beschikbaar, bereikbaar via meta.ai of de Meta AI-app, met een privé-preview-API voor geselecteerde enterprise-partners. Het drijft ook de nieuwe Muse Agent aan.
Claude Opus 4.6 is Anthropic’s nieuwste vlaggenschipmodel, begin 2026 uitgebracht als upgrade van Opus 4.5. Anthropic beschrijft het als hun slimste modelcategorie, met een focus op agentisch coderen, diep redeneren en zelfcorrectie. Het voert de Terminal-Bench 2.0-codingbenchmark aan en staat op gelijke hoogte met de koplopers in verschillende andere benchmarks, zoals BrowseComp voor informatieonderzoek.
Het opvallendste cijfer is het contextvenster van 1 miljoen tokens, momenteel in beta. Dit brengt Opus 4.6 op één lijn met Gemini 3 qua contextlengte en maakt het geschikt voor grote codebases en langlopende agentische taken. Tegelijk met het model lanceerde Anthropic Agent Teams in Claude Code, waardoor meerdere onafhankelijke Claude-instanties parallel aan één taak kunnen werken.
Claude Opus 4.6 is beschikbaar via de Claude API (model-ID: claude-opus-4-6), Claude Code en Claude in PowerPoint. Het is proprietair en alleen in de cloud beschikbaar, zonder open-weight-versie.
Zonder verdere omhaal vergelijken we beide modellen in een paar relevante categorieën.
Wil je snel een antwoord voordat je de details induikt, dan koppelt deze tabel veelvoorkomende scenario’s aan het best passende model.
| Use case | Aanbevolen | Waarom |
|---|---|---|
| Agentisch coderen met parallelle agents | Claude Opus 4.6 | Agent Teams in Claude Code, 80,8 op SWE-Bench Verified |
| Analyse van documenten met lange context | Claude Opus 4.6 | Contextvenster van 1M tokens (beta) |
| Multimodaal redeneren (tekst + afbeeldingen + audio) | Muse Spark | Native multimodaliteit vanaf de basis, visuele chain-of-thought |
| Compute-efficiënte inferentie | Muse Spark | Evenaart Llama 4 Maverick met 10x minder compute |
| Complexe wiskunde en redeneren | Claude Opus 4.6 | Betere scores op redeneerbenchmarks |
| Enterprise API-toegang | Claude Opus 4.6 | Publieke API beschikbaar; Muse Spark API is alleen privépreview |
| Extreme meerstapsredenering | Muse Spark (Contemplating) | Parallelle multi-agent-redenering; concurreert met Gemini Deep Think en GPT Pro |
| PowerPoint- en Excel-integratie | Claude Opus 4.6 | Claude in PowerPoint en Claude in Excel zijn live-integraties |
| Gezondheidsgerelateerde use cases | Muse Spark | Belangrijk sterk punt van Muse Spark: 42,8 vs. 14,8 in HealthBench Hard |
Hoe een model is gebouwd, bepaalt waar het in uitblinkt. Muse Spark en Claude Opus 4.6 weerspiegelen echt verschillende keuzes over waar frontier-AI naartoe zou moeten gaan.
Meta bouwde voor Muse Spark de trainingspipeline vanaf nul opnieuw op. Het model is van nature multimodaal, wat betekent dat tekst, afbeeldingen, audio en toolgebruik samen zijn getraind en niet achteraf zijn toegevoegd. Dit staat in direct contrast met de Llama-serie, die Meta zelf omschreef als gebaseerd op patroonherkenning.
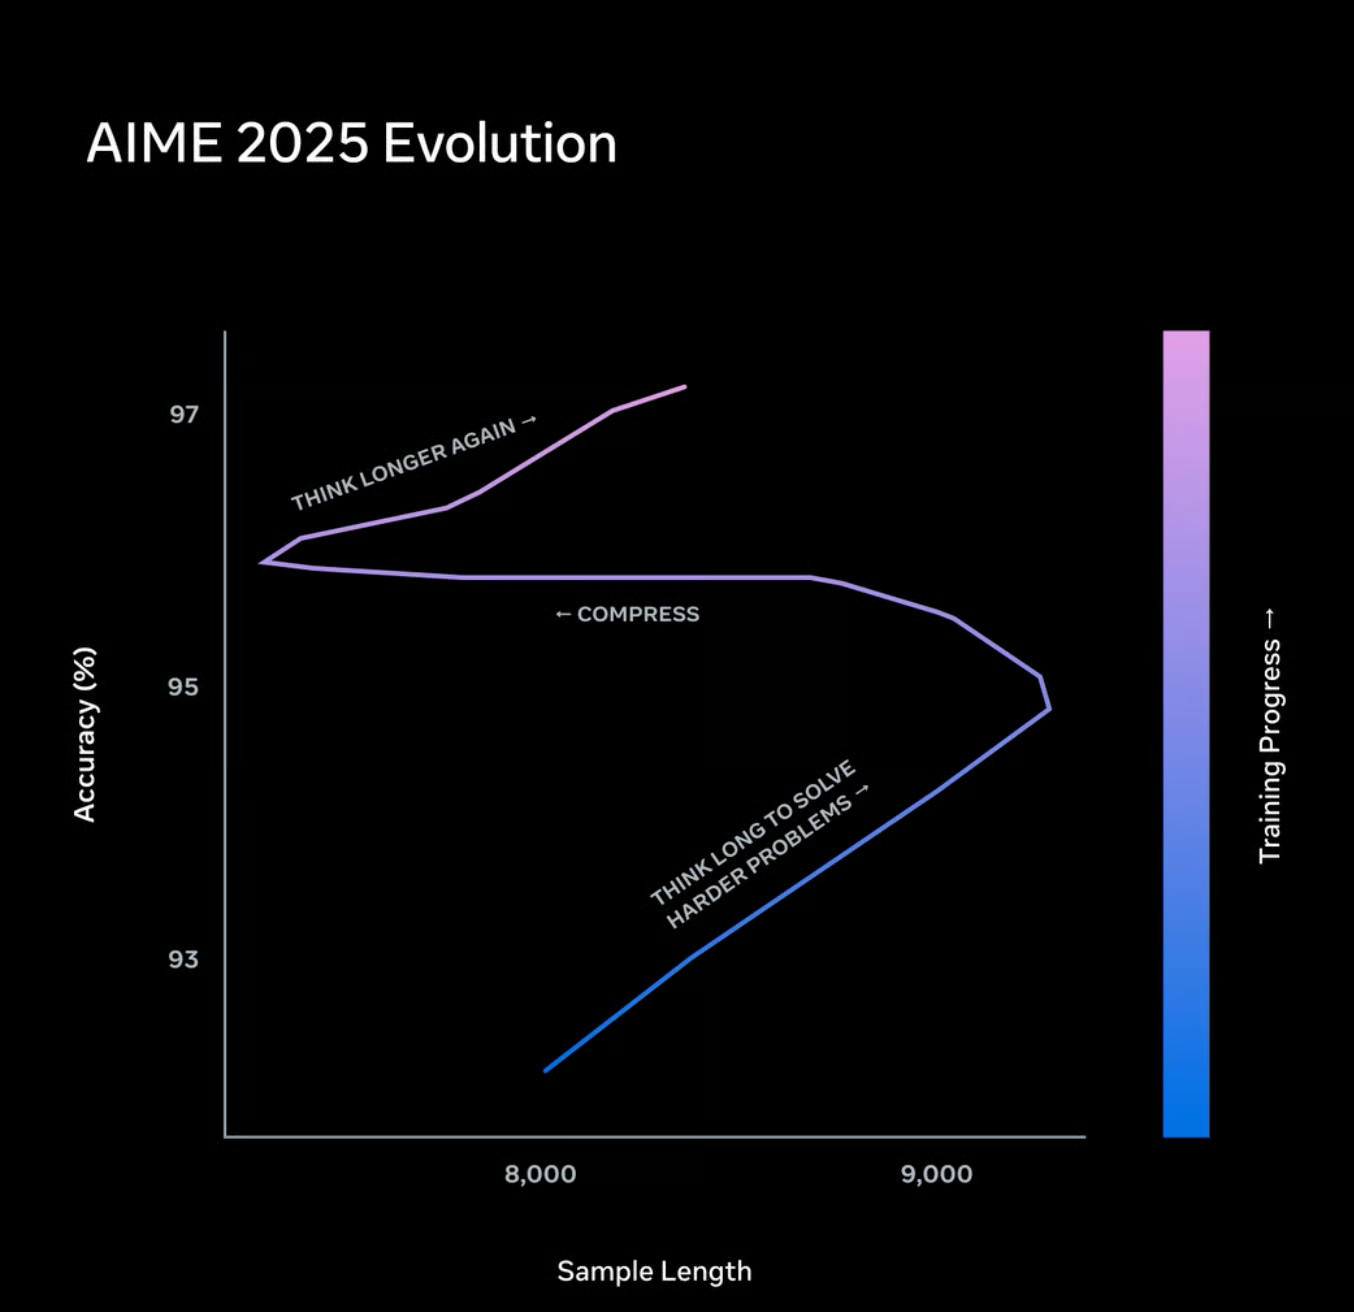
Een van de interessantere technische keuzes is Thought Compression, een reinforcement learning-techniek die buitensporige tokens tijdens het redeneren bestraft. Het doel is efficiëntie: het model wordt geduwd om goed te redeneren zonder onnodige tussentijdse stappen te genereren. Dit is deels waarom Muse Spark de prestaties van Llama 4 Maverick kan evenaren tegen een fractie van de rekenkosten.
Anthropic’s ontwerpfocus voor Opus 4.6 is volgehouden actie in plaats van eenmalige prestaties. Het model is gebouwd om zorgvuldig te plannen, coherentie over lange perioden te behouden en fouten in het eigen redeneren te identificeren. Adaptief denken laat het model bepalen of een prompt een uitgebreide chain-of-thought vereist, en de effort-parameter geeft ontwikkelaars handmatige controle over die afweging.
De effort-niveaus zijn het begrijpen waard als je de API gebruikt:
Muse Spark’s herbouwde stack is een radicalere architecturale koerswijziging, en het verhaal rond reken-efficiëntie is oprecht indrukwekkend. Claude Opus 4.6’s adaptieve denken en effort-regeling zijn direct nuttiger voor ontwikkelaars die fijne controle nodig hebben over kosten versus grondigheid.
Benchmarkcijfers zijn geen perfecte maatstaf, maar ze zijn wel het duidelijkste signaal dat we hebben om modellen te vergelijken die de meeste mensen nog niet naast elkaar hebben gedraaid.
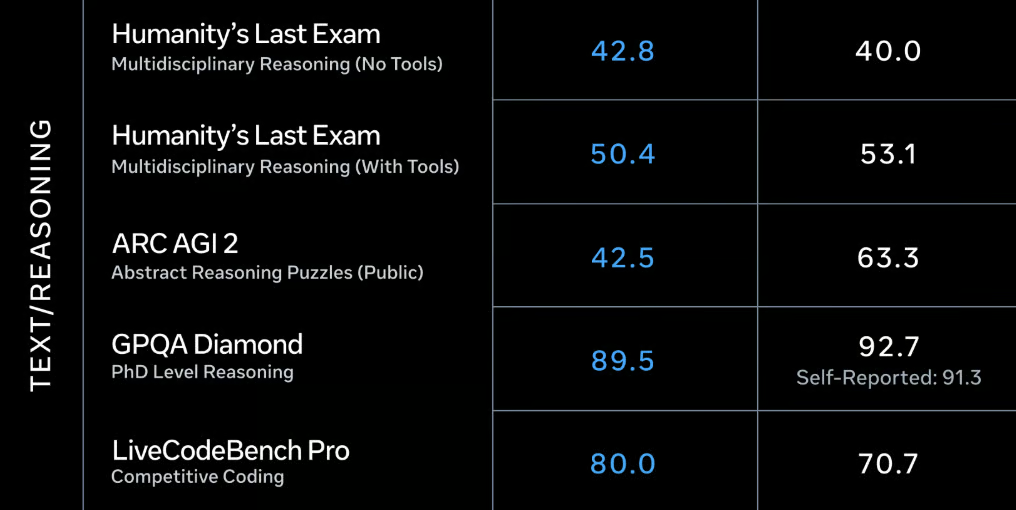
Tekst/redeneerbenchmarks. Scores van Muse Spark (Thinking) links, Claude Opus 4.6 (Max) rechts. Bron: Meta
Bij vergelijking van beide modellen in het tekst-/redeneerdomein zien we de volgende patronen:
Al met al lijkt Claude Opus 4.6 de betere keuze wanneer zeer abstract redeneren vereist is, terwijl Muse Spark gelijkwaardig presteert bij gezond verstand en domeingerelateerd redeneren.
Beide modellen kunnen meer dan tekst aan, maar de diepte van die ondersteuning verschilt aanzienlijk.
Multimodaliteit staat centraal in Muse Spark’s identiteit, niet als toevoeging. Het model is van nature gezamenlijk getraind op tekst, afbeeldingen, audio en gestructureerde data. Visuele chain-of-thought is een specifieke functie: het model kan stap voor stap redeneren door beeldgebaseerde problemen, in plaats van alleen te beschrijven wat het ziet. Toolgebruik is ook native, wat belangrijk is voor agentische workflows die externe API’s aanroepen of gestructureerde data naast ongestructureerde input verwerken.
Claude Opus 4.6 ondersteunt multimodale input, maar de onderzoeksaantekeningen beschrijven het niet als nativemultimodaal in dezelfde architecturale zin als Muse Spark. De opvallendste multimodale integratie zit aan de outputkant: Claude in PowerPoint genereert bewerkbare slide-objecten in plaats van afbeeldingen van slides, en Claude in Excel volgt formuleafhankelijkheden over werkbladen heen.
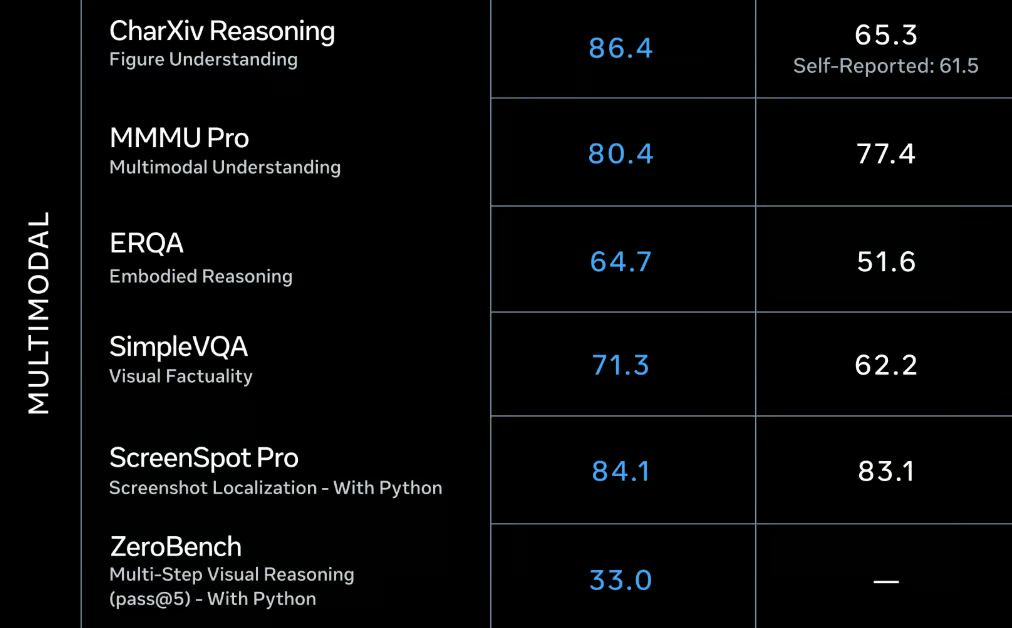
Multimodale benchmarks. Scores van Muse Spark (Thinking) links, Claude Opus 4.6 (Max) rechts. Bron: Meta
In het multimodale domein toont Muse Spark zijn kracht: het ligt voor op Claude Opus 4.6 in elke aangehaalde benchmark. De volgende resultaten zijn vooral indrukwekkend:
Voor taken die tekst, afbeeldingen en audio op modelniveau combineren, heeft Muse Spark de sterkere basis. Voor enterprise-document- en spreadsheetworkflows zijn de integraties van Claude Opus 4.6 direct praktischer.
Beide modellen zijn gepositioneerd voor agentische use cases, maar ze benaderen het probleem anders.
Muse Spark’s Contemplating-modus is zijn agentische troef. In plaats van één model dat sequentieel redeneert, start Contemplating meerdere agents parallel op, elk werkend aan een deel van een probleem, met resultaten die agents-overstijgend worden geverifieerd. Dit lijkt qua geest op Claude’s Agent Teams maar is ingebouwd in de redeneermodus zelf in plaats van als een aparte API-functie.
Agent Teams in Claude Code zijn de opvallendste agentische functie in Opus 4.6. Je kunt meerdere onafhankelijke Claude-instanties opstarten, waarbij één fungeert als hoofdcoördinator en anderen de uitvoering verzorgen, elk in hun eigen contextvenster. Dit betekent dat parallelle werkstromen niet om hetzelfde tokenbudget concurreren, maar de kosten kunnen snel oplopen. Anthropic raadt Agent Teams aan voor scenario’s met hoge complexiteit, waar parallelle uitvoering de uitgaven rechtvaardigt.
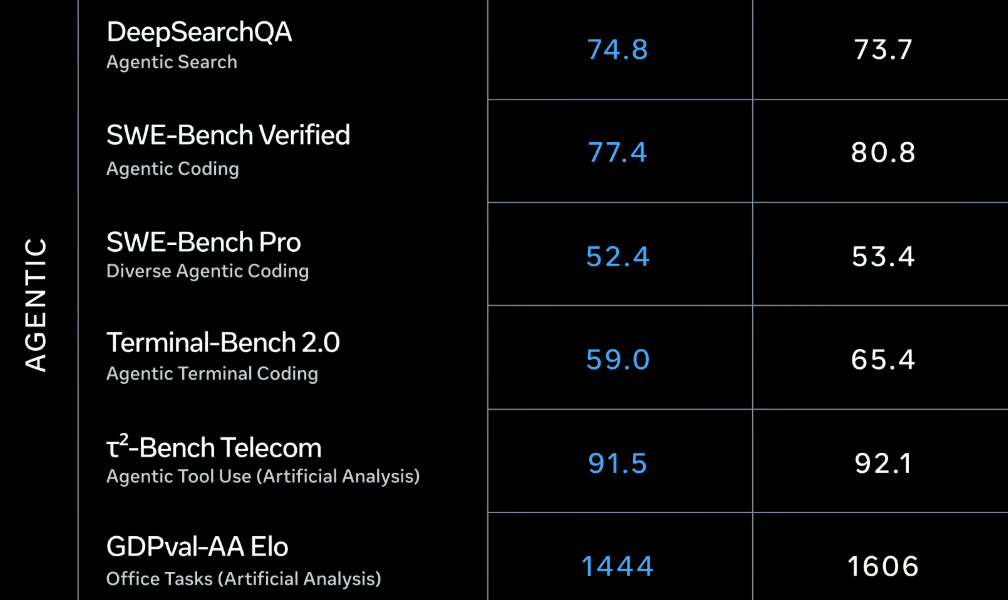
Agentische benchmarks. Scores van Muse Spark (Thinking) links, Claude Opus 4.6 (Max) rechts. Bron: Meta
Over het geheel genomen liggen de meeste agentische benchmarkscores dicht bij elkaar, maar Opus 4.6 heeft een kleine voorsprong op Muse Spark. De meest opvallende observaties:
De agentische capaciteiten van Claude Opus 4.6 zijn volwassener en beter voor de meeste taken. Muse Spark’s Contemplating-modus is veelbelovend maar wordt nog geleidelijk uitgerold, wat beperkt wat je er vandaag daadwerkelijk mee kunt bouwen.
Hoewel dit geen klassieke categorie is om LLM’s in te vergelijken, verdient de prestatie in gezondheidsgerelateerde scenario’s een eervolle vermelding, aangezien een van de belangrijkste doelen van Muse Spark is om mensen te helpen hun gezondheid te begrijpen en te verbeteren. Meta werkte samen met meer dan 1.000 artsen om medische trainingsdata te cureren over alledaagse gezondheidsvragen zoals de voedingswaarde van voedsel of welke spieren worden geactiveerd tijdens het sporten.
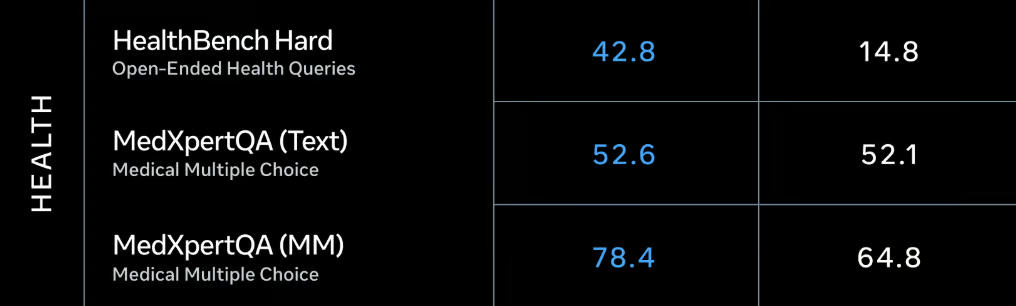
Gezondheidsbenchmarks. Scores van Muse Spark (Thinking) links, Claude Opus 4.6 (Max) rechts. Bron: Meta
De focus op gezondheid zie je terug in de respectieve scores. Als algemeen patroon geldt: hoe minder gestandaardiseerd de gezondheidsvragen zijn, hoe sterker het verschil tussen de twee modellen naar voren komt.
Vooral in combinatie met de multimodale vaardigheden van Muse Spark opent dit een reeks heel toffe toepassingen voor het dagelijks leven. Denk aan een foto van je koelkast maken en als antwoord een gepersonaliseerd weekmenu krijgen dat past bij je voedingsdoelen. Het moet nog blijken hoe goed zulke tools in de praktijk werken, maar het klinkt veelbelovend.
Beide modellen zijn proprietair en alleen in de cloud, maar het toegangsvraagstuk is behoorlijk verschillend.
Muse Spark is beschikbaar via meta.ai en de Meta AI-app, waarvoor beide een Meta-account nodig is. Er is een privé-preview-API voor geselecteerde enterprise-partners, maar geen publieke API en geen bevestigde datum voor bredere toegang. Meta heeft aangegeven toekomstige Muse-versies te willen open-sourcen, maar Muse Spark zelf is closed-source zonder download- of fine-tuningoptie.
Over privacy: het beleid van Meta staat toe dat gespreksdata worden gebruikt voor modelverbetering. Als je met gevoelige data werkt, is het verstandig dat mee te nemen in je overweging voordat je het via Muse Spark laat lopen.
Claude Opus 4.6 is beschikbaar via de publieke Claude API met de model-ID claude-opus-4-6. Het is ook toegankelijk via de Claude web-UI, Claude Code, Claude Cowork en de Claude mobiele apps voor iOS/Android. Op de web-UI is de toegang beperkt tot betalende abonnees. Agent Teams zijn experimenteel in Claude Code.
Voor iedereen die vandaag API-toegang nodig heeft, is Claude Opus 4.6 de enige optie. De privé-preview-API van Muse Spark betekent dat de meeste ontwikkelaars er nog niet mee kunnen bouwen, ongeacht hoe goed het model is.
Omdat de sterke en zwakke punten van beide modellen vrij verschillend zijn, kunnen we duidelijk use cases voor elk aanreiken.
Muse Spark past beter bij een specifieke set scenario’s, die vooral draaien om multimodale input en reken-efficiëntie.
Eerlijke kanttekening: de publieke toegang tot Muse Spark is momenteel beperkt. Als je niet in de enterprise-preview komt, gebruik je het via meta.ai, wat prima is om te verkennen maar niet om productie-workflows op te bouwen.
Claude Opus 4.6 is vandaag de sterkere keuze voor de meeste ontwikkelaars en data scientists, vooral omdat het daadwerkelijk toegankelijk is.
Je hebt een publieke API nodig met een gedocumenteerde model-ID (claude-opus-4-6)
Agentisch coderen is je primaire use case, vooral met Claude Code en Agent Teams
Je werkt met grote codebases die baat hebben bij een contextvenster van 1 miljoen tokens
Je hebt topprestaties nodig op codingbenchmarks
Je wilt fijnmazige controle over de diepte van redeneren via de effort-parameter
Je team gebruikt PowerPoint of Excel en wil AI direct in die tools geïntegreerd
De Agent Teams-functie is nog experimenteel, en de tokenkosten lopen snel op wanneer je parallelle agents draait. Maar voor complexe softwareontwikkelingstaken is het parallelle uitvoeringsmodel echt nuttig, en conversatiecompactie houdt langlopende agents op koers.
Eerlijk gezegd vissen deze twee modellen op dit moment niet naar dezelfde gebruikers. Claude Opus 4.6 is een volwassen, toegankelijk, benchmarkleidend model met een publieke API, gedocumenteerde functies en echte integraties. Muse Spark is een technisch interessante eerste release van een nieuw lab met beperkte publieke toegang en minder gepubliceerde cijfers. Dat gat kan snel dichten, maar dit is de realiteit in april 2026.
Als je vandaag iets moet bouwen als ontwikkelaar of data scientist, is Claude Opus 4.6 de praktische keuze. De codingbenchmarkscores, het contextvenster van 1M tokens en de Agent Teams-functie in Claude Code zijn stuk voor stuk dingen die je daadwerkelijk kunt gebruiken. Muse Spark’s native multimodaliteit en Thought Compression zijn oprecht interessant, maar lastiger te beoordelen zonder bredere API-toegang.
Waar ik Muse Spark nauwlettend in de gaten zou houden, is bij multimodale redeneertaken zodra Contemplating-modus volledig is uitgerold. De parallelle multi-agent-aanpak voor moeilijke problemen is een andere keuze dan simpelweg meer inferentietokens schalen, en als Meta’s efficiëntieclaims standhouden bij onafhankelijke tests, wordt het compute-kostenverhaal zeer aantrekkelijk voor productie-workloads.
Als je geïnteresseerd bent in het ontwikkelen van AI-toepassingen, raad ik je ten zeerste aan je in te schrijven voor onze AI Engineering with LangChain skill track. De lesstof is AI-native, wat betekent dat je een persoonlijke tutor krijgt die je precies de vaardigheden bijbrengt die je nodig hebt om vanaf jouw niveau uit te groeien tot een echte pro in het ontwerpen van AI-workflows.
Leer AI met DataCamp
{count, plural, one {Leerpad} other {Leerpaden}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {Cursus} other {Cursussen}}
{count, plural, one {blog} other {blogs}}
Adel Nehme
15 min