{count, plural, one {Program} other {Program}}
Kecerdasan Buatan untuk Rekayasa Perangkat Lunak
{hours} jam
Anthropic telah merilis Claude Opus 4.7, iterasi terbaru dari tier model andalannya. Peningkatan utama adalah otonomi: Anthropic memosisikannya sebagai model yang dapat Anda serahkan untuk pekerjaan pengkodean dan agen yang paling sulit dan berjalan lama tanpa pengawasan ketat.
Dalam rilis ini, kita juga mengetahui bahwa ada plafon di atas Opus 4.7. Mythos Preview internal Anthropic mencetak nilai lebih tinggi pada beberapa tolok ukur, namun ditahan dari rilis luas sementara Anthropic menguji pengaman siber. Bagi siapa pun yang bukan peneliti internal Anthropic, Opus 4.7 adalah plafon saat ini.
Di artikel ini, kami akan mengulas hal-hal yang benar-benar baru di Opus 4.7, menelusuri hasil tolok ukur, dan membagikan pengujian langsung yang bisa Anda jalankan sendiri. Anda juga dapat melihat panduan kami untuk model kompetitor yang baru dirilis, seperti Muse Spark dari Meta, nAI's GPT-5.5, dan Gemini 3.1 dari Google.
Pembaruan: Pada 28 Mei 2026, Anthropic merilis model penerusnya. Baca selengkapnya di panduan Claude Opus 4.8 kami.
Claude Opus 4.7 adalah model bahasa besar andalan terbaru dari Anthropic, berada di puncak keluarga model Claude di atas Sonnet dan Haiku. Model ini merupakan penerus Claude Opus 4.6 dan dirancang untuk tugas yang paling menuntut, seperti alur kerja agen yang kompleks dan tugas penalaran multi-langkah yang memerlukan kinerja berkelanjutan dalam sesi panjang.
Dibandingkan dengan Opus 4.6, rilis 4.7 berfokus pada tiga area:
Mythos Preview internal Anthropic, yang kami sebutkan sebelumnya dan juga kami bahas di FAQ, memimpin pada beberapa tolok ukur, namun belum tersedia luas. Opus 4.7 pada dasarnya adalah model saudara yang dilatih dengan kapabilitas keamanan siber yang sengaja dikurangi.
Anthropic melaporkan bahwa beberapa area kapabilitas mengalami peningkatan signifikan di Opus 4.7.
Opus 4.7 mengikuti instruksi lebih ketat daripada model sebelumnya. Ini tentu membantu untuk alur kerja apa pun yang bergantung pada keandalan, namun juga dapat menimbulkan konsekuensi tak terduga: Anthropic mendorong pengguna untuk menyetel ulang prompt dan harness mereka, karena instruksi yang sebelumnya dilewati atau ditafsirkan longgar oleh model lama kini akan diikuti secara harfiah.
Visi untuk resolusi tinggi ditingkatkan untuk mendukung gambar hingga 3,75 megapiksel, lebih dari tiga kali lipat dari yang diterima model lama. Agen penggunaan komputer dan alur kerja ekstraksi data berpotensi sangat diuntungkan dari tingkat detail yang lebih tinggi ini, karena keduanya bergantung pada keterbacaan dan ketepatan, terkadang hingga level piksel.
Opus 4.7 lebih baik dalam memori berbasis sistem berkas, yaitu pola di mana model menulis catatan ke berkas saat bekerja dan membacanya kembali pada sesi berikutnya.
Claude Code adalah konteks yang paling jelas untuk ini: sebuah berkas CLAUDE.md di direktori root proyek yang dibaca Claude saat sesi dimulai, diperbarui seiring keputusan dibuat, dan digunakan ketika Anda kembali bekerja.
"Lebih baik" di sini berarti penilaian yang lebih baik tentang apa yang perlu ditulis dan daya ingat yang lebih andal pada putaran selanjutnya. Anthropic mengatakan ini membuat tugas baru "memerlukan lebih sedikit konteks di awal" — yang, jika Anda pernah menjelaskan ulang konvensi proyek Anda ke model untuk kelima kalinya, seperti kami, Anda akan menghargainya.
Jadi, intinya: Jika Anda menggunakan Opus 4.7 untuk pekerjaan multi-sesi, biarkan ia menyimpan catatan. Ia akan melakukannya lebih baik daripada Opus 4.6, meskipun menurut kami Opus 4.6 sudah cukup baik dalam menyimpan catatan.
Anthropic memberi tahu kami bahwa Claude Opus 4.7 mengalami peningkatan signifikan di area berikut.
Kami membuat beberapa pengujian sendiri untuk menguji klaim mereka.
Untuk menguji kepatuhan instruksi Opus 4.7, kami menggunakan prompt rinci berikut untuk mengujinya. Terdapat 12 batasan berbeda yang bisa kami cek di akhir.
You are writing a short briefing document for a new employee at a mid-sized accounting firm. Follow every instruction below.
Write a briefing about the firm's approach to client onboarding. The briefing must meet all of the following requirements:

The briefing must be exactly 4 paragraphs long.
-The second paragraph must begin with the word "Historically".
-Each paragraph must contain between 3 and 5 sentences. No paragraph may have fewer than 3 or more than 5.
-Do not use the words "streamline", "leverage", "robust", or "synergy" anywhere in the document.
-Include exactly two direct quotes from fictional senior partners. Attribute each quote to a named partner. Do not include any other quoted material.
-One of the partners quoted must have a surname that starts with the letter M.
-End the document with a single-sentence closing line on its own, separated from the fourth paragraph by a blank line. This closing line does not count toward the 4-paragraph requirement.
-The closing line must be a question.
-Use British English spelling throughout (e.g., "organisation", "colour", "realise").
-Do not use any bullet points, numbered lists, or headings.
-Mention a specific fictional client name exactly once, and italicise it using markdown asterisks.
-The total word count of the briefing, including the closing line, must be between 280 and 320 words. Do not include any preamble, explanation, or commentary before or after the briefing. Output only the briefing itself.
Dan berikut hasilnya:
Welcome to Harding & Whitcombe, where client onboarding is treated as the foundation of every successful long-term engagement. Our approach centres on understanding the organisation behind the numbers before any technical work begins, which means the first two weeks are devoted almost entirely to listening. New clients are assigned a dedicated onboarding lead who coordinates introductions across tax, audit, and advisory teams. This structure ensures that every colleague touching the account shares a consistent understanding of the client's priorities and sensitivities.

Historically, the firm operated a more transactional model, with onboarding handled piecemeal by whichever partner had signed the engagement letter. That changed in 2014, when senior leadership recognised that our competitors were winning work on relationships rather than fees alone. As Helena Marchbanks, our managing partner, often reminds new hires, "A client who feels understood in week one rarely questions the invoice in month six." The revised approach has measurably improved retention and referral rates across every service line.

In practical terms, you will be expected to attend the initial discovery meeting for any client you support, even in a purely observational capacity. You should familiarise yourself with the client's sector, recent filings, and any public commentary from their leadership before that first conversation. When we onboarded Thornbury Mills Ltd last spring, the junior associate who had read three years of their annual reports was the one who spotted the inventory anomaly that shaped our entire advisory brief. Preparation of that depth is the standard we expect, not the exception.

You will also notice that we emphasise candour from the outset, particularly around scope and realistic timelines. "We would rather lose a pitch than promise something we cannot deliver," says Rupert Castellane, head of our advisory practice, and that philosophy colours every onboarding conversation. Take the time to ask questions, observe the senior partners in action, and recognise that trust accumulates slowly but pays compounding dividends.

Are you ready to meet your first client?
Sekarang saatnya memberi skor. Berikut rubrik kami:
|
# |
Kendala |
Cara memeriksa |
|
1 |
Tepat 4 paragraf (plus baris penutup) |
Hitung jeda paragraf |
|
2 |
Paragraf 2 dimulai dengan "Historically" |
Lihat kata pertama |
|
3 |
Setiap paragraf memiliki 3–5 kalimat |
Hitung kalimat per paragraf |
|
4 |
Tidak ada kata terlarang |
Ctrl+F untuk masing-masing |
|
5 |
Tepat 2 kutipan, keduanya diatribusikan, tidak ada materi kutipan lain |
Hitung tanda kutip |
|
6 |
Salah satu nama belakang partner dimulai dengan M |
Periksa atribusi |
|
7 |
Baris penutup dipisahkan oleh baris kosong |
Pemeriksaan visual |
|
8 |
Baris penutup berupa pertanyaan |
Diakhiri dengan "?" |
|
9 |
Ejaan British |
Ctrl+F untuk "organization", "color", "realize", dll. |
|
10 |
Tidak ada bullet, angka, heading |
Pemeriksaan visual |
|
11 |
Klien fiksi disebutkan sekali, ditulis miring |
Ctrl+F untuk tanda bintang |
|
12 |
Jumlah kata 280–320 |
Tempel ke penghitung kata |
Kami akan menghemat waktu Anda untuk menelusurinya. Model tersebut mendapat 11/12.
Awalnya hasilnya sempurna, namun pada akhirnya melewati batas jumlah kata sedikit saja (325 kata, dan batas 320 kata).
Kami menerapkan tes yang sama pada Claude Sonnet 4.6, dan ia juga memenuhi 11/12 instruksi, dengan kegagalan di tempat yang sama (jumlah kata). Namun kami tetap menganggap Opus 4.7 sebagai peningkatan karena Sonnet 4.6 melewati batas jauh sekali (400 kata).
Untuk tes kedua, kami memberi Opus 4.7 sebuah gambar yang sulit dibaca:
You are analysing a degraded image that may be blurry, low-resolution,
or otherwise difficult to read. Your job is to extract as much accurate
information as possible.

Complete all of the following tasks. Do not include any preamble,
explanation, or commentary. Output only the requested deliverable.

1. Describe what type of document or visualisation this appears to be
   (e.g. bar chart, dashboard, table, report page). State your confidence
   as High, Medium, or Low.

2. List every number you can make out, however partial. For each one,
   state what you believe it refers to and your confidence (High, Medium,
   or Low). If a number is ambiguous between two readings (e.g. could be
   138 or 188), state both possibilities.

3. List every piece of text you can make out — titles, labels, legends,
   footnotes — quoted as precisely as possible. Where a word or character
   is unclear, use [?] to mark the uncertain character, e.g. "Re[?]enue".

4. Describe the layout: how many distinct sections or panels are visible,
   and what does each appear to contain?

5. State what you believe the overall subject or story of the image is,
   in one sentence of no more than 25 words. Flag if your confidence is
   Low.

6. List anything you attempted to read but could not make out at all.
Bersama instruksi ini, kami memberikan Opus 4.7 tangkapan layar terdegradasi dari bagan perdagangan Skotlandia tahun 1786 karya Playfair, yang kami ambil dari artikel kami tentang Contoh Visualisasi Data.
Kami tahu kami bisa memvalidasi keluarannya karena kami memiliki versi resolusi lebih tinggi dari Wikipedia. Berikut gambar yang dilihat Opus 4.7:
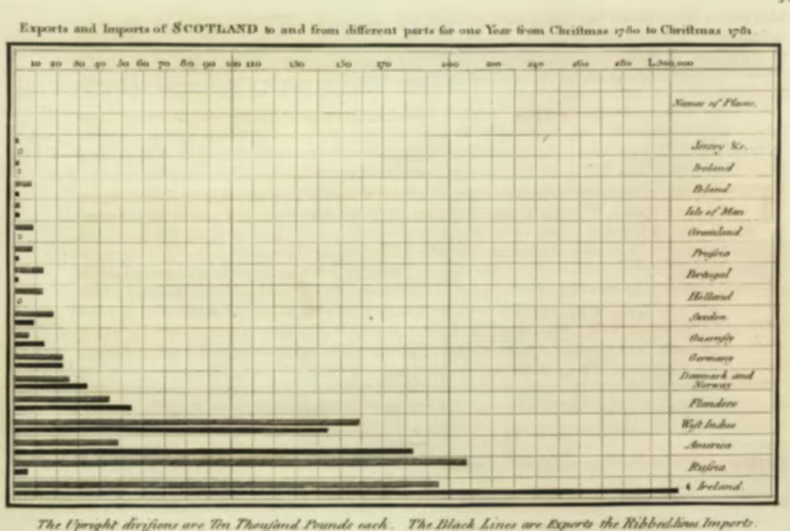
Berikut pembacaan Opus 4.7:
Type: Horizontal bar chart, antique engraving. Confidence: High.

Numbers: X-axis ticks: 10, 20, 30…110, 130, 150, 170, 200, 220, 240, 260, 280, L.300,000 (High, but 130/220 uncertain).

Years "1780" and "1781" in title (High). "Ten Thousand Pounds" per division (High).

Title: "Exports and Imports of SCOTLAND to and from different parts for one Year from Christmas 1780 to Christmas 1781"

Header: "Names of Places"

Places: Jersey &c., Ireland, [?]oland, Isle of Man, Gr[oe]nland, Prussia, Portugal, Holland, Sweden, Guernsey, Germany, Denmark and Norway, Flanders, West Indies, America, Russia, Ireland (duplicate?)

Footnote: "The Upright divisions are Ten Thousand Pounds each. The Black Lines are Exports the Ribbed lines Imports."

Layout: Single panel — title, plot area with ~16 paired bars, right-hand place-name column, footnote below.

Subject: A 1780–81 trade chart showing Scotland's exports and imports by partner. Confidence: High.

Couldn't read: Top-right corner mark; exact bar values; first letter of "[?]oland"; whether bottom "Ireland" is a duplicate.
Kami tahu tes ini bisa jadi rumit, karena sumbu-x bagan Playfair memang beralih cara menghitung di tengah (setiap 10 hingga 110, lalu puluhan ganjil 130/150/170, lalu puluhan genap 200/220/240/260/280). Namun Opus 4.7 membaca sumbu tersebut dengan benar pada percobaan pertama meskipun tidak lazim.
Satu hal yang masih terasa lucu: Kami tahu kami menyukai saat model AI menunjukkan ketidakpastiannya, tetapi “[?]oland" seharusnya bisa dibaca yakin sebagai “Poland" dan "Gr[oe]nland" seharusnya “Greenland.” Meskipun kami tidak memiliki rubrik resmi untuk ini, kami cukup adil memberi nilai 9/10.
Opus 4.7 dievaluasi pada 14 tolok ukur yang mencakup pengodean, penalaran, penggunaan alat, penggunaan komputer, dan penalaran visual. Tabel di bawah menunjukkan perbandingan lengkap dengan Opus 4.6, GPT 5.4, Gemini 3.1 Pro, dan Mythos Preview yang belum dipublikasikan.
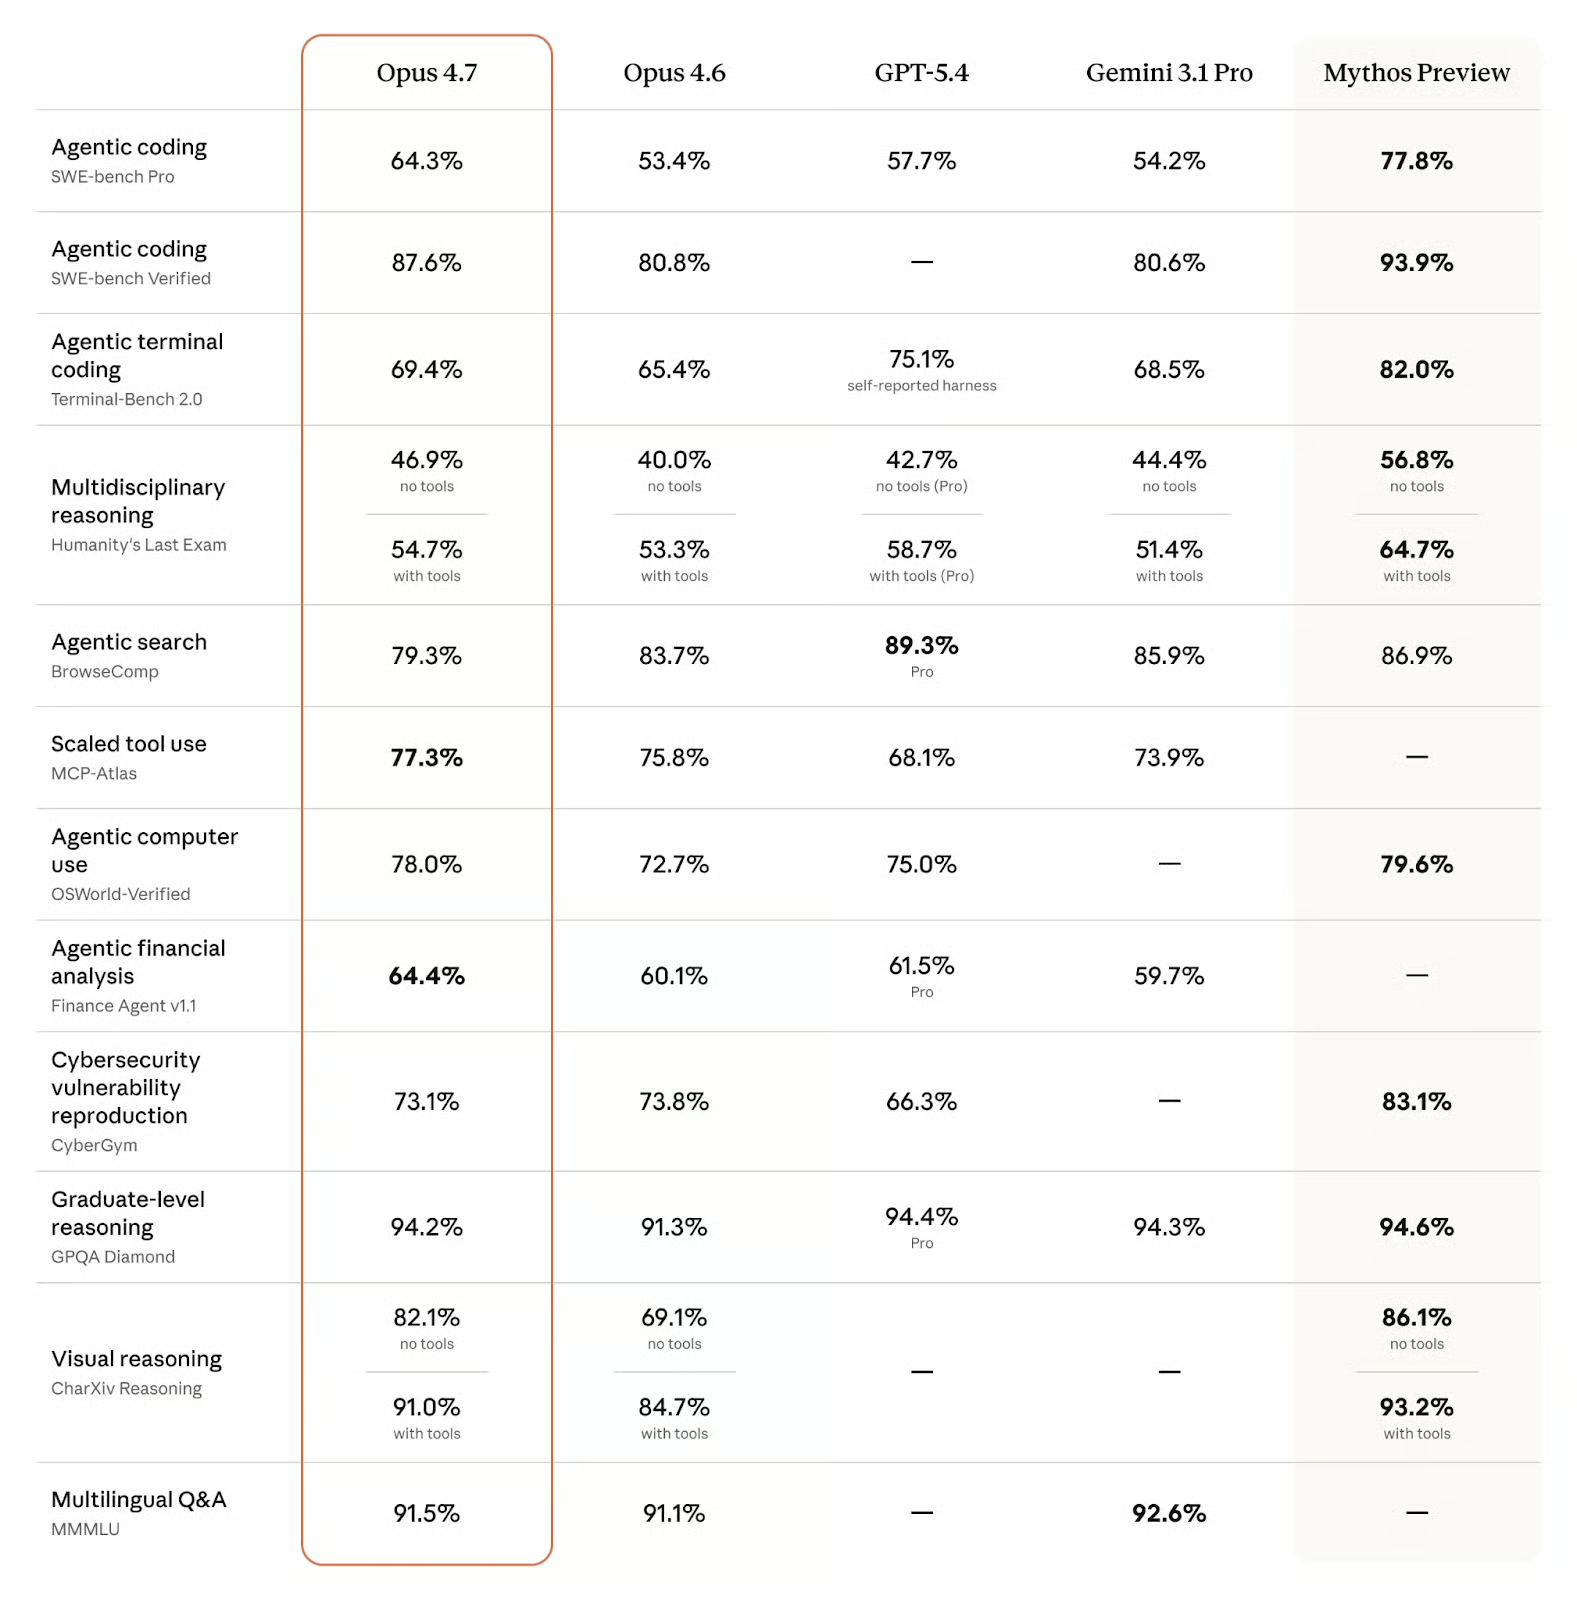
Pada SWE-bench Pro, Opus 4.7 mencetak 64,3%, di depan GPT-5.4 dengan 57,7%, Gemini 3.1 Pro 54,2%, dan Opus 4.6 53,4%. Pada SWE-bench Verified, Opus 4.7 mencapai 87,6% dibanding 80,6% milik Gemini 3.1 Pro dan 80,8% milik Opus 4.6. GPT-5.4 tidak memiliki skor yang dipublikasikan di SWE-bench Verified dalam perbandingan ini.
SWE-bench menguji kemampuan model untuk menyelesaikan isu GitHub nyata di repositori Python open-source. Pro adalah varian yang lebih sulit dengan isu yang lebih kompleks. Kenaikan 10,9 poin dibanding Opus 4.6 pada SWE-bench Pro adalah peningkatan terbesar dalam rilis ini (secara persentase poin) dan menempatkan Opus 4.7 jelas di depan dua kompetitor utama pada tugas ini.
Hanya Mythos Preview internal Anthropic yang mencetak 77,8% pada SWE-bench Pro dan 93,9% pada SWE-bench Verified, menunjukkan masih ada ruang di atas Opus 4.7. Namun Mythos belum tersedia luas, jadi untuk penggunaan produksi, Opus 4.7 adalah plafon saat ini.
Hasil pada Terminal-Bench 2.0, yang merupakan tolok ukur andalan untuk pengodean agen di terminal, cukup menarik. Opus 4.7 sedikit meningkat dibanding pendahulunya (69,4% vs. 65,4%) dan menyalip Gemini 3.1 Pro yang mencetak 68,5%.
Meski begitu, ia belum bisa menyaingi GPT-5.4 (75,1%) dalam hal ini, meskipun catatan kehati-hatian yang dilaporkan sendiri pada skor GPT-5.4 patut diingat saat membandingkan. Namun, ini mungkin mengecewakan bagi Anthropic bahwa model andalan terbarunya (yang dirilis) tidak memuncaki tolok ukur yang sentral untuk pengembangan perangkat lunak berbasis agen.
Humanity's Last Exam adalah kumpulan pertanyaan tingkat pascasarjana di bidang sains, matematika, dan humaniora, yang dirancang sulit untuk model frontier saat ini. Opus 4.7 memimpin varian tanpa alat, yang menguji penalaran murni tanpa pengambilan eksternal. Kesenjangan pada varian dengan alat yang menguntungkan GPT-5.4 (58,7%) adalah area paling jelas di mana Opus 4.7 (54,7%) tidak memimpin.
Penalaran tingkat pascasarjana biasanya diukur dengan GPQA-Diamond, yang kini cukup jenuh: Seperti semua model frontier saat ini, keempat model yang dibandingkan mencapai skor di atas 90% dan pada dasarnya seri.
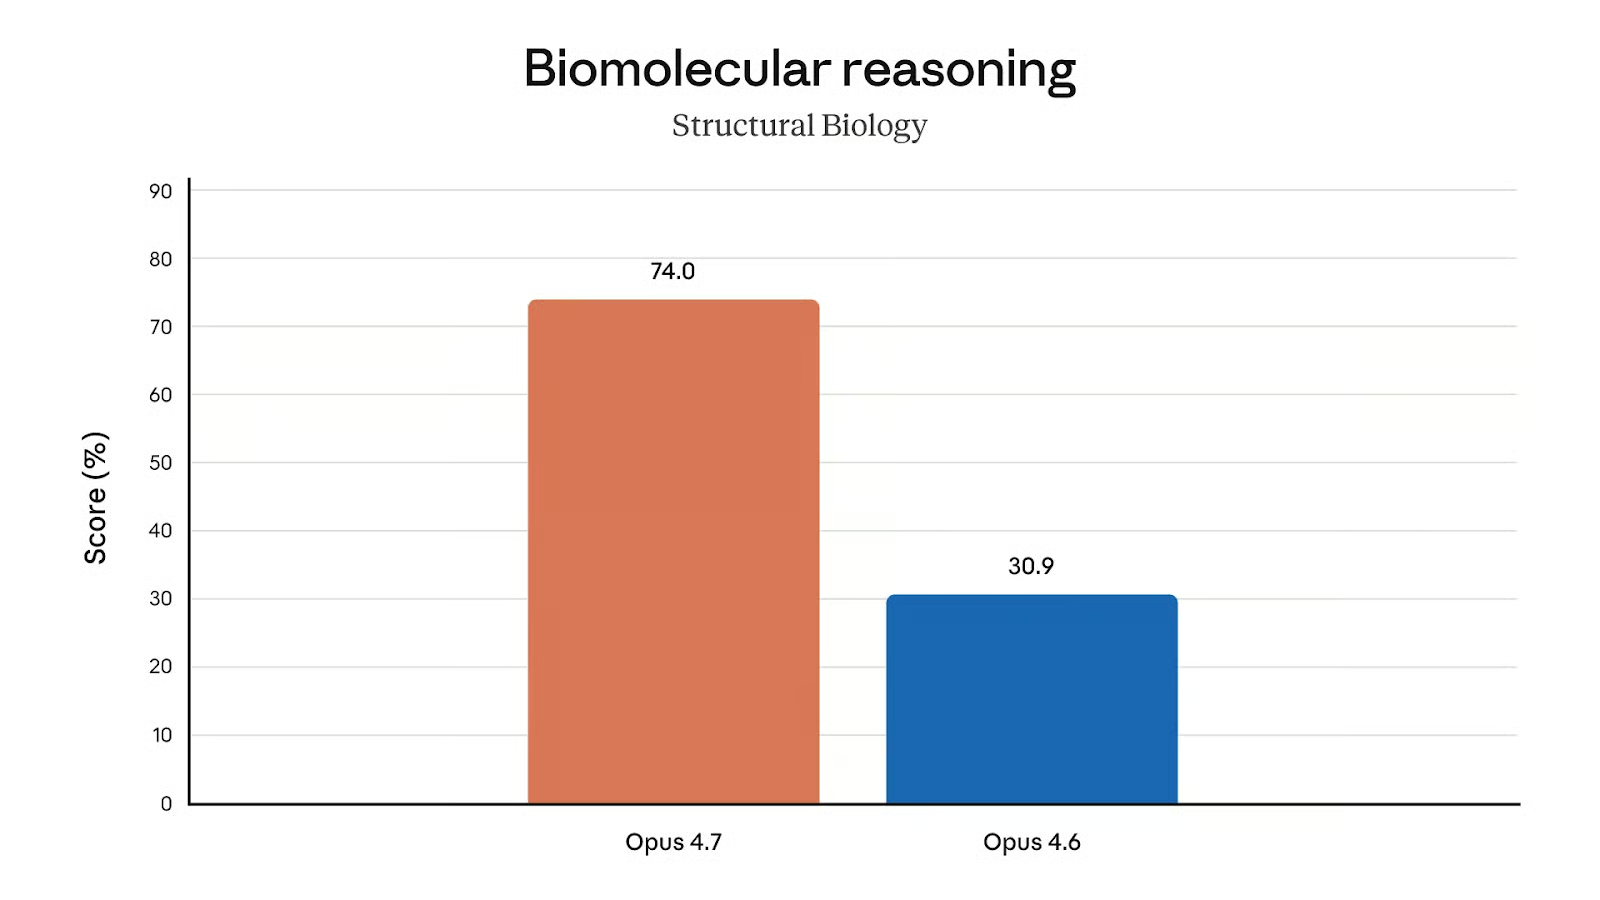
Hasil tolok ukur yang lebih menarik menargetkan biologi, salah satu bidang yang juga diuji di GPQA-Diamond. Meski kami tidak dapat membandingkannya dengan model kompetitor, lompatan antara Opus 4.6 (30,9%) dan Opus 4.7 (74,0%) jelas patut dicatat!
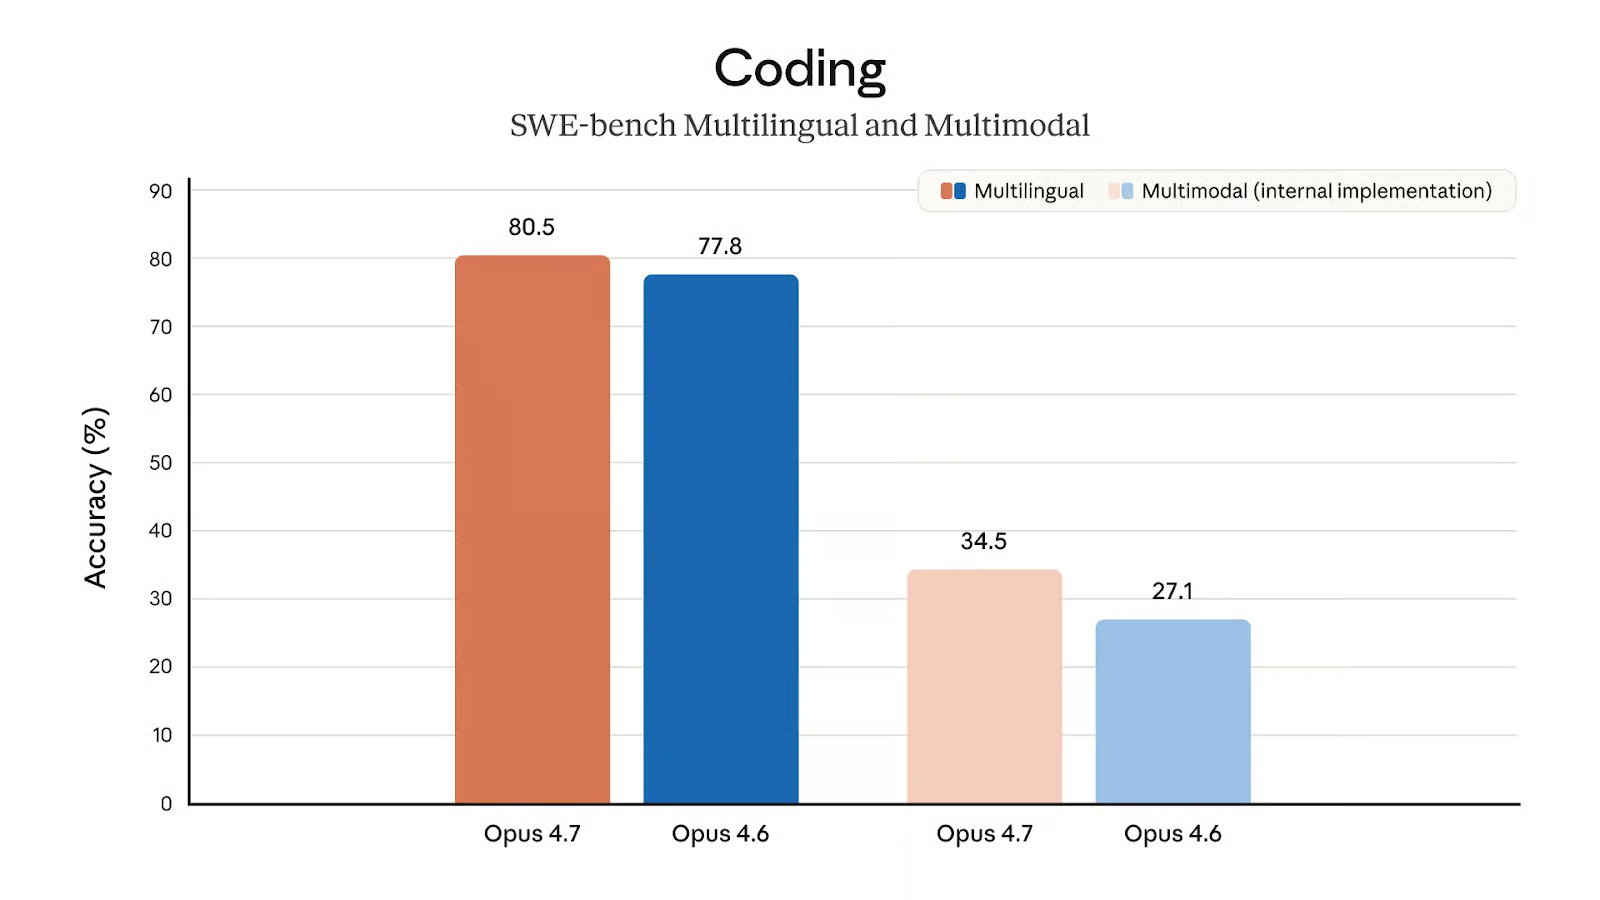
Hasil pada tolok ukur CharXiv, yang mengukur penalaran visual tentang bagan dan figur ilmiah, mencerminkan bahwa ini adalah salah satu area fokus utama dalam pengembangan Opus 4.7.
Peningkatan 13 poin tanpa alat adalah kenaikan relatif terbesar pada rilis ini. Tanpa skor kompetitor untuk dibandingkan, sulit mengatakan posisi Opus 4.7 di bidang yang lebih luas untuk tugas ini, tetapi peningkatan dibanding Opus 4.6 sangat substansial.
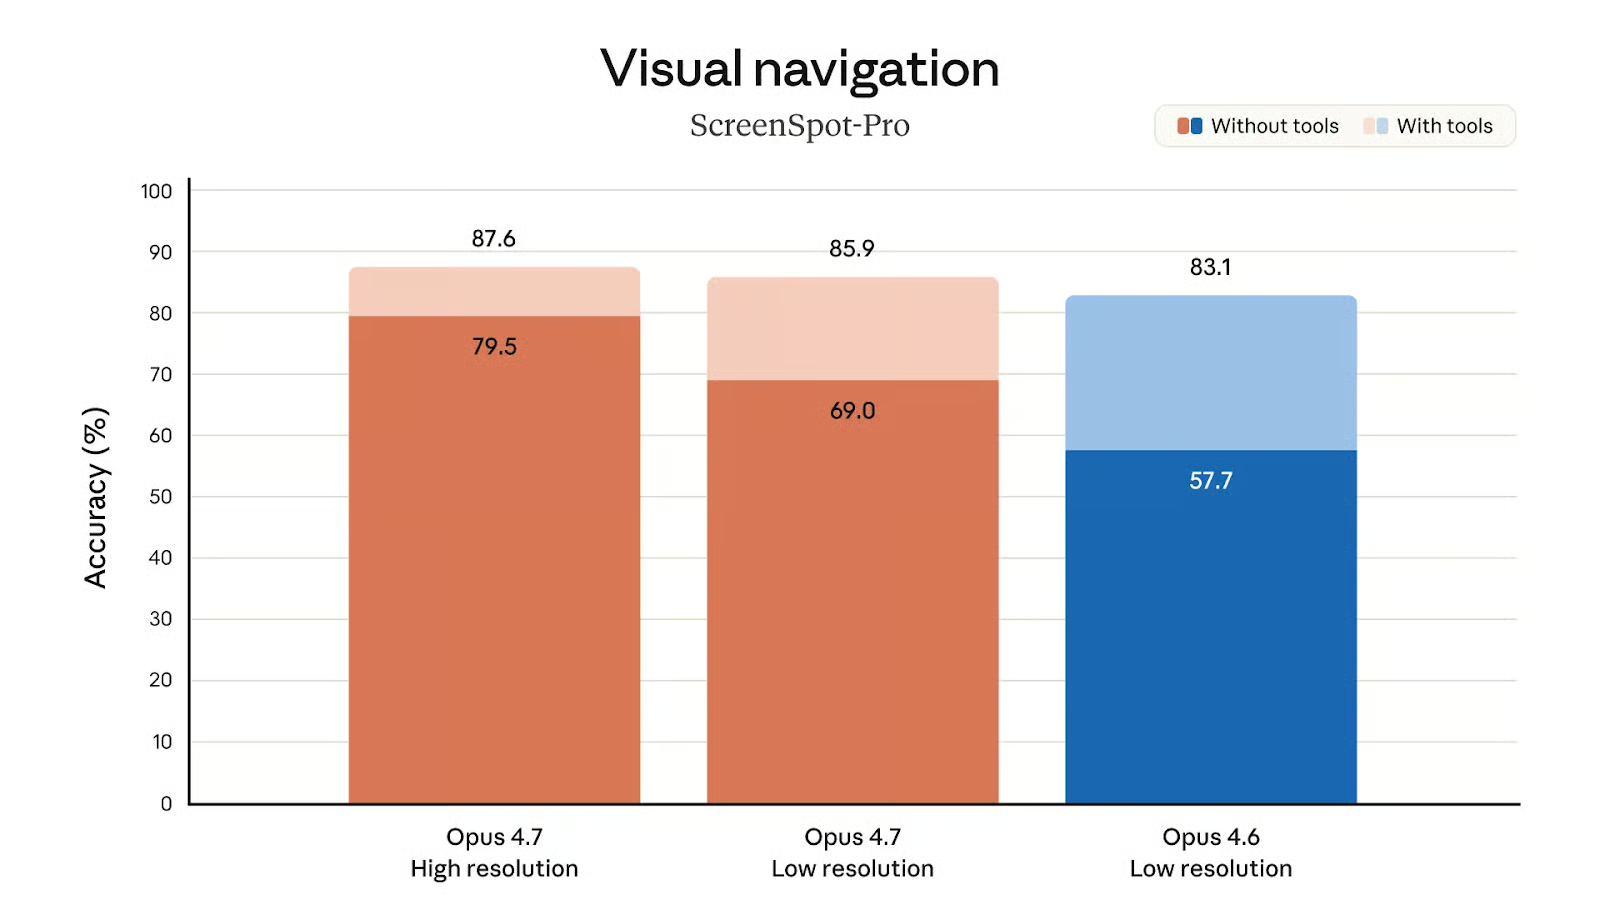
Dukungan untuk gambar beresolusi lebih tinggi kemungkinan menjadi salah satu alasan peningkatan penalaran visual. Grafik skor Screenspot-Pro pada berbagai resolusi menunjukkan lonjakan akurasi yang besar pada Opus 4.7 dari resolusi yang lebih tinggi, terutama tanpa penggunaan alat (79,5% vs. 69,0%).
MCP-Atlas menguji kinerja pada alur kerja multi-alat yang kompleks. Opus 4.7 mencetak 77,3% di sini, tertinggi dari model mana pun dalam perbandingan. Satu-satunya model yang sedikit melampaui skor MCP-Atlas Opus 4.7 adalah Muse Spark, yang dilaporkan 78,3%.
OSWorld menguji kemampuan model untuk menyelesaikan tugas dengan mengendalikan antarmuka komputer, mengklik, mengetik, dan menavigasi aplikasi. Opus 4.7 mencetak 78,0%, naik dari 72,7% pada Opus 4.6. GPT-5.4 mencetak 75,0%, dan Gemini 3.1 Pro tidak memiliki skor yang dipublikasikan pada tolok ukur ini. Mythos Preview mencetak 79,6%, sedikit di atas Opus 4.7.
Ini jelas salah satu area di mana Opus 4.7 unggul: Ia memimpin MCP-Atlas dan OSWorld-Verified dengan selisih yang berarti dibanding model andalan kompetitor dari Google dan OpenAI, yang merupakan hasil kuat bagi siapa pun yang membangun sistem agen produksi yang mengandalkan orkestrasi alat dan agen penggunaan komputer.
Kemampuan analisis keuangan model ini layak mendapat sebutan terhormat: Opus 4.7 berada di puncak papan peringkat Finance Agent v1.1 (64,4%), secara signifikan di depan GPT-5.4 (61,5%) dan Gemini 3.1 Pro (59,7%).
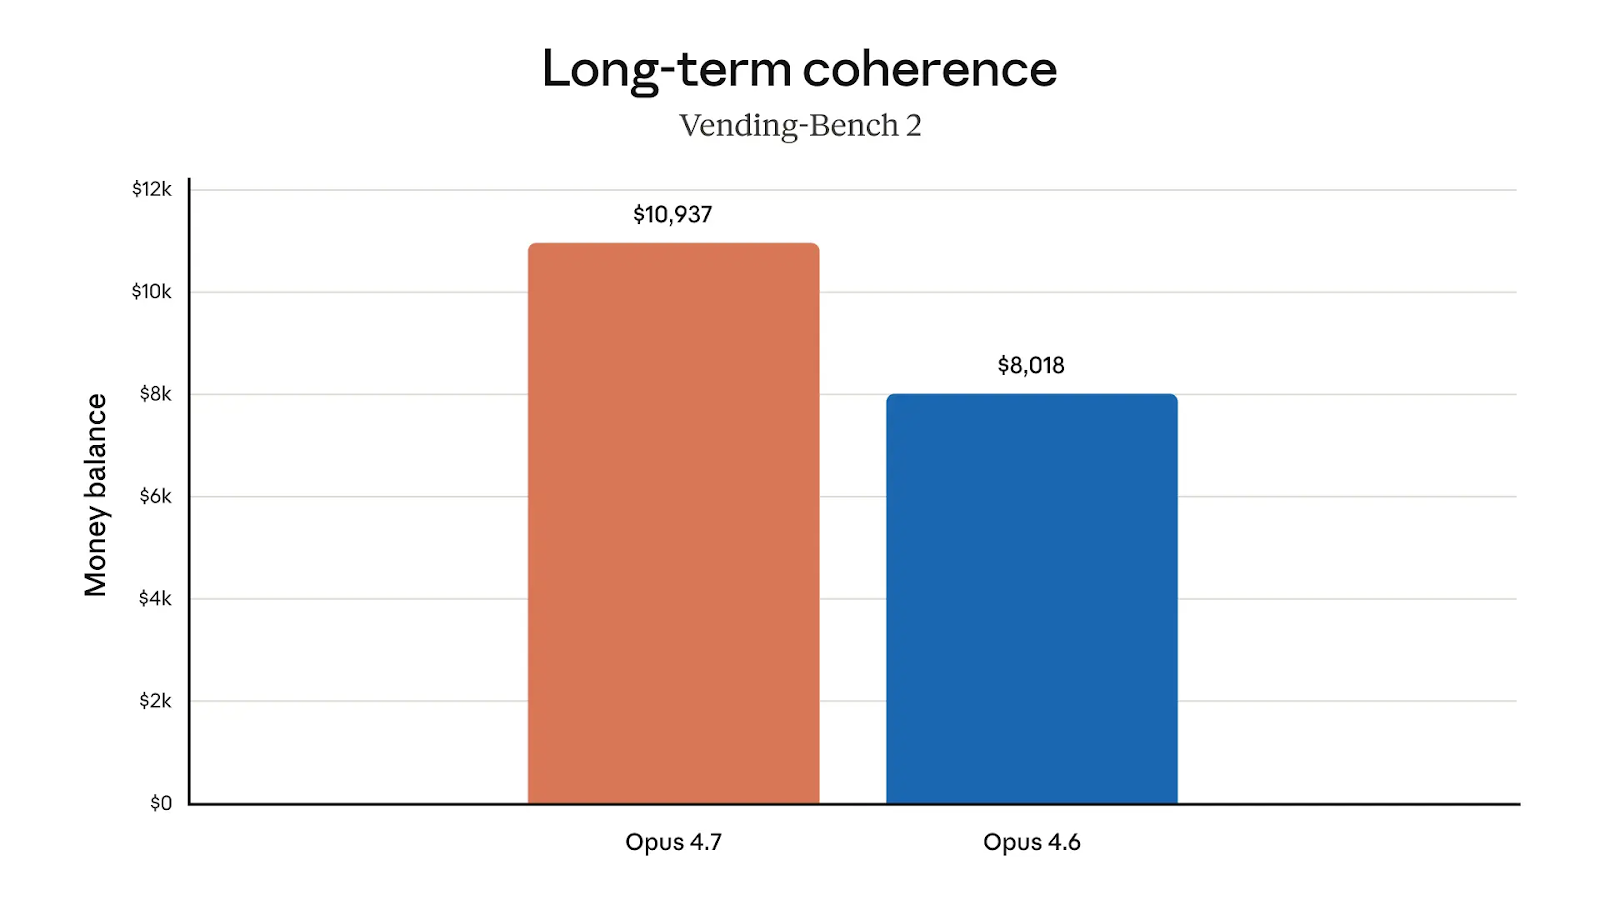
Dalam Vending-Bench 2 yang lebih praktis, kita dapat melihat bahwa Opus 4.7 juga lebih piawai soal uang. Rata-rata, model ini berakhir dengan jumlah $10.937, dibanding $8.018 pada Opus 4.6.
Anthropic tidak membuat kita menunggu. Opus 4.7 kini tersedia
Di semua produk Claude
Claude API (claude-opus-4-7)
Vertex AI, dan
Microsoft Foundry
Kekhawatiran terhadap inflasi — terutama saat ini — selalu ada. Namun syukurlah, harganya sama seperti Opus 4.6. Yaitu $5 per satu juta token input dan $25 per satu juta token output. (Tidak ada kenaikan harga antara Opus 4.6 dan Opus 4.7.)
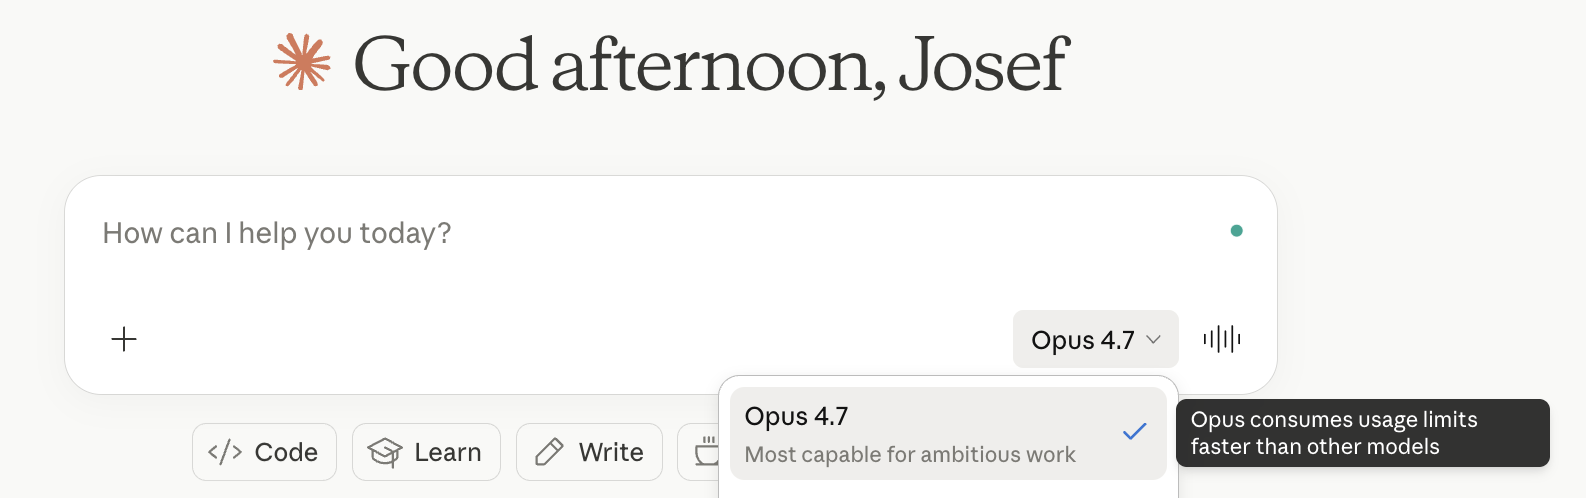
Sebagai pengingat umum, jika Anda menggunakan Opus di Claude.ai: Setiap pesan yang Anda kirim menyertakan seluruh percakapan sejauh ini (pertanyaan baru Anda + semua tanya jawab sebelumnya) ditambah balasan model. Semuanya dihitung dalam token. Paket Anda, apa pun itu, memiliki anggaran token yang terisi ulang pada jendela bergulir.
Model yang berbeda membebankan tarif berbeda terhadap anggaran tersebut. Opus adalah yang termahal karena paling bertenaga. Perkiraan rasio yang dipublikasikan: Biaya Opus sekitar 5× dari Sonnet per token.
Anthropic merilis beberapa pembaruan bersamaan dengan model itu sendiri yang patut diketahui, setidaknya jika Anda menggunakan Claude Code atau membangun di atas API.
Tingkat upaya xhigh ("extra high") baru kini berada di antara high dan max. Ini memberi Anda opsi tambahan saat memilih antara kedalaman penalaran dan latensi. Di Claude Code, tingkat upaya default dinaikkan ke xhigh di semua paket, dan Anthropic merekomendasikan memulai dengan high atau xhigh saat menguji Opus 4.7 pada tugas pengodean dan agen.
Claude Code mendapatkan perintah garis miring baru /ultrareview, yang menjalankan tinjauan khusus atas perubahan Anda dan menandai bug atau masalah desain yang akan ditangkap oleh peninjau manusia yang cermat. Pengguna Pro dan Max mendapatkan tiga ultrareview gratis untuk mencobanya.
Pengguna Max kini mendapatkan akses ke mode otomatis, pengaturan perizinan di mana Claude membuat keputusan atas nama Anda. Ini adalah jalan tengah antara menyetujui setiap langkah dan melewati perizinan sepenuhnya.
Anggaran tugas kini dalam beta publik di Claude API. Ini memungkinkan pengembang membatasi pengeluaran token Claude selama satu run, yang sangat berguna untuk alur kerja agen yang lebih panjang ketika Anda ingin model mengatur tempo alih-alih menghabiskan anggarannya dengan cepat.
Kami menelaah dengan saksama hasil tolok ukur, dan hasil tersebut memuat perbandingan dengan model lain. Secara garis besar, mari bandingkan Opus 4.7 dengan GPT-5.4 secara langsung.
Intinya, Opus 4.7 dioptimalkan untuk otonomi jangka panjang. GPT-5.4 adalah model serbaguna terpadu dengan dukungan alat yang lebih luas dan harga konteks pendek yang lebih murah.
| Claude Opus 4.7 | GPT-5.4 | |
|---|---|---|
| Unggul dalam | Run pengkodean panjang, penggunaan komputer desktop, visi padat |
Riset peramban, tugas konteks pendek, pengarahan di tengah respons |
| SWE-bench Pro | 64,3% | 57,7% |
| BrowseComp | 79,3% | 89,3% |
| Harga | Tarif flat untuk konteks 1M | Lebih murah di bawah 272K, seluruh sesi dihitung ulang di atasnya |
| Jendela konteks | ~1M token | ~1M token |
Untuk perbandingan lengkap dengan model penerus OpenAI, GPT-5.5, lihat postingan blog kami, Claude Opus 4.7 vs. GPT-5.5.
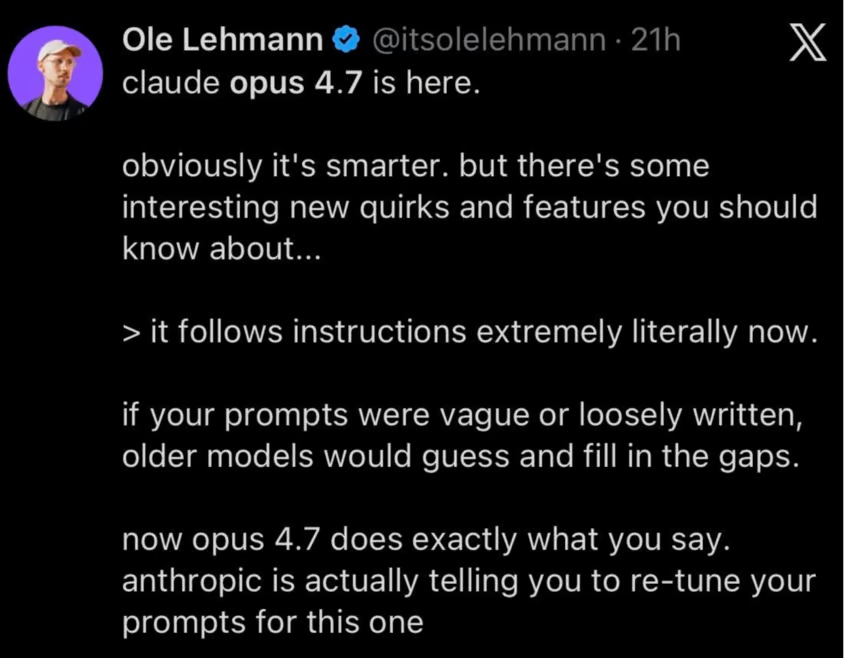
Beberapa pengguna melaporkan bahwa pipeline mereka bermasalah karena Opus 4.7 mengikuti instruksi lebih harfiah daripada sebelumnya. Anthropic telah memperingatkan perlunya menyetel ulang prompt.
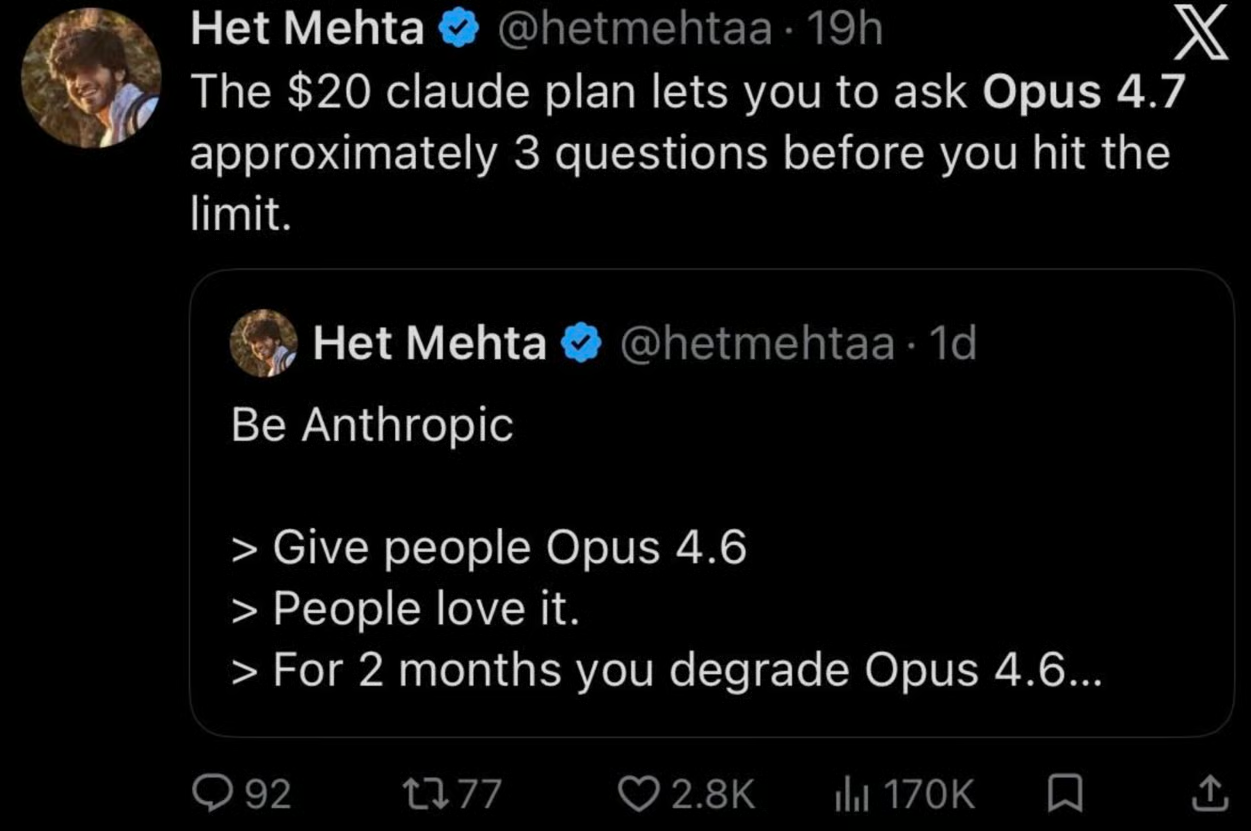
Pengguna lain khawatir tentang penggunaan token. Sebagai bagian dari rilis, Anthropic menaikkan batas laju untuk semua pengguna guna mengimbangi penggunaan token yang lebih tinggi, namun belum jelas apakah itu benar-benar mengimbangi.
Claude Opus 4.7 adalah model paling andal yang benar-benar dapat digunakan kebanyakan orang saat ini. Semua peningkatannya mengarah ke satu hal: pekerjaan agen yang berjalan lebih lama dan kurang diawasi, dengan pengodean lebih kuat, visi lebih tajam, dan memori lintas sesi yang lebih baik untuk mendukungnya.
Yang membuat rilis ini menarik adalah bingkai Mythos. Opus 4.7 adalah kendaraan uji yang dibatasi dari sisi siber dalam perjalanan menuju rilis kelas Mythos yang lebih luas, yang berarti kini ada plafon jelas di atasnya yang tidak dapat Anda akses — namun juga bahwa pengaman yang dikirim bersama 4.7 merupakan pratinjau bagaimana Anthropic berencana menangani rilis frontier ke depan.
Belajar bersama DataCamp
{count, plural, one {Program} other {Program}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {Kursus} other {Kursus}}
{count, plural, one {blog} other {blogs}}
Javier Canales Luna
14 mnt
{count, plural, one {blog} other {blogs}}
Dario Radečić
15 mnt
{count, plural, one {blog} other {blogs}}
Hugo Bowne-Anderson
13 mnt
{count, plural, one {blog} other {blogs}}
David Woods
13 mnt