{count, plural, one {Programma} other {Programmi}}
AI Engineering with LangChain
{hours} ore
Due dei modelli più discussi all’inizio del 2026 arrivano da realtà molto diverse. Muse Spark di Meta è il primo modello dei Meta Superintelligence Labs e un distacco deciso dalla linea Llama. Claude Opus 4.6 di Anthropic è arrivato all’inizio dell’anno come aggiornamento del livello di punta dell’azienda, con una finestra di contesto da 1 milione di token e il punteggio più alto su Terminal-Bench 2.0.
La scelta tra i due non è scontata. Muse Spark è nativamente multimodale con tre modalità di ragionamento distinte e un focus sull’efficienza computazionale. Claude Opus 4.6 è pensato per coding agentico, workflow di lunga durata e ragionamento profondo, con Agent Teams e pensiero adattivo integrati. Entrambi sono proprietari e solo cloud, il che restringe già il campo rispetto alle alternative open-weight.
In questo articolo confronterò Muse Spark e Claude Opus 4.6 in sei dimensioni chiave: architettura e filosofia di design, ragionamento e benchmark, capacità multimodali, funzionalità agentiche, accesso e disponibilità, privacy e licensing.
Se vuoi saperne di più sui large language model (LLM) di Anthropic, ti consiglio il nostro corso Introduzione ai modelli Claude. Dai anche un’occhiata al nostro altro confronto su GPT-5.4 vs Claude Opus 4.6.
Aggiornamento: Poco dopo la pubblicazione di questo articolo è uscita una nuova versione di Opus. Assicurati di leggere la nostra guida a Claude Opus 4.7.
Muse Spark è il primo modello rilasciato sotto il nome di famiglia Muse, originariamente con nome in codice "Avocado" durante lo sviluppo. È stato costruito dai Meta Superintelligence Labs, una divisione creata da Meta a giugno 2025 dopo un investimento di 14,3 miliardi di dollari che includeva l’assunzione di Alexandr Wang da Scale AI. Il modello è stato lanciato l’8 aprile 2026.
La scelta progettuale chiave dietro Muse Spark è una pipeline di training ricostruita da zero. Invece di estendere l’architettura Llama, il team di Meta è ripartito da capo con multimodalità nativa su testo, immagini, audio e uso di strumenti. Il risultato è un modello che, secondo Meta, eguaglia le prestazioni di Llama 4 Maverick utilizzando un ordine di grandezza in meno di compute. Meta ha rilasciato Muse Spark 1.3 il 2 settembre 2026.
Muse Spark offre tre modalità di ragionamento:
Il modello è solo cloud, accessibile via meta.ai o app Meta AI, con un’API in anteprima privata per alcuni partner enterprise. Alimenta anche il nuovo Muse Agent.
Claude Opus 4.6 è l’ultimo modello di punta di Anthropic, rilasciato all’inizio del 2026 come upgrade di Opus 4.5. Anthropic lo descrive come il suo livello di modello più intelligente, con focus su coding agentico, ragionamento profondo e autocorrezione. Guida la classifica del benchmark di coding Terminal-Bench 2.0 ed è alla pari con i leader in diversi altri benchmark, come BrowseComp per la ricerca di informazioni.
Il numero di copertina è la finestra di contesto da 1 milione di token, attualmente in beta. Questo porta Opus 4.6 in linea con Gemini 3 sulla lunghezza del contesto e lo rende adatto a grandi codebase e task agentici di lunga durata. Insieme al modello, Anthropic ha lanciato Agent Teams in Claude Code, consentendo a più istanze indipendenti di Claude di lavorare in parallelo su un singolo task.
Claude Opus 4.6 è disponibile tramite la Claude API (ID modello: claude-opus-4-6), Claude Code e Claude in PowerPoint. È proprietario e solo cloud, senza versione open-weight.
Senza ulteriori indugi, confrontiamo i due modelli in alcune categorie rilevanti.
Se vuoi una risposta veloce prima di entrare nei dettagli, questa tabella mappa scenari comuni al modello più adatto.
| Caso d’uso | Consigliato | Perché |
|---|---|---|
| Coding agentico con agenti in parallelo | Claude Opus 4.6 | Agent Teams in Claude Code, 80,8 su SWE-Bench Verified |
| Analisi di documenti con lungo contesto | Claude Opus 4.6 | Finestra di contesto da 1M token (beta) |
| Ragionamento multimodale (testo + immagini + audio) | Muse Spark | Multimodalità nativa fin dalle fondamenta, visual chain-of-thought |
| Inference efficiente in termini di compute | Muse Spark | Eguaglia Llama 4 Maverick con 10x meno compute |
| Matematica e ragionamento complessi | Claude Opus 4.6 | Punteggi migliori nei benchmark di ragionamento |
| Accesso API enterprise | Claude Opus 4.6 | API pubblica disponibile; l’API di Muse Spark è solo anteprima privata |
| Ragionamento multi-step estremo | Muse Spark (Contemplating) | Modalità di ragionamento multi-agente parallelo; compete con Gemini Deep Think e GPT Pro |
| Integrazione con PowerPoint ed Excel | Claude Opus 4.6 | Claude in PowerPoint e Claude in Excel sono integrazioni già attive |
| Casi d’uso legati alla salute | Muse Spark | Punto di forza di Muse Spark: 42,8 vs 14,8 in HealthBench Hard |
Come è costruito un modello ne determina i punti di forza. Muse Spark e Claude Opus 4.6 incarnano scommesse davvero diverse su dove dovrebbe andare l’AI di frontiera.
Meta ha ricostruito da zero la pipeline di training per Muse Spark. Il modello è nativamente multimodale, il che significa che testo, immagini, audio e uso di strumenti sono stati addestrati insieme, non aggiunti dopo. È un contrasto diretto con la serie Llama, che la stessa Meta ha descritto come basata sul pattern-matching.
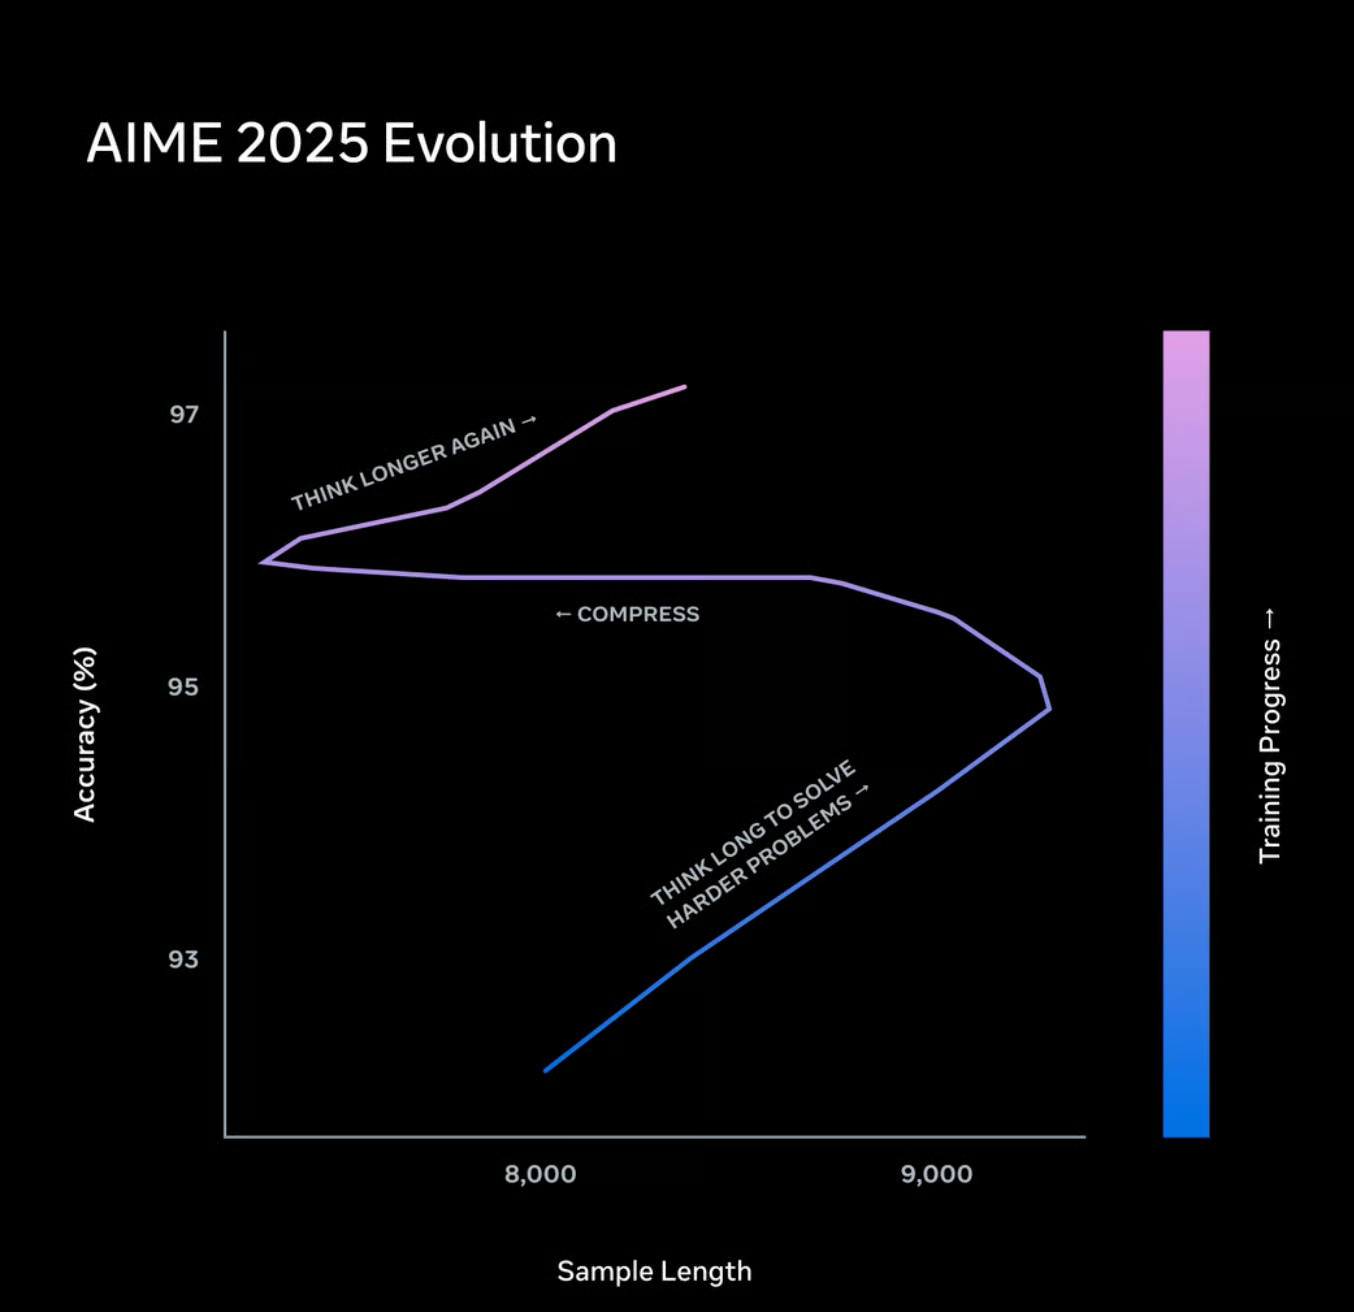
Una delle scelte tecniche più interessanti è la Thought Compression, una tecnica di reinforcement learning che penalizza l’eccesso di token durante il ragionamento. L’obiettivo è l’efficienza: spingere il modello a ragionare bene senza generare passaggi intermedi non necessari. È anche uno dei motivi per cui Muse Spark può eguagliare le prestazioni di Llama 4 Maverick a una frazione del costo computazionale.
Il focus progettuale di Anthropic per Opus 4.6 è l’azione sostenuta piuttosto che la performance sul singolo turno. Il modello è costruito per pianificare con cura, mantenere coerenza nel tempo e individuare errori nel proprio ragionamento. Il pensiero adattivo consente al modello di decidere se un prompt richiede una chain-of-thought estesa, e il parametro effort dà agli sviluppatori controllo manuale su questo compromesso.
I livelli di effort valgono la pena di essere capiti se usi l’API:
Lo stack ricostruito di Muse Spark è una deviazione architetturale più radicale, e la storia dell’efficienza computazionale è davvero impressionante. Il pensiero adattivo e i controlli sull’effort di Claude Opus 4.6 sono invece più utili nell’immediato per chi ha bisogno di un controllo fine tra costi e accuratezza.
I numeri dei benchmark sono proxy imperfetti, ma restano il segnale più chiaro per confrontare modelli che la maggior parte delle persone non ha ancora messo fianco a fianco.
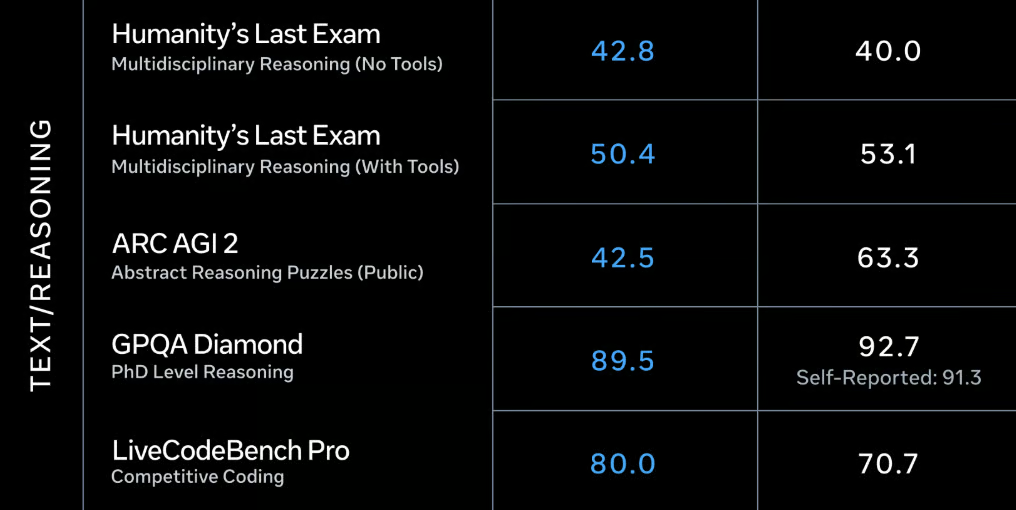
Benchmark di testo/ragionamento. Punteggi di Muse Spark (Thinking) a sinistra, Claude Opus 4.6 (Max) a destra. Fonte: Meta
Confrontando i due modelli nel dominio testo/ragionamento, emergono questi pattern:
Nel complesso, Claude Opus 4.6 sembra la scelta migliore quando è richiesto un ragionamento molto astratto, mentre Muse Spark è alla pari per il buon senso e il ragionamento legato ai domini.
Entrambi i modelli gestiscono più del testo, ma la profondità del supporto differisce in modo significativo.
La multimodalità è centrale nell’identità di Muse Spark, non un’aggiunta. Il modello è stato addestrato nativamente su testo, immagini, audio e dati strutturati insieme. La visual chain-of-thought è una funzionalità specifica: il modello può ragionare passo dopo passo su problemi basati su immagini, non solo descrivere ciò che vede. Anche l’uso di strumenti è nativo, il che conta per workflow agentici che prevedono chiamate a API esterne o l’elaborazione di dati strutturati accanto a input non strutturati.
Claude Opus 4.6 supporta input multimodali, ma le note di ricerca non lo descrivono come nativamente multimodale nello stesso senso architetturale di Muse Spark. L’integrazione multimodale di rilievo è sul lato output: Claude in PowerPoint genera oggetti di slide modificabili invece di immagini di slide, e Claude in Excel traccia le dipendenze delle formule tra i fogli.
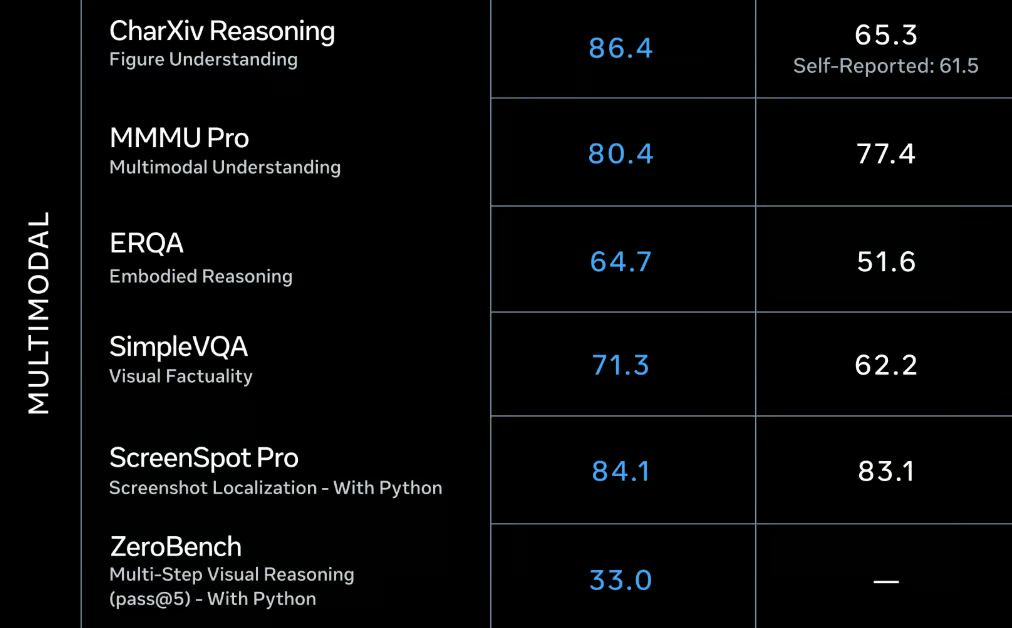
Benchmark multimodali. Punteggi di Muse Spark (Thinking) a sinistra, Claude Opus 4.6 (Max) a destra. Fonte: Meta
Nel dominio multimodale, Muse Spark mostra i suoi punti di forza: è in vantaggio su Claude Opus 4.6 in ogni benchmark citato. I seguenti risultati sono particolarmente notevoli:
Per task che mescolano testo, immagini e audio a livello di modello, Muse Spark ha fondamenta più solide. Per i workflow aziendali su documenti e fogli di calcolo, le integrazioni di Claude Opus 4.6 sono più immediatamente pratiche.
Entrambi i modelli sono pensati per casi d’uso agentici, ma affrontano il problema in modo diverso.
La modalità Contemplating di Muse Spark è la sua carta agentica. Piuttosto che far ragionare un singolo modello in sequenza, Contemplating avvia più agenti in parallelo, ciascuno su una parte del problema, con risultati verificati tra agenti. È simile nello spirito agli Agent Teams di Claude, ma integrato nella modalità di ragionamento stessa invece che esposto come funzionalità API separata.
Gli Agent Teams in Claude Code sono la funzionalità agentica di punta in Opus 4.6. Puoi avviare più istanze indipendenti di Claude, con una che funge da coordinatore e le altre che gestiscono l’esecuzione, ciascuna nel proprio contesto. Ciò significa che flussi di lavoro paralleli non competono per lo stesso budget di token, ma i costi possono moltiplicarsi rapidamente. Anthropic consiglia Agent Teams per scenari ad alta complessità in cui l’esecuzione parallela giustifica la spesa.
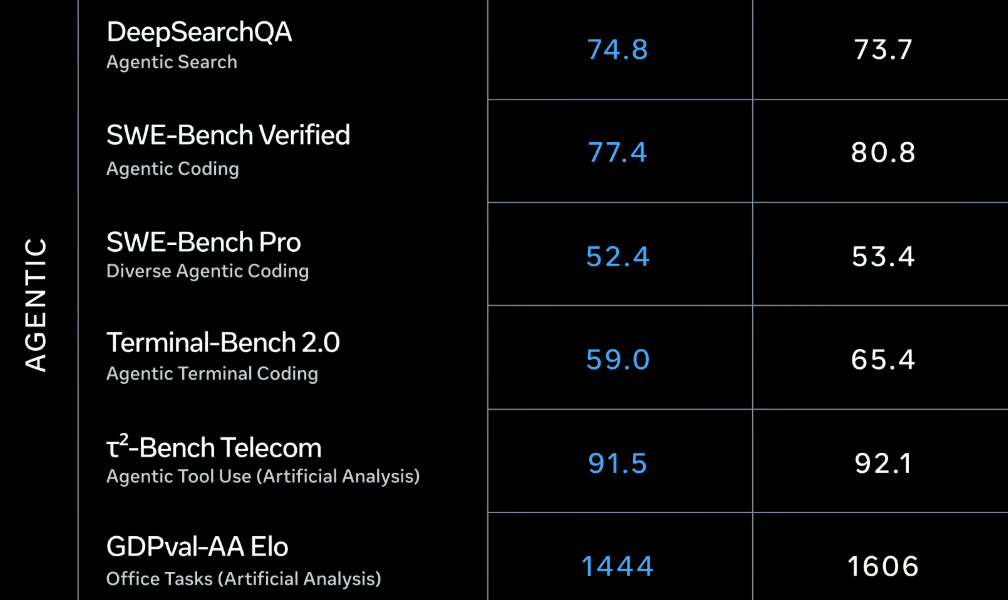
Benchmark agentici. Punteggi di Muse Spark (Thinking) a sinistra, Claude Opus 4.6 (Max) a destra. Fonte: Meta
Nel complesso, la maggior parte dei punteggi dei benchmark agentici è piuttosto simile tra i due modelli, ma Opus 4.6 ha un leggero vantaggio su Muse Spark. Le osservazioni più rilevanti:
Le capacità agentiche di Claude Opus 4.6 sono più mature e migliori per la maggior parte dei task. La modalità Contemplating di Muse Spark è promettente ma ancora in rollout graduale, il che limita ciò che puoi effettivamente costruire oggi.
Anche se non è una categoria classica per confrontare gli LLM, le prestazioni in scenari legati alla salute meritano una menzione, dato che uno degli obiettivi chiave di Muse Spark è aiutare le persone a conoscere e migliorare la propria salute. Meta ha collaborato con oltre 1.000 medici per curare dati di training medico su domande quotidiane legate alla salute come il contenuto nutrizionale degli alimenti o i muscoli attivati durante l’esercizio.
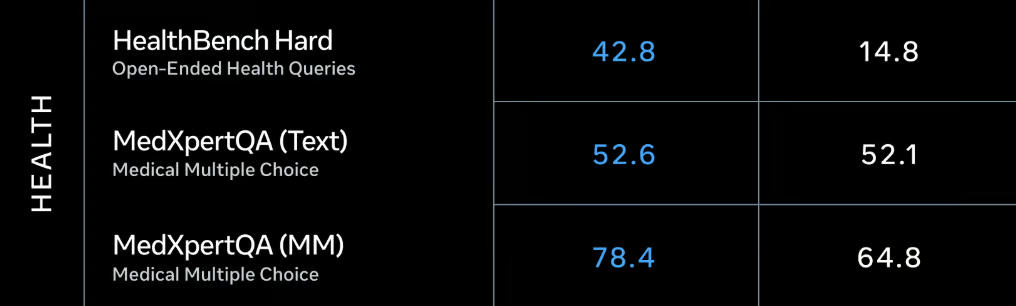
Benchmark sulla salute. Punteggi di Muse Spark (Thinking) a sinistra, Claude Opus 4.6 (Max) a destra. Fonte: Meta
Il focus sulla salute si riflette nei rispettivi punteggi. In generale, meno sono standardizzate le query sanitarie, più emerge la differenza tra i due modelli.
Soprattutto in combinazione con le capacità multimodali di Muse Spark, questo apre una serie di applicazioni molto interessanti per la vita di tutti i giorni. Pensa a scattare un’immagine del tuo frigo e ricevere un piano pasti personalizzato in linea con i tuoi obiettivi nutrizionali della settimana. Resta da vedere quanto bene funzionino tali strumenti nella pratica, ma suona promettente.
Entrambi i modelli sono proprietari e solo cloud, ma la storia dell’accesso è piuttosto diversa.
Muse Spark è disponibile tramite meta.ai e l’app Meta AI, entrambi richiedono un account Meta. Esiste un’API in anteprima privata per partner enterprise selezionati, ma nessuna API pubblica e nessuna data confermata per un accesso più ampio. Meta ha dichiarato di sperare di open-sourcizzare le future versioni di Muse, ma Muse Spark è closed-source senza opzioni di download o fine-tuning.
Quanto alla privacy: la policy di Meta consente di usare i dati delle conversazioni per migliorare il modello. Se lavori con dati sensibili, è un aspetto da considerare prima di farli passare da Muse Spark.
Claude Opus 4.6 è disponibile tramite la Claude API pubblica usando l’ID modello claude-opus-4-6. È accessibile anche tramite l’interfaccia web di Claude, Claude Code, Claude Cowork e le app mobili Claude per iOS/Android. Sul web, l’accesso è limitato agli abbonati paganti. Gli Agent Teams sono sperimentali in Claude Code.
Per chi ha bisogno di un’API oggi, Claude Opus 4.6 è l’unica opzione. L’API in anteprima privata di Muse Spark significa che la maggior parte degli sviluppatori non può ancora costruirci sopra, a prescindere dalla qualità del modello.
Dato che punti di forza e debolezza dei due modelli sono piuttosto distinti, possiamo suggerire chiaramente i casi d’uso per ciascuno.
Muse Spark è più adatto in un insieme specifico di scenari, per lo più incentrati su input multimodali ed efficienza computazionale.
Un caveat onesto: l’accesso pubblico a Muse Spark al momento è limitato. Se non riesci a entrare nell’anteprima enterprise, lo usi tramite meta.ai, che va bene per esplorare ma non per costruire workflow di produzione.
Claude Opus 4.6 è la scelta più solida per la maggior parte degli sviluppatori e data scientist oggi, principalmente perché è effettivamente accessibile.
Ti serve un’API pubblica con un ID modello documentato (claude-opus-4-6)
Il coding agentico è il tuo caso d’uso principale, soprattutto con Claude Code e Agent Teams
Lavori con grandi codebase che beneficiano di una finestra di contesto da 1 milione di token
Ti serve performance di livello top nei benchmark di coding
Vuoi controllo fine sulla profondità del ragionamento tramite il parametro effort
Il tuo team usa PowerPoint o Excel e vuole l’AI integrata direttamente in quegli strumenti
La funzionalità Agent Teams è ancora sperimentale e i costi in token si moltiplicano rapidamente quando esegui agenti in parallelo. Ma per task complessi di sviluppo software, il modello di esecuzione parallela è davvero utile e la compattazione delle conversazioni mantiene gli agenti di lunga durata sulla giusta rotta.
La verità è che questi due modelli, al momento, non competono davvero per gli stessi utenti. Claude Opus 4.6 è un modello maturo, accessibile, ai vertici dei benchmark, con API pubblica, funzionalità documentate e integrazioni reali. Muse Spark è un primo rilascio tecnicamente interessante da un nuovo laboratorio, con accesso pubblico limitato e meno numeri pubblicati. Il divario potrebbe chiudersi rapidamente, ma questa è la realtà ad aprile 2026.
Se sei uno sviluppatore o un data scientist che deve costruire qualcosa oggi, Claude Opus 4.6 è la scelta pratica. I punteggi nei benchmark di coding, la finestra di contesto da 1M token e la funzionalità Agent Teams in Claude Code sono tutte cose che puoi usare davvero. La multimodalità nativa e la Thought Compression di Muse Spark sono davvero interessanti, ma sono più difficili da valutare senza un accesso API più ampio.
Dove terrei d’occhio Muse Spark è nei task di ragionamento multimodale quando la modalità Contemplating sarà pienamente distribuita. L’approccio multi-agente parallelo ai problemi difficili è una scommessa diversa dal semplice scalare i token di inference e, se le affermazioni di Meta sull’efficienza reggeranno a test indipendenti, la storia dei costi computazionali diventerà molto convincente per i carichi di lavoro in produzione.
Se vuoi sviluppare applicazioni di AI, ti consiglio vivamente di iscriverti al nostro percorso di competenze AI Engineering with LangChain. I contenuti didattici sono AI-native, il che significa che avrai un tutor personale che ti insegna esattamente le competenze di cui hai bisogno per partire dal tuo livello e diventare davvero esperto nell’ingegnerizzare workflow di AI.
Impara l’AI con DataCamp
{count, plural, one {Programma} other {Programmi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {Corso} other {Corsi}}
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
15 min
{count, plural, one {blog} other {blogs}}
Abid Ali Awan
10 min
{count, plural, one {blog} other {blogs}}
Tim Lu
12 min