Baru-baru ini saya menyelesaikan sebuah kontrak dengan perusahaan AI. Di antara berbagai hal, mereka membantu peneliti melakukan pelatihan lanjutan (post-train) pada LLM. Sebagai PhD matematika, saya membuat prompt matematika yang membuat model AI terdepan kewalahan. Prompt tipu daya tidak dihitung; prompt harus mengungkap kesalahan penalaran.
Selama pekerjaan itu, saya sering mendengar referensi ke "Humanity’s Last Exam." Saya mengetahui bahwa itu adalah tolok ukur AI yang dirancang untuk menguji penalaran di banyak bidang akademik. Rasa ingin tahu mendorong saya menggali lebih dalam tentang apa itu HLE dan apa yang dikatakannya tentang batas penalaran AI saat ini.
Jika Anda baru dalam AI dan benchmarking, saya merekomendasikan untuk mengambil jalur keterampilan AI Fundamentals.
Apa Itu “Humanity’s Last Exam"?
Seiring kemajuan LLM, para peneliti mengandalkan kumpulan pertanyaan evaluasi, yang dikenal sebagai benchmark, untuk membandingkan kinerja dan melacak kemajuan. Humanity's Last Exam (HLE) adalah benchmark yang dirancang untuk mengukur kemampuan penalaran suatu LLM, bukan sekadar kemampuannya mencocokkan pola. Tujuannya adalah mengevaluasi seberapa baik model menangani masalah setara pakar di banyak domain akademik.
Mengapa Kita Membutuhkan “Ujian Terakhir”?
Dengan banyaknya benchmark yang sudah ada, mengapa perlu satu lagi? Benchmark yang dulunya menantang LLM, seperti MMLU, kini telah jenuh, dengan model sering meraih nilai di atas 90 persen. Pada titik ini, benchmark tersebut berhenti mengukur perbedaan yang bermakna antar model.
HLE adalah benchmark generasi berikutnya yang menaikkan tingkat kesulitan dengan menghimpun pertanyaan yang dibuat pakar dan menuntut penalaran multi-langkah, bukan sekadar mengingat dari pencocokan pola yang dangkal.
Bagaimana HLE Dikembangkan?
Pada akhir 2024, Centre for AI Safety, sebuah organisasi nirlaba yang berfokus pada keselamatan AI, bermitra dengan Scale AI, perusahaan data, untuk mengembangkan tolok ukur AI yang lebih sulit. Dan Hendrycks memimpin proyek tersebut.
Tim mengumpulkan pertanyaan setingkat pascasarjana dari berbagai disiplin akademik dan menawarkan hadiah yang signifikan: 50 kontributor teratas masing-masing memenangkan $5000, dan 500 berikutnya mendapat $500.
Hasilnya adalah kumpulan besar pertanyaan setingkat pakar di banyak subjek, seperti matematika, ilmu komputer, sastra, analisis musik, dan sejarah.
Apa Saja yang Termasuk dalam Humanity's Last Exam?
Makalah HLE menggambarkan benchmark ini sebagai "...benchmark tertutup terakhir untuk keterampilan akademik yang luas." Pertanyaannya memerlukan penalaran multi-langkah, yang mencegah model menebak atau menghafal jawaban.
HLE terdiri dari 2.500 pertanyaan publik dan sekitar 500 pertanyaan tambahan dalam himpunan penahanan (holdout) privat.
Setiap pertanyaan harus orisinal, memiliki satu jawaban benar, dan tidak mudah dijawab dengan pencarian web sederhana atau pencarian basis data. Sekitar 76% pertanyaan menggunakan format jawaban exact-match dan 24% sisanya pilihan ganda. Sekitar 14% pertanyaan bersifat multimodal, melibatkan teks dan gambar.
Tim HLE memiliki proses penapisan yang ketat untuk pertanyaan-pertanyaan tersebut.
- Agar diterima, pertanyaan harus membuat LLM terdepan kewalahan. Sekitar tujuh puluh ribu pertanyaan memenuhi kriteria ini.
- Peninjau sejawat yang ahli menyempurnakan dan menyaring totalnya menjadi tiga belas ribu pertanyaan.
- Penyelenggara dan peninjau ahli menyetujui secara manual enam ribu dari pertanyaan ini.
- Para peneliti membagi kumpulan pertanyaan ini menjadi set publik berisi 2.500 pertanyaan dan set penahanan sekitar 500 pertanyaan.
Kritik terhadap Humanity’s Last Exam
Hasil awal menunjukkan bahwa model-model terdepan awalnya meraih skor buruk pada pertanyaan, namun menyatakan tingkat keyakinan yang tinggi. Kesenjangan ini mengindikasikan halusinasi.
Kelompok independen juga mengemukakan kekhawatiran. Future House, sebuah laboratorium riset nirlaba, menerbitkan blog, "Sekitar 30% jawaban kimia/biologi Humanity’s Last Exam kemungkinan salah."
Analisis mereka berfokus pada protokol peninjauan. Penulis pertanyaan mengklaim jawaban benar, tetapi peninjau diinstruksikan hanya menghabiskan lima menit untuk meninjau kebenaran jawaban. Mereka berargumen bahwa proses ini membiarkan jawaban yang terlalu kompleks, direkayasa, atau ambigu lolos, yang sering kali bertentangan dengan literatur ilmiah.
Pengelola HLE menanggapi unggahan tersebut dengan menugaskan tinjauan oleh tiga pakar terhadap subset yang disengketakan. Per 16 September 2025, mereka berencana mengumumkan proses tinjauan bergulir untuk HLE.
Lanskap Tolok Ukur AI
HLE berada dalam ekosistem tolok ukur yang lebih luas yang menguji aspek-aspek berbeda dari kemampuan LLM.
Pengetahuan dan penalaran
Benchmark ini mengevaluasi pengetahuan akademik dan penalaran.
- Massive Multitask Language Understanding (MMLU). MMLU menguji kinerja zero-shot di lima puluh tujuh subjek berbeda.
- MMLU-Pro/MMLU Pro+. Kompleksitas pertanyaan meningkat dan fokus pada penalaran tingkat tinggi.
- Google Proof Q&A (GPQA) Benchmark STEM setingkat pascasarjana yang tahan-Google dengan 448 pertanyaan pilihan ganda.
- Humanity's Last Exam (HLE). HLE menggunakan masalah kurasi setingkat pakar yang menekankan penalaran dibanding ingatan.
Pemahaman multimodal
Benchmark ini mengukur penalaran yang melibatkan teks dan gambar.
- The Massive Multi-discipline Multimodal Understanding and Reasoning (MMMU). Sekitar 1.500 pertanyaan multimodal dan multidisiplin yang bersumber dari ujian, kuis, dan buku teks.
- The MMMU-Pro menghapus pertanyaan yang dapat dipecahkan oleh model hanya-teks, menambah opsi jawaban yang lebih andal, dan memperkenalkan pengaturan vision-only di mana seluruh prompt disematkan dalam sebuah gambar.
Rekayasa perangkat lunak dan penggunaan alat
Benchmark lainnya berfokus khusus pada rekayasa perangkat lunak dan penggunaan alat.
- SWE-bench. Dibangun dari issue GitHub nyata dari dua belas repositori Python. Model membaca basis kode, menafsirkan deskripsi masalah, dan mengusulkan patch.
- SWE-bench Verified. Versi yang ditingkatkan dari SWE-bench yang memperbaiki pengujian yang terlalu spesifik, memperjelas deskripsi masalah yang samar, dan menstabilkan penyiapan lingkungan.
- SWE-bench-Live. Versi yang skalabel dan terus diperbarui dengan 1319 tugas di 93 repo.
Kerangka evaluasi holistik multi-metrik
Stanford's Center for Research on Foundation Models (CRFM) mengembangkan Holistic Evaluation of Language Models (HELM) untuk mendukung evaluasi AI yang bertanggung jawab.
HELM mengevaluasi model pada serangkaian skenario standar, seperti tanya jawab, peringkasan, kueri yang kritis terhadap keselamatan, serta konten sosial/etis. Skenario ini dinilai di berbagai dimensi, tidak hanya akurasi, tetapi juga kalibrasi, ketangguhan, dan toksisitas.
HELM telah berkembang menjadi keluarga kerangka terkait.
- HEML Capabilities. Papan peringkat tujuan umum untuk mengevaluasi LM.
- Audio. Evaluasi untuk tugas terkait audio dan ucapan.
- HELM Lite. Subset yang lebih kecil dan cepat untuk perbandingan cepat.
- HELM Finance. HELM yang disesuaikan untuk tugas finansial.
- MedHELM. Evaluasi untuk penalaran dan keselamatan terkait layanan kesehatan.
Evaluasi keselamatan dan kapabilitas berbahaya
Kerangka keselamatan mengukur risiko alih-alih kompetensi intelektual.
- Model Evaluation & Threat Research (METR) adalah organisasi riset nirlaba yang mengevaluasi kapabilitas yang berpotensi berbahaya, seperti serangan siber, upaya menghindari pemadaman, atau kemampuan mengotomasi litbang AI. Misinya adalah mendeteksi risiko katastropik sejak dini.
- Google DeepMind's Frontier Safety Framework. Mendefinisikan critical capability levels (CCL), memantau apakah model frontier mendekatinya, dan menerapkan rencana mitigasi saat itu terjadi.
Di Mana Skor Model AI Saat Ini pada Tolok Ukur AI?
Banyak papan peringkat publik melacak kinerja LLM di berbagai metrik.
Papan peringkat
Berikut beberapa skor pada saat penulisan ini, Desember 2025.
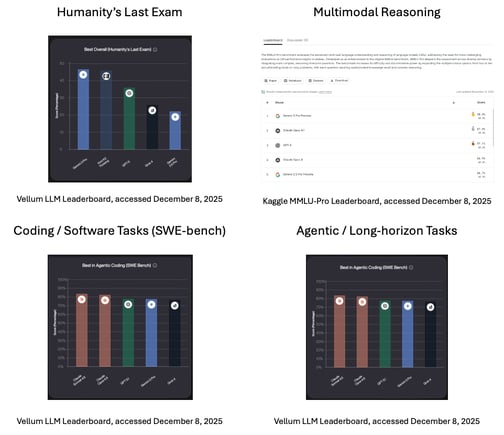
- Humanity's Last Exam. Menurut papan peringkat Vellum, pemimpin saat ini (pada saat penulisan) adalah Gemini 3 Pro, model AI generatif multimodal andalan Google.
- Penalaran Multimodal. Gemini 3 Pro, yang dirancang untuk menyatukan berbagai modalitas dalam satu sistem, memimpin dalam penalaran multimodal, menurut papan peringkat Kaggle MMLU-Pro.
- Pengodean / Tugas Perangkat Lunak (SWE-bench). Claude Sonnet 4.5 dari Anthopic, yang mengutamakan penalaran yang cermat, menempati posisi teratas dalam pengodean dan tugas perangkat lunak dunia nyata, menurut papan peringkat Vellum.
- Tugas Agenik / Horizon Panjang. Claude Sonnet 4.5 juga memimpin dalam tugas agenik dan horizon panjang, menurut papan peringkat Vellum.
Keselamatan/kapabilitas berbahaya
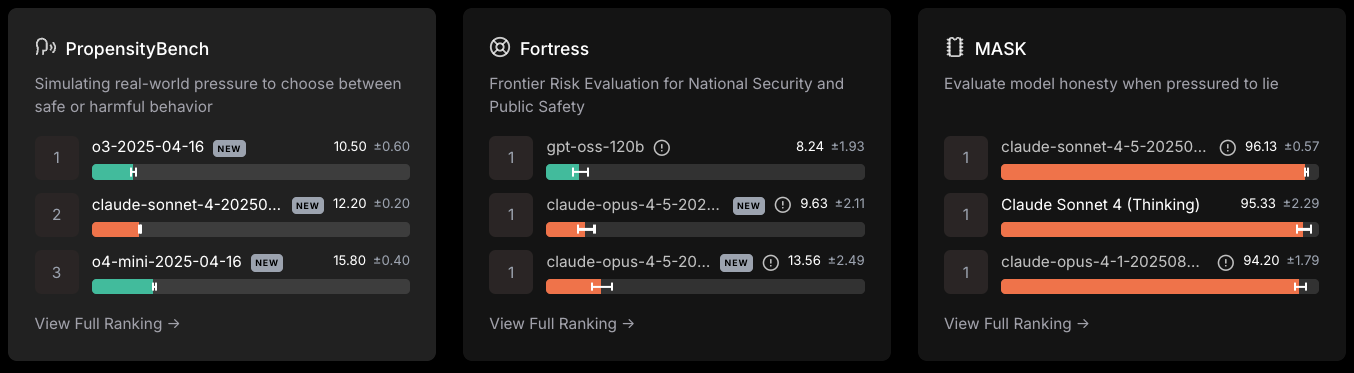
Scale LLM Safety Leaderboard, diakses 8 Desember 2025
- Open AI's o3-2024-04-18 memimpin di PropensityBench, yang mengukur pilihan antara perilaku aman atau berbahaya.
- GPT-oss-120b memimpin dalam Frontier Risk Evaluation for National Security and Public Safety.
- Caude Sonnet-4 .5 paling menolak tekanan untuk berbohong.
Bagaimana Humanity’s Last Exam Digunakan
Sejauh ini, saya telah menguraikan apa itu HLE dan bagaimana ia dikembangkan. Sekarang mari kita lihat bagaimana tes ini digunakan secara praktis.
Untuk tim riset
HLE menyediakan metode evaluasi standar lintas domain. Ini menyoroti kekuatan dan kelemahan model. Ini mengungkap jarak antara model dan kinerja pakar manusia. Tim dapat menggunakan pola ini untuk memandu pengembangan model dan post-training yang terarah.
Untuk pembuat kebijakan
HLE menyediakan metrik publik dan global tentang kemajuan penalaran AI. Ini menciptakan titik acuan bersama lintas negara dan badan regulator serta dapat menjadi jangkar diskusi tentang ambang batas, pengawasan, dan tata kelola dalam realitas, bukan sensasi.
Kesimpulan
Tolok ukur AI membentuk cara kita mengukur kemajuan AI. Ketika tolok ukur sebelumnya telah jenuh, kebutuhan akan tolok ukur baru yang berfokus pada penalaran, bukan sekadar ingatan atau pencocokan pola, menjadi jelas.
Humanity's Last Exam berupaya mengisi kekosongan itu dengan crowdsourcing pertanyaan setingkat pascasarjana dari para pakar di seluruh dunia untuk mengungkap keterbatasan LLM. Ini bukan kata akhir, tetapi memperjelas posisi AI saat ini dibanding penalaran pakar manusia.
Untuk informasi lebih lanjut tentang LLM dan cara kerjanya, saya merekomendasikan sumber berikut:




Baru-baru ini saya menyelesaikan sebuah kontrak dengan perusahaan AI. Di antara berbagai hal, mereka membantu peneliti melakukan pelatihan lanjutan (post-train) pada LLM. Sebagai PhD matematika, saya membuat prompt matematika yang membuat model AI terdepan kewalahan. Prompt tipu daya tidak dihitung; prompt harus mengungkap kesalahan penalaran.
Selama pekerjaan itu, saya sering mendengar referensi ke "Humanity’s Last Exam." Saya mengetahui bahwa itu adalah tolok ukur AI yang dirancang untuk menguji penalaran di banyak bidang akademik. Rasa ingin tahu mendorong saya menggali lebih dalam tentang apa itu HLE dan apa yang dikatakannya tentang batas penalaran AI saat ini.
Jika Anda baru dalam AI dan benchmarking, saya merekomendasikan untuk mengambil jalur keterampilan AI Fundamentals.
Apa Itu “Humanity’s Last Exam"?
Seiring kemajuan LLM, para peneliti mengandalkan kumpulan pertanyaan evaluasi, yang dikenal sebagai benchmark, untuk membandingkan kinerja dan melacak kemajuan. Humanity's Last Exam (HLE) adalah benchmark yang dirancang untuk mengukur kemampuan penalaran suatu LLM, bukan sekadar kemampuannya mencocokkan pola. Tujuannya adalah mengevaluasi seberapa baik model menangani masalah setara pakar di banyak domain akademik.
Mengapa Kita Membutuhkan “Ujian Terakhir”?
Dengan banyaknya benchmark yang sudah ada, mengapa perlu satu lagi? Benchmark yang dulunya menantang LLM, seperti MMLU, kini telah jenuh, dengan model sering meraih nilai di atas 90 persen. Pada titik ini, benchmark tersebut berhenti mengukur perbedaan yang bermakna antar model.
HLE adalah benchmark generasi berikutnya yang menaikkan tingkat kesulitan dengan menghimpun pertanyaan yang dibuat pakar dan menuntut penalaran multi-langkah, bukan sekadar mengingat dari pencocokan pola yang dangkal.
Bagaimana HLE Dikembangkan?
Pada akhir 2024, Centre for AI Safety, sebuah organisasi nirlaba yang berfokus pada keselamatan AI, bermitra dengan Scale AI, perusahaan data, untuk mengembangkan tolok ukur AI yang lebih sulit. Dan Hendrycks memimpin proyek tersebut.
Tim mengumpulkan pertanyaan setingkat pascasarjana dari berbagai disiplin akademik dan menawarkan hadiah yang signifikan: 50 kontributor teratas masing-masing memenangkan $5000, dan 500 berikutnya mendapat $500.
Hasilnya adalah kumpulan besar pertanyaan setingkat pakar di banyak subjek, seperti matematika, ilmu komputer, sastra, analisis musik, dan sejarah.
Apa Saja yang Termasuk dalam Humanity's Last Exam?
Makalah HLE menggambarkan benchmark ini sebagai "...benchmark tertutup terakhir untuk keterampilan akademik yang luas." Pertanyaannya memerlukan penalaran multi-langkah, yang mencegah model menebak atau menghafal jawaban.
HLE terdiri dari 2.500 pertanyaan publik dan sekitar 500 pertanyaan tambahan dalam himpunan penahanan (holdout) privat.
Setiap pertanyaan harus orisinal, memiliki satu jawaban benar, dan tidak mudah dijawab dengan pencarian web sederhana atau pencarian basis data. Sekitar 76% pertanyaan menggunakan format jawaban exact-match dan 24% sisanya pilihan ganda. Sekitar 14% pertanyaan bersifat multimodal, melibatkan teks dan gambar.
Tim HLE memiliki proses penapisan yang ketat untuk pertanyaan-pertanyaan tersebut.
Kritik terhadap Humanity’s Last Exam
Hasil awal menunjukkan bahwa model-model terdepan awalnya meraih skor buruk pada pertanyaan, namun menyatakan tingkat keyakinan yang tinggi. Kesenjangan ini mengindikasikan halusinasi.
Kelompok independen juga mengemukakan kekhawatiran. Future House, sebuah laboratorium riset nirlaba, menerbitkan blog, "Sekitar 30% jawaban kimia/biologi Humanity’s Last Exam kemungkinan salah."
Analisis mereka berfokus pada protokol peninjauan. Penulis pertanyaan mengklaim jawaban benar, tetapi peninjau diinstruksikan hanya menghabiskan lima menit untuk meninjau kebenaran jawaban. Mereka berargumen bahwa proses ini membiarkan jawaban yang terlalu kompleks, direkayasa, atau ambigu lolos, yang sering kali bertentangan dengan literatur ilmiah.
Pengelola HLE menanggapi unggahan tersebut dengan menugaskan tinjauan oleh tiga pakar terhadap subset yang disengketakan. Per 16 September 2025, mereka berencana mengumumkan proses tinjauan bergulir untuk HLE.
Lanskap Tolok Ukur AI
HLE berada dalam ekosistem tolok ukur yang lebih luas yang menguji aspek-aspek berbeda dari kemampuan LLM.
Pengetahuan dan penalaran
Benchmark ini mengevaluasi pengetahuan akademik dan penalaran.
Pemahaman multimodal
Benchmark ini mengukur penalaran yang melibatkan teks dan gambar.
Rekayasa perangkat lunak dan penggunaan alat
Benchmark lainnya berfokus khusus pada rekayasa perangkat lunak dan penggunaan alat.
Kerangka evaluasi holistik multi-metrik
Stanford's Center for Research on Foundation Models (CRFM) mengembangkan Holistic Evaluation of Language Models (HELM) untuk mendukung evaluasi AI yang bertanggung jawab.
HELM mengevaluasi model pada serangkaian skenario standar, seperti tanya jawab, peringkasan, kueri yang kritis terhadap keselamatan, serta konten sosial/etis. Skenario ini dinilai di berbagai dimensi, tidak hanya akurasi, tetapi juga kalibrasi, ketangguhan, dan toksisitas.
HELM telah berkembang menjadi keluarga kerangka terkait.
Evaluasi keselamatan dan kapabilitas berbahaya
Kerangka keselamatan mengukur risiko alih-alih kompetensi intelektual.
Di Mana Skor Model AI Saat Ini pada Tolok Ukur AI?
Banyak papan peringkat publik melacak kinerja LLM di berbagai metrik.
Papan peringkat
Berikut beberapa skor pada saat penulisan ini, Desember 2025.
Keselamatan/kapabilitas berbahaya
Scale LLM Safety Leaderboard, diakses 8 Desember 2025
Bagaimana Humanity’s Last Exam Digunakan
Sejauh ini, saya telah menguraikan apa itu HLE dan bagaimana ia dikembangkan. Sekarang mari kita lihat bagaimana tes ini digunakan secara praktis.
Untuk tim riset
HLE menyediakan metode evaluasi standar lintas domain. Ini menyoroti kekuatan dan kelemahan model. Ini mengungkap jarak antara model dan kinerja pakar manusia. Tim dapat menggunakan pola ini untuk memandu pengembangan model dan post-training yang terarah.
Untuk pembuat kebijakan
HLE menyediakan metrik publik dan global tentang kemajuan penalaran AI. Ini menciptakan titik acuan bersama lintas negara dan badan regulator serta dapat menjadi jangkar diskusi tentang ambang batas, pengawasan, dan tata kelola dalam realitas, bukan sensasi.
Kesimpulan
Tolok ukur AI membentuk cara kita mengukur kemajuan AI. Ketika tolok ukur sebelumnya telah jenuh, kebutuhan akan tolok ukur baru yang berfokus pada penalaran, bukan sekadar ingatan atau pencocokan pola, menjadi jelas.
Humanity's Last Exam berupaya mengisi kekosongan itu dengan crowdsourcing pertanyaan setingkat pascasarjana dari para pakar di seluruh dunia untuk mengungkap keterbatasan LLM. Ini bukan kata akhir, tetapi memperjelas posisi AI saat ini dibanding penalaran pakar manusia.
Untuk informasi lebih lanjut tentang LLM dan cara kerjanya, saya merekomendasikan sumber berikut: