
Program
Dasar-Dasar Kecerdasan Buatan
10 jam
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan GoogleJika Anda mengikuti perkembangan dunia teknologi, Anda pasti sering mendengar istilah ‘Large Language Models (LLMs)’. LLM saat ini menjadi istilah teknologi paling populer, dan signifikansinya dalam dunia kecerdasan buatan (AI) kian meningkat setiap hari. LLM terus mendorong revolusi AI generatif seiring model-model ini belajar memproses bahasa manusia, seperti ChatGPT dan Bard.
LLM menjadi pemain penting di pasar yang terus berkembang saat ini berkat kemampuannya meniru percakapan manusia melalui sistem pemrosesan bahasa alami (NLP) yang mendalam. Tentu saja, segala sesuatu memiliki keterbatasan, dan asisten bertenaga AI pun memiliki tantangannya sendiri.
Tantangan unik ini adalah potensi bias LLM, yang berakar pada data yang digunakan untuk melatih model.
Mari mundur selangkah. Apa itu LLM?
LLM adalah sistem AI seperti ChatGPT yang digunakan untuk memodelkan dan memproses bahasa manusia. Ini adalah jenis algoritma AI yang menggunakan teknik pembelajaran mendalam untuk meringkas, menghasilkan, dan memprediksi konten baru. Disebut “besar” karena model memerlukan jutaan bahkan miliaran parameter, yang digunakan untuk melatih model menggunakan korpus data teks yang ‘besar’.
LLM dan NLP berjalan beriringan karena keduanya bertujuan memiliki pemahaman tinggi atas bahasa manusia dan polanya serta mempelajari pengetahuan menggunakan dataset besar.
Jika Anda pendatang baru di dunia LLM, artikel berikut direkomendasikan agar Anda cepat memahami dasarnya:
Apa itu LLM? Panduan tentang Large Language Models dan Cara Kerjanya. Atau ikuti Kursus Konsep Large Language Models (LLM) kami, yang juga tepat untuk mempelajari LLM.
LLM telah digunakan luas dalam berbagai jenis aplikasi AI. Popularitasnya kian meningkat, dan bisnis mencari berbagai cara untuk mengintegrasikannya ke dalam sistem dan perkakas mereka saat ini guna meningkatkan produktivitas alur kerja.
LLM dapat digunakan untuk use case berikut:
LLM menggunakan model Transformer, sebuah arsitektur pembelajaran mendalam yang mempelajari konteks dan pemahaman melalui analisis data berurutan.
Tokenisasi adalah ketika teks masukan dipecah menjadi unit-unit lebih kecil yang disebut token agar model dapat memproses dan menganalisisnya melalui persamaan matematika untuk menemukan relasi antar token. Proses matematis ini mengadopsi pendekatan probabilistik untuk memprediksi urutan kata berikutnya selama fase pelatihan model.
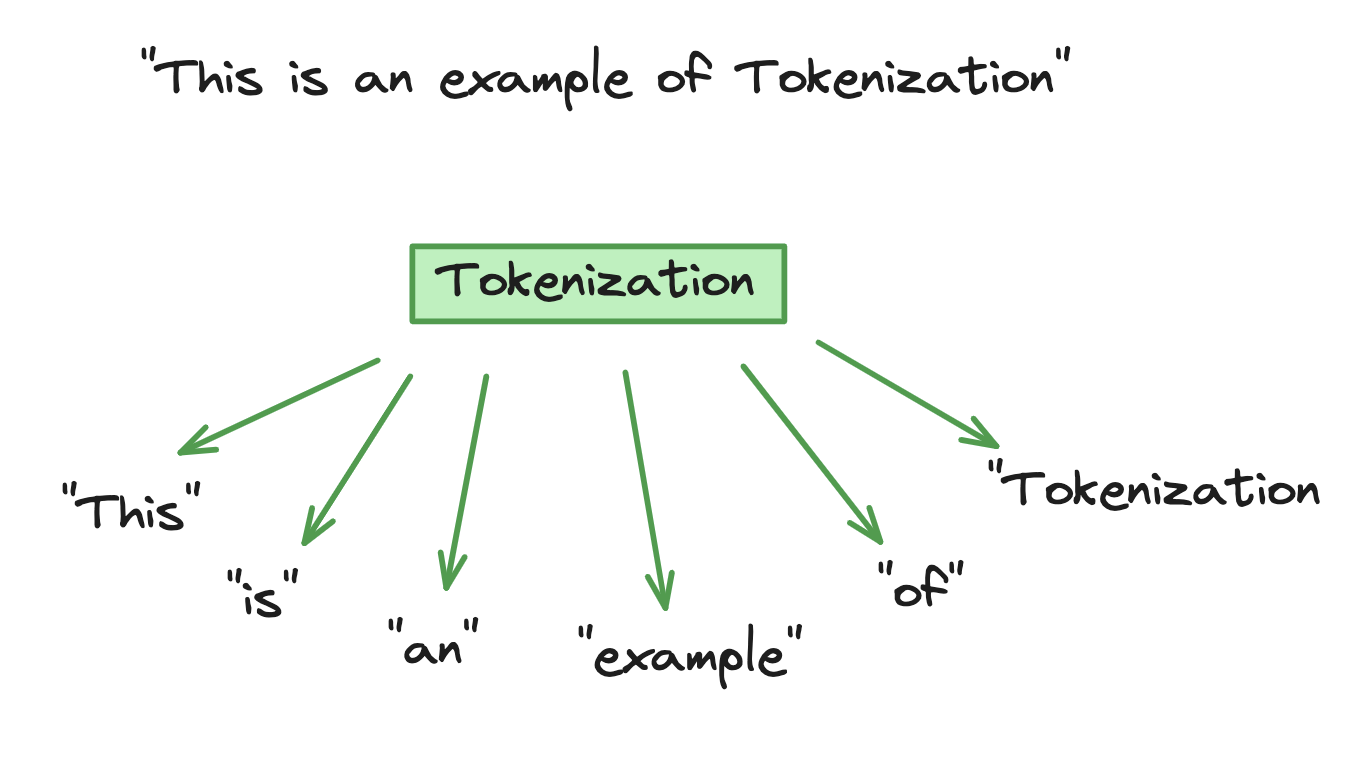
Contoh Tokenisasi
Fase pelatihan terdiri atas memasukkan kumpulan besar data teks ke model untuk membantu model memahami beragam konteks, nuansa, dan gaya linguistik. LLM akan membangun basis pengetahuan sehingga dapat meniru bahasa manusia secara efektif.
Versatilitas dan pemahaman bahasa yang dimiliki LLM menjadi bukti kemampuan AI yang canggih. Dilatih pada dataset ekstensif dari berbagai genre dan gaya, seperti dokumen hukum dan narasi fiksi, LLM memperoleh kemampuan beradaptasi dengan berbagai skenario dan konteks.
Namun, versatilitas LLM melampaui prediksi teks. Kemampuan menangani tugas dalam berbagai bahasa, konteks, dan keluaran adalah bentuk versatilitas yang tampak pada beragam aplikasi adaptif seperti layanan pelanggan. Ini berkat pelatihan ekstensif pada dataset spesifik berskala besar dan proses fine-tuning, yang meningkatkan efektivitasnya di berbagai bidang.
Namun, kita harus ingat tantangan unik LLM: bias.
Seperti kita ketahui, LLM dilatih pada beragam data teks dari berbagai sumber. Saat data dimasukkan ke model, data tersebut menjadi satu-satunya basis pengetahuan dan diinterpretasikan sebagai faktual. Namun, data mungkin mengandung bias serta misinformasi, yang dapat membuat keluaran LLM mencerminkan bias.
Alat yang dikenal mampu meningkatkan produktivitas dan membantu tugas sehari-hari ini menunjukkan area yang memunculkan kekhawatiran etis. Anda dapat mempelajari lebih lanjut tentang etika AI di kursus kami.
Semakin banyak data, semakin baik. Jika data pelatihan yang digunakan untuk LLM mengandung sampel yang tidak representatif atau bias, secara alami model akan mewarisi dan mempelajari bias tersebut. Contoh bias LLM meliputi bias gender, ras, dan budaya.
Sebagai contoh, LLM bisa bias terhadap gender jika mayoritas datanya menunjukkan bahwa perempuan umumnya bekerja sebagai petugas kebersihan atau perawat, sedangkan laki-laki biasanya sebagai insinyur atau CEO. LLM mewarisi stereotip masyarakat karena data pelatihan yang dimasukkan. Contoh lain adalah bias rasial, di mana LLM mungkin mencerminkan kelompok etnis tertentu melalui stereotip, serta bias budaya berupa representasi berlebihan untuk menyesuaikan stereotip.
Dua sumber utama bias pada LLM adalah:
Walaupun LLM sangat serbaguna, tantangan ini menunjukkan bahwa model kurang efektif saat menghadapi konten multikultural. Kekhawatiran seputar LLM dan bias bermuara pada penggunaan LLM dalam proses pengambilan keputusan, yang secara alami menimbulkan isu etika.
Dampak bias pada LLM memengaruhi baik pengguna model maupun masyarakat luas.
Seperti disinggung di atas, ada berbagai jenis stereotip, seperti budaya dan gender. Bias dalam data pelatihan LLM terus memperkuat stereotip yang merugikan, menyebabkan masyarakat terjebak dalam siklus prasangka dan pada akhirnya menghambat kemajuan sosial.
Jika LLM terus mencerna data yang bias, mereka akan terus mendorong perpecahan budaya dan ketidaksetaraan gender.
Diskriminasi adalah perlakuan tidak adil terhadap berbagai kategori orang berdasarkan jenis kelamin, etnis, usia, atau disabilitas. Data pelatihan bisa sangat tidak terwakili, sehingga tidak menunjukkan representasi yang benar atas berbagai kelompok.
Keluaran LLM yang memuat respons bias yang terus melanggengkan diskriminasi ras, gender, dan usia memperburuk dampak negatif bagi kehidupan sehari-hari orang dari komunitas terpinggirkan, misalnya dalam proses rekrutmen hingga kesempatan pendidikan. Hal ini menyebabkan kurangnya keberagaman dan inklusivitas pada keluaran LLM, menimbulkan kekhawatiran etis karena keluaran ini bisa digunakan lebih lanjut dalam proses pengambilan keputusan.
Jika ada kekhawatiran bahwa data pelatihan yang digunakan untuk LLM mengandung sampel yang tidak representatif atau bias, timbul pula pertanyaan apakah data tersebut berisi informasi yang benar. Penyebaran misinformasi atau disinformasi melalui LLM dapat berdampak konsekuensial.
Sebagai contoh, di bidang layanan kesehatan, penggunaan LLM yang mengandung informasi bias dapat mengarah pada keputusan kesehatan yang berbahaya. Contoh lain adalah LLM yang memuat data bias politik dan mendorong narasi tersebut sehingga memicu disinformasi politik.
Kekhawatiran etis seputar LLM bukan satu-satunya alasan mengapa sebagian masyarakat belum menerima baik penerapan sistem AI dalam kehidupan sehari-hari. Sebagian orang memiliki kekhawatiran tentang penggunaan sistem AI dan dampaknya pada masyarakat, misalnya kehilangan pekerjaan dan ketidakstabilan ekonomi.
Sudah ada kurangnya kepercayaan terhadap sistem AI. Karena itu, bias yang dihasilkan LLM dapat sepenuhnya mengikis kepercayaan atau keyakinan yang dimiliki masyarakat terhadap sistem AI secara keseluruhan. Agar teknologi LLM dapat diterima dengan yakin, masyarakat perlu memercayainya.
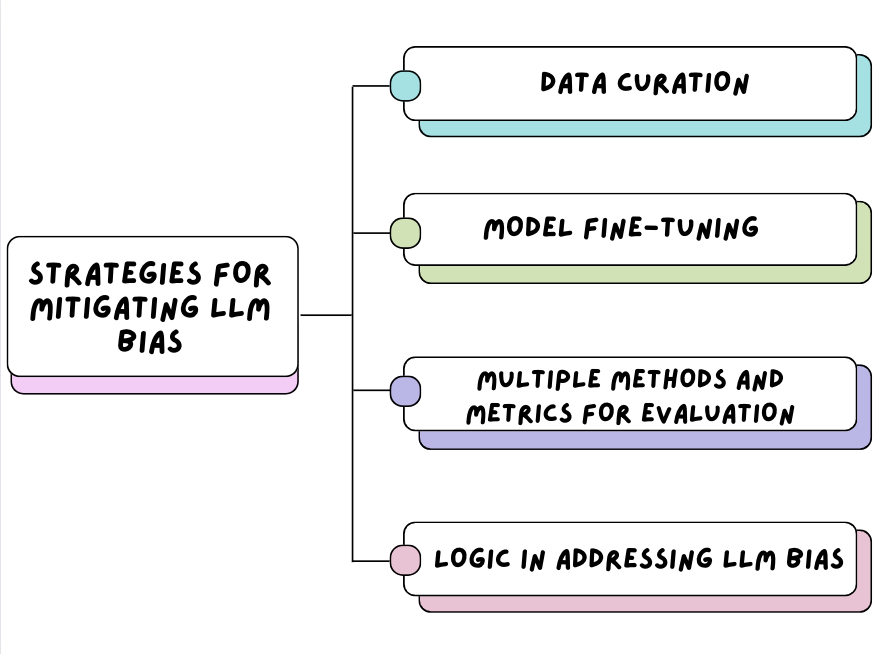
Strategi Mengurangi Bias LLM
Mari mulai dari awal, yakni datanya. Perusahaan harus sangat bertanggung jawab atas jenis data yang mereka masukkan ke dalam model.
Memastikan data pelatihan untuk LLM dikurasi dari beragam sumber data. Dataset teks yang berasal dari berbagai demografi, bahasa, dan budaya akan menyeimbangkan representasi bahasa manusia. Ini memastikan data pelatihan tidak mengandung sampel yang tidak representatif dan memandu upaya fine-tuning model yang terarah, yang dapat mengurangi dampak bias saat digunakan oleh komunitas yang lebih luas.
Setelah ragam sumber data dikumpulkan dan dimasukkan ke model, organisasi dapat terus meningkatkan akurasi dan mengurangi bias melalui fine-tuning model. Ada beberapa pendekatan fine-tuning, seperti:
Anda dapat mempelajari lebih lanjut tentang proses fine-tuning melalui tutorial Fine-Tuning LLaMA 2 kami yang menyajikan panduan langkah demi langkah untuk menyesuaikan model pra-latih.
Agar sistem AI terus berkembang dengan aman dan dapat diintegrasikan ke masyarakat saat ini, organisasi perlu memiliki beragam metode dan metrik dalam proses evaluasi mereka. Sebelum sistem AI seperti LLM dibuka untuk komunitas luas, metode dan metrik yang tepat harus diterapkan untuk memastikan dimensi bias yang berbeda tertangkap pada keluaran LLM.
Contoh metode meliputi evaluasi manusia, evaluasi otomatis, atau evaluasi hibrida. Semua metode ini digunakan untuk mendeteksi, mengestimasi, atau menyaring bias dalam LLM. Contoh metrik meliputi akurasi, sentimen, keadilan, dan lainnya. Metrik ini dapat memberikan umpan balik tentang bias pada keluaran LLM dan membantu terus meningkatkan bias yang terdeteksi dalam LLM.
Jika Anda ingin mempelajari lebih lanjut tentang berbagai evaluasi untuk meningkatkan kualitas LLM, lihat code-along kami tentang Evaluating LLM Responses.
Sebuah studi dari Computer Science and Artificial Intelligence Laboratory (CSAIL) MIT membuat kemajuan signifikan pada LLM dengan mengintegrasikan penalaran logis: Large language models are biased. Can logic help save them?
Pentingnya pemikiran logis dan terstruktur dalam LLM memungkinkan model memproses dan menghasilkan keluaran dengan penerapan penalaran logis dan berpikir kritis sehingga LLM dapat memberikan respons yang lebih akurat beserta alasannya.
Prosesnya terdiri atas membangun model bahasa netral di mana hubungan antar token dianggap ‘netral’ karena tidak ada logika yang menyatakan adanya keterkaitan di antara keduanya. CSAIL melatih metode ini pada model bahasa dan menemukan bahwa model yang baru dilatih menjadi lebih sedikit bias tanpa perlu lebih banyak data dan pelatihan algoritme tambahan.
Model bahasa yang sadar logika akan memiliki kemampuan menghindari produksi stereotip yang berbahaya.
Google Research terus menyempurnakan LLM BERT dengan memperluas data pelatihannya untuk memastikan lebih inklusif dan beragam. Penggunaan dataset besar yang berisi teks tanpa anotasi untuk fase pra-pelatihan memungkinkan model kemudian di-fine-tune agar beradaptasi dengan tugas spesifik. Tujuannya adalah menciptakan LLM yang lebih sedikit bias dan menghasilkan keluaran yang lebih tangguh. Google Research menyatakan bahwa metode ini menunjukkan pengurangan keluaran stereotip yang dihasilkan model dan terus meningkatkan kinerjanya dalam memahami berbagai dialek dan konteks budaya.
Tim Google Research menyusun beberapa alat bernama ‘Fairness Indicators,’ yang bertujuan mendeteksi bias pada model pembelajaran mesin dan melalui proses mitigasi. Indikator ini menggunakan metrik seperti false positive dan false negative untuk mengevaluasi kinerja dan mengidentifikasi kesenjangan yang mungkin tersembunyi oleh metrik umum.
OpenAI memastikan kepada komunitas luas bahwa keselamatan, privasi, dan isu etika menjadi prioritas utama tujuan mereka. Mitigasi pra-pelatihan mereka untuk DALL-E 2 mencakup penyaringan gambar kekerasan dan seksual dari dataset pelatihan, menghapus gambar yang secara visual mirip satu sama lain, lalu mengajarkan model untuk mengurangi dampak dari penyaringan dataset tersebut.
Mencapai satu hal tanpa mengorbankan yang lain terkadang sulit. Ini berlaku saat berupaya menyeimbangkan pengurangan bias LLM sembari menjaga atau bahkan meningkatkan performa model. Debiasing model sangat penting untuk mencapai keadilan. Namun, performa dan akurasi model tidak boleh dikompromikan.
Pendekatan strategis perlu diterapkan untuk memastikan bahwa metode mitigasi pengurangan bias, seperti kurasi data, fine-tuning model, dan penggunaan beragam metode, tidak memengaruhi kemampuan model dalam memahami dan menghasilkan keluaran bahasa. Perbaikan perlu dilakukan; namun, performa model tidak boleh menjadi tumbal.
Ini adalah soal coba-coba, pemantauan dan penyesuaian, debiasing dan peningkatan.
Dalam artikel ini, kami membahas:
Bias LLM adalah tantangan yang kompleks dan multidimensi yang perlu diprioritaskan agar masyarakat lebih memercayainya dan dengan bebas menerima integrasinya dalam tugas sehari-hari. Organisasi perlu memahami dampak negatif jangka panjang yang ditimbulkan stereotip terhadap individu dan masyarakat serta menggunakannya untuk memastikan jalur mitigasi bias LLM melalui kurasi data, fine-tuning model, dan pemodelan logis terbangun.
Untuk mempelajari lebih lanjut tentang LLM, lihat kursus Konsep Large Language Models kami yang membahas bagaimana alat canggih ini membentuk lanskap AI.
Mulai Perjalanan AI Anda Hari Ini!
Program
Kursus
Berlatih dan lacak kemajuan Anda.
Lanjutkan Dengan Googleblogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



