Kursus
Bekerja dengan OpenAI API
3 Hr
173.9K
Perhatian pada model baru Anthropic hanya bertahan sekitar satu jam dalam perlombaan menuju model frontier yang lebih efisien dan terjangkau.
Claude Opus 5.5 mereka adalah model pertama dalam keluarga Claude 5.5, diposisikan sebagai performa setara Fable 5.1 dengan biaya operasional lebih rendah daripada Opus 5.
OpenAI menjawab sangat cepat, merilis GPT-6 Sol sebagai kelas menengah dari keluarga GPT-6, dilatih dengan metode yang sama seperti flagship GPT-6 Astra dan diluncurkan dengan harga API separuh dari pendahulunya, GPT-5.6 Sol.
Dalam artikel ini, saya membandingkan GPT-6 Sol dan Claude Opus 5.5 pada banyak kategori performa, guardrail, dan penetapan harga, serta menyertakan satu uji bangun langsung yang saya jalankan pada keduanya.
GPT-6 Sol adalah model GPT-6 kelas menengah dari OpenAI, dirilis pada 22 September 2026 bersamaan dengan GPT-6 Luna dan diposisikan di bawah flagship GPT-6 Astra.
Keunggulannya adalah resep pelatihan Astra dengan harga API separuh dari GPT-5.6 Sol, dengan caching prompt yang tetap bertahan meskipun terjadi perubahan tingkat penalaran atau alat di tengah percakapan.
Panduan GPT-6 Sol dan Luna kami membahas peluncurannya, dan tutorial API GPT-6 Astra kami menjelaskan alat asinkron keluarga ini dan pengarahannya.
Claude Opus 5.5 adalah model Claude 5.5 pertama dari Anthropic, dirilis pada 22 September 2026, sebagai model terdepan perusahaan untuk coding agentik jangka panjang dan pekerjaan berbasis pengetahuan.
Keunggulannya adalah hasil kelas Fable dengan harga Opus: Anthropic menyatakan model ini menyamai Claude Fable 5.1 pada sebagian besar pekerjaan, dan hadir dengan pengaman siber dan biologi kelas Fable.
Panduan Opus 5.5 kami membahas peluncurannya, dan tutorial API Claude Opus 5 kami membahas API generasi sebelumnya.
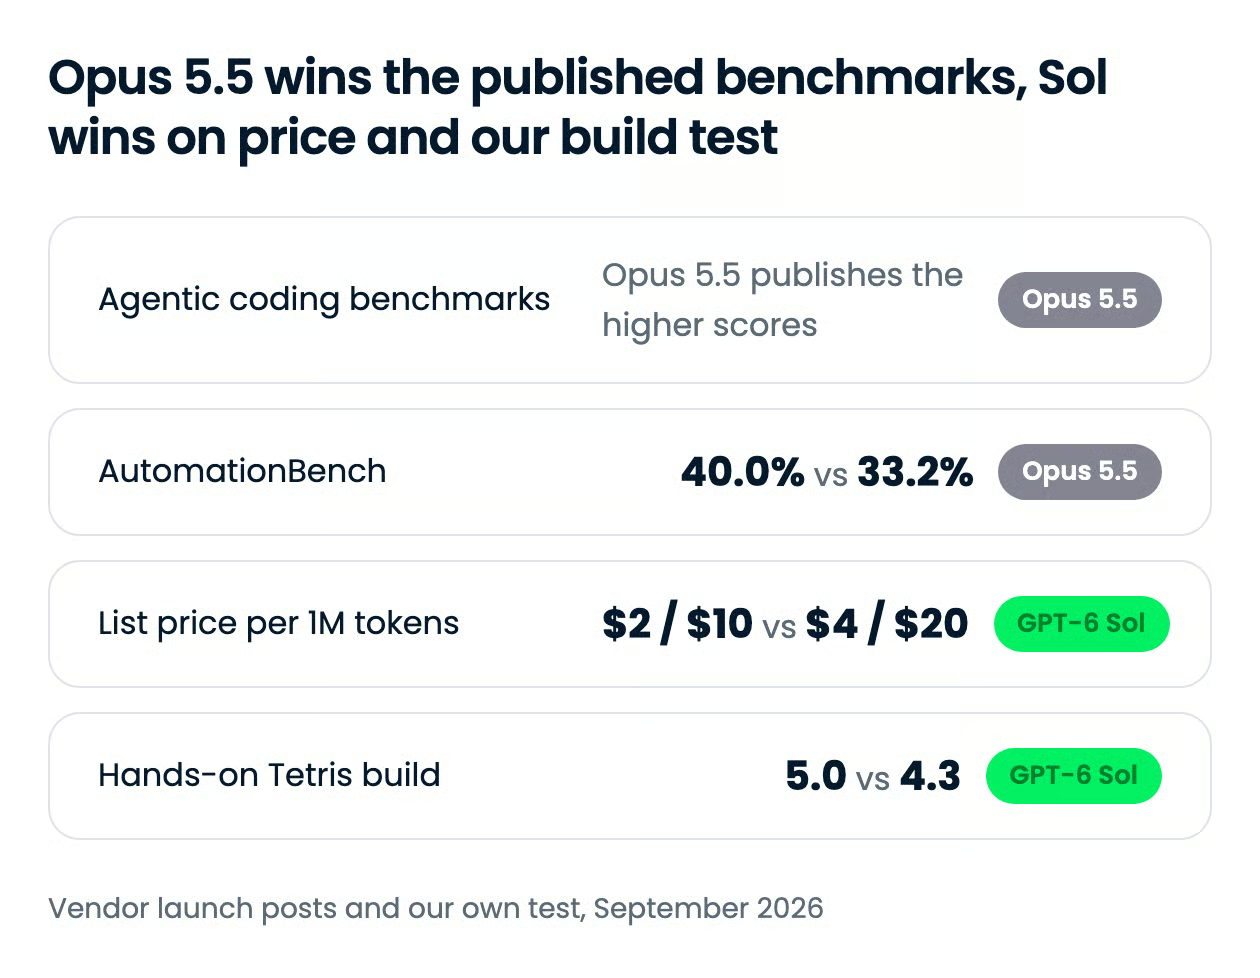
Karena waktu rilis yang berdekatan, tidak ada vendor yang memasukkan model baru lawannya dalam tabel peluncuran, sehingga kedua model hanya tumpang tindih pada dua tolok ukur, dan Opus 5.5 memimpin keduanya. Argumen Sol bertumpu pada harga dan pada bagaimana ia bertahan dalam uji kami sendiri.
| Fitur | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Tolok ukur agentic coding | DeepSWE v1.1 68,8% pada effort maksimum; "menyamai Claude Fable 5.1" pada FrontierCode, tanpa angka dipublikasikan | Terminal-Bench 4.0 66,4%, FrontierCode v1.1 54,4%, CursorBench 4.0 57,8% |
| AutomationBench (bersama) | 33,2% pada xhigh effort, $0,27 per tugas | 40,0% (run oleh Zapier, tanpa model fallback) |
| OSWorld 2.0, skor parsial (bersama) | 60,5% pada set offline di xhigh effort | 81,8% |
| Pekerjaan pengetahuan | Sekitar separuh kesalahan faktual GPT-5.6 Sol pada evaluasi internal OpenAI | GDPval-AA v2.1 1846 Elo, di atas GPT-6 Astra dan GPT-5.6 Sol |
| Jendela konteks / output maks | 1,05M token / 128K | 1M token / 128K |
| Harga daftar per 1M token | $2 input / $10 output | $4 input / $20 output |
| Guardrail | Effort dari none ke max; lebih sedikit klaim menyesatkan tentang pekerjaan coding-nya dibanding GPT-5.6 Sol |
Pemikiran tidak dapat dimatikan; sebagian besar tugas keamanan siber dialihkan ke Opus 4.8 |
| Uji bangun Tetris kami (rata-rata tiga sumbu) | 5,0 | 4,3 |
Opus 5.5 mempublikasikan angka agentic-coding yang lebih kuat, dan tulisan Sol tidak menentangnya secara langsung. Anthropic melaporkan Opus 5.5 pada Terminal-Bench 4.0, FrontierCode, dan CursorBench; OpenAI melaporkan Sol pada DeepSWE dan hanya menggambarkan hasil FrontierCode-nya sebagai menyamai Claude Fable 5.1 pada xhigh effort. Anthropic menempatkan Fable 5.1 pada 50,3% di FrontierCode melawan 54,4% untuk Opus 5.5, jadi jika keduanya benar, Sol berada sekitar empat poin di belakang Opus 5.5 pada satu tolok ukur coding yang keduanya sebut.
| Tolok ukur | GPT-6 Sol | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| Terminal-Bench 4.0 | Tidak dipublikasikan | 66,4% (xhigh) | Dijalankan oleh Anthropic; GPT-6 Astra 57,9% dan GPT-5.6 Sol 37,3% seperti dilaporkan OpenAI |
| FrontierCode v1.1 Main | Tidak dipublikasikan; "menyamai Claude Fable 5.1 xhigh" | 54,4% | Anthropic menilai Fable 5.1 pada 50,3%; dinilai pada kemampuan merge, bukan hanya kebenaran |
| CursorBench 4.0 | Tidak dipublikasikan | 57,8% | Dijalankan oleh Anthropic; GPT-5.6 Sol 41,7% |
| DeepSWE v1.1 | 68,8% (maks) | Tidak dipublikasikan | Dijalankan oleh OpenAI; skor terbaik Claude Fable 5 adalah 69,9% pada xhigh |
Kedua vendor bertumpu pada anekdot jangka panjang alih-alih skor bersama. Penulisan ulang HAProxy internal Anthropic dari C ke Rust membuat Opus 5.5 selesai dalam 9,5 jam dibanding 12 jam untuk Fable 5.1 dengan biaya 51% lebih rendah. Argumen OpenAI adalah biaya per tugas: Sol berada sekitar satu poin dari skor DeepSWE Fable 5 dengan biaya sekitar 80% lebih rendah.
Dua alasan untuk mengambil tabel ini dengan hati-hati:
Di atas kertas, Opus 5.5 adalah model coding yang lebih kuat; uji bangun tunggal kami di bawah ini adalah tempat di mana kesenjangan itu tidak tampak.
Opus 5.5 memimpin kedua tolok ukur yang sama-sama dimiliki, dan selisih di AutomationBench adalah angka paling bersih dalam artikel ini: 40,0% untuk Opus 5.5 melawan 33,2% untuk Sol pada uji Zapier terhadap agen yang bekerja lintas 47 alat bisnis.
Tandingan Sol adalah tagihan: OpenAI membingkai Sol sebagai mengalahkan Claude Opus 5 pada 9% dari biaya per tugas Opus 5, meski perbandingan itu dengan Opus sebelumnya, bukan yang ini.
| Tolok ukur | GPT-6 Sol | Claude Opus 5.5 | Catatan |
|---|---|---|---|
| AutomationBench | 33,2% (xhigh), $0,27 per tugas | 40,0% | Angka Opus 5.5 dari run akses awal Zapier tanpa model fallback; angka Sol dari OpenAI |
| OSWorld 2.0 (parsial) | 60,5% (set offline, xhigh) | 81,8% | Subset dan pengaturan effort berbeda; OpenAI menyebut Astra tetap menjadi model penggunaan komputer terbaiknya |
| Agents' Last Exam | 56,4% (maks) | Tidak dipublikasikan | OpenAI menyebut ini mengungguli skor terbaik Claude Opus 5 dengan biaya per tugas 60% lebih rendah |
Opus 5.5 adalah agen yang lebih kuat pada skor; Sol adalah yang dapat Anda jalankan pada setiap tiket.
Opus 5.5 memegang satu-satunya angka lintas vendor di sini: 1846 Elo pada GDPval-AA v2.1, di atas skor GPT-6 Astra dan GPT-5.6 Sol dalam tabel Anthropic; Sol sendiri tidak tercantum. Dalam uji penulisan laporan Anthropic, di mana angka yang dibuat-buat menggagalkan run, 16 dari 18 laporan Opus 5.5 lulus, dan baik Fable 5.1 maupun Opus 5 tidak sekali pun lulus.
Bukti Sol adalah melawan pendahulunya sendiri: pada set faktualitas internal OpenAI, Sol membuat sekitar setengah kesalahan GPT-5.6 Sol. Uji AA-Omniscience dari Artificial Analysis sependapat, dengan catatan: laju halusinasi Sol turun dari 92% ke 60% sementara ia menjawab hanya 83% pertanyaan dibanding 99% pendahulunya.
Keduanya lebih hati-hati daripada pendahulunya; hanya Opus 5.5 yang telah menunjukkannya melawan rival.
Sol adalah API yang kurang terbatasi, dan Opus 5.5 lebih diawasi.
Opus 5.5 tidak dapat berjalan dengan pemikiran dimatikan, menolak pemaksaan penggunaan alat, dan mengikat blok pemikiran pada model dan percakapan yang menghasilkannya, sehingga konteks yang diedit gagal dengan error 400 pada akun yang dibuat setelah 31 Agustus 2026. Sebagian besar tugas keamanan siber dialihkan ke Opus 4.8 di luar Cyber Verification Program, dan pekerjaan biologi memerlukan Life Sciences Verification Program.
Tangga effort Sol berjalan dari none hingga max, effort dapat berubah di tengah percakapan tanpa merusak cache, dan OpenAI melaporkan lebih sedikit klaim menyesatkan tentang pekerjaan coding-nya dibanding GPT-5.6 Sol.
Trade-off ini disengaja: Opus 5.5 mencoba menembus batas penahanan sekitar 85% lebih jarang daripada Opus 5, yang penting untuk agen tanpa pengawasan.
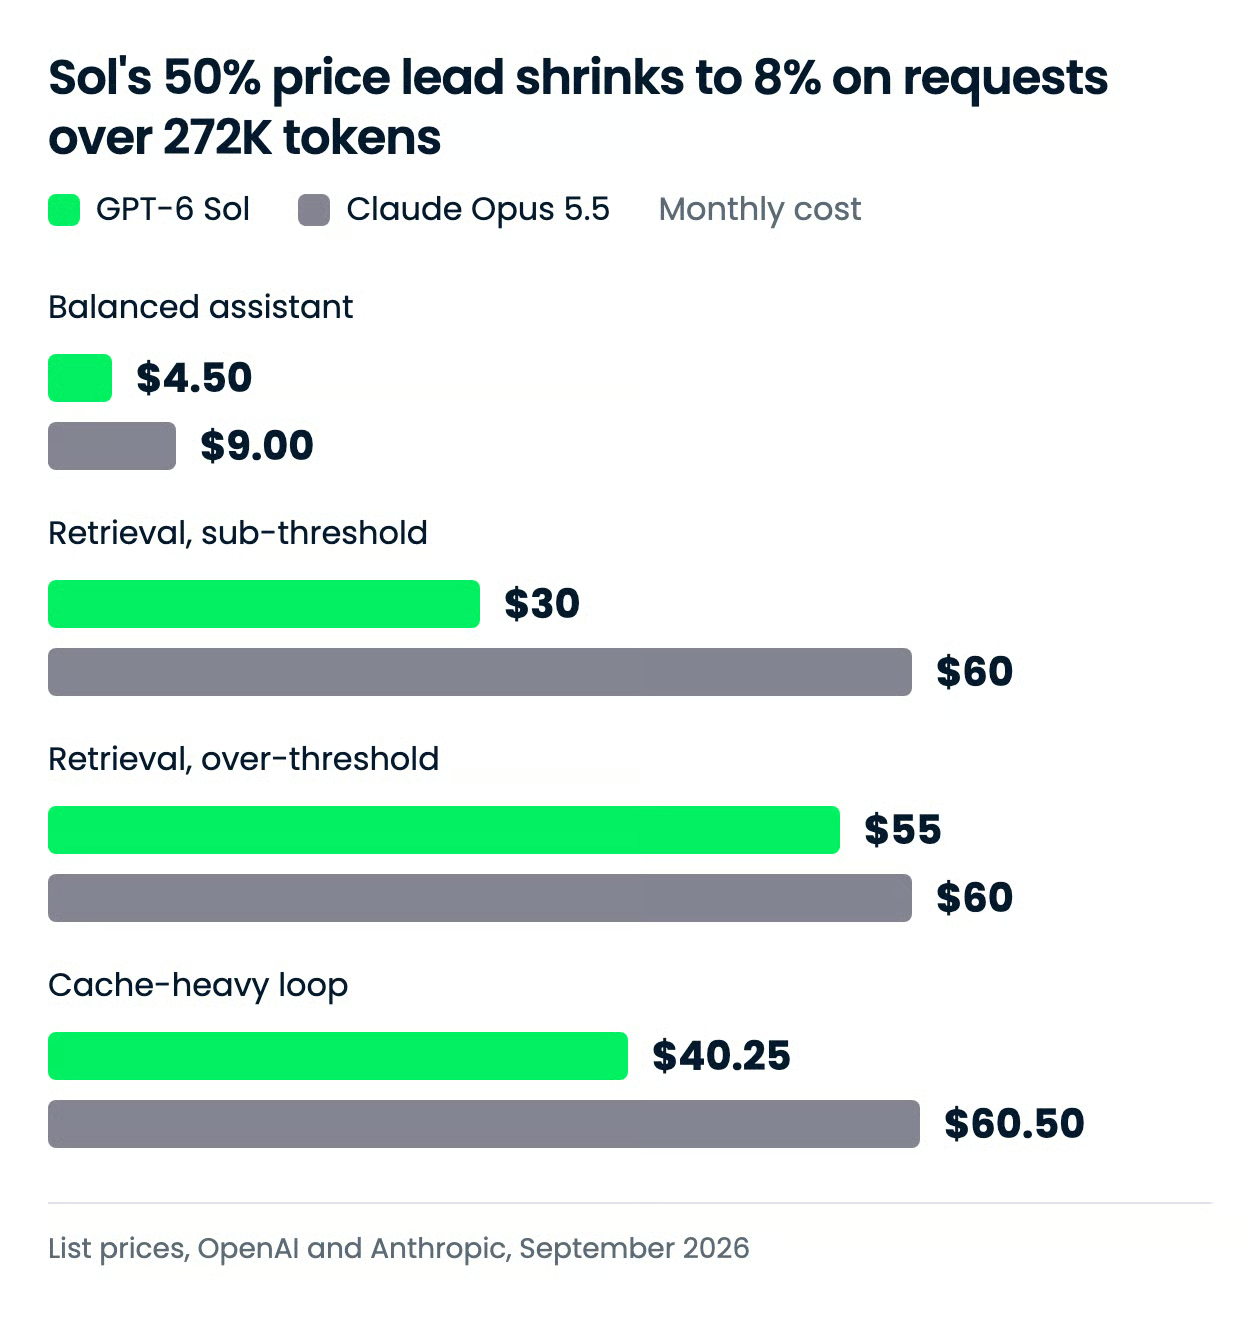
Opus 5.5 berharga tepat dua kali Sol pada tarif utama, tetapi dua mekanisme yang benar-benar dibayar agen mematahkan pola ini: pembacaan cache harganya sama, dan Sol menambahkan biaya tambahan di atas 272K token yang tidak dimiliki Anthropic.
| Tarif | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Input, per 1M token | $2,00 | $4,00 |
| Output, per 1M token | $10,00 | $20,00 |
| Pembacaan input cache, per 1M token | $0,20 | $0,20 |
| Penulisan cache, per 1M token | $2,50 | $5,00 (5 menit) atau $8,00 (1 jam) |
| Diskon batch | 50% (Batch dan Flex) | 50% |
| Harga konteks panjang | Di atas 272K token input: 2x tarif input dan cache, 1,5x output, untuk seluruh permintaan | Jendela penuh 1M pada tarif standar |
| Mode cepat | 2x tarif yang berlaku | $8,00 input / $40,00 output, hingga 2,5x kecepatan |
| Paket konsumen | ChatGPT Work dan Codex pada Plus, Pro, Business, Enterprise, dan Edu | Aplikasi Claude; batas dinaikkan pada Pro, Max, Team, dan Enterprise saat peluncuran |
Premi rata di seluruh input, output, dan penulisan cache, jadi ini menyakiti semua bentuk beban kerja secara setara sampai caching atau konteks panjang berperan. Pembacaan cache adalah pengecualian, dan Anthropic menyebut itu membentuk sebagian besar biaya pekerjaan agentik dan coding. Tidak ada vendor yang mempublikasikan tarif terpisah untuk token penalaran, jadi anggarkan pada tarif output.
| Beban kerja | GPT-6 Sol | Claude Opus 5.5 | Perbedaan |
|---|---|---|---|
| Asisten seimbang: 1M masuk / 250K keluar | $4,50 | $9,00 | $4,50 (50%) |
| Retrieval, di bawah ambang: 10M masuk / 1M keluar, permintaan di bawah 272K | $30 | $60 | $30 (50%) |
| Retrieval, di atas ambang: 10M masuk / 1M keluar, permintaan di atas 272K | $55 | $60 | $5 (8%) |
| Loop berat-cache: prefix 100K ditulis sekali, 1.000 pembacaan cache, 5K masuk baru / 1K keluar per permintaan | $40,25 | $60,50 | $20,25 (33%) |
Baris di atas ambang adalah intinya: begitu setiap permintaan melewati ambang, biaya tambahan Sol mengangkat tagihannya hingga dalam 8% dari Opus 5.5, sehingga pipeline retrieval konteks panjang hampir tidak mendapat diskon bila memilih Sol. Loop berat-cache mempersempit kesenjangan menjadi 33% karena alasan berbeda: 1.000 pembacaan cache berbiaya sama pada kedua model, dan hanya token baru yang membawa premi 2x.
Kedua model menggunakan tokenizer yang berbeda, dan tidak ada vendor yang mempublikasikan hitungan token untuk beban kerja bersama, jadi anggap total ini sebagai perbandingan tarif, bukan tagihan. Anthropic menyebut Opus 5.5 menggunakan lebih sedikit token per tugas daripada Opus 5, meski tidak membandingkannya dengan Sol.
Tolok ukur dari dua vendor yang tidak menguji model baru satu sama lain hanya sejauh itu, jadi saya menjalankan satu tugas bangun terhadap keduanya dengan prompt dan tooling yang identik.
Saya meminta keduanya membangun klon Tetris satu-berkas pada papan 12×24 dengan satu twist: gravitasi berbalik setiap 20 detik. Dua hal yang diminta prompt membuatnya sulit: setelah berbalik, kepingan harus jatuh ke arah langit-langit dan mengunci pada tumpukan kedua di sana, dengan baris penuh dibersihkan pada salah satu tumpukan, dan sel yang sudah terkunci tidak boleh pernah bergerak.
Kedua model berjalan di dalam OpenCode dengan permukaan alat yang dipasangkan identik: hanya pembacaan, pencarian, dan pengeditan berkas, tanpa shell dan tanpa jaringan. Keduanya berjalan pada tingkat penalaran high, satu percobaan masing-masing, tanpa ulang, dan prompt dikirim byte-untuk-byte ke sesi baru.
Satu asimetri untuk diingat: high berada dua anak tangga di bawah langit-langit pada kedua tangga, tetapi tangga Sol memiliki satu anak tangga none ekstra di bawah, jadi high adalah posisi keempat dari enam pengaturan dan posisi ketiga dari lima pada Opus 5.5.
Inilah prompt-nya:
Build a single-file HTML page (inline CSS and JS, canvas, no build step, no external dependencies, no network) that is a playable Tetris clone with one twist: gravity flips every 20 seconds. It needs:
- a 12×24 board, the seven tetrominoes, rotation, left/right movement, soft drop, hard drop, line clears, a score, and a game-over state, controlled with the arrow keys and the space bar;
- the twist: every 20 seconds the direction of gravity flips between down and up. Pieces then fall toward the ceiling, land on the stack that has formed there, and full rows clear on either stack. Pieces already locked in place never move when gravity flips;
- a visible gravity indicator (an arrow showing the current direction) and a countdown to the next flip, both always on screen;
- a fixed starting position: the board loads with the same flat four-row stack already locked on the floor (a few gaps, no complete rows), so the flip has a stack to leave behind;
- a fixed seed for the piece sequence, so two loads produce the same game;
- autoplay on load: with no key pressed, a simple built-in player plays at the normal starting speed of about one row per second, sliding each piece without rotating into the column where the stack it is falling toward is currently lowest (the leftmost such column on a tie) and letting it fall — never a hard drop — so pieces are seen falling the moment the page opens. Any key press hands control to the keyboard for the rest of the game;
- the whole board, indicator and countdown fit in one viewport of about 1440×900 without scrolling.

Ship it as one working file named `index.html`. Do not install packages. Do not open, screenshot, or headless-render the page (no Playwright, Puppeteer, or Chrome). Do not ask me clarifying questions — make reasonable assumptions and note them briefly in a comment at the top of the file.
Saya mencatat biaya dan menilai keduanya pada tiga rubrik berikut, dengan skor 1 hingga 5:
Sol membutuhkan 6 giliran dan 9 panggilan alat: ia membuat daftar, mencari, dan membaca ruang kerja kosong sebelum menulis index.html berukuran 22 KB, lalu menambalnya sekali lagi. Hasilnya memiliki branding sendiri, "Fall / Rise, a game of shifting ground", dengan panel gravitasi yang berubah warna dari amber ke teal saat flip, hitung mundur ke inversi berikutnya, dan kartu aturan di margin.
Ia melakukan apa yang seharusnya dan bekerja dengan mulus serta stabil: tumpukan lantai tetap di tempat saat flip, kepingan naik dan mengunci di langit-langit, baris dibersihkan pada kedua tumpukan, dan soft drop terasa responsif, yang membuatnya lebih menyenangkan dimainkan dibanding yang satu lagi.
Model ini juga menambahkan penghitung level yang tidak diminta siapa pun, dan saya menganggapnya impas alih-alih nilai tambah: level naik cukup lambat sehingga tidak berdampak hingga jauh ke dalam permainan melebihi yang realistis bagi kedua build ini. Kekurangan Opus ada pada feel, bukan logika: tata letaknya lebih sederhana daripada Sol dan soft drop kurang halus, sehingga kehilangan satu poin pada kualitas visual dan satu pada kelengkapan.
| Ukuran | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Giliran | 6 | 3 |
| Panggilan alat | 9 | 2 |
| Biaya | $0,26 | $0,87 |
| Total token | 120.226 | 107.958 |
| Token penalaran | 8.123 | 22.551 |
| Keterjalankan | lulus | lulus |
| Mekanika flip | 5 | 5 |
| Kelengkapan gim | 5 | 4 |
| Kualitas visual dan feel | 5 | 4 |
| Skor rubrik (rata-rata tiga sumbu) | 5 | 4,3 |
GPT-6 Sol memenangkan uji ini, tetapi tipis, dan bukan pada bagian tersulitnya. Keduanya berhasil pada flip gravitasi, jadi marginnya bergantung pada craft, dan responsivitas serta kerapian visual Sol memberinya keunggulan atas Opus.
Yang membedakan mereka lebih tajam adalah biaya run. Opus 5.5 menghabiskan $0,87 melawan $0,26 milik Sol, lebih dari tiga kali lipat, dan itu dilakukan pada lebih sedikit total token: 108k melawan 120k. Perbedaannya ada pada penalaran: Opus berpikir kira-kira tiga kali lebih keras per giliran, mencapai build yang benar dalam setengah giliran, dan berhenti. Sol beriterasi di dalam berkas, dengan murah, dan keluar sedikit unggul pada feel.
Ini adalah satu run dari satu tugas pada satu pengaturan effort, dan ini menguji logika game-loop dalam satu berkas, bukan pekerjaan repositori jangka panjang yang dijadikan tolok ukur oleh kedua vendor. Angka biaya adalah satu titik data masing-masing, bukan rata-rata.
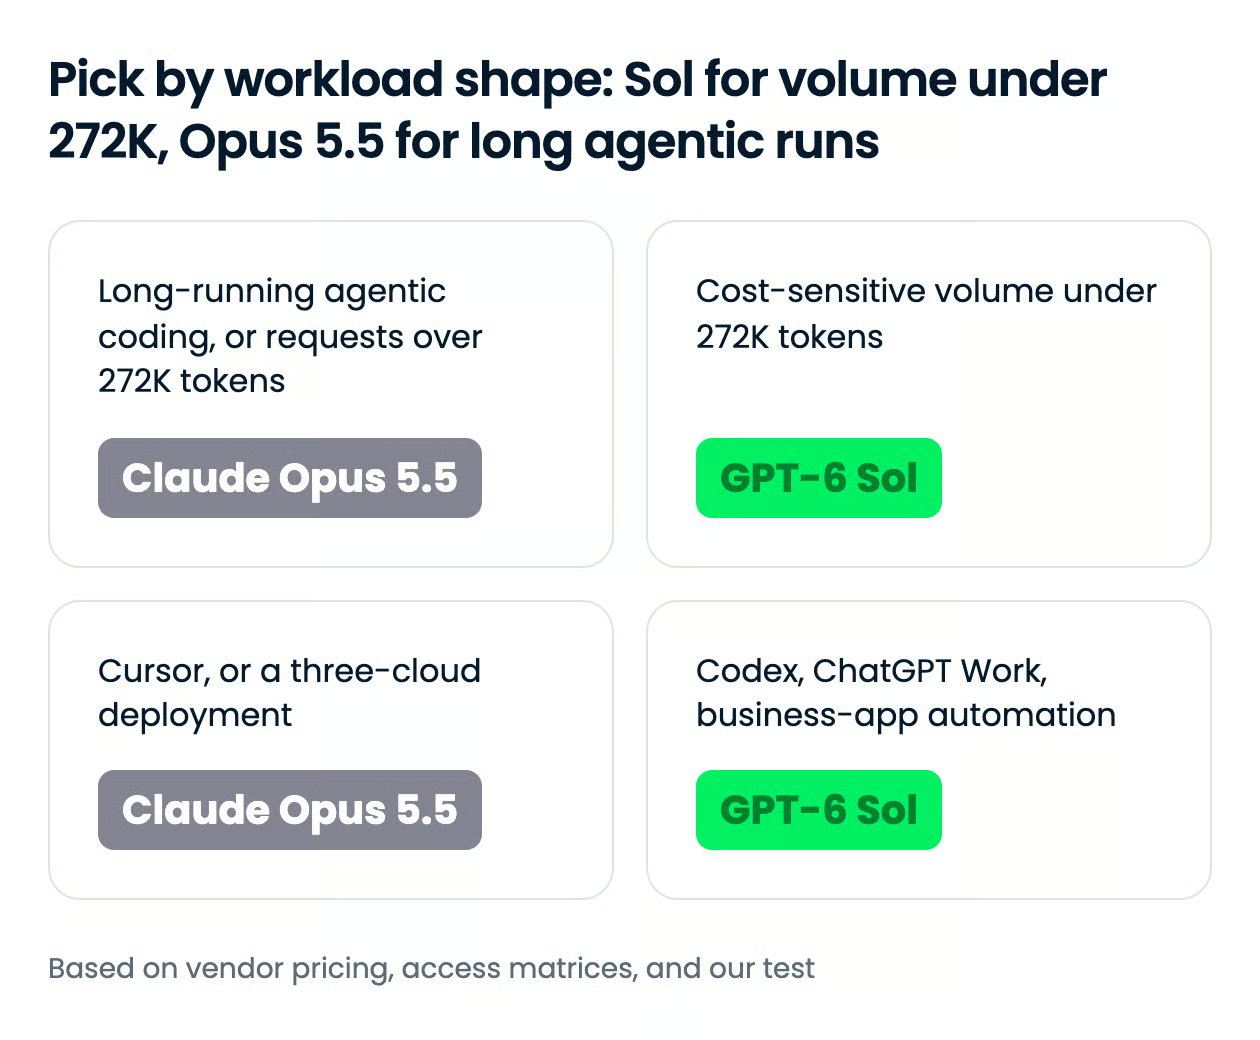
Pemisahnya adalah ukuran permintaan dan bentuk beban kerja alih-alih kemampuan mentah: di bawah 272K token per permintaan, diskon Sol nyata; di atas itu, atau pada loop yang berat cache, dua tagihan mendekat, dan keunggulan Opus 5.5 yang dipublikasikan pada pekerjaan agentik adalah hal yang Anda bayar.
none Sol dan perubahan effort yang aman terhadap cache memungkinkan agen menjalankan tindak lanjut murah dan meningkatkan hanya pada langkah sulit.| Permukaan | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|
| Aplikasi konsumen | ChatGPT Work dan Codex pada paket Plus, Pro, Business, Enterprise, dan Edu; belum ada di Chat konsumen ChatGPT | Aplikasi Claude; batas penggunaan dinaikkan pada paket Pro, Max, Team, dan Enterprise saat peluncuran |
| API pihak pertama | Ya, OpenAI API (Responses API direkomendasikan) | Ya, Claude API |
| Platform cloud | Azure AI Foundry, AWS Bedrock | AWS Bedrock, Google Cloud Vertex AI, Microsoft Foundry |
| Agen coding | Codex, GitHub Copilot | Claude Code, Cursor, GitHub Copilot |
| Router pihak ketiga | OpenRouter, Vercel AI Gateway | OpenRouter, Vercel AI Gateway |
| ID model API | gpt-6-sol |
claude-opus-5-5 |
Opus 5.5 diluncurkan di ketiga cloud besar dan di Cursor pada hari pertama, sementara Sol berada di dua cloud dan belum muncul di daftar model Cursor. Pada API, string-nya adalah gpt-6-sol dan claude-opus-5-5.
Setiap model hadir di dalam agen milik vendornya, Codex untuk Sol dan Claude Code untuk Opus 5.5, dan keduanya dapat dipilih di GitHub Copilot. Jika Anda menginginkan satu harness untuk keduanya, agen berbasis router seperti OpenCode menjangkaunya melalui OpenRouter sebagai openai/gpt-6-sol dan anthropic/claude-opus-5.5, yang merupakan cara uji kami menjalankannya dengan tooling identik.
Pemanggilan API langsung menggunakan SDK berbeda, jadi penggantiannya adalah klien dan string model, bukan satu baris semata:
from openai import OpenAI

client = OpenAI()
response = client.responses.create(
    model="gpt-6-sol",
    reasoning={"effort": "high"},
    input="Refactor this module and explain what you changed.",
)
print(response.output_text)
from anthropic import Anthropic
client = Anthropic()
response = client.messages.create(
model="claude-opus-5-5",
max_tokens=4096,
messages=[{"role": "user", "content": "Refactor this module and explain what you changed."}],
)
print(response.content[0].text)Untuk setup agen lengkap, tutorial CLI Codex dan tutorial Claude Code kami membahas instalasi dan alur kerja, dan perbandingan Codex vs Claude Code kami menimbang harness keduanya.
Jika beban kerja Anda adalah coding agentik panjang, atau permintaan Anda melewati ambang konteks panjang, gunakan Claude Opus 5.5: ia mempublikasikan angka agentik yang lebih kuat, dan harganya tidak menghukum permintaan besar. Jika Anda menjalankan volume di bawah ambang tersebut, bekerja di Codex atau ChatGPT Work, atau mengotomasi aplikasi bisnis dengan anggaran, gunakan GPT-6 Sol dan simpan selisihnya.
Yang paling menarik bagi saya adalah tidak ada vendor yang mampu memasukkan model baru lawannya dalam tabelnya, dan pada satu tempat di mana kami bisa membandingkannya sendiri, sebuah build mandiri, model yang lebih murah unggul pada kerapian.
Jika Anda ingin membangun dengan salah satu model, saya merekomendasikan kursus Working with the OpenAI API dan Introduction to Claude Models kami.
Belajar AI Bersama DataCamp!
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt