
Kursus
Pengantar AI untuk Pekerjaan
2 jam
127.2K
OpenAI telah meluncurkan GPT-6 Astra, yang disebutnya sebagai model paling cerdas dan selaras di dunia.
Astra hadir di lapisan frontier yang padat, di mana Claude Fable 5.1 (dirilis 1 September 2026) dan Claude Opus 5 dari Anthropic menjadi acuan untuk pengkodean dan kerja agen.
Klaim utamanya cukup agresif.
Astra menembus FrontierMath Tier 4 dengan skor 97,6%, menembus ARC-AGI-3 dengan skor 99,9% di bawah provider adapter harness milik OpenAI, dan meraih 100% pada ExploitBench. Ia juga menetapkan standar baru pada penggunaan komputer dan peramban, mencetak 72,6% pada OSWorld 2.0 dengan waktu per tugas sekitar 47% lebih singkat daripada pendahulunya, GPT-5.6 Sol.
Baik ARC-AGI-3 maupun FrontierMath Tier 4 dirancang khusus untuk tetap selangkah di depan kemampuan AI, jadi menembusnya memberi sinyal sesuatu yang secara kualitatif berbeda dari sekadar memuncaki papan peringkat standar.
Di artikel ini, saya akan membahas semua hal baru di GPT-6 Astra, meninjau fitur-fitur barunya, mengeksplorasi tolok ukur, dan melihat beberapa contoh kasus penggunaan.
Jika Anda ingin melihat modelnya beraksi, ikuti tutorial API GPT-6 Astra kami dan lihat beberapa proyek GPT-6 Astra yang bisa Anda coba. Untuk melihat perbandingannya dengan kompetitor, baca perbandingan kami antara GPT-6 Astra dan Claude Fable 5.1. Saya juga menyarankan membaca panduan kami tentang belajar Claude, serta liputan kami tentang model Jev System One yang baru beserta perbandingan Jev vs GPT-6 Astra.
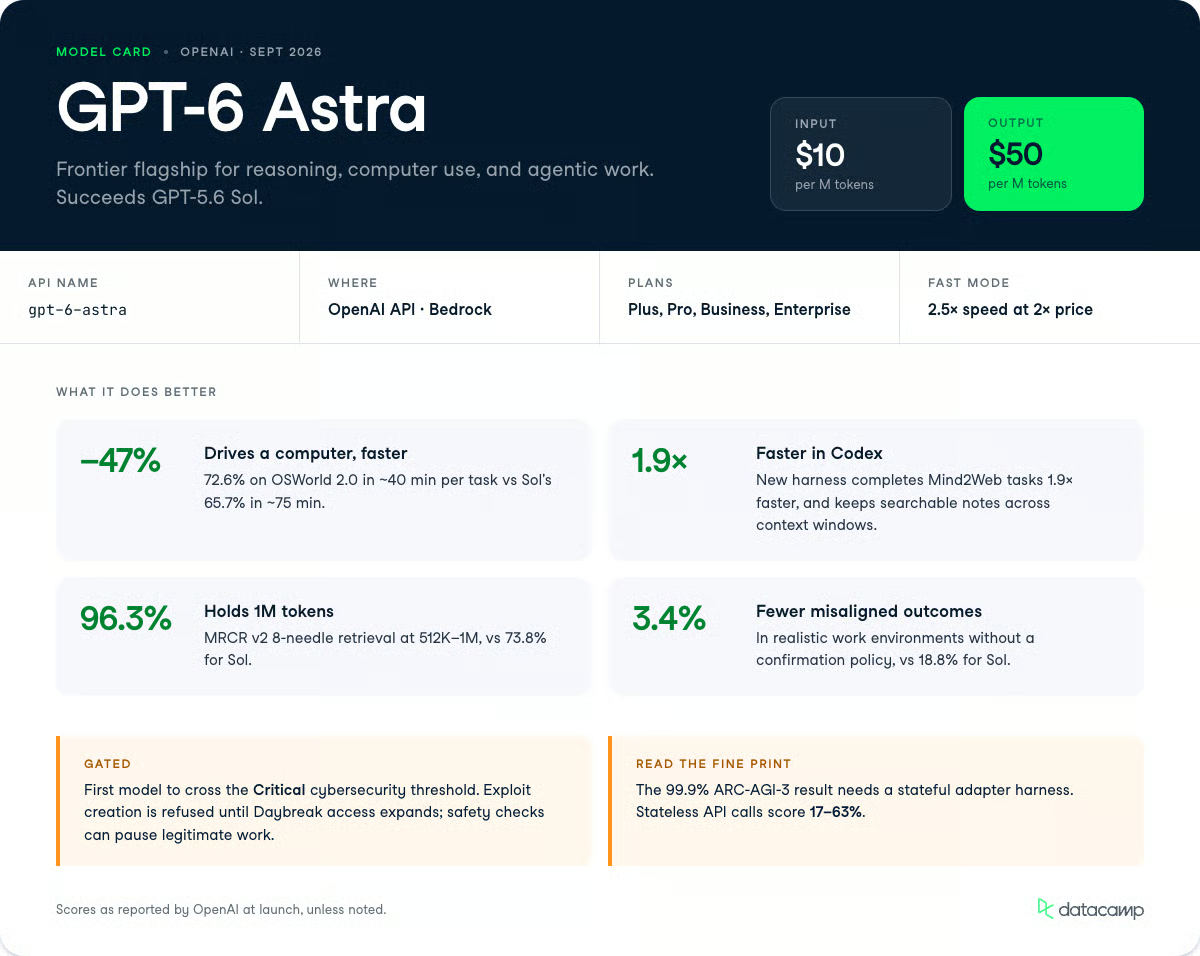
GPT-6 Astra adalah flagship frontier baru OpenAI, penerus GPT-5.6 Sol sebagai model teratas untuk penalaran, penggunaan komputer, dan kerja agen.
OpenAI memposisikannya pada tiga area:
Tolok ukur yang paling berguna bagi praktisi adalah OSWorld 2.0, di mana Astra mencetak 72,6% dalam sekitar 40 menit per tugas, dibandingkan GPT-5.6 Sol yang 65,7% dalam sekitar 75 menit.
Kombinasi akurasi lebih tinggi dan waktu penyelesaian lebih singkat adalah perbedaan antara agen yang harus diawasi dan agen yang bisa Anda delegasikan tugasnya.
Astra hadir bersama harness Codex yang diperbarui yang menurut OpenAI memberikan penyelesaian tugas 1,9x lebih cepat dibanding pengalaman GPT-5.6 Sol saat ini pada tolok ukur Mind2Web.
Model ini tersedia sebagai gpt-6-astra di OpenAI API dan melalui Amazon Bedrock, dengan tier GPT-6 Astra Pro untuk paket Pro, Business, dan Enterprise.
Jika Anda juga tertarik pada model terbaru OpenAI di tier yang lebih rendah, lihat panduan GPT-6 Sol dan Luna kami.
Perubahan Astra berpusat pada eksekusi agen: menggunakan komputer, menghasilkan artefak profesional yang selesai, menjaga konteks di sesi pengkodean panjang, dan tetap dalam batas kewenangan.
Berikut kemampuan yang menonjol.
Astra dapat mengoperasikan komputer secara langsung, menangani pekerjaan bertele-tele multi-langkah yang biasanya menghabiskan satu siang.
Beberapa contoh yang bagus meliputi:
Pada simulasi latensi di OSWorld 2.0, Astra mencapai 72,6% dalam sekitar 40 menit per tugas dibanding GPT-5.6 Sol yang 65,7% dalam sekitar 75 menit, pemangkasan waktu per tugas sebesar 47%.
OSWorld 2.0 mengukur apakah model benar-benar dapat mengoperasikan komputer, seperti menavigasi antarmuka nyata, mengklik, mengetik, dan menyelesaikan tugas multi-langkah sebagaimana manusia.
Pemangkasan 47% waktu per tugas sama pentingnya dengan kenaikan akurasi karena biaya agen berskala dengan waktu dinding; model yang selesai dalam 40 menit alih-alih 75 bukan hanya lebih cepat, tetapi kira-kira setengah harga untuk beban kerja yang sama.
Meski begitu, pengujian independen ARC Prize menunjukkan angka utama penggunaan komputer dan penalaran Astra sangat bergantung pada harness.
Pada ARC-AGI-3, harness stateless standar menghasilkan skor sekitar 17% hingga 63% tergantung tier penalaran, sementara provider adapter harness yang mempertahankan status penalaran mencapai ~99,9% seperti yang dipasarkan.
Jika Anda memanggil model secara stateless, harapkan angka lebih rendah daripada grafik peluncuran.
Astra dilatih untuk menghasilkan artefak profesional yang rapi dan mengikuti templat Anda alih-alih draf awal generik.
Ia membuat dokumen, presentasi, spreadsheet, dan analisis yang cocok dengan gaya tulisan dan visual Anda, serta hanya menarik konteks yang relevan ke output alih-alih menjejalkannya dengan semua yang ia tahu.
Demo OpenAI menunjukkan Astra membangun dek slide tentang model fiksi dari beberapa slide templat, menjaga nada dan tata letak tetap konsisten.
Bagi siapa pun yang pernah menghabiskan satu jam memformat ulang dump markdown LLM ke templat perusahaan, kepatuhan pada templat adalah bagian yang paling ingin saya uji terlebih dahulu.
Dengan Sites di ChatGPT, Astra dapat membuat, meng-host, dan membagikan situs web, aplikasi web, dan gim langsung dari prompt, menerapkan penilaian visual yang lebih baik pada render dibanding model sebelumnya.
Astra memutuskan kapan harus bertanya kepada Anda dan kapan harus melanjutkan dengan asumsi yang masuk akal.
Saat instruksi menyisakan ruang interpretasi, ia mengisi celah rutin secara mandiri dan hanya mengajukan pertanyaan terfokus ketika jawabannya bisa mengubah hasil.
Dalam perbandingan berdampingan milik OpenAI, GPT-5.6 Sol membangun situs karier personal secara otonom dalam 13 menit 15 detik, sementara Astra berhenti setelah 20 detik untuk menanyakan karier apa yang dituju pengguna.
Di Codex, Astra dapat bertanya secara asinkron, melanjutkan pekerjaan yang tidak bergantung pada jawaban Anda dan hanya menunggu keputusan yang berdampak.
Astra juga tetap terarah saat sebuah tugas berubah.
Model sebelumnya kadang memperlakukan pesan pengarahan di tengah tugas sebagai tujuan baru dan kehilangan batasan awal; Astra menggabungkan kebutuhan baru dan menjawab pertanyaan sampingan tanpa menjatuhkan pekerjaan yang lebih luas.
GPT-6 Astra memperkenalkan cara baru bagi Codex untuk mempertahankan dan mengambil konteks saat jendela konteks penuh, mengganti rangkuman berulang dengan catatan yang dapat dicari.
Secara historis, model menggunakan kompaksi untuk memampatkan sesi debug panjang atau refactor besar menjadi satu rangkuman, yang dapat menghapus detail tentang mengapa perbaikan gagal atau bagaimana sebuah komponen berperilaku.
Dengan Astra, Codex menyimpan catatan lintas jendela dan membiarkan jendela lebih awal tetap bisa dicari, sehingga ia dapat menemukan kebutuhan atau hasil uji dari pesan sebelumnya meskipun catatan tidak menangkapnya.
Anda mengaktifkan fitur eksperimental ini di config.toml Codex Anda, dan OpenAI menyatakan ini akan menjadi default untuk Astra dalam beberapa minggu mendatang.
Astra mencapai ambang Kritis dalam keamanan siber di bawah Kerangka Kesiapsiagaan OpenAI, yang sekaligus menjadi kemampuan barunya yang paling kuat dan paling dibatasi.
Pada peluncuran, model ini akan membantu tinjauan kode aman dan patching, namun menolak tugas yang lebih maju seperti membuat eksploit bukti-konsep.
OpenAI berencana memperluas akses melalui program Daybreak dengan pengaman yang kurang ketat, memungkinkan validasi kerentanan dan bukti-konsep, analisis malware, dan detection engineering.
Karena risiko yang meningkat, pemeriksaan keamanan tambahan dapat menjeda atau menghentikan pekerjaan yang sah: di ChatGPT atau Codex Anda mungkin diminta meninjau suatu tindakan, dan di API tugas akan langsung dihentikan.
Astra menetapkan rekor baru pada penggunaan komputer, matematika, pengkodean, dan keamanan siber dalam evaluasi yang dilaporkan OpenAI, seringkali sambil menggunakan token output lebih sedikit daripada GPT-5.6 Sol atau model Claude.
Skor di bawah berasal dari tabel peluncuran OpenAI, jadi anggap sebagai laporan vendor dan perhatikan catatan tentang harness di mana berlaku.
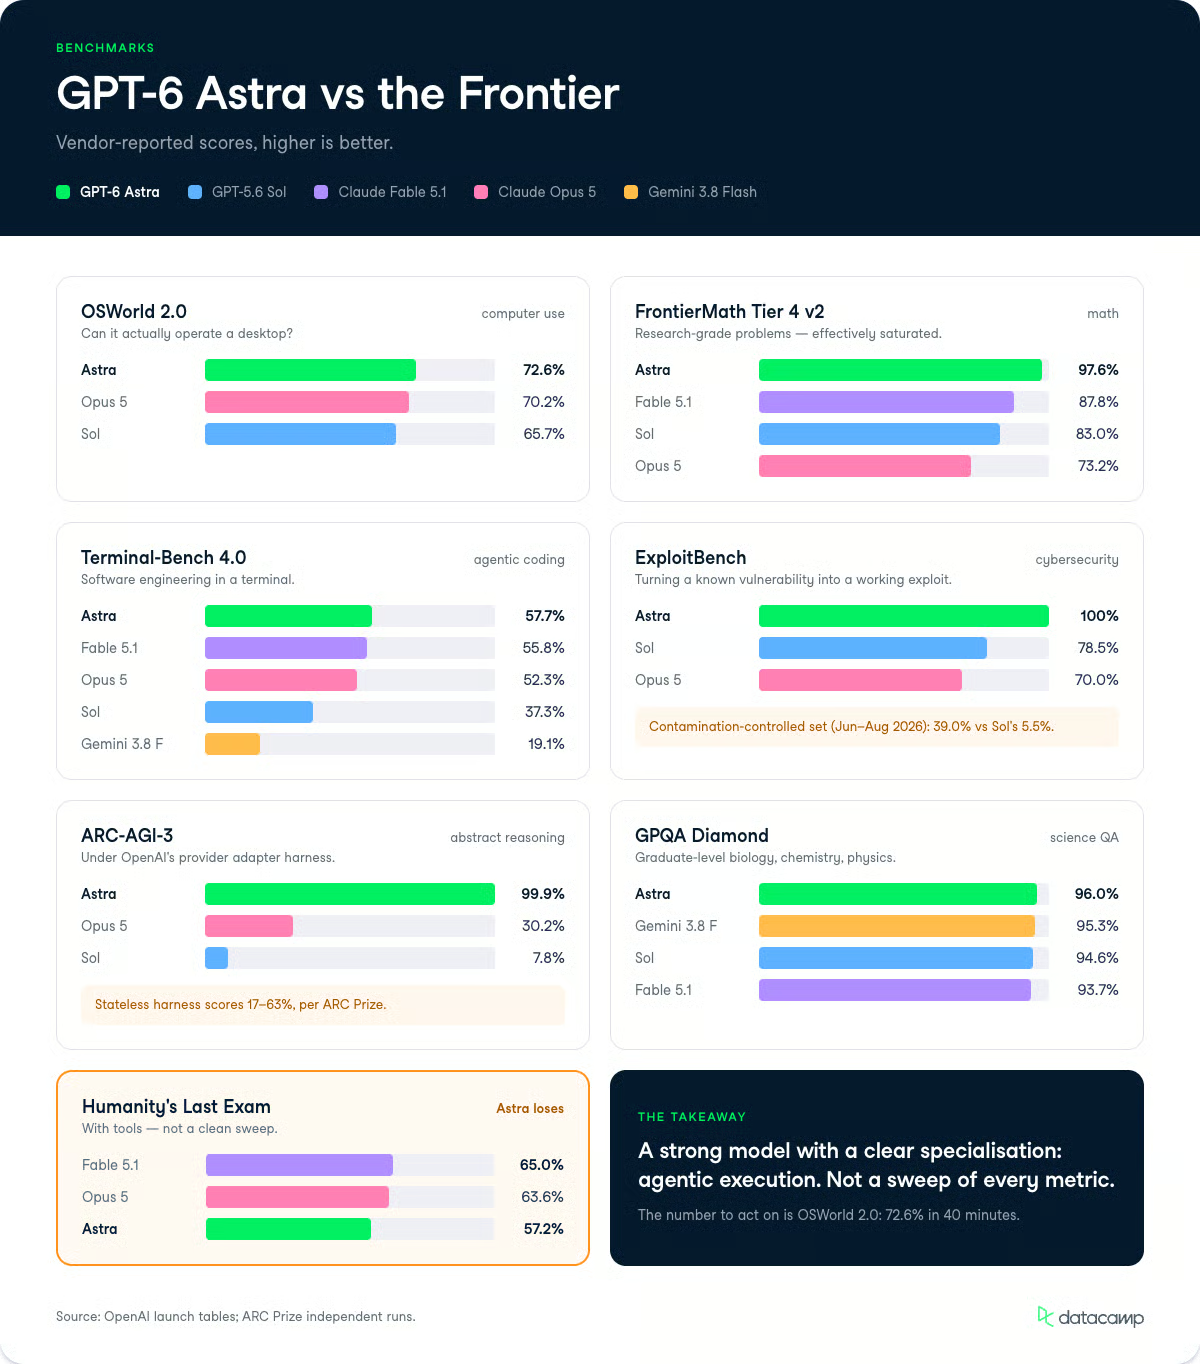
Astra mencetak 72,6% pada set offline OSWorld 2.0, dibanding 65,7% untuk GPT-5.6 Sol dan 70,2% untuk Claude Opus 5.
OSWorld mengukur apakah sebuah agen dapat menyelesaikan tugas desktop nyata seperti menavigasi aplikasi dan memanipulasi berkas, jadi ini adalah proksi terdekat untuk "apakah ini benar-benar bisa menggunakan komputer untuk saya."
Pada ScreenSpot-Pro, yang menguji pengaitan elemen UI di layar tanpa alat bantu, Astra meraih 92,7% melawan 76,9% milik GPT-5.6 Sol dan 87,3% milik Claude Fable 5.
Pada Agents' Last Exam, ia mencapai 59,3%, di depan 55,5% milik Claude Opus 5 dan 53,6% milik GPT-5.6 Sol, sambil menggunakan sekitar 65% token output lebih sedikit daripada Opus 5.
Astra mencetak 97,6% pada FrontierMath Tier 4 v2, tier terberat dari tolok ukur matematika tingkat riset, dibanding 87,8% untuk Claude Fable 5.1 dan Fable 5, serta 73,2% untuk Claude Opus 5.
OpenAI menyebut ini sebagai saturasi, dan mengingat batas atasnya, itu penilaian yang wajar.
Pada GPQA Diamond, sekumpulan pertanyaan tingkat pascasarjana di biologi, kimia, dan fisika, Astra mencapai 96,0% melawan 95,3% milik Gemini 3.8 Flash dan 94,6% milik GPT-5.6 Sol.
Namun, ia tidak memuncaki semua metrik. Pada Humanity's Last Exam dengan tools, Astra mencetak 57,2%, di belakang 65,0% milik Claude Fable 5.1 dan 63,6% milik Opus 5, jadi ia tidak menyapu bersih semua evaluasi penalaran.
Pada Terminal-Bench 4.0, yang menguji agen pada rekayasa perangkat lunak, konfigurasi sistem, dan analisis data di terminal, Astra mencetak 57,7% dibanding 37,3% milik GPT-5.6 Sol, 55,8% milik Claude Fable 5.1, dan 19,1% milik Gemini 3.8 Flash.
Itu adalah keunggulan lebar atas Gemini Flash dan keunggulan moderat atas Fable 5.1.
Gambaran koding lebih ketat di tempat lain.
Pada FrontierCode 1.1 Main, Astra mencetak 53,3% melawan 53,5% milik Fable 5 dan 53,4% milik Opus 5, secara efektif seri, dan pada DeepSWE v1.1 ia mencapai 74,1% melawan 73,8% milik Gemini 3.8 Flash dan 69,9% milik Fable 5.
Saat kami meninjau GPT-5.6 Terra dalam perbandingan Terra vs Claude Sonnet 5, Terra mencapai 87,4% pada Terminal-Bench 2.1, versi yang berbeda, jadi perbandingan lintas versi di sini tidak sebanding.
Astra mencetak 100% pada ExploitBench melawan 78,5% milik GPT-5.6 Sol dan 70% milik Claude Opus 5, serta 42,4% pada ExploitGym melawan 30,3% milik Sol.
ExploitBench mengukur apakah model dapat mengubah kerentanan yang diketahui menjadi eksploit yang berfungsi, jadi skor sempurna adalah alasan OpenAI mengunci kemampuan ini saat peluncuran.
Pada ExploitBench terkontrol kontaminasi (Juni–Agustus 2026), yang dibangun dari kerentanan tiga bulan sebelumnya, Astra mencetak 39,0% melawan 5,5% milik Sol.
Pada SRE-Bench, yang mengukur rekayasa balik biner tanpa sumber, Astra menyelesaikan 88,0% dalam satu percobaan melawan 55,9% milik Sol.
Lab independen Irregular melaporkan Astra menyelesaikan 86 dari 226 tantangan FrontierCyber melawan 34 milik Sol, termasuk temuan zero-day di peramban dan basis data cloud.
Astra mencetak 99,9% pada ARC-AGI-3 di bawah provider adapter harness milik OpenAI, melawan 7,8% untuk GPT-5.6 Sol dan 30,2% untuk Claude Opus 5.
Ini adalah angka yang harus dibaca dengan cermat: uji independen ARC Prize menunjukkan harness stateless standar mencetak sekitar 17% hingga 63% tergantung tier penalaran, dengan angka ~99,9% memerlukan adapter harness stateful dan satu run komprehensif yang biayanya puluhan ribu dolar.
Pada konteks panjang, Astra mencapai 100% pada OpenAI MRCR v2 8-needle di rentang 256K–512K dan 96,3% di rentang 512K–1M, dibanding 91,5% dan 73,8% untuk GPT-5.6 Sol.
Keandalan pengambilan pada 1M token itu adalah lompatan nyata atas Sol untuk pipeline yang sarat dokumen.
Astra mencatat 2,4% pada tolok ukur keamanan penggunaan komputer internal OpenAI (lebih rendah lebih baik) dibanding 22,0% milik GPT-5.6 Sol, 9,5% milik Fable 5.1, dan 11,5% milik Opus 5.
Di lingkungan kerja realistis, tingkat hasil tidak selaras secara keseluruhan tanpa kebijakan konfirmasi adalah 3,4%, melawan 18,8% milik Sol dan 13,5% milik GPT-5.6 Terra.
Satu regresi yang ditandai OpenAI adalah keterpantauan chain-of-thought.
Astra menghasilkan penalaran yang lebih singkat, kurang bertele-tele, dan mengendalikan CoT jauh lebih baik daripada Sol; pada CoT-Control antara 750 dan 1.250 token ia mengikuti batasan 60,9% dari waktu dibanding 16,1% milik Sol.
UK AISI menemukan Astra dapat menghindari pemantauan di bawah prompting adversarial, dan OpenAI menilai penurunan ini cukup serius hingga menamainya sebagai prioritas riset.
Berikut bagaimana skor yang dilaporkan Astra sejajar dengan para pesaing yang dibidiknya di beberapa tolok ukur kunci.
| Tolok Ukur | GPT-6 Astra | GPT-5.6 Sol | Claude Fable 5.1 | Claude Opus 5 | Gemini 3.8 Flash |
|---|---|---|---|---|---|
| OSWorld 2.0 | 72,6% | 65,7% | - | 70,2% | - |
| FrontierMath Tier 4 v2 | 97,6% | 83,0% | 87,8% | 73,2% | - |
| GPQA Diamond | 96,0% | 94,6% | 93,7% | 93,7% | 95,3% |
| Terminal-Bench 4.0 | 57,7% | 37,3% | 55,8% | 52,3% | 19,1% |
| ExploitBench | 100,0% | 78,5% | - | 70,0% | - |
| ARC-AGI-3 (adapter harness) | 99,9% | 7,8% | - | 30,2% | - |
GPT-6 Astra diluncurkan terlebih dahulu ke sejumlah organisasi terbatas, lalu ke semua pengguna ChatGPT Plus, Pro, Business, dan Enterprise dalam beberapa hari mendatang, serta melalui OpenAI API dan AWS.
Admin Enterprise dapat mengaktifkannya per ruang kerja, dan pada peluncuran statusnya nonaktif secara default. Paket Pro, Business, dan Enterprise juga mendapat GPT-6 Astra Pro.
Bagi pengembang, model ini tersedia sebagai gpt-6-astra di OpenAI API dan di Amazon Bedrock.
Harga API Standar adalah:
Untuk konteks, itu jauh di atas tarif $2/$12 milik GPT-5.6 Terra dari liputan kami sebelumnya, dan di atas $5/$25 milik Claude Opus 5.
Astra dihargai sebagai model penalaran dan otomasi frontier, bukan kuda beban teks massal.
Ia mendukung Zero Data Retention untuk pelanggan API yang memenuhi syarat, dan penggunaan termasuk dalam alokasi langganan yang ada dengan opsi membeli kredit tambahan.
Linimasa media sosial saya penuh dengan contoh kasus penggunaan GPT-6 Astra. Meski saya sendiri belum sempat mencobanya langsung, ada beberapa contoh menarik yang patut disorot di sini:
Saya melihat banyak unggahan di mana orang menggunakan GPT-6 Astra di Blender untuk membuat model 3D yang sangat detail dan realistis.
Pada klip di bawah, pengguna X, Tom Krcha, memberi GPT-6 'gambar sebuah rumah dan meminta untuk membuatnya dalam 3D dengan semua detailnya, termasuk mainan, peralatan, dan furnitur. Ini adalah rekonstruksi model 3D penuh di Blender dengan geometri yang dapat Anda ubah secara manual dan berjalan 60fps sebagai "gim" yang dirender lokal di perangkat.'
Kursus Teratas di DataCamp
Kursus
Kursus
Program
blogs
Javier Canales Luna
14 mnt
blogs
Dario Radečić
15 mnt
blogs
David Woods
13 mnt
blogs
Hugo Bowne-Anderson
13 mnt



