कोर्स
Large Language Models (LLMs) कॉन्सेप्ट्स
2 घंटा
112K
जैसे-जैसे प्राकृतिक भाषा संसाधन (NLP) तेजी से बढ़ रहा है, बड़े भाषा मॉडल (LLMs) अत्यंत शक्तिशाली उपकरण बन गए हैं, जो बढ़ती संख्या में कार्यों को संभालने में सक्षम हैं। हालांकि, एक लगातार बनी रहने वाली चुनौती इन सामान्य मॉडलों को अत्यधिक विशेषीकृत क्षेत्रों, जैसे चिकित्सा साहित्य या सॉफ़्टवेयर डाक्यूमेंटेशन, के अनुरूप ढालना रही है।
यहीं पर Retrieval-Augmented Fine-Tuning (RAFT) काम आता है—एक नई तकनीक जो डोमेन-विशिष्ट NLP को बदल सकती है। RAFT, Retrieval-Augmented Generation (RAG) की ताकत—जो LLMs को बाहरी डेटा स्रोतों से जोड़ती है—और फाइन-ट्यूनिंग को मिलाता है, जिससे मॉडल न केवल डोमेन-विशिष्ट ज्ञान सीखते हैं बल्कि कार्य निष्पादन के लिए बाहरी संदर्भ को सटीक रूप से पुनः प्राप्त करना और समझना भी सीखते हैं।
इस लेख में, हम RAFT के आंतरिक कामकाज की पड़ताल करेंगे, इसके फायदे देखेंगे, और समझेंगे कि यह अत्याधुनिक तकनीक डोमेन-विशिष्ट NLP कार्यों के प्रति हमारे दृष्टिकोण में कैसे क्रांति ला सकती है। शुरुआत करने के लिए, RAG पर कुछ संसाधन देखें, जैसे हमारा RAG परिचय और RAG के व्यावहारिक अनुप्रयोग।
Retrieval Augmented Fine-Tuning (RAFT) भाषा मॉडलों के लिए एक क्रांतिकारी दृष्टिकोण है जो RAG और फाइन-ट्यूनिंग के लाभों को जोड़ता है। यह तकनीक मॉडलों की डोमेन-विशिष्ट ज्ञान को समझने और इस्तेमाल करने की क्षमता को बढ़ाते हुए, गलत पुनर्प्राप्तियों के प्रति मज़बूती सुनिश्चित करके उन्हें विशिष्ट डोमेन्स के लिए अनुकूलित करती है।
RAFT विशेष रूप से LLMs को विशेषीकृत डोमेन्स में ढालने की चुनौतियों से निपटने के लिए डिज़ाइन किया गया है। इन संदर्भों में, सामान्य ज्ञान पर तर्क करना कम महत्वपूर्ण हो जाता है, और प्राथमिक ध्यान पूर्व-निर्धारित डोमेन-विशिष्ट दस्तावेजों के सेट के सापेक्ष सटीकता को अधिकतम करने पर केंद्रित हो जाता है।
Retrieval-Augmented Generation (RAG) एक तकनीक है जो भाषा मॉडलों को एक रिट्रीवल मॉड्यूल के एकीकरण से बेहतर बनाती है, जो बाहरी नॉलेज बेस से प्रासंगिक जानकारी प्राप्त करता है।
यह रिट्रीवल मॉड्यूल इनपुट क्वेरी के आधार पर प्रासंगिक दस्तावेज़ लाता है। भाषा मॉडल तब इस अतिरिक्त संदर्भ का उपयोग अंतिम आउटपुट बनाने के लिए करता है।
'रिट्रीव-एंड-रीड' प्रतिमान के तहत काम करते हुए, RAG ने भाषा मॉडलिंग और ओपन-डोमेन प्रश्नोत्तर सहित विभिन्न NLP कार्यों में अत्यधिक प्रभावशीलता दिखाई है।
हालांकि, इन भाषा मॉडलों को सटीक डोमेन-विशिष्ट दस्तावेजों को पुनः प्राप्त करने के लिए प्रशिक्षित नहीं किया गया है और इनके पास केवल प्री-ट्रेनिंग से सामान्य डोमेन ज्ञान होता है।
मूल शोध पत्र में उल्लेखित अनुसार, मौजूदा इन-कॉन्टेक्स्ट रिट्रीवल विधियाँ ऐसे हैं मानो आप ओपन-बुक परीक्षा दे रहे हों, लेकिन यह न जानते हुए कि प्रश्न का उत्तर देने के लिए कौन से दस्तावेज़ सबसे अधिक प्रासंगिक हैं।
RAG के बारे में अधिक जानने के लिए देखें कैसे GPT और Milvus के साथ RAG का उपयोग करके प्रश्नोत्तर किया जा सकता है।
फाइन-ट्यूनिंग, पूर्व-प्रशिक्षित LLMs को डाउनस्ट्रीम कार्यों के अनुसार ढालने की व्यापक रूप से अपनाई गई विधि है। इस प्रक्रिया में मॉडल को कार्य-विशिष्ट डेटा पर आगे प्रशिक्षित करना शामिल है, जिससे वह पैटर्न सीख सके और वांछित आउटपुट प्रारूप के अनुरूप हो सके।
फाइन-ट्यूनिंग ने सारांशण, प्रश्नोत्तर और संवाद निर्माण जैसे कई NLP अनुप्रयोगों में सफलता दिखाई है। हालांकि, पारंपरिक फाइन-ट्यूनिंग विधियाँ बाहरी डोमेन-विशिष्ट ज्ञान का लाभ उठाने या इन्फ़रेंस के दौरान अपूर्ण रिट्रीवल्स को सँभालने में संघर्ष कर सकती हैं।
पहले वाली ही उपमा का उपयोग करें, तो फाइन-ट्यूनिंग दस्तावेज़ों को रटने और परीक्षा के दौरान उन्हें देखे बिना प्रश्नों का उत्तर देने जैसी है। इस दृष्टिकोण की समस्या यह है कि फाइन-ट्यूनिंग महंगी हो सकती है, और फाइन-ट्यून किया गया ज्ञान पुराना पड़ सकता है। साथ ही, ये फाइन-ट्यूनिंग विधियाँ RAG-आधारित तरीकों जितनी प्रतिक्रियाशील नहीं होतीं।
फाइन-ट्यूनिंग के बारे में अधिक जानने के लिए यहाँ LLMs की फाइन-ट्यूनिंग का परिचयात्मक मार्गदर्शक है।
RAFT मौजूदा दृष्टिकोणों की सीमाओं को पहचानता है और RAG व फाइन-ट्यूनिंग की ताकतों को मिलाने का लक्ष्य रखता है। फाइन-ट्यूनिंग प्रक्रिया के दौरान डोमेन-विशिष्ट दस्तावेज़ों को शामिल करके, RAFT मॉडल को लक्ष्य डोमेन के लिए विशिष्ट पैटर्न सीखने में सक्षम बनाता है और साथ ही बाहरी संदर्भ को प्रभावी ढंग से समझने और उपयोग करने की इसकी क्षमता को बढ़ाता है।
उच्च स्तर पर, RAFT में प्रशिक्षण डेटा प्रश्नों, दस्तावेज़ों (प्रासंगिक और अप्रासंगिक दोनों), और प्रासंगिक दस्तावेज़ों से उत्पन्न चेन-ऑफ-थॉट-शैली के उत्तरों से बना होता है। मॉडल को इन प्रदान किए गए दस्तावेज़ों के आधार पर प्रश्नों का उत्तर देने के लिए प्रशिक्षित किया जाता है, जिसमें ऐसे डिस्टैक्टर दस्तावेज़ भी शामिल होते हैं जिनमें प्रासंगिक जानकारी नहीं होती। यह दृष्टिकोण मॉडल को प्रासंगिक जानकारी की पहचान और प्राथमिकता देना सिखाता है, जबकि अप्रासंगिक सामग्री को नजरअंदाज करना भी।
आइए देखें कि Retrieval-Augmented Fine-Tuning यांत्रिक रूप से कैसे काम करता है। RAFT इन-डोमेन RAG आंसरिंग मॉडलों को प्रशिक्षित करने के लिए फाइन-ट्यूनिंग डेटा तैयार करने की एक नई विधि प्रस्तावित करता है। RAFT में, प्रशिक्षण डेटासेट का प्रत्येक डेटा पॉइंट निम्न से बना होता है:
RAFT फाइन-ट्यूनिंग प्रशिक्षण डेटासेट में, प्रत्येक प्रश्न को दस्तावेज़ों के एक सेट के साथ जोड़ा जाता है—कुछ में उत्तर होते हैं और कुछ में नहीं—साथ ही चेन-ऑफ-थॉट शैली के उत्तर के साथ। यह संरचना उत्तर निकालते समय उपयोगी और अप्रासंगिक जानकारी में अंतर करने के लिए मॉडल को प्रशिक्षित करने में विशेष रूप से सहायक है।
मॉडल के सीखने को और बेहतर करने के लिए, RAFT प्रशिक्षण डेटासेट में प्रश्नों के प्रकारों का मिश्रण शामिल होता है:
अंततः, चेन-ऑफ-थॉट शैली के उत्तरों में ओरेकल दस्तावेज़ों के अंश और विस्तृत तर्क प्रक्रिया शामिल होती है। यह दृष्टिकोण मॉडल की उत्तर देने की सटीकता को बढ़ाता है, क्योंकि यह उसे मूल संदर्भ के प्रासंगिक अंशों का उपयोग करके एक तर्क श्रृंखला बनाना सिखाता है।
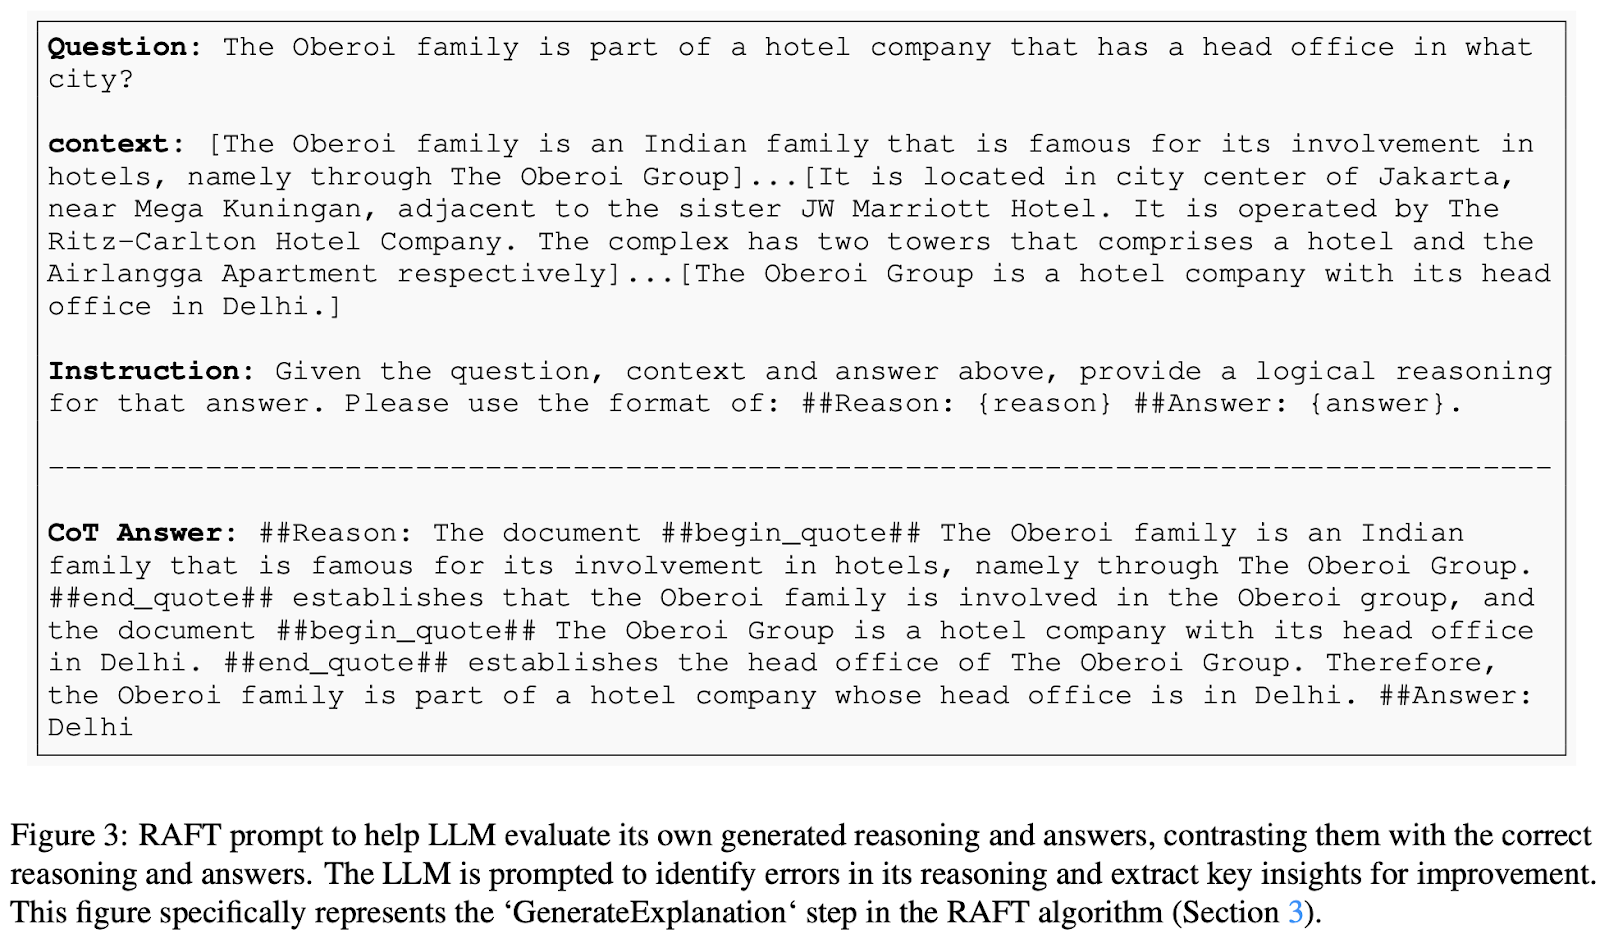
छवि स्रोत: RAFT: Adapting Language Model to Domain Specific RAG
जब प्रशिक्षण डेटा तैयार हो जाए, तो फाइन-ट्यूनिंग प्रक्रिया में शामिल है:
इन्फ़रेंस चरण के दौरान, हमारे फाइन-ट्यून किए गए मॉडल को एक प्रश्न और RAG पाइपलाइन द्वारा पुनः प्राप्त किए गए टॉप-K दस्तावेज़ प्रस्तुत किए जाएंगे। ध्यान दें कि रिट्रीवर मॉड्यूल RAFT से स्वतंत्र रूप से कार्य करता है।
यह दिखाने के लिए कि RAFT इन-डोमेन दस्तावेज़ों से प्रासंगिक जानकारी निकालने और प्रश्नों का उत्तर देने में उत्कृष्ट है, मूल शोध पत्र ने RAFT दृष्टिकोण की तुलना RAG के साथ एक सामान्य-उद्देश्य मॉडल और डोमेन-विशिष्ट फाइन-ट्यून किए गए मॉडलों से की। विशेष रूप से, उन्होंने RAFT विधि का उपयोग करके Llama-2 को फाइन-ट्यून करके RAFT 7B मॉडल बनाया, और इसकी तुलना निम्न से की:
इन मॉडलों का तीन प्रकार के डेटासेट पर मूल्यांकन किया गया ताकि विभिन्न डोमेन्स में RAFT के प्रदर्शन का आकलन किया जा सके:
कुल मिलाकर, परिणाम बताते हैं कि PubMed, HotpotQA और अन्य API डेटासेट्स में RAFT ने RAG के साथ और बिना—दोनों स्थितियों में—सुपरवाइज़्ड फाइन-ट्यूनिंग पद्धति से लगातार बेहतर प्रदर्शन किया।
डोमेन-विशिष्ट फाइन-ट्यूनिंग (DSF) से तुलना करने पर, RAFT ने DSF को उल्लेखनीय रूप से पीछे छोड़ा। रोचक बात यह है कि RAG के साथ DSF ने बेहतर प्रदर्शन नहीं किया, बल्कि वास्तव में कमजोर रहा।
यह दर्शाता है कि DSF दी गई सामग्री से प्रासंगिक जानकारी प्रभावी ढंग से निकालने की क्षमता में कमी रखता है। RAFT का उपयोग करके, हम मॉडल को दस्तावेज़ों को सटीक रूप से संसाधित करने और उपयुक्त उत्तर देने की शैली प्रदान करने—दोनों के लिए—प्रशिक्षित करते हैं।
RAFT दृष्टिकोण ने RAG के साथ GPT-3.5—जो एक बहुत बड़ा भाषा मॉडल है—से भी बेहतर प्रदर्शन किया, जो RAFT की प्रभावशीलता को रेखांकित करता है।
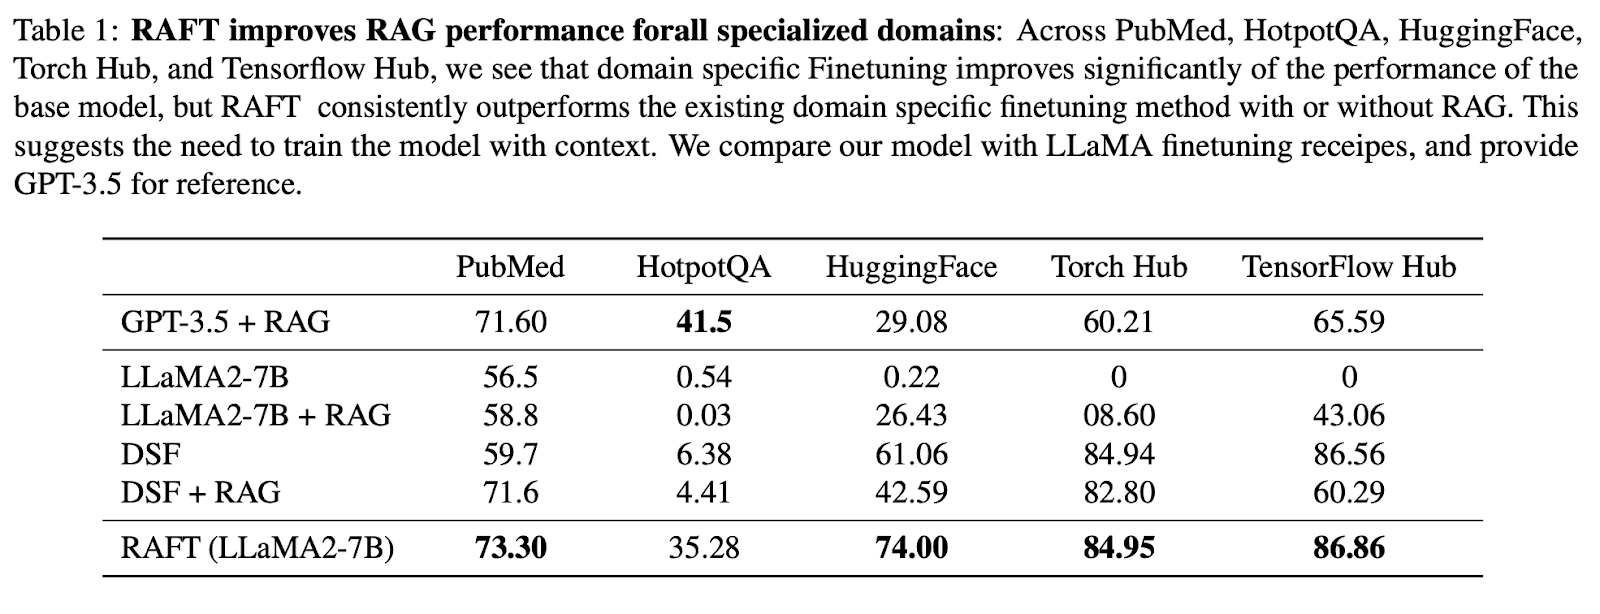
छवि स्रोत: RAFT: Adapting Language Model to Domain Specific RAG
एब्लेशन अध्ययन
मुख्य प्रयोगों के अलावा, मूल शोध पत्र ने RAFT के प्रदर्शन पर विभिन्न घटकों के प्रभाव को समझने के लिए कई एब्लेशन अध्ययन भी किए:
RAFT को लागू करने के लिए, शोधकर्ता और व्यावसायिक विशेषज्ञ शोध पत्र में उल्लिखित चरणों का पालन कर सकते हैं। इसमें प्रासंगिक दस्तावेज़ों से चेन-ऑफ-थॉट-शैली के उत्तर उत्पन्न करना, प्रशिक्षण के दौरान डिस्टैक्टर दस्तावेज़ों को शामिल करना, और सुपरवाइज़्ड लर्निंग तकनीकों का उपयोग करके मॉडल को फाइन-ट्यून करना शामिल है। लेखकों ने कोड को ओपन-सोर्स किया है और RAFT पर आगे के प्रयोग और अपनाने को सुगम बनाने के लिए एक डेमो भी प्रदान किया है।
RAFT, डोमेन-विशिष्ट भाषा मॉडलिंग के क्षेत्र में एक महत्वपूर्ण प्रगति का प्रतिनिधित्व करता है, जो LLMs को विशेषीकृत डोमेन्स के लिए अनुकूलित करने का एक शक्तिशाली समाधान प्रदान करता है। RAG और फाइन-ट्यूनिंग की ताकतों को मिलाकर, RAFT भाषा मॉडलों को डोमेन-विशिष्ट ज्ञान का प्रभावी ढंग से लाभ उठाने में सक्षम बनाता है, जबकि रिट्रीवल अशुद्धियों के प्रति मज़बूती बनाए रखता है।
जो लोग RAG और फाइन-ट्यूनिंग की दुनिया में और गहराई से जाना चाहते हैं, उनके लिए हम निम्न संसाधन देखने की सलाह देते हैं:
जैसे-जैसे डोमेन-विशिष्ट भाषा मॉडलों की मांग बढ़ती जा रही है, RAFT जैसी तकनीकें विभिन्न उद्योगों और डोमेन्स में अधिक सटीक और विश्वसनीय NLP अनुप्रयोगों को सक्षम करने में महत्वपूर्ण भूमिका निभाएँगी।
आज ही अपनी AI सीखने की यात्रा जारी रखें!
कोर्स
कोर्स
कोर्स