Cursus
Concepten van Large Language Models (LLMs)
2 uur
111.7K
Nu natural language processing (NLP) razendsnel groeit, zijn large language models (LLM’s) uitgegroeid tot krachtige tools die een steeds grotere reeks taken aankunnen. Een blijvende uitdaging is echter het aanpassen van deze algemene modellen aan sterk gespecialiseerde gebieden, zoals medische literatuur of softwaredocumentatie.
Daar komt Retrieval-Augmented Fine-Tuning (RAFT) om de hoek kijken, een nieuwe techniek die domeinspecifieke NLP kan transformeren. RAFT combineert de sterke punten van Retrieval-Augmented Generation (RAG), een methode die LLM’s koppelt aan externe databronnen, en fine-tuning, waardoor modellen niet alleen domeinkennis leren, maar ook leren hoe ze externe context nauwkeurig kunnen ophalen en begrijpen om taken uit te voeren.
In dit artikel duiken we in de werking van RAFT, bekijken we de voordelen en zien we hoe deze geavanceerde techniek onze aanpak van domeinspecifieke NLP-taken kan veranderen. Om te beginnen kun je bronnen over RAG bekijken, zoals onze introductie tot RAG en praktische toepassingen van RAG.
Retrieval Augmented Fine-Tuning (RAFT) is een baanbrekende benadering voor taalmodellen die de voordelen van RAG en fine-tuning combineert. Deze techniek stemt taalmodellen af op specifieke domeinen door het vermogen van de modellen te vergroten om domeinspecifieke kennis te begrijpen en te benutten, terwijl ze robuust blijven tegen onnauwkeurige retrievals.
RAFT is specifiek ontworpen om de uitdagingen aan te pakken bij het aanpassen van LLM’s aan gespecialiseerde domeinen. In deze contexten wordt redeneren op basis van algemene kennis minder belangrijk, en verschuift de focus naar maximale nauwkeurigheid ten opzichte van een vooraf gedefinieerde set domeinspecifieke documenten.
Retrieval-Augmented Generation (RAG) is een techniek die taalmodellen verbetert door een retrievalmodule te integreren die relevante informatie haalt uit externe kennisbanken.
Deze retrievalmodule haalt relevante documenten op op basis van de inputvraag. Het taalmodel gebruikt deze extra context vervolgens om de uiteindelijke output te genereren.
Werkend volgens het paradigma ‘ophalen-en-lezen’ heeft RAG zich bewezen als zeer effectief in verschillende NLP-taken, waaronder taalmodellering en open-domain vraagbeantwoording.
Deze taalmodellen zijn echter niet getraind om nauwkeurige, domeinspecifieke documenten op te halen en beschikken in plaats daarvan alleen over algemene domeinkennis uit pre-training.
Zoals opgemerkt in het oorspronkelijke paper, komen bestaande in-context retrievalmethoden neer op het maken van een openboektoets zonder te weten welke documenten het meest relevant zijn om de vraag te beantwoorden.
Wil je meer leren over RAG, bekijk dan hoe RAG met GPT en Milvus kan worden gebruikt voor vraagbeantwoording.
Fine-tuning is een veelgebruikte aanpak om voorgetrainde LLM’s aan te passen aan downstream-taken. Dit proces omvat verdere training van het model op taakspecifieke data, zodat het patronen leert en zich aanpast aan het gewenste outputformaat.
Fine-tuning is succesvol gebleken in uiteenlopende NLP-toepassingen, zoals samenvatten, vraagbeantwoording en dialooggeneratie. Traditionele fine-tuningmethoden kunnen echter moeite hebben om externe, domeinspecifieke kennis te benutten of met onvolmaakte retrievals tijdens inferentie om te gaan.
Om dezelfde analogie te gebruiken als eerder: fine-tuning is alsof je documenten uit je hoofd leert en vragen beantwoordt zonder ze tijdens het examen te raadplegen. Het probleem is dat fine-tuning kostbaar kan zijn en dat de aangeleerde kennis kan verouderen. Bovendien reageren deze fine-tuningmethoden minder flexibel dan RAG-gebaseerde methoden.
Voor meer over fine-tuning, bekijk een inleidende gids voor het fine-tunen van LLM’s.
RAFT erkent de beperkingen van bestaande benaderingen en wil de sterke punten van RAG en fine-tuning combineren. Door tijdens het fine-tuningproces domeinspecifieke documenten op te nemen, stelt RAFT het model in staat patronen te leren die specifiek zijn voor het doeldomein, en verbetert het tegelijk het vermogen om externe context effectief te begrijpen en te benutten.
Op hoofdlijnen bestaat de trainingsdata in RAFT uit vragen, documenten (zowel relevant als irrelevant) en bijbehorende chain-of-thought-achtige antwoorden die uit de relevante documenten zijn gegenereerd. Het model wordt getraind om vragen te beantwoorden op basis van deze aangeleverde documenten, inclusief afleiddocumenten die geen relevante informatie bevatten. Deze aanpak leert het model relevante informatie te identificeren en te prioriteren, terwijl irrelevante inhoud wordt genegeerd.
Laten we dieper ingaan op de mechaniek van Retrieval-Augmented Fine-Tuning. RAFT stelt een nieuwe methode voor om fine-tuningdata voor te bereiden om in-domain RAG-antwoordsystemen te trainen. In RAFT bestaat elk datapunt in de trainingsset uit:
In de RAFT fine-tuning-trainingsset wordt elke vraag gekoppeld aan een set documenten, waarvan sommige de antwoorden bevatten en andere niet, samen met een chain-of-thought-achtig antwoord. Deze structuur is vooral nuttig om het model te trainen om bruikbare en irrelevante informatie te onderscheiden bij het afleiden van antwoorden.
Om het leerproces verder te versterken, bevat de RAFT-trainingsset een mix van vraagtypen:
Tot slot bevatten de chain-of-thought-achtige antwoorden segmenten uit de oracledocumenten en een gedetailleerd redeneerproces. Deze aanpak verhoogt de nauwkeurigheid van het model bij het beantwoorden van vragen door het te leren een redeneringsketen te vormen met relevante segmenten uit de originele context.
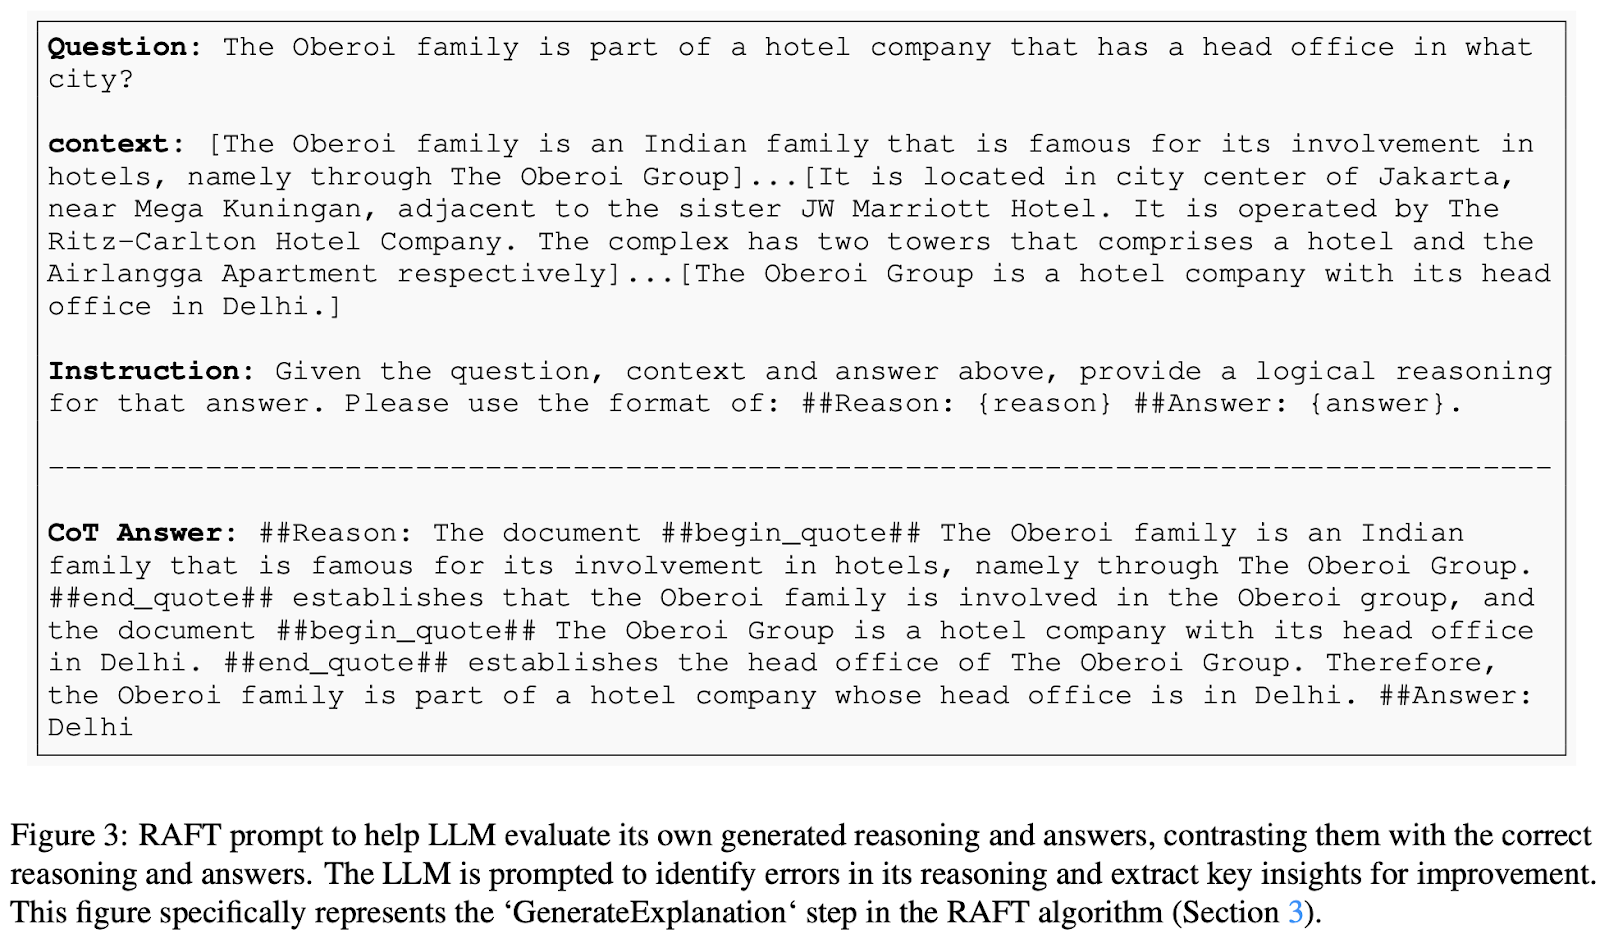
Beeldbron: RAFT: Adapting Language Model to Domain Specific RAG
Zodra de trainingsdata zijn voorbereid, omvat het fine-tuningproces:
Tijdens de inferentiefase krijgt ons fijn-afgestelde model een vraag en de top-K documenten die door de RAG-pijplijn zijn opgehaald. Let op: de retrievermodule werkt onafhankelijk van RAFT.
Om aan te tonen dat RAFT uitblinkt in het extraheren van relevante informatie uit in-domain documenten en in vraagbeantwoording, vergeleek het oorspronkelijke paper de RAFT-aanpak met een generiek model met RAG en met domeinspecifiek fijn-afgestelde modellen. Concreet fijn-afstemden ze Llama-2 met de RAFT-methode om het RAFT 7B-model te creëren, en vergeleken dat met het volgende:
Deze modellen zijn geëvalueerd op drie soorten datasets om de prestaties van RAFT over verschillende domeinen te beoordelen:
Over het geheel genomen laten de resultaten zien dat RAFT consequent beter presteerde dan de supervised fine-tuningmethode, zowel met als zonder RAG, op PubMed, HotpotQA en de andere API-datasets.
In vergelijking met domeinspecifieke fine-tuning (DSF) presteerde RAFT aanzienlijk beter. Opmerkelijk genoeg leidde DSF met RAG niet tot betere prestaties en deed het zelfs slechter.
Dit geeft aan dat DSF het vermogen mist om effectief relevante informatie uit aangeleverde documenten te halen. Met RAFT trainen we het model om zowel documenten nauwkeurig te verwerken als een geschikte antwoordstijl te hanteren.
De RAFT-aanpak presteerde zelfs beter dan GPT-3.5 met RAG, een veel groter taalmodel, wat de effectiviteit van RAFT aantoont.
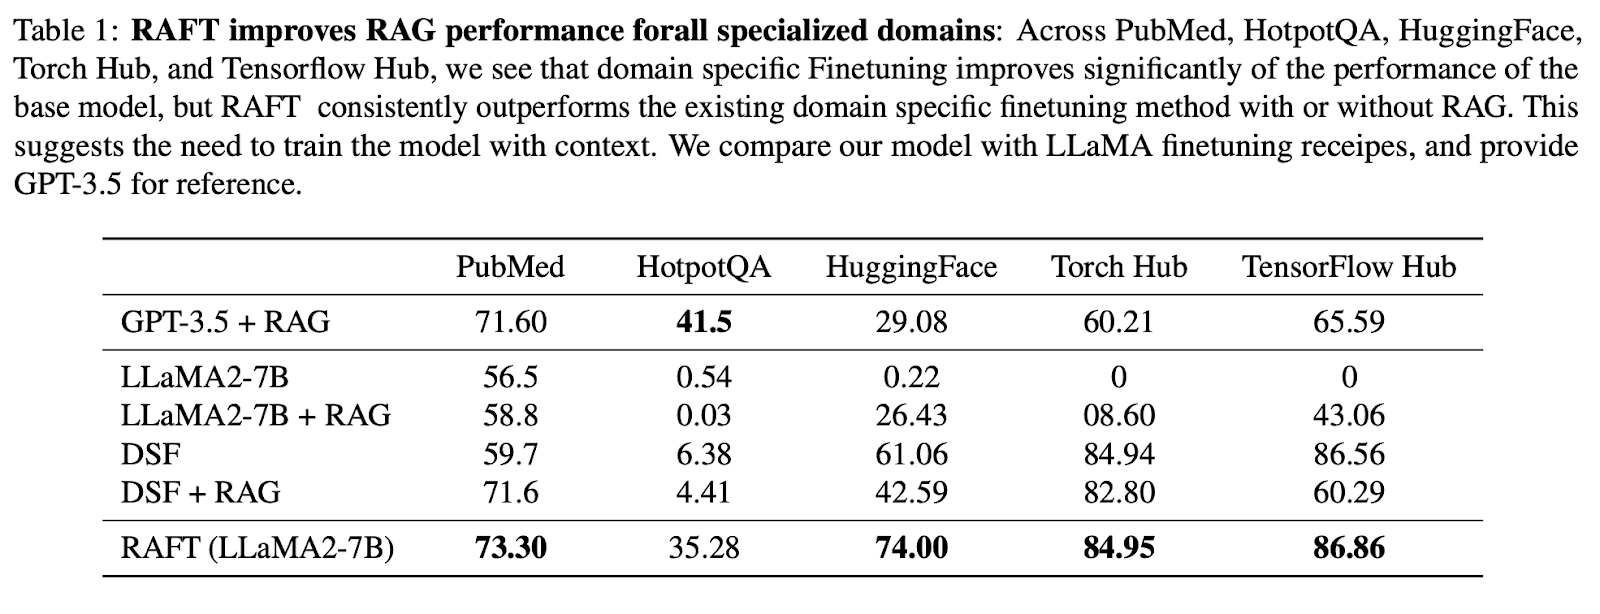
Beeldbron: RAFT: Adapting Language Model to Domain Specific RAG
Ablatiestudies
Naast de hoofdexperimenten voerde het oorspronkelijke paper ook verschillende ablatiestudies uit om de impact van diverse componenten op de prestaties van RAFT te begrijpen:
Om RAFT te implementeren kunnen onderzoekers en praktijkmensen de stappen in het paper volgen. Dit omvat het genereren van chain-of-thought-achtige antwoorden uit relevante documenten, het opnemen van distractordocumenten tijdens de training en het fijn-afstemmen van het model met supervised learning-technieken. De auteurs hebben ook de code open-source beschikbaar gemaakt en een demo geleverd om verdere experimenten en adoptie van RAFT te ondersteunen.
RAFT is een belangrijke stap vooruit op het gebied van domeinspecifieke taalmodellering en biedt een krachtige oplossing om LLM’s aan te passen aan gespecialiseerde domeinen. Door de sterke punten van RAG en fine-tuning te combineren, geeft RAFT taalmodellen het vermogen om domeinspecifieke kennis effectief te benutten en tegelijk robuust te blijven bij onnauwkeurigheden in retrieval.
Als je dieper wilt duiken in de wereld van RAG en fine-tuning, raden we de volgende bronnen aan:
Naarmate de vraag naar domeinspecifieke taalmodellen blijft groeien, zullen technieken zoals RAFT een cruciale rol spelen bij het mogelijk maken van nauwkeurigere en betrouwbaardere NLP-toepassingen in uiteenlopende sectoren en domeinen.
Zet je AI-leerreis vandaag voort!
Cursus
Cursus
Cursus
blog
Adel Nehme
15 min

