Corso
Concetti sui Large Language Models (LLM)
2 ore
112K
Con la rapida crescita dell'elaborazione del linguaggio naturale (NLP), i large language model (LLM) sono diventati strumenti molto potenti, in grado di gestire un numero sempre maggiore di compiti. Tuttavia, una sfida persistente è adattare questi modelli generali ad ambiti altamente specializzati, come la letteratura medica o la documentazione software.
È qui che entra in gioco il Retrieval-Augmented Fine-Tuning (RAFT), una nuova tecnica che potrebbe trasformare l'NLP specifica di dominio. RAFT combina i punti di forza della Retrieval-Augmented Generation (RAG), un metodo che integra gli LLM con fonti di dati esterne, e del fine-tuning, consentendo ai modelli non solo di apprendere conoscenze specifiche di dominio, ma anche di imparare a recuperare e comprendere con precisione il contesto esterno per svolgere i compiti.
In questo articolo esploreremo il funzionamento interno di RAFT, ne analizzeremo i vantaggi e vedremo come questa tecnica all'avanguardia potrebbe rivoluzionare il nostro approccio ai compiti NLP specifici di dominio. Per iniziare, dai un'occhiata ad alcune risorse su RAG, come la nostra introduzione a RAG e le applicazioni pratiche di RAG.
Il Retrieval Augmented Fine-Tuning (RAFT) è un approccio innovativo ai modelli linguistici che combina i benefici di RAG e del fine-tuning. Questa tecnica adatta i modelli linguistici a domini specifici migliorando la capacità dei modelli di comprendere e utilizzare conoscenze di dominio, garantendo al contempo robustezza rispetto a recuperi imprecisi.
RAFT è progettato specificamente per affrontare le sfide dell'adattamento degli LLM a domini specializzati. In questi contesti, il ragionamento basato su conoscenze generali diventa meno critico e l'attenzione principale si sposta verso la massimizzazione dell'accuratezza rispetto a un insieme predefinito di documenti specifici di dominio.
La Retrieval-Augmented Generation (RAG) è una tecnica che potenzia i modelli linguistici integrando un modulo di recupero che attinge informazioni pertinenti da basi di conoscenza esterne.
Questo modulo di recupero estrae documenti rilevanti in base alla query in input. Il modello linguistico utilizza poi questo contesto aggiuntivo per generare l'output finale.
Operando secondo un paradigma "recupera e leggi", RAG si è dimostrata molto efficace in vari compiti NLP, tra cui il language modeling e il question answering in domini aperti.
Tuttavia, questi modelli linguistici non sono stati addestrati a recuperare documenti accurati specifici di dominio e hanno invece solo conoscenze generali di dominio acquisite nel pre-training.
Come osservato nell'articolo originale, i metodi di recupero in-context esistenti equivalgono a sostenere un esame a libro aperto senza sapere quali documenti siano più pertinenti per rispondere alla domanda.
Per saperne di più su RAG, scopri come usare RAG con GPT e Milvus per eseguire il Question Answering.
Il fine-tuning è un approccio ampiamente adottato per adattare LLM pre-addestrati a compiti a valle. Questo processo prevede un ulteriore addestramento del modello su dati specifici del compito, permettendogli di apprendere pattern e allinearsi al formato di output desiderato.
Il fine-tuning ha avuto successo in varie applicazioni NLP, come il riassunto, il question answering e la generazione di dialoghi. Tuttavia, i metodi tradizionali di fine-tuning possono faticare a sfruttare conoscenze esterne specifiche di dominio o a gestire recuperi imperfetti in fase di inferenza.
Usando un'analogia simile alla precedente, il fine-tuning è come memorizzare i documenti e rispondere alle domande senza consultarli durante l'esame. Il problema di questo approccio è che il fine-tuning può essere costoso e le conoscenze apprese possono diventare obsolete. Inoltre, questi metodi di fine-tuning non sono reattivi quanto i metodi basati su RAG.
Per saperne di più sul fine-tuning, ecco una guida introduttiva al fine-tuning degli LLM.
RAFT riconosce i limiti degli approcci esistenti e mira a combinare i punti di forza di RAG e del fine-tuning. Incorporando documenti specifici di dominio durante il processo di fine-tuning, RAFT consente al modello di apprendere pattern specifici del dominio di destinazione e allo stesso tempo di migliorare la capacità di comprendere e utilizzare in modo efficace il contesto esterno.
A livello generale, in RAFT i dati di addestramento sono composti da domande, documenti (sia pertinenti che irrilevanti) e dalle corrispondenti risposte in stile chain-of-thought generate a partire dai documenti rilevanti. Il modello è addestrato a rispondere alle domande basandosi su questi documenti forniti, compresi documenti distraenti che non contengono informazioni rilevanti. Questo approccio insegna al modello a identificare e dare priorità alle informazioni pertinenti ignorando i contenuti irrilevanti.
Entriamo più a fondo nella meccanica del Retrieval-Augmented Fine-Tuning. RAFT propone un metodo innovativo per preparare i dati di fine-tuning al fine di addestrare modelli di risposta RAG in-domain. In RAFT, ogni punto dati del dataset di addestramento è composto da:
Nel dataset di addestramento per il fine-tuning RAFT, ogni domanda è abbinata a un insieme di documenti, alcuni contenenti le risposte e altri no, insieme a una risposta in stile chain-of-thought. Questa struttura è particolarmente utile per addestrare il modello a distinguere tra informazioni utili e irrilevanti quando elabora le risposte.
Per migliorare ulteriormente l'apprendimento del modello, il dataset di addestramento RAFT include un mix di tipologie di domande:
Infine, le risposte in stile chain-of-thought incorporano segmenti tratti dai documenti oracle e un processo di ragionamento dettagliato. Questo approccio migliora l'accuratezza del modello nell'offrire risposte insegnandogli a costruire una catena di ragionamento utilizzando segmenti pertinenti del contesto originale.
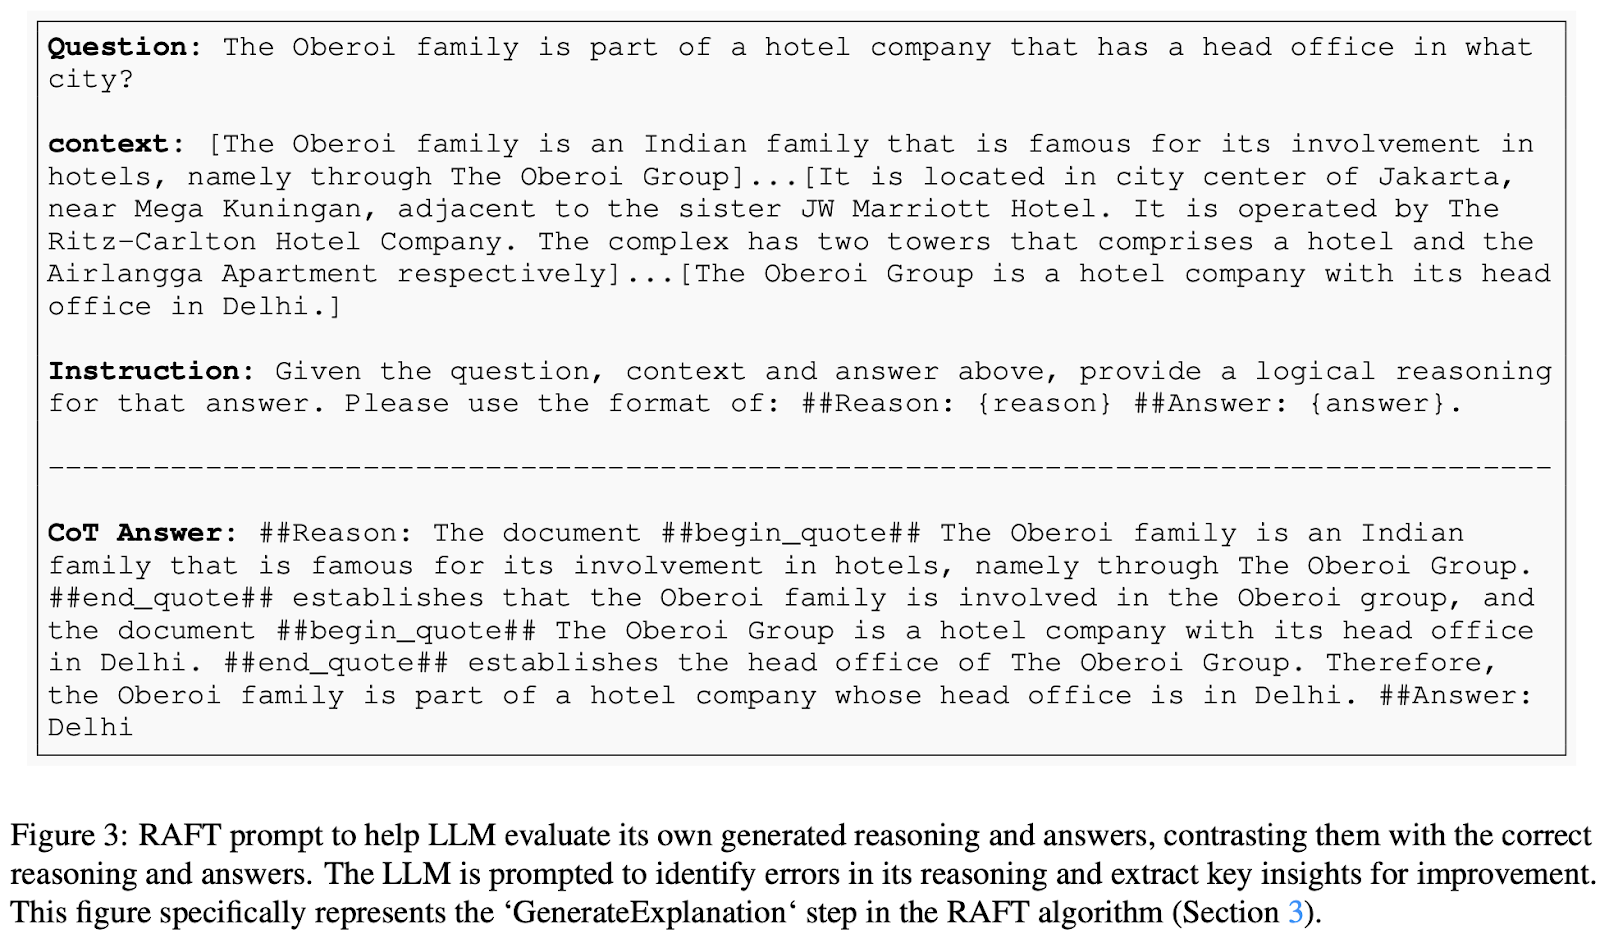
Fonte immagine: RAFT: Adapting Language Model to Domain Specific RAG
Una volta preparati i dati di addestramento, il processo di fine-tuning prevede:
Durante la fase di inferenza, al nostro modello fine-tuned verrà presentata una domanda e i top-K documenti recuperati dalla pipeline RAG. Nota che il modulo di retrieval opera in modo indipendente da RAFT.
Per dimostrare che RAFT eccelle nell'estrazione di informazioni pertinenti da documenti in-domain e nel rispondere alle domande, l'articolo originale ha confrontato l'approccio RAFT con un modello generico con RAG e con modelli fine-tuned specifici di dominio. In particolare, hanno eseguito il fine-tuning di Llama-2 usando il metodo RAFT per creare il modello RAFT 7B e lo hanno confrontato con i seguenti:
Questi modelli sono stati valutati su tre tipi di dataset per misurare le prestazioni di RAFT in una gamma di domini:
Nel complesso, i risultati mostrano che RAFT ha superato costantemente il metodo di fine-tuning supervisionato, sia con sia senza RAG, su PubMed, HotpotQA e gli altri dataset di API.
Rispetto al fine-tuning specifico di dominio (DSF), RAFT ha superato in modo significativo DSF. È interessante notare che DSF con RAG non ha portato a prestazioni migliori e, anzi, ha ottenuto risultati peggiori.
Ciò indica che DSF non è in grado di estrarre in modo efficace informazioni pertinenti dai documenti forniti. Utilizzando RAFT, addestriamo il modello sia a processare accuratamente i documenti sia a fornire uno stile di risposta adeguato.
L'approccio RAFT ha persino superato GPT-3.5 con RAG, che è un modello linguistico molto più grande, dimostrando l'efficacia di RAFT.
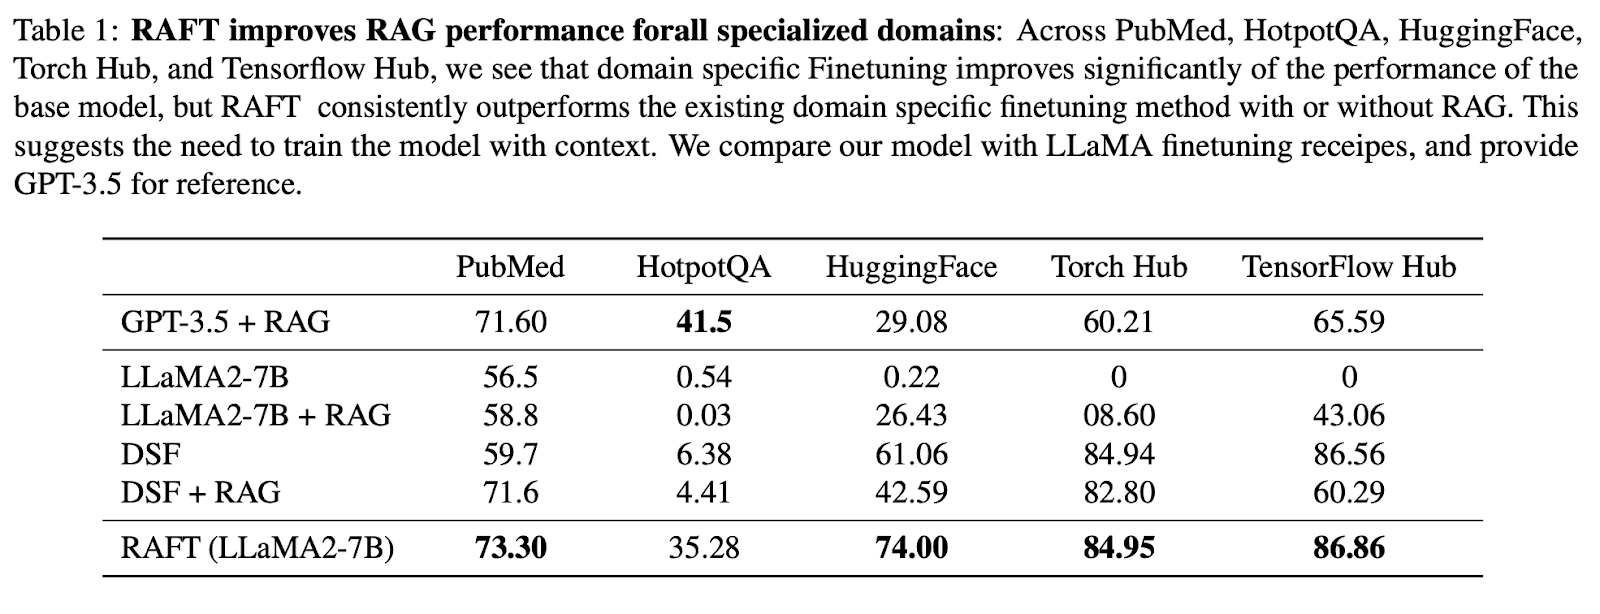
Fonte immagine: RAFT: Adapting Language Model to Domain Specific RAG
Studi di ablation
Oltre agli esperimenti principali, l'articolo originale ha condotto anche diversi studi di ablation per comprendere l'impatto di vari componenti sulle prestazioni di RAFT:
Per implementare RAFT, ricercatori e professionisti possono seguire i passaggi delineati nell'articolo. Ciò include generare risposte in stile chain-of-thought a partire dai documenti rilevanti, includere documenti distraenti durante l'addestramento ed eseguire il fine-tuning del modello utilizzando tecniche di apprendimento supervisionato. Gli autori hanno anche reso open source il codice e fornito una demo per facilitare ulteriori esperimenti e l'adozione di RAFT.
RAFT rappresenta un avanzamento significativo nel campo della modellazione linguistica specifica di dominio, offrendo una soluzione potente per adattare gli LLM a domini specializzati. Combinando i punti di forza di RAG e del fine-tuning, RAFT dota i modelli linguistici della capacità di sfruttare efficacemente le conoscenze di dominio mantenendo robustezza rispetto a imprecisioni nel recupero.
Se vuoi approfondire il mondo di RAG e del fine-tuning, ti consigliamo di esplorare le seguenti risorse:
Poiché la domanda di modelli linguistici specifici di dominio continua a crescere, tecniche come RAFT svolgeranno un ruolo cruciale nel consentire applicazioni NLP più accurate e affidabili in vari settori e domini.
Continua oggi il tuo percorso di apprendimento sull'IA!
Corso
Corso
Corso
blog
Abid Ali Awan
15 min
blog
Abid Ali Awan
10 min
blog
Tim Lu
12 min



