

Khóa học
Các khái niệm về Large Language Models (LLMs)
2 giờ
113.3K
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với GoogleKhi xử lý ngôn ngữ tự nhiên (NLP) tiếp tục phát triển nhanh chóng, các mô hình ngôn ngữ lớn (LLM) đã trở thành những công cụ rất mạnh mẽ, có khả năng xử lý ngày càng nhiều tác vụ. Tuy nhiên, một thách thức dai dẳng là làm thế nào để thích ứng các mô hình tổng quát này với những lĩnh vực có mức độ chuyên môn hóa cao, như tài liệu y khoa hoặc tài liệu phần mềm.
Đây chính là lúc Retrieval-Augmented Fine-Tuning (RAFT) xuất hiện, một kỹ thuật mới có thể thay đổi cách tiếp cận NLP theo miền. RAFT kết hợp điểm mạnh của Retrieval-Augmented Generation (RAG) — phương pháp kết hợp LLM với nguồn dữ liệu bên ngoài — và fine-tuning, giúp mô hình không chỉ học kiến thức theo miền mà còn học cách truy xuất và hiểu chính xác ngữ cảnh bên ngoài để thực hiện tác vụ.
Trong bài viết này, chúng ta sẽ khám phá cơ chế hoạt động của RAFT, xem xét các ưu điểm của nó và tìm hiểu cách kỹ thuật tiên tiến này có thể cách mạng hóa cách chúng ta xử lý các tác vụ NLP theo miền. Để bắt đầu, hãy xem một số tài nguyên về RAG, như bài giới thiệu về RAG và ứng dụng thực tiễn của RAG.
Retrieval Augmented Fine-Tuning (RAFT) là một cách tiếp cận đột phá dành cho mô hình ngôn ngữ, kết hợp lợi ích của RAG và fine-tuning. Kỹ thuật này điều chỉnh mô hình ngôn ngữ cho các miền cụ thể bằng cách tăng cường khả năng hiểu và sử dụng kiến thức theo miền, đồng thời đảm bảo độ vững vàng trước các truy xuất không chính xác.
RAFT được thiết kế riêng để giải quyết thách thức trong việc thích ứng LLM với các lĩnh vực chuyên biệt. Trong các bối cảnh này, suy luận dựa trên kiến thức tổng quát trở nên kém quan trọng hơn, và trọng tâm chuyển sang tối đa hóa độ chính xác đối với một tập tài liệu theo miền được xác định trước.
Retrieval-Augmented Generation (RAG) là một kỹ thuật tăng cường mô hình ngôn ngữ bằng cách tích hợp một mô-đun truy xuất, mô-đun này lấy thông tin liên quan từ các cơ sở tri thức bên ngoài.
Mô-đun truy xuất sẽ tìm các tài liệu phù hợp dựa trên truy vấn đầu vào. Sau đó, mô hình ngôn ngữ sử dụng ngữ cảnh bổ sung này để tạo ra đầu ra cuối cùng.
Hoạt động theo mô hình “truy xuất và đọc”, RAG đã chứng tỏ hiệu quả cao trong nhiều tác vụ NLP, bao gồm mô hình hóa ngôn ngữ và hỏi đáp mở.
Tuy nhiên, các mô hình ngôn ngữ này không được huấn luyện để truy xuất chính xác các tài liệu theo miền và thay vào đó chỉ có kiến thức tổng quát từ giai đoạn tiền huấn luyện.
Như đã nêu trong bài báo gốc, các phương pháp truy xuất trong ngữ cảnh hiện có tương đương với việc làm bài thi “mở sách” nhưng không biết tài liệu nào liên quan nhất để trả lời câu hỏi.
Để tìm hiểu thêm về RAG, hãy xem cách dùng RAG với GPT và Milvus để thực hiện Hỏi đáp.
Fine-tuning là một cách tiếp cận được áp dụng rộng rãi để điều chỉnh các LLM đã tiền huấn luyện cho các tác vụ hạ nguồn. Quá trình này bao gồm việc huấn luyện thêm mô hình trên dữ liệu theo tác vụ, giúp nó học các mẫu và căn chỉnh với định dạng đầu ra mong muốn.
Fine-tuning đã chứng minh thành công trong nhiều ứng dụng NLP, như tóm tắt, hỏi đáp và tạo hội thoại. Tuy nhiên, các phương pháp fine-tuning truyền thống có thể gặp khó khăn khi tận dụng kiến thức theo miền từ bên ngoài hoặc xử lý các truy xuất chưa hoàn hảo trong giai đoạn suy luận.
Dùng một phép so sánh tương tự, fine-tuning giống như ghi nhớ tài liệu và trả lời câu hỏi mà không tham chiếu lại trong lúc thi. Vấn đề là fine-tuning có thể tốn kém, và kiến thức đã fine-tune có thể nhanh chóng lỗi thời. Ngoài ra, các phương pháp fine-tuning này không linh hoạt bằng các phương pháp dựa trên RAG.
Để tìm hiểu thêm về fine-tuning, đây là hướng dẫn nhập môn về fine-tuning LLM.
RAFT nhận ra những hạn chế của các cách tiếp cận hiện tại và nhằm kết hợp điểm mạnh của RAG và fine-tuning. Bằng cách đưa các tài liệu theo miền vào trong quá trình fine-tuning, RAFT giúp mô hình học các mẫu đặc trưng cho miền đích, đồng thời tăng cường khả năng hiểu và sử dụng hiệu quả ngữ cảnh bên ngoài.
Ở mức cao, trong RAFT, dữ liệu huấn luyện gồm có câu hỏi, tài liệu (cả liên quan và không liên quan), và các câu trả lời theo kiểu chuỗi suy luận (chain-of-thought) được tạo từ các tài liệu liên quan. Mô hình được huấn luyện để trả lời câu hỏi dựa trên những tài liệu được cung cấp này, bao gồm cả các tài liệu gây nhiễu không chứa thông tin phù hợp. Cách tiếp cận này dạy mô hình nhận diện và ưu tiên thông tin liên quan trong khi bỏ qua nội dung không liên quan.
Hãy đi sâu hơn vào cơ chế hoạt động của Retrieval-Augmented Fine-Tuning. RAFT đề xuất một phương pháp mới để chuẩn bị dữ liệu fine-tuning nhằm huấn luyện các mô hình trả lời RAG theo miền. Trong RAFT, mỗi điểm dữ liệu trong tập huấn luyện bao gồm:
Trong tập dữ liệu fine-tuning của RAFT, mỗi câu hỏi được ghép với một tập tài liệu, một số chứa đáp án và một số không, kèm theo một câu trả lời theo kiểu chuỗi suy luận. Cấu trúc này đặc biệt hữu ích để huấn luyện mô hình phân biệt giữa thông tin hữu ích và thông tin không liên quan khi suy ra câu trả lời.
Để tăng cường khả năng học của mô hình, tập dữ liệu huấn luyện RAFT bao gồm nhiều kiểu câu hỏi:
Cuối cùng, các câu trả lời theo kiểu chuỗi suy luận sẽ lồng ghép các đoạn trích từ tài liệu oracle và quy trình lập luận chi tiết. Cách làm này nâng cao độ chính xác của mô hình khi trả lời bằng cách dạy nó tạo chuỗi lập luận dựa trên các đoạn liên quan từ ngữ cảnh gốc.
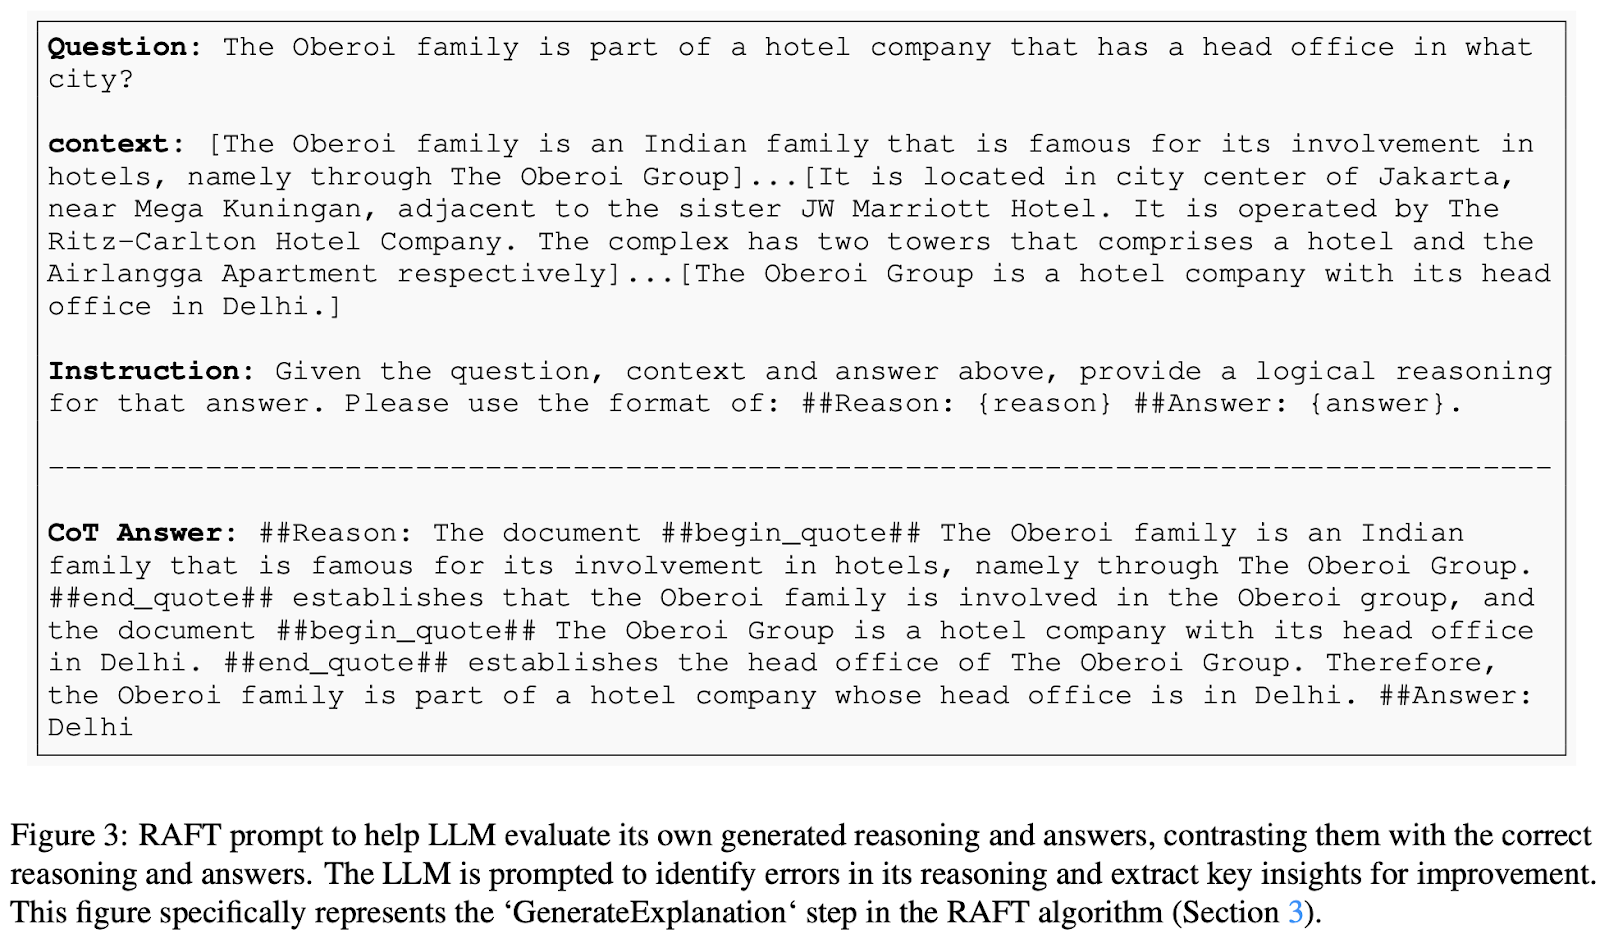
Nguồn ảnh: RAFT: Adapting Language Model to Domain Specific RAG
Sau khi chuẩn bị dữ liệu huấn luyện, quy trình fine-tuning bao gồm:
Trong giai đoạn suy luận, mô hình đã fine-tune sẽ được đưa một câu hỏi và top-K tài liệu do pipeline RAG truy xuất. Lưu ý rằng mô-đun truy xuất hoạt động độc lập với RAFT.
Để chứng minh RAFT vượt trội trong việc trích xuất thông tin liên quan từ tài liệu trong miền và trả lời câu hỏi, bài báo gốc đã so sánh cách tiếp cận RAFT với một mô hình mục đích chung dùng RAG và với các mô hình fine-tuning theo miền. Cụ thể, họ đã fine-tune Llama-2 bằng phương pháp RAFT để tạo ra mô hình RAFT 7B và so sánh với các phương án sau:
Các mô hình này được đánh giá trên ba loại tập dữ liệu để đo lường hiệu năng của RAFT trên nhiều miền:
Nhìn chung, kết quả cho thấy RAFT liên tục vượt trội so với phương pháp fine-tuning có giám sát, cả khi có và không có RAG, trên PubMed, HotpotQA và các tập API khác.
Khi so với fine-tuning theo miền (DSF), RAFT vượt trội đáng kể. Đáng chú ý, DSF kèm RAG không mang lại hiệu năng tốt hơn, thậm chí còn kém hơn.
Điều này cho thấy DSF thiếu khả năng trích xuất hiệu quả thông tin liên quan từ các tài liệu được cung cấp. Nhờ sử dụng RAFT, chúng ta huấn luyện mô hình vừa xử lý tài liệu chính xác vừa đưa ra phong cách trả lời phù hợp.
Cách tiếp cận RAFT thậm chí còn vượt GPT-3.5 kèm RAG — một mô hình ngôn ngữ lớn hơn nhiều — cho thấy hiệu quả của RAFT.
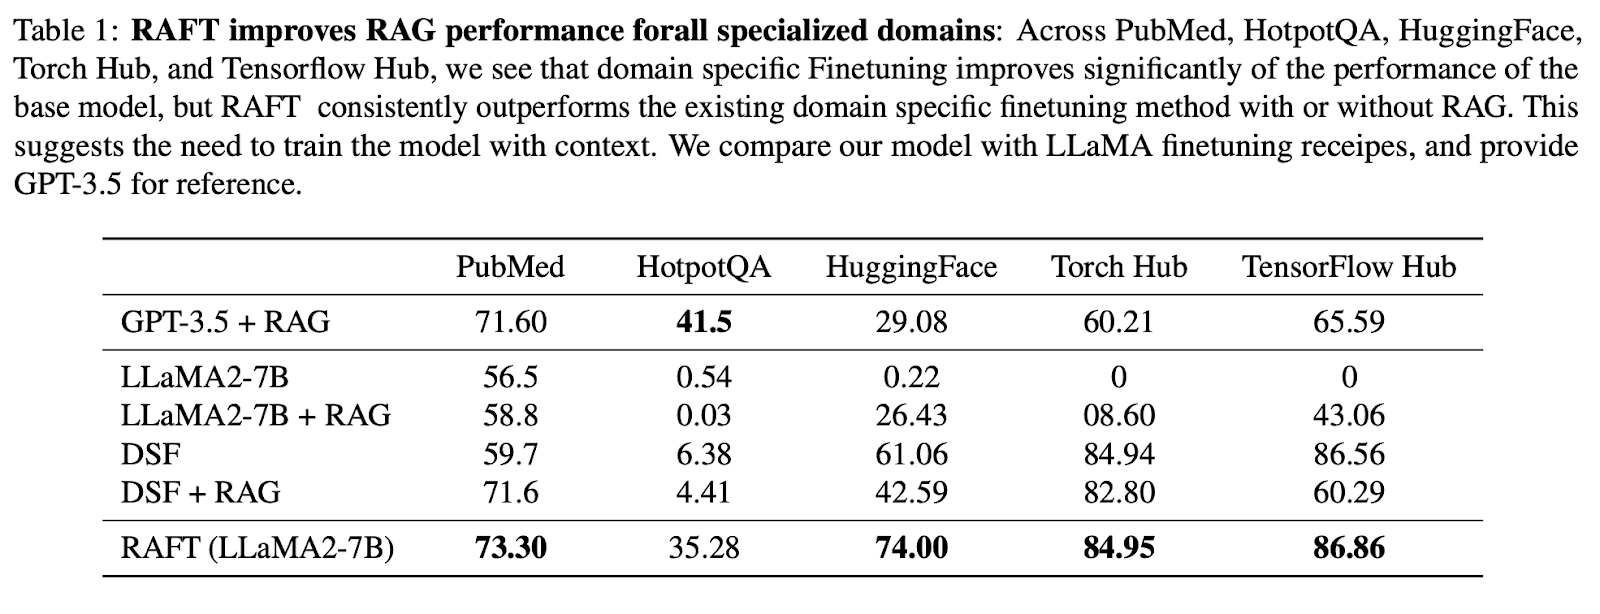
Nguồn ảnh: RAFT: Adapting Language Model to Domain Specific RAG
Nghiên cứu cắt giảm thành phần (ablation)
Ngoài các thí nghiệm chính, bài báo gốc cũng thực hiện một số nghiên cứu ablation để hiểu tác động của các thành phần khác nhau lên hiệu năng của RAFT:
Để triển khai RAFT, các nhà nghiên cứu và thực hành có thể làm theo các bước được nêu trong bài báo. Điều này bao gồm tạo các câu trả lời kiểu chuỗi suy luận từ tài liệu liên quan, đưa tài liệu gây nhiễu vào quá trình huấn luyện và fine-tuning mô hình bằng các kỹ thuật học có giám sát. Các tác giả cũng đã mã nguồn mở và cung cấp bản demo để hỗ trợ thử nghiệm và áp dụng RAFT rộng rãi hơn.
RAFT là một bước tiến quan trọng trong lĩnh vực mô hình ngôn ngữ theo miền, mang lại giải pháp mạnh mẽ để thích ứng LLM với các miền chuyên biệt. Bằng cách kết hợp điểm mạnh của RAG và fine-tuning, RAFT trang bị cho mô hình ngôn ngữ khả năng tận dụng hiệu quả kiến thức theo miền, đồng thời duy trì độ vững vàng trước các sai lệch khi truy xuất.
Nếu muốn đào sâu hơn vào thế giới RAG và fine-tuning, bạn có thể khám phá các tài nguyên sau:
Khi nhu cầu về mô hình ngôn ngữ theo miền tiếp tục tăng, các kỹ thuật như RAFT sẽ đóng vai trò then chốt trong việc tạo ra các ứng dụng NLP chính xác và đáng tin cậy hơn trên nhiều ngành và lĩnh vực.
Tiếp tục hành trình học AI của bạn ngay hôm nay!
Khóa học
Khóa học
Luyện tập và Lộ trình tiến trình của bạn.
Tiếp Tục Với Googleblog
Matt Crabtree
10 phút
