Kurs
Konzepte großer Sprachmodelle (LLMs)
2 Std.
110.3K
Mit dem rasanten Fortschritt im Bereich Natural Language Processing (NLP) sind große Sprachmodelle (LLMs) zu äußerst leistungsfähigen Werkzeugen geworden, die immer mehr Aufgaben bewältigen. Eine zentrale Herausforderung bleibt jedoch, diese allgemeinen Modelle an hochspezialisierte Bereiche wie medizinische Fachliteratur oder Softwaredokumentation anzupassen.
Genau hier setzt Retrieval-Augmented Fine-Tuning (RAFT) an – eine neue Technik, die domänenspezifisches NLP grundlegend verändern könnte. RAFT vereint die Stärken von Retrieval-Augmented Generation (RAG), also der Kombination von LLMs mit externen Datenquellen, und Fine-Tuning. So lernen Modelle nicht nur domänenspezifisches Wissen, sondern auch, wie sie externen Kontext gezielt auffinden und verstehen, um Aufgaben präzise zu lösen.
In diesem Artikel schauen wir uns an, wie RAFT im Inneren funktioniert, welche Vorteile es bietet und wie diese Technik unser Vorgehen bei domänenspezifischen NLP-Aufgaben revolutionieren könnte. Zum Einstieg empfehlen wir Ressourcen zu RAG wie unsere Einführung in RAG und praktische Anwendungsbeispiele für RAG.
Retrieval Augmented Fine-Tuning (RAFT) ist ein neuartiger Ansatz für Sprachmodelle, der die Vorteile von RAG und Fine-Tuning kombiniert. Die Technik passt Sprachmodelle an spezifische Domänen an, indem sie die Fähigkeit der Modelle stärkt, domänenspezifisches Wissen zu verstehen und zu nutzen – und zugleich robust gegenüber ungenauen Retrievals zu bleiben.
RAFT wurde speziell entwickelt, um die Herausforderungen bei der Anpassung von LLMs an spezialisierte Domänen zu adressieren. In solchen Kontexten ist allgemeines Weltwissen weniger entscheidend; im Vordergrund steht maximale Genauigkeit bezogen auf einen vordefinierten Korpus domänenspezifischer Dokumente.
Retrieval-Augmented Generation (RAG) erweitert Sprachmodelle um ein Retrieval-Modul, das passende Informationen aus externen Wissensquellen bezieht.
Dieses Modul sucht auf Basis der Eingabeanfrage relevante Dokumente. Das Sprachmodell nutzt den zusätzlichen Kontext anschließend zur Generierung der Ausgabe.
RAG folgt dem Prinzip „abrufen und lesen“ und hat sich in vielen NLP-Aufgaben bewährt, etwa beim Sprachmodellieren oder beim Open-Domain-Question-Answering.
Allerdings wurden diese Sprachmodelle nicht darauf trainiert, präzise domänenspezifische Dokumente zu retrieven, sondern verfügen vor allem über allgemeines Domänenwissen aus dem Pre-Training.
Wie im Originalpapier beschrieben, ähneln bestehende In-Context-Retrieval-Methoden einer Open-Book-Prüfung, bei der man nicht weiß, welche Dokumente für die Antwort tatsächlich relevant sind.
Mehr zu RAG findest du hier: Wie sich RAG mit GPT und Milvus für Question Answering einsetzen lässt.
Fine-Tuning ist ein verbreiteter Ansatz, um vortrainierte LLMs für nachgelagerte Aufgaben anzupassen. Das Modell wird dafür mit aufgabenspezifischen Daten weitertrainiert, lernt Muster und richtet sich am gewünschten Ausgabeformat aus.
Fine-Tuning war in vielen NLP-Anwendungen erfolgreich, etwa beim Zusammenfassen, beim Question Answering oder in der Dialoggenerierung. Klassische Fine-Tuning-Verfahren tun sich jedoch schwer damit, externes domänenspezifisches Wissen zu nutzen oder bei der Inferenz mit unvollkommenen Retrievals umzugehen.
Um im Bild zu bleiben: Fine-Tuning entspricht dem Auswendiglernen von Dokumenten und dem Beantworten von Fragen, ohne während der Prüfung in die Unterlagen zu schauen. Das Problem: Fine-Tuning kann teuer sein, das erlernte Wissen veraltet schnell, und die Verfahren reagieren weniger flexibel als RAG-basierte Methoden.
Wenn du tiefer einsteigen willst, gibt es hier eine Einführung ins Fine-Tuning von LLMs.
RAFT erkennt die Grenzen bestehender Ansätze und kombiniert gezielt die Stärken von RAG und Fine-Tuning. Durch die Einbindung domänenspezifischer Dokumente während des Fine-Tunings lernt das Modell domänentypische Muster – und verbessert zugleich seine Fähigkeit, externen Kontext effektiv zu verstehen und zu nutzen.
Auf hoher Ebene besteht das Trainingsmaterial bei RAFT aus Fragen, Dokumenten (sowohl relevanten als auch irrelevanten) und dazugehörigen Chain-of-Thought-Antworten, die aus den relevanten Dokumenten abgeleitet sind. Das Modell wird darauf trainiert, Fragen auf Basis der bereitgestellten Dokumente zu beantworten, einschließlich Ablenkdokumenten ohne relevante Information. So lernt es, Relevantes zu erkennen und zu priorisieren und Irrelevantes auszublenden.
Werfen wir einen genaueren Blick auf die Mechanik von Retrieval-Augmented Fine-Tuning. RAFT schlägt eine neuartige Methode zur Aufbereitung der Fine-Tuning-Daten vor, um In-Domain-RAG-Answering-Modelle zu trainieren. In RAFT besteht jeder Datenpunkt im Trainingsdatensatz aus:
Im RAFT-Fine-Tuning-Datensatz ist jede Frage einem Set aus Dokumenten zugeordnet – teils mit Antworten, teils ohne – plus einer Chain-of-Thought-Antwort. Diese Struktur eignet sich besonders, um das Modell darin zu schulen, bei der Ableitung der Antwort Nützliches von Unnützem zu trennen.
Zur weiteren Vertiefung mischt der RAFT-Datensatz unterschiedliche Fragetypen:
Die Chain-of-Thought-Antworten enthalten schließlich Auszüge aus den Oracle-Dokumenten sowie einen detaillierten Argumentationspfad. Auf diese Weise lernt das Modell, mithilfe relevanter Segmente aus dem Originalkontext eine konsistente Begründungskette zu bilden und dadurch genauer zu antworten.
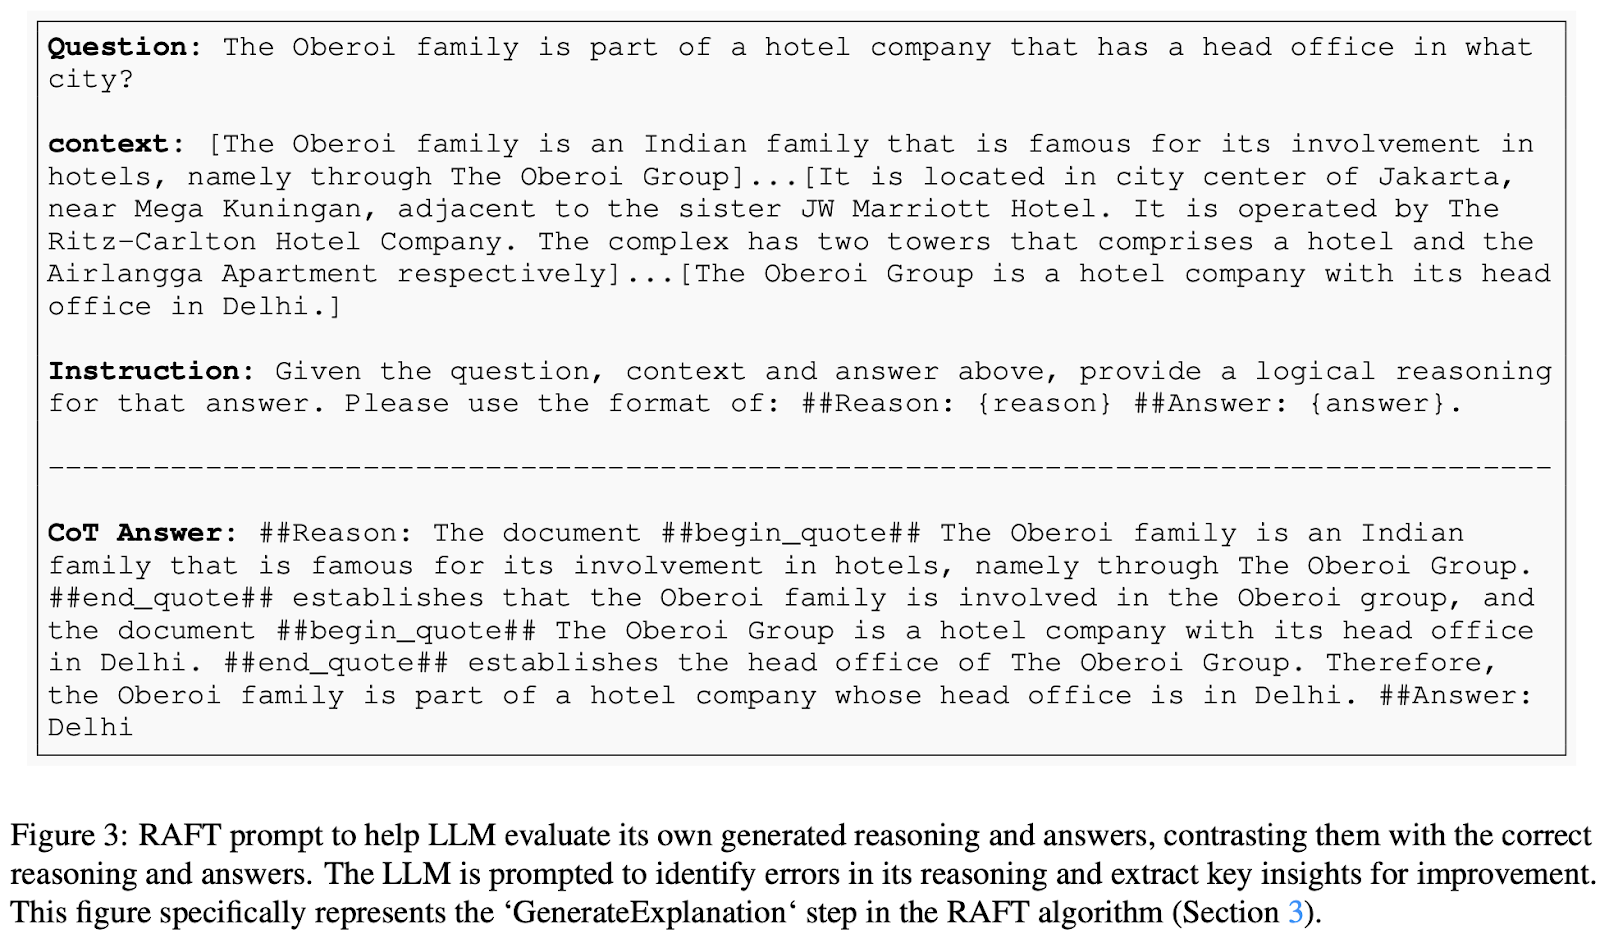
Bildquelle: RAFT: Adapting Language Model to Domain Specific RAG
Sobald die Trainingsdaten vorbereitet sind, umfasst der Fine-Tuning-Prozess:
In der Inferenzphase erhält das feinabgestimmte Modell eine Frage und die Top-K-Dokumente, die durch die RAG-Pipeline gefunden wurden. Wichtig: Das Retriever-Modul arbeitet unabhängig von RAFT.
Um zu zeigen, dass RAFT relevante Informationen aus In-Domain-Dokumenten besonders gut extrahiert und Fragen beantwortet, vergleicht das Originalpapier den RAFT-Ansatz mit einem General-Purpose-Modell mit RAG sowie mit domänenspezifisch feinabgestimmten Modellen. Konkret wurde Llama-2 per RAFT-Methode feinabgestimmt (RAFT 7B) und verglichen mit:
Die Modelle wurden auf drei Datensatztypen evaluiert, um die RAFT-Performance über verschiedene Domänen hinweg zu messen:
Insgesamt zeigte sich: RAFT übertraf die überwachten Fine-Tuning-Methoden konsistent – mit und ohne RAG – in PubMed, HotpotQA und den API-Datensätzen.
Im direkten Vergleich mit domänenspezifischem Fine-Tuning (DSF) lag RAFT deutlich vorn. Bemerkenswert: DSF mit RAG brachte keine besseren Ergebnisse – im Gegenteil, die Performance verschlechterte sich.
Das legt nahe, dass DSF relevante Informationen aus bereitgestellten Dokumenten nicht effektiv extrahieren kann. Mit RAFT hingegen trainieren wir das Modell darauf, Dokumente korrekt zu verarbeiten und im passenden Stil zu antworten.
Der RAFT-Ansatz übertraf sogar GPT-3.5 mit RAG – obwohl dieses deutlich größer ist. Das unterstreicht die Wirksamkeit von RAFT.
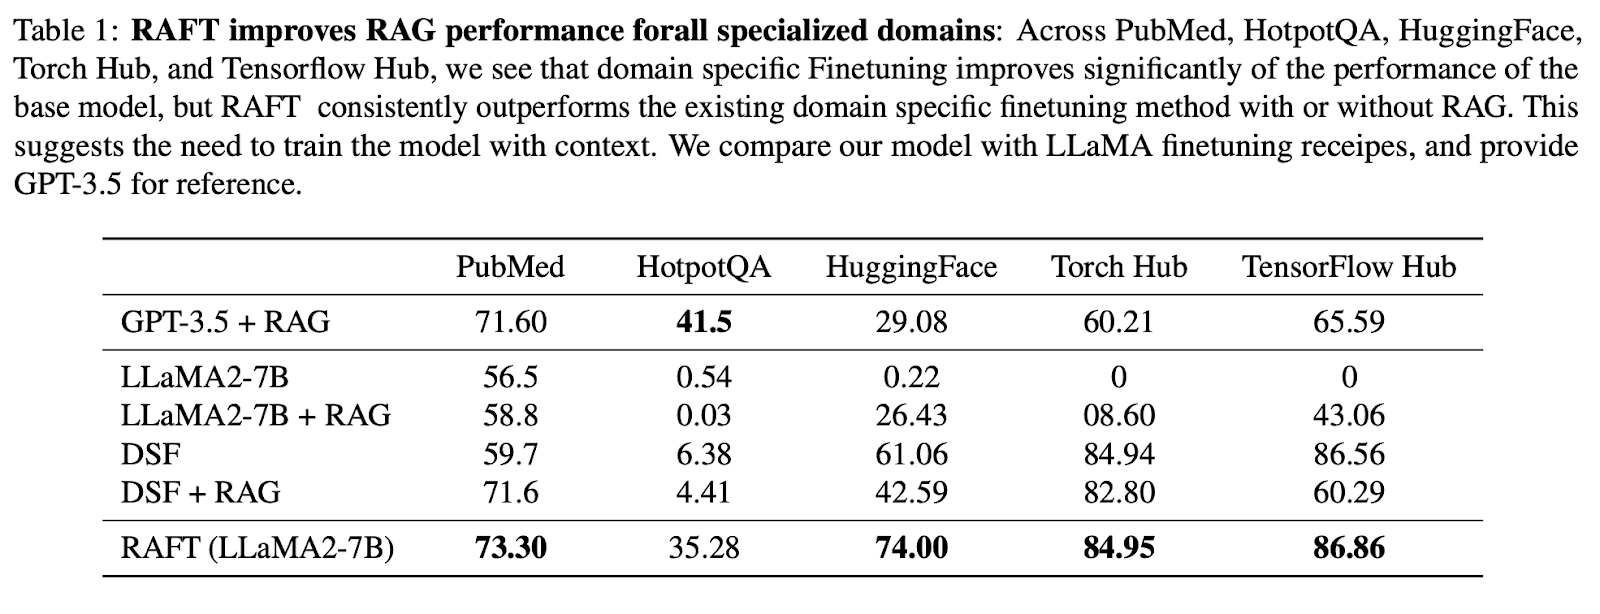
Bildquelle: RAFT: Adapting Language Model to Domain Specific RAG
Ablationsstudien
Zusätzlich zu den Hauptexperimenten führten die Autorinnen und Autoren mehrere Ablationsstudien durch, um den Einfluss einzelner Komponenten auf die RAFT-Performance zu verstehen:
Für die Umsetzung können Forschende und Praktiker den Schritten aus dem Paper folgen: Chain-of-Thought-Antworten aus relevanten Dokumenten generieren, Distractor-Dokumente ins Training einbeziehen und das Modell per überwachtem Lernen feinabstimmen. Der Code ist als Open Source verfügbar, inklusive Demo, um Experimente und die Anwendung von RAFT zu erleichtern.
RAFT ist ein bedeutender Schritt im domänenspezifischen Sprachmodellieren und bietet eine starke Lösung, um LLMs an spezialisierte Domänen anzupassen. Durch die Kombination der Stärken von RAG und Fine-Tuning können Sprachmodelle domänenspezifisches Wissen effektiv nutzen – und bleiben zugleich robust gegenüber Retrieval-Ungenauigkeiten.
Wenn du tiefer in RAG und Fine-Tuning eintauchen möchtest, empfehlen wir folgende Ressourcen:
Da die Nachfrage nach domänenspezifischen Sprachmodellen weiter steigt, werden Techniken wie RAFT entscheidend sein, um in unterschiedlichsten Branchen präzise und verlässliche NLP-Anwendungen zu ermöglichen.
Starte noch heute mit deiner KI-Lernreise!
Kurs
Kurs
Kurs