Kursus
Memahami Machine Learning
2 jam
313.7K
Gunakan teknik mutakhir dengan R, NLP, dan Machine Learning untuk memodelkan topik dalam teks dan membangun sistem rekomendasi musik Anda sendiri!
Ini adalah Bagian Dua-B dari seri tutorial tiga bagian di mana Anda akan terus menggunakan R untuk melakukan berbagai tugas analitik pada studi kasus lirik lagu dari seniman legendaris Prince, serta artis dan penulis lain. Ketiga tutorial mencakup hal-hal berikut:
Bayangkan Anda adalah seorang Data Scientist yang bekerja di NASA. Anda diminta memantau dua wahana antariksa untuk orbit bulan yang akan mempelajari interaksi bulan dengan matahari. Seperti halnya wahana antariksa lain, bisa ada masalah yang tertangkap selama pengujian atau pascapeluncuran. Anomali ini didokumentasikan dalam bahasa alami ke hampir 20.000 laporan masalah. Tugas Anda adalah mengidentifikasi topik paling populer dan tema yang sedang tren dalam korpus laporan tersebut dan memberikan hasil analisis preskriptif kepada para insinyur dan direktur program, sehingga berdampak pada masa depan eksplorasi ruang angkasa.
Ini adalah contoh skenario nyata dan seharusnya memberi gambaran tentang kekuatan yang akan Anda miliki setelah mempelajari cara menggunakan teknik mutakhir, seperti pemodelan topik dengan machine learning, Natural Language Processing (NLP), dan pemrograman R. Untungnya, Anda tidak harus bekerja di NASA untuk melakukan sesuatu yang sama inovatifnya. Dalam tutorial ini, misi Anda, jika Anda memilih untuk menerimanya, adalah mempelajari tentang pemodelan topik dan cara membangun sistem rekomendasi sederhana (alias recommender) berdasarkan lirik musik dan buku nonfiksi.
Hanya untuk Bersenang-senang!
Ini tidak ada hubungannya dengan pemodelan topik, tetapi untuk seru-seruan, gunakan paket hebat bernama circlize, yang diperkenalkan di tutorial sebelumnya, untuk menyalakan fotoreseptor Anda dan nikmati diagram lingkaran dari semua sumber yang akan Anda gunakan dalam tutorial ini.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)
Dalam tutorial sebelumnya, Anda mempelajari isi lirik Prince menggunakan frekuensi kata, statistik tf-idf, dan analisis sentimen. Anda bisa mendapatkan wawasan lebih dalam ke lirik dan teks lain dengan menggunakan konsep pemodelan topik.
Dalam tutorial ini, Anda akan membangun empat model menggunakan algoritma machine learning Latent Dirichlet Allocation (LDA) dan klastering K-Means. Saya akan menjelaskan algoritma tersebut nanti di tutorial.
Model Satu memanfaatkan teks dari lirik Prince yang digabungkan dengan dua buku nonfiksi. Tujuan model ini adalah memberi Anda contoh sederhana penggunaan LDA, sebuah algoritma tanpa pengawasan, untuk menghasilkan kumpulan kata yang bersama-sama menyiratkan tema. Tema-tema ini tidak berlabel dan memerlukan interpretasi manusia. Setelah Anda mengidentifikasi sejumlah tema yang telah ditentukan, Anda kemudian akan mengambil hasil model dan mengklasifikasikan setiap lagu atau halaman buku ke dalam setiap kategori. Sebuah lagu mungkin memuat semua topik yang Anda hasilkan, tetapi bisa lebih pas ke salah satu dibanding yang lain. Ini disebut sebagai klasifikasi dokumen, namun karena Anda mengetahui penulis dokumen, pada dasarnya Anda mengklasifikasikan penulis ke dalam kelompok tematik.
Model Dua menggunakan dataset Model Satu dan memberikan sekilas proses menghasilkan tema menggunakan algoritma berbeda, k-means, serta bagaimana ini mungkin bukan pilihan terbaik untuk pemodelan topik.
Kembali menggunakan LDA, Model Tiga memanfaatkan dataset yang lebih besar dengan banyak artis dari berbagai genre dan lebih banyak penulis buku. Ketika Anda mengklasifikasikan mayoritas dokumen dari seorang penulis/artis ke topik paling mungkin mereka, Anda menciptakan kemampuan untuk mengelompokkan penulis dengan komposisi tematik serupa. Dengan model yang solid, Anda seharusnya melihat genre serupa muncul dalam kelompok topik yang sama. Misalnya, artis rap akan muncul dalam satu topik, dan dua buku dengan subjek serupa akan muncul bersama dalam topik berbeda. Dengan demikian, Anda berpotensi dapat merekomendasikan penulis serupa! Jelas, penulis dan genre mereka berlabel, tetapi topiknya tidak, sehingga bersifat tanpa pengawasan.
Model Empat menggunakan LDA hanya pada lirik Prince. Kali ini Anda akan menggunakan dataset beranotasi yang dihasilkan di luar tutorial ini, yang menandai setiap kata sebagai kelas kata (mis. nomina, verba, dll.) serta bentuk dasar (lematisasi) katanya. Anda juga akan memeriksa bagaimana topik berubah dari waktu ke waktu.
NLP dan Machine Learning adalah subbidang Kecerdasan Buatan. Baru-baru ini ada upaya menggunakan AI untuk menulis lagu. Itu bukan tujuan tutorial ini, tetapi merupakan contoh bagaimana AI dapat digunakan sebagai seni. Bagaimanapun, tiga huruf pertamanya adalah A-R-T! Bandingkan sejenak AI dengan penulisan lagu: Anda bisa dengan mudah mengikuti pola dan membuat struktur (bait, reff, bait, dst.), tetapi yang membuat lagu hebat adalah ketika penulis menyuntikkan kreativitas ke dalam proses. Dalam tutorial ini, Anda perlu mengasah keterampilan teknis untuk membangun model, namun Anda juga perlu memanggil kreativitas artistik Anda dan mengembangkan kemampuan untuk menafsirkan serta menjelaskan hasil Anda.
Pertimbangkan ini: Jika pemodelan topik adalah seni, maka lirik adalah kodenya, penulisan lagu adalah algo-rhythm, dan lagunya adalah model! Apa analogi Anda?
Sistem rekomendasi yang umum tidak sepenuhnya berbasis teks. Misalnya, Netflix dapat merekomendasikan film berdasarkan pilihan sebelumnya dan metadata terkait. Pandora memiliki pendekatan berbeda dan bergantung pada Music Genome yang terdiri dari 400 atribut musik, termasuk melodi, ritme, komposisi, dan ringkasan lirik; namun, pengembangan genom ini dimulai pada tahun 2000 dan memakan waktu lima tahun serta melibatkan 30 pakar teori musik. Ada banyak makalah riset yang membahas rekomendasi film berdasarkan ringkasan plot. Contoh sistem rekomendasi musik yang benar-benar berbasis konten lirik lebih sulit ditemukan. Ingin mencobanya?
Bagian Dua-B dari seri tutorial ini memerlukan pemahaman dasar tentang tidy data - khususnya paket seperti dplyr dan ggplot2. Latihan penambangan teks menggunakan tidytext juga direkomendasikan, karena telah dibahas dalam tutorial sebelumnya. Anda juga perlu familier dengan fungsi R, karena Anda akan memanfaatkan beberapa fungsi untuk menggunakan ulang kode pada tiap model. Agar fokus pada penangkapan wawasan, saya menyertakan kode yang dirancang untuk digunakan pada dataset Anda sendiri, tetapi penjelasan mendetail mungkin memerlukan eksplorasi lebih lanjut dari Anda.
Apa yang dapat Anda lakukan dengan pemodelan topik? Barangkali ada dokumen yang memuat informasi penting bagi bisnis Anda yang dapat Anda gali. Mungkin Anda dapat mengikis data dari Twitter dan mengetahui apa yang orang katakan tentang produk perusahaan Anda. Mungkin Anda bisa membangun sistem klasifikasi Anda sendiri untuk mengirim dokumen tertentu ke departemen yang tepat untuk dianalisis. Ada banyak kemungkinan yang dapat Anda jelajahi! Silakan!
Berikut beberapa penerapan pemodelan topik:
Satu-satunya paket baru dalam tutorial ini yang tidak ada di Bagian Satu atau Bagian Dua-A adalah topicmodels, tm, dan plotly. Anda akan menggunakan fungsi LDA() dari topicmodels yang memungkinkan model belajar membedakan berbagai dokumen. Paket tm untuk penambangan teks, dan Anda hanya menggunakan fungsi inspect() sekali untuk melihat isi document-term matrix, yang akan saya jelaskan nanti. Anda hanya menggunakan plotly sekali untuk membuat versi interaktif grafik ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Fungsi-fungsi berikut didefinisikan di tutorial sebelumnya kecuali word_chart(); namun, konten dan deskripsi word_chart() juga dapat ditemukan di Bagian Dua-B. Yang terutama perlu Anda ketahui adalah bahwa fungsi ini menggunakan ggplot() dengan cara unik untuk membuat visual berbasis kata alih-alih titik.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Untuk benar-benar melihat kekuatan pemodelan topik dan klasifikasi, Anda tidak hanya akan menggunakan lirik Prince seperti pada tutorial sebelumnya, tetapi Anda juga akan bekerja dengan beberapa artis lain dari genre berbeda yang diakui di Billboard Charts. Selain itu, saya menambahkan beberapa buku tentang topik berbeda, seperti nutrisi olahraga, gunung es, dan bahkan machine learning! Dengan memiliki dataset yang beragam, Anda dapat mengklasifikasikan dokumen ke dalam topik terkait dan membedakan antara artis/penulis yang serupa.
Tip: Saya akan merujuk lagu dan halaman buku sebagai dokumen, dan musisi/penulis sebagai penulis. Dalam kode, Anda akan melihat referensi ke kata source. Ini hanya merujuk ke penulis mana data tersebut mengacu. Saya akan menggunakan kata genre untuk merujuk pada genre musik maupun kategori buku. Alih-alih menggunakan nama penulis buku, saya menggunakan judul buku, demi kejelasan. Referensi ini akan masuk akal saat Anda maju melalui tutorial.
Agar fokus pada pemodelan, saya melakukan conditioning data di luar tutorial ini dan telah menyediakan semua data yang Anda butuhkan dalam tiga file di bawah ini dengan conditioning berikut sudah diterapkan:
pdf_text() dari paket pdftools untuk mengumpulkan konten empat buku (setiap halaman mewakili dokumen yang berbeda)tidytext yang dijelaskan di Bagian SatuAnda akan memiliki tiga dataset berbeda untuk dikerjakan dalam tutorial ini:
three_sources_tidy_balanced: berisi lirik Prince dan dua bukuall_sources_tidy_balanced: berisi lirik dari delapan artis dan empat bukuprince_tidy: hanya berisi lirik PrinceSaya juga menyertakan dataset beranotasi dari lirik Prince. Saya akan menjelaskan apa yang dimaksud dengan anotasi ketika Anda sampai ke Model Empat.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)Tujuan utama pemodelan topik adalah menemukan istilah-istilah ( topik ) yang secara tematik saling terkait dalam data tekstual tak terstruktur yang diukur sebagai pola ko-kemunculan kata. Komponen dasar model topik adalah dokumen, istilah, dan topik. Latent Dirichlet Allocation (LDA) adalah metode pembelajaran tanpa pengawasan yang menemukan berbagai topik yang mendasari kumpulan dokumen, di mana setiap dokumen adalah kumpulan kata. LDA membuat asumsi berikut:
LDA berupaya menemukan kelompok kata yang saling terkait. Ini adalah algoritma generatif yang iteratif. Berikut dua langkah utamanya:
Konsep di balik model topik LDA adalah bahwa kata-kata yang termasuk dalam sebuah topik muncul bersama dalam dokumen. Ia mencoba memodelkan setiap dokumen sebagai campuran topik dan setiap topik sebagai campuran kata. (Anda mungkin melihat ini disebut sebagai model keanggotaan campuran.) Anda kemudian dapat menggunakan probabilitas bahwa suatu dokumen termasuk dalam topik tertentu untuk mengklasifikasikannya. Dalam kasus Anda, karena Anda mengetahui penulis dokumen dari data asli, Anda kemudian dapat merekomendasikan artis/penulis berdasarkan struktur topik yang serupa. Sekarang saatnya melihat contoh.
Untuk model ini, Anda akan menggunakan dataset dengan kombinasi tiga penulis berbeda (yaitu sumber) dan mencari topik tersembunyi. Untuk membantu Anda memahami kekuatan pemodelan topik, ketiga sumber yang dipilih ini sangat berbeda dan secara intuitif Anda tahu bahwa mereka mencakup tiga topik berbeda. Akibatnya, Anda akan memberi tahu model Anda untuk membuat tiga topik dan melihat seberapa cerdas model tersebut. Pertama Anda ingin memeriksa dataset menggunakan fungsi my_kable_styling() bersama color_bar() dan color_tile() dari paket formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
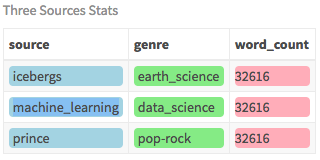
Di sini Anda akan menggunakan lirik Prince, sebuah buku berjudul "Machine Learning For Dummies", dan satu buku lagi berjudul "Why Icebergs Float", masing-masing memiliki lebih dari 30.000 kata (non-distinct).
Karena Anda saat ini memiliki dataset seimbang dan rapi dengan lirik Prince dan dua buku, pertama-tama Anda akan membuat document-term matrix (DTM) di mana setiap dokumen adalah baris, dan setiap kolom adalah istilah. Format ini diperlukan untuk algoritma LDA. Dokumen merujuk pada lagu dalam lirik dan nomor halaman dalam buku. Pertama, Anda akan mengambil data rapi dan menghitung kata-kata dalam sebuah dokumen, lalu menyalurkannya ke fungsi cast_dtm() dari tidytext di mana document adalah nama field dengan nama dokumen dan word adalah nama field dengan istilah. Ada parameter lain yang bisa Anda lewati, tetapi dua ini wajib.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Ini memberi tahu Anda berapa banyak dokumen dan istilah yang Anda miliki dan bahwa ini adalah matriks yang sangat jarang. Kata jarang menyiratkan bahwa DTM sebagian besar berisi kolom kosong. Karena luasnya kosakata istilah yang mungkin dari semua dokumen, hanya sedikit yang akan digunakan dalam masing-masing dokumen.
Jika Anda melihat isi beberapa baris dan kolom DTM menggunakan fungsi inspect() dari paket tm, Anda akan melihat bahwa setiap baris adalah dokumen dan setiap kolom adalah istilah. (Silakan gunakan str() untuk melihat struktur sebenarnya.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Sekarang setelah Anda tahu apa yang dibutuhkan sebagai masukan untuk membangun model, setel dua variabel yang dapat Anda set ulang saat membangun tiap model. Anda akan menamainya source_dtm dan source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedAkhirnya, bagian seru untuk melakukan fitting model. Kodenya sederhana, tetapi untuk menjadi Data Scientist yang baik, Anda perlu memahami apa yang terjadi di balik layar. Meskipun ini deskripsi singkat, ada banyak informasi tentang LDA di internet. Untuk tujuan Anda, Anda hanya perlu mengetahui empat parameter: masukan, jumlah topik, metode sampling, dan seed.
Karena Anda tahu dataset berisi tiga penulis berbeda, Anda akan menyetel k ke 3 dan menyetel seed ke konstanta agar hasil dapat diulang. Ada parameter control lain, karenanya format list pada kode, tetapi untuk saat ini Anda hanya menggunakan seed. Parameter method mendefinisikan algoritma sampling yang digunakan. Anda akan menggunakan metode sampling GIBBS. Defaultnya adalah VEM, tetapi menurut pengalaman saya, ia tidak berkinerja sebaik alternatifnya yaitu sampling GIBBS.
Penjelasan teknis singkat tentang sampling GIBBS adalah bahwa ia melakukan random walk yang dimulai di suatu titik yang dapat Anda inisialisasi (Anda akan menggunakan default 0) dan pada tiap langkah bergerak plus atau minus satu dengan probabilitas yang sama. Baca deskripsi rinci di sini jika Anda tertarik detailnya.
Catatan: Saya melewatkan detail algoritma LDA. Meskipun Anda tidak perlu memahami teori statistik untuk menggunakannya, saya sarankan membaca dokumen ini oleh Ethen Liu yang memberikan penjelasan solid.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Anda dapat melihat bahwa ini membuat objek LDA_Gibbs dengan tiga topik. Saya tidak menjalankan str(lda) di sini karena keluarannya besar, tetapi silakan lakukan sendiri untuk melihat isinya.
Langkah berikutnya adalah membuka objek itu dan melihat hasilnya. Anda dapat menggunakan fungsi tidy() untuk menaruhnya dalam format yang mudah dipahami. Di dalam pemanggilan tidy() lewatkan objek LDA dan beta untuk argumen matrix. Melewatkan beta memberikan probabilitas per-topik-per-kata dari model. Contoh berikut, menggunakan istilah iceberg, menunjukkan probabilitas kata tersebut berada di setiap topik. Kata iceberg memiliki probabilitas lebih tinggi dihasilkan dalam Topik 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Untuk memahami model dengan jelas, Anda perlu melihat istilah apa yang ada di tiap topik. Bangun fungsi yang akan merapikan model LDA, dan mengekstrak istilah teratas untuk setiap topik. Dengan kata lain, istilah per topik dengan nilai beta terbesar. Di dalam fungsi ini, Anda akan merujuk word_chart() yang Anda buat sebelumnya untuk menghasilkan tampilan menarik dari tiga topik dan kata-kata teratas. Setel num_words ke 10 untuk contoh ini, tetapi Anda dapat bereksperimen untuk mendapatkan perspektif berbeda tentang topik.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)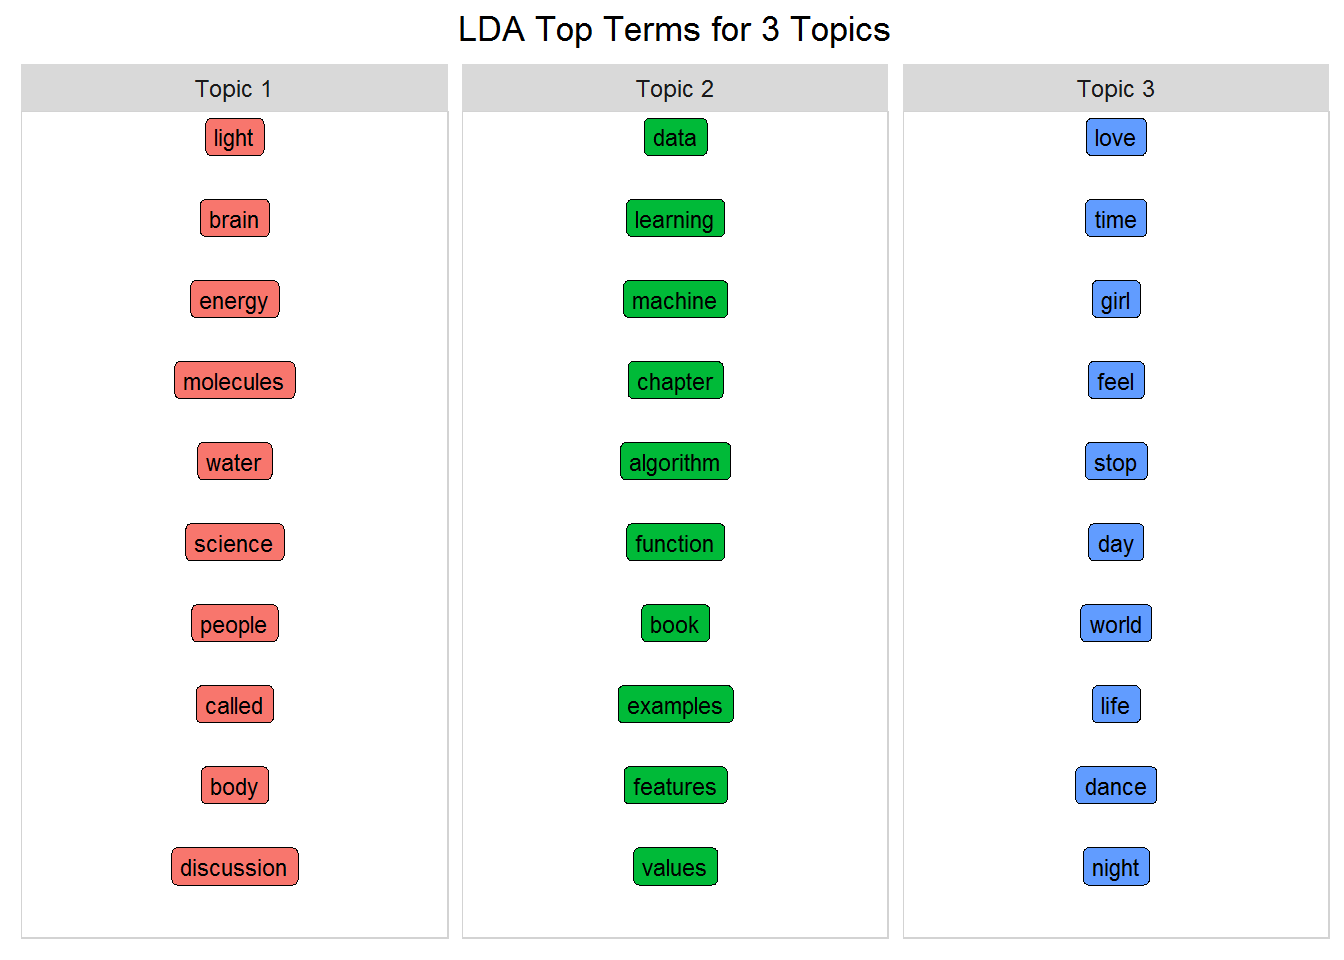
Pembelajaran tanpa pengawasan selalu memerlukan interpretasi manusia... tetapi topik-topik ini jelas mencerminkan tiga sumber Icebergs, Machine Learning, dan Prince! Meskipun ini contoh yang sangat sederhana, cukup menakjubkan jika Anda pikirkan kemungkinannya!
Selain memperkirakan setiap topik sebagai campuran kata, LDA juga menunjukkan setiap dokumen sebagai campuran topik. Kali ini saat Anda merapikan model LDA, gunakan matrix = "gamma" dan Anda akan mendapatkan probabilitas per-dokumen-per-topik. Misalnya, lihat lagu Prince 1999. Di sini Anda melihat bahwa, sama seperti sebuah kata akan terkait dengan banyak topik, hal yang sama berlaku untuk dokumen. Ini kembali ke konsep keanggotaan campuran. Di bawah ini Anda dapat melihat bahwa 1999 paling mungkin muncul di Topik 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661Lagu ini termasuk ke tiap topik, namun pada persentase berbeda, yang direpresentasikan oleh nilai gamma. Beberapa dokumen lebih pas pada beberapa topik dibanding yang lain. Seperti ditunjukkan di atas, 1999 memiliki nilai gamma lebih tinggi untuk Topik 3.
Untuk memperjelas pemahaman Anda tentang apa yang dilakukan LDA, lihat plot lingkaran ini. Plot ini menunjukkan persentase dokumen dari setiap sumber yang termasuk dalam setiap topik. Untuk membuatnya, gabungkan model LDA yang rapi kembali ke source_tidy tempat Anda menyimpan sumber asli (yaitu penulis), dan gabungkan berdasarkan document. Kemudian jika Anda melakukan pengelompokan yang tepat, Anda bisa mendapatkan nilai rata-rata gamma per sumber, per topik. Sekarang Anda dapat melihat, untuk setiap sumber, ke topik mana mayoritas dokumen jatuh.
Luangkan waktu sejenak untuk benar-benar memeriksanya jika Anda belum pernah menggunakan plot lingkaran sebelumnya. (Lihat Bagian Dua-A untuk latihan dengan chordDiagrams() dan paket circlize. Semua yang perlu Anda ketahui tentang paket ini tercakup dalam buku ini oleh Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")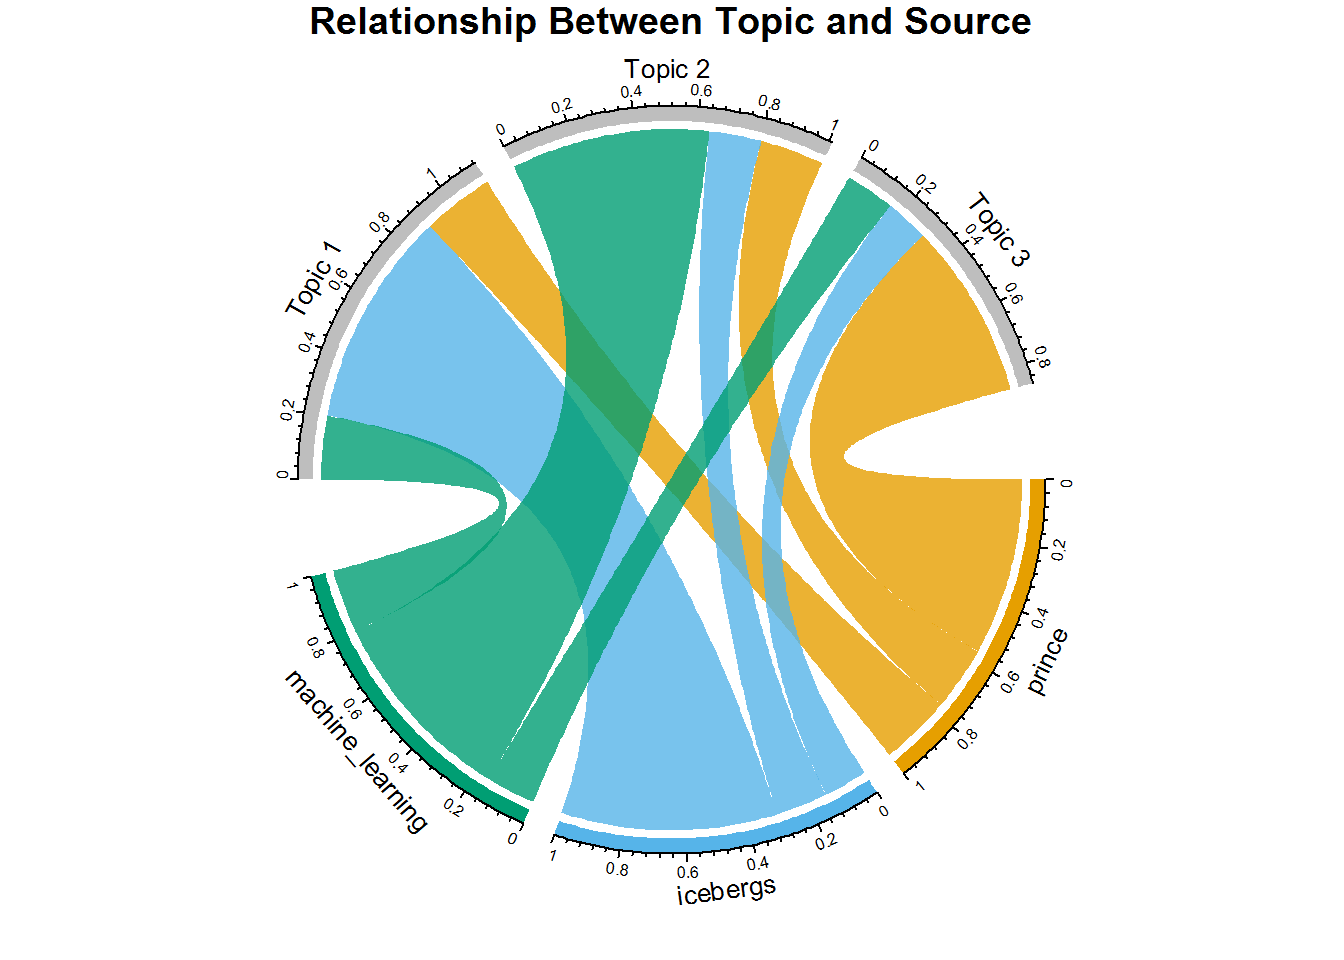
Ini cara yang sangat menarik untuk melihat bahwa meskipun dokumen dari setiap sumber muncul di setiap topik, tiap sumber jelas memiliki mayoritas pada topik tertentu. Misalnya, lagu-lagu Prince sebagian besar terkait dengan Topik 3 karena chord itu lebih besar daripada chord yang menuju topik satu dan dua. Hal yang sama terjadi untuk Icebergs dan Topik 1, serta Machine Learning dan Topik 2. Setelah Anda melihat polanya, menjadi sangat jelas apa yang terjadi.
Jika Anda memikirkan apa yang baru saja dilakukan, Anda sebenarnya telah mengklasifikasikan dokumen ke dalam Topik berdasarkan rerata gamma untuk suatu topik/sumber. Jika Anda mengetahui penulis dokumen, dan Anda tahu penulis tersebut menulis sebagian besar lirik atau buku pada topik tertentu, Anda mungkin berasumsi bahwa artis dari genre serupa akan jatuh ke topik yang sama dan karenanya Anda dapat merekomendasikan penulis yang serupa... Saat melihat dataset yang lebih besar, Anda akan mempraktikkan latihan ini.
Sekarang lihat pada level dokumen individual dan lihat dokumen teratas per topik.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)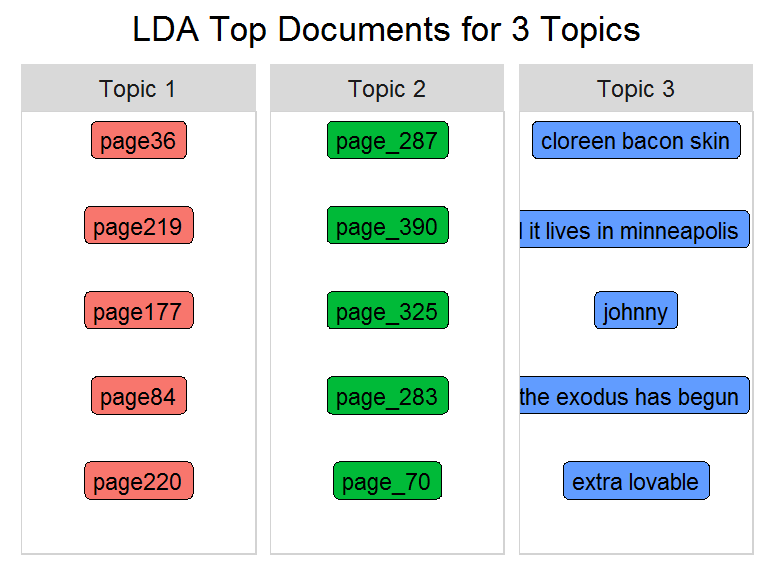
Karena Anda mungkin tidak mengetahui tatanama judul dokumen/lagu (mis. halaman dengan garis bawah berasal dari buku machine learning), saya akan mengganti nama dokumen dengan nama sumber.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)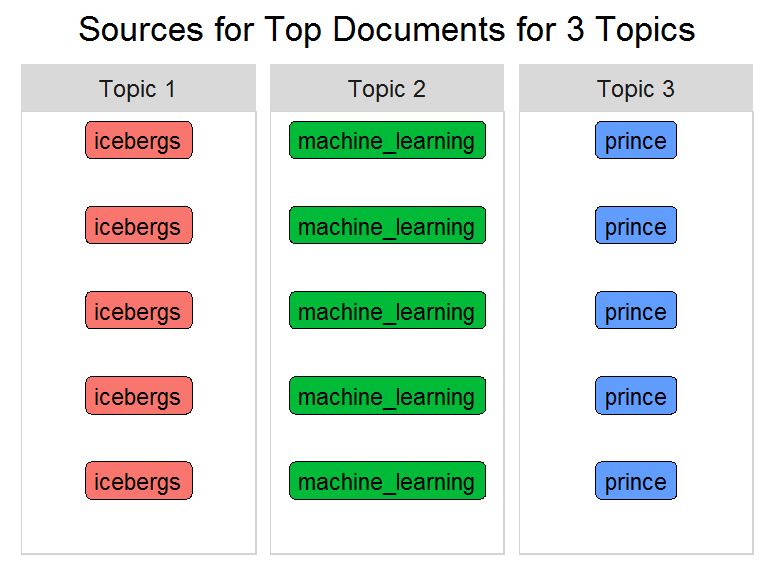
Dokumen teratas untuk tiap topik seperti ditunjukkan pada grafik sebelumnya diganti dengan sumbernya. Kode Anda telah berhasil mengklasifikasikan dokumen-dokumen ini karena jatuh ke kategori yang sama (setidaknya untuk 5 teratas ini)! Pertanyaan besarnya adalah apakah ini bekerja untuk lebih dari tiga sumber. Jika hasil Anda akurat, Anda kemudian dapat merekomendasikan penulis dengan topik serupa.
Anda akan membuat model kedua menggunakan teknik machine learning berbeda: algoritma k-means. Seperti LDA, k-means adalah algoritma pembelajaran tanpa pengawasan dan mengharuskan Anda memutuskan jumlah topik di awal. Berbeda dengan model keanggotaan campuran LDA, k-means membagi dokumen ke dalam klaster yang tampak saling lepas (yaitu topik). Di sini, algoritma mengelompokkan dokumen ke grup berbeda berdasarkan ukuran kemiripan. Ia mentransformasikan dokumen menjadi vektor numerik dengan bobot yang ditetapkan ke kata per dokumen (mirip tf-idf). Setiap dokumen akan muncul tepat di satu klaster. Ini disebut hard clustering. Keluaran berupa sekumpulan klaster beserta dokumennya. Sebaliknya, LDA adalah teknik clustering kabur (soft) di mana sebuah data point dapat termasuk ke lebih dari satu klaster.
Secara konseptual, saat diterapkan pada bahasa alami, LDA seharusnya memberikan hasil lebih realistis daripada k-means untuk penetapan topik, mengingat teks biasanya memuat lebih dari satu topik. Bangun model Anda sekarang, periksa objek k-means, dan lihat apakah asumsi Anda benar.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"Struktur objek k-means memperlihatkan dua informasi penting: clusters dan centers. Anda dapat menggunakan format di bawah untuk melihat isi masing-masing variabel untuk lagu 1999 dan kata party yang muncul pada lagu tersebut.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Field-field ini menunjukkan bahwa 1999 ditempatkan dalam satu klaster (klaster dua), dan party ada di ketiga klaster, tetapi terutama jatuh pada klaster satu. Sekarang lihat kata-kata teratas berdasarkan nilai centers untuk mengidentifikasi tema.
Ingat bahwa dataset ini berisi tiga sumber: Prince, Icebergs, dan Machine Learning. Cetak kata-kata teratas untuk setiap klaster dan bandingkan hasil Anda dengan keluaran LDA. Anda perlu sedikit memanipulasi format data agar dapat menggunakan fungsi word_chart(). Anda dapat mengikuti kodenya, tetapi detailnya tidak sepenting analisis kata-kata teratasnya.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)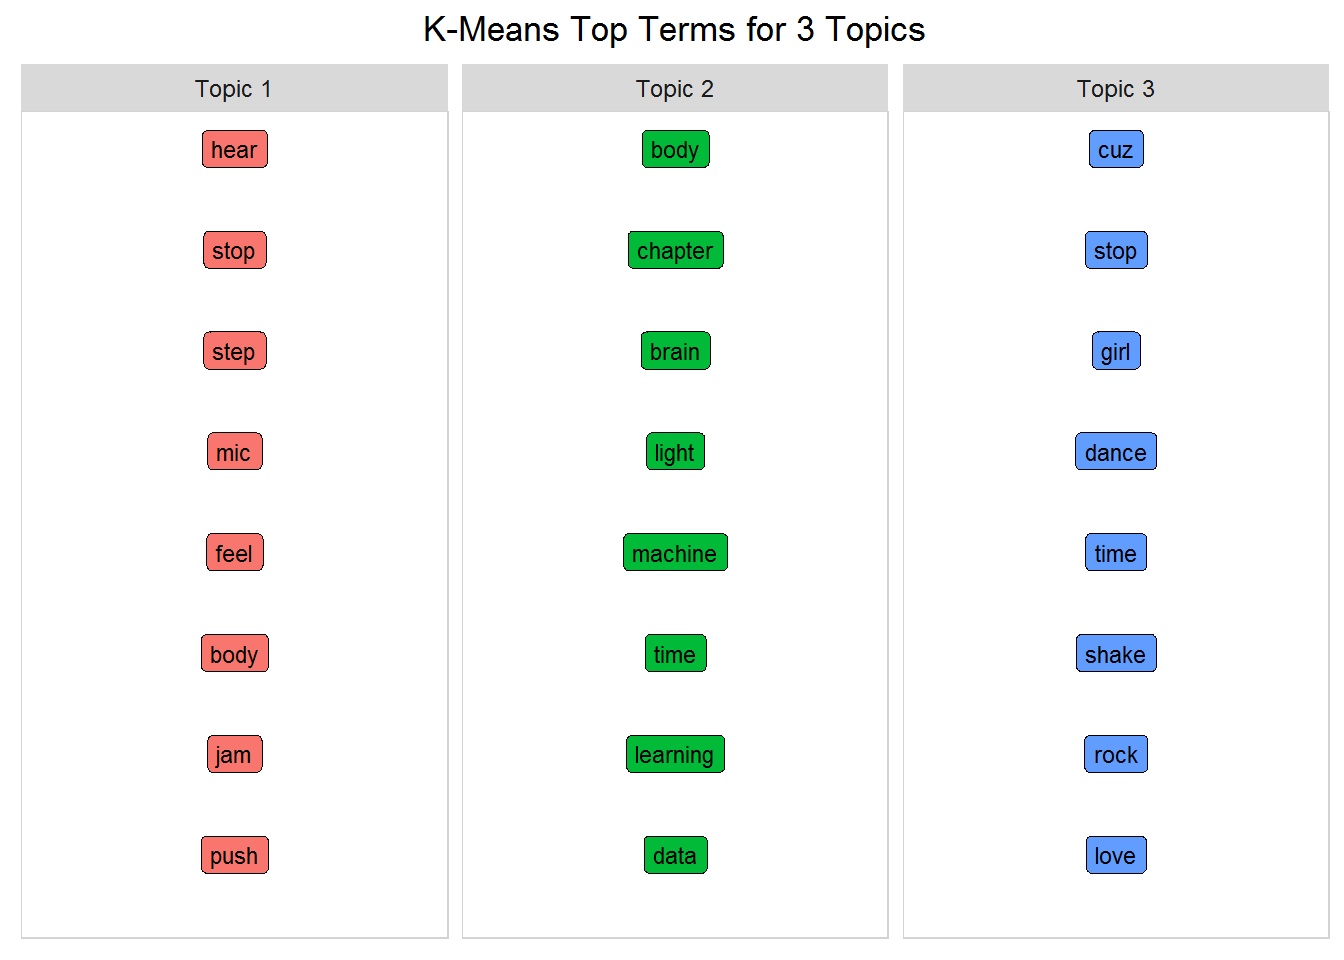
Algoritma k-means cukup cerdas untuk memisahkan topik antara buku dan musik. Dengan kata lain, Topik 1 dan 3 jelas bertema Prince, dan Topik 2 adalah gabungan dari dua buku. Namun, ia tidak mampu membedakan kedua buku itu sendiri seperti yang dapat Anda lakukan menggunakan LDA. K-means dapat di-tuning untuk kinerja yang lebih baik, demikian pula LDA. Sekilas, dengan parameter default, k-means tampak tidak berkinerja sebaik LDA, dan memang, hard clustering biasanya tidak banyak digunakan untuk pemodelan topik. (Untuk opsi lain, lihat paket mallet.)
Untuk model ini, Anda akan menggunakan algoritma LDA pada dataset dengan 12 sumber/penulis berbeda yang mencakup berbagai genre. Dataset sudah seimbang dengan jumlah dokumen dan kata yang serupa per penulis. Berikut ikhtisar datanya:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")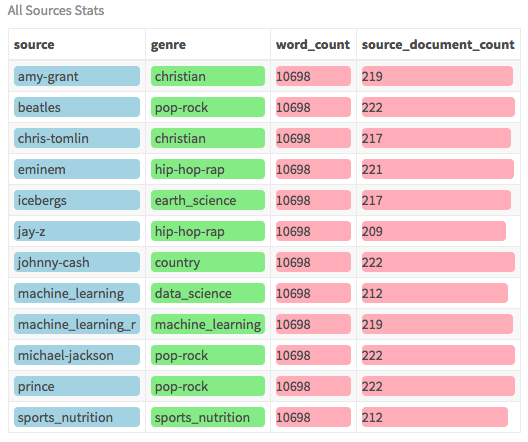
Dataset ini berisi beragam artis mulai dari Prince, hingga Johnny Cash (country), hingga Eminem (rap) serta empat buku berbeda. Artis dipilih karena mereka dinilai paling produktif di genre masing-masing. Konten diambil dari situs web lirik. Meskipun ada dua buku machine learning, yang satu berfokus pada data science umum dan satu lagi lebih tentang machine learning khusus pemrograman R. Semua buku tersedia sebagai PDF yang dapat diunduh. (PDF mentah tidak diperlukan untuk analisis ini karena versi tidy telah disediakan).
Langkah kebersihan cepat: beberapa deskripsi genre terlalu panjang untuk grafik kita, jadi buat bentuk singkat agar lebih mudah dibaca.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedKali ini Anda memiliki dua belas penulis dan delapan genre. Saya berharap penulis dari genre yang sama akan dikelompokkan dalam topik yang sama. Itulah ujian sebenarnya. Jadi, setel jumlah topik menjadi delapan dan lakukan fitting model lagi menggunakan dataset yang lebih besar ini.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)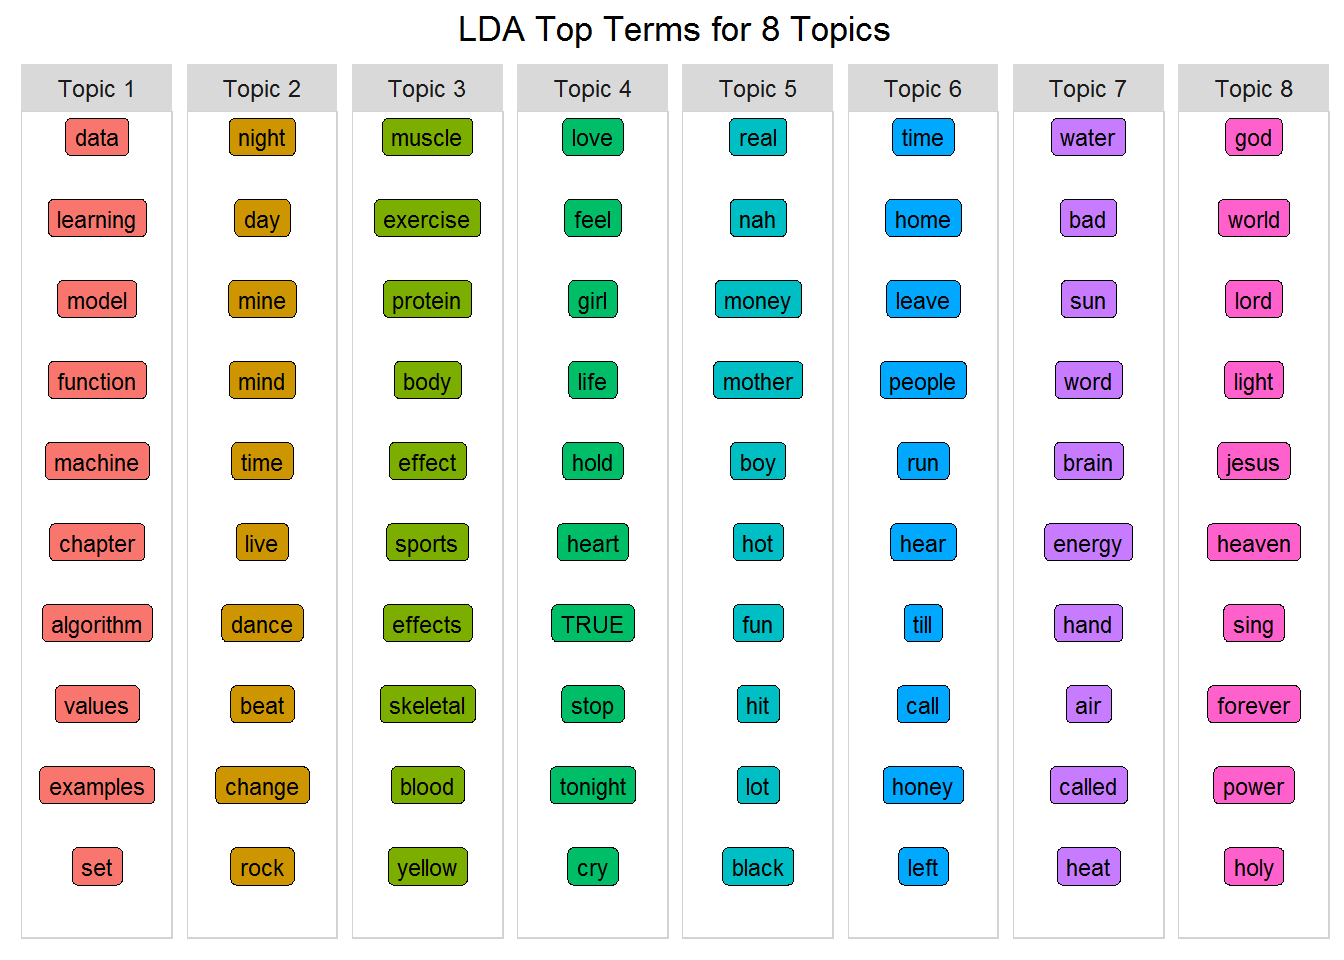
Tidak bermaksud memengaruhi pendapat Anda, tetapi reaksi saya: "Wow"! Mengingat masukan untuk model ini, apakah Anda melihat temanya? Lihat masing-masing topik dan coba cocokkan dengan delapan genre yang diketahui. Beberapa akan sulit dibedakan, tetapi yang lain akan cukup jelas. Misalnya, berikut kemungkinan interpretasi:
Jangan lupa tentang konsep keanggotaan campuran dan bahwa topik-topik ini tidak dimaksudkan sepenuhnya saling lepas, tetapi saya takjub melihat hasilnya sediskret ini. Sekadar catatan: algoritma LDA memiliki lebih banyak parameter dari yang Anda gunakan dan karenanya Anda dapat men-tuning model agar lebih kuat.
Bagian berikut benar-benar menarik. Bagaimana membuatnya lebih mudah melihat topik-topik ini? Dalam banyak kasus, sulit untuk menafsirkan, tetapi dengan dataset yang tepat, model Anda dapat bekerja dengan baik. Jika model Anda dapat menentukan dokumen mana yang lebih mungkin jatuh ke tiap topik, Anda dapat mulai mengelompokkan penulis. Dan karena dalam kasus Anda mengetahui genre seorang penulis, Anda dapat memvalidasi hasil—hingga tingkat tertentu! Langkah pertama adalah mengklasifikasikan setiap dokumen.
Sebagai pengingat, setiap dokumen memuat banyak topik, tetapi pada persentase berbeda yang diwakili oleh nilai gamma. Beberapa dokumen lebih cocok pada beberapa topik dibanding yang lain. Plot ini menunjukkan nilai rata-rata gamma dokumen dari setiap sumber untuk tiap topik. Ini pendekatan yang sama seperti di atas dengan tiga penulis, kecuali kali ini Anda akan melihat field genre. Ini cara yang fantastis untuk menunjukkan hubungan antara genre penulis dan topik.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")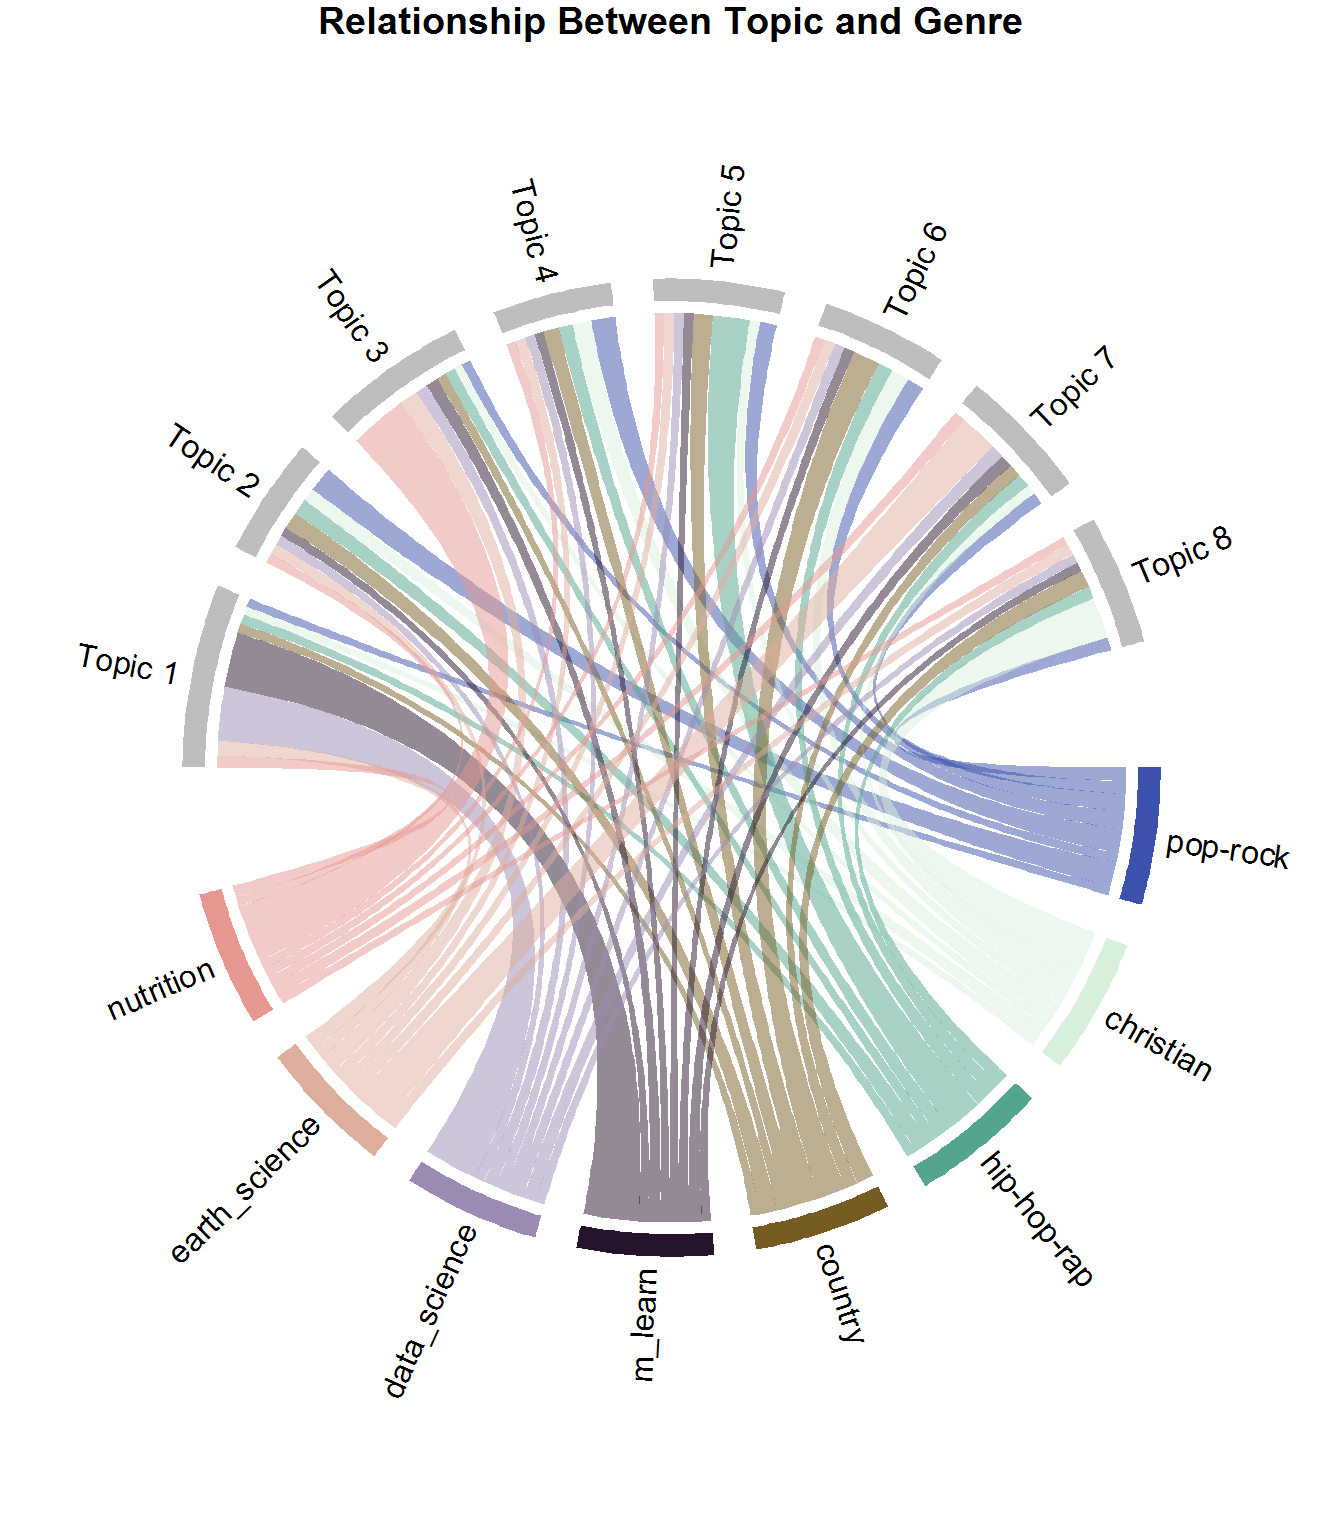
Setiap chord (yaitu tautan) merepresentasikan nilai gamma rata-rata dokumen per genre yang termasuk dalam suatu topik. Jika Anda melihat bagian sports_nutrition, Anda dapat melihat bahwa chord ke Topik 3 lebih besar dari chord lainnya. Ini berarti lebih banyak halaman nutrisi olahraga jatuh ke topik itu. Jelas, mayoritas halaman Machine Learning dan Data Science jatuh ke Topik 1; mayoritas dokumen Ilmu Bumi jatuh ke Topik 7, dan seperti yang mungkin Anda harapkan, Pop-Rock terbagi cukup merata ke banyak topik. Ini masuk akal karena, secara definisi, Pop berarti populer dan merupakan genre umum. Rap-Hip-Hop, di sisi lain, lebih umum pada Topik 5. Jadi apa yang dapat Anda lakukan dengan informasi ini? Anda dapat membuat rekomendasi kepada pendengar berdasarkan konten tematik!
Tentu saja, konten lirik tidak harus menjadi satu-satunya fitur yang digunakan oleh sistem rekomendasi, tetapi dapat dikombinasikan dengan metadata seperti ritme, instrumentasi, tempo, dll., untuk pengalaman mendengarkan yang lebih baik.
Sekarang setelah Anda dapat melihat hubungan antara dokumen dan topik, lakukan pengelompokan berdasarkan source (yaitu penulis) dan topik serta ambil jumlah nilai gamma per grup. Lalu pilih penulis dengan topic_sum tertinggi untuk setiap topik menggunakan top_n(1). Karena Anda ingin melakukan hal yang sama untuk genre seperti yang Anda lakukan di sini untuk penulis, buat fungsi bernama top_items_per_topic() dan lewati source sebagai tipe. Dengan cara ini Anda dapat memanggilnya lagi saat mengklasifikasikan dokumen berdasarkan genre.
Ini momen krusial ketika Anda benar-benar memetakan penulis ke topik tertentu. Apa yang Anda harapkan akan terjadi?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")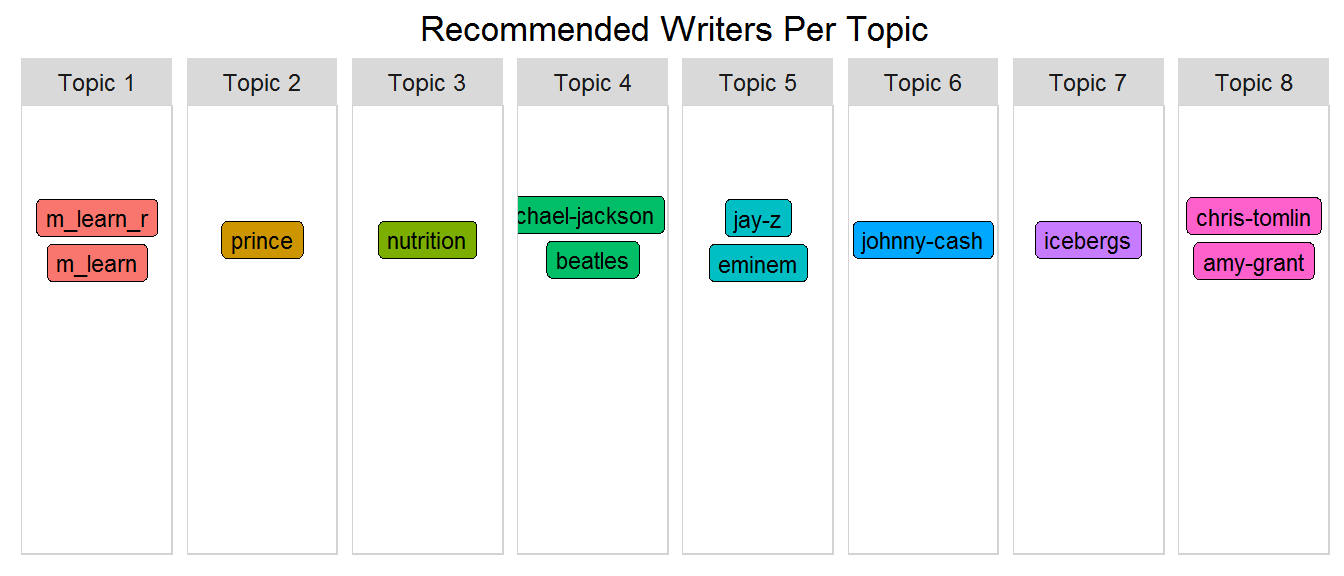
Ini menarik! Namun, karena Anda mungkin tidak terlalu mengenal para artis ini, saya akan memperjelas dengan mengganti penulis dengan genre. Bersiaplah...
top_items_per_topic(lda, source_tidy, "genre")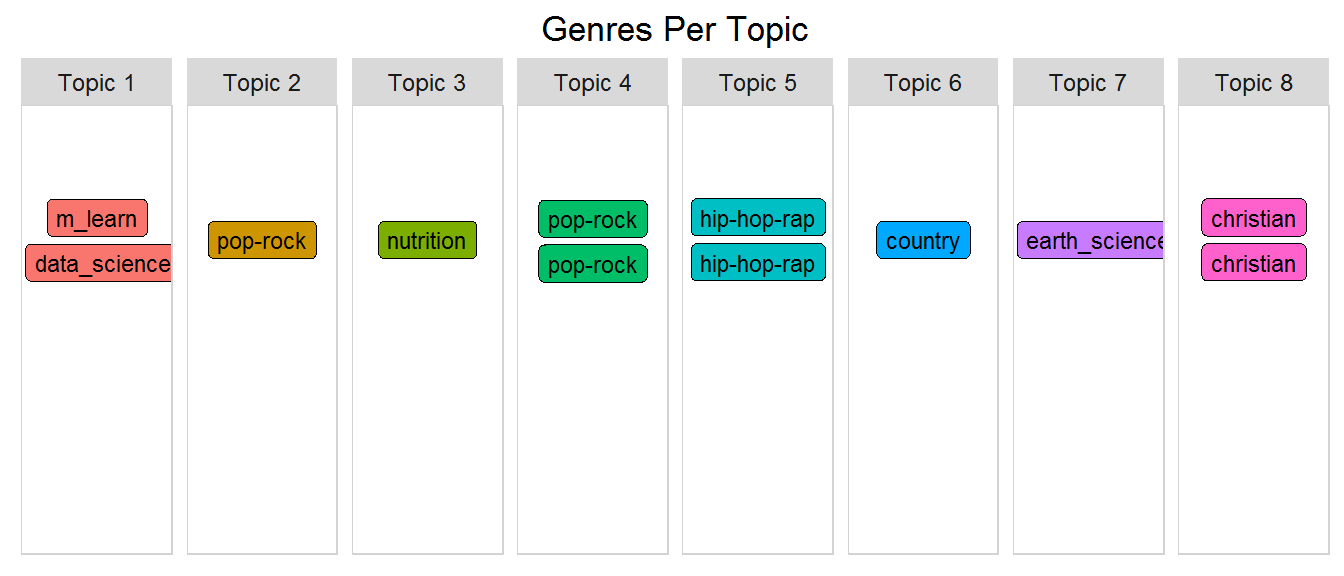
Artis hip-hop-rap dikelompokkan bersama; artis Kristen bersama; dua artis pop-rock bersama, dan masing-masing buku memiliki topiknya sendiri! Cukup menakjubkan melihat bahwa pembelajaran tanpa pengawasan dapat menghasilkan hasil seperti ini (mengenali genre berbeda) semata-mata berdasarkan teks. Apa yang akan terjadi jika Anda memilih jumlah topik yang berbeda? Genre apa yang akan digabung atau dipisah? Mungkin Anda bisa mencobanya sendiri. Untuk saat ini, model Anda berikutnya akan berfokus pada dataset Prince yang Anda gunakan pada tutorial sebelumnya.
Untuk model ini, Anda akan menggunakan dataset yang hanya berisi lagu-lagu Prince. Meskipun ada topik-topik berbeda yang dibahas dalam lirik, sering kali satu lagu mencakup lebih dari satu topik. Ketika dataset Anda hanya memiliki satu artis, topik Anda akan lebih bercampur dan kurang saling lepas. Ini membuat langkah interpretasi menjadi sangat krusial. Alih-alih menggunakan data mentah dari lirik Prince, Anda akan menggunakan versi yang sedikit dimodifikasi seperti dijelaskan di bawah.
Sebelumnya Anda menggunakan kata sebagaimana muncul dalam teks. Namun sekarang Anda akan menggunakan bentuk data beranotasi yang dihasilkan dari paket NLP yang kuat bernama cleanNLP. Paket ini adalah model data rapi untuk Natural Language Processing yang menyediakan tugas anotasi seperti tokenisasi, penandaan kelas kata, pengenalan entitas bernama, pelinking entitas, analisis sentimen, dan banyak lagi. Latihan ini dilakukan di luar tutorial ini, tetapi saya telah menyediakan semua yang Anda butuhkan untuk pemodelan topik.
Dalam dataset beranotasi, ada satu baris untuk setiap kata dalam korpus lirik Prince dengan informasi penting tentang setiap kata.
Lihat lebih dekat objek anotasi bertoken dengan memeriksa nama field.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Untuk saat ini, Anda hanya akan menggunakan dua potong informasi:
Field word adalah kata asli dan lemma adalah versi terlematisasi. upos adalah kode kelas kata universal. Jika Anda memanggil table() pada upos Anda akan melihat jumlah kata yang jatuh ke tiap kelas kata yang ditandai. (Perhatikan bahwa beberapa kata bisa ditandai beberapa kali)
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Untuk memberi gambaran seperti apa datanya, perbesar ke beberapa lagu di mana lemma tidak sama dengan kata asli, dan hapus stop word.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Ini menunjukkan bagaimana Anda bisa sangat selektif dalam memilih apa yang Anda masukkan ke dalam model (mis. kata, lemma, atau kelas kata tertentu). Ini benar-benar keputusan penilaian apakah akan menggunakan kata terlematisasi atau kata asli. Atau Anda bahkan mungkin ingin menggunakan bentuk lain yang disebut stem yang disebutkan di Bagian Dua-A. Anda juga mungkin mempertanyakan hasil cleanNLP dan apa yang ditentukan sebagai nomina versus adjektiva. Saya sarankan bereksperimen dengan beberapa konfigurasi berbeda hingga Anda menemukan yang paling cocok.
Untuk tutorial ini, Anda hanya akan memodelkan nomina. Untuk mendapatkan metadata Prince terkait seperti genre dan tahun, gabungkan prince_annotated dengan prince_tidy berdasarkan word dan document, lalu buat DTM seperti biasa. Saya memilih menghapus beberapa kata yang sangat umum yang ada di semua topik hanya agar lebih menarik. (Perhatikan bahwa menggunakan konsep tf-idf yang dibahas di Bagian Satu adalah metode lain yang mungkin Anda pertimbangkan untuk menghapus kata umum.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)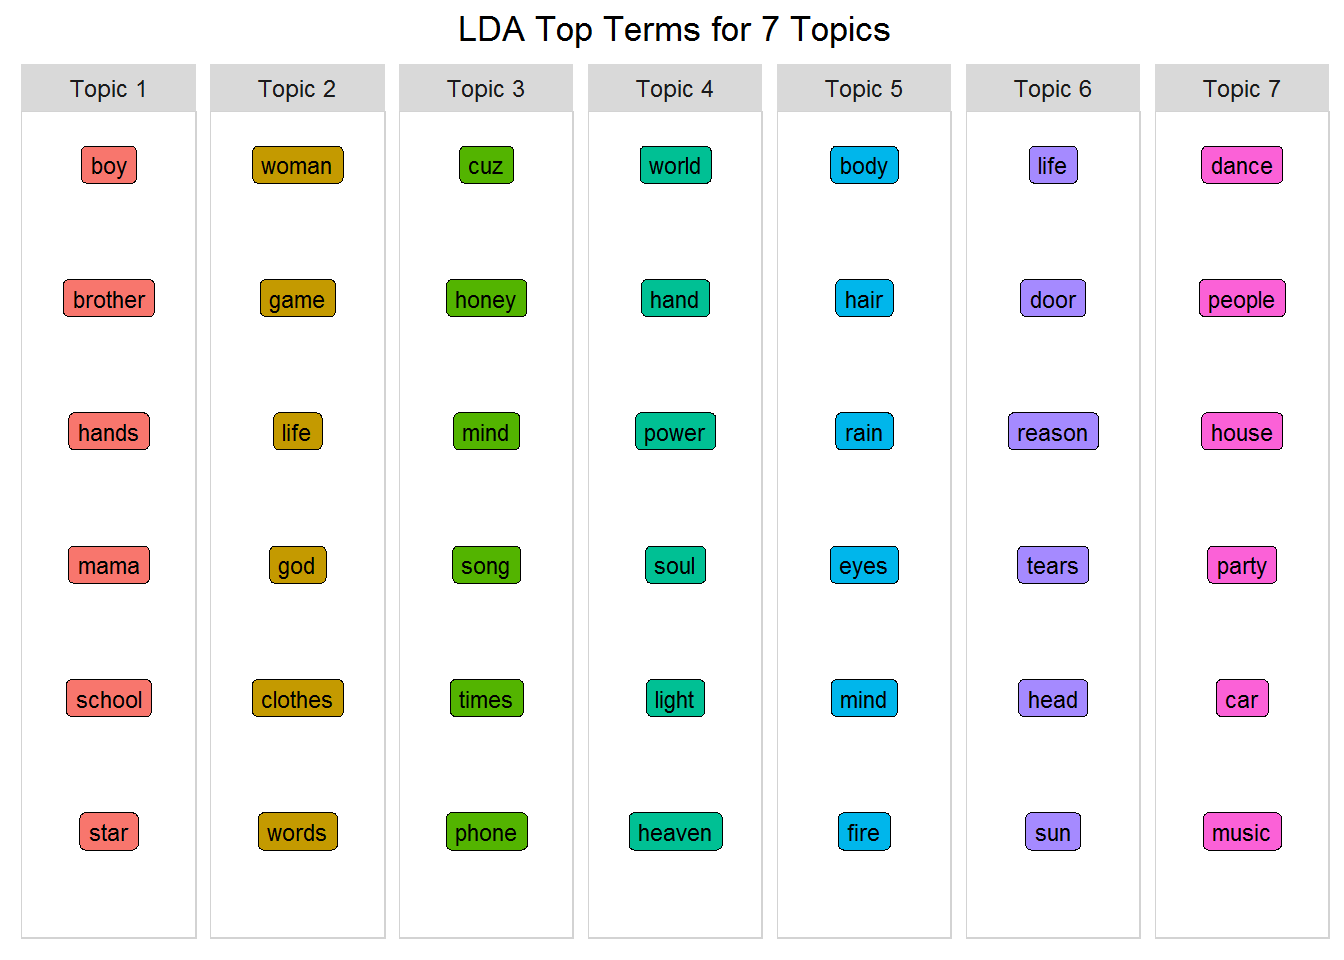
Di bawah ini adalah daftar tema yang selama ini diberi label orang sebagai kemungkinan tema dalam musik Prince. Tema-tema tersebut ditandai dengan kata-kata tertentu, dan seperti halnya semua pemodelan topik, ada tumpang tindih. Namun lihat tema yang diberi label manual ini (dicantumkan secara acak!), dan lihat apakah Anda dapat menemukannya dalam model yang Anda bangun.
Tampaknya Topik 1 Anda tentang people dan family; Topik 7 tentang music, dance, dan party; dan Topik 4 tentang self, society, dan religion. Ini memerlukan interpretasi yang sangat subjektif. Dalam konteks bisnis, langkah ini paling baik dilakukan oleh pakar domain yang mungkin punya gambaran tentang apa yang diharapkan. Sekarang Anda dapat melihat mengapa NLP benar-benar persinggungan antara kecerdasan buatan dan linguistik komputasional!
Cobalah menjalankan ini dengan jumlah topik berbeda, atau hanya dengan verba, atau menggunakan kata mentah versus bentuk terlematisasi, atau dengan jumlah kata teratas yang berbeda dan lihat wawasan apa yang bisa Anda peroleh. Ada metode baru untuk membantu menentukan jumlah topik: lihat konsep perplexity di sini, atau paket
ldatuningdi sini.
Karena dataset Prince memuat year, Anda dapat melacak tema dari waktu ke waktu. Anda bisa sangat kreatif di sini, tetapi untuk saat ini lihat beberapa kata dari dua topik dan lihat frekuensinya dari waktu ke waktu. Tren bisa menjadi satu tutorial tersendiri, jadi jika Anda benar-benar tertarik, lihat sumber ini.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)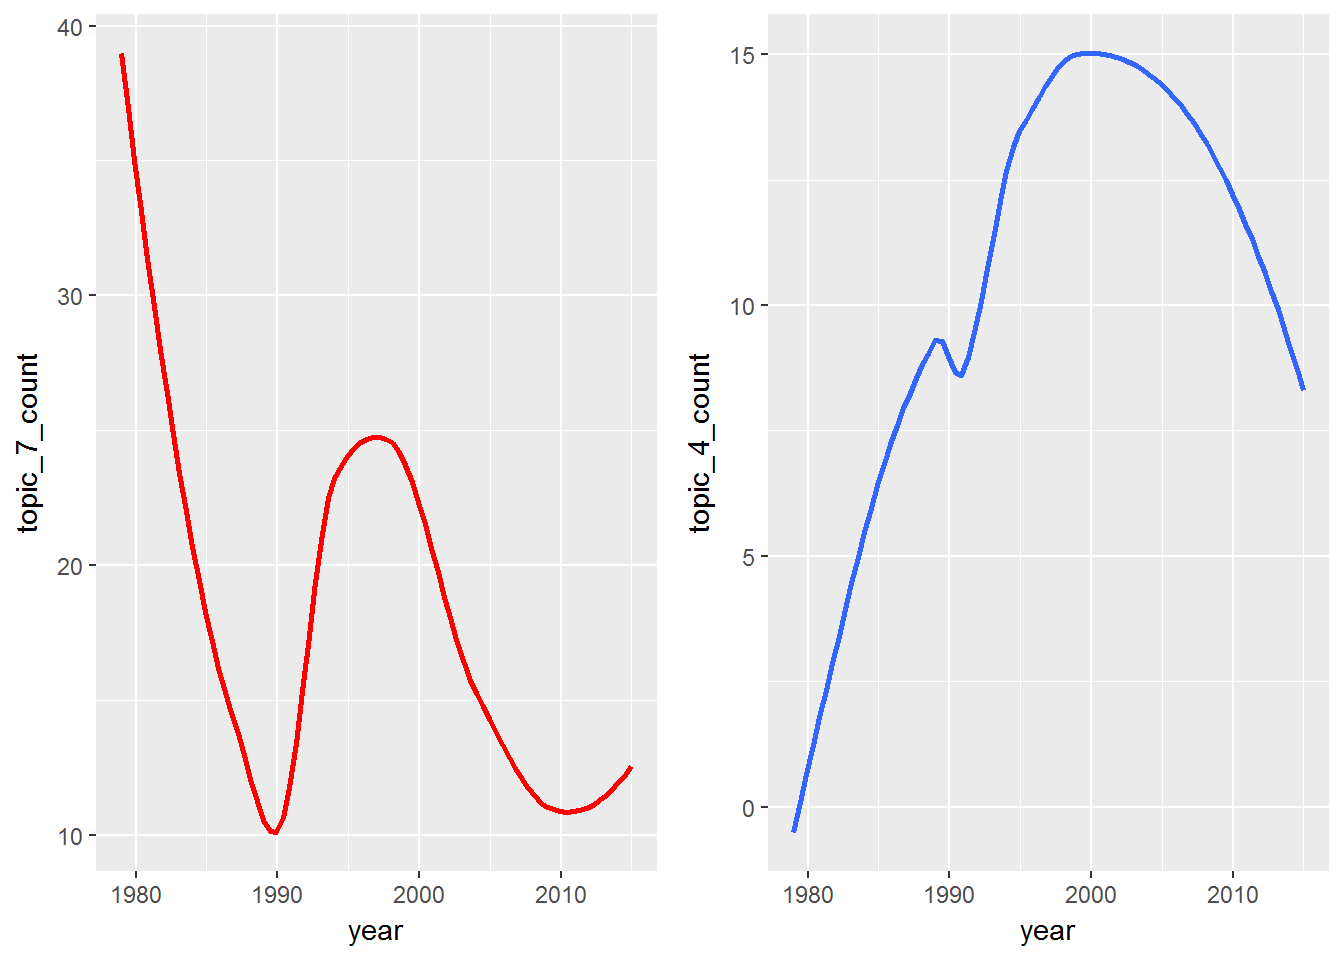
Ini adalah contoh yang sangat mendasar tentang bagaimana tema berubah dari waktu ke waktu, tetapi bagaimana jika Anda memperluas jenis analisis ini di luar musik? Mungkin perusahaan Anda tertarik pada korelasi antara penjualan produk dan tema yang sedang tren dalam cuitan pelanggan tentang produk Anda. Ada banyak aplikasi untuk memahami bagaimana topik berubah dari waktu ke waktu.
Tutorial ini hanya menggores permukaan dari apa yang mungkin dilakukan dengan pemodelan topik, NLP, dan machine learning. Ini adalah bidang data science yang sedang berkembang dan akan terus tumbuh seiring lebih banyak ilmuwan menangani lautan data tak terstruktur yang belum dijelajahi. Dalam musik, konsep mengklasifikasikan lagu berdasarkan lirik sebagian besar ditemukan dalam makalah riset, jadi mungkin Anda bisa melompat dari pekerjaan ini dan membuat kontribusi Anda sendiri ke dunia AI.
Anda menggunakan data dari lirik dan buku nonfiksi untuk mengidentifikasi tema, mengklasifikasikan dokumen individual ke topik paling mungkin, dan mengidentifikasi penulis serupa berdasarkan konten tematik. Dengan demikian Anda mampu membangun sistem rekomendasi sederhana berbasis teks dan penulis berlabel.
Ingatlah; Anda mencoba memodelkan seni dengan mesin. Seorang artis bisa berkata "You are the apple of my eye", tetapi mereka tidak merujuk buah atau bagian tubuh. Anda harus menemukan yang tersembunyi. Saat Anda mendengarkan musik, Anda tidak selalu mendengar vokal latar, tetapi suaranya ada. Naikkan volume lagu favorit Anda dan dengarkan melewati vokal utama dan Anda mungkin akan terkejut menemukan dunia informasi tersembunyi. Jadi tempatkan logika di latar belakang dan munculkan kreativitas ke garis depan selama eksplorasi Anda!
Seperti pada semua tutorial dalam seri ini, saya mendorong Anda menggunakan data yang disajikan di sini sebagai studi kasus yang menyenangkan, tetapi juga sebagai generator ide untuk menganalisis teks yang menarik bagi Anda. Bisa jadi artis favorit Anda, media sosial, korporat, ilmiah, atau teks sosio-ekonomi. Apa pendapat Anda tentang potensi penerapan pemodelan topik? Silakan tinggalkan komentar di bawah dengan ide Anda!
Nantikan Bagian Tiga (artikel keempat) dari seri ini: Lyric Analysis: Predictive Analytics using Machine Learning with R. Di sana Anda akan menggunakan lirik dan metadata berlabel untuk memprediksi masa depan sebuah lagu. Anda akan bekerja dengan beberapa algoritma berbeda seperti Decision Trees, Naive Bayes, dan lainnya untuk memprediksi genre, dekade, dan mungkin bahkan apakah sebuah lagu akan masuk tangga lagu! Sampai jumpa!
Pernyataan Penyangkalan:
Peringatan satu: Satu-satunya cara Anda mendapatkan hasil yang sama dengan saya adalah jika Anda menjalankan kode dalam urutan yang persis sama dengan file data yang sama dan tidak dimodifikasi. Jika tidak, referensi ke topik tertentu tidak akan masuk akal.
Peringatan dua: Tidak ada aturan baku dalam pekerjaan ini, dan ini didasarkan pada riset saya sendiri. Meskipun pemodelan topik memang ada dalam aplikasi dunia nyata, tidak banyak aktivitas tentang pengembangan recommender musik yang sepenuhnya berbasis lirik.
Peringatan tiga: Pemodelan topik itu rumit. Membangun model adalah satu hal, tetapi menafsirkan hasilnya menantang, subjektif, dan sulit divalidasi sepenuhnya (meski riset sedang berlangsung: lihat artikel oleh Thomas W. Jones). Prosesnya tanpa pengawasan, generatif, iteratif, dan berbasis probabilitas. Topik bersifat halus, tersembunyi, dan tersirat, bukan eksplisit.
Jika Anda ingin mempelajari lebih lanjut tentang machine learning menggunakan R, lihat tutorial pemula kami. Juga, ikuti kursus Introduction to Machine Learning.
Pelajari lebih lanjut tentang Machine Learning
Kursus
Kursus
Kursus
blogs
David Woods
13 mnt
blogs
Dario Radečić
15 mnt
blogs
Hugo Bowne-Anderson
13 mnt
blogs
Javier Canales Luna
14 mnt



