Corso
Capire il Machine Learning
2 ore
313.7K
Usa tecniche all’avanguardia con R, NLP e Machine Learning per modellare i temi nei testi e costruire il tuo sistema di raccomandazione musicale!
Questa è la Parte Due-B di una serie di tre tutorial in cui continuerai a usare R per svolgere vari compiti analitici su un caso di studio dei testi musicali del leggendario Prince, oltre che di altri artisti e autori. I tre tutorial coprono i seguenti argomenti:
Immagina di essere un Data Scientist alla NASA. Ti chiedono di monitorare due veicoli spaziali destinati all’orbita lunare, che studieranno le interazioni della luna con il sole. Come per qualsiasi veicolo spaziale, possono emergere problemi durante i test o dopo il lancio. Queste anomalie vengono documentate in linguaggio naturale in quasi 20.000 report. Il tuo compito è identificare gli argomenti più frequenti e i temi di tendenza nel corpus dei report e fornire analisi prescrittive a ingegneri e direttori di programma, influenzando così il futuro dell’esplorazione spaziale.
Questo è un esempio di uno scenario reale e dovrebbe darti un’idea del potere che avrai tra le mani dopo aver imparato a usare tecniche all’avanguardia come il topic modeling con il machine learning, l’elaborazione del linguaggio naturale (NLP) e la programmazione in R. Per fortuna, non devi lavorare alla NASA per fare qualcosa di altrettanto innovativo. In questo tutorial, la tua missione, se deciderai di accettarla, è imparare il topic modeling e come costruire un semplice sistema di raccomandazione basato sui testi delle canzoni e su libri di saggistica.
Solo per divertirsi!
Non ha nulla a che vedere con il topic modeling, ma per divertimento usa un ottimo pacchetto chiamato circlize, introdotto in un tutorial precedente, per accendere quei fotorecettori e goderti questo diagramma circolare di tutte le fonti che userai in questo tutorial.
 library(jpeg)
library(circlize) #you'll use this package later
#read in the list of jpg files of album/book covers
files = list.files("jpg\\", full.names = TRUE)
#clean up the file names so we can use them in the diagram
removeSpecialChars <- function(x) gsub("[^a-zA-Z]", " ", x)
names <- lapply(files, removeSpecialChars)
names <- gsub("jpg","", names )

#read up on the circlize package for details
#but there will be comments in later sections
circos.clear()
circos.par("points.overflow.warning" = FALSE)
circos.initialize(names, xlim = c(0, 2))
circos.track(ylim = c(0, 1), panel.fun = function(x, y) {
  image = as.raster(readJPEG(files[CELL_META$sector.numeric.index]))
  circos.text(CELL_META$xcenter, CELL_META$cell.ylim[1] - uy(1.5, "mm"),
              CELL_META$sector.index,
              CELL_META$sector.index, facing = "clockwise", niceFacing = TRUE,
              adj = c(1, 0.5), cex = 0.9)
  circos.raster(image, CELL_META$xcenter, CELL_META$ycenter, width = "1.5cm",
        facing = "downward")
}, bg.border = 1, track.height = .4)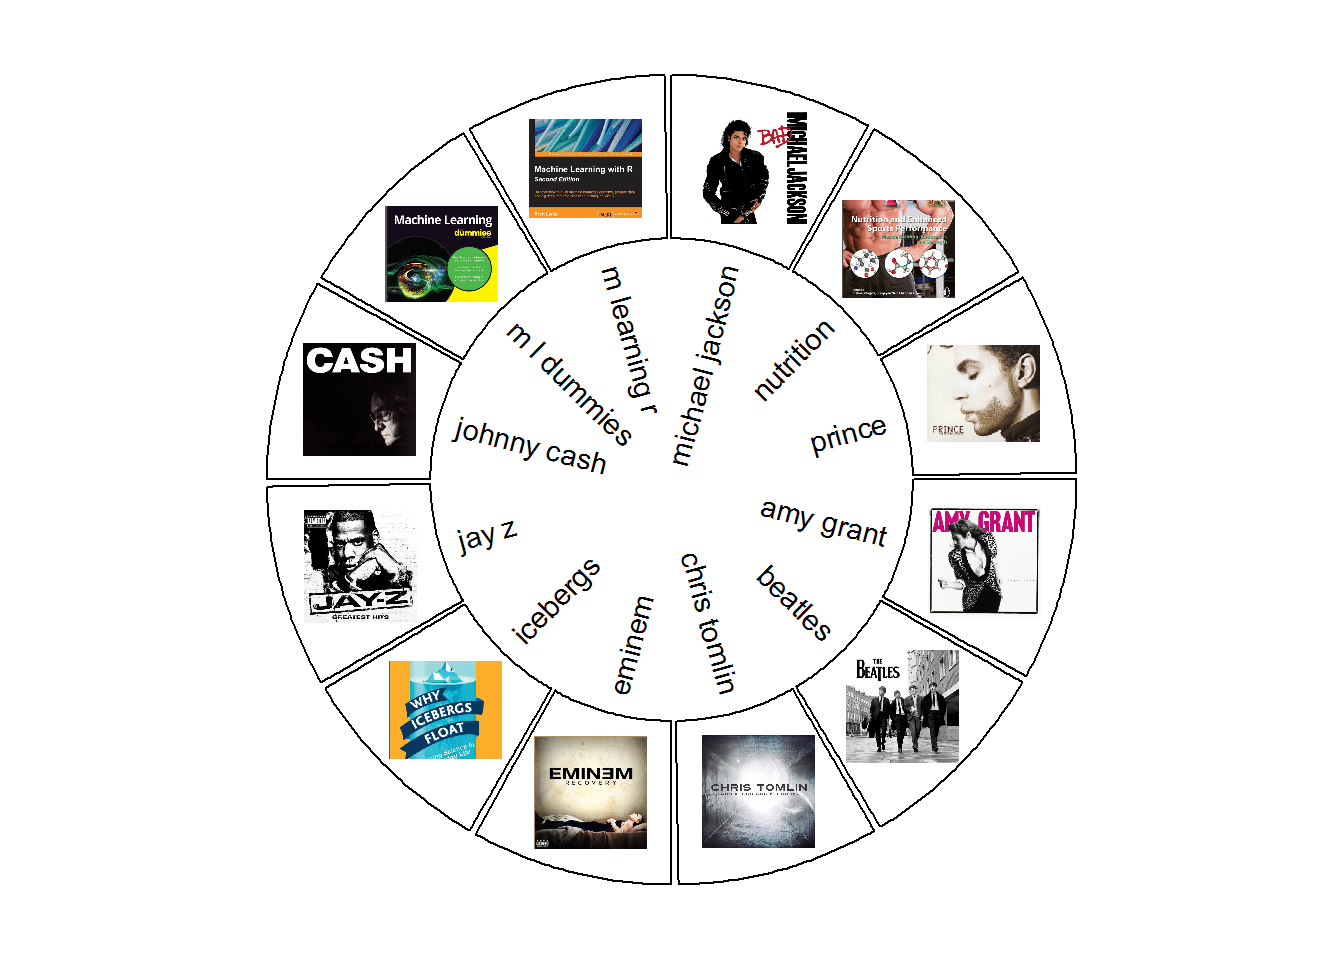
Nei tutorial precedenti hai studiato i testi di Prince usando la frequenza delle parole, la statistica tf-idf e l’analisi del sentiment. Puoi ottenere una comprensione più profonda dei testi e di altri contenuti usando il concetto di topic modeling.
In questo tutorial costruirai quattro modelli usando gli algoritmi di machine learning Latent Dirichlet Allocation (LDA) e clustering K-Means. Spiegherò gli algoritmi più avanti nel tutorial.
Il Modello Uno utilizza i testi delle canzoni di Prince combinati con due libri di saggistica. L’obiettivo è fornirti un esempio semplice di utilizzo di LDA, un algoritmo non supervisionato, per generare collezioni di parole che insieme suggeriscono temi. Questi temi sono senza etichetta e richiedono interpretazione umana. Una volta identificato un numero predefinito di temi, prenderai i risultati del modello e classificherai ogni canzone o pagina di libro in ciascuna categoria. Una canzone può contenere tutti i temi che hai generato, ma adattarsi meglio a uno rispetto a un altro. Questo è chiamato classificazione dei documenti, ma dato che conosci l’autore del documento, di fatto stai classificando gli autori in raggruppamenti tematici.
Il Modello Due usa il dataset del Modello Uno e offre una rapida occhiata alla generazione di temi con un algoritmo diverso, k-means, e a come potrebbe non essere la scelta migliore per il topic modeling.
Usando ancora LDA, il Modello Tre impiega un dataset più ampio con più artisti di generi diversi e più autori. Quando classifichi la maggior parte dei documenti di un autore/artista nel loro tema più probabile, hai la possibilità di raggruppare autori con composizioni tematiche simili. Con un buon modello, dovresti vedere generi simili comparire nello stesso raggruppamento tematico. Per esempio, i rapper apparirebbero in un tema, e due libri su un argomento simile dovrebbero apparire insieme in un tema diverso. Così potresti potenzialmente raccomandare autori simili! Ovviamente, gli autori e il loro genere sono etichettati, ma i temi no e sono quindi non supervisionati.
Il Modello Quattro usa LDA solo sui testi di Prince. Questa volta userai un dataset annotato generato al di fuori di questo tutorial, in cui ogni parola è etichettata per parte del discorso (cioè nome, verbo, ecc.) e nella forma base (lemmatizzata). Esaminerai anche come un tema cambia nel tempo.
NLP e Machine Learning sono sotto-discipline dell’Intelligenza Artificiale. Di recente sono stati fatti tentativi di usare l’AI per scrivere canzoni. Non è l’obiettivo di questo tutorial, ma è un esempio di come l’AI possa essere arte. Dopotutto, le prime tre lettere sono A-R-T! Per un momento, confronta l’AI con la scrittura di canzoni: puoi seguire facilmente uno schema e creare una struttura (strofa, ritornello, strofa, ecc.), ma ciò che rende una canzone grande è quando l’autore infonde creatività nel processo. In questo tutorial dovrai esercitare le tue competenze tecniche per costruire modelli, ma anche chiamare in causa la tua creatività artistica e sviluppare la capacità di interpretare e spiegare i risultati.
Pensa a questo: se il topic modeling è un’arte, allora i testi sono il codice, la scrittura è l’algo-ritmo e la canzone è il modello! Qual è la tua analogia?
I sistemi di raccomandazione tipici non si basano interamente sul testo. Per esempio, Netflix può raccomandare film in base alle scelte precedenti e ai metadati associati. Pandora ha un approccio diverso e si basa su un Music Genome composto da 400 attributi musicali, tra cui melodia, ritmo, composizione e sintesi dei testi; tuttavia, lo sviluppo di questo genoma è iniziato nel 2000 e ha richiesto cinque anni e 30 esperti di teoria musicale per essere completato. Esistono molti articoli di ricerca che trattano le raccomandazioni di film basate sui riassunti delle trame. Esempi di sistemi di raccomandazione musicale basati sul contenuto testuale effettivo sono più difficili da trovare. Vuoi provarci?
La Parte Due-B di questa serie richiede una comprensione di base dei dati tidy, in particolare dei pacchetti come dplyr e ggplot2. È consigliata anche un po’ di pratica con il text mining usando tidytext, trattato nei tutorial precedenti. Dovrai inoltre avere familiarità con le funzioni in R, dato che ne utilizzerai alcune per riusare il codice per ciascun modello. Per concentrarti sull’estrazione di insight, ho incluso del codice pensato per essere usato sul tuo dataset, ma spiegazioni dettagliate potrebbero richiedere ulteriori approfondimenti da parte tua.
Cosa puoi fare tu con il topic modeling? Magari hai documenti con informazioni critiche per il tuo business che potresti analizzare. Forse potresti fare scraping di dati da Twitter e scoprire cosa dicono le persone sui prodotti della tua azienda. Oppure potresti costruire un tuo sistema di classificazione per inviare determinati documenti ai reparti giusti per l’analisi. C’è un mondo di possibilità da esplorare! Buttati!
Ecco diverse applicazioni del topic modeling:
Gli unici pacchetti nuovi in questo tutorial che non sono in Parte Uno o Parte Due-A sono topicmodels, tm e plotly. Userai la funzione LDA() di topicmodels che consente ai modelli di imparare a distinguere tra documenti diversi. Il pacchetto tm serve per il text mining, e userai la funzione inspect() una volta per vedere l’interno di una matrice documento-termine, che spiegherò più avanti. Userai plotly una sola volta per creare una versione interattiva di un grafico ggplot2.
 library(tidytext) #text mining, unnesting
library(topicmodels) #the LDA algorithm
library(tidyr) #gather()
library(dplyr) #awesome tools
library(ggplot2) #visualization
library(kableExtra) #create attractive tables
library(knitr) #simple table generator
library(ggrepel) #text and label geoms for ggplot2
library(gridExtra)
library(formattable) #color tile and color bar in `kables`
library(tm) #text mining
library(circlize) #already loaded, but just being comprehensive
library(plotly) #interactive ggplot graphs
Le funzioni seguenti sono state definite nei tutorial precedenti, ad eccezione di word_chart(); tuttavia, il contenuto e la descrizione di word_chart() sono presenti anche nella Parte Due-B. In sostanza, ti basta sapere che usa ggplot() in modo particolare per creare una visualizzazione basata sulle parole piuttosto che sui punti.
 #define some colors to use throughout
my_colors <- c("#E69F00", "#56B4E9", "#009E73", "#CC79A7", "#D55E00", "#D65E00")

#customize ggplot2's default theme settings
#this tutorial doesn't actually pass any parameters, but you may use it again in future tutorials so it's nice to have the options
theme_lyrics <- function(aticks = element_blank(),
                         pgminor = element_blank(),
                         lt = element_blank(),
                         lp = "none")
{
  theme(plot.title = element_text(hjust = 0.5), #center the title
        axis.ticks = aticks, #set axis ticks to on or off
        panel.grid.minor = pgminor, #turn on or off the minor grid lines
        legend.title = lt, #turn on or off the legend title
        legend.position = lp) #turn on or off the legend
}

#customize the text tables for consistency using HTML formatting
my_kable_styling <- function(dat, caption) {
  kable(dat, "html", escape = FALSE, caption = caption) %>%
  kable_styling(bootstrap_options = c("striped", "condensed", "bordered"),
                full_width = FALSE)
}

word_chart <- function(data, input, title) {
  data %>%
  #set y = 1 to just plot one variable and use word as the label
  ggplot(aes(as.factor(row), 1, label = input, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        #axis.title.x = element_text(size = 9),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  labs(x = NULL, y = NULL, title = title) +
    #xlab(NULL) + ylab(NULL) +
  #ggtitle(title) +
  coord_flip()
}Per vedere davvero la potenza del topic modeling e della classificazione, non userai solo i testi di Prince come nei tutorial precedenti, ma lavorerai anche con diversi altri artisti di generi differenti riconosciuti nelle classifiche Billboard. Inoltre, ho aggiunto alcuni libri su argomenti diversi, come nutrizione sportiva, iceberg e persino machine learning! Con un dataset vario, puoi classificare i documenti nei temi associati e distinguere tra artisti/autori simili.
Suggerimento: farò riferimento alle canzoni e alle pagine dei libri come documenti, e a musicisti/autori come scrittori. Nel codice vedrai il riferimento alla parola source. Indica semplicemente a quale autore si riferiscono i dati. Userò la parola genere per indicare sia il genere musicale sia la categoria di un libro. Invece dei nomi degli autori, ho usato i titoli dei libri, per chiarezza. Questi riferimenti avranno senso man mano che procedi nel tutorial.
Per concentrarti sulla modellazione, ho eseguito la preparazione dei dati al di fuori di questo tutorial e ti ho fornito tutti i dati necessari in questi tre file con le seguenti operazioni già applicate:
pdf_text() dal pacchetto pdftools per raccogliere il contenuto di quattro libri (ogni pagina rappresenta un documento distinto)tidytext descritto in Parte UnoAvrai tre dataset distinti con cui lavorare in questo tutorial:
three_sources_tidy_balanced: contiene testi di Prince e due libriall_sources_tidy_balanced: contiene testi di otto artisti e quattro libriprince_tidy: contiene solo testi di PrinceHo incluso anche un dataset annotato dei testi di Prince. Spiegherò cosa significa “annotato” quando arriverai al Modello Quattro.
 #Get Tidy Prince Dataset and Balanced Tidy Dataset of All Sources and 3 Sources

three_sources_tidy_balanced <- read.csv("three_sources_tidy_balanced.csv",
                                        stringsAsFactors = FALSE)

all_sources_tidy_balanced <- read.csv("all_sources_tidy_balanced.csv",
                                      stringsAsFactors = FALSE)

prince_tidy <- read.csv("prince_tidy.csv",
stringsAsFactors = FALSE)L’obiettivo principale del topic modeling è trovare termini tematicamente correlati (topic) in dati testuali non strutturati, misurati come pattern di co-occorrenza di parole. I componenti di base dei topic model sono documenti, termini e temi. La Latent Dirichlet Allocation (LDA) è un metodo di apprendimento non supervisionato che scopre temi diversi alla base di una collezione di documenti, dove ogni documento è una collezione di parole. LDA fa le seguenti assunzioni:
LDA cerca gruppi di parole correlate. È un algoritmo generativo e iterativo. Ecco i due passaggi principali:
Il concetto alla base di LDA è che parole appartenenti a un tema compaiono insieme nei documenti. Cerca di modellare ogni documento come una mistura di temi e ogni tema come una mistura di parole. (Potresti vederlo chiamato modello a appartenenza mista.) Puoi poi usare la probabilità che un documento appartenga a un tema specifico per classificarlo di conseguenza. Nel tuo caso, poiché conosci l’autore dal dato originale, puoi raccomandare un artista/autore basandoti su strutture tematiche simili. Ora è il momento di vedere un esempio.
Per questo modello userai il dataset con una combinazione di tre autori distinti (cioè fonti) e cercherai temi nascosti. Per aiutarti a capire la potenza del topic modeling, queste tre fonti sono molto diverse e intuitivamente sai che trattano tre temi differenti. Di conseguenza, dirai al modello di creare tre temi e vedrai quanto è “intelligente”. Per prima cosa vuoi esaminare il dataset usando la funzione my_kable_styling() insieme a color_bar() e color_tile() dal pacchetto formattable.
 #group the dataset by writer (source) and count the words
three_sources_tidy_balanced %>%
  group_by(source) %>%
  mutate(word_count = n()) %>%
  select(source, genre, word_count) %>% #only need these fields
  distinct() %>%
  ungroup() %>%
  #assign color bar for word_count that varies according to size
  #create static color for source and genre
  mutate(word_count = color_bar("lightpink")(word_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("Three Sources Stats")
Qui userai i testi di Prince, un libro chiamato "Machine Learning For Dummies" e un altro libro chiamato "Why Icebergs Float", ciascuno con oltre 30.000 parole (non distinte).
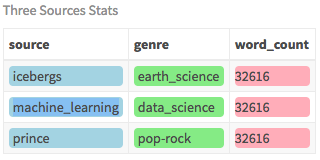
Dato che hai un dataset bilanciato e tidy con i testi di Prince e due libri, per prima cosa creerai una document-term matrix (DTM) in cui ogni documento è una riga e ogni colonna è un termine. Questo formato è richiesto dall’algoritmo LDA. Un documento è una canzone nei testi e un numero di pagina nei libri. Per iniziare, prenderai i dati tidy e conterai le parole in un documento, poi passerai il risultato alla funzione cast_dtm() di tidytext, dove document è il nome del campo con il nome del documento e word è il nome del campo con il termine. Ci sono altri parametri che potresti passare, ma questi due sono obbligatori.
 three_sources_dtm_balanced <- three_sources_tidy_balanced %>%
  #get word count per document to pass to cast_dtm
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
  #create a DTM with docs as rows and words as columns
  cast_dtm(document, word, n)
#examine the structure of the DTM
three_sources_dtm_balanced

<<DocumentTermMatrix (documents: 1449, terms: 13608)>>
Non-/sparse entries: 71386/19646606
Sparsity           : 100%
Maximal term length: 27
Weighting          : term frequency (tf)
Questo ti dice quanti documenti e termini hai e che si tratta di una matrice molto sparsa. Sparsa implica che la DTM contiene per lo più campi vuoti. A causa dell’ampio vocabolario di possibili termini da tutti i documenti, solo pochi verranno usati in ciascun documento.
Se guardi il contenuto di alcune righe e colonne della DTM usando la funzione inspect() del pacchetto tm, vedrai che ogni riga è un documento e ogni colonna è un termine. (Puoi usare str() per vedere la struttura effettiva.)
 #look at 4 documents and 8 words of the DTM
inspect(three_sources_dtm_balanced[1:4,1:8])
<<DocumentTermMatrix (documents: 4, terms: 8)>>
Non-/sparse entries: 9/23
Sparsity : 72%
Maximal term length: 9
Weighting : term frequency (tf)
Sample :
Terms
Docs beautiful dance party push rock roll shake style
party up 0 0 40 0 1 2 0 0
push it up 0 1 1 56 0 0 0 0
shake 0 0 1 0 0 0 52 0
style 0 0 0 0 0 0 0 32Ora che sai cosa serve come input per costruire il modello, imposta due variabili che potrai semplicemente reimpostare quando costruirai ciascun modello. Le chiamerai source_dtm e source_tidy.
 #assign the source dataset to generic var names
#so we can use a generic function per model
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balancedFinalmente si passa alla parte divertente dell’adattamento del modello. Il codice è semplice, ma per essere un buon Data Scientist, vorrai capire cosa succede dietro le quinte. Anche se questa è una descrizione sommaria, online trovi una mole di informazioni su LDA. Per i tuoi scopi, ti basterà conoscere quattro parametri: l’input, il numero di temi, il metodo di campionamento e il seed.
Poiché sai che il dataset contiene tre autori distinti, imposterai k su 3 e seed su una costante per ottenere risultati ripetibili. Esistono altri parametri di controllo, da cui il formato a lista nel codice, ma per ora userai solo seed. Il parametro method definisce l’algoritmo di campionamento da usare. Userai il metodo GIBBS. Il default è VEM, ma per esperienza non rende quanto l’alternativa GIBBS.
Una breve spiegazione tecnica del campionamento GIBBS è che esegue una random walk che parte da un punto che puoi inizializzare (userai il default 0) e a ogni passo si muove di più o meno uno con uguale probabilità. Leggi una descrizione dettagliata qui se ti interessano i dettagli.
Nota: ho sorvolato sui dettagli dell’algoritmo LDA. Anche se non devi comprenderne tutta la teoria statistica per usarlo, ti suggerisco di leggere questo documento di Ethen Liu che offre una solida spiegazione.
 k <- 3 #number of topics
seed = 1234 #necessary for reproducibility
#fit the model passing the parameters discussed above
#you could have more control parameters but will just use seed here
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))
#examine the class of the LDA object
class(lda)
[1] "LDA_Gibbs"
attr(,"package")
[1] "topicmodels"Vedi che è stato creato un oggetto LDA_Gibbs con tre temi. Non ho eseguito str(lda) qui a causa dell’output voluminoso, ma puoi farlo tu per vedere cosa contiene.
Il passo successivo è aprire quell’oggetto e vedere i risultati. Puoi usare la funzione tidy() per metterlo in un formato facile da capire. All’interno della chiamata a tidy() passa l’oggetto LDA e beta per l’argomento matrix. Passare beta ti fornisce le probabilità per tema e per parola del modello. Nell’esempio seguente, usando il termine iceberg, vedi la probabilità che quella parola sia in ciascun tema. La parola iceberg ha una probabilità più alta di essere generata nel Tema 1.
 #convert the LDA object into a tidy format
#passing "beta" shows the word probabilities
#filter on the word iceberg as an example
#results show probability of iceberg for each topic
tidy(lda, matrix = "beta") %>% filter(term == "iceberg")
[# A tibble: 3 x 3 topic term beta 1 1 iceberg 0.000198
2 2 iceberg 0.00000292 3 3 iceberg 0.00000315]
Per comprendere chiaramente il modello, devi vedere quali termini ci sono in ciascun tema. Crea una funzione che renda “tidy” il modello LDA ed estragga i termini principali per ciascun tema, cioè i termini per tema con i valori beta più alti. All’interno di questa funzione farai riferimento a word_chart() che hai costruito prima per generare una bella visualizzazione dei tre temi e delle parole principali. Imposta num_words a 10 per questo esempio, ma puoi giocare con il numero per prospettive diverse sui temi.
 num_words <- 10 #number of words to visualize

#create function that accepts the lda model and num word to display
top_terms_per_topic <- function(lda_model, num_words) {

  #tidy LDA object to get word, topic, and probability (beta)
  topics_tidy <- tidy(lda_model, matrix = "beta")


  top_terms <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(beta)) %>%
  #get the top num_words PER topic
  slice(seq_len(num_words)) %>%
  arrange(topic, beta) %>%
  #row is required for the word_chart() function
  mutate(row = row_number()) %>%
  ungroup() %>%
  #add the word Topic to the topic labels
  mutate(topic = paste("Topic", topic, sep = " "))
  #create a title to pass to word_chart
  title <- paste("LDA Top Terms for", k, "Topics")
  #call the word_chart function you built in prep work
  word_chart(top_terms, top_terms$term, title)
}
#call the function you just built!
top_terms_per_topic(lda, num_words)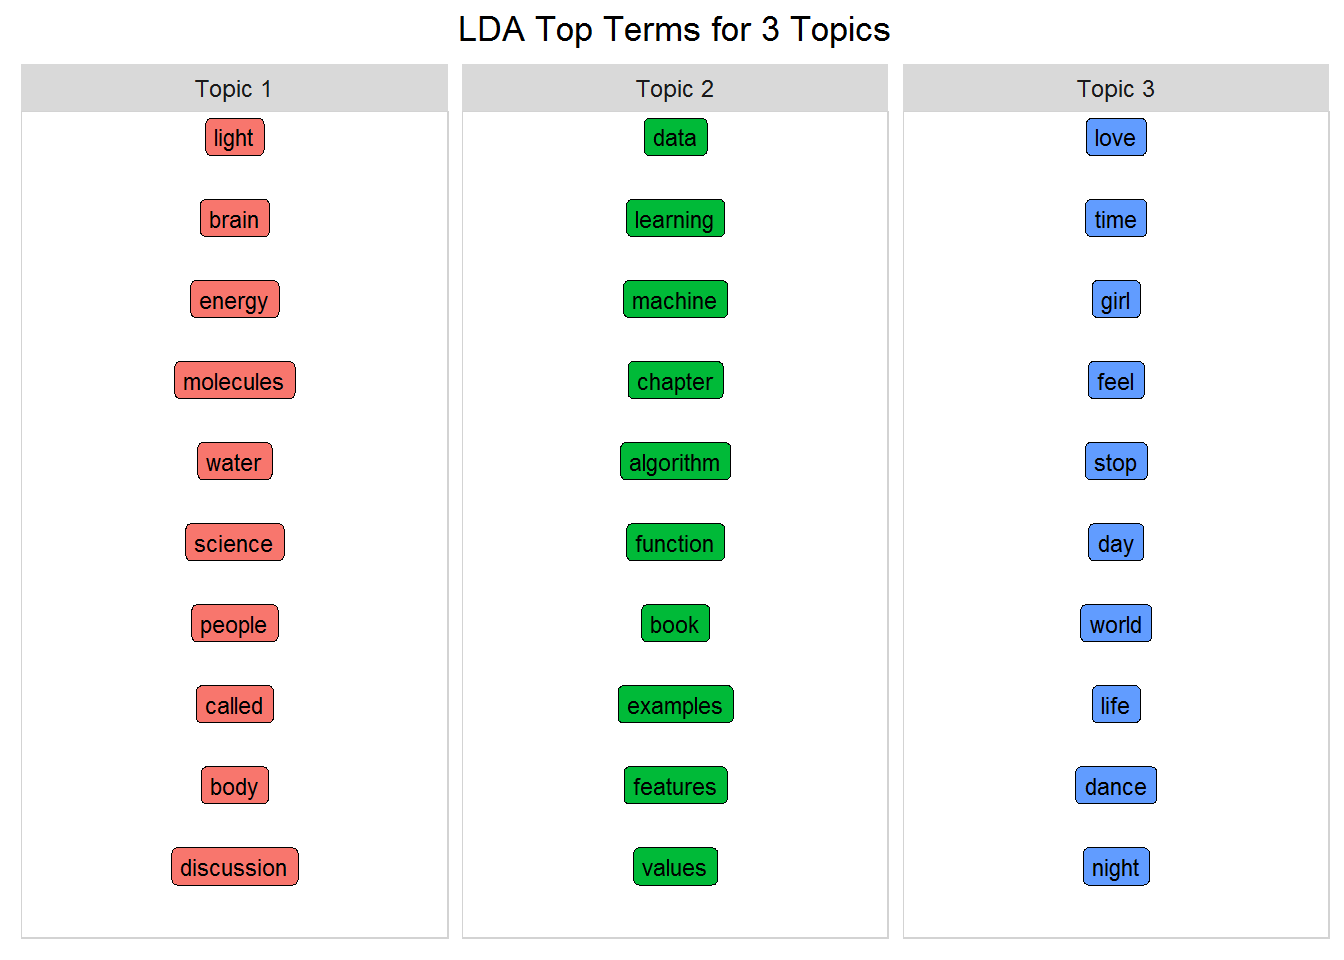
L’apprendimento non supervisionato richiede sempre interpretazione umana... ma questi temi riflettono chiaramente le tre fonti Icebergs, Machine Learning e Prince! Anche se è un esempio molto semplice, è piuttosto sorprendente se pensi alle possibilità!
Oltre a stimare ogni tema come una mistura di parole, LDA mostra anche ogni documento come una mistura di temi. Questa volta, quando rendi “tidy” il modello LDA, usa matrix = "gamma" e otterrai le probabilità per documento e per tema. Per esempio, guarda la canzone di Prince 1999. Qui vedi che, proprio come una parola è associata a più temi, lo stesso vale per i documenti. Questo rimanda al concetto di appartenenza mista. Sotto puoi vedere che 1999 è più probabile che compaia nel Tema 3.
 #this time use gamma to look at the prob a doc is in a topic
#just look at the Prince song 1999 as an example
tidy(lda, matrix = "gamma") %>% filter(document == "1999")
# A tibble: 3 x 3
document topic gamma
<chr> <int> <dbl>
1 1999 1 0.170
2 1999 2 0.170
3 1999 3 0.661Questa canzone appartiene a ciascun tema, ma con percentuali diverse, rappresentate dal valore gamma. Alcuni documenti si adattano meglio a determinati temi. Come mostrato sopra, 1999 ha un valore gamma più alto per il Tema 3.
Per chiarire la comprensione di ciò che fa LDA, dai un’occhiata a questo grafico circolare. Mostra la percentuale di documenti di ciascuna fonte che appartiene a ciascun tema. Per crearlo, unisci il modello LDA in forma tidy a source_tidy dove hai archiviato la fonte effettiva (cioè l’autore), unendo per document. Poi, con i raggruppamenti corretti, puoi ottenere il valore medio di gamma per fonte e per tema. Ora puoi vedere, per ciascuna fonte, in quale tema cade la maggior parte dei documenti.
Prenditi un attimo per esaminarlo davvero se non hai usato grafici circolari prima. (Dai un’occhiata alla Parte Due-A per esercitarti con chordDiagrams() e il pacchetto circlize. Tutto ciò che ti serve sapere sul pacchetto è coperto in questo libro di Zuguang Gu.)
 #using tidy with gamma gets document probabilities into topic
#but you only have document, topic and gamma
source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to orig tidy data by doc to get the source field
  inner_join(three_sources_tidy_balanced, by = "document") %>%
  select(source, topic, gamma) %>%
  group_by(source, topic) %>%
  #get the avg doc gamma value per source/topic
  mutate(mean = mean(gamma)) %>%
  #remove the gamma value as you only need the mean
  select(-gamma) %>%
  #removing gamma created duplicates so remove them
  distinct()

#relabel topics to include the word Topic
source_topic_relationship$topic = paste("Topic", source_topic_relationship$topic, sep = " ")

circos.clear() #very important! Reset the circular layout parameters
#assign colors to the outside bars around the circle
grid.col = c("prince" = my_colors[1],
             "icebergs" = my_colors[2],
             "machine_learning" = my_colors[3],
             "Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey")

# set the global parameters for the circular layout. Specifically the gap size (15)
#this also determines that topic goes on top half and source on bottom half
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
#main function that draws the diagram. transparancy goes from 0-1
chordDiagram(source_topic_relationship, grid.col = grid.col, transparency = .2)
title("Relationship Between Topic and Source")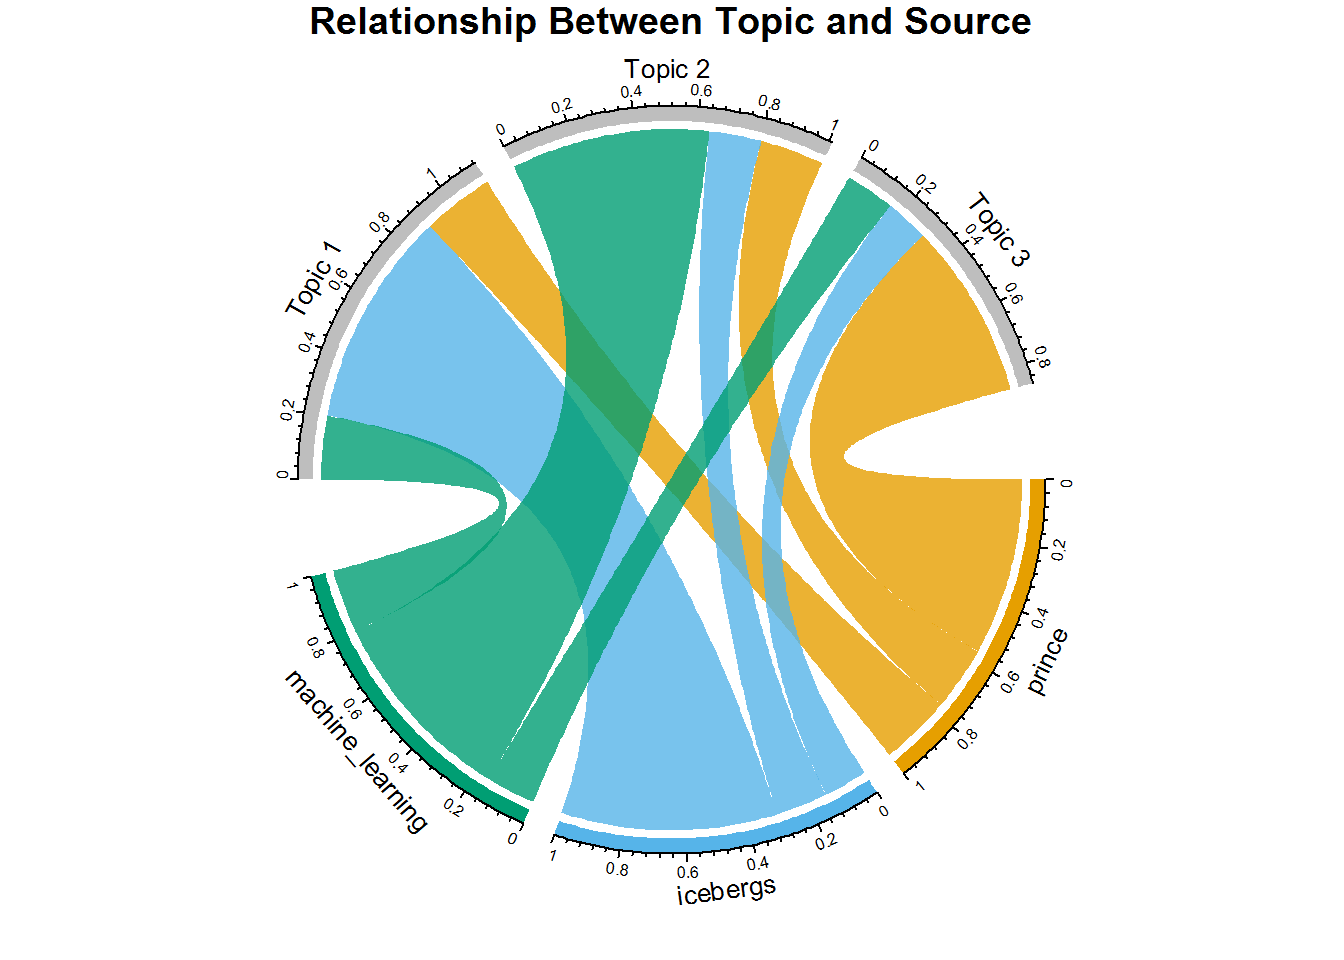
È un modo davvero interessante per vedere che, sebbene i documenti di ciascuna fonte compaiano in ogni tema, ogni fonte ha chiaramente una maggioranza in un tema specifico. Per esempio, le canzoni di Prince sono per lo più associate al Tema 3, poiché quella corda è più grande delle corde che vanno ai temi uno e due. Lo stesso avviene per Icebergs e il Tema 1, e per Machine Learning e il Tema 2. Una volta visto il pattern, diventa tutto molto chiaro.
Se pensi a ciò che hai appena fatto, hai effettivamente classificato i documenti in Temi basandoti sulla media di gamma per tema/fonte. Se conosci l’autore di un documento e sai che quell’autore compone la maggior parte dei testi o dei libri su un tema specifico, potresti supporre che artisti di generi simili ricadano negli stessi temi e quindi puoi raccomandare autori simili... Quando guarderai il dataset più grande, metterai in pratica questo esercizio.
Ora guarda al livello del singolo documento e visualizza i documenti principali per tema.
 number_of_documents = 5 #number of top docs to view
title <- paste("LDA Top Documents for", k, "Topics")

#create tidy form showing topic, document and its gamma value
topics_tidy <- tidy(lda, matrix = "gamma")

#same process as used with the top words
top_documents <- topics_tidy %>%
  group_by(topic) %>%
  arrange(topic, desc(gamma)) %>%
  slice(seq_len(number_of_documents)) %>%
  arrange(topic, gamma) %>%
  mutate(row = row_number()) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " "))

title <- paste("LDA Top Documents for", k, "Topics")
word_chart(top_documents, top_documents$document, title)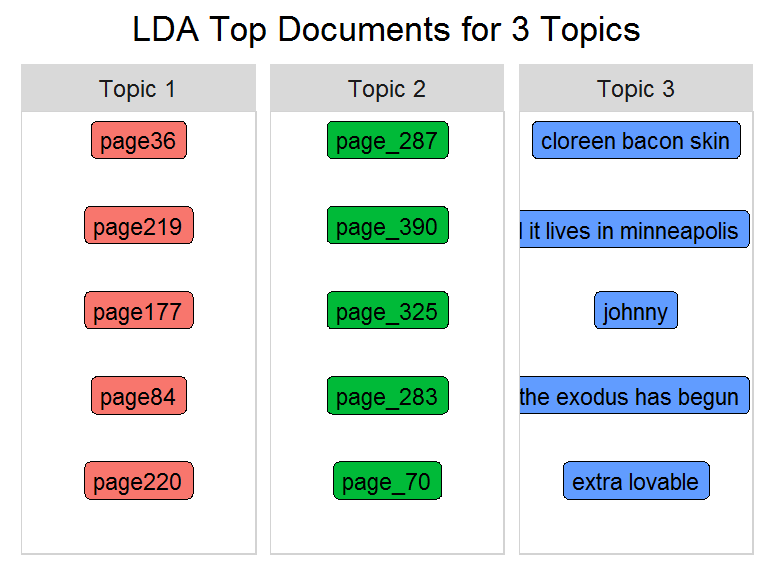
Poiché potresti non conoscere la nomenclatura dei titoli dei documenti/canzoni (cioè le pagine con un underscore provengono dal libro di machine learning), sostituirò il nome del documento con il nome della fonte.
 title <- paste("Sources for Top Documents for", k, "Topics")

topics_tidy <- tidy(lda, matrix = "gamma")

top_sources <- top_documents %>%
  #join back to the tidy form to get the source field
  inner_join(source_tidy) %>%
  select(document, source, topic) %>%
  distinct() %>%
  group_by(topic) %>%
  #needed by word_chart (not relevant here)
  mutate(row = row_number()) %>%
  ungroup()

word_chart(top_sources, top_sources$source, title)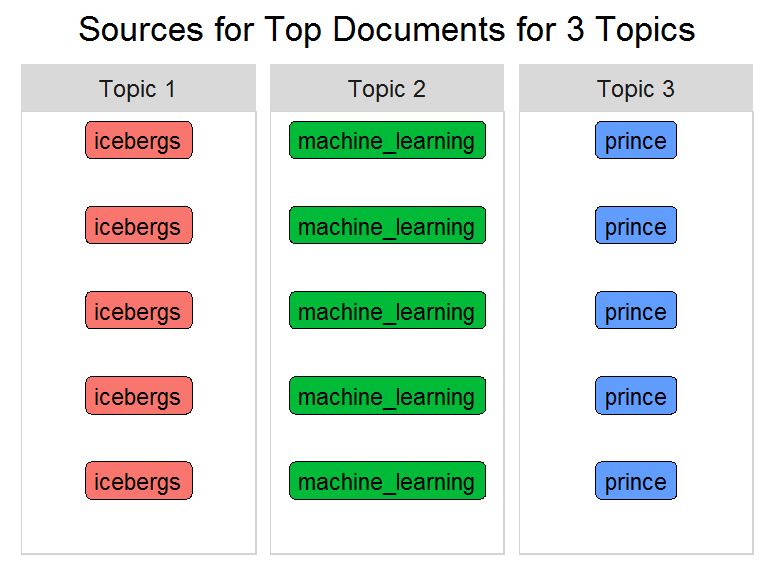
I documenti principali per ciascun tema, come mostrato nel grafico precedente, sono stati sostituiti dalla loro fonte. Il tuo codice ha classificato bene questi documenti perché sono ricaduti nella stessa categoria (almeno per questi 5 migliori)! La grande domanda è se questo funzioni con più di tre fonti. Se i risultati sono accurati, allora puoi raccomandare autori con temi simili.
Creerai il secondo modello usando una tecnica di machine learning diversa: l’algoritmo k-means. Come LDA, anche k-means è non supervisionato e richiede di decidere in anticipo il numero di temi. In contrasto con il modello a appartenenza mista di LDA, k-means partiziona i documenti in cluster disgiunti (cioè temi). Qui l’algoritmo raggruppa i documenti in gruppi diversi basandosi su una misura di similarità. Trasforma i documenti in un vettore numerico con pesi assegnati alle parole per documento (simile a tf-idf). Ogni documento appare in un solo cluster. Questo si chiama hard clustering. L’output è un insieme di cluster con i loro documenti. Al contrario, LDA è una tecnica fuzzy (soft) in cui un punto dati può appartenere a più cluster.
Quindi, concettualmente, applicato al linguaggio naturale, LDA dovrebbe dare risultati più realistici di k-means per l’assegnazione dei temi, dato che il testo di solito comprende più di un tema. Costruisci ora il tuo modello, esamina l’oggetto k-means e verifica se l’assunzione regge.
 #use the same three sources you started with
source_dtm <- three_sources_dtm_balanced
source_tidy <- three_sources_tidy_balanced

#Set a seed for replicable results
set.seed(1234)
k <- 3
kmeansResult <- kmeans(source_dtm, k)
str(kmeansResult)
List of 9
$ cluster : Named int [1:1449] 1 3 2 2 3 1 3 2 2 3 ...
..- attr(*, "names")= chr [1:1449] "push it up" "shake" "party up" "style" ...
$ centers : num [1:3, 1:13608] 42 0.01065 0.00758 0 0.01141 ...
..- attr(*, "dimnames")=List of 2
.. ..$ : chr [1:3] "1" "2" "3"
.. ..$ : chr [1:13608] "push" "shake" "party" "style" ...
$ totss : num 237535
$ withinss : num [1:3] 640 202211 28285
$ tot.withinss: num 231137
$ betweenss : num 6398
$ size : int [1:3] 2 1315 132
$ iter : int 3
$ ifault : int 0
- attr(*, "class")= chr "kmeans"La struttura dell’oggetto k-means rivela due informazioni importanti: clusters e centers. Puoi usare il formato seguente per vedere il contenuto di ciascuna variabile per la canzone 1999 e la parola party che appare in quella canzone.
head(kmeansResult$cluster["1999"])1999
2head(kmeansResult$centers[,"party"])1 2 3
0.5000000 0.1269962 0.1439394Questi campi mostrano che 1999 è collocata in un singolo cluster (cluster due) e che party è in tutti e tre i cluster, ma cade principalmente nel cluster uno. Ora guarda le parole principali basate sui valori di centers per identificare i temi.
Ricorda che questo dataset contiene tre fonti: Prince, Icebergs e Machine Learning. Stampa le parole principali per ciascun cluster e confronta i risultati con l’output LDA. Dovrai manipolare leggermente il formato dei dati per usare la tua funzione word_chart(). Puoi seguire il codice, ma qui contano più l’analisi delle parole principali che i dettagli.
 num_words <- 8 #number of words to display
#get the top words from the kmeans centers
kmeans_topics <- lapply(1:k, function(i) {
  s <- sort(kmeansResult$centers[i, ], decreasing = T)
  names(s)[1:num_words]
})

#make sure it's a data frame
kmeans_topics_df <- as.data.frame(kmeans_topics)
#label the topics with the word Topic
names(kmeans_topics_df) <- paste("Topic", seq(1:k), sep = " ")
#create a sequential row id to use with gather()
kmeans_topics_df <- cbind(id = rownames(kmeans_topics_df),
                          kmeans_topics_df)
#transpose it into the format required for word_chart()
kmeans_top_terms <- kmeans_topics_df %>% gather(id, 1:k)
colnames(kmeans_top_terms) = c("topic", "term")

kmeans_top_terms <- kmeans_top_terms %>%
  group_by(topic) %>%
  mutate(row = row_number()) %>% #needed by word_chart()
  ungroup()

title <- paste("K-Means Top Terms for", k, "Topics")
word_chart(kmeans_top_terms, kmeans_top_terms$term, title)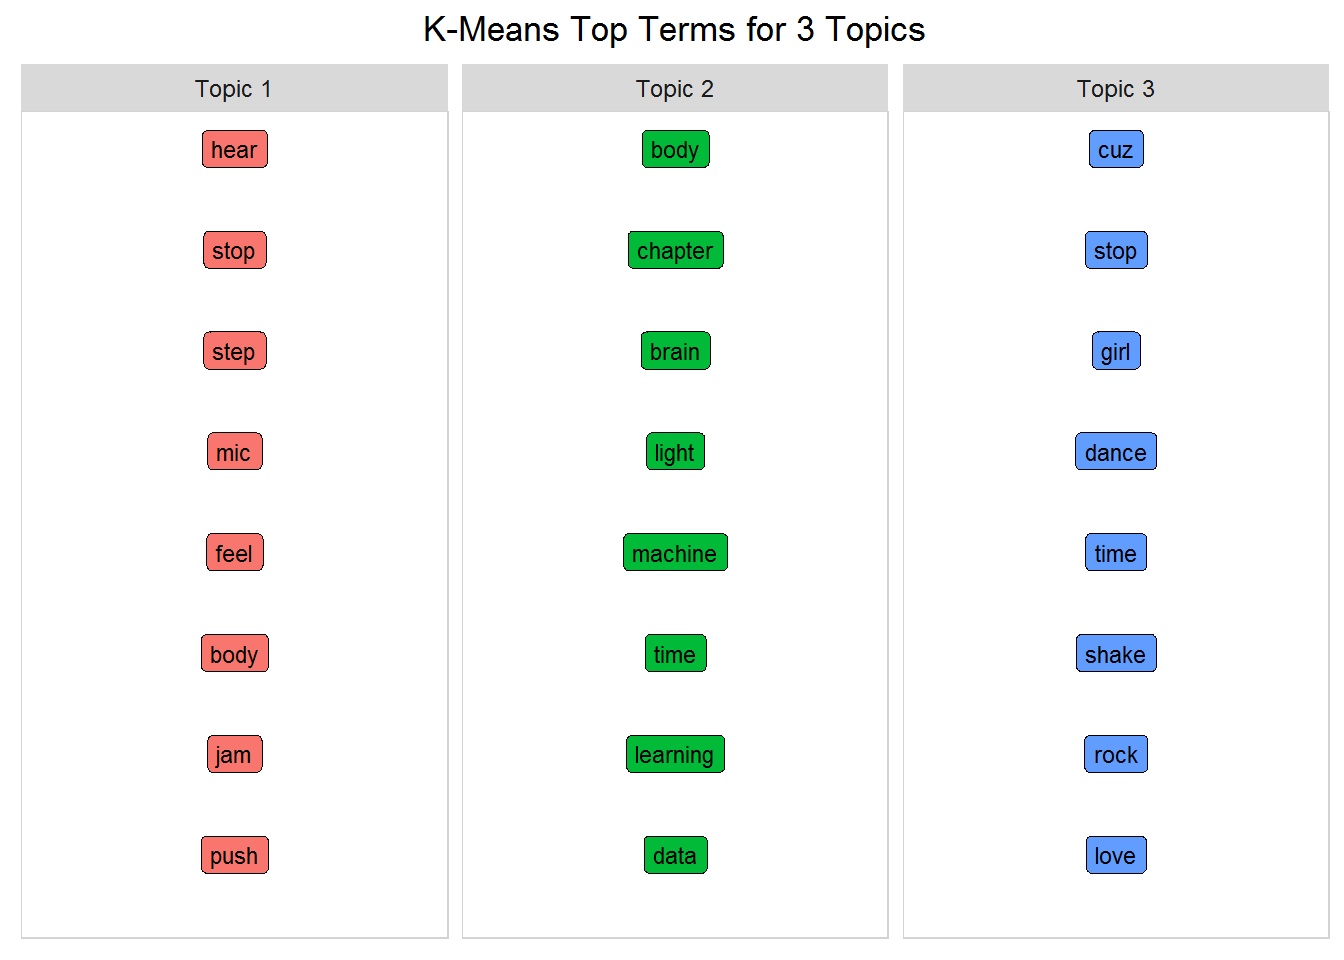
L’algoritmo k-means è abbastanza intelligente da separare i temi tra libri e musica. In altre parole, i Temi 1 e 3 sono chiaramente legati a Prince, e il Tema 2 è una combinazione dei due libri. Tuttavia, non è stato in grado di distinguere tra i due libri stessi come hai fatto con LDA. K-means può essere ottimizzato, ma anche LDA può esserlo. A colpo d’occhio, con parametri di default, k-means non sembra funzionare bene quanto LDA e, di fatto, l’hard clustering non è tipicamente usato per il topic modeling. (Per un’altra opzione, dai un’occhiata al pacchetto mallet.)
Per questo modello userai l’algoritmo LDA sul dataset con 12 fonti/autori diversi che coprono più generi. Il dataset è già bilanciato con un numero simile di documenti e parole per autore. Ecco una panoramica dei dati:
 all_sources_tidy_balanced %>%
  group_by(source) %>%
  #get the word count and doc count per source
  mutate(word_count = n(),
         source_document_count = n_distinct(document)) %>%
  select(source, genre, word_count, source_document_count) %>%
  distinct() %>%
  ungroup() %>%
  #bars change size according to number
  #tiles are static sizes
  mutate(word_count = color_bar("lightpink")(word_count),
         source_document_count = color_bar("lightpink")(source_document_count),
         source = color_tile("lightblue","lightblue")(source),
         genre = color_tile("lightgreen","lightgreen")(genre)) %>%
  my_kable_styling("All Sources Stats")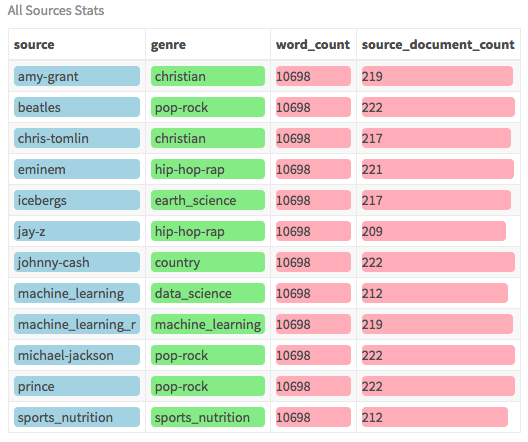
Questo dataset contiene un’ampia varietà di artisti che vanno da Prince a Johnny Cash (country), fino a Eminem (rap) nonché quattro libri distinti. Questi artisti sono stati scelti perché risultano tra i più prolifici nei rispettivi generi. I contenuti sono stati estratti da un sito di testi. Benché ci siano due libri di machine learning, uno è focalizzato sulla data science generale e uno è più specifico per il machine learning in R. Tutti i libri sono disponibili come PDF scaricabili. (I PDF grezzi non sono necessari per questa analisi poiché sono state fornite le versioni tidy).
Un rapido passaggio di pulizia: alcune descrizioni di genere sono troppo lunghe per i grafici, quindi crea forme abbreviate per renderle più leggibili.
 all_sources_tidy_balanced <- all_sources_tidy_balanced %>%
  mutate(source = ifelse(source == "machine_learning", "m_learn",
         ifelse(source == "machine_learning_r", "m_learn_r",
         ifelse(source == "michael_jackson", "mi_jackson",
         ifelse(source == "sports_nutrition", "nutrition", source))))) %>%
  mutate(genre = ifelse(genre == "machine_learning", "m_learn",
ifelse(genre == "sports_nutrition", "nutrition", genre))) #this time use the dataset with 12 sources
all_sources_dtm_balanced <- all_sources_tidy_balanced %>%
count(document, word, sort = TRUE) %>%
ungroup() %>%
cast_dtm(document, word, n)
source_dtm <- all_sources_dtm_balanced
source_tidy <- all_sources_tidy_balancedQuesta volta hai dodici autori e otto generi. Spero che autori dello stesso genere vengano raggruppati nello stesso tema. Questo è il vero test. Quindi imposta il numero di temi a otto e adatta di nuovo il modello usando questo dataset più grande.
 k <- 8 #number of topics chosen to match the number of genres
num_words <- 10 #number of words we want to see in each topic
seed = 1234 #make it repeatable
#same as before
lda <- LDA(source_dtm, k = k, method = "GIBBS", control = list(seed = seed))

top_terms_per_topic(lda, num_words)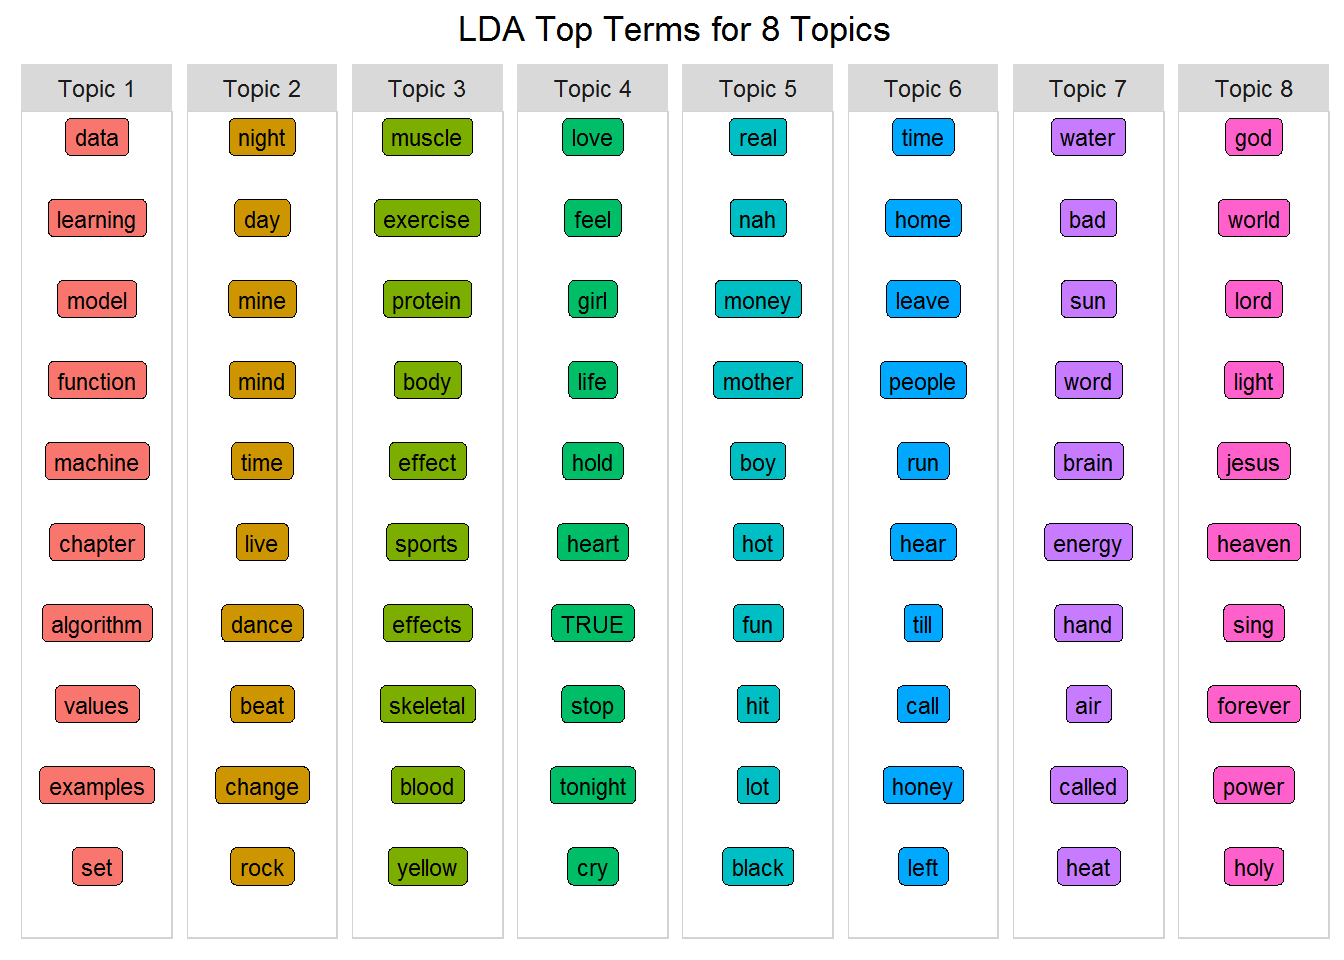
Per non influenzare la tua opinione, la mia reazione è: «Wow»! Dato l’input di questo modello, riesci a vedere i temi? Guarda ciascun tema e prova ad associarlo agli otto generi noti. Alcuni saranno difficili da distinguere, ma altri piuttosto evidenti. Per esempio, ecco alcune possibili interpretazioni:
Non dimenticare il concetto di appartenenza mista e che questi temi non sono pensati per essere completamente disgiunti, ma sono rimasto stupito nel vedere risultati così netti. Nota a margine: l’algoritmo LDA accetta più parametri di quelli usati qui e quindi puoi tarare il tuo modello per renderlo ancora più solido.
La prossima parte è davvero entusiasmante. Come puoi rendere più facile capire di cosa trattano questi temi? Nella maggior parte dei casi è difficile da interpretare, ma con il dataset giusto il modello può rendere bene. Se il modello riesce a determinare in quali temi è più probabile che ricada ciascun documento, puoi iniziare a raggruppare gli autori. E poiché nel tuo caso conosci il genere di un autore, puoi validare i risultati — entro certi limiti! Il primo passo è classificare ogni documento.
Ricorda: ogni documento contiene più temi, ma con percentuali diverse rappresentate dal valore gamma. Alcuni documenti si adattano meglio a certi temi. Questo grafico mostra il valore medio di gamma dei documenti di ciascuna fonte per ciascun tema. È lo stesso approccio usato sopra con tre autori, ma questa volta guarderai il campo genere. È un modo fantastico per mostrare la relazione tra il genere degli autori e i temi.
 source_topic_relationship <- tidy(lda, matrix = "gamma") %>%
  #join to the tidy form to get the genre field
  inner_join(source_tidy, by = "document") %>%
  select(genre, topic, gamma) %>%
  group_by(genre, topic) %>%
  #avg gamma (document) probability per genre/topic
  mutate(mean = mean(gamma)) %>%
  select(genre, topic, mean) %>%
  ungroup() %>%
  #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  distinct()

circos.clear() #very important! Reset the circular layout parameters
#this is the long form of grid.col just to show you what I'm doing
#you can also assign the genre names individual colors as well
grid.col = c("Topic 1" = "grey", "Topic 2" = "grey", "Topic 3" = "grey",
             "Topic 4" = "grey", "Topic 5" = "grey", "Topic 6" = "grey",
             "Topic 7" = "grey", "Topic 8" = "grey")

#set the gap size between top and bottom halves set gap size to 15
circos.par(gap.after = c(rep(5, length(unique(source_topic_relationship[[1]])) - 1), 15,
                         rep(5, length(unique(source_topic_relationship[[2]])) - 1), 15))
chordDiagram(source_topic_relationship,  grid.col = grid.col, annotationTrack = "grid",
             preAllocateTracks = list(track.height = max(strwidth(unlist(dimnames(source_topic_relationship))))))
#go back to the first track and customize sector labels
#use niceFacing to pivot the label names to be perpendicular
circos.track(track.index = 1, panel.fun = function(x, y) {
  circos.text(CELL_META$xcenter, CELL_META$ylim[1], CELL_META$sector.index,
              facing = "clockwise", niceFacing = TRUE, adj = c(0, 0.5))
}, bg.border = NA) # here set bg.border to NA is important
title("Relationship Between Topic and Genre")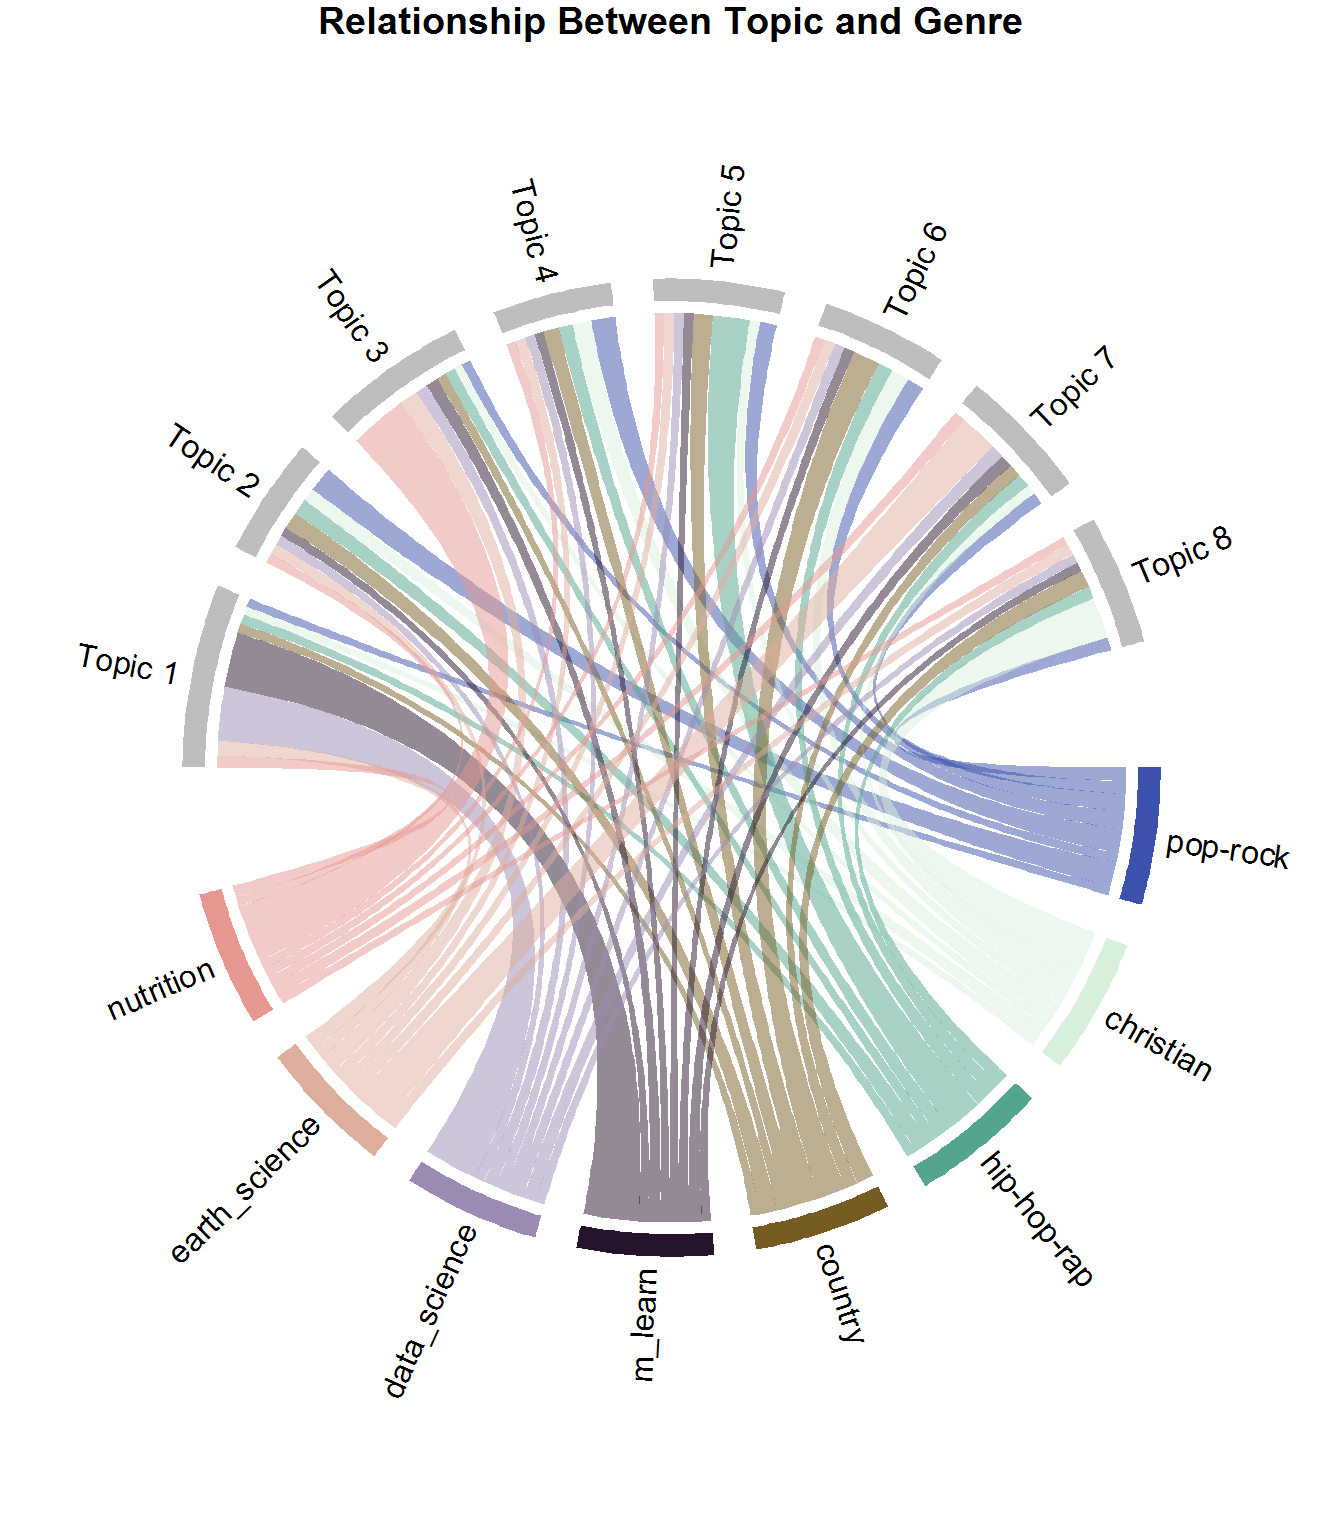
Ogni corda (cioè collegamento) rappresenta il valore medio di gamma dei documenti per genere che appartengono a un tema. Se guardi la sezione sports_nutrition, vedi che la corda verso il Tema 3 è più grande delle altre. Significa che più pagine di nutrizione sportiva ricadono in quel tema. Chiaramente, la maggior parte delle pagine di Machine Learning e Data Science ricade nel Tema 1; la maggior parte dei documenti di Scienze della Terra nel Tema 7 e, come ci si aspetterebbe, Pop-Rock è ben distribuito su più temi. Ha perfettamente senso perché, per definizione, Pop sta per popolare ed è un genere generalista. Rap/Hip-Hop, invece, è più comune nel Tema 5. Cosa puoi farci? Puoi fare raccomandazioni agli ascoltatori basate sul contenuto tematico!
Ovviamente, il contenuto dei testi non deve essere l’unica feature usata dai sistemi di raccomandazione, ma può essere combinato con metadati come ritmo, strumentazione, tempo, ecc., per un’esperienza di ascolto migliore.
Ora che vedi la relazione tra documenti e temi, raggruppa per source (cioè autore) e tema e ottieni la somma dei valori gamma per gruppo. Poi seleziona l’autore con il topic_sum più alto per ciascun tema usando top_n(1). Dato che vorrai fare la stessa cosa per il genere come qui per l’autore, crea una funzione chiamata top_items_per_topic() e passa source come tipo. In questo modo potrai richiamarla anche quando classifichi per genere.
Questo è il momento critico in cui mappi effettivamente l’autore a un tema specifico. Cosa ti aspetti che succeda?
 #this function can be used to show genre and source via passing the "type"
top_items_per_topic <- function(lda_model, source_tidy, type) {
  #get the tidy version by passing gamma for the per document per topic probs
  document_lda_gamma <- tidy(lda_model, matrix = "gamma") %>%
  #join to the tidy form to get source and genre
  inner_join(source_tidy) %>%
  select(document, gamma, source, genre, topic) %>%
  distinct() %>% #remove duplicates
  #group so that you can get sum per topic/source
  group_by(source, topic) %>%
  #sort by decending gamma value
  arrange(desc(gamma)) %>%
  #create the sum of all document gamma vals per topic/source. Important!
  mutate(topic_sum = sum(gamma)) %>%
  select(topic, topic_sum, source, genre) %>%
  distinct() %>%
  ungroup() %>%
  #type will be either source or genre
  group_by(source, genre ) %>%
  #get the highest topic_sum per type
  top_n(1, topic_sum) %>%
  mutate(row = row_number()) %>%
  mutate(label = ifelse(type == "source", source, genre),
         title = ifelse(type == "source", "Recommended Writers Per Topic",
                        "Genres Per Topic")) %>%
  ungroup() %>%
   #re-label topics
  mutate(topic = paste("Topic", topic, sep = " ")) %>%
  select(label, topic, title)

#slightly different format from word_chart input, so use this version
document_lda_gamma %>%
#use 1, 1, and label to use words without numeric values
ggplot(aes(1, 1, label = label, fill = factor(topic) )) +
  #you want the words, not the points
  geom_point(color = "transparent") +
  #make sure the labels don't overlap
  geom_label_repel(nudge_x = .2,
                   direction = "y",
                   box.padding = 0.1,
                   segment.color = "transparent",
                   size = 3) +
  facet_grid(~topic) +
  theme_lyrics() +
  theme(axis.text.y = element_blank(), axis.text.x = element_blank(),
        axis.title.y = element_text(size = 4),
        panel.grid = element_blank(), panel.background = element_blank(),
        panel.border = element_rect("lightgray", fill = NA),
        strip.text.x = element_text(size = 9)) +
  xlab(NULL) + ylab(NULL) +
  ggtitle(document_lda_gamma$title) +
  coord_flip()
}

top_items_per_topic(lda, source_tidy, "source")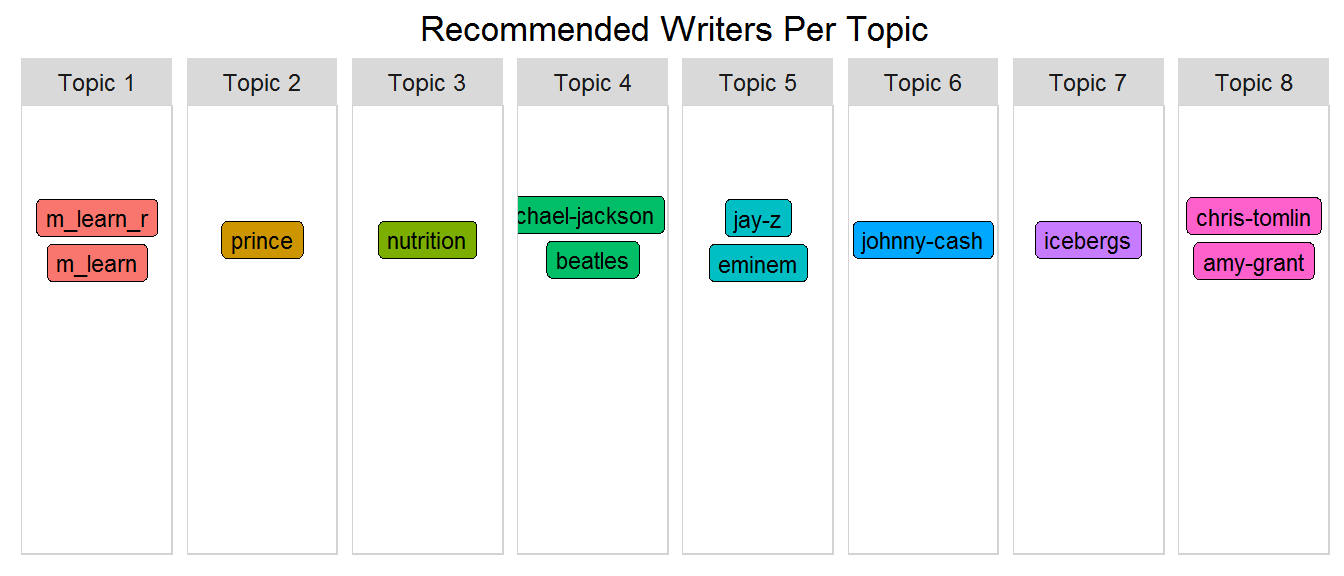
Entusiasmante! Tuttavia, dato che potresti non conoscere bene questi artisti, renderò tutto più chiaro sostituendo l’autore con il genere. Pronti...
top_items_per_topic(lda, source_tidy, "genre")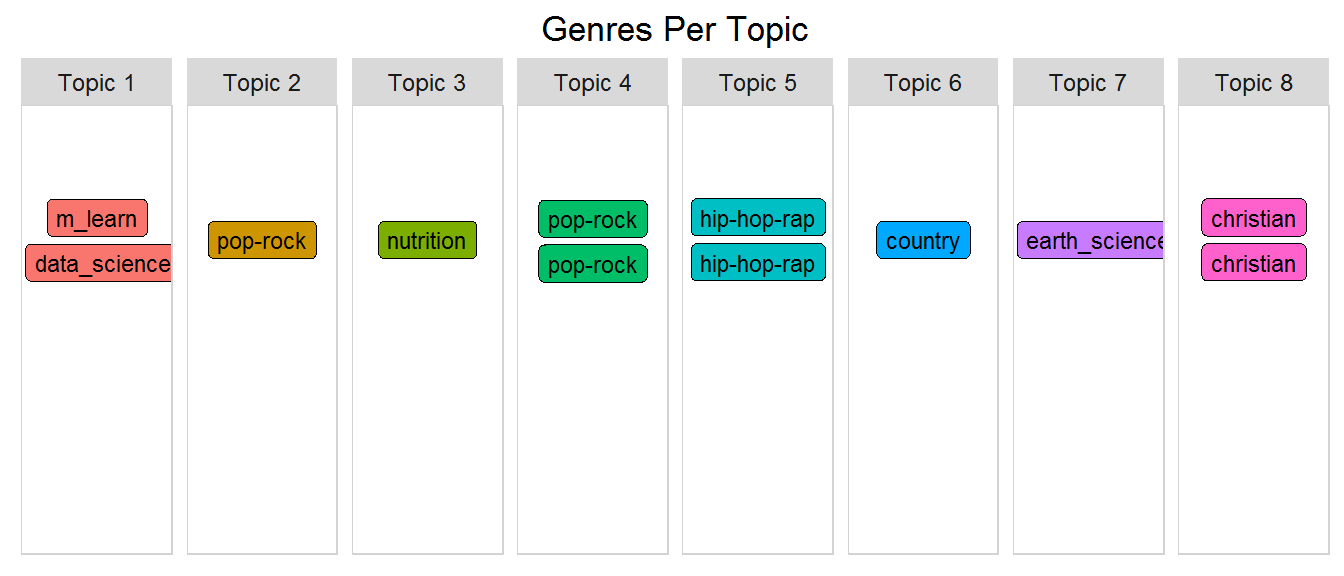
Gli artisti hip-hop/rap sono raggruppati insieme; gli artisti cristiani sono insieme; due artisti pop-rock sono insieme e ogni libro ha il proprio tema! È davvero sorprendente vedere che l’apprendimento non supervisionato può produrre risultati come questi (riconoscere generi diversi) basandosi interamente sul testo. Cosa succederebbe se scegliessi un numero diverso di temi? Quali generi verrebbero combinati o separati? Magari potresti provare da solo. Per ora, il prossimo modello si concentrerà sul dataset di Prince usato nei tutorial precedenti.
Per questo modello userai il dataset con sole canzoni di Prince. Sebbene nei testi compaiano temi distinti, spesso una singola canzone copre più di un tema. Quando il dataset ha un solo artista, i temi saranno più mescolati e meno disgiunti. Questo rende l’interpretazione uno step critico. Invece di usare i dati grezzi dei testi di Prince, userai una versione leggermente modificata come descritto sotto.
In precedenza hai usato le parole come compaiono nel testo. Ora userai una forma annotata dei dati, ottenuta con un potente pacchetto NLP chiamato cleanNLP. Questo pacchetto è un modello tidy per l’Elaborazione del Linguaggio Naturale che fornisce attività di annotazione come tokenizzazione, part-of-speech tagging, riconoscimento di entità nominate, entity linking, analisi del sentiment e molto altro. Questo esercizio è stato svolto al di fuori del tutorial, ma ho fornito tutto ciò che serve per il topic modeling.
Nel dataset annotato, c’è una riga per ogni parola nel corpus dei testi di Prince con informazioni importanti su ciascuna parola.
Guarda più da vicino l’oggetto di annotazione tokenizzato esaminando i nomi dei campi.
 #read in the provided annotated dataset
prince_annotated <- read.csv("prince_data_annotated.csv")
#look at the fields provided in the dataset
names(prince_annotated)
[1] "X" "id" "sid" "tid" "word"
[6] "lemma" "upos" "pos" "cid" "pid"
[11] "case" "definite" "degree" "foreign" "gender"
[16] "mood" "num_type" "number" "person" "poss"
[21] "pron_type" "reflex" "tense" "verb_form" "voice"Per ora userai solo due informazioni:
Il campo word è la parola originale e lemma è la versione lemmatizzata. upos è il codice universale della parte del discorso. Se chiami table() su upos vedrai il conteggio delle parole che rientrano in ciascuna etichetta di parte del discorso. (Nota che alcune parole possono essere taggate più volte)
table(prince_annotated$upos)ADJ ADP ADV AUX CCONJ DET INTJ NOUN NUM PART PRON PROPN
15193 19157 20439 19855 5601 20777 5399 48047 5439 10087 50932 523
SCONJ SYM VERB X
5626 72 43673 3095Per darti un’idea di come sono i dati, zooma su un paio di canzoni in cui il lemma non è uguale alla parola originale e rimuovi le stop word.
 prince_annotated %>%
  #most lemmas are the same as the raw word so ignore those
  filter((as.character(word) != as.character(lemma))
         & (id %in% c("broken", "1999"))) %>% #filter on 2 songs
  anti_join(stop_words) %>%
  select(song = id, word, lemma, upos) %>%
  distinct() %>%
  my_kable_styling("Annotated Subset")
Questo mostra come puoi essere molto selettivo su cosa includere nei modelli (cioè la parola, il lemma o una certa parte del discorso). È una scelta soggettiva se usare la parola lemmatizzata o quella originale. Potresti voler usare anche un’altra forma detta stem, citata in Parte Due-A. Potresti anche mettere in discussione i risultati di cleanNLP e cosa viene identificato come nome rispetto ad aggettivo. Ti consiglio di sperimentare più configurazioni finché non trovi quella che funziona meglio per te.
Per questo tutorial modellerai solo i sostantivi. Per ottenere i metadati associati a Prince come genere e anno, unisci prince_annotated a prince_tidy per word e document, quindi crea la DTM come al solito. Ho scelto di rimuovere alcune parole molto comuni presenti in tutti i temi per rendere il tutto più interessante. (Nota che usare il concetto di tf-idf trattato in Parte Uno è un altro metodo per rimuovere parole comuni.)
 source_tidy <- prince_annotated %>%
  select(document = id, word, lemma, upos) %>%
  filter(upos == "NOUN") %>% #choose only the nouns
  inner_join(prince_tidy, by = c("word", "document")) %>%
  select(document, word, lemma, upos, source, genre, year) %>%
  distinct()

source_dtm <- source_tidy %>%
  #filter out some words that exist across themes just for our purposes
  filter(!word %in% c("love", "time", "day", "night", "girl")) %>%
  count(document, word, sort = TRUE) %>%
  ungroup() %>%
cast_dtm(document, word, n) #Changing these parameters or the source data will cause different results!!
k <- 7
num_words <- 6
seed = 4321
lda <- LDA(source_dtm, k = k, method = "GIBBS",
control = list(seed = seed))
top_terms_per_topic(lda, num_words)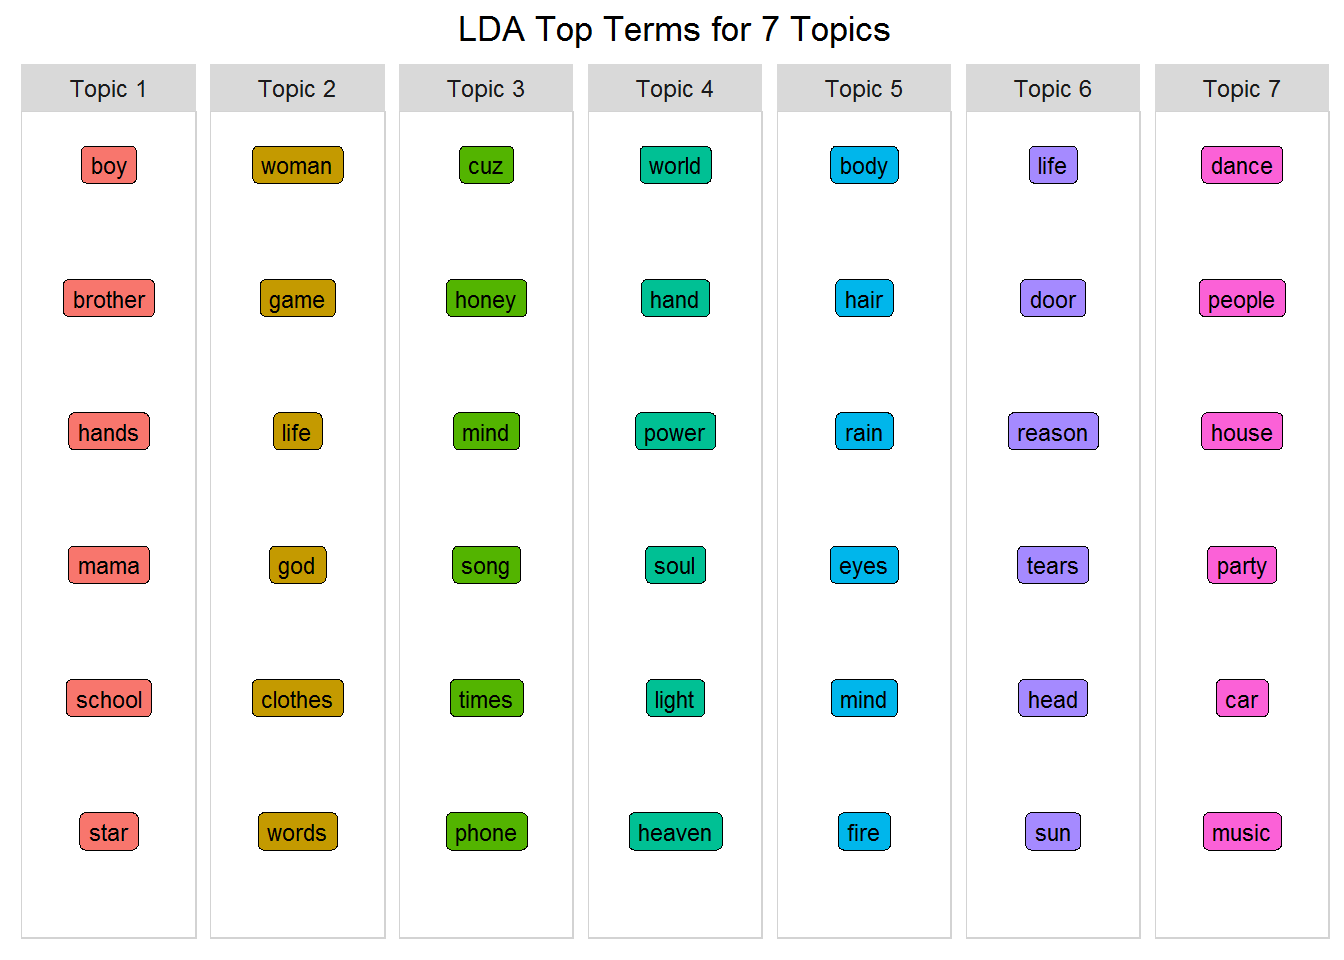
Qui sotto c’è un elenco di temi che nel tempo sono stati etichettati come potenziali temi nella musica di Prince. Sono associati a certe parole e, come in tutto il topic modeling, ci sono sovrapposizioni. Ma guarda questi temi etichettati manualmente (elencati in ordine casuale!) e vedi se riesci a ritrovarli nel modello che hai costruito.
Sembra che il tuo Tema 1 riguardi persone e famiglia; il Tema 7 riguardi musica, danza e festa; e il Tema 4 riguardi sé, società e religione. Questo richiede un’interpretazione molto soggettiva. In un contesto aziendale, questo passaggio è meglio eseguito da un esperto della materia che può avere un’idea di cosa aspettarsi. Ora capisci perché l’NLP è davvero l’intersezione tra intelligenza artificiale e linguistica computazionale!
Prova a eseguire il modello con un numero diverso di temi, o solo con i verbi, o usando la parola grezza invece della forma lemmatizzata, o con un numero diverso di parole principali e vedi quali insight ne derivano. Ci sono nuovi metodi per aiutarti a determinare il numero di temi: vedi il concetto di perplessità qui, o il pacchetto
ldatuningqui.
Dato che il dataset di Prince contiene l’anno, puoi tracciare i temi nel tempo. Puoi essere davvero creativo qui, ma per ora guarda solo alcune parole di due temi e osservane la frequenza nel tempo. L’analisi delle tendenze potrebbe essere un intero tutorial a sé, quindi se ti interessa, dai un’occhiata a questa risorsa.
 p1 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("music", "party", "dance")) %>%
  group_by(year) %>%
  mutate(topic_7_count = n()) %>%
  select(year, topic_7_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_7_count)) + geom_smooth(se = FALSE, col = "red")

p2 <-  prince_tidy %>%
  filter(!year == "NA") %>% #remove songs without years
  filter(word %in% c("heaven","hand","soul")) %>%
  group_by(year) %>%
  mutate(topic_4_count = n()) %>%
  select(year, topic_4_count) %>%
  distinct() %>%
  ggplot(aes(year, topic_4_count)) + geom_smooth(se = FALSE)

grid.arrange(p1, p2, ncol = 2)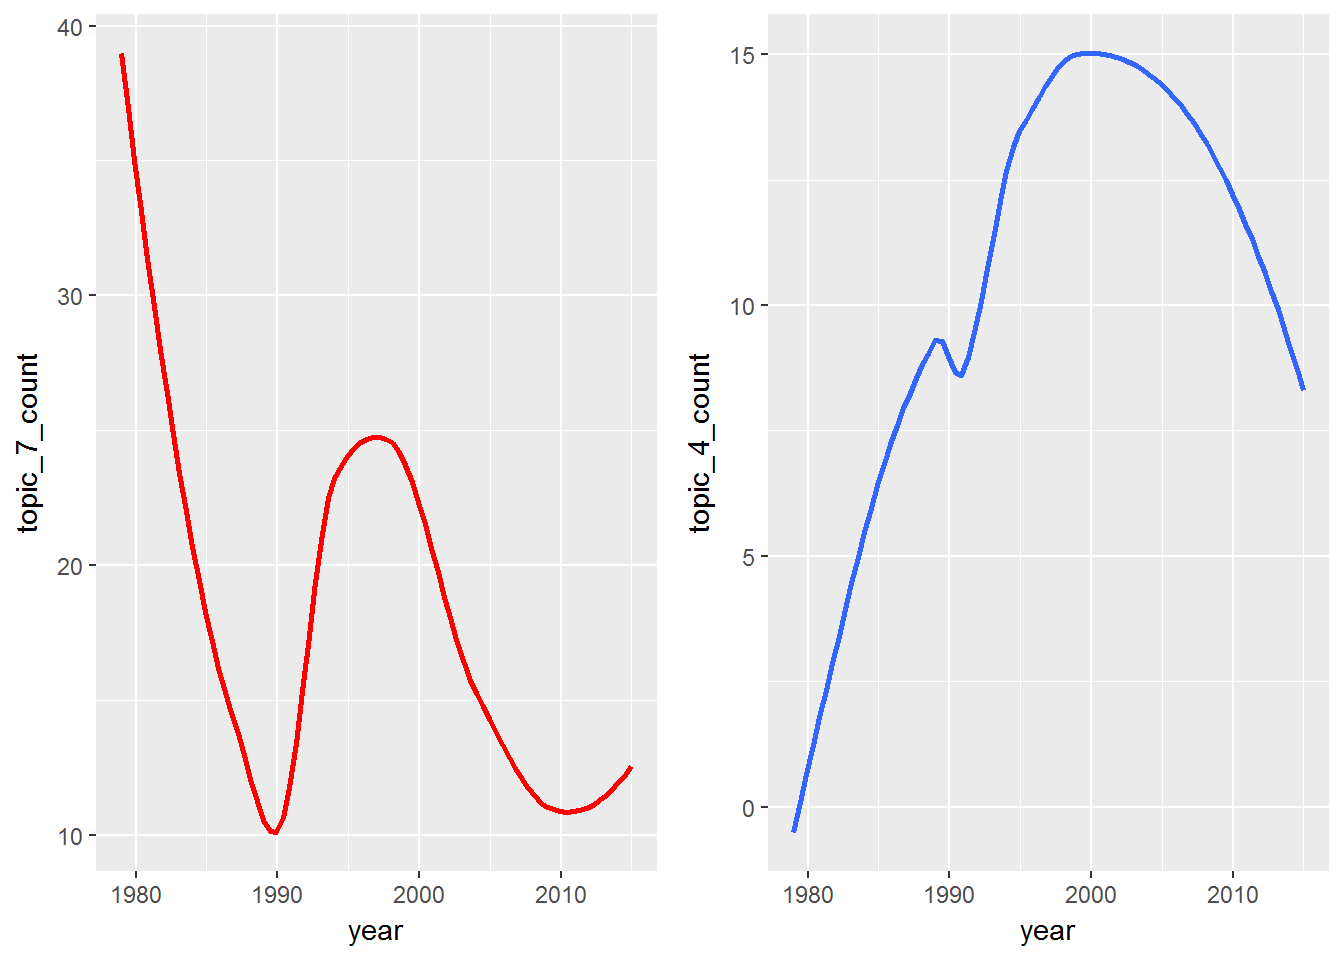
Questo è un esempio estremamente rudimentale di come i temi cambiano nel tempo, ma cosa succederebbe se estendessi questo tipo di analisi oltre la musica? Forse la tua azienda è interessata alla correlazione tra vendite di prodotto e temi di tendenza nei tweet dei clienti sul tuo prodotto. Le applicazioni per capire come i temi cambiano nel tempo sono molte.
Questo tutorial graffia solo la superficie di ciò che è possibile con topic modeling, NLP e machine learning. È un campo della data science in piena espansione che continuerà a fiorire mentre sempre più scienziati affrontano gli oceani inesplorati dei dati non strutturati. In musica, il concetto di classificare le canzoni in base ai testi si trova soprattutto in articoli accademici, quindi magari puoi usare questo lavoro come trampolino per dare il tuo contributo al mondo dell’AI.
Hai usato dati di testi e libri di saggistica per identificare temi, classificare i singoli documenti nei temi più probabili e identificare autori simili in base al contenuto tematico. In tal modo, hai costruito un semplice sistema di raccomandazione basato su testo e autori etichettati.
Ricorda: stai cercando di modellare l’arte con le macchine. Un artista può dire “You are the apple of my eye”, ma non si riferisce né alla frutta né alle parti del corpo. Devi trovare ciò che è nascosto. Quando ascolti musica, non senti sempre i cori in sottofondo, ma ci sono. Alza il volume della tua canzone preferita e ascolta oltre la voce principale: potresti scoprire un mondo di informazioni nascoste. Quindi metti la logica sullo sfondo e porta la creatività in primo piano durante l’esplorazione!
Come in tutti i tutorial di questa serie, ti incoraggio a usare i dati presentati qui come caso di studio divertente, ma anche come generatore di idee per analizzare testi che ti interessano. Potrebbero essere i tuoi artisti preferiti, i social media, testi aziendali, scientifici o socio-economici. Quali sono le tue idee sulle possibili applicazioni del topic modeling? Lascia un commento qui sotto con le tue proposte!
Resta sintonizzato per la Parte Tre (il quarto articolo) della serie: Analisi dei testi: Analitica Predittiva con Machine Learning in R. Lì userai testi e metadati etichettati per prevedere il futuro di una canzone. Lavorerai con diversi algoritmi come Decision Trees, Naive Bayes e altro per prevedere genere, decennio e forse persino se una canzone entrerà in classifica! Spero di rivederti presto!
Avvertenze:
Avvertenza uno: L’unico modo per ottenere gli stessi risultati è eseguire il codice nello stesso identico ordine con gli stessi file di dati non modificati. Altrimenti, i riferimenti a temi specifici non avranno senso.
Avvertenza due: Non esistono regole rigide e veloci per questo lavoro, ed è basato sulla mia ricerca. Sebbene il topic modeling esista in applicazioni reali, non c’è molta attività nello sviluppo di sistemi di raccomandazione musicali basati interamente sui testi.
Avvertenza tre: Il topic modeling è insidioso. Costruire il modello è un conto, ma interpretare i risultati è impegnativo, soggettivo e difficile da validare completamente (anche se la ricerca è in corso: vedi questo articolo di Thomas W. Jones). Il processo è non supervisionato, generativo, iterativo e basato su probabilità. I temi sono sottili, nascosti e impliciti, non espliciti.
Se vuoi saperne di più sul machine learning con R, dai un’occhiata al nostro tutorial per principianti. Inoltre, segui il nostro corso Introduction to Machine Learning.
Scopri di più sul Machine Learning
Corso
Corso
Corso
blog
Abid Ali Awan
10 min
blog
Abid Ali Awan
15 min
blog
Tim Lu
12 min



